缓慢变化维 SCD1、SCD2、SCD3 有什么区别?
面试怎么回答
SCD1 直接覆盖旧值,只看当前状态;SCD2 新增版本并维护有效区间,适合完整历史追溯;SCD3 在同一行保存当前值和有限前值,适合简单前后比较。我不会按整张维度表一刀切,而会按属性判断是纠错、真实状态变化还是有限历史需求,并说明事实表是否要按业务时间关联历史版本。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
“SCD2 不就是拉链表吗?”
这种回答只讲了表长什么样,没有讲清三个方案分别保留什么历史、事实如何关联,以及修改成本在哪里。
SCD 选型的核心不是编号,而是业务需要当前值、完整历史,还是有限的前后对比。
SCD1:覆盖当前值
旧值被直接更新,只保留最新状态。实现简单、查询直接,适合纠错或业务不关心历史的属性,但历史报表会随维度更新而变化。
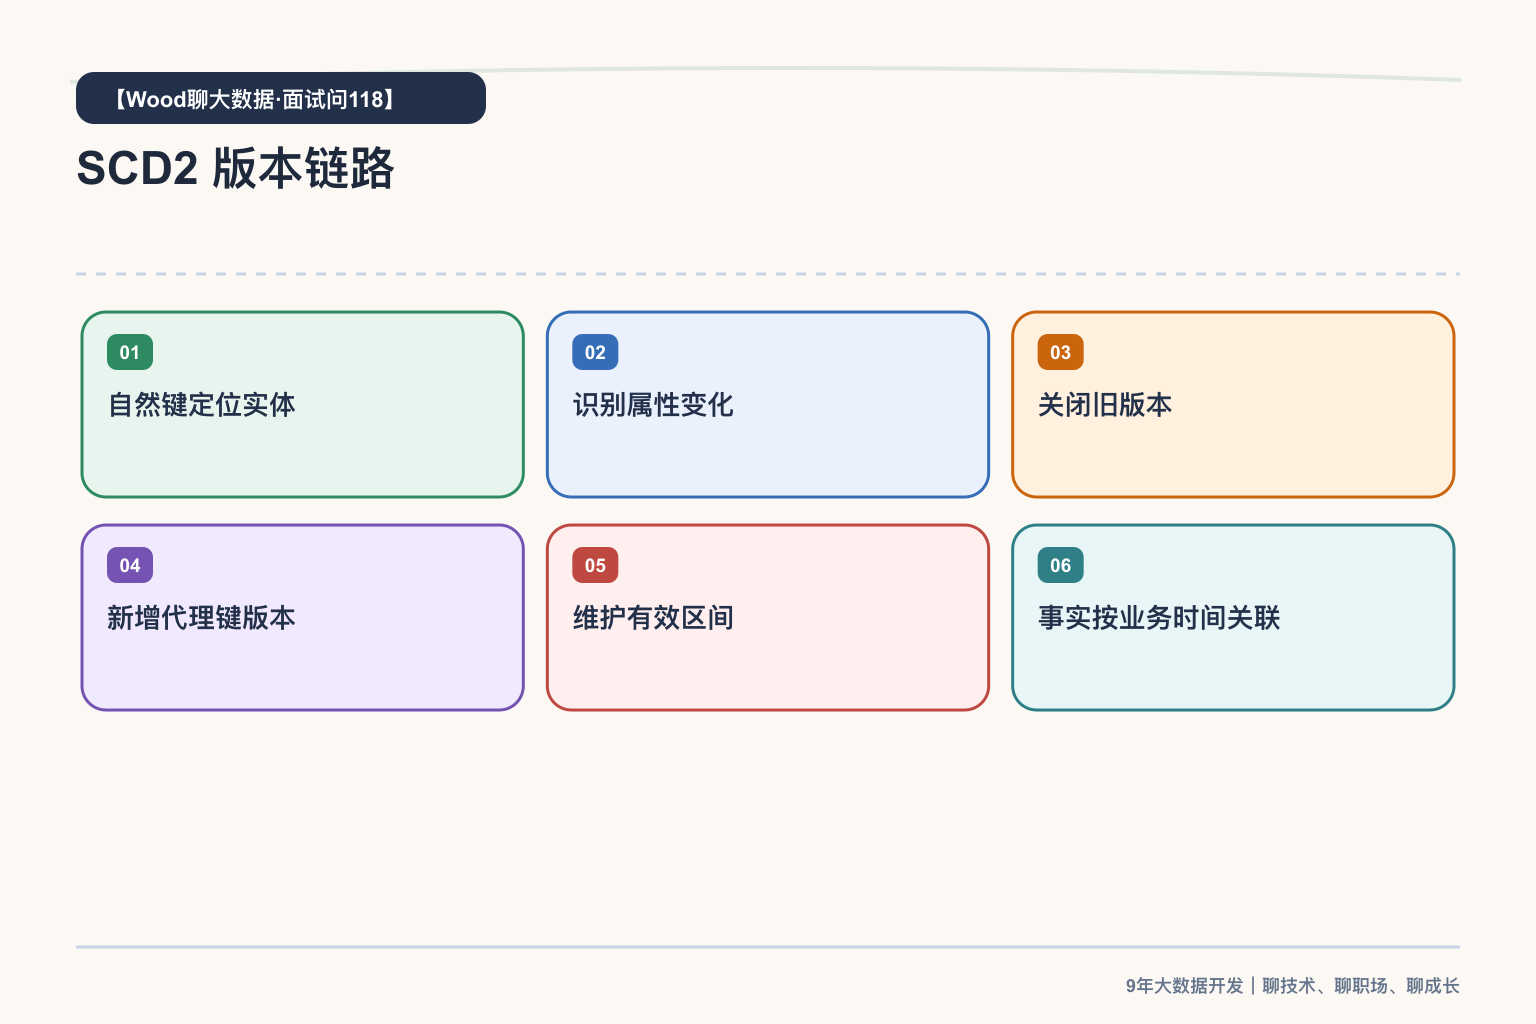
SCD2:新增历史版本
属性变化时关闭旧版本并新增一行,使用生效时间、失效时间和当前标记管理区间。它能回答“当时是什么”,但 ETL、代理键和区间 Join 更复杂。
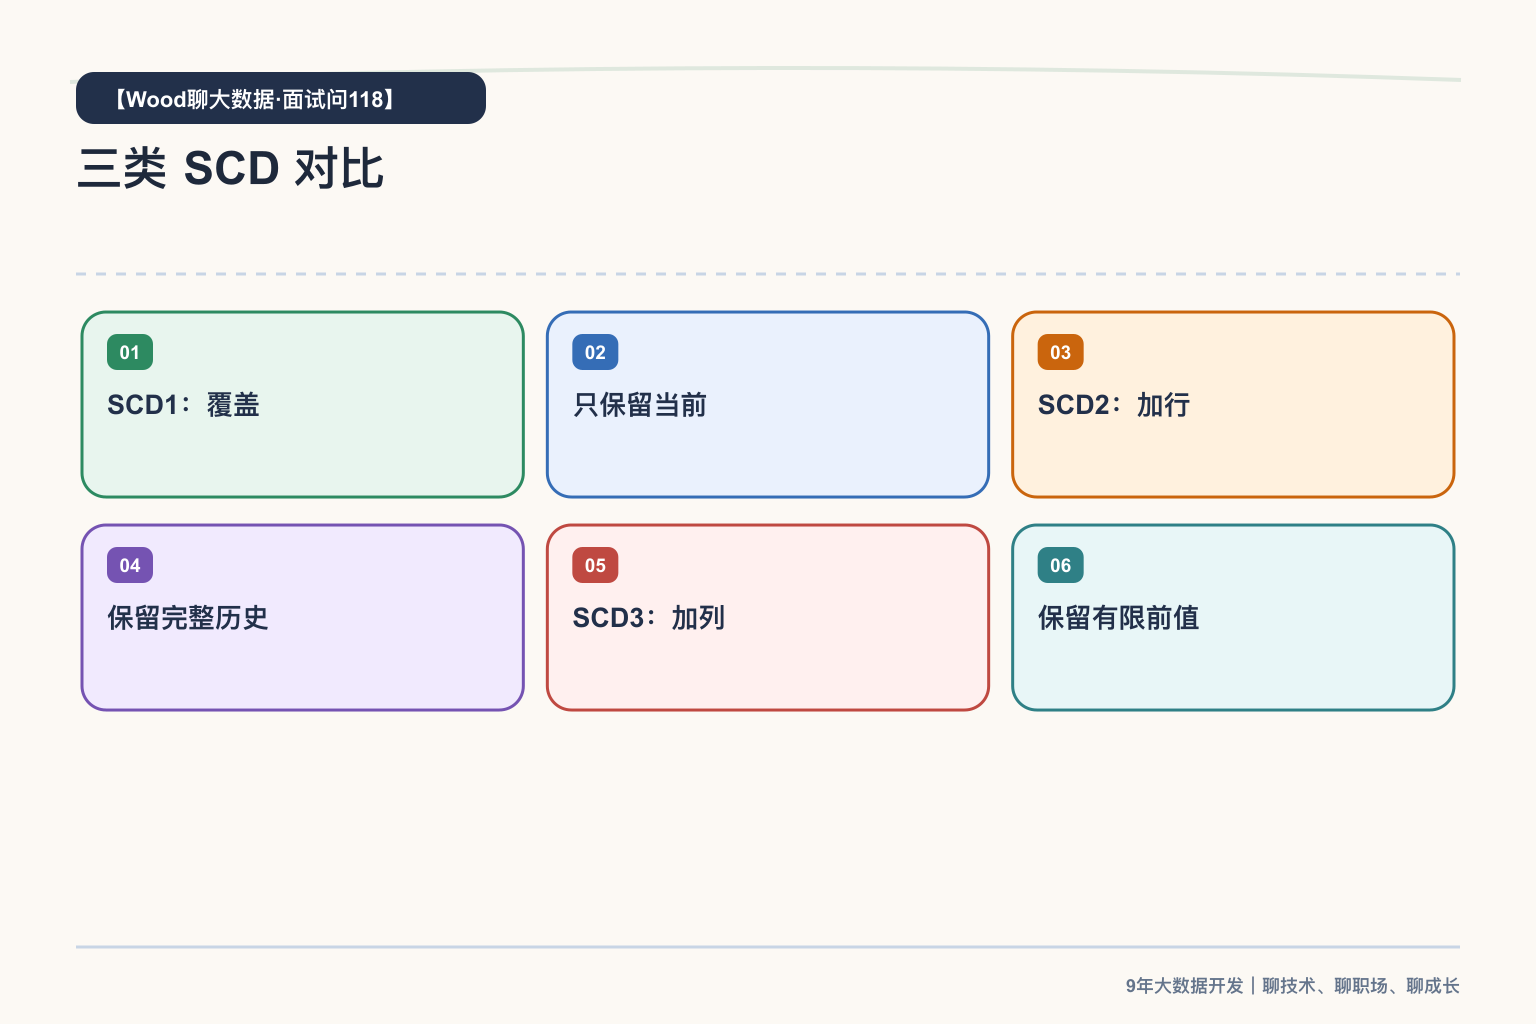
SCD3:在同一行保留有限历史
通过 current_value、previous_value 等列记录少量前后状态,适合只比较上一次变化的场景。变化次数一多,列会膨胀,无法替代完整历史。
属性可以混合策略
同一维度不必所有字段采用同一种 SCD。姓名纠错可覆盖,会员等级可能保留历史,运营分组只需前值。应按属性语义定义变更策略和审计要求。
为什么不能只回答概念?
“浅答案:1 覆盖、2 加行、3 加列”之所以常见,是因为它在理想数据和单次执行里往往说得通。但生产环境会加入数据规模、异常值、并发、版本、失败重试和下游口径,这些条件一变化,只记住术语就很容易给出错误结论。
所以我会把 SCD1:覆盖当前值、SCD2:新增历史版本、SCD3:在同一行保留有限历史、属性可以混合策略 串成一条完整链路。最终判断标准不是某个函数或配置是否出现,而是能否稳定得到可解释、可验证、可恢复的业务结果。
落地时我会检查什么?
- 输入边界:确认数据范围、时间口径、主键和异常值是否符合假设。
- 执行过程:观察分区、并行度、状态、Shuffle 或资源变化,验证方案是否真正生效。
- 输出结果:用行数、唯一性、关键指标和样本明细证明结果正确,而不是只看任务成功。
- 失败恢复:说明重跑、回滚、版本兼容和责任人,避免一次成功后无人维护。
这些检查不一定全部写进一条 SQL 或一个任务,但面试时能主动补充,说明你回答的不是背诵题,而是在描述一套可上线的工程方案。
一个典型场景
常见反例是把客户地址修改全部做 SCD2。后来发现其中大量变化只是标准化修正,例如“路”与“Road”的统一,却产生了新版本,事实关联和报表解释都变复杂。正确做法是区分纠错与真实业务变化:纠错走 SCD1,影响历史分析的迁移才走 SCD2。
先识别变更语义,再决定覆盖、加行还是加列。