Hive SQL 跑得很慢,你怎么排查?
面试怎么回答
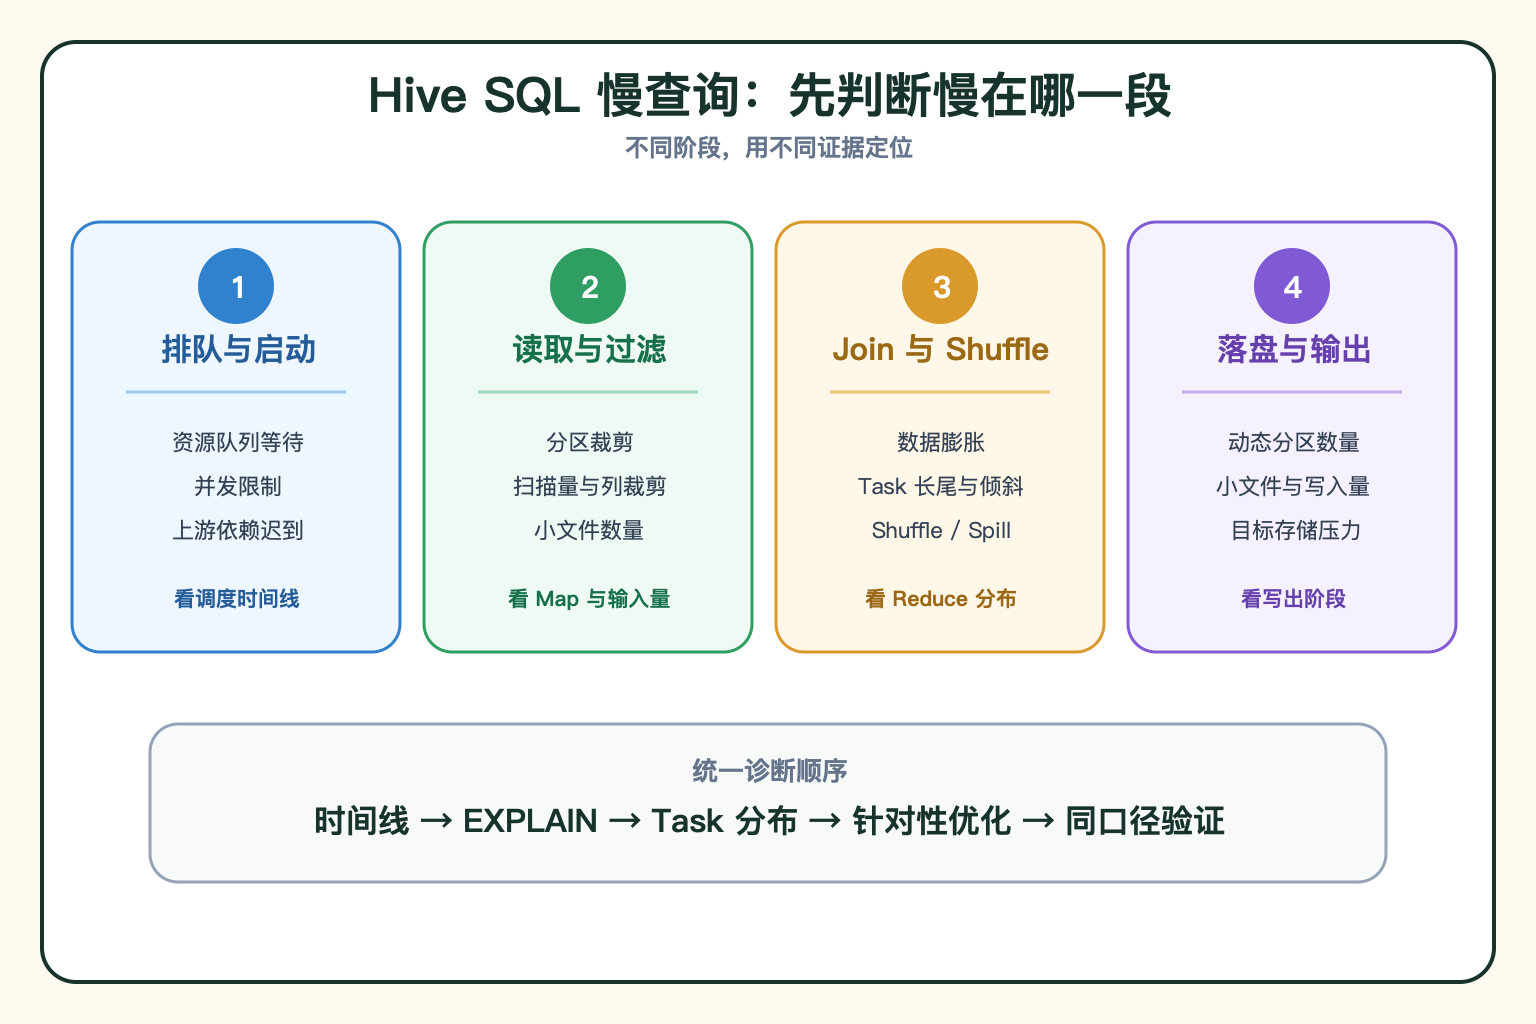
我会先把总耗时拆成排队启动、读取过滤、Join 与 Shuffle、结果写出四个阶段,避免直接调参数。然后结合任务时间线和 EXPLAIN,确认分区裁剪、扫描量、Join 方式、数据膨胀和 Shuffle 是否符合预期。运行指标上,我会比较 Task 时长和输入分布:整体都慢更像扫描量或资源问题,少数长尾更像倾斜;Map 慢重点看小文件和读取,Reduce 慢重点看 Shuffle、Spill 和热点 key。优化时先减少扫描和数据放大,再调整 Join、聚合与分区,最后才针对明确瓶颈调参数或资源,并用同口径数据复跑验证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人一上来就会回答:
- 调大内存
- 增加并行度
- 开启 MapJoin
- 把小文件合并一下
这些方法都可能有效。
但如果还没确认任务慢在哪,就直接改参数,很容易把一次 SQL 问题变成一场“配置试错”。
因为 Hive SQL 慢,可能慢在四个完全不同的位置:
排队慢、扫描慢、Shuffle 慢,或者输出慢。
真正有效的排查方式不是背优化项,而是先把耗时拆开,再用执行计划和运行指标定位最贵的阶段。
第一步:先确认时间到底花在哪里
不要看到总耗时两小时,就默认 SQL 本身执行了两小时。
先拆成四段:
第一类:排队与启动
任务长时间没有真正运行,常见原因是队列资源紧张、并发限制、容器申请慢或上游依赖迟到。
这类问题的重点是调度时间线和资源队列,不是改 SQL。
第二类:读取与过滤
看实际扫描了多少分区、多少文件、多少数据,分区条件有没有生效,是否读取了大量最终不用的列。
如果只查一天却扫描整张表,优先检查分区裁剪,而不是先增加 Reducer。
第三类:Join、聚合与 Shuffle
看哪个 Stage 数据交换量最大,Task 是否均匀,有没有少数长尾 Task,以及 Join 前后数据量是否异常膨胀。
这一步通常能暴露大表双边 Shuffle、热点 key、错误 Join 关系和无效 DISTINCT。
第四类:落盘与输出
计算已经结束但写出很慢,可能是动态分区过多、小文件过多、目标存储压力或单分区输出过大。
不同阶段的根因不同,优化动作也不能混用。
第二步:用执行计划确认数据为什么这样流动
运行日志告诉我“哪里慢”,EXPLAIN 帮我理解“为什么会这样执行”。
我会重点看:
- 分区过滤是否真正下推
- Join 的输入规模和执行方式
- 是否出现不必要的全局排序、重复去重或多次 Shuffle
- 聚合是在数据放大前还是放大后执行
- 估算行数与实际数据是否差异很大
执行计划不是为了背算子名字,而是确认三件事:
读了多少、数据在哪里变多、为什么必须移动。
如果统计信息失真,优化器可能对表大小和 Join 顺序作出错误判断。这时除了改 SQL,也要检查统计信息是否完整、是否过期。
第三步:根据指标判断是哪类瓶颈
如果所有 Task 都慢,通常更像总扫描量太大、计算过重或资源整体不足。
如果大部分 Task 很快,只有少数 Task 拖尾,优先怀疑数据倾斜、单分区过大或热点 key。
如果 Map 阶段慢,重点看文件数量、数据格式、分区裁剪和读取量。
如果 Reduce 阶段慢,重点看 Shuffle 量、分区分布、聚合状态和 Spill。
如果 Task 数量极多但每个 Task 都很短,通常要检查小文件和过细分区;如果 Task 太少且单个任务很重,则要检查并行度和数据切分。
先用指标把问题归类,再决定是改数据布局、SQL 结构、执行参数还是资源。
一个典型场景
比如一条按天运行的 Hive SQL 突然从四十分钟变成几个小时。
第一反应可能是当天数据量增长,需要扩容。
但继续看执行时间线,会发现大部分 Map Task 正常,Reduce 阶段只有少数 Task 一直不结束。
再对比各 Task 输入量,发现某个默认渠道值承载了大量记录;同时 SQL 在 Join 前没有过滤无效数据,还使用了 SELECT DISTINCT 掩盖 Join 后的重复。
真正的根因不是“集群不够大”,而是:
热点 key 造成倾斜,错误的 Join 关系放大数据,最后又用全局去重继续放大 Shuffle 成本。
处理顺序应该是先修正 Join 粒度和无效数据,再单独治理热点,最后才评估并行度和资源。
为什么不能一上来就调参数?
参数只能改变现有执行方式的资源边界,不能修正错误的数据关系。
增加 Reducer 解决不了一个必须落到同一分区的热点 key;扩大内存也解决不了扫描了错误分区;开启 MapJoin 更不能替代对小表大小和内存风险的判断。
盲调参数还可能带来新的问题:任务数暴涨、小文件增多、队列资源被占满,或者单个容器更容易 OOM。
所以优化的优先级应该是:
先修数据范围和 SQL 结构,再调分区与参数,最后才是资源扩容。