HDFS 节点下线怎么做?Decommission 和 Maintenance 有什么区别?
面试怎么回答
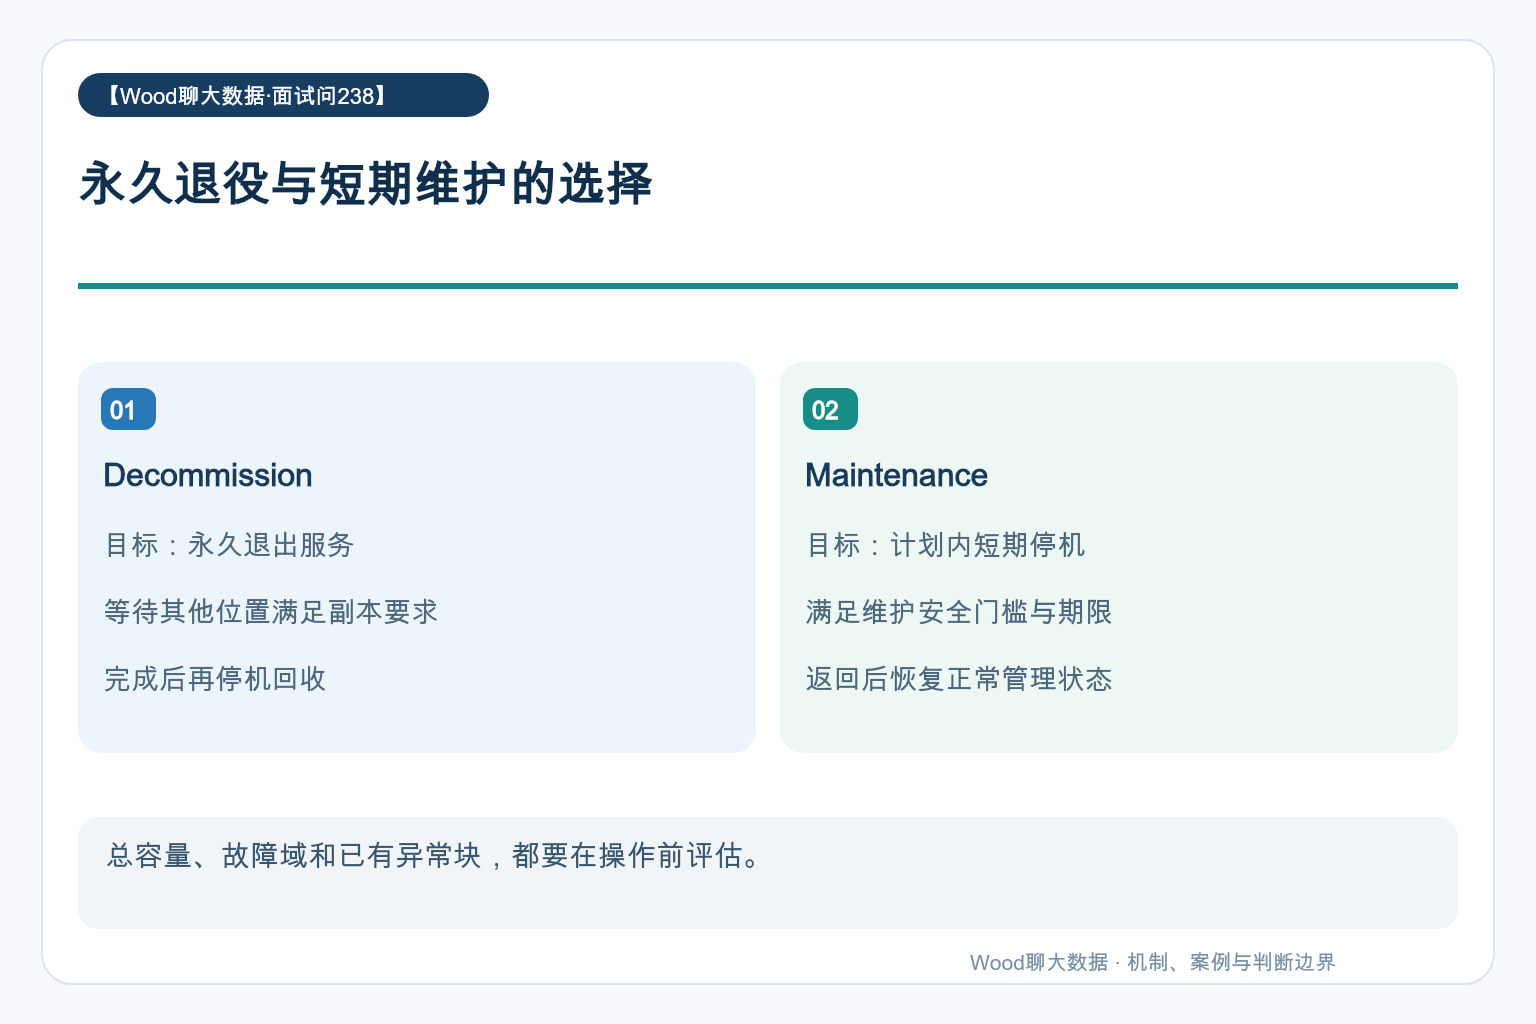
永久退役用 Decommission,先让其他节点满足块副本要求,确认状态完成后再关闭;短期停机可用受支持的 Maintenance,按最小副本与期限控制。下线前检查容量、故障域和已有坏块,多节点分批推进;进度卡住就定位具体块和候选目标,最后用管理状态、块健康及业务读写共同验收。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一台 DataNode 要永久退役,另一台只停机半小时更换硬件。两台都直接停进程,看起来省事,但集群为它们付出的补副本成本和承受的风险并不相同。
永久退役先完成副本迁移,短期维护使用受支持的维护状态与最小副本门槛;操作结束以块安全、管理状态和业务读写共同验收。
永久退役需要让其他节点承接数据
Decommission 用于让节点退出正常服务。进入退役过程后,系统需要确认该节点持有的块在其他位置达到相应要求,期间可能触发补副本,直到管理状态达到已退役。
所以修改排除配置或刷新节点信息,只是发起操作。立即停机可能中断原本可以在线迁移的过程。下线前要检查剩余容量、目标存储类型、机架分布以及当前缺失块,确认集群具备迁移条件。
短期维护关注一段时间内的安全下界
Maintenance 面向计划内短期停机,通过维护状态和相应的最小副本要求减少不必要的完整补副本开销。进入维护前仍需满足其他位置的块安全条件,并可以设置维护到期时间。
它不是“暂时忽略这个节点”的随意开关。支持情况、主机配置格式和维护复制要求都要按实际 Hadoop 版本确认;维护时间超过预期时,应及时更新计划或转为合适的恢复流程,不能让短期维护无限拖延。
多节点并行下线要按块分布评估
总空闲容量足够,也不代表同时停掉同机架几台机器就安全。若某些块的可用副本集中在待下线节点上,或者剩余节点无法满足放置策略,退役可能卡住甚至扩大故障风险。
可以分批下线,观察复制积压与业务负载,再推进下一批。补副本会占网络、磁盘和 NameNode 管理资源,迁移速度要与在线业务承载能力协调;简单提高迁移并发可能把计划维护变成全局性能事件。
一个典型场景:退役进度长期不结束
比如一台节点一直处于退役中,团队以为配置没生效,多次刷新后仍无变化。查看块状态才发现,部分块的其他副本位于异常节点,剩余目标还受存储策略或容量限制。
原检查只看集群总容量和任务返回状态,没定位卡住的具体块。正确处理是追踪未达要求的块与候选目标,修复节点或补足资源,再等待管理状态收敛。为了尽快结束而直接关闭机器,会失去原来尚可读取的副本来源。
下线完成与维护返回都有验收步骤
永久退役完成后再按运维流程停服务并回收资源,检查缺失块、低副本和关键路径读写。短期维护结束后,要让节点恢复正常管理状态,确认心跳、块报告和磁盘健康。
维护状态自动到期并不代表物理设备已修好;同样,机器启动也不代表配置已经重新纳入服务。把管理状态、实际进程和数据健康放在一起核对,避免一个控制台绿灯掩盖另一个层面的缺口。