YARN Capacity Scheduler 如何做队列和资源隔离?
面试怎么回答
Capacity Scheduler 用层级叶子队列承接应用,capacity 提供有需求时的资源保障,maximum-capacity 限制扩张上限,空闲资源可以借用以提高利用率。要形成真正的隔离,还要配用户限制、应用并发、ACL、Placement Rule、节点标签和 Preemption。设计时我会先按 SLA 和成本归属划队列,再用监控验证排队时间、利用率和抢占损耗。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
离线补数一启动,实时任务就排队;把队列容量各切一半,又有大量资源长期空闲。
Capacity Scheduler 要解决的正是保障、共享和利用率之间的矛盾。
Capacity Scheduler 用层级队列、容量、上限、用户限制和抢占机制,在保障与集群利用率之间平衡。
层级队列先表达组织边界
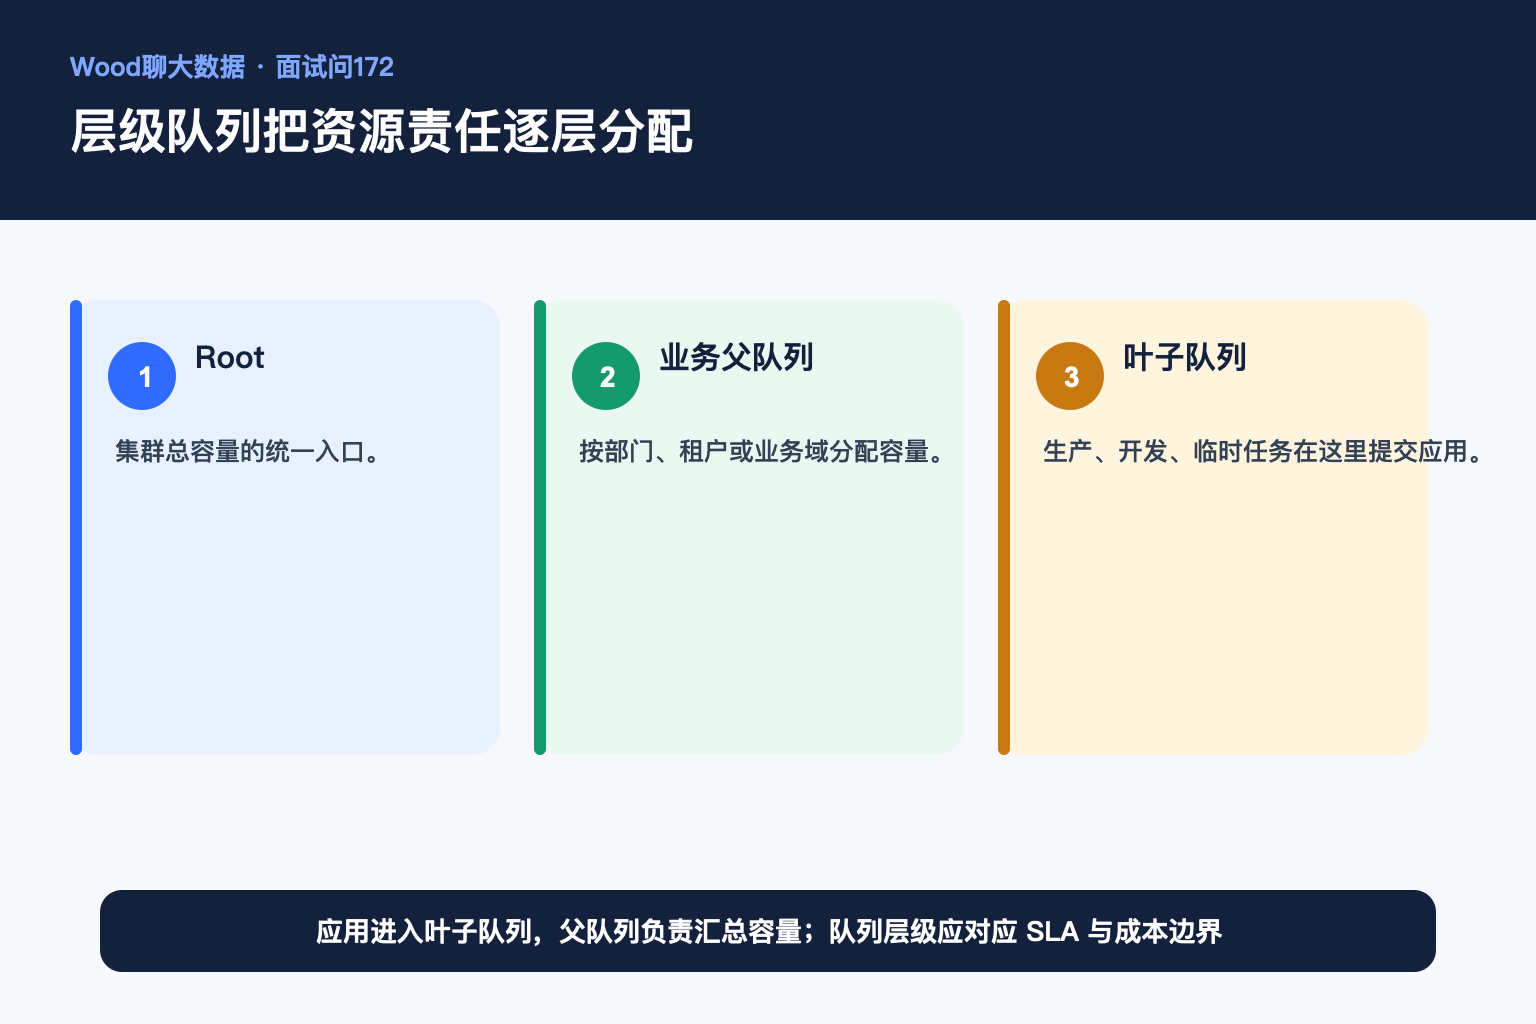
Capacity Scheduler 支持父子队列。根队列下可以按部门划分,再按生产、开发和临时任务细分;应用最终进入叶子队列。父队列的容量由子队列共享,层级结构应与成本归属、SLA 和运维责任一致,而不是照着组织架构无限拆分。
Capacity 是保障,不一定是硬隔离
队列容量表示在有需求时可获得的资源保障。其他队列空闲时,应用通常可以使用更多集群资源,直到队列最大容量或其他限制。这样避免预留资源长期闲置,但也意味着只配置 capacity 不能阻止一个活跃队列暂时吃掉空闲资源。
Maximum、用户限制和并发共同控制风险
Maximum Capacity 限制队列可扩张的上界;User Limit Factor 和最小用户占比避免单个用户垄断队列;还可以限制应用数量、ApplicationMaster 资源比例和节点标签。不同版本配置项有差异,落地应以当前 Hadoop 文档和实际调度器配置为准。
Preemption 负责把借出去的资源拿回来
高优队列需要资源时,如果容量长期被其他队列借用,可以通过抢占逐步回收 Container。抢占过于激进会造成任务反复被杀和计算浪费,太保守又无法兑现 SLA,因此要结合容忍时间、回收比例和任务可重试性调节。

一个典型场景
生产队列保障 60%,开发队列保障 20%,其余给临时和共享任务。夜间生产空闲时,开发任务可以借用资源;早晨生产流量回升后,调度器通过正常释放和必要抢占把资源逐步还给生产。同时用 Placement Rule 把用户自动送到正确队列,用 ACL 禁止绕过准入。
参考资料
- Apache Hadoop Capacity Scheduler 文档:https://hadoop.apache.org/docs/current/hadoop-yarn/hadoop-yarn-site/CapacityScheduler.html