HBase 的读写流程是怎样的?
面试怎么回答
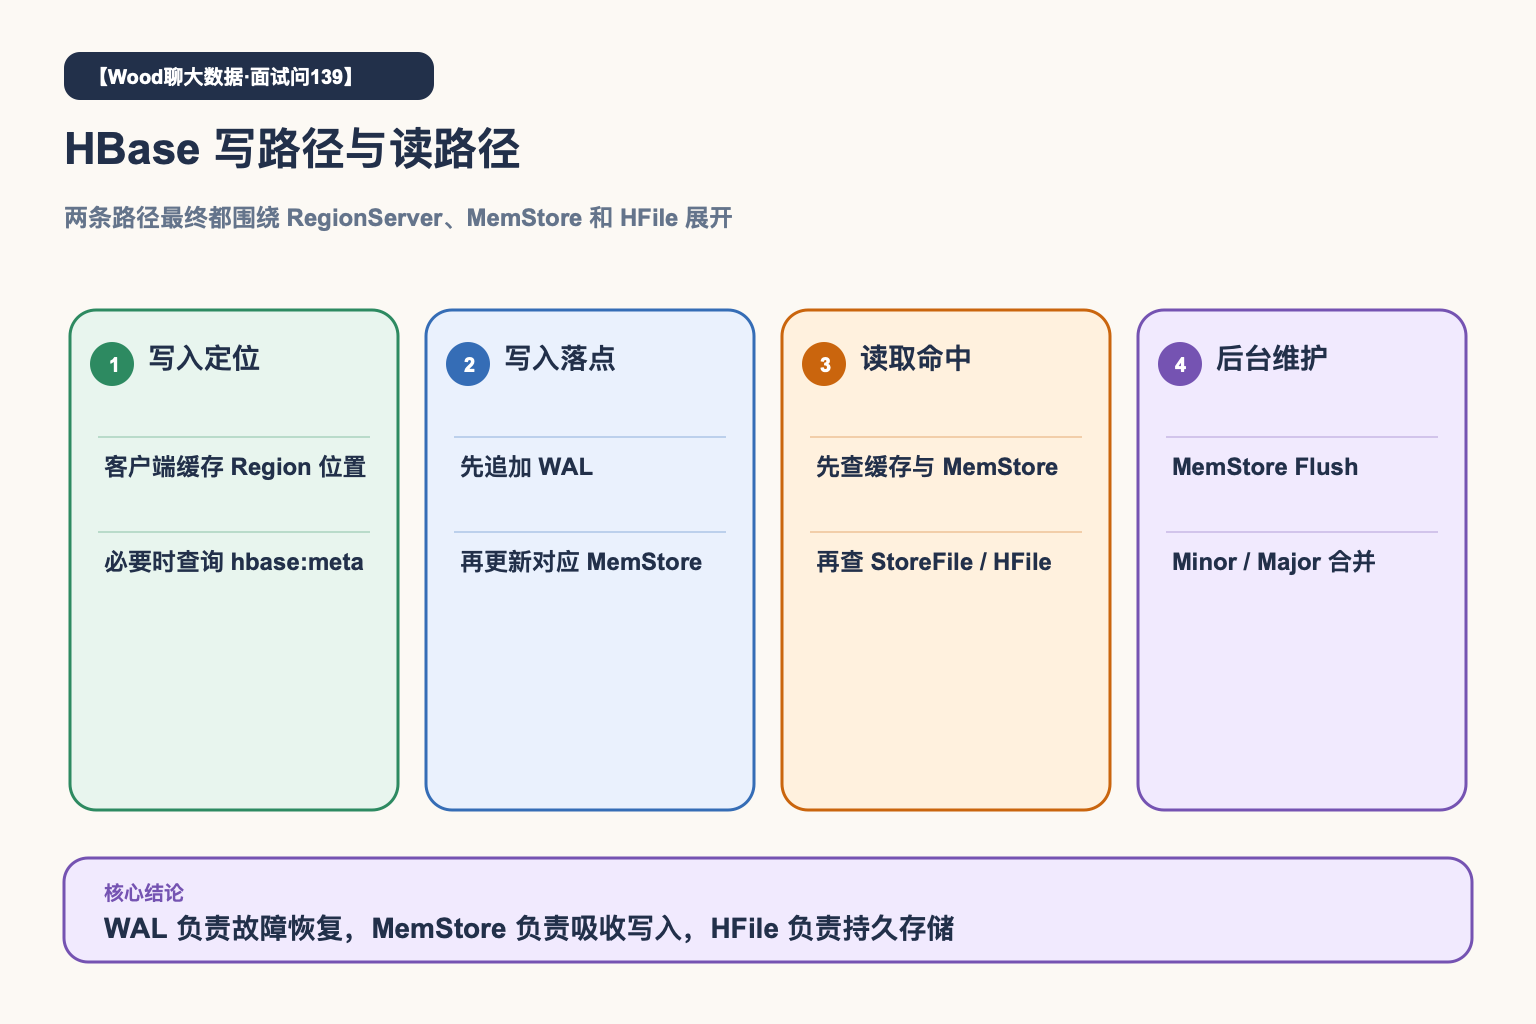
HBase 客户端先根据 RowKey 定位 RegionServer。写入时,RegionServer 先追加 WAL 以保证故障恢复,再写入对应 MemStore;MemStore 达到条件后 Flush 成 HFile。读取时会综合 MemStore、BlockCache 和 HFile 的结果,利用索引与 Bloom Filter 减少磁盘访问。后台 Compaction 负责合并文件和清理旧版本。排障时我会把客户端重试、WAL、MemStore、缓存命中、HFile 数量和 Compaction 队列连起来看。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
只记住“写 WAL、读 HFile”,还解释不了 HBase 为什么能快速写入,也解释不了为什么 HFile 变多后读延迟会升高。
真正的读写流程,要从 Region 定位、内存结构和后台 Compaction 一起看。
HBase 写入先通过 WAL 保证可恢复,再进入 MemStore;读取优先利用缓存和内存数据,未命中时再按索引访问 HFile。
第一步都是定位 Region
表按 RowKey 范围切分为多个 Region,每个 Region 由某个 RegionServer 提供服务。客户端会缓存 Region 位置;缓存失效时,再通过元数据定位并重试。
因此频繁 Region Split、Region 迁移或热点都可能增加定位与重试成本。
写路径:WAL 之后进入 MemStore
RegionServer 收到 Put 或 Delete 后,通常先把变更追加到 WAL,再更新对应 Column Family 的 MemStore。WAL 用于 RegionServer 故障后重放尚未 Flush 的数据。
写请求不需要立刻生成 HFile,因此可以先由内存吸收随机写。当 MemStore 达到条件后,后台 Flush 生成新的 StoreFile/HFile。
读路径:先查近处,再查持久层
读请求会结合 MemStore、BlockCache 和 HFile 中的数据返回最新可见版本。缓存命中可以减少 HDFS I/O;未命中时,HBase 利用索引和 Bloom Filter 等结构缩小需要读取的文件与数据块。
因为同一个 Cell 的不同版本可能散落在 MemStore 和多个 HFile 中,读取还需要按时间戳、删除标记和版本规则做合并判断。
Flush 和 Compaction 决定长期状态
Flush 只是把内存数据写成新文件,不会自动消除历史小文件。随着 HFile 增多,读放大和文件句柄压力会上升。
Compaction 会合并文件、清理满足条件的删除标记和过期版本,但同时消耗磁盘与 CPU。写得快不代表没有代价,只是把一部分工作移到了后台。
一个典型场景
某张表写吞吐正常,点查延迟却逐步升高。第一反应是 BlockCache 太小,但检查后发现单个 Store 下堆积了大量 HFile,Compaction 长期追不上写入。
缓存扩容只能缓解一部分读 I/O,根因仍然是文件数量和 Compaction 债务。最终需要同时检查 Flush 频率、HFile 大小、Compaction 队列和热点 Region。
读写流程不是两条孤立链路,后台文件维护会把写入压力传导到读取。