HDFS NameNode HA 是怎么实现的?
面试怎么回答
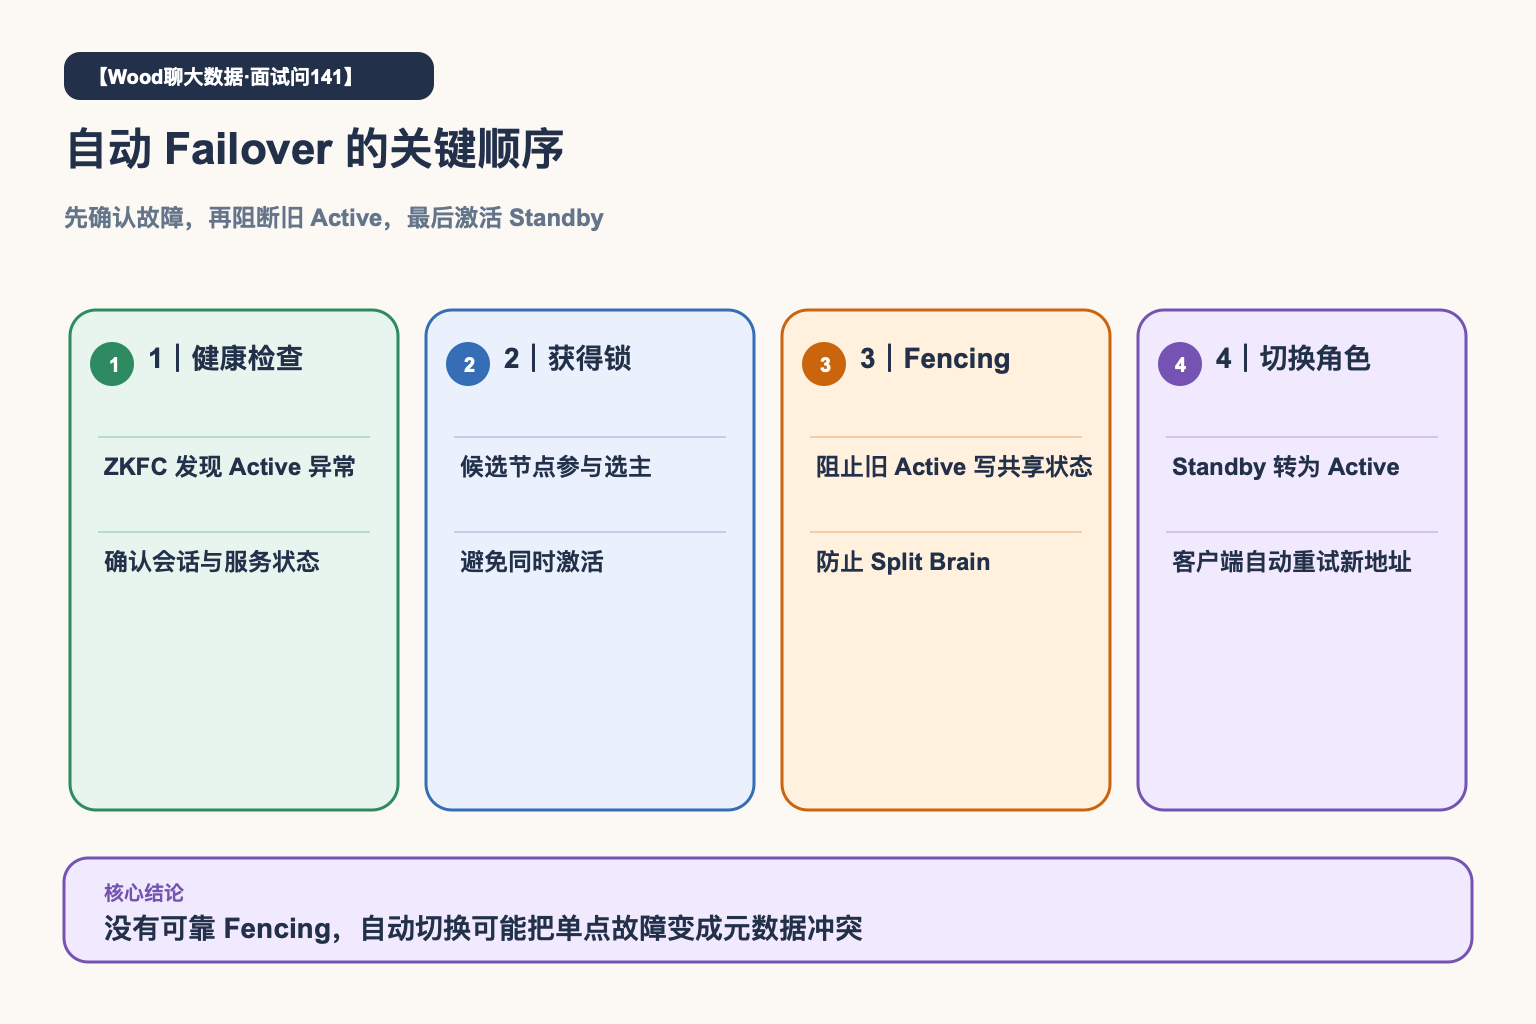
HDFS NameNode HA 采用 Active/Standby 模式。Active 处理元数据变更,并把 EditLog 写入 JournalNode 集群;Standby 持续读取 EditLog,同时接收 DataNode 的块信息。ZKFC 负责健康检查,并通过 ZooKeeper 协调自动 Failover。切换前必须 Fencing 旧 Active,防止双 Active。客户端使用 HA 逻辑名称自动切换。生产上我还会定期演练日志追平、切换耗时、Fencing 和客户端重试,而不是只确认两个进程都在。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
部署两个 NameNode,不等于已经实现高可用。
如果元数据没有持续同步、故障时没人做角色切换,或者旧 Active 仍能写入,共享存储反而可能出现更严重的问题。
NameNode HA 通常依靠 Active/Standby、共享 EditLog、自动故障转移和 Fencing 共同实现,核心目标是快速接管且不出现双 Active。
Active 和 Standby 不是双写服务
正常情况下只有 Active NameNode 对外处理会改变命名空间的客户端请求,Standby 保持热备状态。
Standby 要持续拥有接近最新的文件系统元数据,这样发生切换时才能快速接管,而不是从头重建整个命名空间。
共享 EditLog 保证元数据状态同步
常见方案使用 Quorum Journal Manager,把 Active 产生的 EditLog 写入一组 JournalNode。Standby 持续读取并应用这些编辑记录。
DataNode 还会向主备 NameNode 发送块信息,让 Standby 了解 Block 位置。否则即使命名空间同步了,接管后仍需要较长时间恢复块视图。

ZKFC 负责健康检查与自动切换
ZooKeeper Failover Controller 会监控本地 NameNode 健康状态,并借助 ZooKeeper 协调哪个节点可以成为 Active。
客户端配置逻辑名称和多个 NameNode 地址,发生 Failover 后通过重试与地址切换连接新的 Active。业务是否真正无感,还取决于超时和重试设置。
Fencing 是防脑裂的最后保险
网络分区时,旧 Active 可能只是与 ZooKeeper 失联,但进程仍在运行。如果新 Standby 已经被激活,而旧 Active 还能修改共享状态,就会形成 Split Brain。
因此切换前要通过 SSH、进程终止、存储隔离等手段 Fencing 旧 Active,确保它不能继续提供写服务。
一个典型场景
一次切换演练中,Standby 成功变成 Active,但部分客户端仍然长时间报错。检查后发现客户端只配置了单个物理地址,没有使用 HA 逻辑名称,服务端切换并不能让这些客户端自动发现新 Active。
另一些环境虽然配置了双节点,却没有验证 Fencing。真正故障时如果旧 Active 处于“假死”状态,风险比单节点不可用更大。
HA 要验证整条链路:日志同步、健康检查、选主、Fencing 和客户端重试。