HBase 热点问题怎么产生?如何解决?
面试怎么回答
HBase 热点是请求集中到少数 Region 或 RegionServer,常见原因是递增 RowKey、超级热点对象和 Region 分配不均。我会先用 Region 级指标确认热点位置,再分析 RowKey 与访问分布。治理上可以用固定 Salt、Hash 前缀、反转 ID、业务分桶和预分区,但要评估范围查询需要多桶扫描的代价。上线后还要持续观察 Region 请求量、Split、Flush 和 Compaction,不能把“加随机前缀”当成一次性答案。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
集群还有很多空闲节点,某一台 RegionServer 的写入却已经打满。
这通常不是机器数量不够,而是请求都落到了少数 RowKey 范围,增加节点也不会自动把热点拆开。
HBase 热点的本质,是访问量在 Region 维度分布不均;解决方案必须同时考虑写入打散和查询方式。
先确认热点发生在哪一层
可以先比较各 RegionServer 的请求量、写入吞吐、队列、Flush、Compaction 和延迟,再下钻到 Region,确认是单个 Region、少数 Region,还是整个节点磁盘异常。
如果只有一个 Region 请求量极高,扩容 RegionServer 基本无效;如果多个 Region 都集中在一台机器,还要检查 Region 分配是否均衡。
递增 RowKey 是最常见诱因
时间戳、连续订单号直接放在 RowKey 前部时,新数据会持续写入排序空间的尾部,在 Region Split 之前集中到一个 Region。
另外,某个超级用户、热门内容或固定租户也会形成业务热点。它们不一定来自递增键,而是访问频率本身极不均匀。
打散策略要服务于查询模式
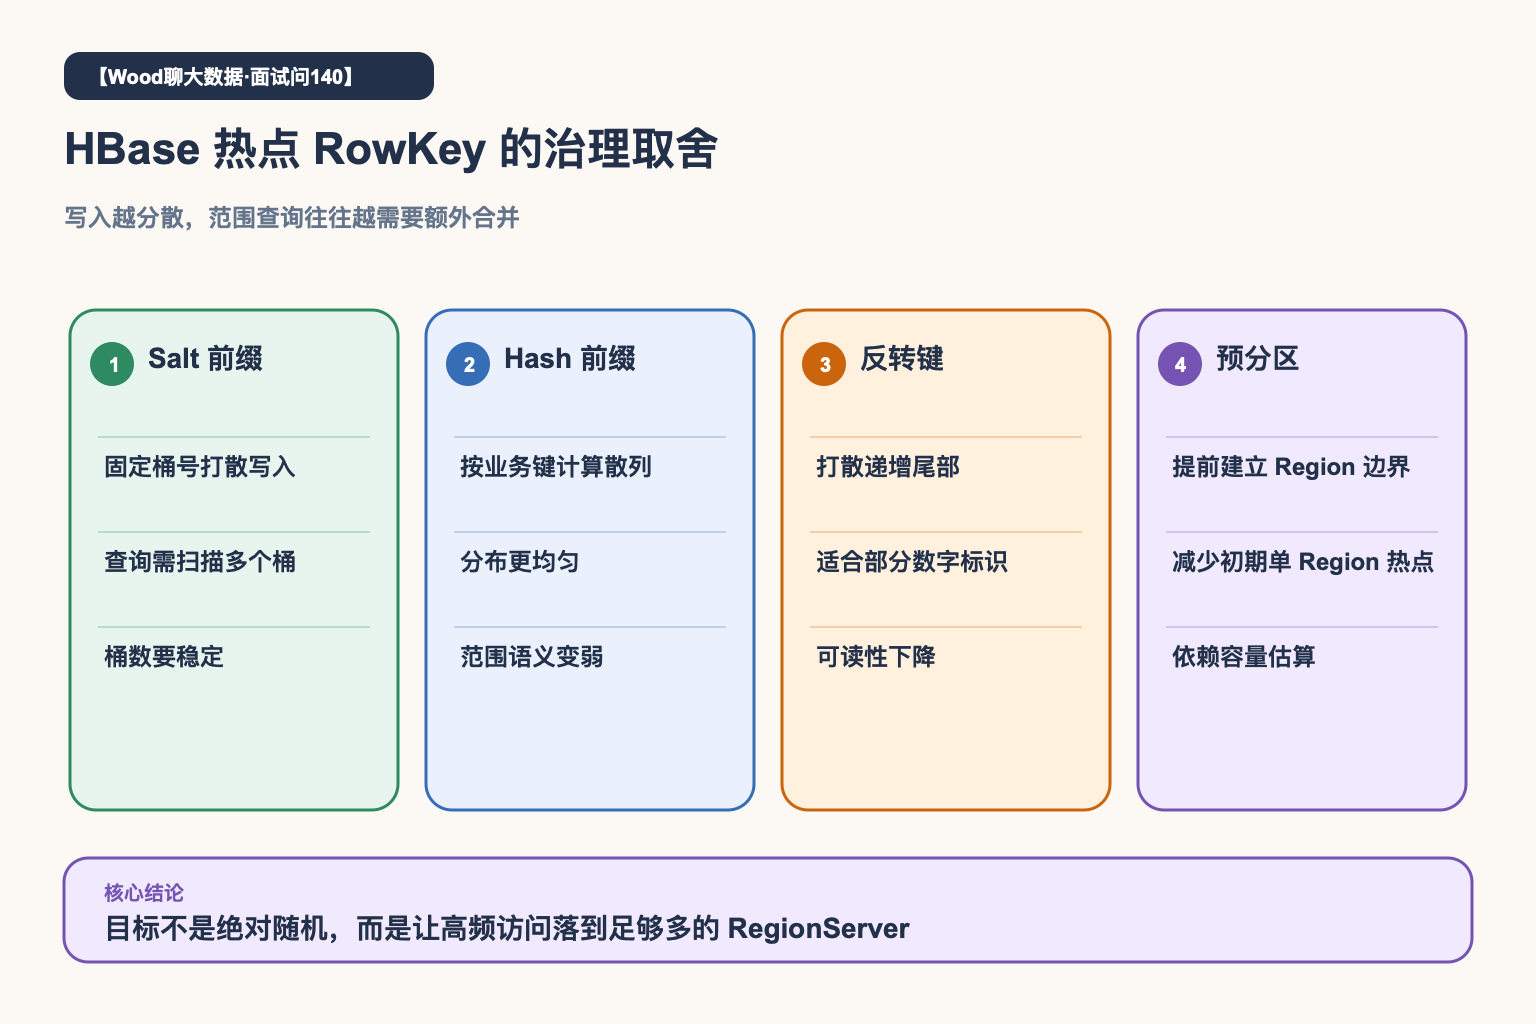
常见方案包括 Salt 前缀、Hash 前缀、反转递增 ID,以及把高频对象拆成多个逻辑桶。它们可以分散写入,但范围查询可能要同时扫描多个桶并在客户端合并。
因此不能只说“RowKey 加随机数”。完全随机会破坏局部性,也让查询范围和数据迁移难以控制。更合适的是固定、可计算、可枚举的桶规则。
预分区解决冷启动,不替代长期治理
新表只有少量 Region 时,即使 RowKey 最终均匀,初期也可能集中写入。根据前缀桶或范围提前 Split,可以让数据一开始就分布到多个 RegionServer。
但预分区数量过多会带来元数据和调度成本。上线后仍要监控 Region 大小、请求量、Split 和 Compaction,判断原来的分布假设是否仍然成立。
一个典型场景
一张行为明细表把毫秒时间戳放在 RowKey 最前面。所有最新事件都写到最后一个 Region,单节点延迟持续升高,而其他节点利用率很低。
简单增加 RegionServer 后问题没有改善。把 RowKey 调整为固定 hash 桶 + 业务时间 + 用户标识,并按桶预分区后,写入才真正分散;查询侧则根据桶数并发扫描再合并结果。
热点治理的代价通常会转移到查询端,设计时必须把两端一起算。