HDFS 支持追加,为什么不能像数据库一样随机修改文件?
本文目录
面试怎么回答
我会区分HDFS文件追加和业务行更新。HDFS面向大文件顺序访问,同一文件严格单写者,追加或截断不等于任意位置覆盖;Parquet等格式还有自身元数据结构,不能按文本行直接改。需要更新时,可重写受影响文件或使用支持增量与删除语义的湖表格式;高频随机点更新则评估数据库。还要设计并发提交和读者可见性,不能只看到append接口就认为已经具备事务更新能力。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一份文件里某个订单金额错了,能不能找到那一行,直接把100改成90?如果这是HDFS上的Parquet文件,答案不能从“支持append”直接推出来。追加是在尾部继续写,而这次需求是修改已有记录,连文件格式和提交方式都变了。
追加改变文件尾部,不等于随机更新已有字节;行级更新需要上层组织新版本、索引与提交语义。
三种写入动作,不要用一个“修改”概括
追加是在文件尾部写入新内容,截断缩短文件长度,随机覆盖则是在已有位置替换字节。这些动作有不同的一致性与存储要求。
HDFS面向大规模顺序读写,官方架构文档说明文件采用写一次语义,并支持追加和截断等例外,同一时刻严格只有一个写者。
这不意味着文件永远不可变化,也不意味着它像普通数据库一样支持任意记录原地更新。讨论能力时,必须把具体动作说清楚。
文件写者与业务并发,不是同一个层次
多个任务可以分别写不同文件,再由上层组织成一张表;这并不等于多个客户端可以同时随意修改同一文件。
客户端异常退出后的写入恢复,也有文件系统自己的协调过程。业务不能假设连接断开后立刻开启另一个写者,就一定可以无冲突接着写。
更重要的是,文件系统维护的是字节与命名空间,不知道哪一行代表订单A,也不知道金额调整是否需要同时修改汇总表。业务事务必须由上层协议负责。
Parquet不能当成一行一条的文本文件
Parquet包含行组、列块和文件元数据,记录的各列并不一定相邻存储。找到订单号,也不等于能在原文件某个连续文本位置直接替换金额。
如果改动涉及编码、压缩或列块长度,相关布局和元数据都可能需要变化。向尾部随便追加一段新行字节,也不自动形成合法的Parquet新版本。
因此即使底层文件系统支持append,某种表格式或写入器也可能采用生成新文件再提交的方式。文件系统能力和数据格式能力不能互相代替。
一个典型场景:追加“修正记录”后查询仍有旧值
比如为了更正订单,任务不重写旧数据,而是在目录里追加一条新记录。查询简单扫描所有文件,结果同时出现旧金额100与新金额90。
最初怀疑文件缓存未刷新,实际上两个版本都真实存在。根因是把“保存一条更新信息”当成“所有查询都会应用更新语义”。
旧验收只检查新文件写入成功,没有验证读取端如何识别版本、删除或覆盖关系。修复应明确唯一键、版本顺序和上层更新机制,或者重写受影响数据并受控发布。
不能只在某张报表加取最新逻辑就认为全表更新完成。其他消费者如果仍然普通扫描,仍会看到重复或旧值。
根据更新形态选择方案
少量离线更正可以重写受影响文件或分区,但要控制影响范围与并发写入,避免更正旧日期时覆盖其他新结果。
湖表格式可以通过新数据文件、删除信息及元数据提交组织行级更新语义,具体机制因格式与执行引擎而异;它不是让HDFS突然获得随机行覆盖。
高频低延迟点更新,则应评估具备相应能力的数据库或键值系统,同时考虑查询、吞吐、成本和一致性要求。
验收要包含读者看到什么
写入成功后,应确认新读者读取哪个版本、在途读者是否仍可完成,以及失败时有没有半成品被当成正式文件读取。
跨文件、跨表更新也不会因为底层某个重命名操作成功就自动变成整体事务。需要发布版本或上层事务协议建立一致视图。
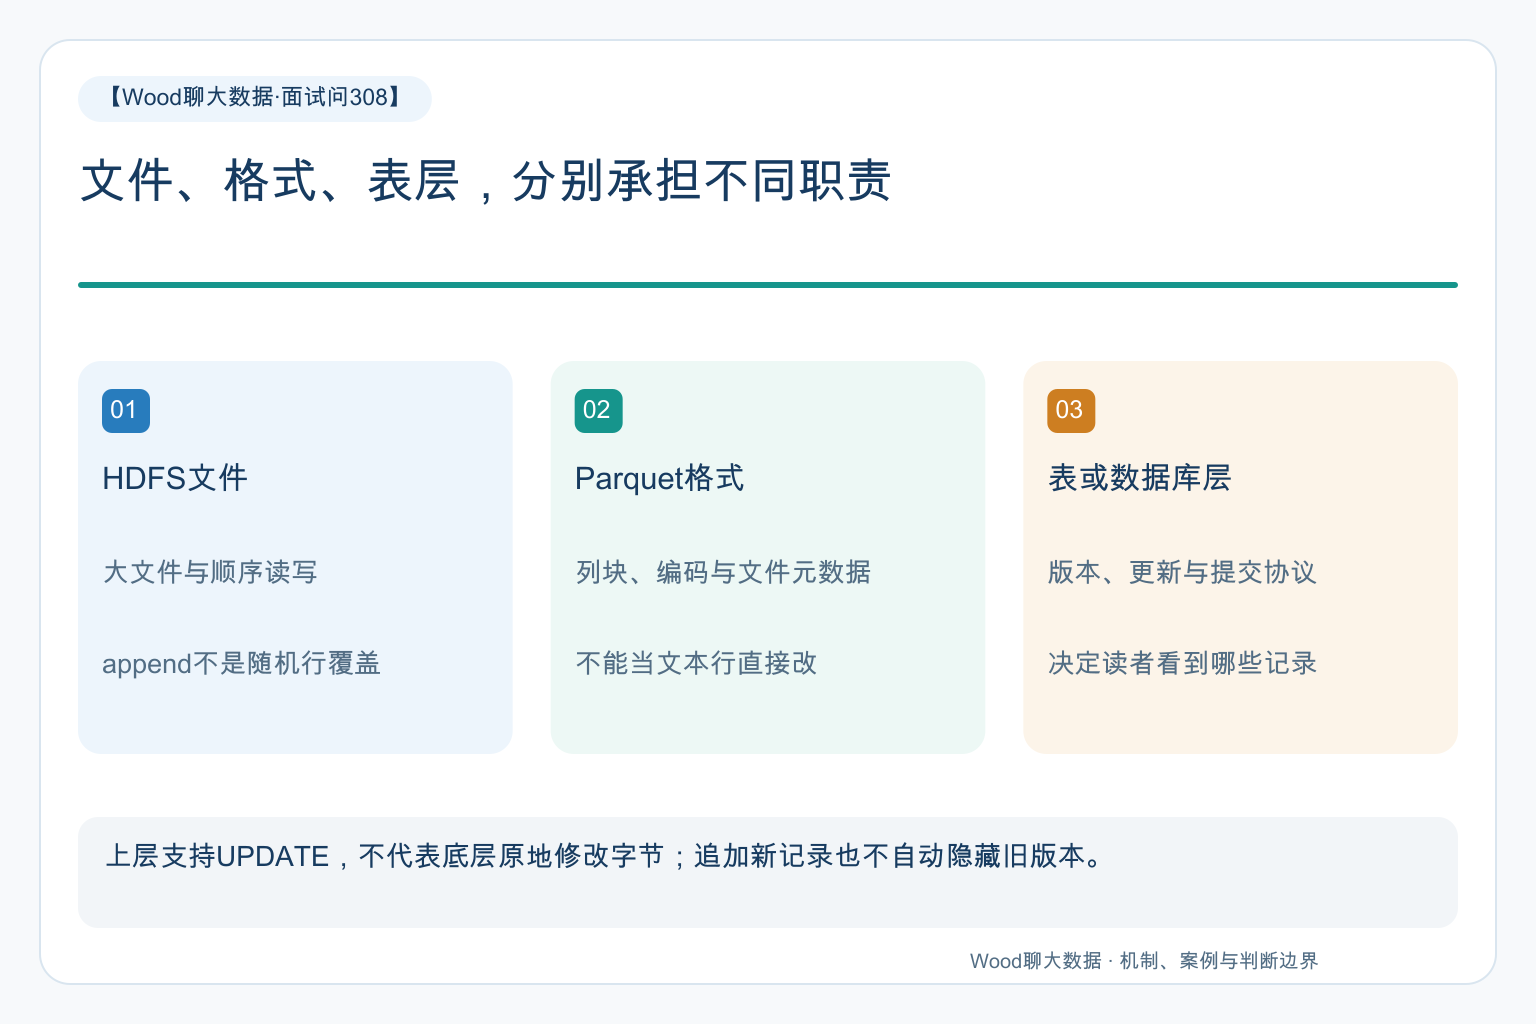
这道题的核心是认清层次:HDFS负责文件存储,格式负责记录布局,表层负责更新和提交。上层能执行UPDATE,不代表底层在原地改了一行字节。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。