Hive 动态分区怎么写?为什么分区太多会拖慢任务?
面试怎么回答
Hive 动态分区是把查询输出的分区列值映射为目标分区,经典显式写法要求动态列放在 SELECT 末尾并与 PARTITION 顺序一致。严格模式至少要有一个静态分区,但静态目标值不替代源数据过滤。分区过多会增加文件、写入器和元数据压力。我会先预检分区基数和异常值,再限制批次范围、优化分布与文件大小,并验证覆盖或追加的重跑语义。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
任务提示动态分区超限,有人把限制调高,任务终于往下跑了,却开始在写文件和提交阶段耗很久。参数放开了,问题真的解决了吗?这道题要讲清楚的,是数据如何变成分区,以及一次写入到底摊开了多大范围。
动态分区把输出列值变成分区路径;写入范围、分区基数和文件数量要一起控制,限制开关不是优化方案。
动态分区不是自动找到正确的数据范围
静态分区是在语句里给出固定分区值;动态分区则从查询输出里取得值,映射到目标分区。
下面使用 Hive 经典显式动态分区写法。假设目标表的普通列依次为 event_id、user_id,分区列依次为 dt、country:
SET hive.exec.dynamic.partition = true;
SET hive.exec.dynamic.partition.mode = strict;

INSERT OVERWRITE TABLE dwd_event
PARTITION (dt = '2026-09-01', country)
SELECT event_id, user_id, country
FROM ods_event
WHERE dt = '2026-09-01';
dt 是固定值,country 来自结果列。动态分区列放在 SELECT 末尾,并与 PARTITION 中动态列的顺序一致。这是显式写法的列位置映射,不能只靠别名相同就认为不会写错。
不同 Hive 版本和平台可能提供自动推导能力,生产使用前仍应核对目标环境。文章示例用于解释语义,不是让大家直接对线上表执行覆盖。
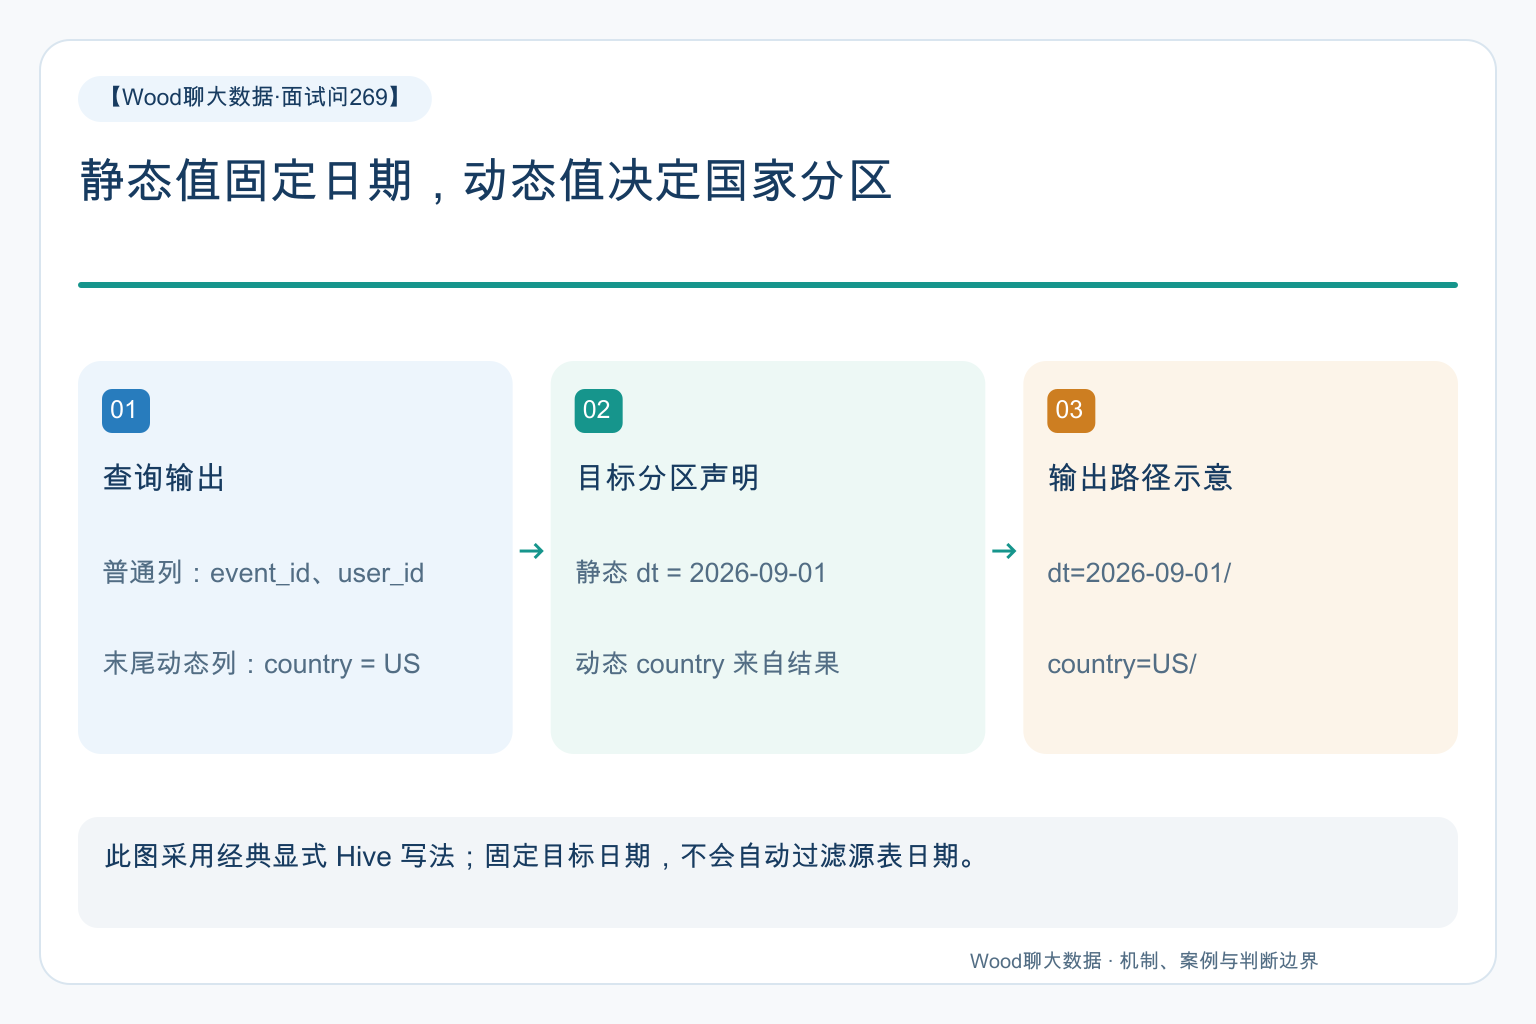
有静态分区,不等于源表已经过滤
strict 模式要求至少有一个静态分区。它限制的是目标动态写入范围,不会自动给源查询补上 WHERE 条件。
假如忘了示例里的源表日期过滤,其他日期的数据也可能被写入固定的目标日期。任务仍然成功,甚至只有一个日期目录,但业务日期已经混进去了。
因此我会分别检查:源数据取哪一批,目标允许落到哪些分区。两者是独立约束,不能用“目标写的是昨天”来证明“源数据只有昨天”。
验收也不只是看目标目录是否存在,还要核对记录所属日期、分区内行数,以及业务键和关键指标。
分区多,代价为什么会扩散?
动态分区字段的不同值数量越大,潜在输出分区就越多。若大量写入任务都接触许多分区,可能产生更多写入器和文件,随后还要处理文件提交与分区元数据登记。
这不是“分区数量等于文件数量”的固定公式。执行引擎、数据分布、文件滚动和合并策略都会影响结果,但高基数带来的压力不会因为提高上限就消失。
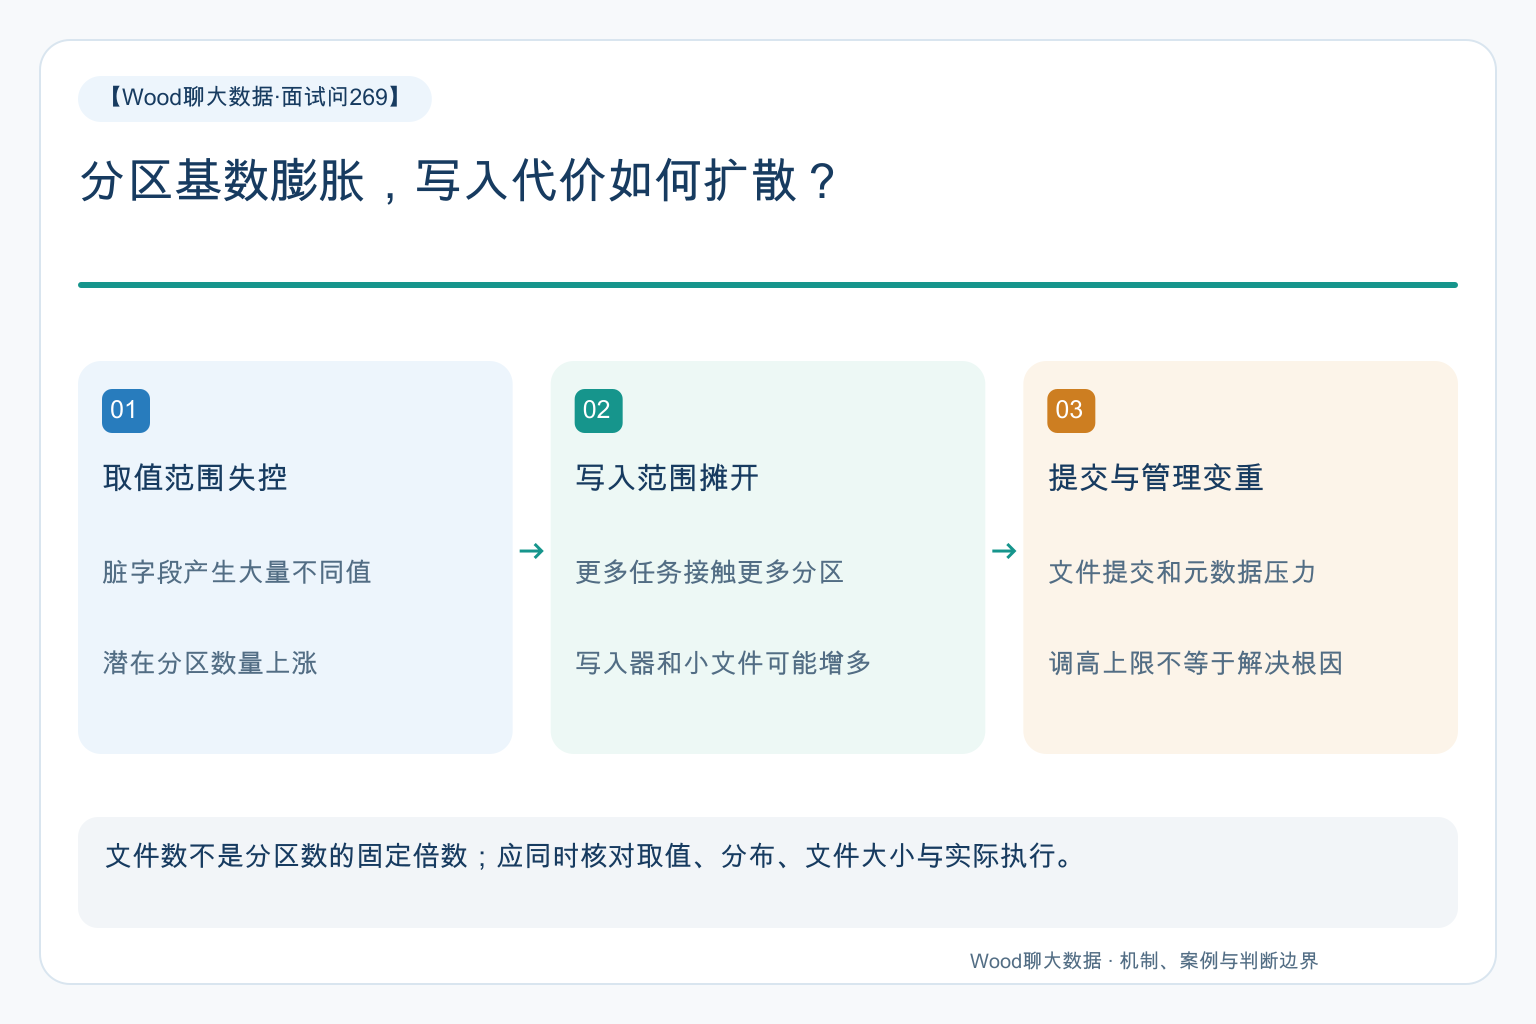
因此要同时看分区数、每个分区的数据量、文件数与文件大小分布。总共只有几百万行,也可能散成很多非常小的分区;只看输入规模会误判任务很轻。
用户 ID、精确时间戳这类高基数字段,更不应该未经访问需求评估就直接拿来作为目录分区键。
一个国家字段引出的分区爆炸
看一个示例:原本 country 只有几十种值,某天却出现大量动态分区,任务报超限。团队先提高参数,错误消失了,提交阶段却变得更慢。
追查发现,上游部分记录把请求标识拼进了国家字段。同一个国家被写成许多不同字符串,文件和分区数量一起膨胀。
旧检查只对总行数和金额做了校验。脏值并没有改变总行数,也没影响金额求和,所以全部通过。第一次修复只是允许错误摊得更大,并没有纠正分区字段。
新的规则应在写入前检查不同值数量、取值合法性和异常占比,并保留异常样本。无法解释的值先隔离,不能无条件创建新分区,也不要随意改成正常国家码。
空值同样要明确处理策略,避免大量记录进入默认分区后被忽略。默认目录名和具体行为,应以当前平台配置为准。
优化顺序与重跑语义
我的顺序是先治理字段,再控制批次和分区范围,接着结合执行引擎优化分布及文件大小,最后才讨论合理上限。必要时分批发布,但仍要保留批次间可核对的范围。
还要问清楚 INSERT OVERWRITE 和 INSERT INTO 的选择。追加重跑可能产生重复;动态覆盖也不能想当然地理解成“这一天所有历史子分区都会清空”。
本批没有生成的分区、零输出场景和历史残留,必须在目标版本里验证。比较稳妥的是事先列出预期分区,写后核对实际分区、行数和残留范围,再让下游使用。
面试官真正想听的,不是你能背几个限制参数,而是你能否让一次动态写入有边界、可验收、可安全重跑。