HBase BulkLoad 为什么比批量 Put 快?导入成功就算验收通过吗?
面试怎么回答
我会先说明BulkLoad预生成HFile,再让RegionServer装载,与逐条Put路径不同。导入前核对RowKey排序、列族、Region边界和Cell时间戳,导入后验收关键行、聚合与实际读者结果。还要确认跨集群复制支持和配置,以及重复导入的语义,不能把命令成功等同于整张表一次性原子发布。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同样是一批历史数据,一种方案不断发Put,另一种先生成HFile再导入。后者快,并不只是因为“批量更大”,而是它把很多工作换了一条路径完成。
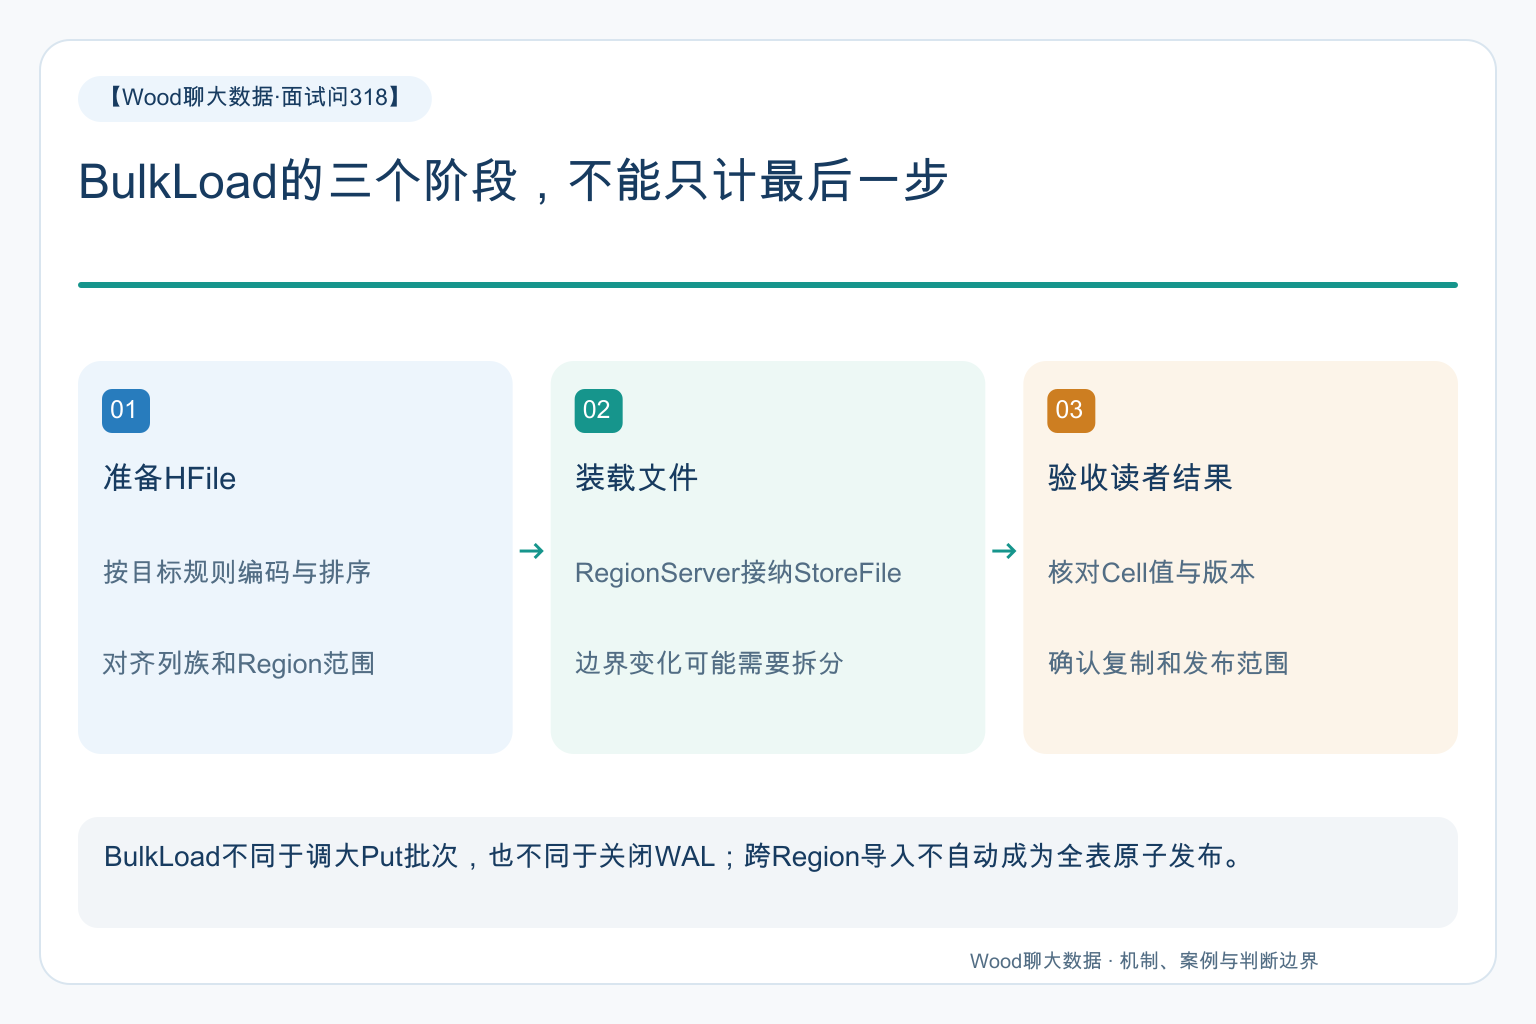
BulkLoad通过预生成并装载HFile改变写入路径;验收还要覆盖RowKey、Cell版本、Region边界和实际读者可见结果。
快,首先因为改变了写入路径
普通Put通过客户端向RegionServer提交变更,走在线写入的相关处理流程。BulkLoad则先把数据组织成HBase内部使用的StoreFile,也就是HFile,再把这些文件装载到运行中的集群。
它把数据整理工作前置,减少逐条在线写入带来的请求与处理开销。官方文档描述了预生成文件与装载两个阶段,而不是简单把一批Put包得更大。
但生成HFile本身也需要读取、排序和写文件。评估耗时应该覆盖准备与导入的全流程,不能只统计最后那个导入命令的运行时间。
HFile不是任意排序的文本文件
需要按HBase要求组织RowKey、列族和Cell顺序,并根据目标表Region范围划分输出。应使用相应版本支持的生成工具和API,而不是凭经验手工拼出一个“看起来有序”的文件。
准备期间Region边界可能变化。文档说明,装载工具可以按新的边界拆分文件,但这会增加额外工作,因此准备完成到正式导入之间的变化也要纳入评估。
列族配置、压缩方式和数据类型编码要与读取方式一致。数字按字符串编码还是二进制编码,会影响RowKey顺序和范围扫描结果;行数正确并不能证明查询区间正确。
时间戳会改变哪一版数据可见
HBase的Cell版本与时间戳有关。历史导入若统一使用导入当天时间,可能把老值放到较新的版本位置;若使用很旧的时间戳,又要核对TTL和版本保留规则下的可见性。
重复导入也不能只问“会不会多一行”。同一RowKey、列族、限定符与时间戳的组合,以及不同时间戳产生的版本,可能导致不同结果,需要在测试表验证目标写入语义。
不要把BulkLoad等同于关闭WAL的Put。两者是不同路径;HBase还有BulkLoad相关事件与复制机制,不能笼统断言导入完全没有日志、必然无法复制,或者只关WAL就能获得同等保证。
装载完成,不代表所有读者同时看到新版本
跨Region导入不能直接被当作整张表的全局原子切换。若业务要求读到完整批次,应考虑先在隔离目标完成导入与验证,再通过适合当前系统的发布方式开放读取。
跨集群复制还要核对版本支持、BulkLoad复制开关及相关文件访问配置。正常Put复制已运行,不足以证明本次HFile也会按预期到达目标端。
这里不建议照抄生产命令直接操作。源文件、目标表、权限、复制拓扑和回退路径都应先确认,再做小范围验证。
一个典型场景:主表成功,查询却缺历史记录
假设导入命令完成,扫描也能找到目标RowKey,但业务读取默认最新版本时,拿到的仍然不是期望值。团队最初怀疑缓存没有刷新。
逐个检查Cell时间戳后,发现历史导入值的版本顺序与业务预期相反;另一些旧时间戳还触发了保留规则。旧验收只按RowKey检查是否存在,没有对比限定符与实际返回版本,因此漏掉问题。
修正时明确每个字段的版本时间来源,使用小表覆盖新旧版本交错、重复导入与过期数据,再按实际查询接口核对字段值。若有复制端,还要在复制端执行对应验收。
吞吐提高是选择BulkLoad的理由,结果可解释才是完成交付的证据。把准备、导入、读取和复制四个阶段说清楚,才算回答了“为什么快,以及快完之后怎么保证对”。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。