HDFS 纠删码和三副本怎么选?
面试怎么回答
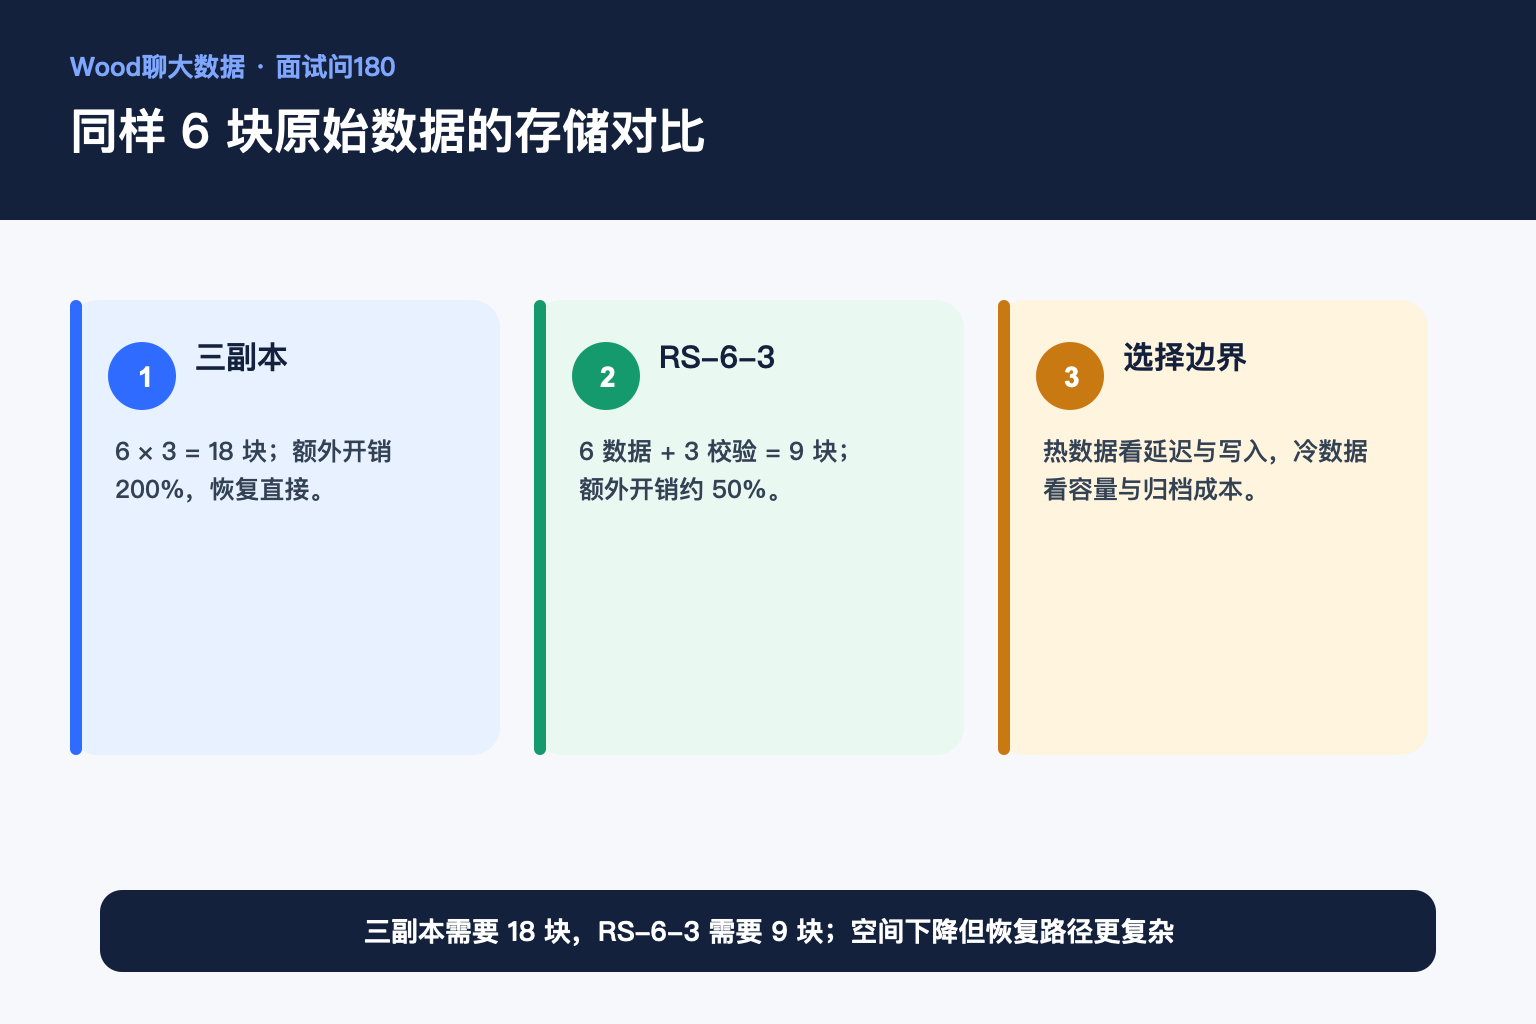
三副本保存完整副本,读取和故障恢复简单,但有 200% 额外空间开销;纠删码例如 RS-6-3 用 6 个数据块加 3 个校验块,额外开销约 50%,代价是编码解码、跨节点读取和恢复更复杂。我会让热数据、频繁写和低延迟数据保留副本,把稳定冷数据迁到纠删码,并评估节点数、机架、网络和版本功能限制。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
冷数据占满了 HDFS,直接把三副本改成纠删码,空间问题看起来立刻解决。
但当节点故障、任务随机读或文件频繁追加时,省下来的磁盘可能会换成 CPU、网络和功能限制。
三副本用空间换简单恢复与读性能,纠删码用数据块加校验块降低存储开销,但增加计算、网络和运维要求。
三副本为什么简单但昂贵
HDFS 默认三副本保存三份完整数据,存储开销是原始数据的三倍,也就是额外 200%。读取可以就近选择一个健康副本,单块损坏时从另一副本直接复制恢复,路径简单,适合热数据和频繁读写。
纠删码如何降低空间开销
以 RS-6-3 为例,每个条带包含 6 个数据块和 3 个校验块,9 个内部块可以容忍最多 3 个块缺失。6 份原始数据只占 9 份空间,额外开销约 50%,明显低于三副本的 200%。
省空间为什么会增加计算和网络
纠删码写入要编码校验块,故障恢复要从多个 DataNode 并行读取幸存块并解码,带来额外 CPU 与跨机架网络。集群还必须满足条带宽度和机架容错要求。随机小范围读取、重建高峰和网络不足都可能放大延迟。
策略按目录生效,不会自动改写旧文件
HDFS 纠删码策略通常设置在目录上,新文件创建时继承。修改目录策略不会自动转换既有文件,转换需要重写数据。某些追加、截断、hflush 或 hsync 语义也受限制,使用前要结合当前 Hadoop 版本核对。
一个典型场景
近 30 天明细供高频查询和补数,保留三副本;半年以前的稳定归档几乎只在审计时扫描,可以迁移到纠删码目录。不要把正在持续追加的实时落地文件直接切换,而应在文件封存后通过受控重写迁移,并监控重建带宽。
参考资料
- Apache Hadoop HDFS Erasure Coding:https://hadoop.apache.org/docs/current/hadoop-project-dist/hadoop-hdfs/HDFSErasureCoding.html