HBase Scan 为什么慢?Filter、Caching 和 Batch 怎么配?
本文目录
面试怎么回答
HBase Scan 我会先看 RowKey 起止范围,再收窄列、时间与版本;Filter 可以减少返回,但不一定减少底层扫描。Caching 控制 RPC 取行批量,Batch 控制单次 Result 的 Cell 数,可能出现部分行。调参结合行宽和客户端能力,并验证扫描量、RPC、缓存影响与结果完整性,一次性大扫描还要控制并发和缓存填充。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同样从 HBase 返回一百条记录,一个查询很快,另一个却扫了半天。结果条数相近,为什么服务端开销能差这么多?要先看 Scan 到底经过了多大的 RowKey 范围。
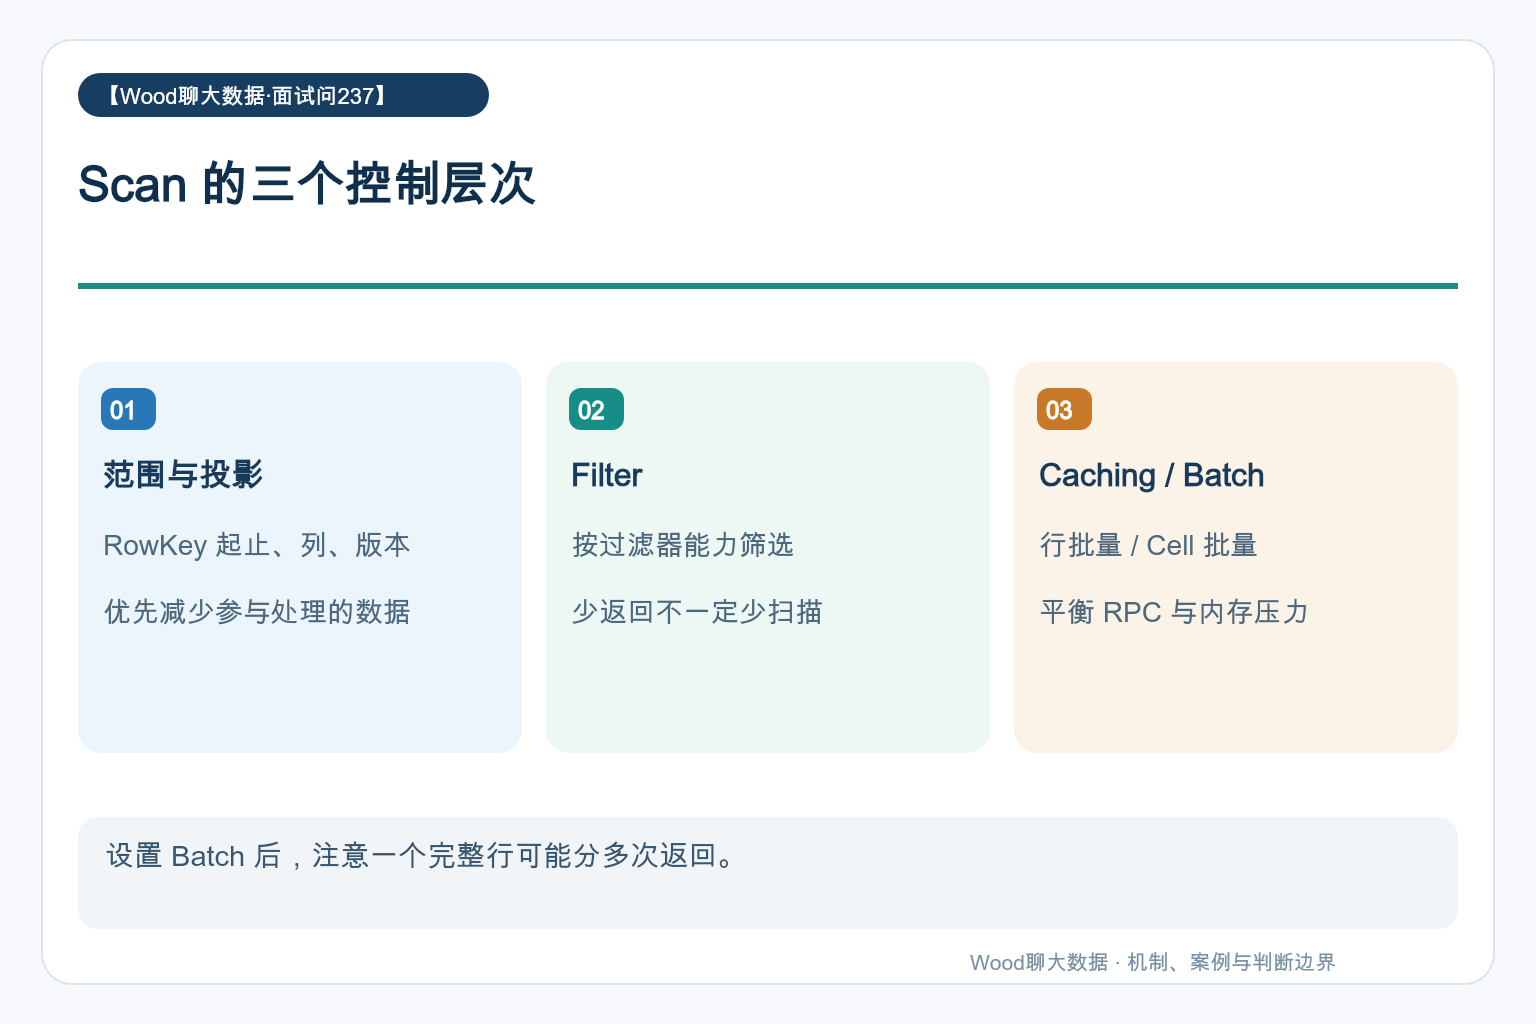
Scan 优化先收窄 RowKey、列和版本范围,再评估服务端过滤与 RPC 批量;返回少不等于扫描少,Caching 与 Batch 控制的对象也不同。
决定扫描量的第一层是 RowKey 范围
HBase 按 RowKey 组织数据,明确 start row、stop row 或可定位的前缀,有机会避免遍历无关区域。常用范围采用包含起点、不包含终点的语义,具体 API 也可能提供包含性参数,要按版本确认。
如果业务总按某个非 RowKey 字段查,却每次都扫描全表再过滤,应重新评估 RowKey、索引表或分析系统。给 Scan 调几个批量参数,无法把缺失的访问路径凭空补出来。
Filter 通常减少返回,但能力并不完全相同
服务端 Filter 可以在结果发回客户端之前筛除记录,减少网络和客户端处理量;某些过滤器还能利用定位提示跳过范围,但不能假设所有值过滤都等同于索引查找。
同时指定必要列族、Qualifier、时间范围和版本数,能够减少无用数据读取与处理。查最新值却允许返回大量历史版本,或者只需一个字段却读取所有列族,都会把成本扩大,尤其是宽行与大值场景。
Caching 和 Batch 不是同一个批量开关
Scan Caching 主要影响一次 RPC 希望获取的行数,实际响应仍受大小等限制;Batch 关注一次 Result 返回的 Cell 数,可能让一行拆成多个部分结果。客户端必须正确理解并处理这些结果形态。
Caching 太小会增加 RPC 次数,太大可能提高内存和单次等待。Batch 也不能无视过滤器与客户端兼容限制。调参应该结合行宽、Cell 数、扫描速度和客户端消费能力,没有适用于所有表的固定最佳值。
一个典型场景:返回不多却拖慢在线查询
比如离线导出扫描整表,Filter 最后只留下少量行,导出看起来结果很小,却让同集群点查延迟升高。最初怀疑 Region 热点,指标显示是大量扫描挤占磁盘与缓存。
原监控只统计返回条数,没有统计扫描与过滤规模。优化时先限制范围和列,对于一次性大扫描评估不填充 BlockCache,并控制导出并发;这不会消除磁盘竞争,但可以降低对热点缓存的污染。
验收需要同时观察客户端与 RegionServer
客户端记录总扫描时长、RPC 次数、批次体积和消费停顿;服务端观察请求延迟、磁盘读取、缓存命中及 Region 负载。扫描器要及时关闭,长时间不继续拉取还可能触发租约或超时问题。
最后用相同的 RowKey 范围和数据版本比较改前改后结果,尤其验证一行被拆成部分结果时有没有漏列或重复计行。性能调优不能只让 RPC 变少,还必须确保完整行语义和线上服务影响可控。