HBase WAL 和 MemStore 如何保证写入不丢?
本文目录
面试怎么回答
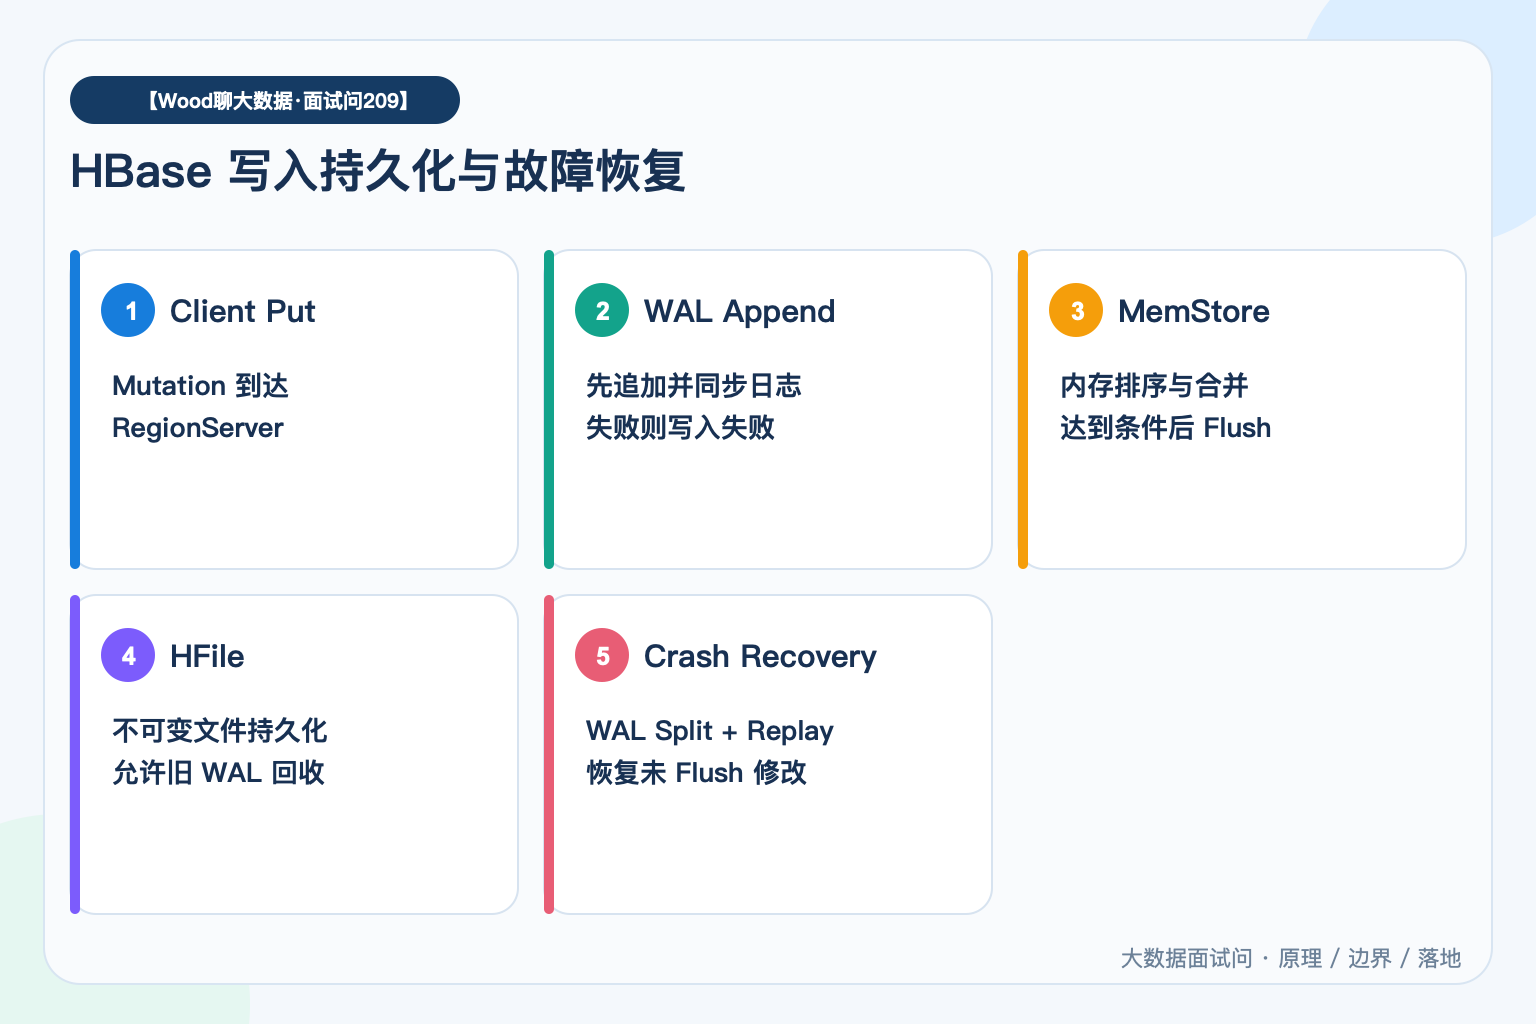
HBase 写入采用 WAL Ahead:Mutation 先追加并同步到 WAL,再进入 MemStore;MemStore 只是内存缓冲,之后 Flush 成 HFile。如果 RegionServer 在 Flush 前宕机,Master 会重新分配 Region,并通过 WAL Split 和 Replay 恢复未落盘修改。Flush 完成后,相应 WAL 才能回收。若使用 SKIP_WAL 等低 Durability 配置,这个保证会被削弱。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
Put 已经返回成功,但数据还在内存里的 MemStore,没有 Flush 成 HFile。此时 RegionServer 突然宕机,数据为什么还能恢复?
关键是写入先进入持久化 WAL,再进入 MemStore;WAL 成功与否决定这次修改能否对客户端确认。
HBase 先把 Mutation 追加到 WAL,再更新 MemStore;未 Flush 数据在 RegionServer 故障后可通过 WAL Split 与 Replay 恢复,Flush 后旧 WAL 才能安全回收。
写路径遵循 Write Ahead
RegionServer 接到 Put 或 Delete 后,先将 Mutation 追加到 WAL,再写入对应 Store 的 MemStore。WAL 写入失败时,修改操作应失败,不能先告诉客户端成功。这样即使内存状态丢失,持久日志仍保留重放依据。
MemStore 为什么还需要存在
直接把每次随机写都落成 HFile 成本很高。MemStore 在内存中按 Key 排序并合并修改,达到阈值或触发条件后批量 Flush,生成不可变 StoreFile。它提升写入吞吐,但本身不是最终持久化保障。
RegionServer 宕机后怎么恢复
Master 发现 RegionServer 失联后,相关 Region 会重新分配。故障节点的 WAL 被拆分为各 Region 可重放的 Edit,新 RegionServer 在打开 Region 时 Replay,把未 Flush 的修改重新写回 MemStore,随后正常对外服务。
Flush 决定 WAL 的可回收边界
当一个 Region 的 MemStore 成功 Flush 到 HFile 后,对应早期 WAL Edit 已有持久副本。只有当某段 WAL 中涉及的所有 Region 修改都已安全落盘,它才可以归档或清理。大量 Region 长时间不 Flush 会拖住 WAL 回收。
Durability 配置会改变保证
默认持久化语义优先保证数据安全;若使用 SKIP_WAL 或降低同步级别,可能换取延迟和吞吐,但 RegionServer 故障时存在丢失未 Flush 数据的风险。不能只记“WAL 保证不丢”,还要确认写请求实际使用的 Durability。
监控要串起整条链路
关注 WAL append/sync 延迟、WAL 数量与大小、MemStore 使用率、Flush 队列、Blocked Updates 和 Replay 时间。若 WAL 持续增长,可能不是日志本身有问题,而是 Flush、磁盘或 Compaction 跟不上。
参考资料
- HBase RegionServer WAL:https://hbase.apache.org/docs/architecture/regionserver/#write-ahead-log-wal
- HBase Regions and MemStore:https://hbase.apache.org/docs/architecture/regions/