HDFS Block 越大越好吗?文件、Block 和 InputSplit 有什么区别?
面试怎么回答
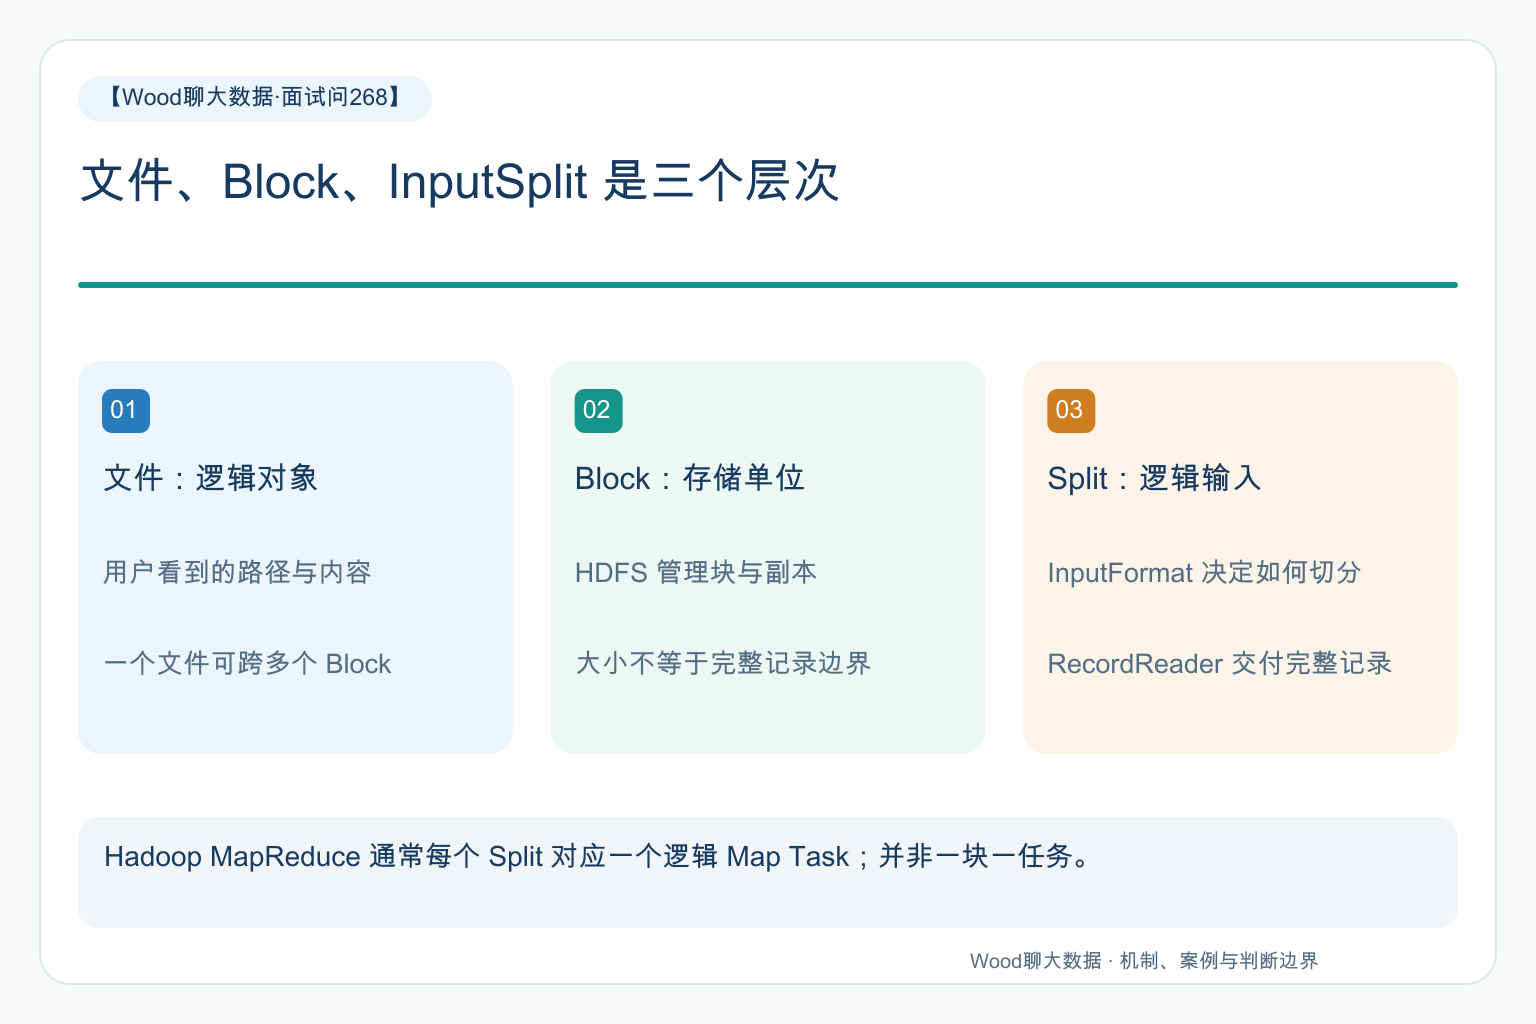
我会分成三层:文件是用户看到的逻辑对象,Block 是 HDFS 的存储和副本管理单位,InputSplit 是 InputFormat 为 MapReduce 生成的逻辑处理范围,通常一个 Split 对应一个 Map Task。两者常有关联但不是固定一比一,格式、压缩和切分策略都会影响。RecordReader 再处理完整记录边界。Block 大小要平衡元数据与计算粒度,不能认为越大越好或能自动合并小文件。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
文件是逻辑数据对象,Block 是存储单位,InputSplit 是计算切分;三者相关,但不能画等号。
先把三个层次拆开
文件是用户看到的逻辑对象,比如一个日志文件;Block 是 HDFS 管理存储和副本的单位;InputSplit 是 MapReduce 输入侧划出的逻辑处理范围。
Split 通常记录范围及位置信息,不是把对应数据再复制一份。框架根据这些信息安排读取,并尽量利用数据位置,减少不必要的网络传输。
假设一个文件是 300 MiB,写入时指定 Block 大小为 128 MiB,可以形成三个数据块。但这只能说明存储块数量,不能脱离输入格式直接宣布最终有三个 Map Task。这里的大小只是演示条件,不是给所有集群下默认值结论。
谁决定计算怎么切?
在 Hadoop MapReduce 里,InputFormat 负责生成 InputSplit,通常每个 Split 对应一个逻辑 Map Task。文件格式、压缩方式以及切分配置,都会影响它如何产生 Split。
常见文件输入会参考文件块大小,所以初学时容易产生“一块一任务”的印象。但相关不等于恒等。某些输入方式可以把多个小文件组合为一个 Split;某些压缩文件又不能任意切开。
这里说的是逻辑任务,不是执行尝试。任务失败后的重试,或者推测执行产生的尝试,也不应该算作新的输入切分。更不能把 MapReduce 的这套关系直接套成所有 Spark 数据源的分区规则。
一条记录跨了边界,怎么办?
存储块按字节组织,不会为了让一条业务记录完整,就保证它一定落在同一块里。InputSplit 的边界也不天然等于行边界。
RecordReader 的职责,是把逻辑输入范围转换成完整记录交给 Mapper。对于按行读取的文本,边界处理需要避免把半行当成独立记录,也要避免相邻 Split 重复交付同一行。
因此,“跨块一定丢数据”不成立;反过来,“任意格式都可以按换行切”也不成立。多行 JSON、自定义二进制和复杂压缩格式,需要匹配自己的读取实现。
检查自定义读取器时,我会准备跨边界记录、最后一行没有换行符、空文件等样本,再核对记录数和关键字段,而不是只验证大文件能被打开。
一个调 Block 大小没有解决的慢任务
看一个排查场景:少数超大 gzip 日志进入 MapReduce 后,集群大部分资源空闲,只有几个 Map 长时间运行。
第一反应是把 Block 调小,希望拆出更多任务。但如果使用 TextInputFormat 读取这些普通 gzip 文件,它们不能按任意位置独立解压,一个文件通常还是由一个 Mapper 完整处理。
根因是输入的可切分性,不是单纯存储块太大。旧测试为什么没暴露?测试用的是未压缩文本,任务数随切分变化,看起来参数很有效;上线输入却换了压缩格式。
改进应该从可切分格式、文件组织和上游输出方式入手,再验证真实输入产生了多少 Split。即使要调整 Block,也应确认对哪些新写入文件生效,不能认为改个默认值就自动重排旧文件。
Block 为什么不是越大越好?
较大的块通常有利于降低同等数据量下的块管理开销,也适合大块顺序读取;但计算并行度、任务时长和恢复代价,还要结合输入切分及运行引擎分析。
较小的块也不是越多越快。切分过细可能增加调度与初始化成本,单个任务真正处理数据的时间反而占比很低。只盯着任务数量,很容易把吞吐问题变成调度问题。
还有一个常见误解:小文件小于一个 Block,就会实际占满整块磁盘空间。HDFS 不会按配置块大小给每个小文件预留那么多实际数据空间,但小文件仍会带来文件和块相关的元数据、打开与调度开销。
调大 Block 不能自动把许多小文件合成一个文件。合并输入可以减少部分计算任务,也不等于消除了存储层的小文件元数据。面试回答到这里,才算把两个问题真正分开。