Hive 中 ORDER BY、SORT BY、DISTRIBUTE BY 和 CLUSTER BY 有什么区别?
面试怎么回答
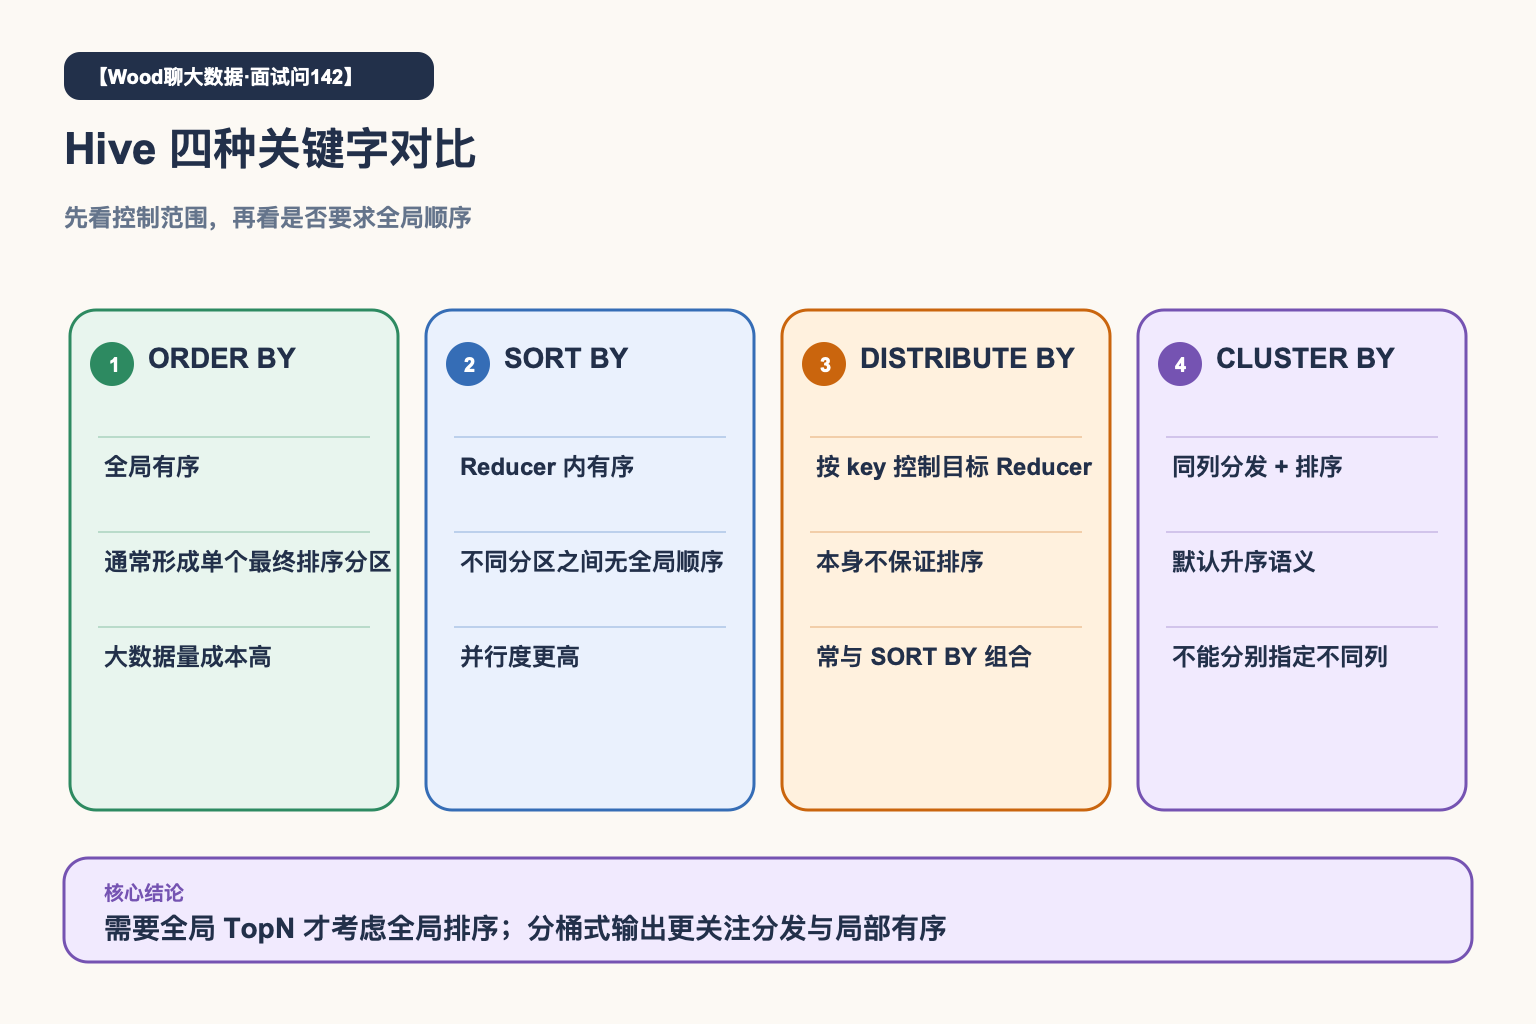
我会先区分数据分发和分区内排序。ORDER BY 要求最终结果全局有序,成本通常最高;SORT BY 只保证每个 Reducer 内有序;DISTRIBUTE BY 决定相同 key 发到哪个 Reducer,但不保证顺序;CLUSTER BY 可以看作相同列上的 DISTRIBUTE BY 加 SORT BY,适合默认升序。如果分发列、排序列或方向不同,就拆开写。生产上还要结合执行计划、Reducer 数量和下游是否真的需要全局顺序。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
四个关键字都和“排序”有关,但它们控制的其实是两个问题:一条记录应该去哪个 Reducer,以及进入 Reducer 后按什么顺序排列。
把这两个问题拆开,区别就清楚了。
ORDER BY 强调全局有序;SORT BY 保证每个 Reducer 内部有序;DISTRIBUTE BY 控制数据分发;CLUSTER BY 是按同一组列分发并排序的简写。
ORDER BY:要求全局顺序
ORDER BY 的目标是让最终结果整体有序。分布式环境下,要得到一个全局顺序,数据通常需要汇聚到单个最终排序分区,或者由引擎执行能够保证全局顺序的额外阶段。
因此它适合最终展示、全局 TopN 等确实需要整体顺序的场景,不适合无意义地给海量落盘数据做全局排序。具体执行计划仍应以 Hive 版本和执行引擎为准。
SORT BY:只保证分区内部有序
SORT BY 会让每个 Reducer 输出内部有序,但不同 Reducer 之间没有统一先后关系。
如果 Reducer 1 输出 1、3、5,Reducer 2 输出 2、4、6,把文件随意拼接后不一定全局有序。它换来的是更好的并行能力。
DISTRIBUTE BY:只决定数据去哪
DISTRIBUTE BY 根据指定表达式把相同键的数据发送到同一个 Reducer,作用类似控制 Shuffle 分区。
它本身不保证 Reducer 内的记录顺序,常见写法是 DISTRIBUTE BY key SORT BY key, event_time,让相同 key 聚到一起,并在每个 key 所在分区内按时间排序。
CLUSTER BY:同列分发加排序
当 DISTRIBUTE BY 和 SORT BY 使用相同列,且采用默认升序语义时,可以用 CLUSTER BY 简写。
如果分发列与排序列不同,或者需要明确降序,就应该拆开写,不能为了简短牺牲语义。
一个典型场景
某任务为了“让下游读取更快”,在全量明细输出前加了 ORDER BY event_time。结果所有数据集中到最终排序瓶颈,任务时间大幅增加,而下游其实只按 user_id 分批处理,并不需要全局时间顺序。
改成按 user_id 分发、分区内按 event_time 排序后,更符合下游消费方式,也保留了并行度。
排序不是越强越好,顺序保证应该刚好满足下游契约。