MapReduce Shuffle 过程是怎样的?
面试怎么回答
MapReduce Shuffle 从 Map 输出开始。Map 端先把记录写入缓冲区,通过 Partitioner 分到不同 Reducer,并在分区内排序;达到阈值后 Spill 到磁盘,最后合并文件。Reduce 端从所有 Map 拉取自己的分区,边拉取边归并,再按 key 分组后交给 reduce 函数。排障时我会分别看 Map 输出与 Spill、网络 fetch、Reduce 端 merge 和 key 倾斜,再决定是否压缩、使用 Combiner、调整并行度或处理热点 key。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
Map 进度已经 100%,Reduce 却迟迟不出结果。
如果只把 Shuffle 理解成“网络传输”,就很难解释为什么磁盘 Spill、排序合并和数据倾斜都会让它变慢。
Shuffle 是从 Mapper 输出开始,到 Reducer 获得按 key 分组数据为止的一整段重分布过程,横跨内存、磁盘、网络与排序。
Map 端:分区、排序和溢写
Mapper 输出的 key/value 先进入内存缓冲区。Partitioner 根据 key 决定它属于哪个 Reducer,同一分区内再按 key 排序。
缓冲区达到阈值后,数据会 Spill 到本地磁盘。一次 Map Task 可能产生多个 spill 文件,结束前还要进行合并,最终形成可供不同 Reducer 拉取的分区数据。
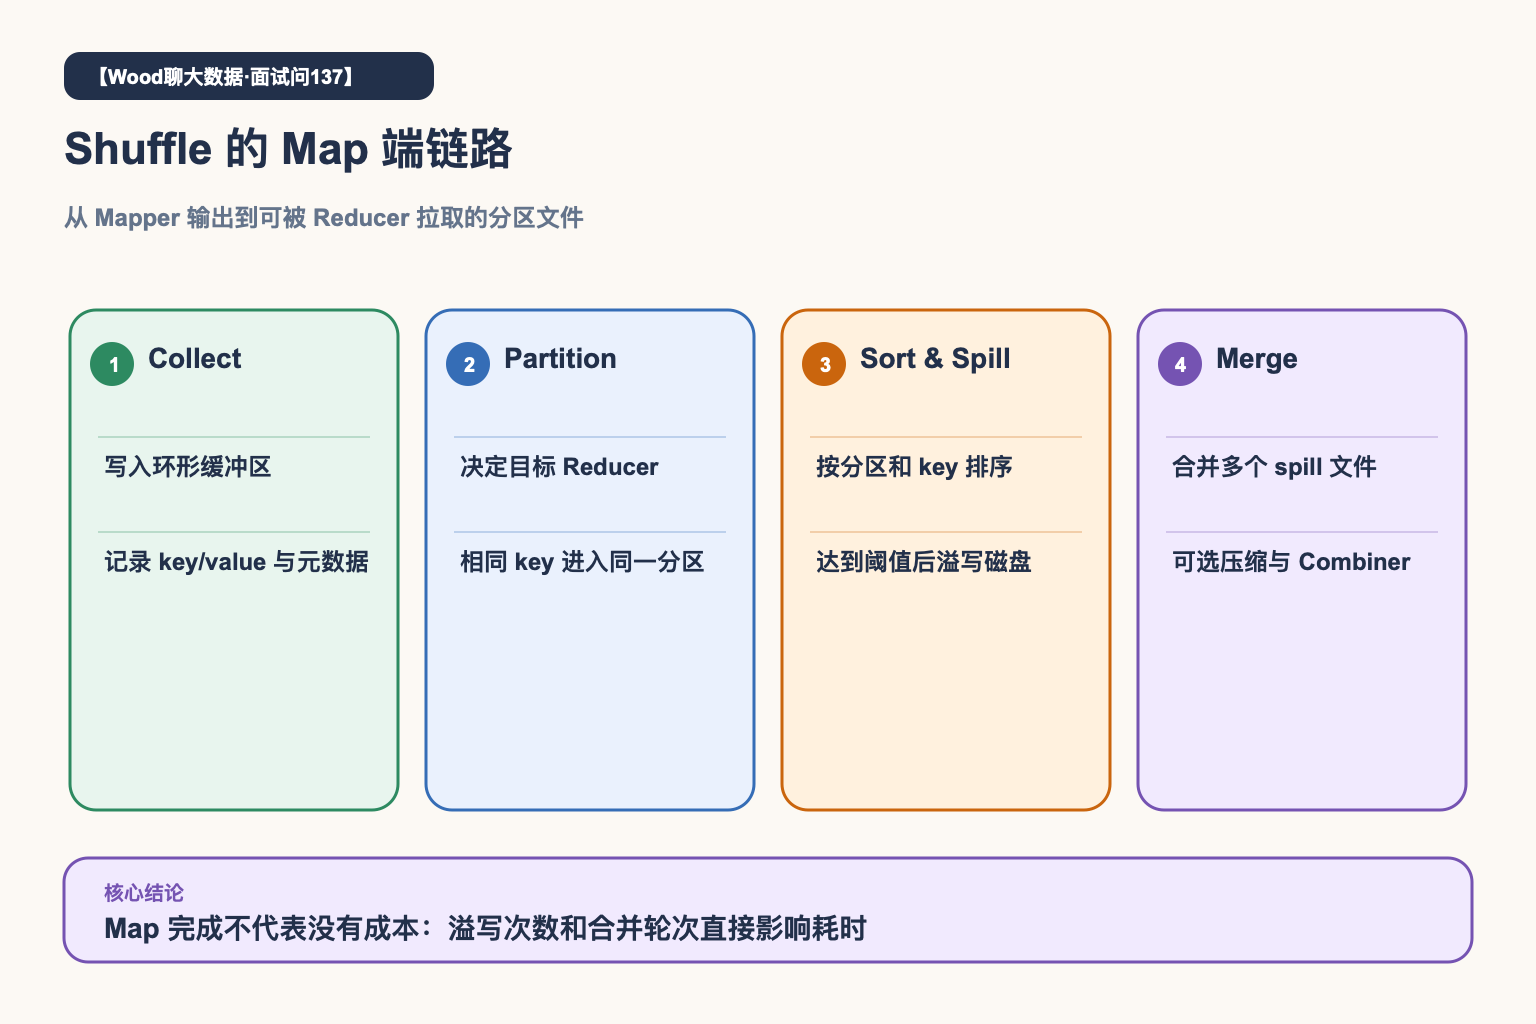
Combiner 可以在 Map 端做局部聚合,减少网络数据量,但它必须满足可交换、可结合等条件。平均值这类计算不能简单把局部平均再平均,否则结果会错。
Reduce 端:拉取、归并和分组
每个 Reducer 会从所有已完成的 Map Task 拉取属于自己的分区。拉取与归并通常交错进行:内存放不下时落盘,多个段再经过若干轮 merge。
最终数据按照 key 有序,并把相同 key 的 value 集合交给 reduce 函数。
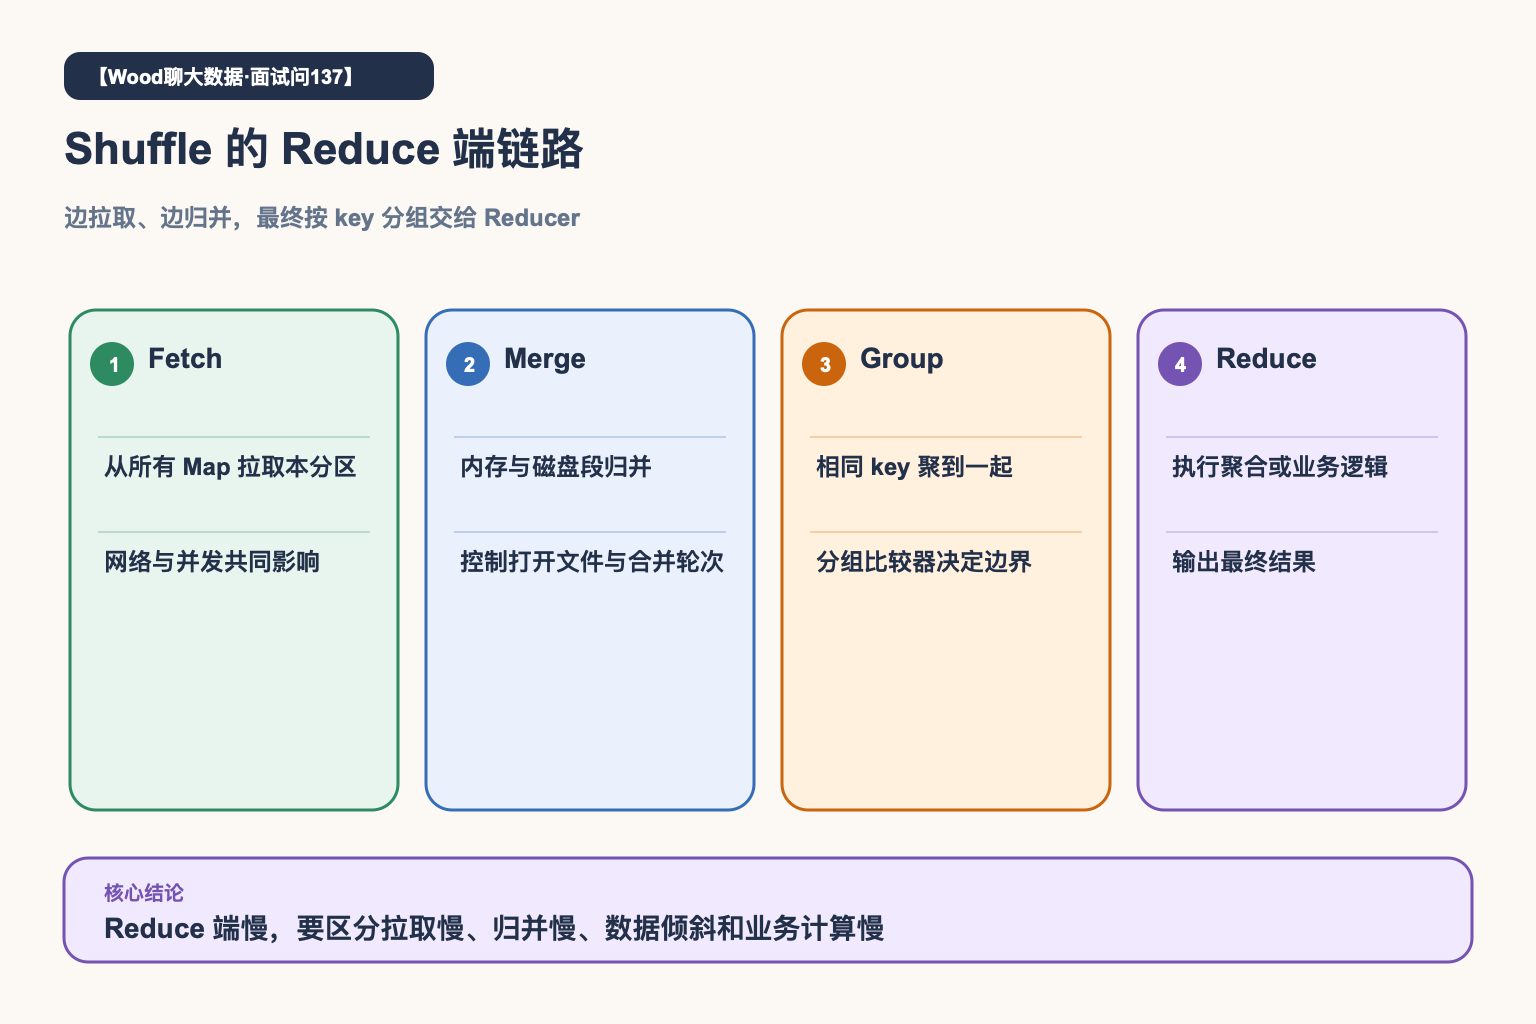
因此 Reduce 慢不一定是 reduce 函数慢,也可能是拉取失败、磁盘合并过多、单个 key 过大或某个节点网络异常。
排障要把阶段拆开看
- Map 端看输出记录数、输出字节、spill 次数和合并情况。
- 网络侧看 fetch 失败、重试、吞吐和慢节点。
- Reduce 端看各分区数据量、merge 时间、GC 和长尾 Task。
- 业务侧看 key 分布、Combiner 是否适用以及 Reducer 数量。
调大缓冲区并不是万能答案。内存过大可能挤压 Task 堆空间,Reducer 过多会增加连接和小文件,过少又会降低并行度。
一个典型场景
某任务 Map 很快结束,绝大多数 Reduce 也在几分钟内完成,只剩一个 Reducer 长时间运行。监控显示网络总吞吐正常,真正的问题是一个空值 key 聚集了大量记录。
如果只调 Shuffle 缓冲区,只会稍微改变 Spill 行为,并不能消除热点。正确处理是先确认空 key 的业务语义,再过滤、拆分或做两阶段聚合。
Shuffle 调优的前提,是先分清资源瓶颈和数据分布问题。