HDFS 小文件过多,怎么治理?
面试怎么回答
我会先按目录和分区统计文件数、总大小、平均大小和新增趋势,再映射到具体写入任务。根因通常是分区过细、写入并行度过高、微批次过于频繁或重跑追加。治理优先从源头调整分区粒度、Writer 并行度、文件滚动和幂等写入,让新增文件保持合理大小;存量文件再通过临时目录重写、数据校验和安全替换完成合并。最后持续监控文件数量、平均大小、NameNode 元数据压力和查询 Task 数,避免只做一次性合并。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会直接回答:
“定时跑合并任务,把小文件合成大文件。”
合并存量文件当然有用,但如果写入方式没有变化,今天合完,明天还会继续产生。
小文件治理真正要回答两个问题:
这些文件为什么产生,以及怎样让新增文件从源头保持合理大小。
第一步:先理解小文件为什么贵
小文件的问题不只是浪费 HDFS Block。
每个文件、目录和数据块都需要对应的文件系统元数据,NameNode 需要维护整个 Namespace。文件数量持续增长,会增加内存压力、元数据操作和目录扫描成本。
对计算引擎来说,大量小文件还会带来:
- 文件 Listing 和 Open 开销
- 更多 Input Split 和 Task 调度
- 单个 Task 工作量太小
- 查询启动慢但真正计算时间短
- 下游继续产生更多碎片文件
把 HDFS Block Size 调大,并不会自动把多个小文件装进同一个文件。文件写小了,元数据和调度开销仍然存在。
第二步:定位是哪条链路在持续制造小文件
先按目录、分区和时间统计:
- 文件数量和总大小
- 平均文件大小与大小分布
- 每天新增文件数
- 哪些分区最严重
- 对应的写入任务、并行度和调度频率
常见来源包括:
分区设计过细
低数据量业务同时按日期、小时、地区和类型分区,每个分区只剩很少数据。
写入并行度过高
每个并行 Task 都写出一个或多个文件,数据量不大但 Task 数很多。
微批次过于频繁
实时或准实时任务每隔很短时间提交一次,每批都生成新文件。
失败重试和追加写
任务重跑没有覆盖或合并原分区,不断追加新的碎片文件。
先找到生产者,才能判断是改分区、并行度、写入频率还是重跑逻辑。
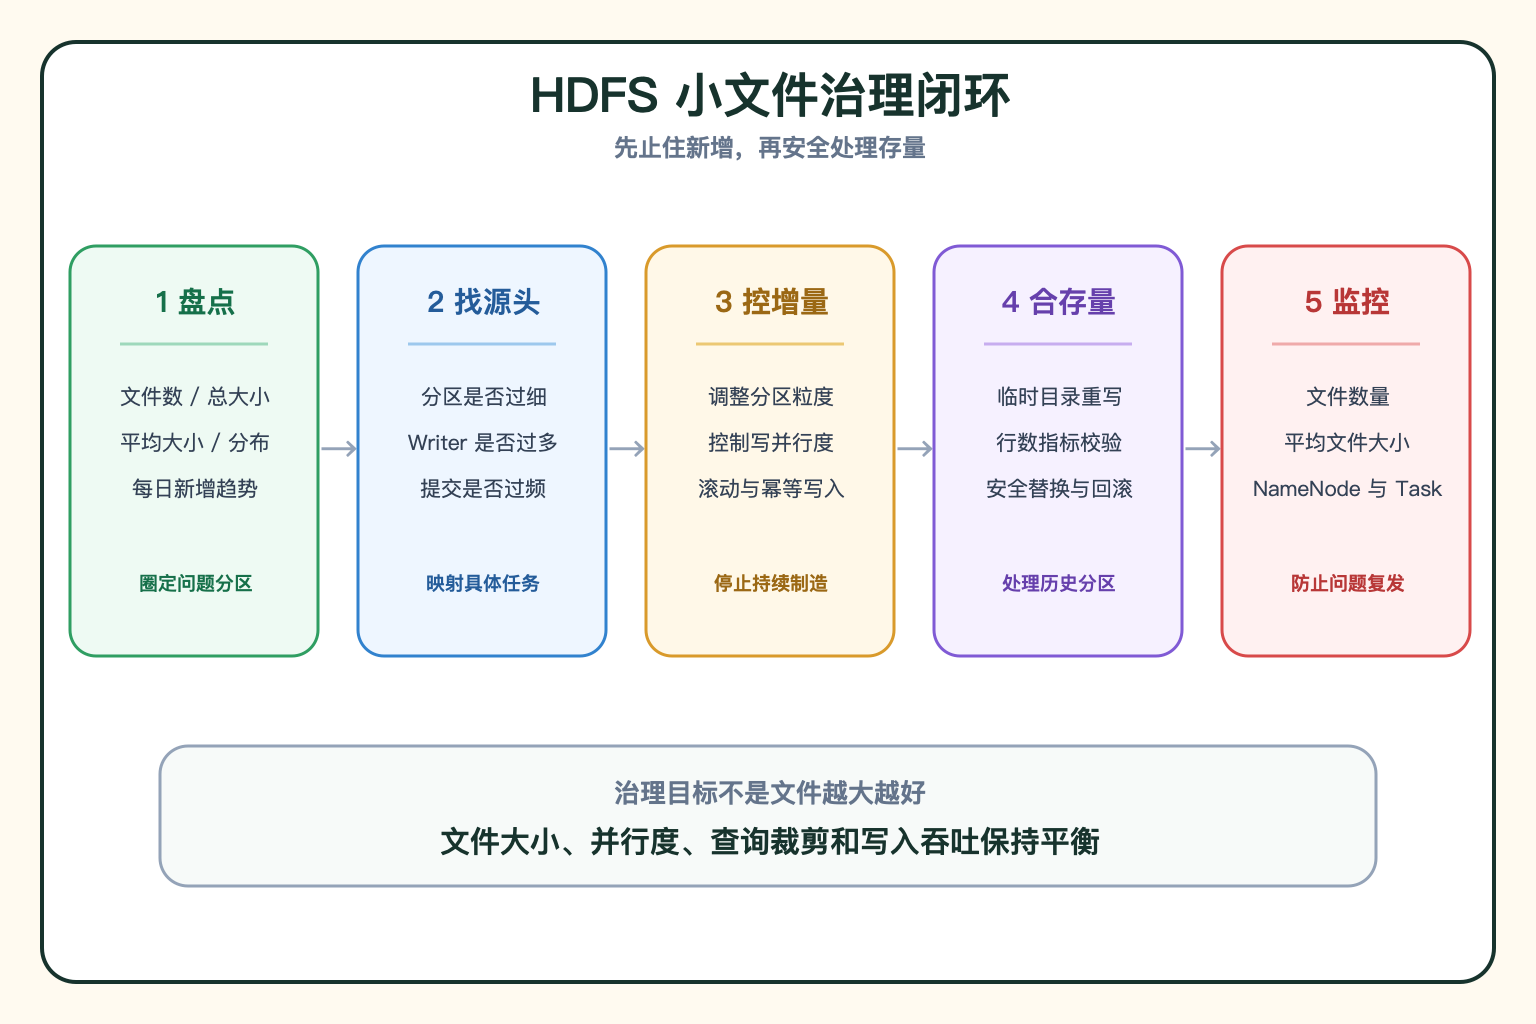
第三步:源头控制比事后合并更重要
调整分区粒度
分区首先服务于查询裁剪和数据管理,不是维度越多越好。
低基数字段、低数据量时间段可以减少分区层级,避免产生大量空分区和微小分区。
控制写出并行度和目标文件大小
根据每个分区的实际数据量决定 Writer 数量,而不是沿用上游最大并行度。
可以在写出前合理 coalesce 或调整 Shuffle 分区,但不能为了减少文件强行写成单文件,造成单 Task 瓶颈。
降低无意义的提交频率
如果业务只要求小时级结果,就没有必要每分钟产生一批落盘文件。实时链路也可以通过滚动策略控制文件达到大小或时间条件后再提交。
保证重跑幂等
固定分区重跑应采用覆盖、原子替换或明确的 Merge 机制,避免失败重试持续追加文件。
第四步:存量文件要有安全的合并流程
存量治理不能直接在生产目录里边读边删。
更稳妥的过程是:
- 选择明确的历史分区和合并窗口
- 写入临时目录,控制目标文件数量和大小
- 校验行数、关键指标、文件数和可读性
- 原子替换或按平台能力安全切换目录
- 保留可回滚窗口,再清理旧文件
合并时还要考虑表格式、压缩方式、分桶规则和下游并发访问,不能只追求文件越大越好。
一个典型场景
比如一张按小时分区的明细表,每个小时数据量并不大,但写入任务沿用了很高的上游并行度。
查询时真正扫描的数据量不大,任务却需要先枚举和打开大量文件,执行计划里出现大量短 Task。
第一次治理只增加了每天合并任务,文件数暂时下降,但小时任务第二天继续制造同样数量的小文件。
最终需要同时调整写出并行度和滚动策略,并把合并任务作为历史兜底,而不是主治理手段。
合并解决存量,写入策略才能控制增量。