HBase BlockCache 和 BloomFilter 如何减少磁盘读?
面试怎么回答
BloomFilter 在访问 HFile 前用概率判断排除肯定不包含目标 RowKey 或 Row+Column 的文件,可能有假阳性但没有假阴性;BlockCache 则缓存已读取的数据块、索引块等,让真正需要的访问尽量命中内存。前者减少无效文件检查,后者减少重复磁盘读,需要结合点查比例、缓存命中和 HFile 数一起调优。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一次不存在 RowKey 的 Get,为什么还可能去多个 HFile 做磁盘查找?
BloomFilter 负责提前回答“这个文件大概率没有”,BlockCache 负责让“确实要读的 Block”尽量留在内存。
BloomFilter 用少量内存排除不可能包含目标 Key 的 HFile,BlockCache 缓存已经读过的数据块与索引块;两者分别减少无效文件访问和重复磁盘读取。
一次读请求会经过多层候选
Region 内的数据可能同时存在 MemStore 和多个 HFile。Get 或 Scan 先判断文件范围与索引,再读取对应 Data Block。Flush 与 Compaction 之前文件较多时,一个 Key 可能需要检查多个候选 HFile,读放大会明显增加。
BloomFilter 先排除不存在
BloomFilter 是概率数据结构,能确定“肯定不存在”,但命中只表示“可能存在”。HBase 常按 ROW 或 ROWCOL 构建过滤器。它会有可控的假阳性,因此不能替代最终数据查找;但对大量点查不存在 Key 的场景,能跳过许多 HFile。
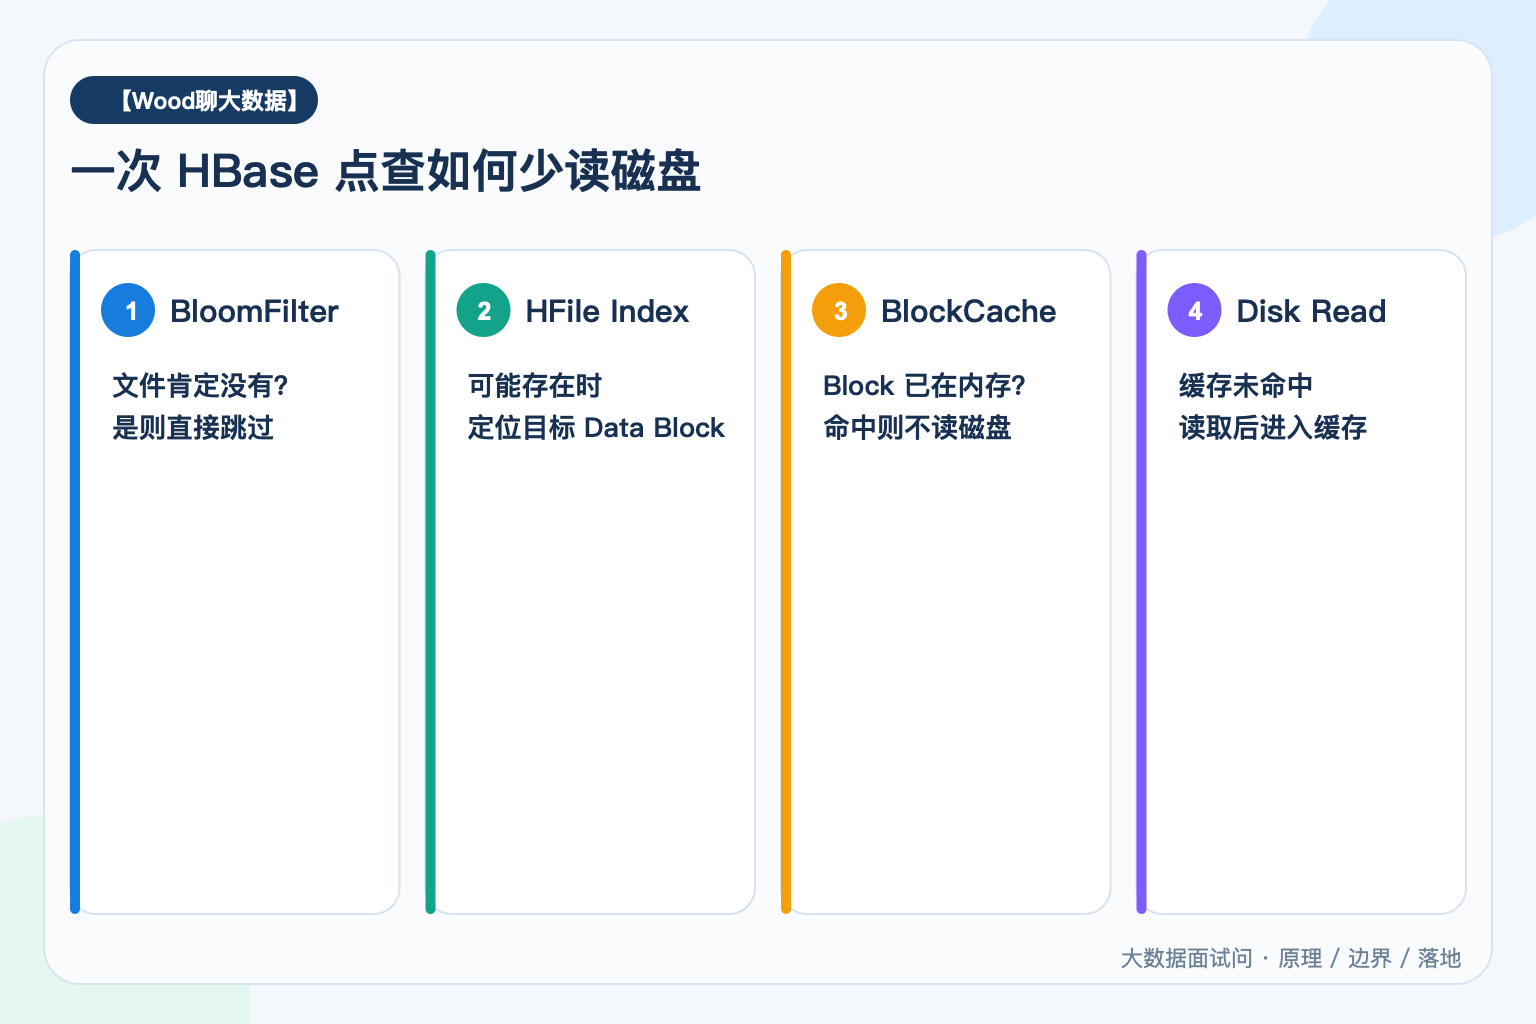
BlockCache 缓存真正访问的 Block
HFile 的 Data Block、Index Block、Bloom Block 等被读取后可进入 BlockCache。热点 Key 或热点范围再次访问时,从内存命中比磁盘读取快得多。缓存容量、实现与优先级会影响数据块和元数据块的竞争。
两者是串联而不是替代
BloomFilter 减少要不要打开和查找某个文件,BlockCache 优化确定需要访问的 Block 从哪里取。即使 Bloom 判断可能存在,索引和数据块也可能在缓存中;即使缓存很大,不做 Bloom 仍会为不存在的 Key 检查大量文件。
场景选择要看访问模式
ROW 适合按 RowKey 点查,ROWCOL 适合经常指定列的查询,但会增加 Filter 大小和写入成本。大范围 Scan 通常不能从 Bloom 获得同等收益;缓存也容易被全表扫描冲掉,需要合理设置 Scan 缓存策略与 BlockCache。
如何验证效果
观察 Bloom 请求数、有效排除数、假阳性相关指标,结合 BlockCache hit ratio、eviction、HFile 数量和读延迟。命中率低不一定只靠加内存解决,也可能是访问没有热点、Block 太大、全表扫描污染缓存或小文件过多。
参考资料
- Apache HBase Reference Guide:https://hbase.apache.org/book.html