MapReduce Combiner 能代替 Reducer 吗?为什么平均值不能直接局部求?
本文目录
面试怎么回答
Combiner用于局部缩小Map输出,不负责跨所有Map的最终汇总,也不能依赖它固定执行一次。合并结果需要与后续输入类型和语义兼容,通常要求可结合、可交换。计数求和可以局部合并;平均值应传总和与数量,Reducer最后相除。我会验证无Combiner、不同分片和多轮合并结果一致,不能把必须执行的业务副作用放进Combiner。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
“WordCount里Combiner和Reducer可以用同一个类,所以所有任务都能这样配。”这句话最容易在计算平均数时露馅:各个Map的样本量不同,局部平均后再平均,结果还一样吗?
Combiner是可选的局部合并优化,正确性不能依赖它执行;中间状态必须能在不合并或多次合并后仍得到同一最终结果。
Reducer需要完整分组,Combiner只看局部
MapReduce会把相同键的输出送到对应Reducer进行最终处理。Combiner则在适合的阶段对局部输出做合并,减少后续传输和处理的数据量。
本地WordCount的一串同键一可以先变成一个局部计数,因为后面继续相加不丢失最终所需信息。但局部计数不是全体Map上的最终词频。
因此不能因为配了Combiner就省去全局汇总需求。若任务本来就是Map-only,那是另一种计算设计,不是Combiner自动接管Reducer。
不要让正确性依赖执行一次
Combiner属于优化环节,框架不会向业务逻辑承诺每条记录必须经过且只经过一次。执行会受到缓冲、溢写和合并路径等影响。
从程序设计角度,应覆盖不执行、局部执行及重复分段合并等情况。这里说的多次合并,是中间结果再次参加合并,不是要求每种业务聚合函数都具备幂等性。
例如求和不具备“同一数值重复相加仍不变”的性质,但只要记录没有被错误复制,它仍能按不同分段得到相同数学结果。不要把结合律与去重幂等混在一起。
平均值要保留两个量
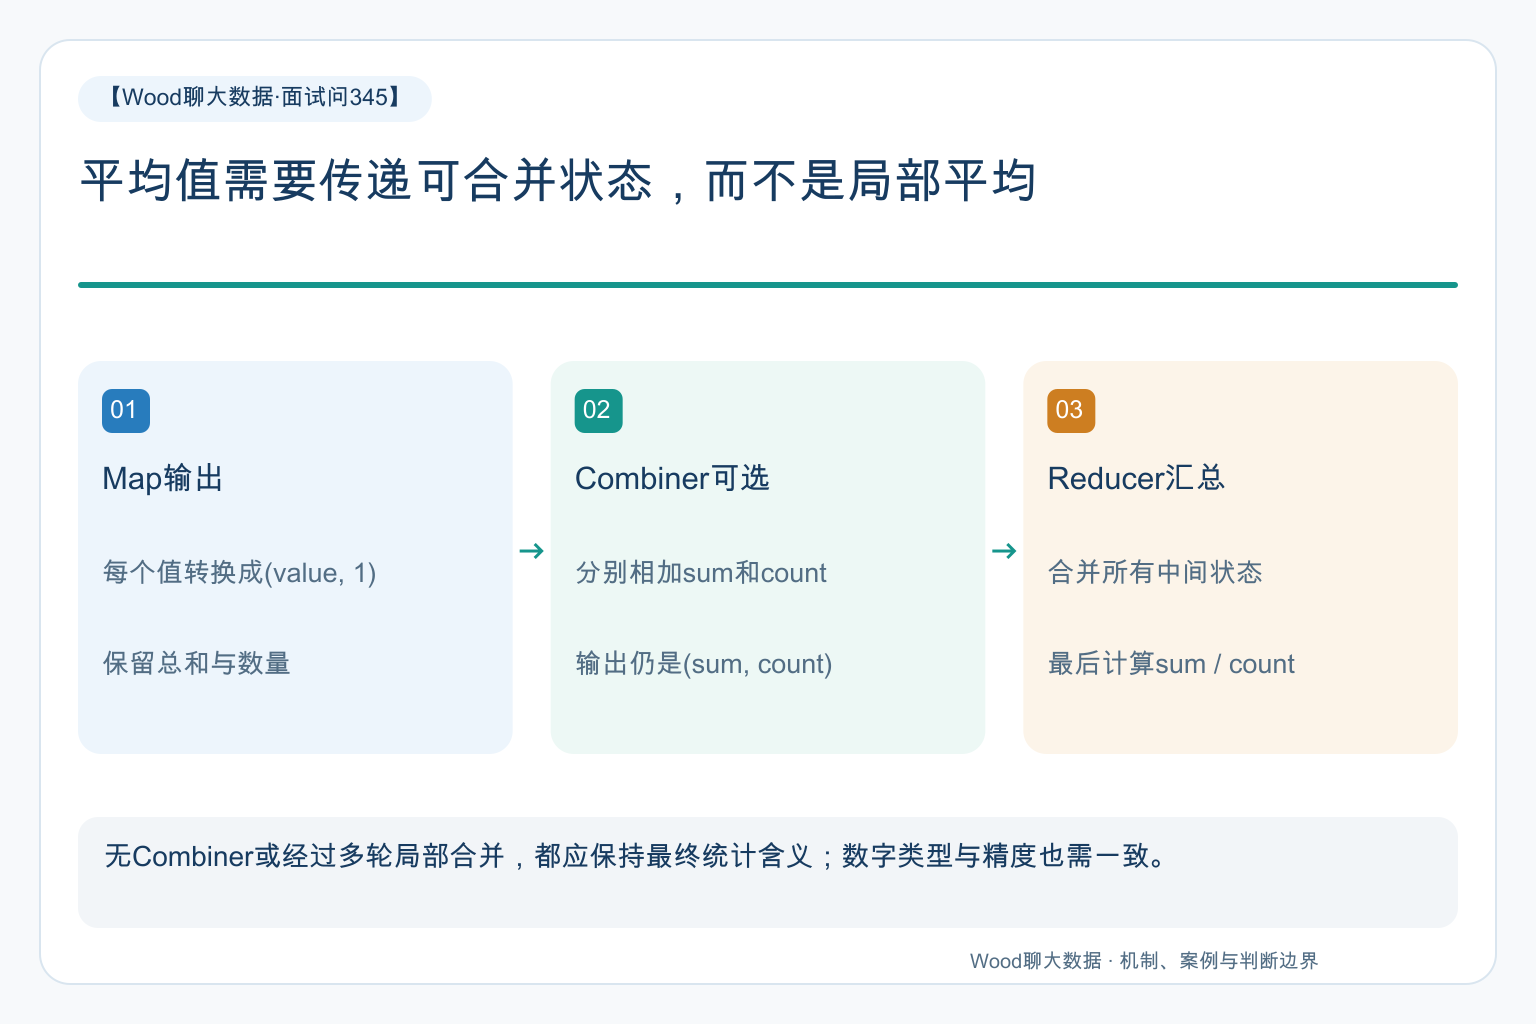
假设一个Map处理一条100,另一个Map处理九条20。它们的平均值是100和20,继续平均为60,而全体平均是28。
如果Map输出总和与数量,局部状态分别为(100,1)和(180,9),合并后得到(280,10),最终再除得到28。
Combiner的输出必须仍能被后续合并逻辑正确理解。若Map输出明细数值,Combiner却输出一种不同含义的平均数,Reducer不知道权重,就已经丢失信息。
不是所有计算都适合局部缩小
完整排序后的序列、需要保留全部记录的业务逻辑,未必能够压成一个简单值。可以尝试设计足够的信息摘要,但必须先证明它支持目标结果。
局部Top N能否用于全局Top N,还要分析排序规则、并列保留和分组维度;不能用“Top N也能聚合”当作无条件结论。
浮点数还存在有限精度问题,合并顺序改变可能出现尾差。对精确金额,应使用明确的数值类型和舍入策略,并把允许误差写进验收,而不是隐藏在性能优化里。
一个典型场景:文件拆分改变了报表均值
假设同一批数据重新组织成不同大小的输入文件后,平均耗时发生变化。最初怀疑部分文件重复读取,行数和原始总耗时却能对上。
原因是Combiner输出局部平均值,输入划分改变了局部分组大小,于是最终平均的隐含权重也改变。旧测试每个分片行数接近,没有暴露这个问题。
修正为可合并的总和与计数,并建立多种分片样本。分别在没有局部合并、单次合并、多层合并的模拟路径下验证最终值,与直接明细计算对照。
检查还要覆盖单键大组、空输入、非法值过滤和数值溢出,避免仅在小数据上成立。
业务副作用不应该绑在优化阶段
不能在Combiner里做必须恰好一次的通知、扣减或外部写入,然后依赖它一定被调用。优化执行路径不是业务事务协议。
性能评估则看Map输出被缩小多少、Shuffle字节量、溢写和Reducer耗时。键几乎不重复或中间状态没有变小,收益可能有限,还会增加合并开销。
面试里最重要的一句不是“Combiner能减少网络”,而是“即使完全不运行Combiner,最终结果也必须正确”。这句话才能把它和真正负责业务完整性的处理阶段区分开。