HDFS hflush 和 hsync 有什么区别?读得到就代表已经持久化吗?
本文目录
面试怎么回答
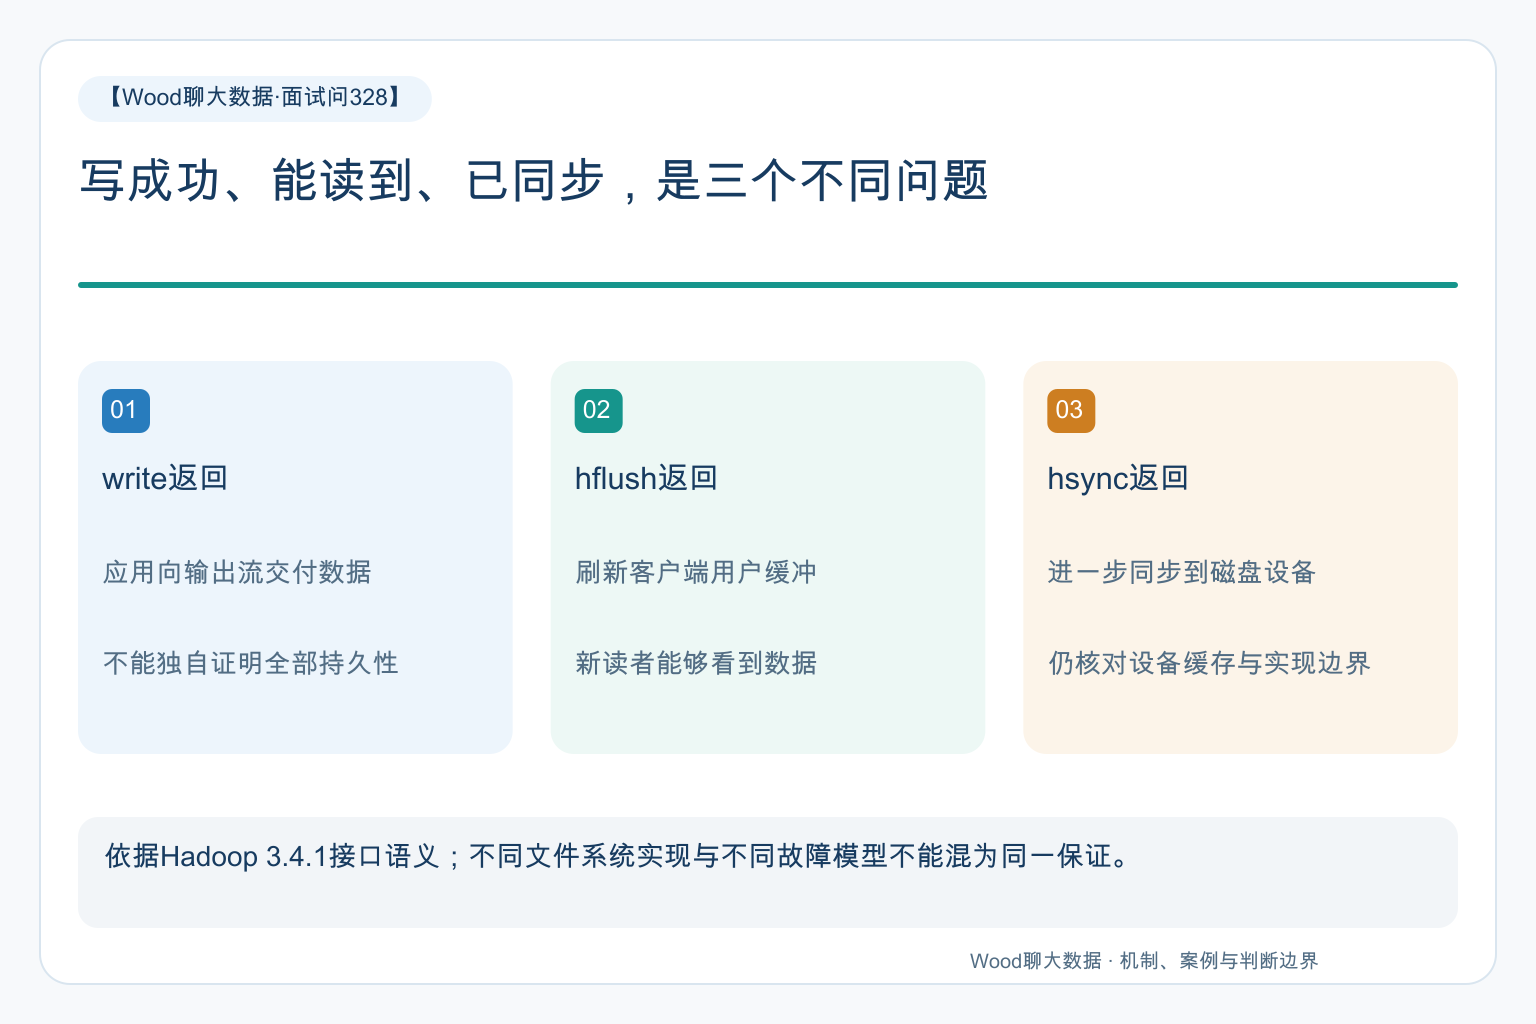
我会把客户端写入、读者可见和持久化分开。Hadoop接口中hflush强调刷新后新读者能看到数据,hsync进一步要求同步到磁盘设备,但设备缓存等仍有边界。实际保证要核对HDFS及存储实现,不能把读得到直接当成所有故障下不丢。测试应分别覆盖写进程退出、节点故障和约定的持久性场景,并检查确认边界。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
写入程序返回成功,另一个客户端也能读到内容,于是有人下结论:“这条数据肯定落盘了。”这个推理跳过了一层:可读到的数据,也可能仍经过某些缓存。
读者可见性与持久性是不同保证;hflush和hsync针对不同同步边界,仍需结合文件系统实现、设备缓存和失败模型验收。
先拆开三个经常被混用的动作
应用调用write,通常只是把数据交给输出流,后续可能还经过客户端缓冲、网络与服务端处理。方法正常返回,不自动包含我们想象中的所有持久性承诺。
另一个读者能够看到数据,说明已经越过了某个可见性边界,但还要问数据位于什么介质、哪些缓存已经同步,以及故障时如何恢复。
因此讨论可靠性时,不能只用一个“成功”概括整个链路。应该明确生产者在什么条件满足后,才向上游确认这一段数据已被接受。
hflush强调可见,hsync强调更深同步
Hadoop 3.4.1的接口说明,hflush刷新客户端用户缓冲,调用返回后新读者能够看到数据。这里特别要注意是接口定义的读者可见语义,不应扩展成所有已有读者都自动刷新到最新内容。
hsync的说明类似于把数据同步到磁盘设备的fsync语义,同时明确设备仍可能具有自身缓存。因此不能用一句“绝对物理落盘,任何断电都不丢”替代文档的实际边界。
这两个接口不是名称不同、效果完全相同的flush。普通输出流flush、文件关闭与文件长度元数据更新,也不应未经核实就当作同一保证。
文件系统接口不等于所有实现都一样
同一套Hadoop文件系统API可能连接HDFS,也可能连接其他存储。接口存在,并不代表底层实现提供完全相同的同步能力。
需要结合具体文件系统、版本与流能力检查。对象存储上的提交与可见语义,不能直接照搬HDFS管道中的同步推理。
即使确认使用HDFS,还要明确故障模型:仅写进程退出、一台DataNode故障、多节点同时断电,涉及的持久性风险不同。副本数量与故障域也不能从单次接口调用中自动推导出来。
同步频率有性能代价
每写一条就同步,通常会增加等待和调用开销;攒较大批次再同步,可以减少同步频率,但未确认窗口也可能扩大。
可以按条数、字节量或时间制定同步策略,并把业务允许的未确认窗口写清楚。不存在一组对所有日志、报表和在线状态都最合适的固定参数。
如果上游有重试能力,还需要稳定记录身份与恢复规则。即使数据已经同步,上游没有收到成功确认,也可能重发;持久性与幂等处理同样不是一件事。
一个典型场景:可读测试过了,故障测试没过
假设一个日志写入程序只调用普通flush,然后启动新读者确认内容可见,就宣布满足持久化要求。某次异常退出后出现尾部数据与确认记录不一致,团队最初怀疑副本机制失效。
真正需要排查的是写入、同步与对外确认的顺序,以及测试实际覆盖了哪种故障。旧测试只验证正常情况下读取成功,没有覆盖未同步窗口或恢复后的文件尾部,所以结论过度扩大。
修正时明确确认点,按实际HDFS能力选择同步方式,并记录已确认序号。测试分别模拟写入进程退出、节点异常和恢复重试,核对已确认数据是否可恢复、未确认数据如何处理。
这个案例是说明性场景,不意味着任何一次flush后的故障都会丢数据;重点是正常读取测试不足以证明更强的失败保证。
验收写清楚“保证到哪里”
最终报告应注明使用的文件系统、接口、同步频率、确认边界和故障范围。对于未测试的设备断电行为,应明确保留限制,而不是用“生产级可靠”笼统带过。
面试回答也是如此。先讲可见性与持久性的区别,再讲API和取舍,最后说明如何验证,比只背一句“一个刷内存,一个刷磁盘”准确得多。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。