Flink 任务出现反压,你怎么排查?
面试怎么回答
我会先明确反压会从下游向上游传播,所以出现反压的算子不一定是根因。排查时先看 Flink Web UI,从下游往上找到第一个持续 Busy、吞吐下降的算子,再比较各个 Subtask 是否均匀。如果全部繁忙,重点查计算逻辑、资源和外部 IO;如果只有少数 Subtask 繁忙,重点查数据倾斜。最后结合输入输出吞吐、Checkpoint、GC 以及数据库或接口延迟确认根因,再决定优化代码、增加并行度、处理热点 key 或调整 Sink。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人一上来就回答:
- 增加并行度
- 增加 TaskManager
- 调大内存
这些方法有时候确实能缓解问题。
但如果只回答这些,面试官很可能会继续追问:
你怎么知道瓶颈到底在哪个算子?
因为反压有一个很容易误导人的特点:
看到反压的位置,不一定是真正产生问题的位置。
下游消费不过来,压力会一路向上游传播。
所以真正有价值的排查思路是:
从下游往上找,定位第一个持续处理不过来的算子。
第一步:先理解反压是怎么产生的
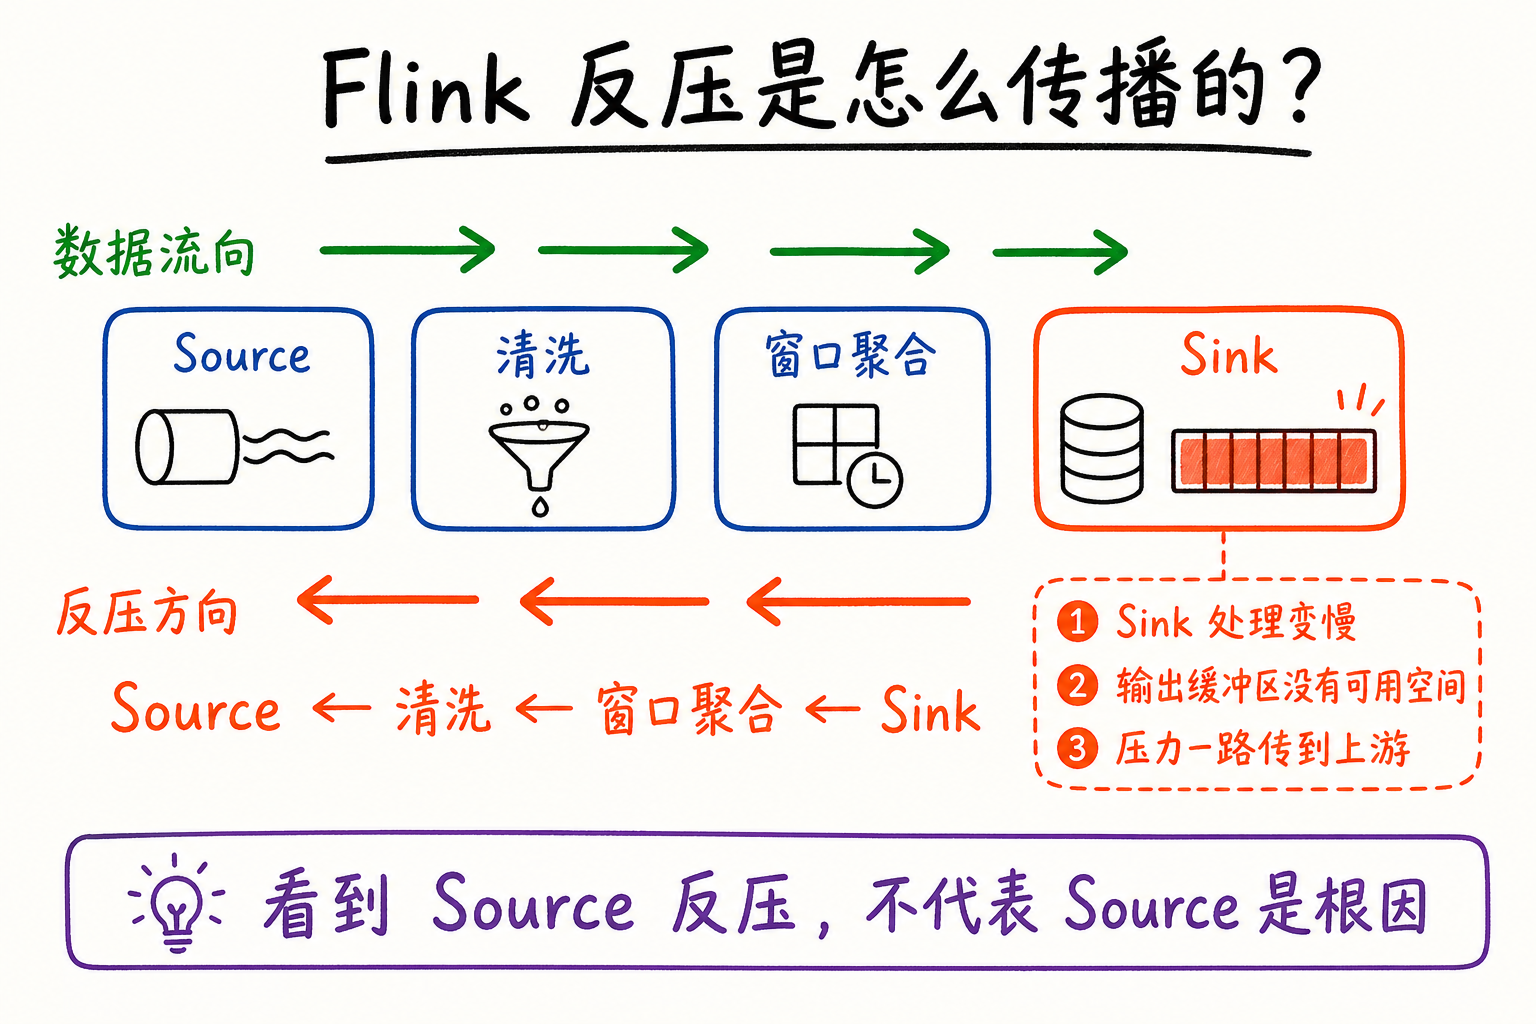
Flink 的数据正常情况下会从 Source 一路流向下游算子,最后进入 Sink。
如果下游处理速度低于上游生产速度,数据就会开始堆积。
当上游没有可用的输出缓冲区时,就会进入反压状态。
这个压力传播的方向和数据流向相反:
数据向下游流,反压向上游传。
例如一条链路是:
Kafka Source → 数据清洗 → 窗口聚合 → MySQL Sink
如果 MySQL 写入突然变慢,最先处理不过来的是 Sink。
但随着压力向上传播,窗口、清洗甚至 Source 都可能显示反压。
所以看到 Source 反压,不代表 Source 有问题。
它很可能只是在等下游释放空间。
第二步:从下游往上找到第一个瓶颈
排查时可以先看 Flink Web UI 的 JobGraph 和 Back Pressure 页面。
官方提供了三个非常有用的指标:
backPressuredTimeMsPerSecond:每秒处于反压状态的时间busyTimeMsPerSecond:每秒真正忙于处理数据的时间idleTimeMsPerSecond:每秒等待输入数据的时间
三个指标加起来大约是 1000 毫秒。
但不要只盯着某一个算子的反压值。
更重要的是把上下游连起来看。
第一看:哪个下游算子持续很忙
如果一个下游算子的 Busy 长期很高,而它的上游出现明显反压,这个下游算子就是重点排查对象。
继续向下看,找到最先出现“持续繁忙、吞吐下降”的位置。
第二看:所有 Subtask 都慢,还是只有少数慢
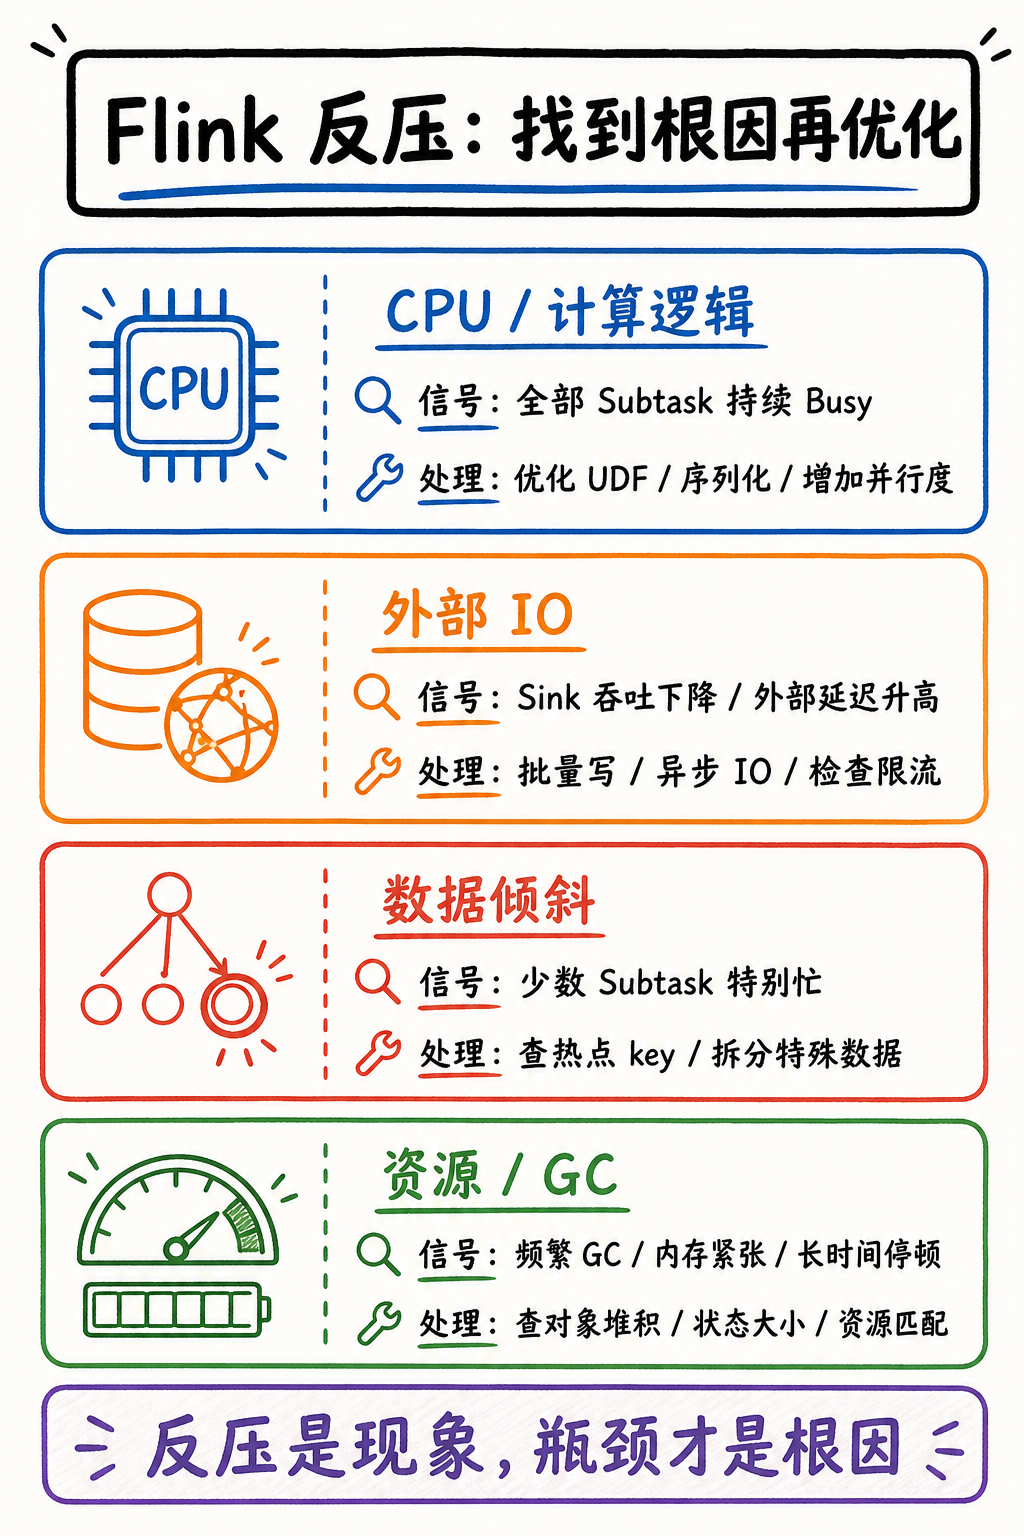
如果所有 Subtask 的 Busy 都很高,通常说明算子整体处理能力不足。
如果只有少数 Subtask 特别忙,其他 Subtask 比较空闲,更像是 keyBy 后的数据倾斜。
这和 Spark 数据倾斜的判断思路很像:
先看分布是否均匀,再决定要不要增加并行度。
第三看:吞吐、延迟和外部系统是否同时变化
继续结合输入输出记录数、消费延迟、Checkpoint 耗时以及外部系统响应时间。
如果 Sink 的输出吞吐下降,同时数据库或者接口延迟上升,问题大概率不在 Flink 计算本身,而在外部 IO。
第三步:根据根因选择解决方式
定位到瓶颈算子之后,再决定怎么优化。
第一类:CPU 或计算逻辑成为瓶颈
常见情况包括:
- UDF 逻辑复杂
- 频繁创建对象
- 序列化、反序列化开销高
- 单条数据进行了过多计算
这时应该先优化计算逻辑和对象使用,再根据实际负载增加算子并行度。
第二类:外部 IO 成为瓶颈
Sink 写数据库、接口、搜索引擎时,经常会因为网络延迟、限流或者单次写入效率低而产生反压。
可以考虑:
- 批量写入
- 异步 IO
- 调整并发和缓冲区
- 增加 Sink 并行度
- 检查外部系统容量和限流策略
但并发不能只在 Flink 侧盲目调大。
如果外部系统已经到达上限,继续增加并发只会让下游压力更大。
第三类:数据分布不均匀
如果只有少数 Subtask 很忙,要重点检查 keyBy 字段的分布。
热点用户、默认值、NULL 或者某个大客户,都可能让数据集中到少数并行实例。
这时应该处理热点 key、拆分特殊数据或者调整分区策略,而不是简单增加整体并行度。
第四类:资源和 GC 问题
如果算子同时出现频繁 GC、内存紧张或者长时间停顿,就需要结合 JVM 和 TaskManager 指标继续排查。
重点不是“内存越大越好”,而是确认对象为什么堆积、状态是否过大,以及资源是否与并行度匹配。
一个典型生产场景
比如一条实时链路从 Kafka 读取订单,完成清洗和聚合后写入数据库。
任务运行一段时间后,Source 和中间算子都出现了反压。
如果只看反压位置,很容易以为 Kafka 消费能力不够,于是先增加 Source 并行度。
但沿着 JobGraph 向下排查,会发现 Sink 长期处于 Busy,输出吞吐同时下降。
继续检查数据库,发现写入延迟明显升高。
这时根因并不在 Source,而在数据库 Sink。
正确的处理方向应该是检查批量写入、连接池、索引、限流和数据库容量,而不是继续扩大上游生产速度。
这条排查链路是:
看到上游反压 → 沿 JobGraph 向下追踪 → 找到第一个持续繁忙的算子 → 结合外部指标确认根因 → 针对瓶颈处理。
为什么增加并行度不一定有效?
增加并行度只对“算子自身计算能力不足”或者“并行度确实不够”的情况有效。
如果真正的瓶颈是:
- 数据库已经达到写入上限
- 外部接口正在限流
- 某个热点 key 仍然集中到一个 Subtask
- 单条数据处理逻辑本身效率很低
盲目增加并行度可能没有效果,甚至会进一步放大对外部系统的压力。
所以处理反压最关键的不是先扩资源,而是先回答:
第一个处理不过来的算子是谁,它为什么处理不过来?
我理解的 Flink 反压排查
反压不是根因,而是下游处理能力不足之后向上游传播的结果。
Web UI 里的反压状态只是入口。
真正的排查要结合 Busy、Idle、Back Pressure、Subtask 分布、吞吐变化和外部系统指标,找到第一个真正的瓶颈。
先定位瓶颈,再决定是优化计算、调整并行度、治理热点 key,还是处理外部 IO。