Flink ProcessFunction 能做什么?
面试怎么回答
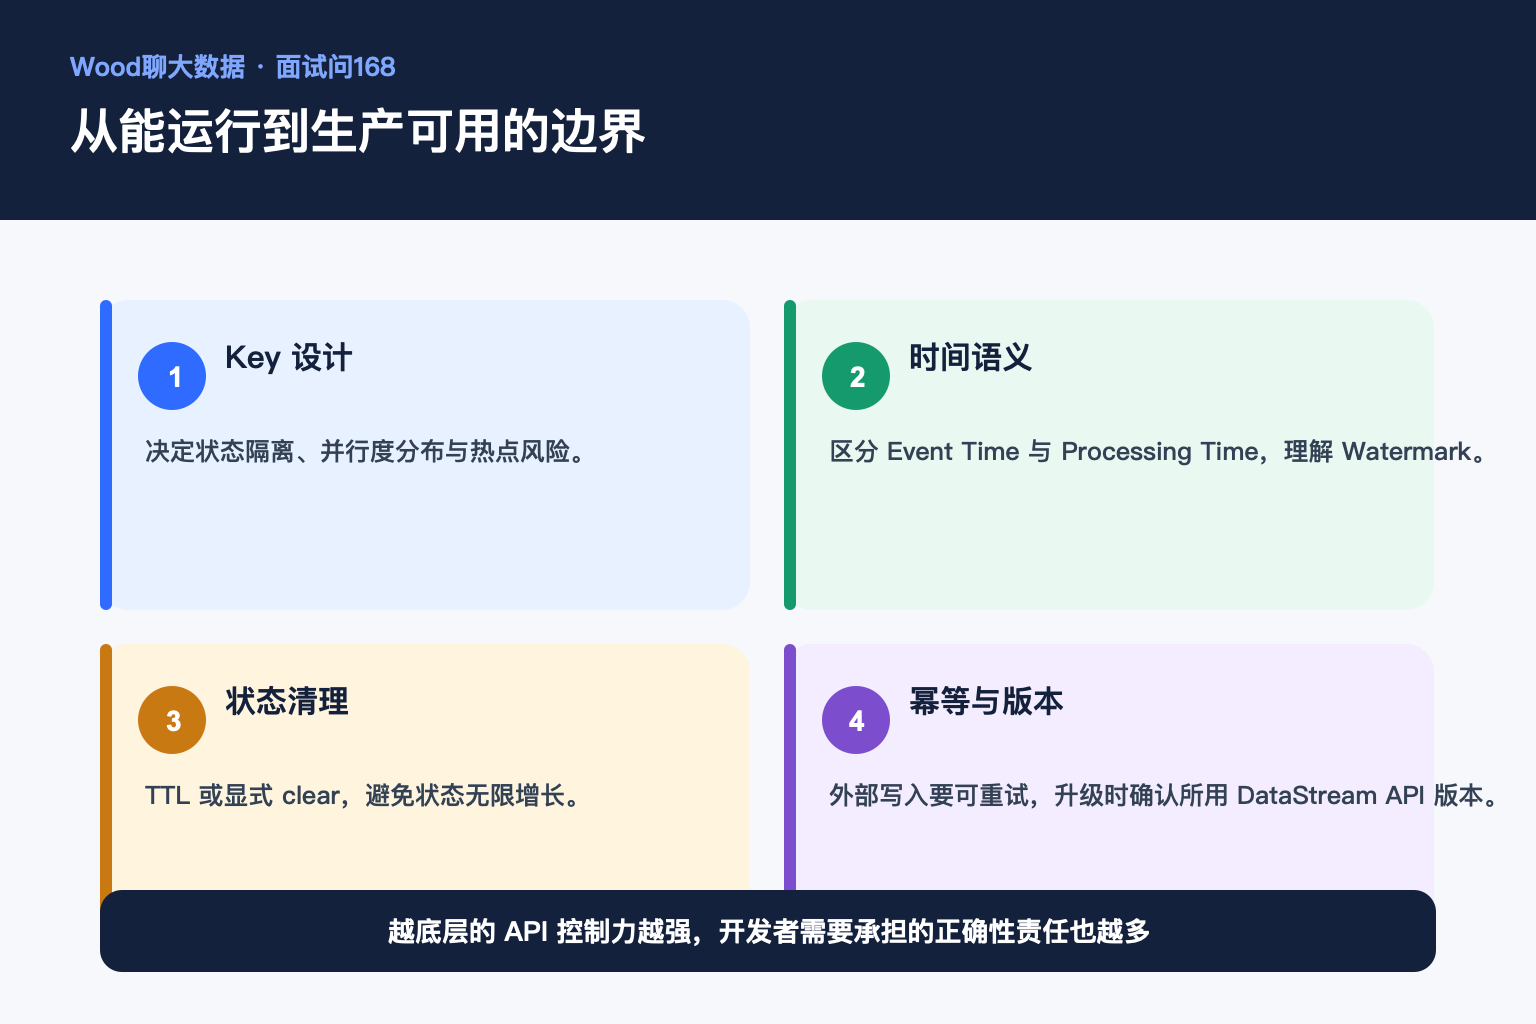
ProcessFunction 适合需要逐条事件处理,同时访问状态、时间和旁路输出的复杂场景。KeyedProcessFunction 通常先 KeyBy,让状态和定时器按 key 隔离;processElement 更新状态并注册或删除定时器,onTimer 处理超时逻辑,Side Output 承接迟到和异常数据。生产上重点是 Key 设计、事件时间语义、状态 TTL、定时器规模和外部写入幂等。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
普通 map 只能处理当前这条数据。
当需求变成等待十分钟、记住历史状态、超时后走旁路,ProcessFunction 才真正登场。
ProcessFunction 是 Flink DataStream 的底层处理抽象,适合同时需要事件、状态、定时器和旁路输出的复杂逻辑。
它比 map 多了哪些能力
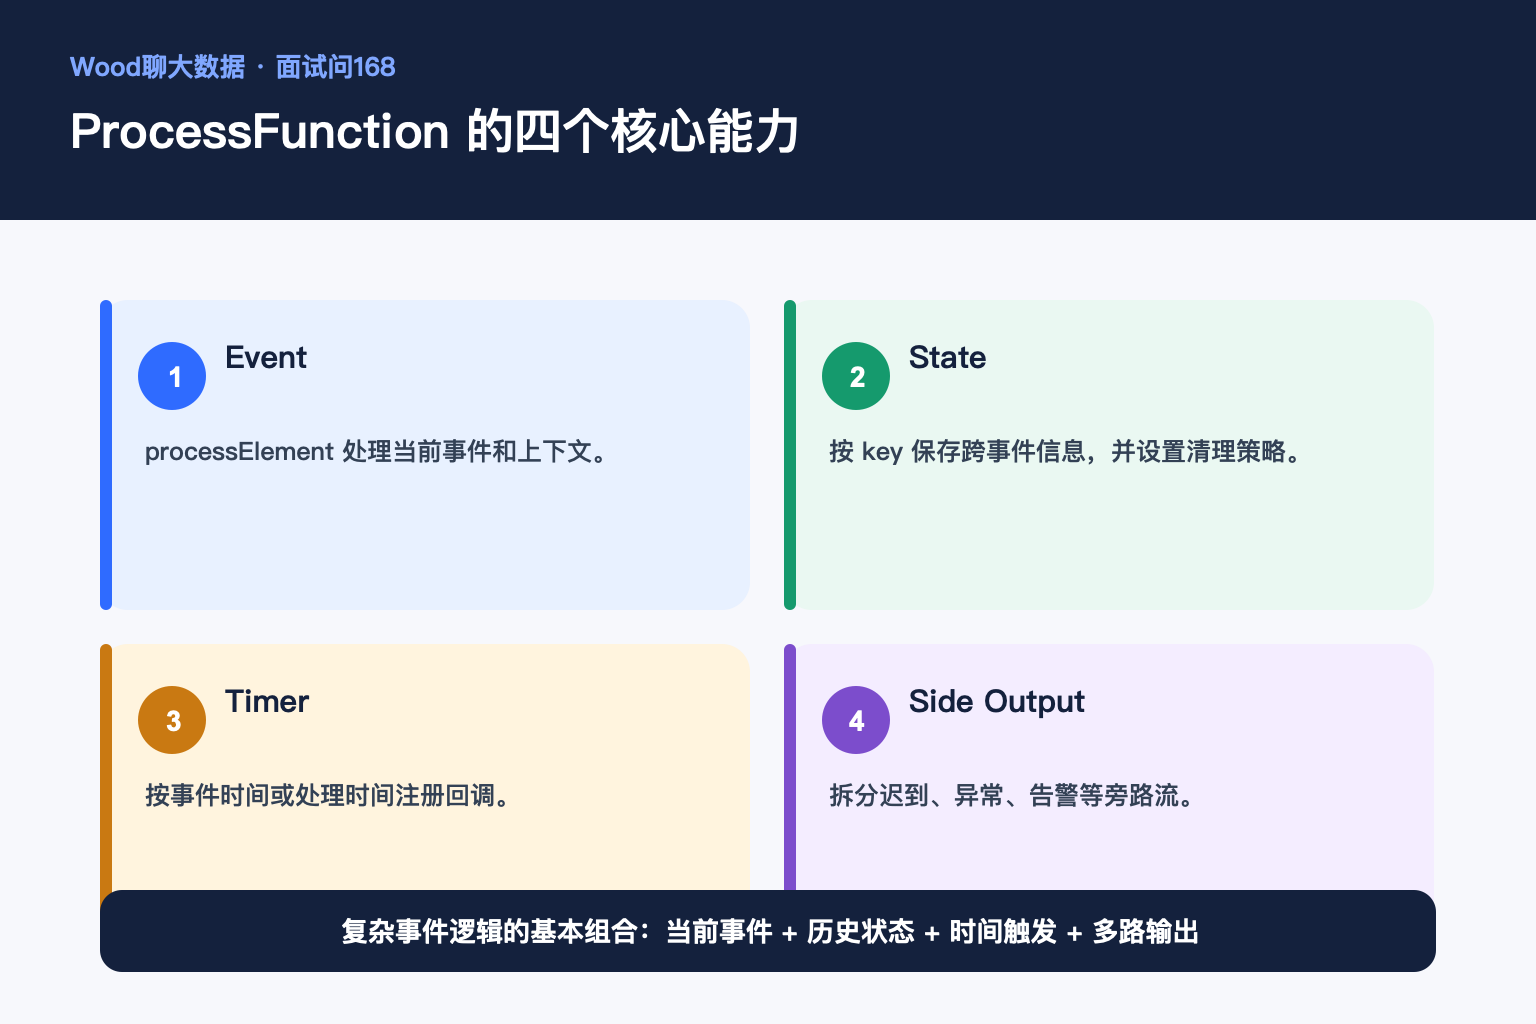
ProcessFunction 不只接收元素和输出结果,还能访问上下文中的时间戳、TimerService,并向 Side Output 输出数据。KeyedProcessFunction 在 KeyedStream 上工作,可以使用按 key 隔离的状态和定时器,适合无法用简单窗口或聚合表达的业务规则。
状态保存跨事件的信息
例如检测用户连续登录、订单创建后是否支付、设备最近一次状态。先 KeyBy 选择稳定业务键,再用 ValueState、ListState 或 MapState 保存必要信息。状态应该尽量小,并设计 TTL 或显式清理,否则 key 数持续增长会把状态后端拖垮。
定时器把等待变成可恢复逻辑
事件时间定时器根据 Watermark 推进,适合对乱序数据按业务时间判断;处理时间定时器根据机器时钟,响应快但结果更受运行环境影响。定时器和 keyed state 一起参与容错恢复,但回调逻辑仍要考虑重复执行和外部写入幂等。
Side Output 让主链路保持清晰
迟到数据、解析失败、风控告警和调试信息可以使用 OutputTag 发送到不同旁路流,避免把所有分支塞进一个结果类型。旁路不是垃圾桶,每条流仍要定义消费方、保留周期和监控。
一个典型场景
订单创建后 15 分钟未支付就发送超时事件。按 order_id KeyBy,创建事件写入状态并注册事件时间定时器;支付到达后更新状态并删除定时器;定时器触发时再次检查状态,确认未支付再输出。迟到支付可以进入 Side Output,交给补偿流程。
参考资料
- Apache Flink Process Function 文档:https://nightlies.apache.org/flink/flink-docs-stable/docs/dev/datastream/operators/process_function/