Flink State Backend 怎么选?
本文目录
面试怎么回答
我会从状态规模、访问延迟、Checkpoint 大小、恢复时间和运维环境选择。HashMap 状态在 JVM Heap,访问快但受内存和 GC 限制;EmbeddedRocksDB 依靠本地磁盘扩展,支持增量 Checkpoint,但有序列化和磁盘成本;新版本 ForSt 更适合远端状态和存算分离,但要评估缓存与远端延迟。我还会把 State Backend 和 Checkpoint Storage 分开设计,并用故障恢复演练验证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
状态只有几百 MB 时追求极致访问速度,和状态达到数 TB 时追求扩展与恢复,答案不会相同。
State Backend 不是“配置一个存储路径”这么简单。
State Backend 决定运行时状态的组织和快照方式;选型要同时看访问延迟、状态容量、Checkpoint、恢复和运维边界。
HashMap:低延迟,但容量受堆内存约束
HashMapStateBackend 把状态对象放在 JVM Heap 中,访问路径直接,适合状态规模可控、延迟敏感的任务。
它会增加堆内存和 GC 压力,状态容量受到 TaskManager 内存边界限制。状态增长速度无法预估时,不能只因为基准测试快就直接选择。
EmbeddedRocksDB:用本地磁盘换容量
EmbeddedRocksDBStateBackend 把状态序列化为字节并存入本地 RocksDB,容量可以扩展到本地磁盘,也支持增量 Checkpoint。
代价是每次状态访问包含序列化,必要时还会访问磁盘;RocksDB 的 BlockCache、WriteBuffer、Compaction 和本地盘性能都会影响延迟。
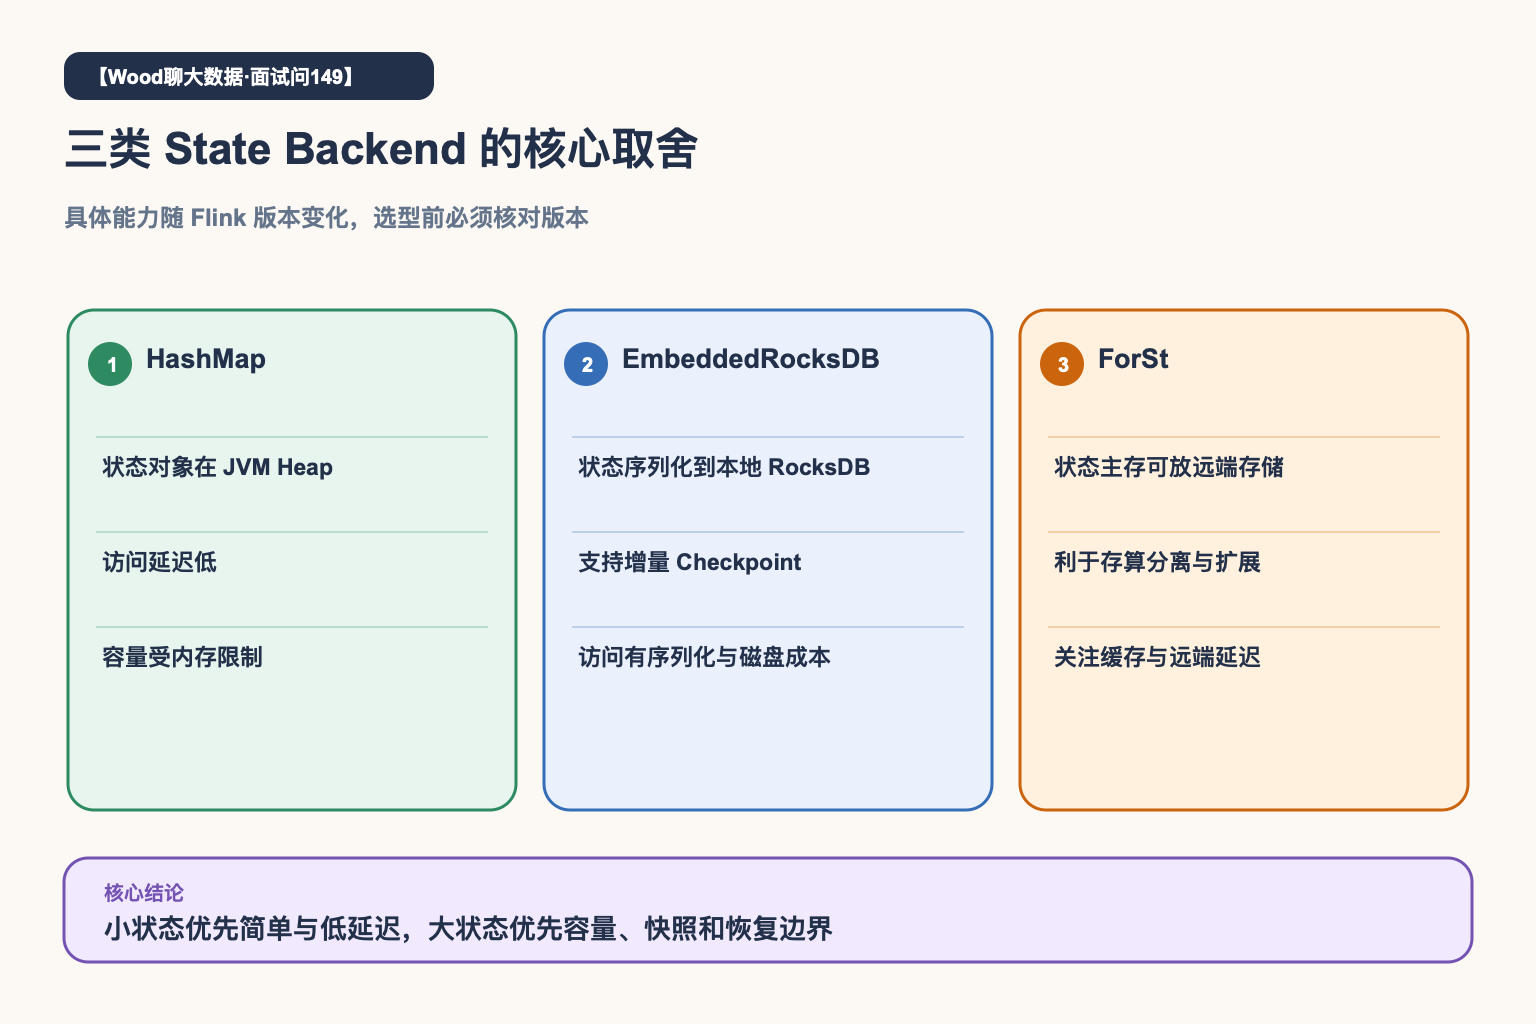
ForSt:关注存算分离和远端状态
较新的 Flink 版本提供 ForStStateBackend,可把主要状态文件放在远端持久存储,并通过本地缓存降低访问成本,适合状态超过本地盘或希望快速弹性伸缩的场景。
它也带来远端 I/O、缓存命中和版本成熟度等新问题。是否可用、支持哪些能力,要以实际 Flink 版本和云环境为准。
别把 Backend 和 Checkpoint Storage 混为一谈
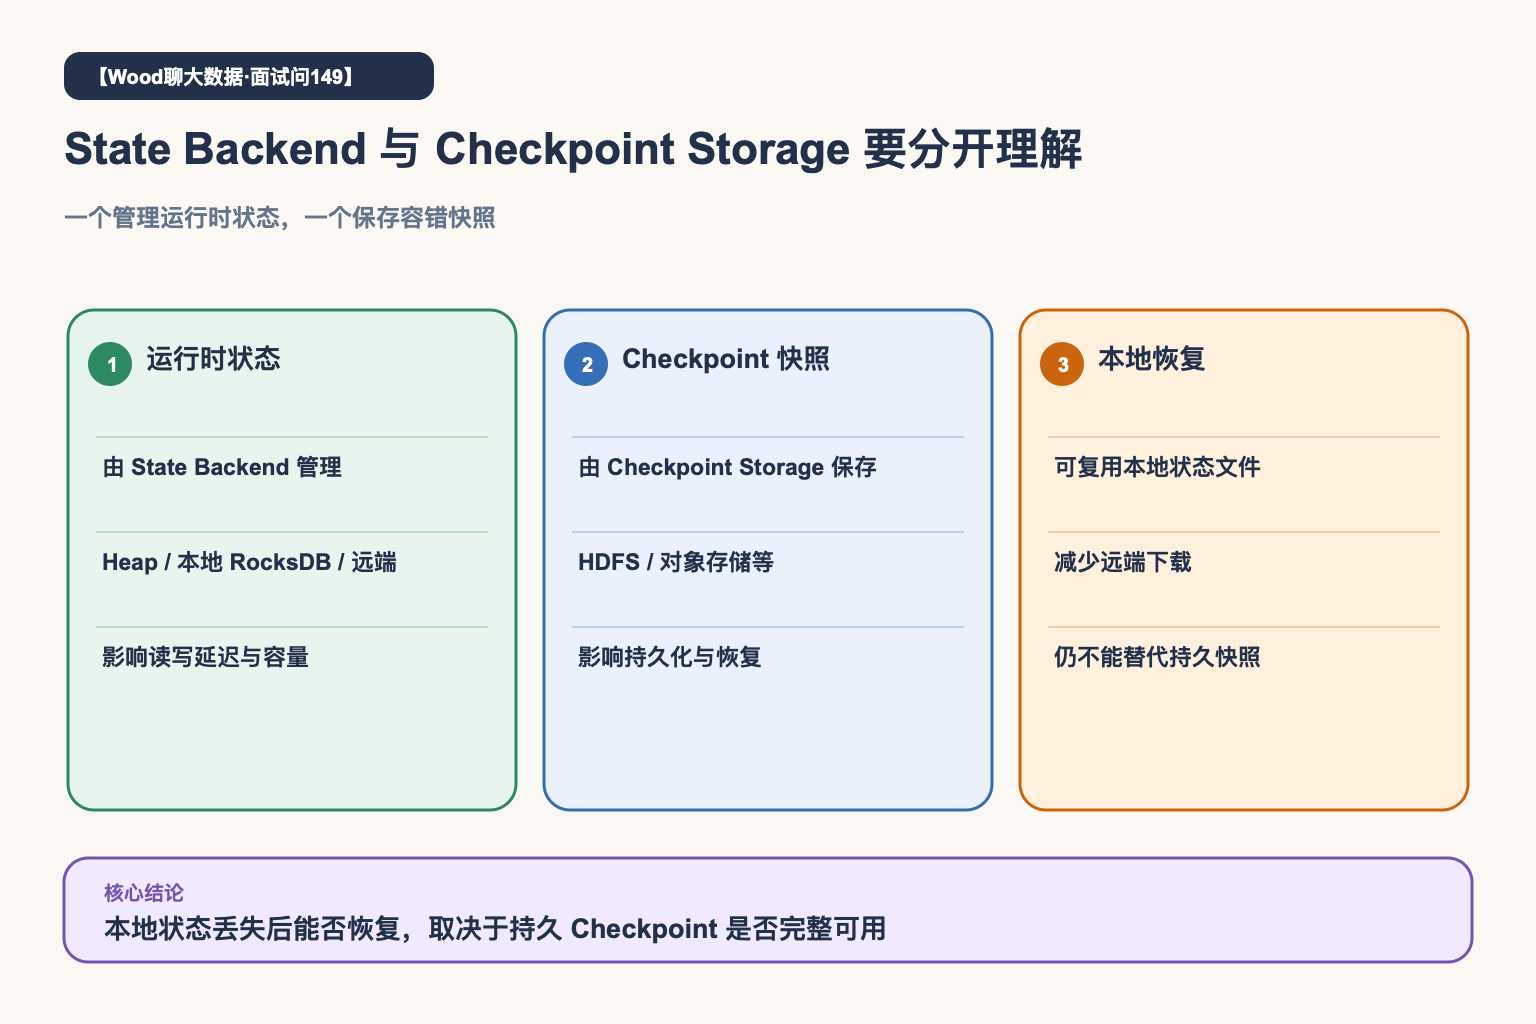
State Backend 管理运行时状态;Checkpoint Storage 决定 Checkpoint 元数据与快照文件持久保存在哪里。两者从 Flink 1.13 起在公共配置中明确拆分。
即使运行时状态在本地 RocksDB,真正容灾仍要依靠可靠的 HDFS 或对象存储 Checkpoint。
一个典型场景
某任务为降低状态访问延迟使用 HashMap,业务增长后状态持续扩大,Full GC 和 Checkpoint 时间一起上升。只增加并行度能暂时缓解,却没有解决状态无界增长。
重新评估 TTL、状态粒度后,将大状态迁移到可扩展 Backend,并验证 Savepoint 兼容和恢复耗时,任务才稳定。
选 Backend 之前,先控制状态为什么增长,再决定状态放在哪里。