Flink 停任务时 cancel、stop 和 drain 怎么选?
面试怎么回答
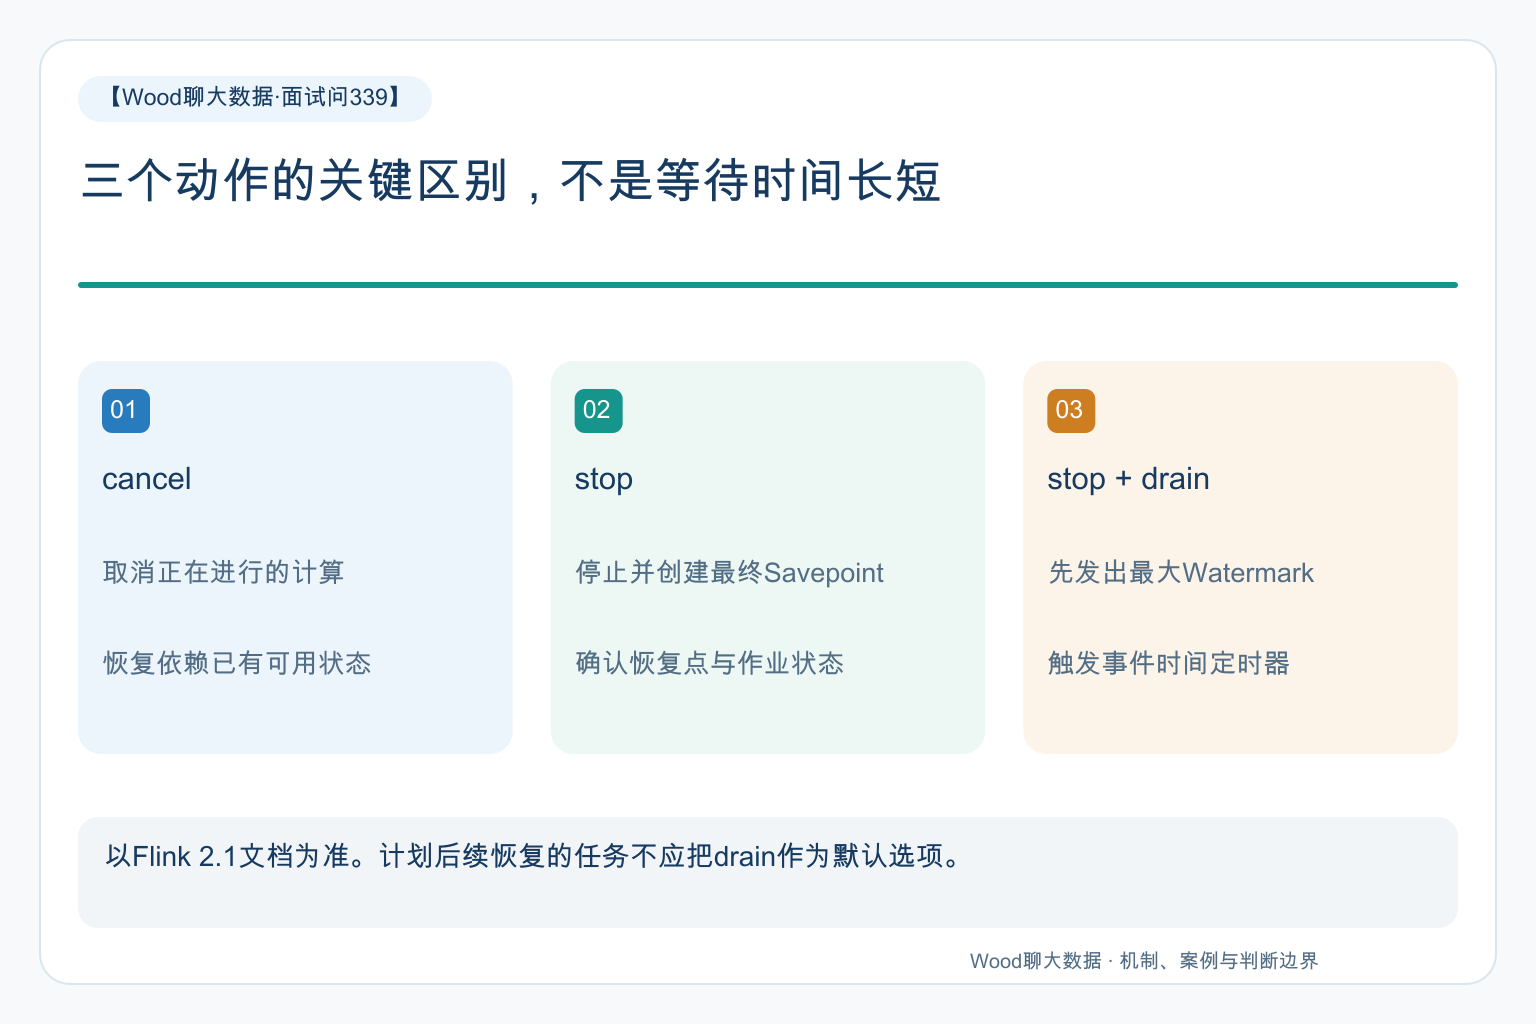
我会先问是临时升级还是永久结束。cancel是取消计算,不能当作本次自动生成恢复点;stop带最终Savepoint更适合有恢复需求的停止。drain会推进最大Watermark并触发事件时间定时器,不只是等待缓冲清空,通常用于永久终结。计划恢复时不默认加drain,还要检查Savepoint可用、作业最终状态和Sink提交,不能只看命令返回。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
停止计算、带Savepoint暂停和终结事件时间并非同一件事;是否还要恢复处理未来事件,决定了能否使用drain。
先把暂停和结束分开
临时升级希望恢复后继续处理未来事件;永久结束则希望把当前流的最终结果尽量完成。两种目标对窗口和定时器的要求不同。
一个事件时间窗口尚未到结束时点,暂停时可以把相关状态保留下来,之后继续接收事件。如果人为宣告事件时间已经走到终点,窗口可能提前进入最终处理阶段。
因此优雅不是某个固定命令的名字,而是停止过程符合数据语义,状态可以解释,外部结果能够验收。
cancel与stop解决的事情不同
在Flink 2.1中,cancel取消运行中的计算。它不能被理解为“顺便为这次停止创建了一个新的可靠恢复点”。
之前是否存在可用于恢复的Checkpoint或Savepoint、是否保留以及怎样恢复,取决于配置和实际产物,不能因为控制台显示Cancelled就认为状态一定可续用。
stop会以更有序的方式沿数据流停止并创建最终Savepoint。仍要确认该操作完成、路径可访问、作业到达预期最终状态,以及当前Source和Sink支持的具体行为。
drain不是简单地把队列读空
官方说明,drain会在最后的Checkpoint Barrier之前发出MAX_WATERMARK,使已注册的事件时间定时器触发,推动等待事件时间的计算完成。
这会影响窗口结束、超时判断及其他基于事件时间的业务逻辑。它不意味着把Kafka未来还会产生的所有消息都读完,也不是对所有外部缓冲和异步副作用的笼统保证。
文档明确提醒:如果打算稍后恢复任务,不应排空这条流水线,因为恢复后可能产生不正确的结果。这里的风险来自时间语义被终结,而不仅是状态文件是否存在。
不要把事件时间定时器与处理时间定时器混为一谈;最大Watermark作用于事件时间,具体用户逻辑仍需要测试。
一个典型场景:例行升级触发大量超时订单
假设任务等待订单支付,在事件时间超过期限后输出未支付结果。升级脚本一律执行带drain的停止,停机瞬间出现大量超时输出。
起初认为上游时间戳跳到了未来,排查发现业务事件本身正常,停止流程却推进了最大Watermark。原本仍在等待中的定时器被集中触发,业务将其解释成真实超时。
旧验收只检查Savepoint文件生成,没有核对停机期间的业务输出。修正首先按业务事实核对并处理误发结果,再区分临时升级与永久终止脚本,测试恢复后的窗口及定时器行为。
不能为了快速恢复而直接删除这些输出。是否撤回以及怎样修正,需要遵循目标系统的业务规则,并保留可追溯记录。
停止成功不等于外部世界已经一致
任务停止过程中可能还有最终输出与Sink提交。需要核对外部目标是否完成预期提交、是否存在待处理事务或失败重试,而不是只看客户端打印的路径。
恢复前还要确认代码、算子标识和状态结构兼容,数据源可以从恢复位置继续读取,目标端能够承受合法重放。停机方式选对了,也不能绕过这些恢复条件。
若只是应急止损,可能需要立即取消,但应明确这会依赖现有恢复点并可能引入回放。安全操作顺序应服从已确认的故障范围,不能为了形式上的优雅延长错误输出。
面试里要给出可验证的决策
可以用三个问题组织回答:后续是否恢复;是否允许此刻终结事件时间;停止后怎样证明状态与外部输出正确。
这样的回答既讲清API差异,也说明你知道窗口、定时器和业务副作用之间的联系。不要把drain当成一个可以让所有停机都更安全的万能开关。