Flink Checkpoint 和 Savepoint 有什么区别?
面试怎么回答
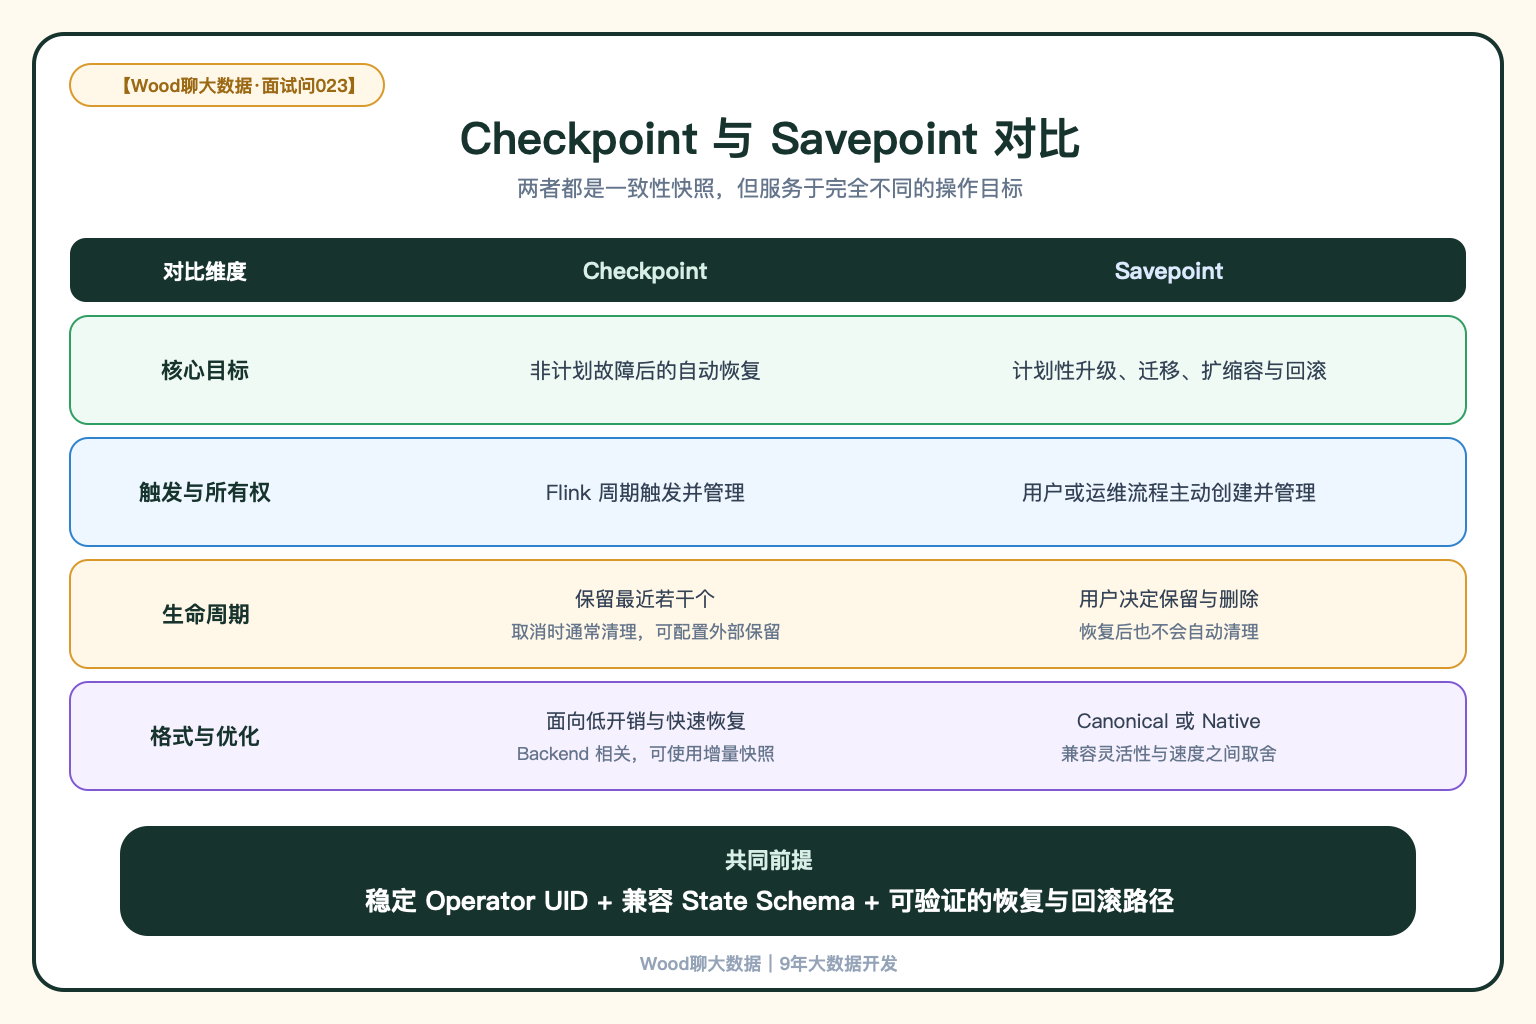
两者都是一致性状态快照,但目标不同。Checkpoint 由 Flink 高频管理,主要用于任务异常后的自动恢复,强调低开销和恢复速度;Savepoint 由用户主动创建和维护,主要用于版本升级、迁移、扩缩容和计划性停机,强调运维灵活性。Savepoint 还分 Canonical 和 Native 格式,能力不完全相同。实际升级时还要保证 Operator UID、State Schema 和并行度兼容,并提前做恢复与回滚验证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会回答:
“Checkpoint 是自动触发,Savepoint 是手动触发。”
这句话没错,但只讲了表面差异。
两者都是一致性状态快照,真正不同的是:
Checkpoint 服务于非计划故障恢复,Savepoint 服务于有计划的停机、升级、迁移和扩缩容。
第一步:看它们为谁负责
Checkpoint:系统恢复机制
Checkpoint 通常由 Flink 周期性触发和管理,目的是让任务失败后自动从最近成功快照恢复。
它更关注:
- 触发开销足够低
- 可以频繁执行
- 故障后恢复足够快
- 生命周期由作业和 Flink 管理
普通 Checkpoint 在任务取消后通常会被清理;如果配置 Externalized Checkpoint,可以选择在取消后保留,用于人工恢复。
Savepoint:用户运维资产
Savepoint 通常由用户或运维流程主动触发,用于停机重启、版本升级、修改作业拓扑、迁移集群或调整并行度。
它由用户管理,不会因为任务结束自动删除。创建、保存、恢复和清理都需要明确的运维责任。
第二步:看格式和可迁移性
Checkpoint 主要针对同一个作业的快速故障恢复,通常采用与 State Backend 相关的格式,也可能是增量快照。
Savepoint 更关注运维灵活性。
Savepoint 可以选择:
- Canonical Format:兼容性和可迁移性更强,但创建与恢复可能更慢
- Native Format:更贴近 State Backend,通常更快,但迁移能力有限
因此不能简单说“Savepoint 一定是全量、一定能跨 Backend”。具体能力要看保存格式和 Flink 版本。
第三步:状态能否恢复,关键还在 Operator UID
有了 Savepoint,不代表修改代码后一定能恢复。
Flink 需要把快照里的状态映射回新作业中的算子。如果没有显式设置稳定的 Operator UID,修改算子顺序、增加算子或重构拓扑后,自动生成的 ID 可能变化,导致状态无法匹配。
所以状态任务在上线时就应该:
- 为有状态算子设置稳定 UID
- 评估 State Schema 是否兼容
- 确认最大并行度和 Key Group 约束
- 在升级前验证新作业能否从 Savepoint 恢复
- 保留回滚版本和原始 Savepoint 路径
Savepoint 是升级载体,UID 和状态兼容性才是能否成功升级的合同。
第四步:生产中怎么选择
可以用一个简单判断:
非计划故障
机器故障、进程异常、网络抖动时,优先依赖 Checkpoint 自动恢复。
计划性变更
发布新版本、调整并行度、迁移集群或修改拓扑时,主动创建 Savepoint,并验证后从指定路径恢复。
临时保底
Externalized Checkpoint 可以作为额外恢复入口,但它仍然不等同于经过版本兼容验证、由用户长期管理的 Savepoint。
不要因为集群里存在 Checkpoint,就省略升级前的 Savepoint 和恢复演练。
一个典型场景
比如一个有状态聚合任务准备升级,发布前只确认最近一次 Checkpoint 成功,就直接停止旧任务并上线新代码。
新版本调整了算子链,也没有显式设置 UID。启动时,快照里的状态无法映射到新算子,最后只能无状态启动或回退代码。
更稳妥的流程应该是:旧任务创建并记录 Savepoint,验证新版本的 UID 和 State Schema 兼容,从 Savepoint 在隔离环境恢复,再执行正式切换,并保留明确回滚路径。
Checkpoint 解决“任务突然挂了怎么办”,Savepoint 解决“我要主动改变任务怎么办”。