Flink SQL Changelog 是什么?
面试怎么回答
Flink SQL 把流式查询看成持续变化的动态表,Changelog 用 +I、-U、+U、-D 表示插入、更新前、更新后和删除。过滤类查询可能是 Append,聚合、去重、TopN 常产生 Upsert 或 Retract。落地前要判断查询的 Changelog Mode、定义可靠主键,并确认 Sink 是否支持对应更新和删除语义。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一条 GROUP BY SQL 跑得好好的,换了一个只支持追加写的 Sink 就失败了。
原因不是聚合不能流式算,而是结果会更新,Sink 却只接受新增。
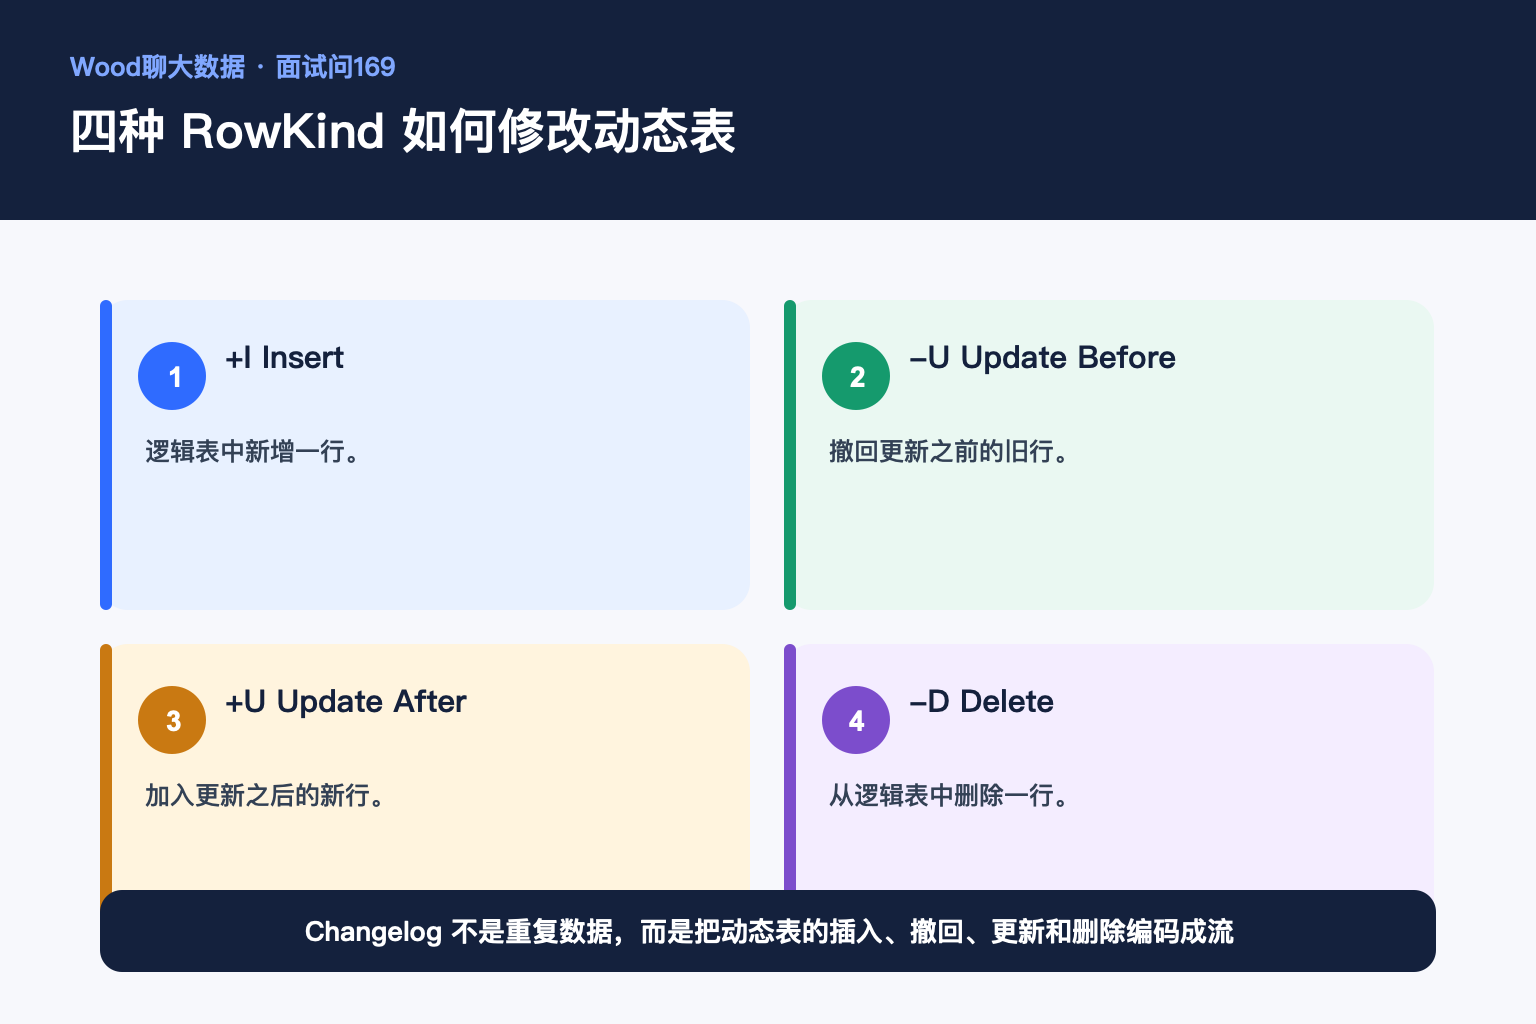
流式 SQL 的聚合、Join 和去重会持续修改动态表,Changelog 用 RowKind 把这些变化编码成消息。
动态表不是一次性结果集
流式表会随着输入事件持续更新。简单过滤可以只追加新行,但 GROUP BY、去重、TopN 和部分 Join 会修改此前已经输出的结果。Changelog 把表的变化编码为事件,使下游能逐步维护同一张逻辑表。
四种 RowKind 表达什么
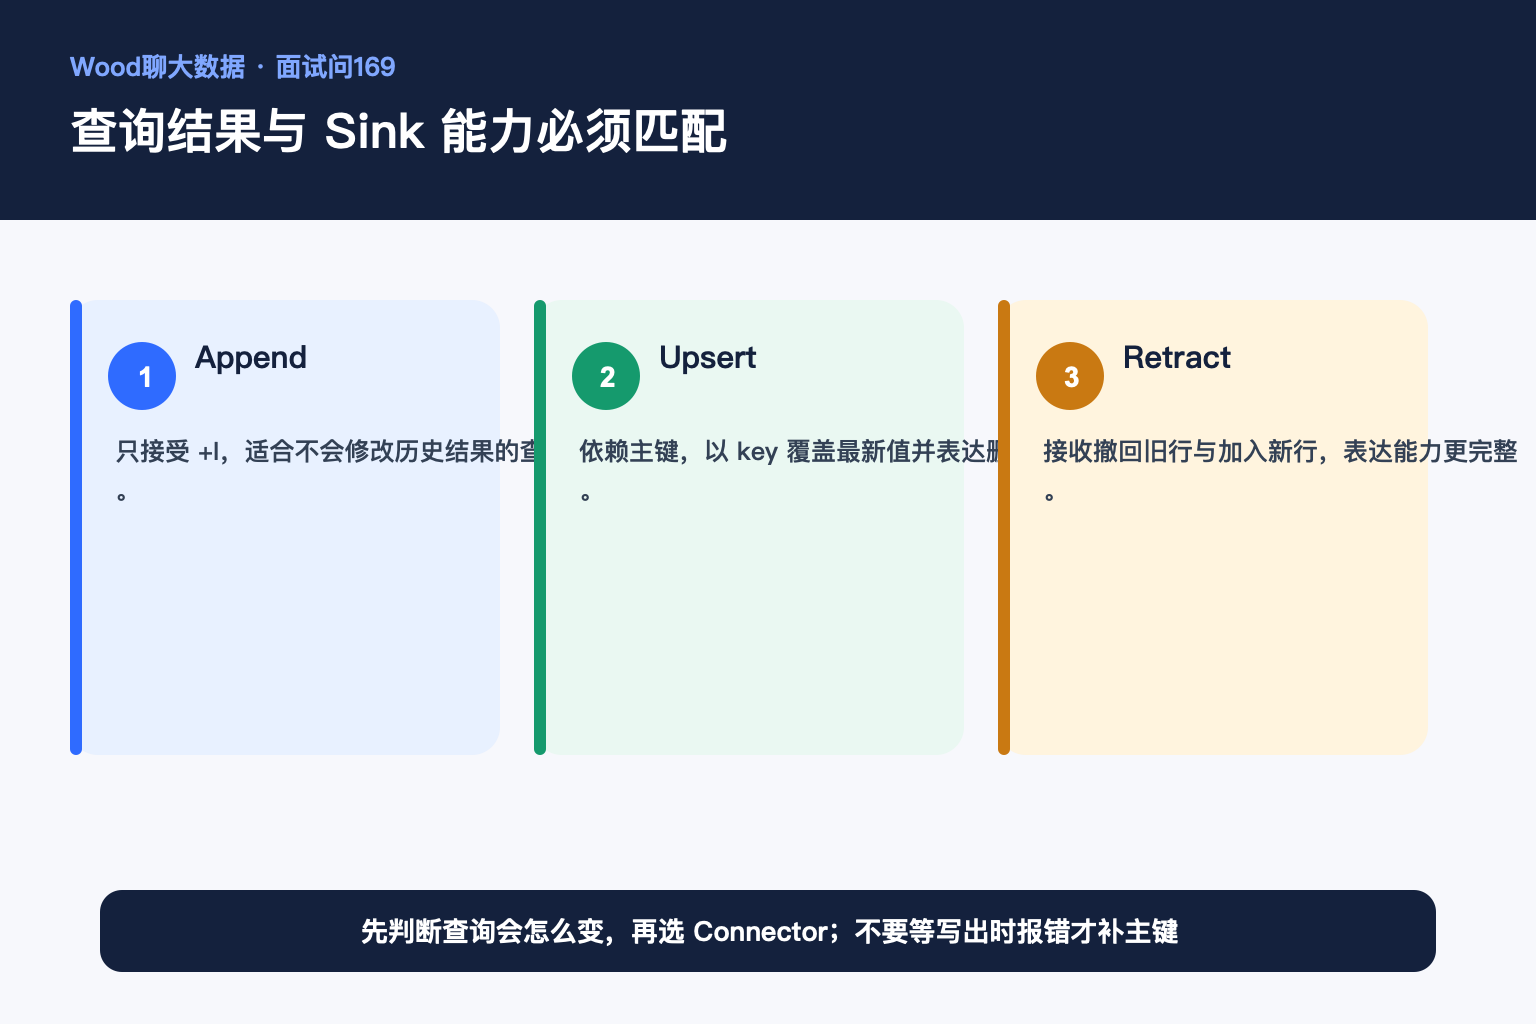
+I 表示插入,-D 表示删除,-U 和 +U 分别表示更新前与更新后。不同算子和规划可能输出不同组合。Upsert 模式通常依靠主键只发送新值和删除;Retract 模式则显式撤回旧值再加入新值。
为什么主键很关键
下游要把一次更新作用到正确记录上,必须能识别同一逻辑行。声明不强制校验的主键,会给优化器和 Connector 提供唯一性信息,但数据本身仍要满足约束。没有可靠主键时,下游可能只能按完整旧行撤回,或者根本无法接受更新。
Sink 必须接受查询产生的变更模式
Append-only 文件 Sink 适合只产生 +I 的查询。Upsert Kafka、支持主键更新的数据库或 Lakehouse Connector 可以接收相应更新。Connector 会声明自己支持的 Changelog Mode;如果查询需要更新或删除而 Sink 不支持,规划阶段就可能失败。
一个典型场景
按 user_id 实时统计累计消费。第一笔订单产生 +I,后续订单到达时累计金额改变,结果需要更新旧值。若写入普通追加 Topic,下游会看到同一用户多行;若定义可靠主键并使用 Upsert Sink,下游可以按 key 覆盖成最新结果。
参考资料
- Apache Flink Dynamic Tables 与 Table Connector 文档:https://nightlies.apache.org/flink/flink-docs-stable/docs/dev/table/sourcessinks/