Flink SQL MiniBatch 和 Local-Global 聚合怎么优化吞吐?
面试怎么回答
MiniBatch 在小批范围合并更新,主要减少同键反复访问状态;Local-Global 先做局部聚合,再按键全局合并,减少网络明细量。它们适合有一定延迟预算、键重复较多且聚合可合并的场景。我会检查真实计划,验证局部压缩比例、吞吐和端到端延迟,并测试更新撤回;高基数负载不一定受益。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
每秒大量订单都在更新同一个店铺的销售额,聚合状态被反复读取、写入。业务能接受稍微晚一点看到结果,这一点延迟空间,能不能换成更高的吞吐?
MiniBatch 合并短时间内的更新以减少状态访问,Local-Global 在网络重分布前做局部聚合;收益取决于键重复程度、可合并语义和延迟预算。
逐条聚合为什么可能成本很高
持续聚合每来一条记录,就可能访问相应键的状态并产生下游更新。相同店铺在短时间内反复出现时,很多工作是在重复读取和修改同一个累加器。
MiniBatch 允许先缓冲一小批输入,再合并部分同键变化,减少状态访问次数。它提供的是吞吐与结果延迟的取舍,不会让窗口含义、事件时间或业务指标口径自动改变,实际算子支持要看执行计划与版本。
批量大小和等待时间要一起设计
常见配置会同时约束批量大小和允许的等待延迟,避免低流量时一直等不够一批。允许延迟只是算子内部的缓冲预算,端到端仍有排队、网络、检查点和下游写入时间。
调参前先测量当前延迟组成。如果下游写入已经占了大部分时间,继续扩大 MiniBatch 可能只让告警更晚。批次变大也会占用更多缓冲内存,并让输出更加集中,需要确认接收端能承受这种节奏。
Local-Global 减少重分布前的明细量
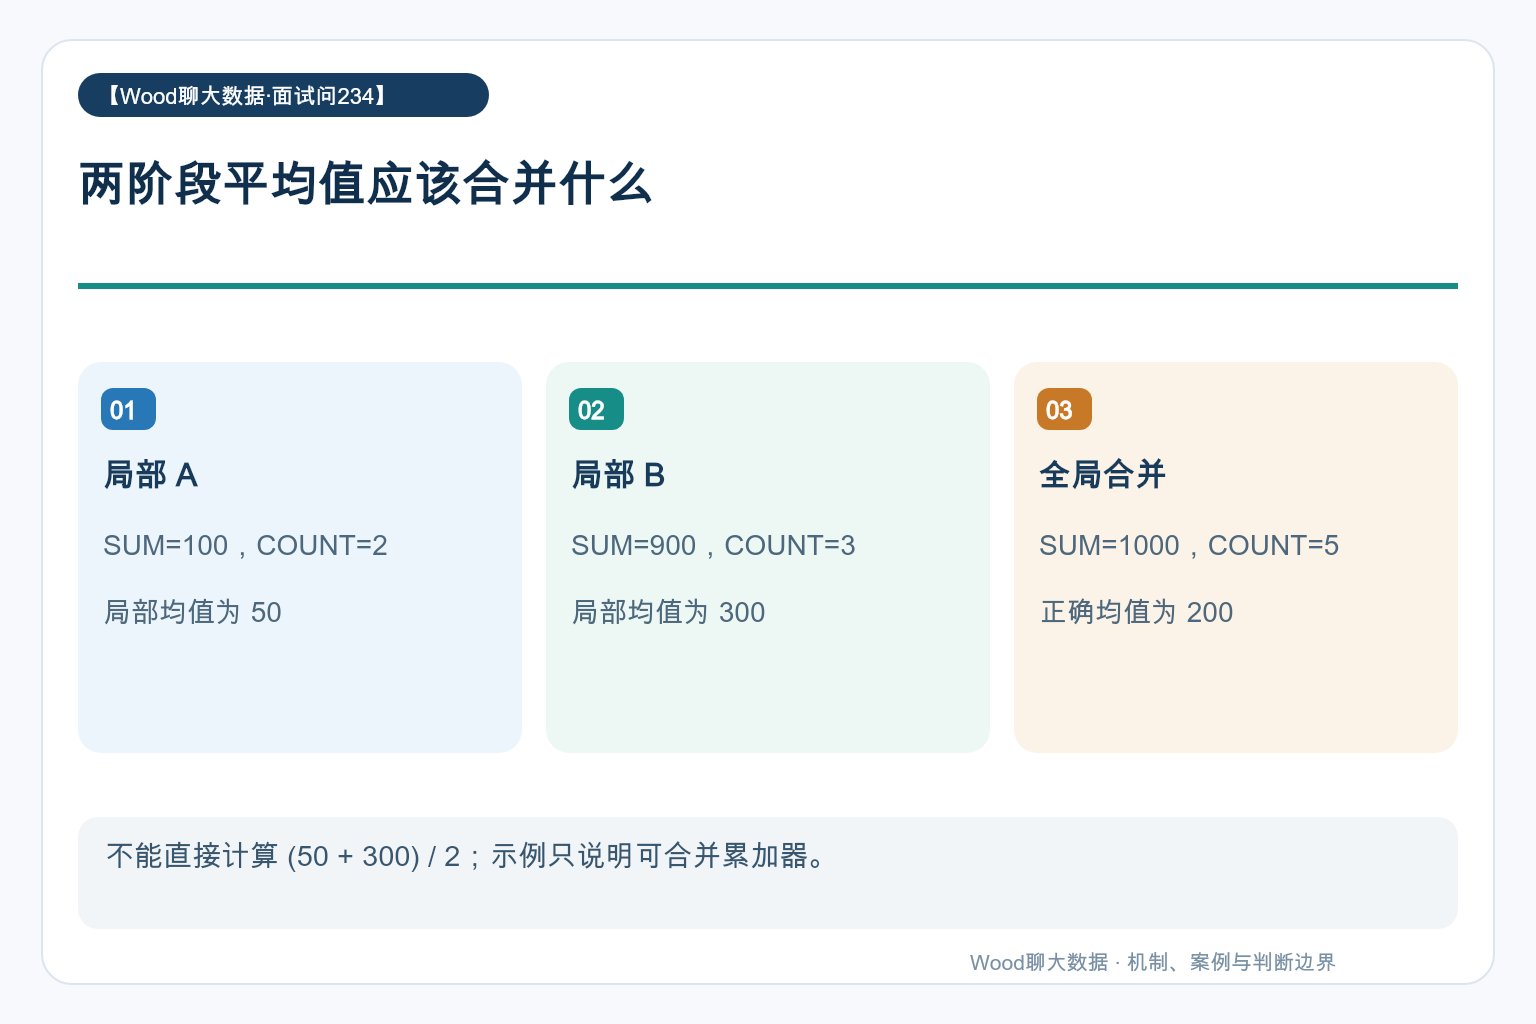
两阶段聚合在上游局部形成累加器,随后按业务键发送给全局聚合,合并得到最终结果。SUM 可以合并局部和,AVG 则应保留局部和与计数,再计算总体平均,不能直接平均各局部平均值。
该优化要求聚合可以按实现支持的方式合并,某些 DISTINCT 或自定义聚合需要其他策略。Flink SQL 文档中的两阶段聚合与 MiniBatch 有配合条件,配置是否生效不能只看参数值,要检查实际计划。
一个典型场景:参数开了却没有收益
比如同一时段每条数据几乎都是新用户,批内相同键很少,打开 MiniBatch 后状态访问下降有限,延迟反而增加。最初怀疑配置没有生效,计划确认后才发现缺少同键重复这个收益前提。
原压测使用了少数店铺循环生成的数据,线上却是大量高基数用户。修正方法是用真实键分布评估批内压缩比例,分别测吞吐、延迟和状态请求量。参数开启成功,不等于它适合当前负载。
用指标证明局部合并确实发生
验证可以对比局部输入与输出记录量、网络传输、状态访问开销、反压和业务结果延迟,同时检查下游更新条数是否下降。仅看作业总 CPU 下降,可能只是缓冲让结果晚输出。
还需要覆盖撤回与更新输入,验证累加器正确处理正负变化。对于超热点键,两阶段能减少部分数据量,但最终仍有全局汇总点;如果局部结果仍过密或状态计算很重,需要继续分析业务粒度与算子负载。