Flink Side Output 什么时候用?
面试怎么回答
Flink Side Output 用来让一个算子在主输出之外产生一个或多个带类型的旁路流,常见于脏数据、迟到数据、告警和不同类型结果的分流。实现上用 OutputTag 标识旁路,在 ProcessFunction 中通过 Context 输出,再从主算子结果获取对应 Side Output。它比复制多份流再 Filter 更适合复杂上下文和异构类型,但旁路仍要设计下游、监控、幂等和补偿闭环。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一条实时链路里,正常数据要继续计算,脏数据要告警,迟到数据还要单独补偿。
如果把同一条流复制三份再分别 filter,逻辑能跑,但规则容易分散,数据也会被重复判断。
这时可以考虑:Flink Side Output。
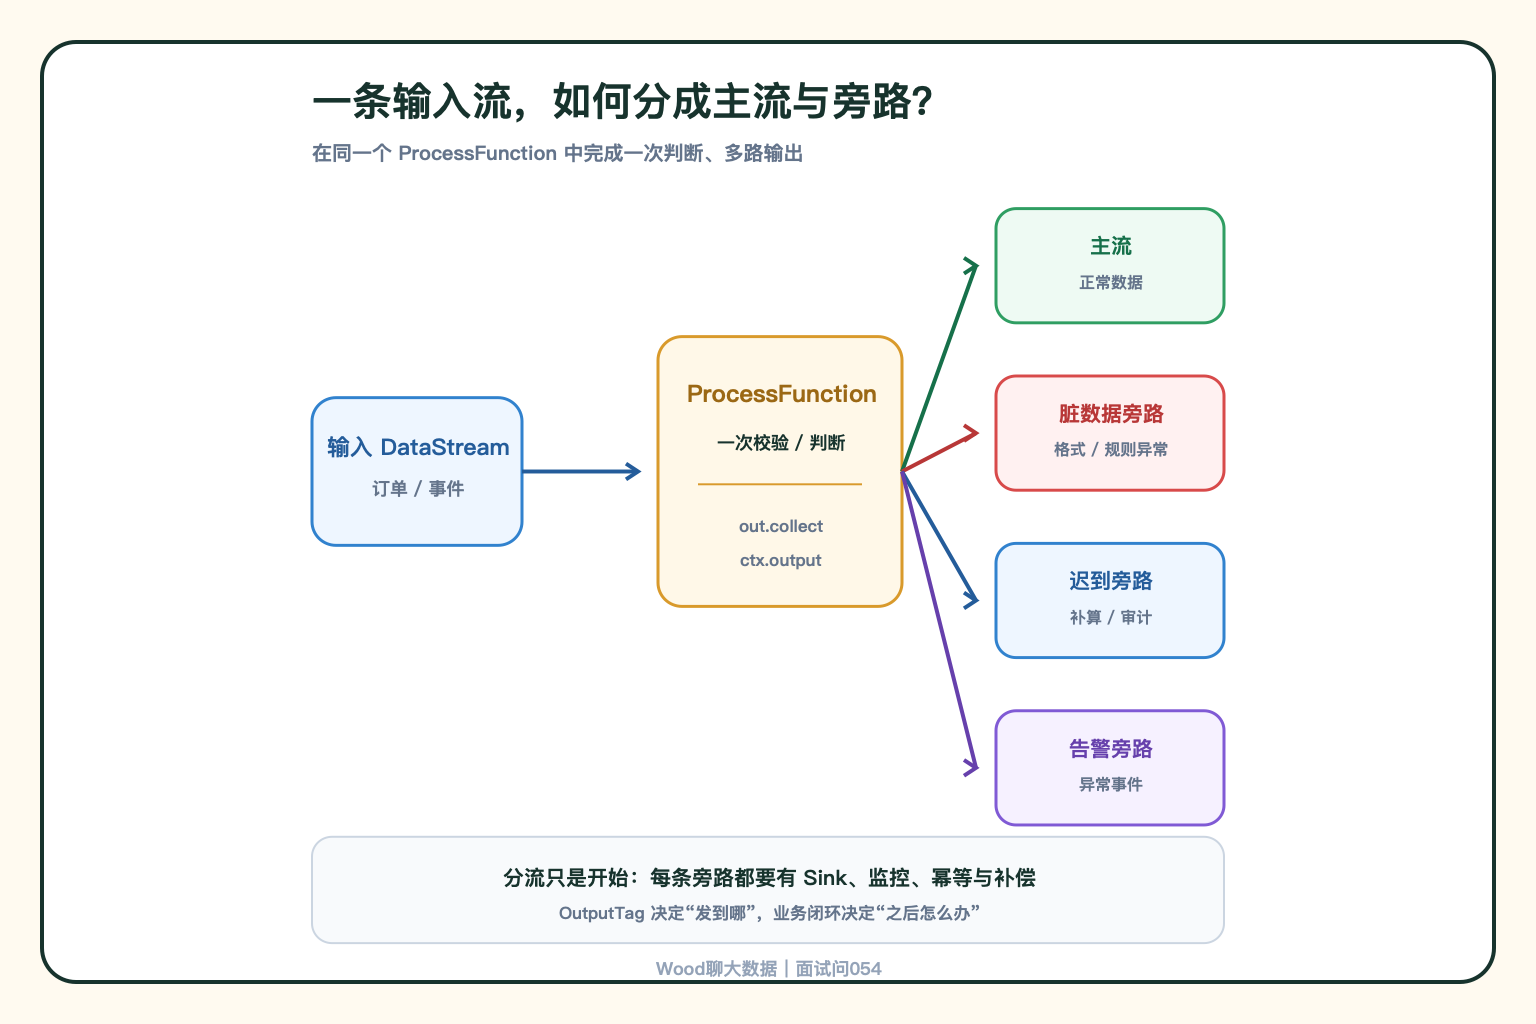
Side Output 的核心不是“多输出一个 Topic”,而是让一个算子在输出主流的同时,把特定数据按类型路由到一个或多个旁路流。
什么时候适合使用?
脏数据与异常数据分流
正常记录进入主计算,字段缺失、格式错误或规则异常的记录进入旁路,后续写入错误表或告警系统。
迟到数据单独处理
窗口已经关闭后到达的数据,可以进入迟到数据旁路,再做补算、审计或人工核查。
同一判断产生不同类型结果
主流输出订单对象,旁路输出告警对象。Side Output 的数据类型可以与主流不同,不必为了复用一个类型而硬塞字段。
把少量特殊分支留在同一算子
当分流条件依赖 ProcessFunction 中的时间、状态或复杂判断时,在同一处完成判断通常更容易保持口径一致。
怎么实现?
Java API 中,先定义带类型的 OutputTag:
final OutputTag<DirtyRecord> dirtyTag =
    new OutputTag<DirtyRecord>("dirty-data") {};
在 ProcessFunction 中输出:
if (isValid(value)) {
    out.collect(value);
} else {
    ctx.output(dirtyTag, toDirtyRecord(value));
}
再从主算子结果中取出旁路:
DataStream<DirtyRecord> dirtyStream =
    mainStream.getSideOutput(dirtyTag);
Java 中常用匿名内部类保留泛型类型信息。OutputTag 的标识和类型要与输出、获取时保持一致。
它和 Split、Filter 有什么区别?
如果只是把同一种类型按简单条件拆成几个独立流,多个 filter 也能完成。
Side Output 更适合:
- 分流发生在 ProcessFunction 的复杂上下文里
- 旁路类型与主流不同
- 希望一次判断完成多路输出
- 分支属于异常、迟到、告警等辅助链路
但不要把一个算子做成“万能路由中心”。分支过多、规则频繁变化时,算子职责会变重,测试和运维也更复杂。
生产里还要注意什么?
- 每条旁路都要明确下游去向,不能只输出不消费
- 为主流和旁路分别监控流量、失败量和延迟
- 脏数据要保留失败原因、原始内容和处理时间
- 旁路 Sink 同样要考虑幂等、Checkpoint 与故障恢复
- 迟到数据旁路要和 Watermark、Allowed Lateness 策略一起设计
Side Output 解决的是算子内分流,不会自动解决旁路数据的闭环。