Flink keyBy、rebalance 和 rescale 有什么区别?
本文目录
面试怎么回答
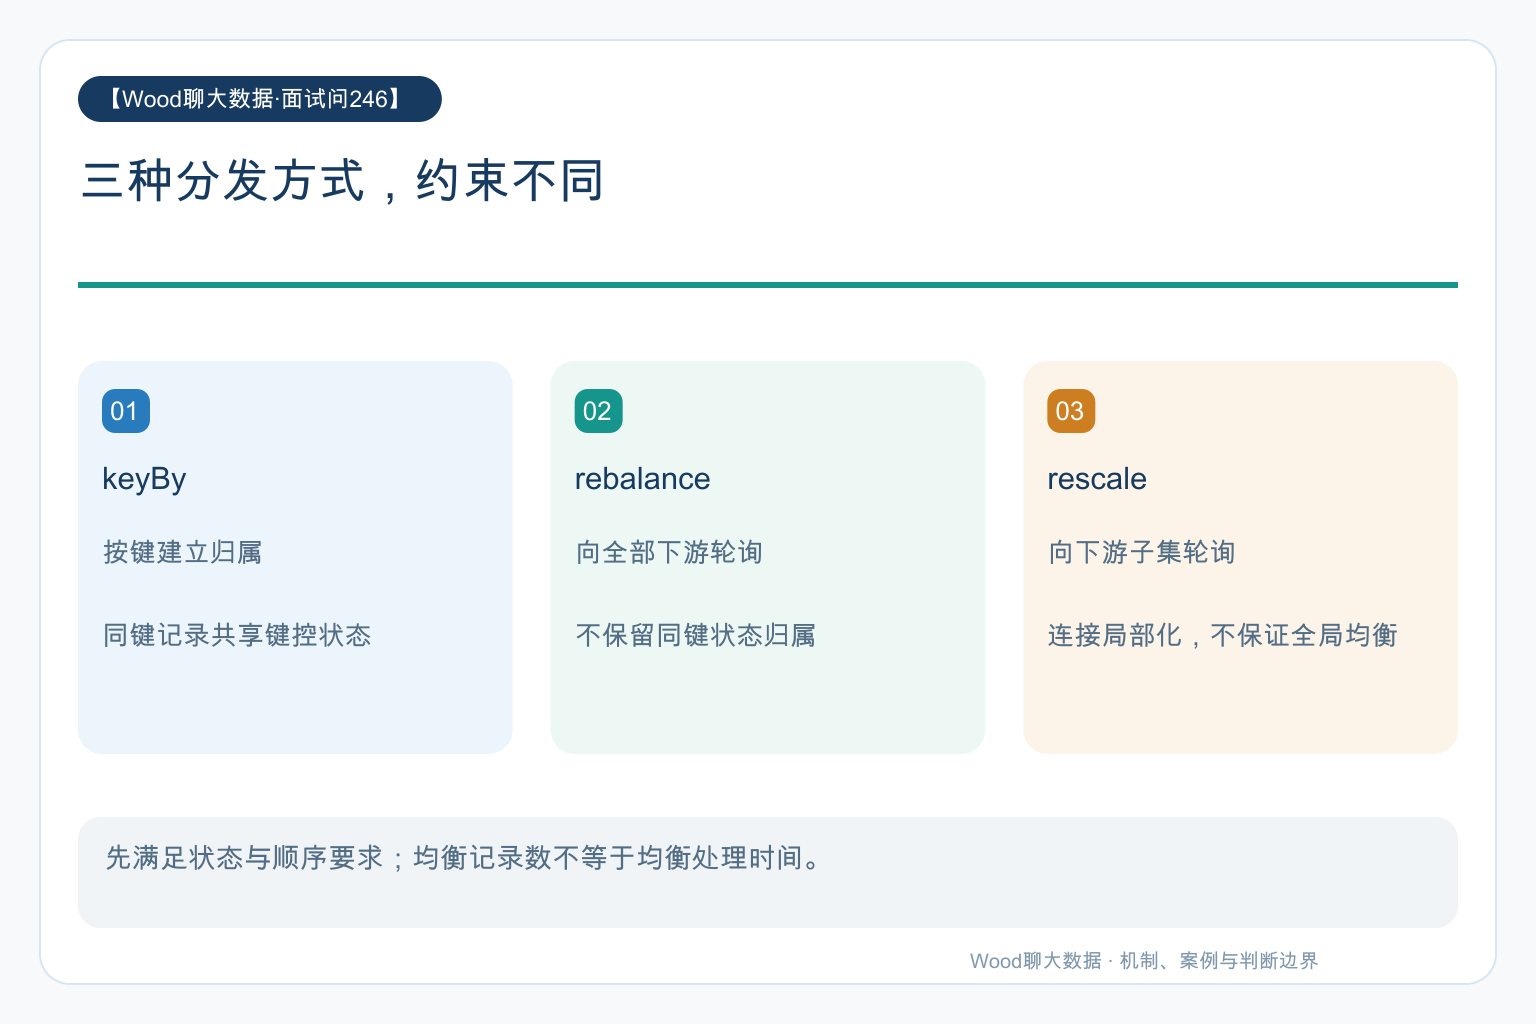
我会先看计算是否依赖同键状态。keyBy 让同键记录和状态归属一致;rebalance 向全部下游轮询,rescale 只向与并行度有关的下游子集轮询。后两者可以用于允许重分发的阶段,但不能替代键控语义,也不保证事件时间顺序。热点键需要另行评估可合并聚合或单键成本。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同样是把数据发给下游,有人为了让负载更均匀,把 keyBy 换成 rebalance。图上的流量确实变平了,但按用户累计的结果却不再正确。分区方式不只是性能开关,它也决定哪些记录能够共享同一份状态。
keyBy 保持键与状态的归属,rebalance 面向全部下游轮询,rescale 面向部分下游轮询;先满足计算语义,再选择分发成本。
keyBy 首先建立的是键的语义
同一个键的记录会被路由到同一个下游键控算子实例,供它访问该键的 Keyed State。按用户累计、订单状态机、基于键的定时器,都依赖这种归属关系。它不是简单把每条记录平均分散。
底层通过键组管理状态分配,不能把当前子任务编号当作稳定业务身份。扩缩容后键组和状态可以重新分配,业务仍应认同一个键,而不是认原来的线程或机器。
rebalance 让每个上游向全部下游轮询
rebalance 将记录按轮询方式分发到全部下游并行实例,适合在没有同键状态要求的处理阶段分摊数据。它能改善部分输入不均,但也可能引入额外的数据交换。
轮询主要均衡记录数量,不等于均衡 CPU 时间。一个超大 JSON、一次慢外部调用,可能比许多普通记录更昂贵。看到条数均匀却有慢子任务时,要继续检查每条记录的成本,而不是认为分区已经证明算子没有问题。
rescale 轮询的只是下游子集
rescale 根据上下游并行度建立局部连接,每个上游只向一部分下游轮询。例如上游并行度 2、下游为 6 时,可以理解为各自负责一个包含 3 个下游的子集。
与全部连接相比,它可能减少连接和跨网络交换,但不保证永远只在本机传输,实际还取决于任务部署。如果两个上游原本一忙一闲,各自对应的下游子集也可能继续一忙一闲,不能指望局部轮询自动实现全局均衡。
一个典型场景:热点用户没有被真正拆开
比如用户 A 的数据远多于其他用户,按用户 keyBy 后,一个聚合子任务成为瓶颈。开发在前面插入 rebalance,看见前置算子负载变均匀,以为倾斜解决;但下一次 keyBy 仍把 A 的记录汇到同一个键控实例。
原来的监控只盯上游吞吐,没有观察最终聚合算子的忙碌时间和状态访问。根因是热点来自一个键,而不是源分区数量不够。如果直接删除 keyBy,又会破坏按用户维护唯一状态的计算语义。
可合并的聚合可以评估两阶段方案:先分散做局部聚合,再按原键合并。需要完整事件顺序的状态机、复杂去重或不可分解逻辑,不能直接照搬这种方式,应优先减少单键处理成本或调整业务切分。
三种方式都不是事件时间排序器
keyBy 让同键记录汇聚,不代表它们按业务发生时间排好序。记录可能来自多个源分区,也可能乱序到达;rebalance 和 rescale 更不能提供全局业务顺序。如果计算依赖事件时间顺序,需要在业务逻辑中另行处理。
同样,rescale 这个数据分发方法和“对有状态作业执行扩缩容”不是同一个动作。后者还涉及状态恢复、并行度约束和连接器能力,不能通过名字相同就推断它们共享所有行为。
优化先画清楚哪一段允许重分发
把链路分成无状态转换、键控计算、外部输出,标注每段的状态和顺序约束。只在允许改变分发的地方比较 rebalance 与 rescale,测量网络字节、子任务负载、端到端延迟和输出正确性。
压测应包含单热点键、源分区不均、记录大小差异以及上下游不同并行度。平均吞吐提升并不足以验收:如果键控结果变化,或者外部系统连接被打满,就不是可直接上线的优化。