Flink Mailbox 模型怎么工作?为什么阻塞调用会拖慢整个 Task?
面试怎么回答
Mailbox 把需要在 Task 主线程执行的记录处理与控制动作协调起来,帮助维持受控的状态访问。同步外部调用或长循环会阻塞主线程,使其他动作延迟,但网络和异步快照仍可能有后台线程。排查要结合线程栈、处理进度和 Checkpoint 分段指标;改造用受支持的异步接口,控制容量、超时和状态访问边界。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一个 Flink 算子只是多查了一次外部接口,结果数据处理变慢,定时器也晚触发,Checkpoint 还开始超时。为什么看似独立的事情会一起受影响?需要沿着 Task 的执行线程看。
Mailbox 让记录处理与投递进邮箱的控制动作在 Task 主线程协调执行;长时间阻塞会延迟其他工作,但不代表所有后台 I/O 都在这一个线程完成。
主线程需要协调数据面与控制面
Flink 的 Task 不只处理记录,还要配合定时器、Checkpoint 触发以及异步工作完成后的动作。Mailbox 模型把需要回到主线程执行的工作组织为邮件,与默认的数据处理动作共同调度。
这种安排有助于让算子状态访问保持可控的串行语义。它不等于进程只有一个线程:网络接收、状态快照的异步阶段和外部客户端都可能有后台线程,关键是哪些动作最终必须回到 Task 主线程继续。
邮件能否及时处理,取决于当前工作能否结束
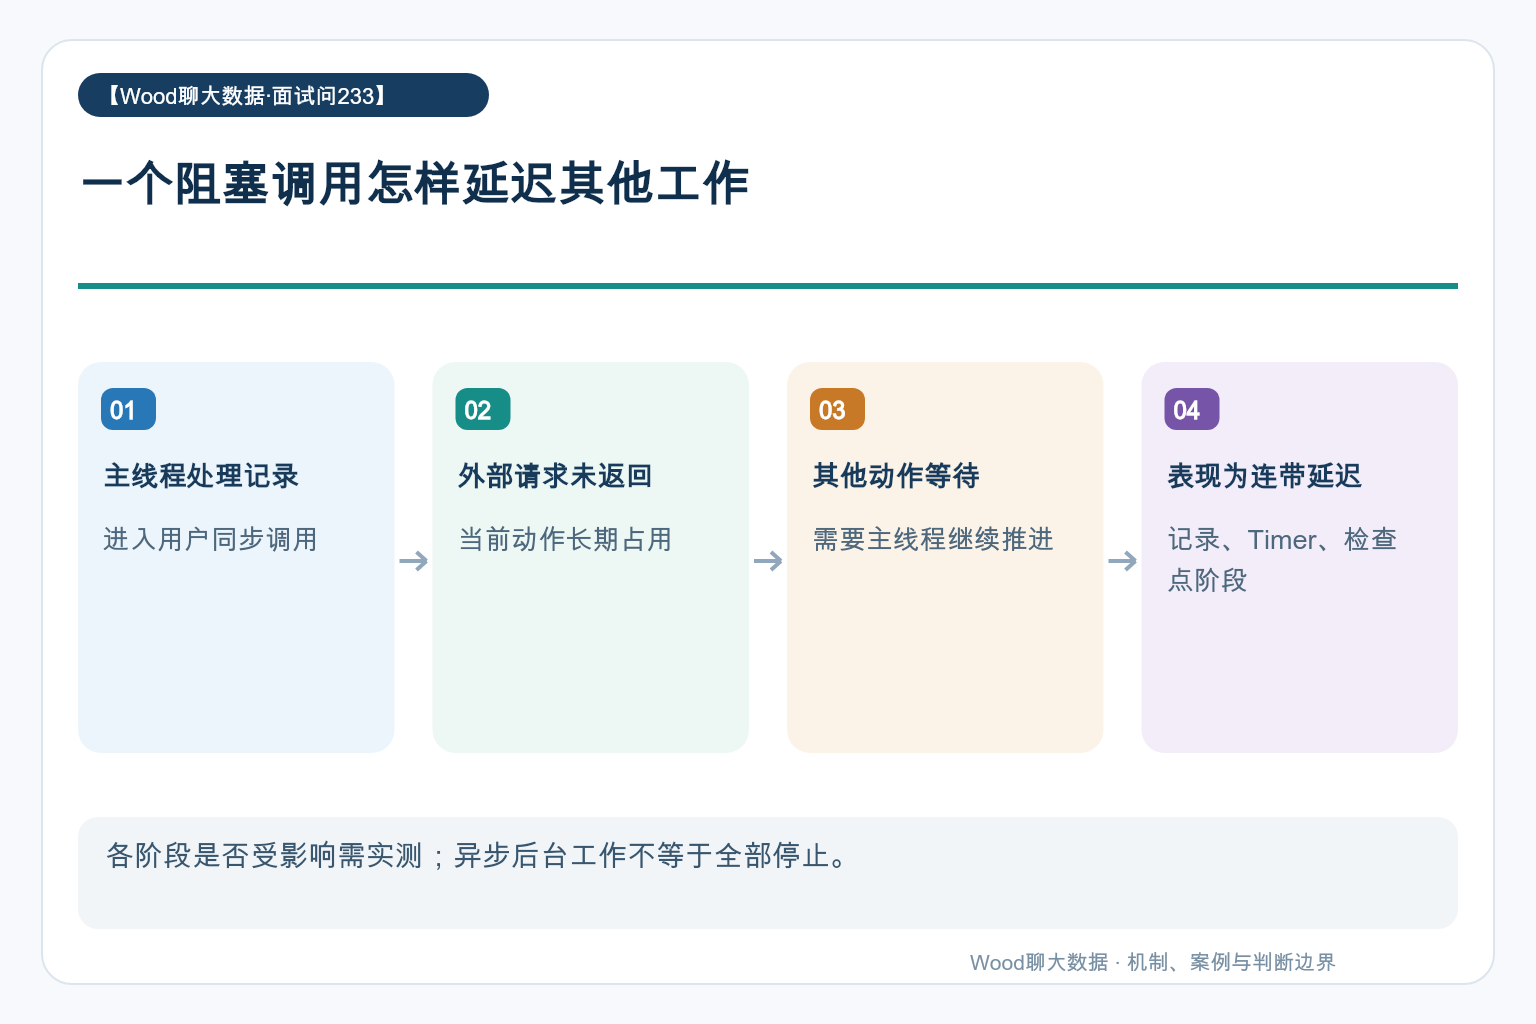
主线程在邮箱循环中处理待执行动作与默认工作。如果用户函数长时间等待同步 HTTP 响应,或者运行很久不返回的循环,主线程就无法及时处理排队工作。
因此 CPU 不高也可能有严重阻塞,因为线程大部分时间在等待网络。不能只靠总 CPU 判断任务健康,要结合 busy、backpressure、记录吞吐和线程栈,确认时间花在计算、等待还是下游输出上。
定时与检查点的延迟要分阶段看
处理时间定时器到点不代表用户回调立刻完成,实际执行仍受 Task 调度影响。Checkpoint 超时也可能发生在触发、Barrier 传播、同步快照或异步上传等不同阶段。
如果主线程长期卡在用户代码里,某些需要它推进的环节就会延迟;但看到上传慢不能反过来直接归因给 Mailbox。排查时把 Checkpoint 阶段指标与线程栈对齐,才能区分主线程阻塞、反压传播和存储瓶颈。
一个典型场景:心跳正常却处理不动
比如 TaskManager 还在正常发送心跳,作业没有退出,业务记录却停止推进。最初判断是上游断流,随后发现输入仍在积压,Task 主线程正等待一个没有超时限制的接口。
原告警只监控进程存活和作业状态,因此没有识别业务停滞。修复需要为调用设置合理超时,评估 Async I/O,并同时监控处理进度。进程活着与主线程能及时推进,是两项独立的观察。
异步改造要保持状态与容量边界
外部请求可以交给受支持的异步接口或连接器,但用户自建线程不能随意修改 Keyed State。返回顺序、超时结果和重试要遵守算子契约,必要时通过框架提供的机制回到受控执行上下文。
异步容量也不是越大越好,待处理请求会占内存并冲击外部服务。上线后比较吞吐、尾延迟、待处理数、Timer 延迟和 Checkpoint 分段耗时,确认原来的串行阻塞确实减少,且没有制造新的外部瓶颈。