Flink CDC 遇到 Schema Evolution 怎么处理?
面试怎么回答
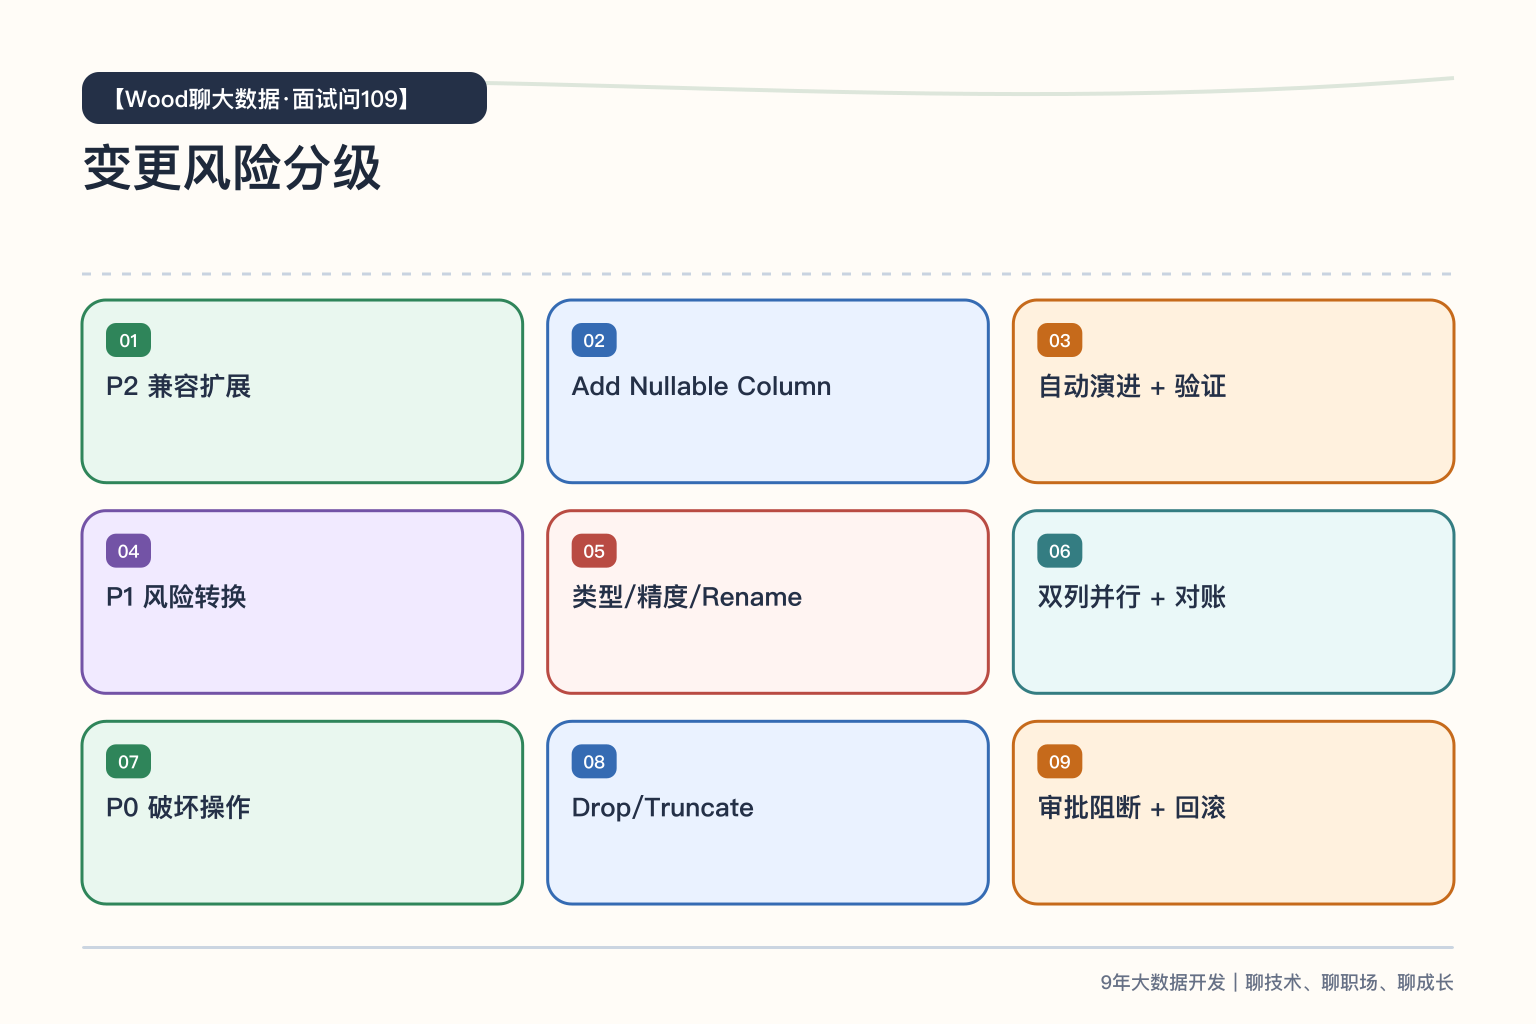
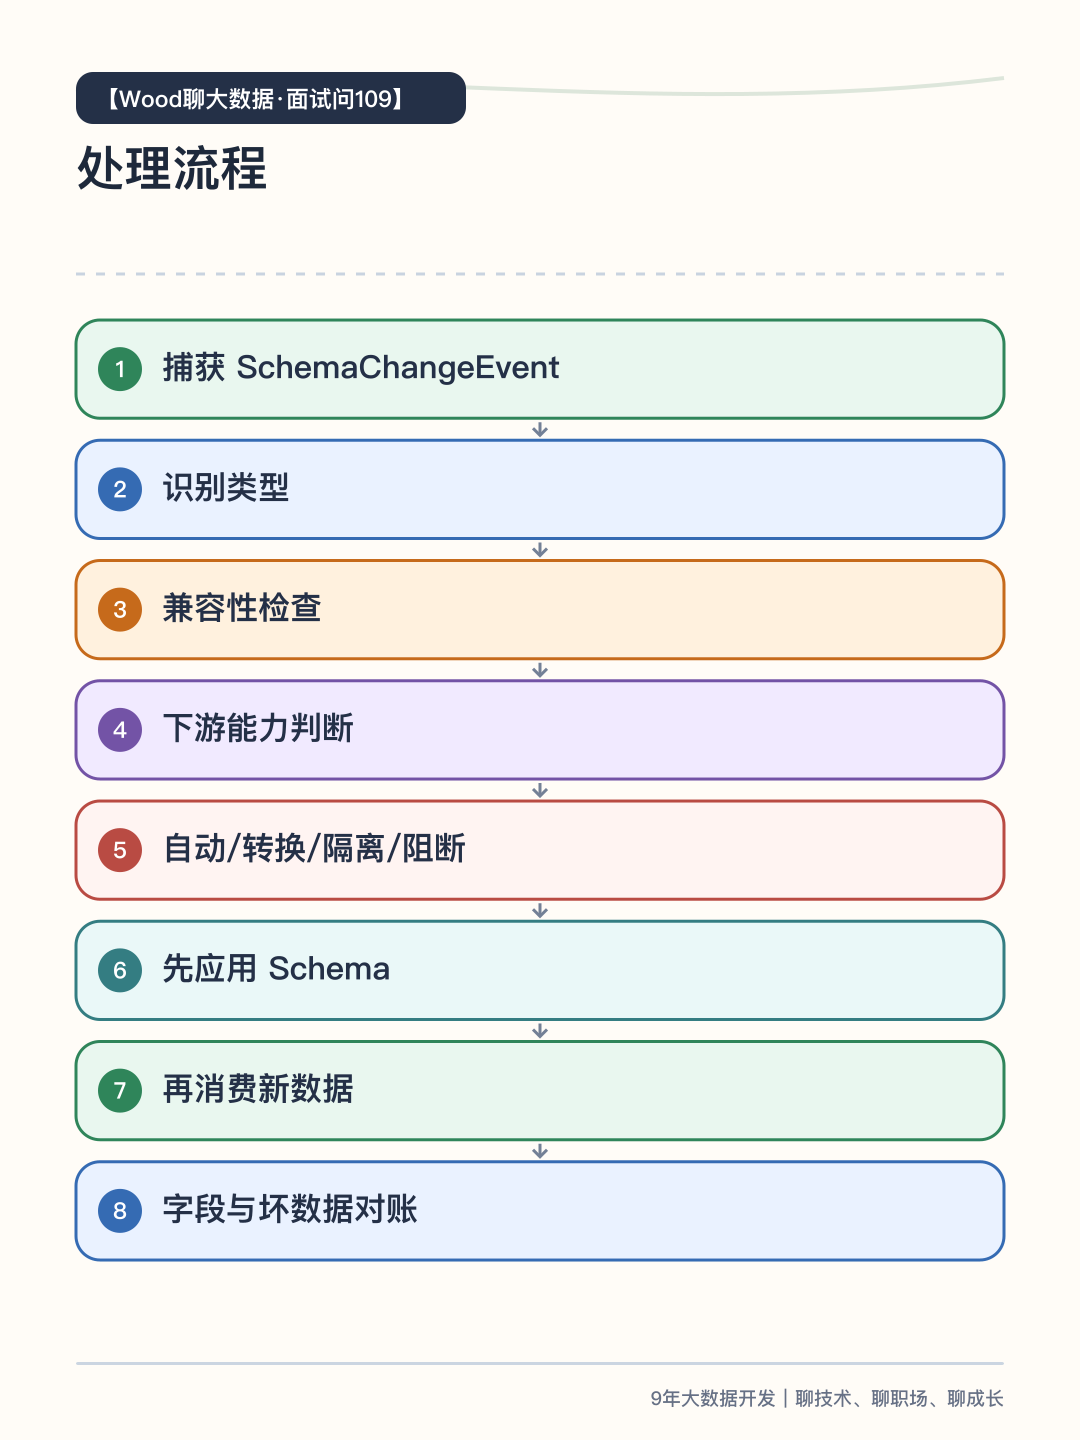
我会先按兼容扩展、风险转换和破坏性操作给 Schema 变更分级。Add Column 等低风险变更可自动演进;类型缩小、重命名采用新旧字段并行和对账;Drop、Truncate 默认审批阻断。系统要保证 Schema 事件先于新结构的数据事件,状态中保留版本;下游不支持时进入兼容转换或隔离,绝不静默丢字段。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
上游只新增了一个字段,CDC 任务为什么会失败?更麻烦的是,有些任务没失败,却把新字段静默丢掉了。
Schema Evolution 处理的不是一条 DDL,而是源端变更、事件顺序、下游能力和数据兼容之间的契约。
先识别变更类型和风险,再决定自动演进、兼容转换、忽略还是阻断,并用版本和对账保证数据事件按正确 Schema 解释。
第一类:向后兼容的扩展
新增可空字段、增加带默认值字段,通常风险较低。下游支持在线 Add Column 时,可以自动同步;不支持时,也可以先保留旧结构,让新字段进入隔离区或等待变更窗口。
即使是新增字段,也要检查列顺序映射、默认值、Sink Connector 和下游 SELECT *。Schema 能写入,不代表所有消费方都兼容。
第二类:可能丢失信息的变更
缩小类型、修改精度、重命名或删除字段,都可能导致转换失败、截断或语义变化。不能简单 Cast 后继续运行。
例如 BIGINT 改为 INT,历史值可能溢出;金额精度变化会影响指标。更稳妥的方式是保留旧列,新增新列,双写验证后再迁移消费者。
第三类:破坏性操作
Drop Column、Truncate、Drop Table 应默认高风险。自动传播到下游可能造成不可恢复删除,因此通常需要审批、延迟生效或显式白名单。
不同 Sink 对 DDL 的支持不同。源端允许修改,不代表目标湖表、OLAP 或消息系统能够原样执行。
Schema 事件与数据事件的顺序
CDC 流必须先让下游知道新 Schema,再处理使用新结构的数据事件。任务故障恢复后,也要从状态中恢复 Schema 版本,不能只恢复 Offset。
每条数据最好可关联表标识和 Schema Version;无法应用的记录进入隔离或死信,并告警,而不是静默丢字段。
治理流程怎么设计?
建立 DDL 类型白名单:Add Column 可自动,扩大类型可尝试,Rename/Drop/Truncate 进入审批。变更前做下游兼容扫描,变更后核对字段、类型、空值、坏数据和数据量。
同时保留回滚方案。结构变更成功但下游任务失败时,要知道如何恢复旧版本或暂停数据消费。
一个典型场景
上游把字符串状态改成整数枚举。目标端自动改类型,历史字符串无法转换,部分记录进入异常但主任务仍继续,最终报表出现缺口。
根因不是 CDC “丢数据”,而是把语义迁移当成普通 DDL。正确方案是新增枚举列、明确映射、双写对账,再逐步切换下游。