Flink State 太大,你怎么优化?
本文目录
面试怎么回答
我会先定位算子、State 类型和 Subtask 分布,结合 Key 数、Checkpoint 大小和恢复时间判断是总量增长还是倾斜。先从业务上设置 TTL、清理窗口、用聚合代替明细并裁剪字段;再处理热点 Key 和并行度;最后选择 State Backend、增量 Checkpoint、本地磁盘和快照参数。因为 Backend 只能改变承载方式,不能解决状态无界增长。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人的第一反应是:
“换 RocksDB State Backend,再开启增量 Checkpoint。”
这两项确实能改善大状态的存储和快照成本,但它们没有回答一个更重要的问题:
这些状态为什么一直增长,其中有多少真的需要长期保留?
如果业务状态本身无界增长,换 Backend 只是把问题从堆内存转移到本地磁盘和远端 Checkpoint。
第一步:先定位状态大在哪个算子、哪个 Subtask
不要只看整个作业的 Checkpoint 大小。
我会先确认:
- 哪个算子的 State 最大
- 是 Keyed State、Operator State 还是窗口状态
- 各 Subtask 状态是否均匀
- Key 数量和单 Key 状态大小如何变化
- Checkpoint 大小、耗时和增量大小趋势
- 恢复时间、磁盘占用和反压是否同时恶化
如果只有少数 Subtask 特别大,优先怀疑热点 Key 或分区不均;如果所有 Subtask 都持续增长,更像状态没有清理、窗口过大或业务保留范围无边界。
先分清“总量过大”和“分布不均”,优化方向才不会错。
第二步:从业务语义上减少状态
这是收益最高的一步。
给状态设置明确生命周期
去重、会话和缓存类状态必须回答:一条状态最晚什么时候可以删除?
能使用 State TTL 的场景,要根据业务追溯周期设置,而不是随便选一个时间。TTL 太短会影响正确性,太长则失去治理意义。
窗口状态则要检查窗口范围、Allowed Lateness 和清理时机,避免窗口结束后仍长期保留。
不要保存可以重新计算的原始明细
如果只需要计数、求和或最大值,就保存增量聚合结果,不要把所有明细塞进 ListState。
如果只需要判断是否出现过,可以考虑更紧凑的数据结构,但要明确误判概率和业务容忍度。
减少无意义的 Key 和字段
过滤空 Key、默认 Key 和无效数据;State 中只保留计算真正需要的字段,避免把完整原始对象长期序列化保存。
第三步:处理状态倾斜和并行度问题
状态按 Key 分布到不同 Subtask。
如果某个热点 Key 承载了大量记录,简单增加并行度也无法拆开这个 Key 的状态。
需要结合业务语义考虑:
- 拆分热点 Key,再做二次聚合
- 调整 Key 设计,避免所有空值进入同一分区
- 对全局状态改用分层或局部汇总
- 清理历史无效 Key
如果 Key 分布均匀,只是总量增长,可以再评估提高并行度来分摊单个 Subtask 的状态和恢复压力。
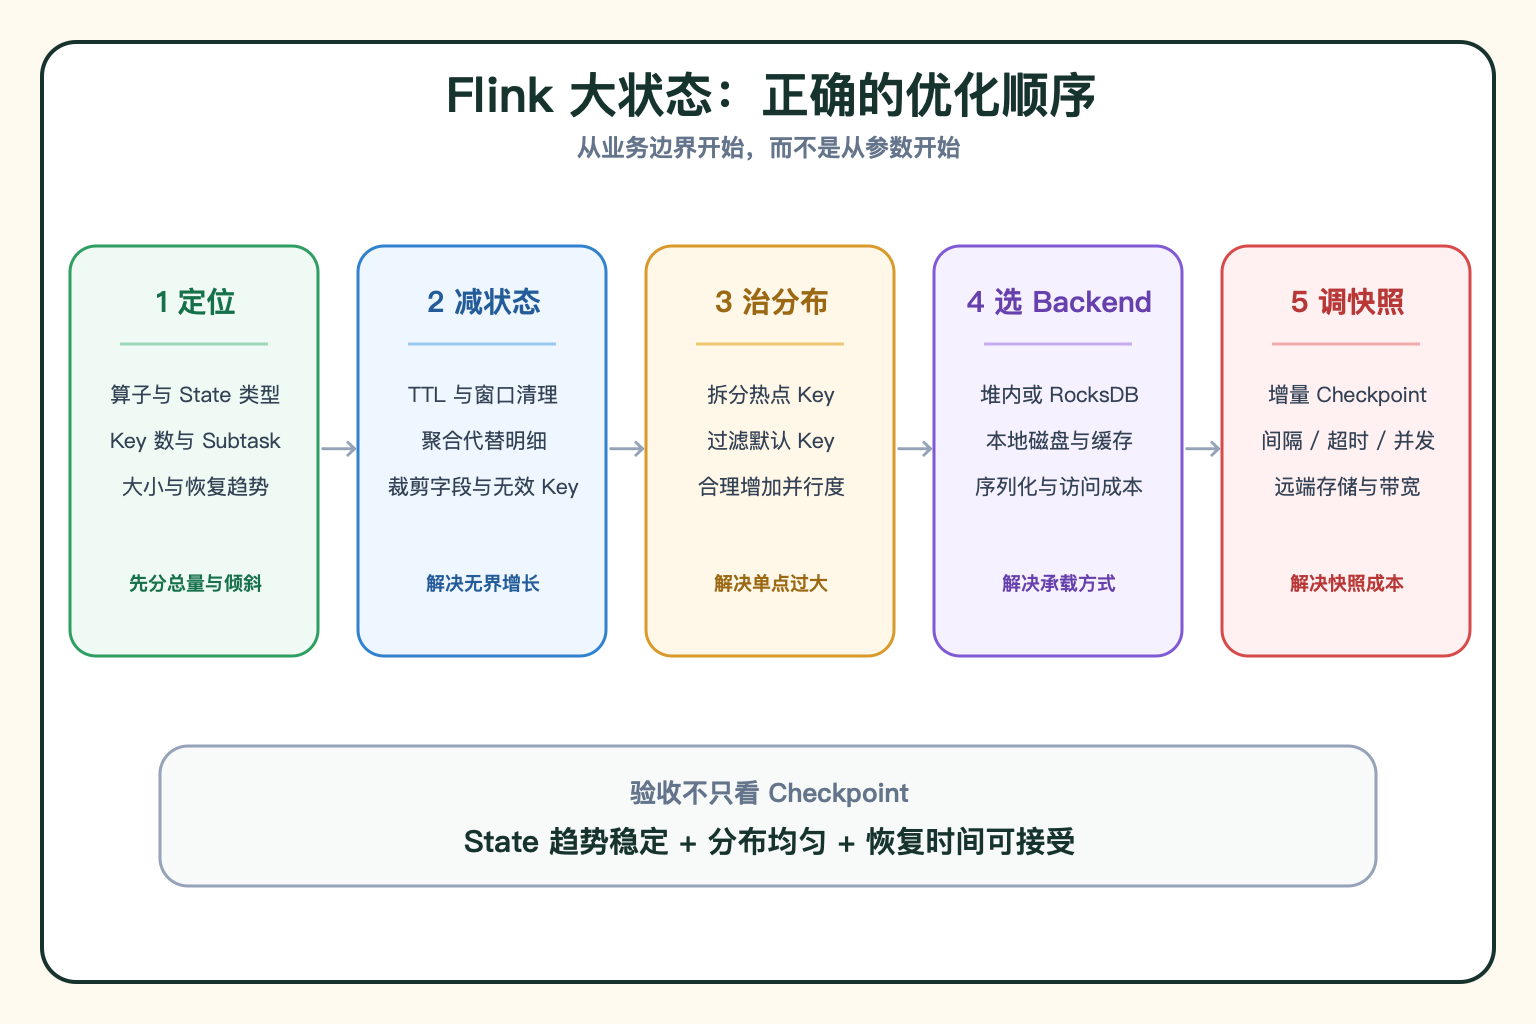
第四步:再选择 Backend 和 Checkpoint 策略
堆内 State 访问快,但容量受 TaskManager 堆内存约束;基于 RocksDB 的 State Backend 可以把工作状态放在本地存储,适合更大的状态规模,但会增加序列化和磁盘访问成本。
增量 Checkpoint 只记录相对上一成功 Checkpoint 的变化,通常可以明显减少大状态的快照数据量,但它不会减少运行时业务状态本身。
还要一起检查:
- 本地磁盘容量和性能
- Checkpoint 并发、间隔与超时
- 上传带宽和远端存储稳定性
- Savepoint 与恢复时间
- Backend 压缩、Compaction 和缓存指标
先减少状态,再优化状态怎么存、怎么快照。
一个典型场景
比如一条去重任务的 State 每天都在增长,Checkpoint 越来越慢。
第一反应是开启增量 Checkpoint,短期内快照耗时下降,但本地状态仍持续膨胀,恢复时间也越来越长。
继续检查代码后发现,任务使用 MapState 保存所有历史事件 ID,却没有任何过期规则;而业务实际上只要求固定周期内去重。
真正的修复是根据业务周期设置状态生命周期,删除不需要长期保留的字段,并补充状态大小和过期效果监控。
Backend 优化解决的是“怎么承载”,生命周期解决的才是“为什么无限增长”。