Flink Keyed State 和 Operator State 有什么区别?
面试怎么回答
Keyed State 绑定业务 Key,只能用于 KeyedStream,运行时会按当前 Key 隔离访问,扩缩容时按 Key Group 重分配,适合用户、订单等业务状态。Operator State 绑定并行算子实例,由算子显式管理,扩缩容时按均匀拆分、联合或广播等方式恢复,适合 Source 分片和 Offset。选择时我主要看状态归属、访问方式和扩缩容后的分配语义。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会回答:
“Keyed State 是按 Key 保存,Operator State 是按算子保存。”
方向没错,但还不够。
生产里真正影响设计的是:状态绑定在哪个逻辑范围、代码如何访问,以及作业扩缩容后状态怎样重新分配。
选状态类型,本质上是在选择状态的归属和恢复语义。
第一层区别:状态归属不同
Keyed State:属于某个 Key
Keyed State 只能用在已经 keyBy 的数据流上。
运行时会根据当前记录的 Key,自动访问这个 Key 对应的状态。不同 Key 的状态彼此隔离,例如:
- 每个用户最近一次行为
- 每个设备的累计次数
- 每个订单的状态机
常见形式有 ValueState、ListState、MapState 等。
Operator State:属于并行算子实例
Operator State 与某个并行 Subtask 绑定,不会由运行时根据当前 Key 自动切换。
它更适合记录算子实例自身需要管理的信息,例如 Source 已读取的分片和 Offset、外部资源分片状态等。
第二层区别:访问方式不同
Keyed State 的访问通常发生在处理某条 KeyedStream 记录时。代码看到的是当前 Key 对应的那份状态,不需要自己维护 key -> state 的大 Map。
Operator State 通常通过 CheckpointedFunction 等接口,在初始化和快照阶段读取或写入。业务代码需要明确这份状态属于当前算子实例。
如果把大量 Key 状态自己塞进 Operator State,不仅管理复杂,扩缩容时也很难做到与 Key 分区一致。
第三层区别:扩缩容时的重分配不同
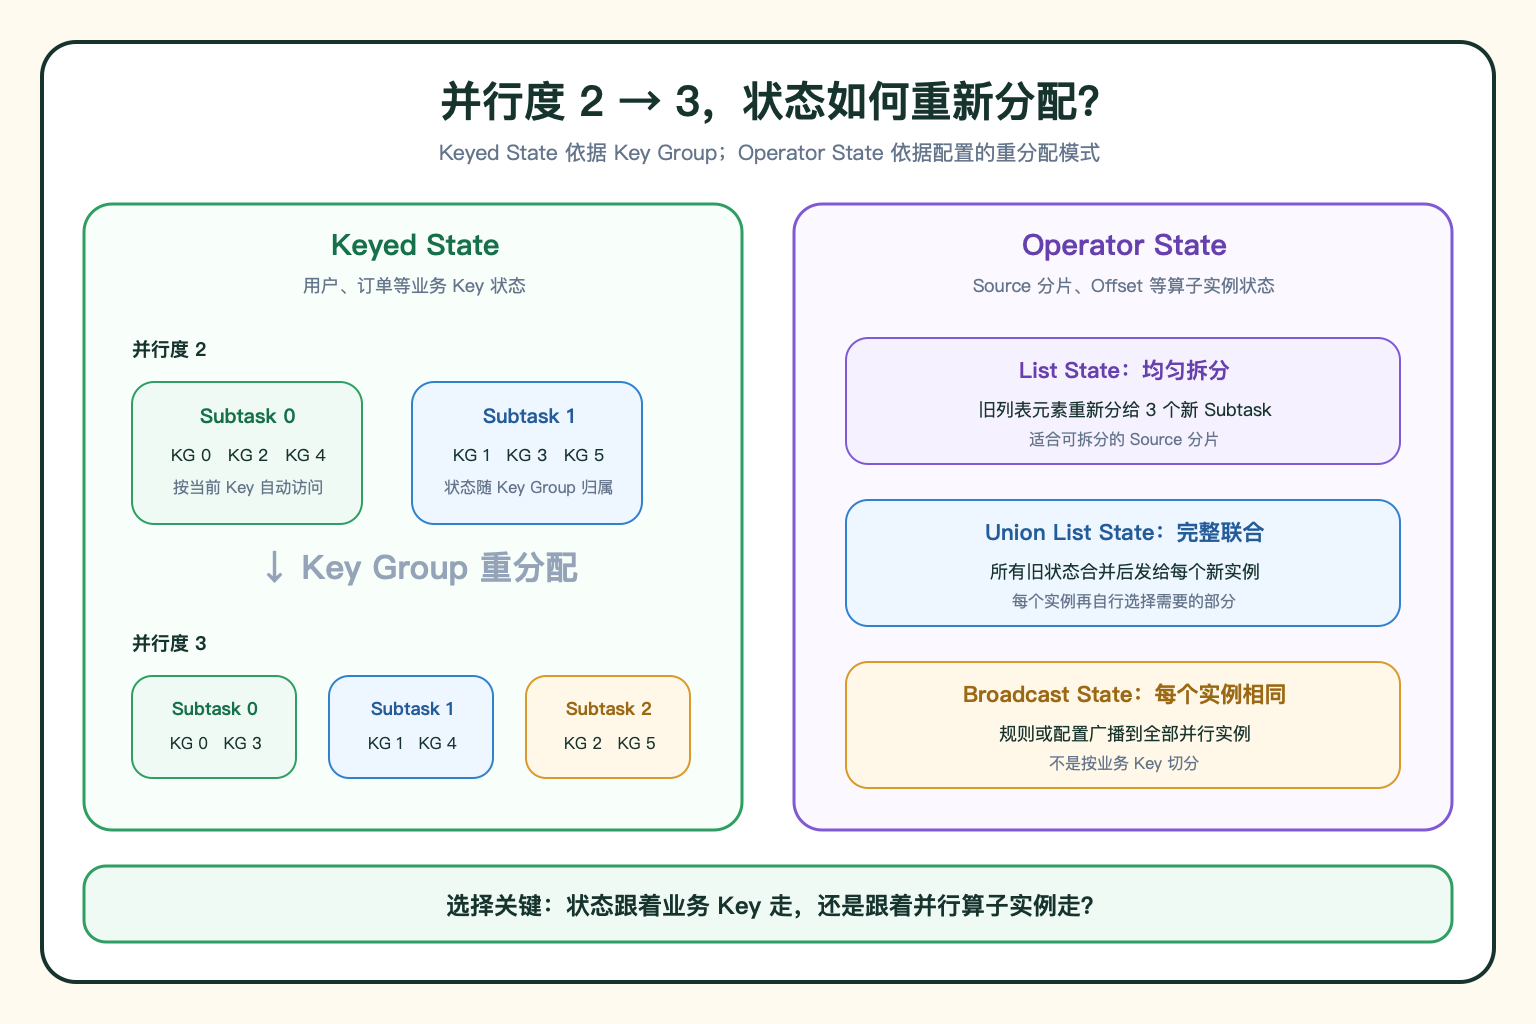
作业从 2 个并行度扩到 3 个并行度时:
- Keyed State 根据 Key Group 重新分配到新的 Subtask
- Operator List State 可以选择均匀拆分或完整联合后再分配
- Broadcast State 会让每个下游并行实例保留相同广播状态
这也是为什么 Source 分片状态经常使用 Operator State:恢复或扩缩容时,分片可以重新分给新的 Source Subtask。
而用户、订单等按业务 Key 隔离的状态,更适合 Keyed State。
一个典型反例
比如要记录 Kafka Source 各分区消费到的 Offset。
如果把 Offset 设计成 Keyed State,就需要先人为构造 Key,还会把 Source 分片归属和业务 Key 分区混在一起。并行度变化后,状态未必能按照 Source 分片需要的方式重新分配。
更合理的方式是使用 Operator List State 保存当前 Subtask 负责的分区与 Offset。恢复时,Flink 根据重分配模式把这些分片交给新的并行实例。
反过来,如果是统计每个用户连续登录次数,就应该 keyBy(user_id) 后使用 Keyed State,而不是在每个 Subtask 里维护一张用户 Map。
先问状态属于业务 Key,还是属于算子实例,答案通常就清楚了。