Flink 维表 Join 怎么设计?
面试怎么回答
我会先确认关联的是处理时刻最新值,还是事实发生时的历史版本。小且更新不频繁的维表可以广播到本地状态;大维表、当前值语义可用外部 Lookup,并设计缓存、异步、超时、重试和限流;需要历史时点一致性则用 Event Time Temporal Join,保证维表有主键版本、正确时间属性和 Watermark。无论哪种方案,还要明确查不到、更新删除、晚到数据和恢复后的处理规则,并用命中率、外部 QPS、状态大小和关联准确率做监控。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会直接回答:
“小表广播,大表就异步查询。”
这是实现方式,但还没有回答最重要的问题:
事实数据需要关联维表的当前值,还是事件发生时的历史版本?
如果语义没选对,任务可能延迟很低、吞吐很高,但关联结果一直是错的。
第一步:先定义维表关联语义
维表通常有两种业务语义。
当前快照语义
事实到达时,关联维表此刻的最新值。
例如实时大屏只展示用户当前等级、商品当前类目,允许历史事件按最新状态补充。
事件时点语义
事实发生在什么时间,就关联维表在那个时间点生效的版本。
例如订单发生时的会员等级、下单时的汇率、投放当时的渠道归属。此时即使事实晚到,也不能直接使用维表最新值。
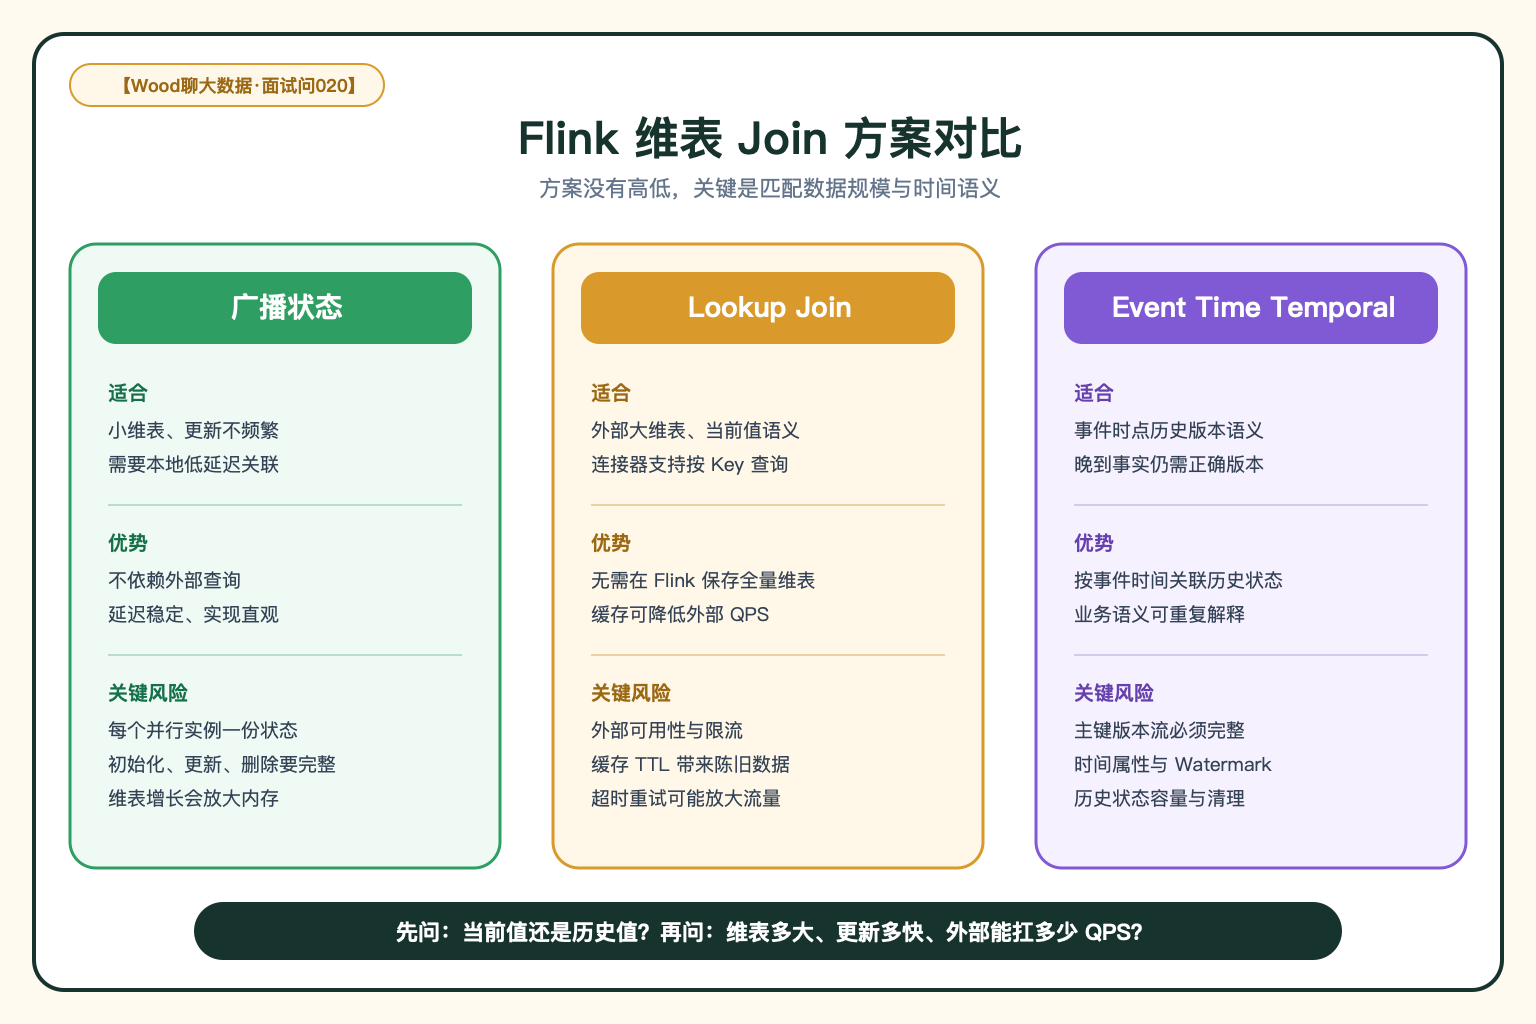
这一步决定后面应该选广播状态、外部 Lookup,还是基于 Event Time 的 Temporal Join。
第二步:根据数据规模和语义选择方案
广播维表状态
适合数据量较小、更新不频繁,而且需要低延迟本地关联的维表。
优点是查询不依赖外部存储,延迟稳定;代价是每个并行实例都要保存一份维表状态,还要处理全量初始化、增量更新和删除事件。
外部 Lookup Join
适合维表较大、保存在 JDBC、HBase 或其他支持 Lookup 的外部系统,并且需要处理时刻最新值的场景。
设计时要同时考虑缓存、异步请求、超时、重试、限流和降级。缓存能减少外部压力,但缓存 TTL 越长,结果越可能不是最新值。
Event Time Temporal Join
适合必须关联事件时点历史版本的场景。
右表需要能够表达带主键的版本变化,事实流和维表流还要有正确的时间属性与 Watermark。系统按照事实事件时间找到当时有效的维表版本,而不是直接取当前值。
第三步:把正确性细节写进设计
维表 Join 不只是把两条流连起来,还要明确以下规则:
- 维表主键是否唯一,重复版本如何处理
- 查不到维度时丢弃、补默认值,还是进入侧输出
- 维度更新和删除如何传播
- 事实晚到时使用最新值还是历史值
- 缓存 TTL、最大容量和失效策略
- 外部查询超时、重试次数、并发与限流
- Checkpoint 恢复后,缓存或状态如何重新建立
- 结果如何抽样对账,如何发现维表陈旧或漏关联
如果这些规则没有约定,同一条数据在重跑、恢复或维表更新后,可能得到不同结果。
第四步:从可用性和容量反推参数
假设每秒有 5 万条事实数据,缓存命中率 90%,仍然有每秒 5000 次外部查询。
这时要继续确认:
- 外部存储能否稳定承受峰值 QPS
- 单次超时会占住多少异步并发
- 重试是否会在故障时放大流量
- 维表变大后,广播状态是否超过 TaskManager 容量
- Temporal Join 保留的历史版本是否随 Watermark 正常清理
参数不是孤立设置,而是由事实吞吐、命中率、外部能力、可接受延迟和一致性要求共同决定。
一个典型场景
比如订单流要关联用户等级,维表查询做了 30 分钟缓存。
用户 10:10 从普通会员升级为 VIP,一笔事件时间为 10:05 的订单因为延迟在 10:20 到达。任务查到缓存中的最新等级 VIP,于是把这笔订单也标成了 VIP。
如果业务要的是处理时刻最新等级,这个结果没问题;如果佣金规则要求使用下单时等级,这个结果就是错的。
后者需要保存维表版本,并用订单 Event Time 做 Temporal Join,同时设计 Watermark 和迟到处理。
方案选择不是看哪个组件更高级,而是先看业务到底需要哪一种时间语义。