Flink Async IO 怎么用
本文目录
面试怎么回答
我会先确认底层客户端是真异步的,在 asyncInvoke 中只发请求,不阻塞等待,并保证成功、异常和超时分支都完成 ResultFuture。输出模式按业务选择:无顺序要求用 Unordered 降低延迟,需要顺序才用 Ordered,并注意队头阻塞。Capacity、并行度、Timeout 和 Retry 要按外部系统 QPS 联动设置;未完成请求会参与故障恢复,因此有副作用的外部调用还要保证幂等。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会回答:
“同步查询慢,就包一层线程池改成异步,再把 Capacity 调大。”
这样可能暂时提高吞吐,也可能把问题放大成连接打满、请求堆积、超时重试风暴和 Checkpoint 变慢。
Async I/O 的价值不是无限并发,而是:
用真正的非阻塞客户端重叠等待时间,同时对顺序、并发、超时、重试和外部系统容量设好边界。
第一步:先确认它适合解决什么问题
Async I/O 适合外部调用延迟较高、单次计算很轻的场景,例如:
- 查询外部 KV 存储补充维度
- 调用数据库或远程服务做数据增强
- 向支持异步客户端的系统发起请求
同步调用时,一个 Subtask 发出请求后会原地等待。假设外部查询耗时 50 ms,大部分时间都浪费在等待网络返回。
异步调用允许同一个 Subtask 同时维护多个在途请求,用后续请求覆盖前一个请求的等待时间,从而提高吞吐。
但它不会让外部系统本身变快,也不会消除下游的 QPS 上限。
第二步:必须是真异步,不能在 asyncInvoke 里阻塞
正确实现通常需要:
- 在
open中创建可复用的异步客户端 - 在
asyncInvoke中快速发出请求并立即返回 - 在回调中调用
ResultFuture.complete或异常完成 - 在
close中释放连接和线程资源
如果底层客户端仍是同步阻塞的,再在 asyncInvoke 里调用 future.get() 等待结果,本质上还是同步 I/O。
用线程池包装同步客户端可以提供有限并发,但会增加线程、队列和连接管理成本,通常不如原生异步客户端高效。
还要确保每条输入最终都完成 ResultFuture。异常分支、空结果和超时分支如果漏掉完成信号,请求会一直占用 Capacity。
第三步:Ordered 和 Unordered 要按业务语义选择
Flink 提供两种输出模式。
UnorderedWait
哪个请求先完成就先输出,延迟和缓存开销通常更低,但输出顺序可能与输入不同。
适合事件相互独立、下游不依赖顺序的维度补全。
OrderedWait
保持输入顺序。后面的请求即使先完成,也要等待前面的请求完成或超时后才能输出。
它适合确实要求顺序的链路,但容易出现队头阻塞。一个慢请求会挡住后面已经完成的结果,也会让更多记录和结果停留在状态中。
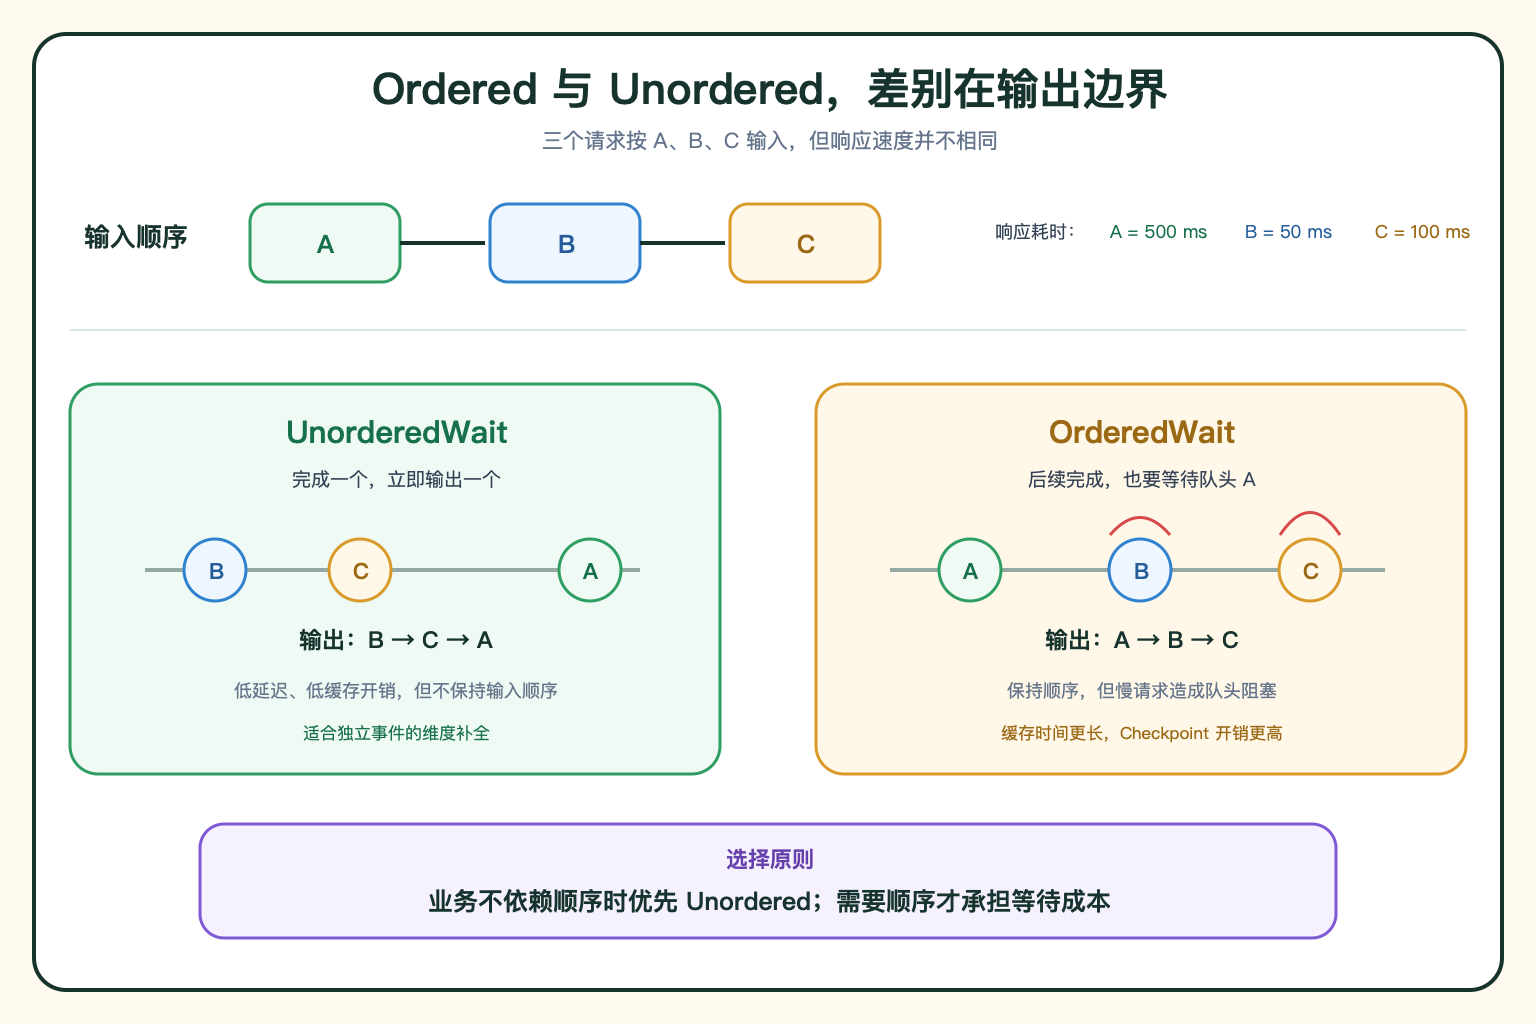
选择时不要默认“有序更安全”。如果业务不需要顺序,Ordered 只会增加延迟和状态成本。
第四步:Capacity、Timeout 和 Retry 必须联动设计
三个参数分别控制不同风险:
- Capacity:单个异步算子 Subtask 最多允许多少在途请求
- Timeout:一次异步操作从首次调用到最终完成的最长时间
- Retry:哪些异常或空结果需要重试,以及间隔和次数
Capacity 用尽后,算子会触发反压,避免无限堆积。它不能只按“越大吞吐越高”设置,还要满足:
总并发 ≈ Async 算子并行度 × 单 Subtask Capacity总并发必须在外部系统的连接数、QPS 和响应时间范围内。
Retry 会延长请求占用 Capacity 的时间;Timeout 又包含多次重试的总时间。失败率升高时,如果同时扩大 Capacity 和重试次数,很容易形成请求风暴。
Flink 会把未完成请求相关的输入记录纳入 Checkpoint 状态,恢复后重新触发异步请求。因此外部操作如果有副作用,还要保证幂等,不能假设每个请求只调用一次。
一个典型场景
比如异步查维表出现反压,第一反应是把 Capacity 从较小值调得非常大。
短时间吞吐提升了,但数据库连接数迅速打满,响应时间上升;更多请求触发 Timeout 和 Retry,队列进一步增长,Checkpoint 也开始变慢。
根因不是 Flink 并发不够,而是总并发超过了外部系统的稳定承载能力。
更合理的方式是先压测单请求延迟和外部系统 QPS,再共同调整 Async 并行度、Capacity、Timeout 与 Retry;对热点 Key 增加缓存,对失败结果设置降级或侧输出,而不是无限堆积。
Async I/O 的目标是隐藏等待,不是把外部系统压到失去响应。