Flink 并行度怎么设置?
本文目录
面试怎么回答
我会先用峰值输入速率和单 Subtask 压测能力估算初始并行度,再按算子校准:Source 看上游分区,计算和窗口看 CPU、Key 分布与输出峰值,Sink 看外部系统容量。然后检查 Slot 是否充足,以及 TaskManager 的 CPU、内存和网络是否匹配。有状态算子还要设置合理的 Max Parallelism,为 Savepoint 扩缩容预留空间,最后用反压、Busy、吞吐和 Checkpoint 指标验证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会给一个经验公式:
“并行度按 CPU 核数的两三倍设置,不够就继续加。”
这个回答的问题是,它把整条作业当成了同一种计算。
实际的 Flink 作业里,Source、计算算子、窗口和 Sink 的处理能力完全不同,限制条件也不同。
所以我更关注的是:
先找到每段链路的吞吐上限和瓶颈,再按算子设置并行度,并用 Slot、内存和下游容量验证它能不能真正跑起来。
第一步:用吞吐目标得到初始并行度
并行度的本质,是一个算子同时有多少个 Subtask 处理数据。
初始估算可以从两个量开始:
目标峰值输入速率
单个 Subtask 稳定处理速率
可以把下面这个关系作为压测起点:
并行度 ≈ 峰值输入速率 ÷ 单 Subtask 稳定处理速率 × 安全系数但单 Subtask 能力不能靠猜,要在接近生产的数据量、数据分布和状态规模下压测。
安全余量还要覆盖流量波动、Checkpoint、GC 和故障恢复后的追数压力。只按平均流量设计,峰值一来就容易持续反压。
第二步:不同算子要看不同上限
不要整条作业统一设置一个并行度。
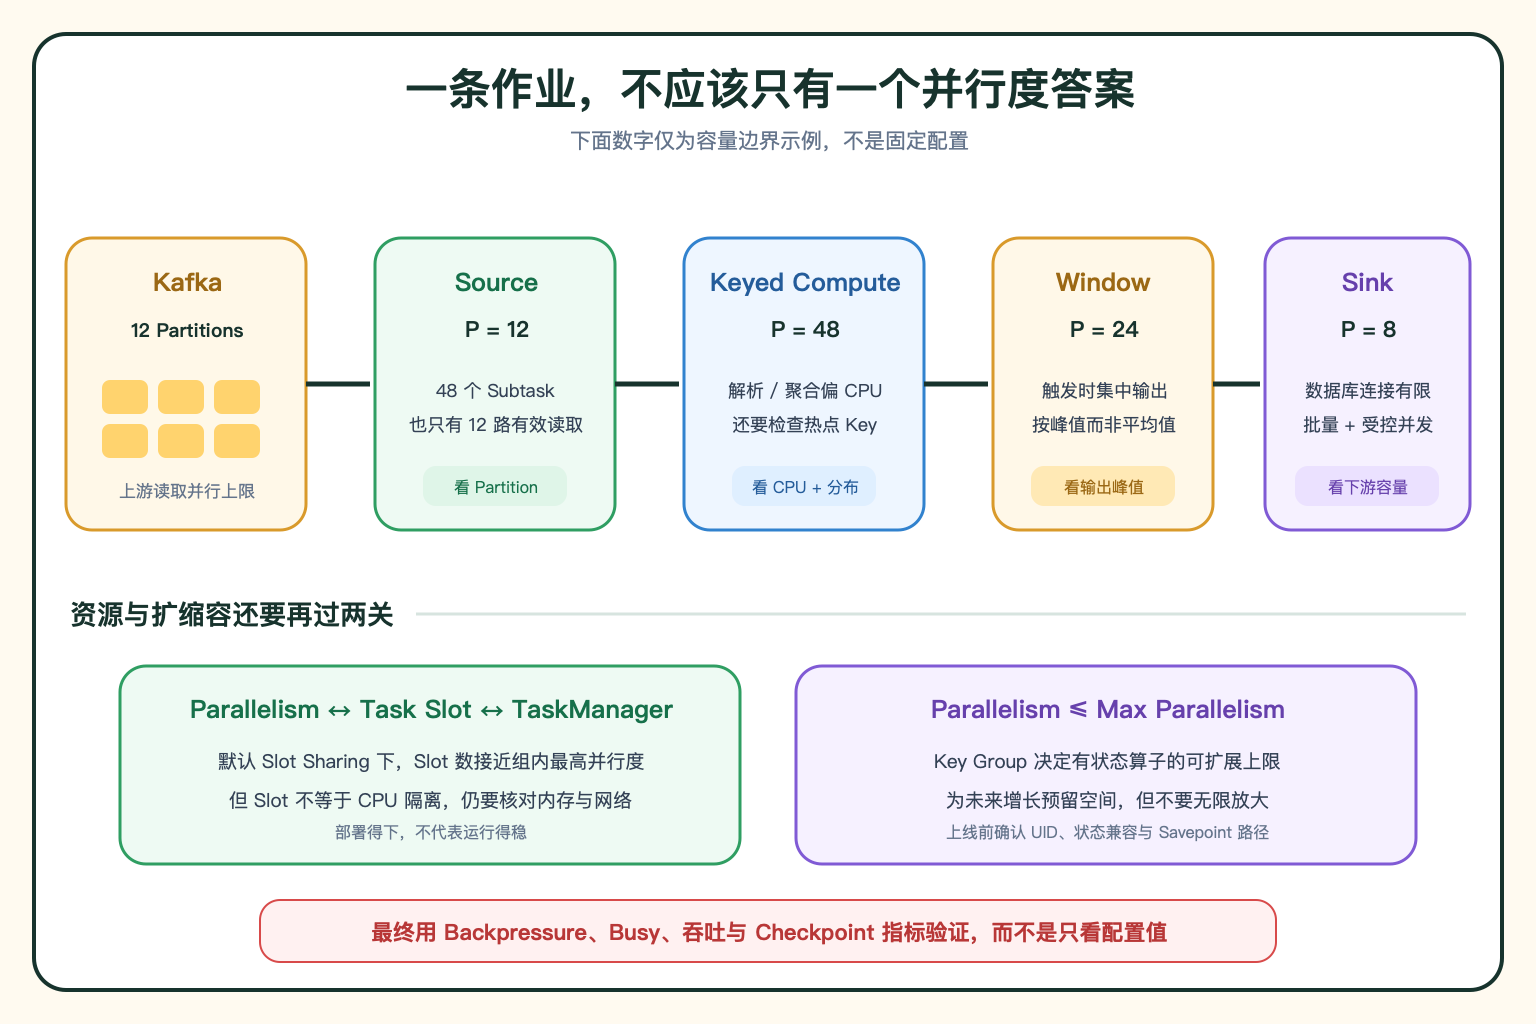
Source:先看上游分区数
Kafka Source 的有效读取并行通常受 Topic Partition 数限制。Topic 只有 12 个 Partition,把 Source 并行度设成 48,并不会凭空产生 48 路有效读取。
计算算子:看 CPU、数据分布和状态
Map、解析、序列化通常偏 CPU;keyBy 后的聚合还要看 Key 是否均匀。一个热点 Key 只能进入一个下游 Subtask,单纯增加并行度不能拆开这个热点。
窗口算子:看瞬时输出峰值
窗口期间可能很平静,但触发时一次性向下游输出大量结果。并行度评估不能只看平均处理速率。
Sink:先看外部系统承载能力
数据库或外部 API 如果只能稳定承受有限并发,盲目增加 Sink 并行度,可能把 Flink 的反压变成下游连接数和写入压力。
第三步:把 Parallelism、Slot 和资源对应起来
Parallelism 表示算子的并行实例数;Task Slot 是 TaskManager 的调度资源单位,两者不是同一个概念。
在默认 Slot Sharing 下,一条流水线上不同算子的 Subtask 可以共享 Slot。因此集群通常需要的 Slot 数,接近同一 Slot Sharing Group 中最高的算子并行度,而不是把所有算子并行度简单相加。
但要注意:
- 一个 Slot 只隔离部分资源,不代表严格 CPU 隔离
- 同一 JVM 中 Task 太多,仍会竞争 CPU、Heap、Network Memory 和 GC
- Slot 太少会部署不下,Slot 很多但 CPU 和内存不足也跑不稳
- Operator Chain 会减少线程切换和序列化,但也可能让轻重算子绑在同一个线程上观察
所以参数不能只看“总 Slot 数”,还要结合每个 TaskManager 的 CPU、内存、网络和状态后端。
第四步:提前设计 Max Parallelism
对 Keyed State 算子,Max Parallelism 不只是一个上限,它还决定 Key Group 的数量,影响后续状态重分配。
如果初次上线只按当前流量设置得过小,未来即使增加资源,也可能无法把并行度扩到需要的水平。
但 Max Parallelism 也不是越大越好。过大的 Key Group 数会增加状态元数据和管理开销;作业带状态恢复时再随意修改,还可能造成状态不兼容。
比较稳妥的做法是:
- 当前 Parallelism 按现有峰值和压测结果设置
- Max Parallelism 为未来增长预留合理空间
- Stateful 算子上线前确认 UID、Max Parallelism 和 Savepoint 扩缩容路径
一个典型场景
比如一条作业统一设置并行度 48,但 Kafka Topic 只有 12 个 Partition,真正有数据的 Source Subtask 只有 12 个;下游写数据库又因为连接和批量写能力受限,持续出现反压。
这时继续把整条作业加到 64,既不能提高 Source 读取并行,也可能让 Sink 建立更多连接,加剧下游压力。
更合理的方式是分别处理:上游确实需要扩展时评估 Partition;CPU 密集算子按压测结果增加并行度;Sink 则通过批量、异步和受控并发匹配外部系统容量。
并行度不是一条作业的统一号码,而是每个算子对吞吐、状态和外部容量的回答。