Flink Timer 太多怎么优化?合并定时器会不会提前触发?
面试怎么回答
我会先检查是否为同一key反复注册不同时间的Timer,并清理失效定时器。需要合并时,选择业务允许的时间粒度,明确向下取整可能提前、向上取整会推迟目标时点。同键同时间才会去重,不同key不能靠取整合成一个全局Timer。回调里按真实截止时间和当前状态复核,测试边界、取消、恢复和批量触发,不能只看Timer总数下降。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一个订单设置30分钟超时,合并定时器后却在29分59秒被取消。只差一秒,业务仍然不接受。优化Timer数量时,最容易忽略的不是能不能取整,而是向下取整会把目标触发时刻往前挪。
定时器合并以时间精度换取更少触发点;取整方向、键范围和回调复核决定它是否仍满足业务语义。
先看Timer为什么越来越多
每条事件都注册“当前时间加超时”,会生成许多不同目标时间。即使它们属于同一个key,也不能因为只差几毫秒就自动合并。
Flink按key和时间戳对同类定时器去重。因此减少同一key下不同的目标时间,有机会减少Timer数量;不同key恰好同一时刻触发,仍然是各自的定时器。
还应检查旧Timer是否已经失效。例如订单状态更新后超时时间被延长,旧Timer是否被取消,或者回调是否能识别它已经不是当前有效截止时间。
时间桶减少目标点,也改变精度
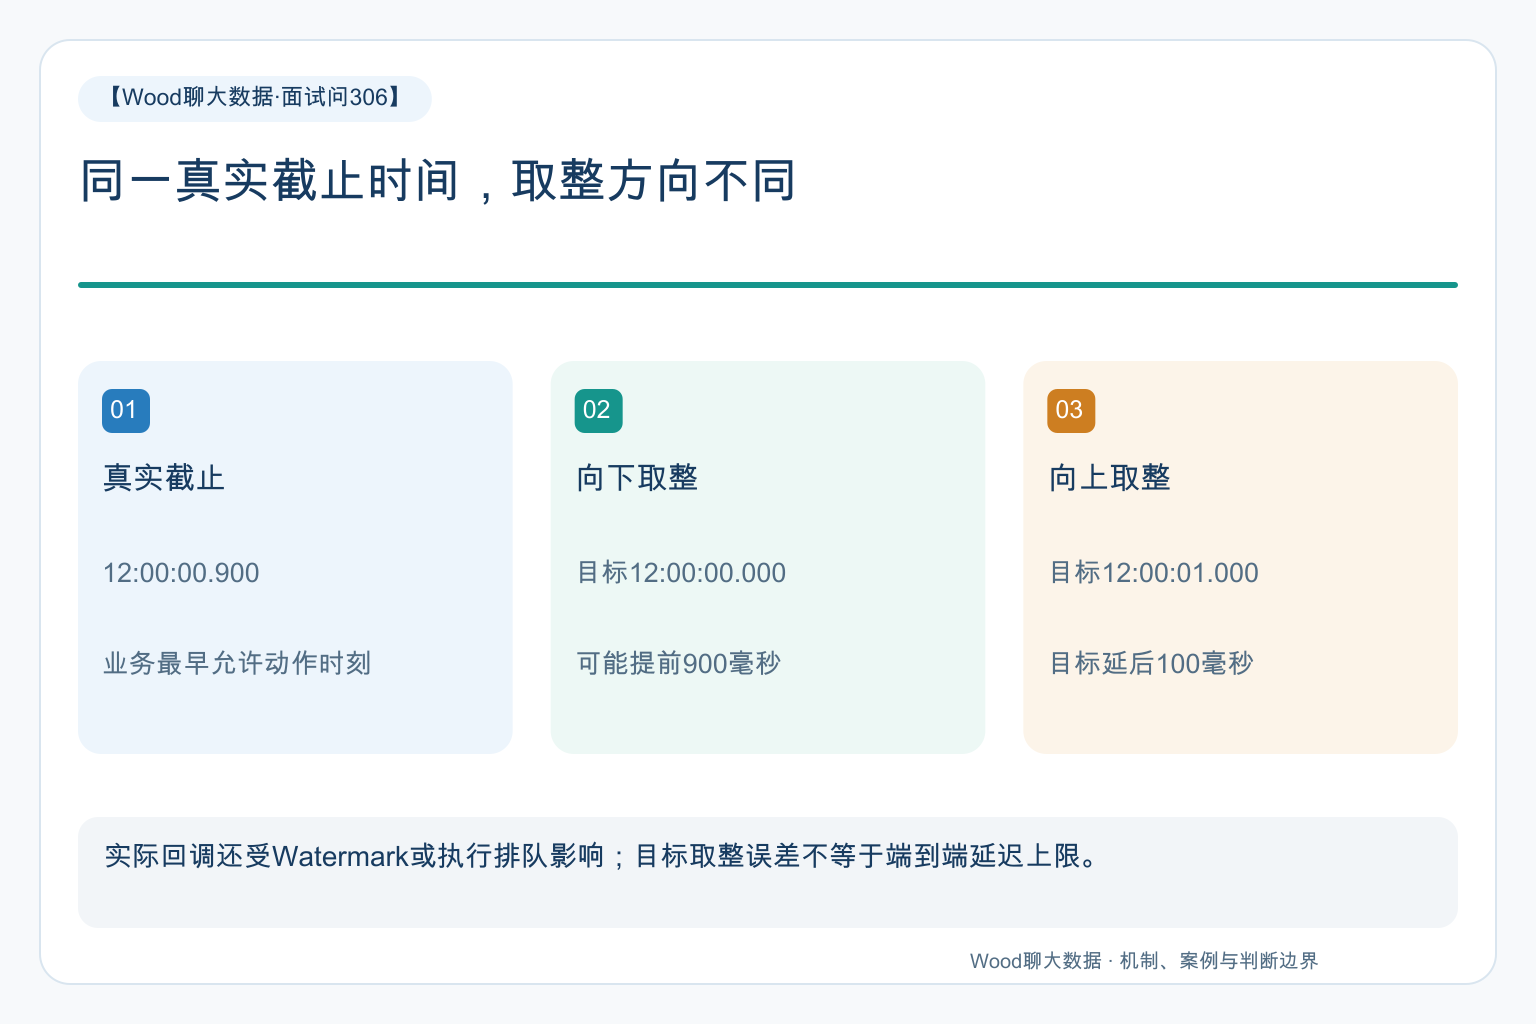
假设真实截止时间为12点00分00秒900毫秒,按秒向下取整后目标变成12点整,比原截止早900毫秒。
向上取整到下一秒,则目标更晚100毫秒。对非负毫秒时间戳,可用数学上的向上取整理解;实际代码需处理整数溢出和边界,不要随手复制一个只适用于小数值的公式。
如果业务要求不能提前关闭订单,应采用不早于真实截止的目标,或者在回调内发现未到期后重新安排。不能因为文档展示了向下取整示例,就忽略自身业务的时间约束。
回调应验证现在是否真的该执行
定时器触发代表到达了某个技术调度点,不必然代表订单仍然待支付。用户可能已经付款,业务也可能延期或撤销。
状态中可以保留真实截止时间与当前有效版本,回调只对仍符合条件的对象执行动作。旧Timer即使触发,也应能够安全退出。
合并到同一个key时间桶的多条业务对象,还需要状态记录桶内待处理对象;不能只保留一个Timer而丢掉具体对象清单。减少定时器数量不意味着待处理业务状态自动消失。
一个典型场景:性能好了,超时却提前了
比如团队将毫秒级Timer统一向下取整到秒,数量下降,Checkpoint表现改善。随后测试发现部分订单提前不足一秒关闭。
最初认为用户时间显示有误,核对真实截止时间和目标Timer时间后,发现取整确实把截止往前移了。旧验收只测整数秒样本,恰好没有暴露偏差。
修复应改用符合“不早于截止”要求的分桶,并在回调复核业务截止与状态。新增样本包含整秒、整秒前一毫秒、整秒后一毫秒和状态已改变。
这是用精度换资源时必须交代的代价,不是一个可以因为偏差很小就忽略的实现细节。
分桶目标,不是实际触发延迟上限
事件时间Timer要等Watermark推进,处理时间Timer也可能受到任务繁忙和排队影响。目标只延后一秒,不代表墙钟时间里一定一秒内执行。
因此应分别监控目标时间偏移和实际业务动作延迟,避免把分桶精度当成端到端SLA。
恢复时也要测试。已过期的处理时间Timer在恢复后可能集中触发,形成瞬时负载;回调中的外部动作仍需幂等,不能假设恢复只发生一次。
最后比较Timer数量、相关状态大小、Checkpoint、回调耗时和业务超时准确性。如果一个时间桶太大,集中处理又制造长尾,就需要重新平衡粒度。
这道题的加分点是说明优化没有免费午餐:减少调度点必须同时保住“不该提前、不该漏、重试不重复”的业务约束。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。