Flink Buffer Debloating 是什么?把网络缓冲调大就能消除反压吗?
面试怎么回答
我会先判断瓶颈是不是网络传输,避免把下游慢误当缓冲不足。较多在途数据有助于吞吐,但会增加排队和Checkpoint相关成本。Flink的Buffer Debloating根据吞吐估计调整有效缓冲量,减少不必要在途数据;它不直接降低预分配网络内存。启用后应对稳定、突发和多输入负载分别测吞吐、延迟与Checkpoint,防止收缩过度导致吞吐下降。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
下游每秒只能处理一万条,上游每秒送两万条。把队列扩大一倍,积压会晚一点顶满,却不会凭空多出一万条处理能力。Flink 的网络缓冲也是这个道理:它能影响传输效率,但不能替代算子和外部系统的容量。
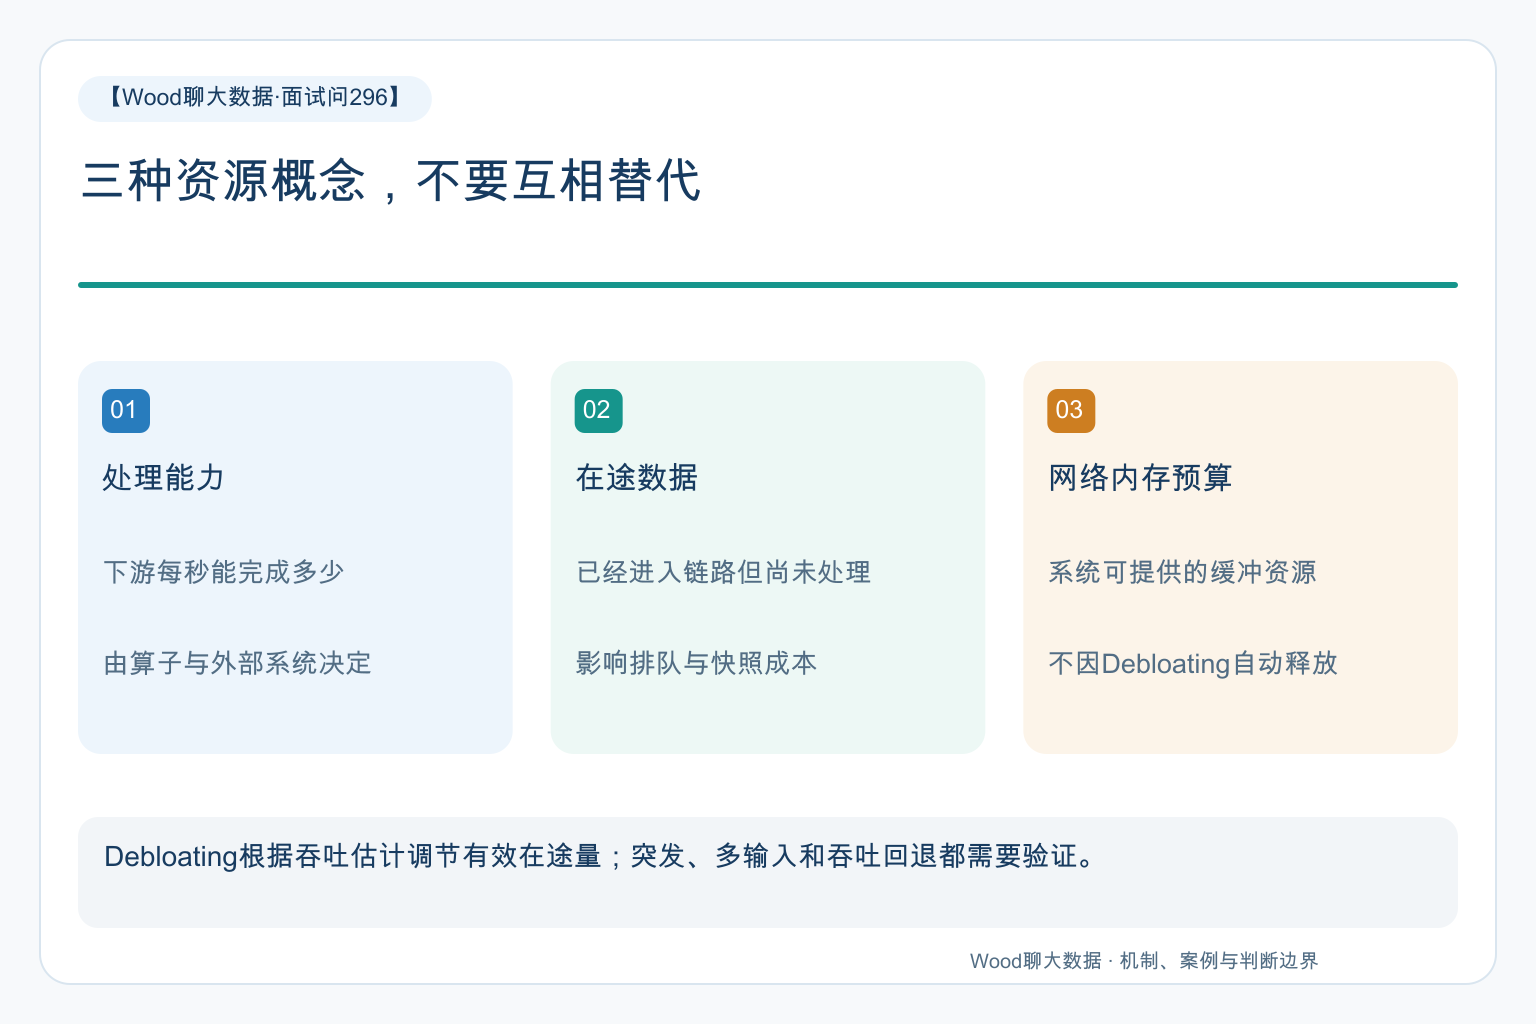
网络缓冲平衡吞吐与在途等待,不能增加下游处理能力;Debloating控制在途量,也不等于释放预留网络内存。
缓冲解决传输节奏,不解决无限积压
记录通常批量放入网络缓冲后传给下游,适当缓冲可以摊薄传输开销,让计算与网络更好衔接。
但如果下游持续处理不过来,扩大队列只是让更多数据等待。短时尖峰可以被吸收,持续超载则仍会反压,甚至让业务结果更晚可见。
先看上下游忙闲、网络队列与外部调用耗时。只有证据指向传输环节不能保持吞吐时,增加缓冲才是有针对性的尝试,而不是遇到反压的固定动作。
在途数据会影响Checkpoint
对齐Checkpoint中,Barrier沿着数据路径传播,前面在途数据很多时,时间进度可能更慢。
非对齐Checkpoint可以把相关在途数据纳入快照,因此缓冲更多,也可能增加需要持久化的快照内容。它改变的是一致性快照的处理方式,不会让这些字节免费消失。
所以同一个缓冲调整,应同时看正常吞吐、端到端等待、Checkpoint时长和大小。只记录每秒输入量,可能把延迟和恢复成本转移到别处。
Debloating调整的是什么?
以Flink 2.1文档为准,Buffer Debloating根据近期吞吐估计在途数据的消费时间,并调整有效缓冲使用量,使其接近配置的目标时间。
它是一个基于历史观测的自动调节机制,不是预知未来。突发流量、周期性窗口输出或者吞吐差异很大的多输入,都需要单独验证。
文档还特别说明,它限制有效使用的缓冲大小,并不直接减少已分配的缓冲数量和物理大小。因此启用后进程内存没有明显下降,不足以证明功能无效;判断目标应先回到在途量与消费时间。
一个典型场景:内存没降,被误判没有生效
比如团队启用Debloating,希望立刻降低TaskManager网络内存占用。看到容器内存曲线变化不大,便认为配置没生效,又继续压低内存参数。
进一步检查发现,估计缓冲消费时间和Checkpoint表现已经改善,只是预留内存并没有按预期释放。根因是把控制有效在途数据量理解成动态缩小进程内存预算。
旧验收只看一个容器内存数字,没有观察缓冲相关指标与吞吐。修复应按机制重新定义验收目标,再决定是否另行调整网络内存配置。
独立缩减内存预算是另一项变更,需要验证缓冲资源是否足够,不能因为Debloating有收益就顺手大幅压低所有资源。
测试不要只用平稳流量
持续稳定输入适合建立基线,但真实任务可能在窗口触发时突然输出大量记录。自动估计使用过去吞吐,面对快速变化可能来不及适配。
多输入任务也可能一条流很快、另一条很慢。只看子任务总体平均吞吐,未必能说明每条输入的缓冲都合适,应该关注不同输入的等待和吞吐差异。
可以分阶段比较开启前后:正常负载、业务峰值、短时突发,以及Checkpoint期间的表现。每次调整保留配置版本和回退方式。
如果吞吐下降、排队仍高,应该重新检查瓶颈,而不是不断把目标时间调得更极端。调参的目标是满足业务时效并稳定恢复,不是让某个队列指标越小越好。
面试里能说清“缓冲容量、在途数据、处理能力”不是一回事,就已经比只记住一个参数名更有价值。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。