Flink Barrier 对齐和非对齐 Checkpoint 有什么区别?
面试怎么回答
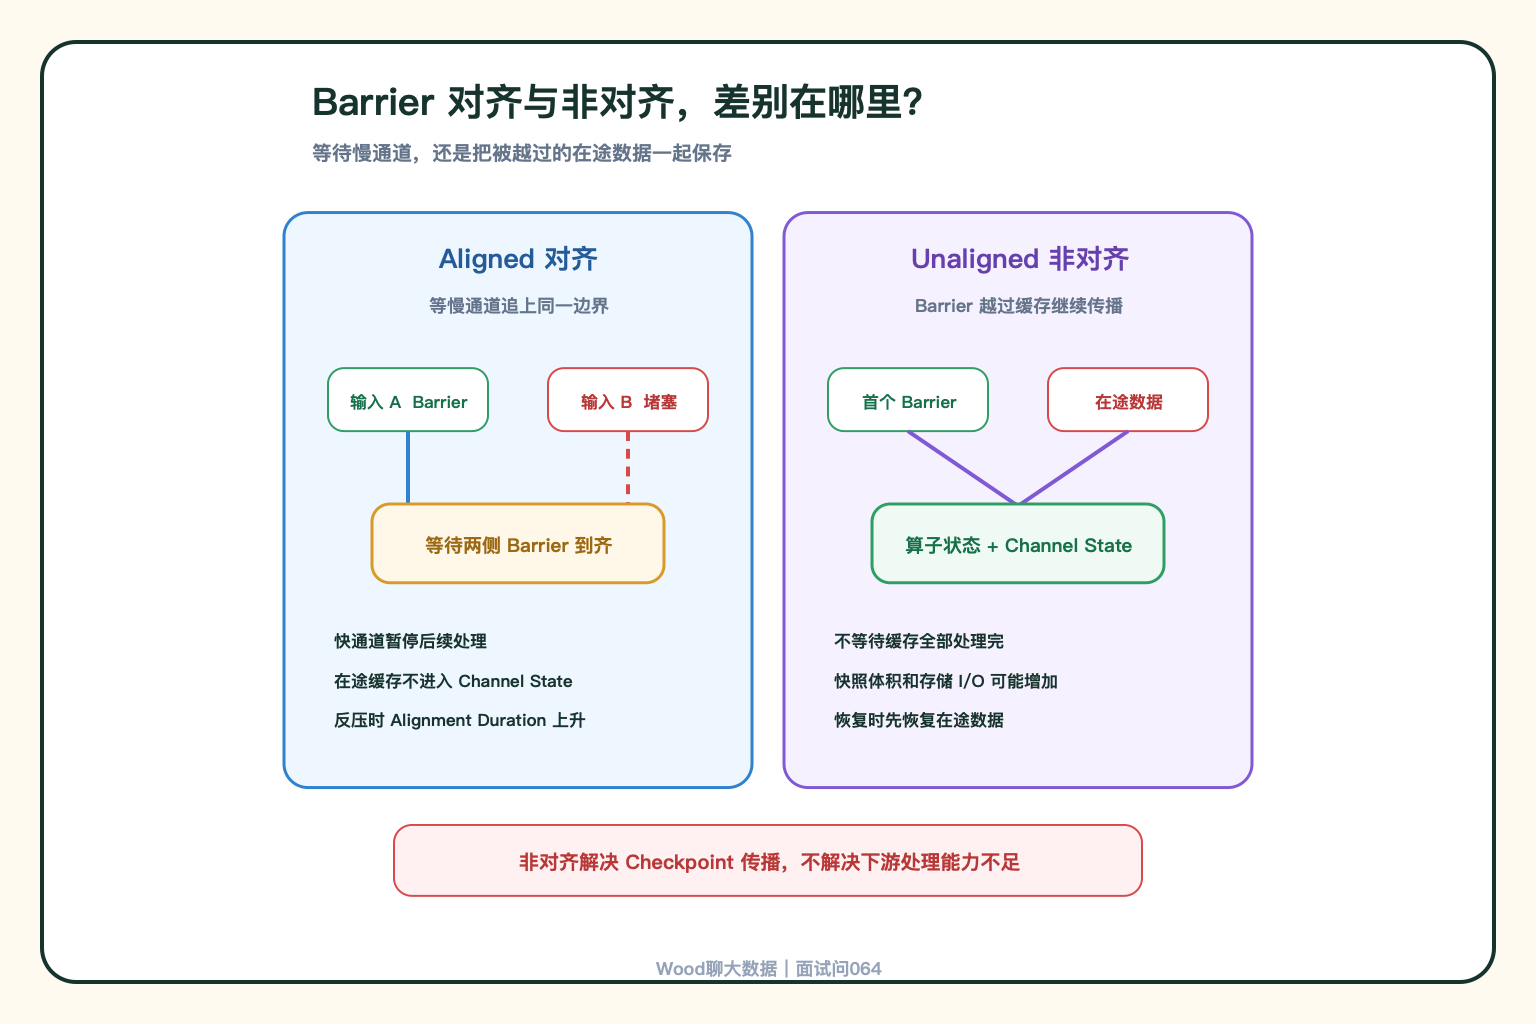
对齐 Checkpoint 会让已收到 Barrier 的输入等待其他输入到达同一边界,状态更直接,但反压时对齐时间会变长。非对齐允许 Barrier 越过缓存,并把在途数据作为 Channel State 一起保存,因此能稳定反压下的 Checkpoint 时长,但会增加存储 I/O、快照体积和恢复成本。它解决的是快照传播,不是反压根因。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一条 Flink 任务平时 Checkpoint 很稳定,一出现持续反压,Checkpoint 的 Alignment Duration 就越来越长,最后甚至超时失败。
这时常见建议是“开启非对齐 Checkpoint”。但如果说不清它保存了什么、换来了什么,就很容易把配置开关当成万能解法。
先说结论:对齐是等待各输入到达同一检查点边界;非对齐是不再等待慢通道,但要把尚未处理的在途数据一起保存。
Barrier 为什么需要对齐?
Flink 会在数据流中插入带编号的 Checkpoint Barrier。Barrier 前的数据属于当前快照,Barrier 后的数据属于下一个阶段。
对于多输入算子,两个输入的 Barrier 不会同时到达。对齐模式下,某个输入先收到 Barrier 后,会暂停继续消费这个输入的后续数据,等待其他输入的同编号 Barrier 到达。
当所有输入都到齐,算子才能确认:当前状态只包含 Barrier 之前的数据,不混入 Barrier 之后的数据,然后完成状态快照并继续处理。
反压为什么会拖慢对齐?
如果其中一条输入链路存在反压、倾斜或网络抖动,Barrier 会被积压的数据挡在后面。
快通道已经到达,只能等待慢通道;等待时间会直接体现在 Alignment Duration 或 Checkpoint Start Delay 上。反压持续越久,Checkpoint 越容易超时。
非对齐 Checkpoint 改变了什么?
非对齐模式下,算子收到第一个 Barrier 后,不再等待其他通道把前面的缓存数据全部处理完。Barrier 可以越过缓存向下游传播,而被越过的在途数据会作为 Channel State 一起写入 Checkpoint。
恢复时,除了恢复算子状态,还要先恢复这些在途数据,才能保持快照一致性。
两种方式怎么选?
正常情况下优先对齐
没有明显反压时,对齐等待通常很短,Checkpoint 结构也更直接,不需要额外持久化大量 Channel State。
反压让 Checkpoint 长时间不稳定时考虑非对齐
非对齐能缩短 Barrier 在拥堵链路上的传播时间,让 Checkpoint 时长不再强依赖当前吞吐。但在途数据越多,Checkpoint 体积、状态存储 I/O 和恢复工作量也可能越大。
状态存储 I/O 已经是瓶颈时要谨慎
非对齐会增加要写入的 Channel State。如果瓶颈本来就在远端存储或网络写入,再增加 I/O 可能适得其反。
部分版本还支持设置对齐超时:Checkpoint 先按对齐方式开始,超过阈值再切换为非对齐。具体配置和限制要以实际 Flink 版本为准。
非对齐不是反压治理
这一点非常重要。
非对齐解决的是“Barrier 被反压拖住,Checkpoint 完不成”,并不会提高下游处理能力,也不会降低业务端到端延迟。
开启之后仍然要继续定位:
- 哪个算子持续反压
- 是否存在数据倾斜
- Sink 或外部系统是否变慢
- 并行度和资源是否不足
- 单条记录处理或 Timer 触发是否过重
先保证容错快照稳定,再解决造成反压的真正瓶颈。