Flink Async IO 有 Exactly-once,调用外部接口就不会重复吗?
面试怎么回答
我会区分Flink内部状态和外部副作用。Async I/O会在恢复时重新触发未完成请求,外部动作可能已经成功,所以不能承诺接口只调用一次。写接口应使用稳定业务操作ID,并让接收方原子地完成去重与动作;或者采用有明确提交语义的Sink。验收要模拟成功回执丢失、重启和重复请求,确认最终业务结果,而不只看Checkpoint状态。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
接口已经给用户增加了积分,Flink却在收到成功回执之前重启。任务恢复以后,同一条事件又发起了一次请求。算子有Exactly-once,积分为什么还能加两遍?
算子状态恢复与外部动作提交是不同边界;异步请求可能重发,外部写操作需要稳定幂等键或可验证的提交协议。
先把“只处理一次”拆开
系统可以多次尝试处理同一事件,而最终状态只体现一次效果。这个意义上的Exactly-once,不等于网络请求在物理上只发出一次。
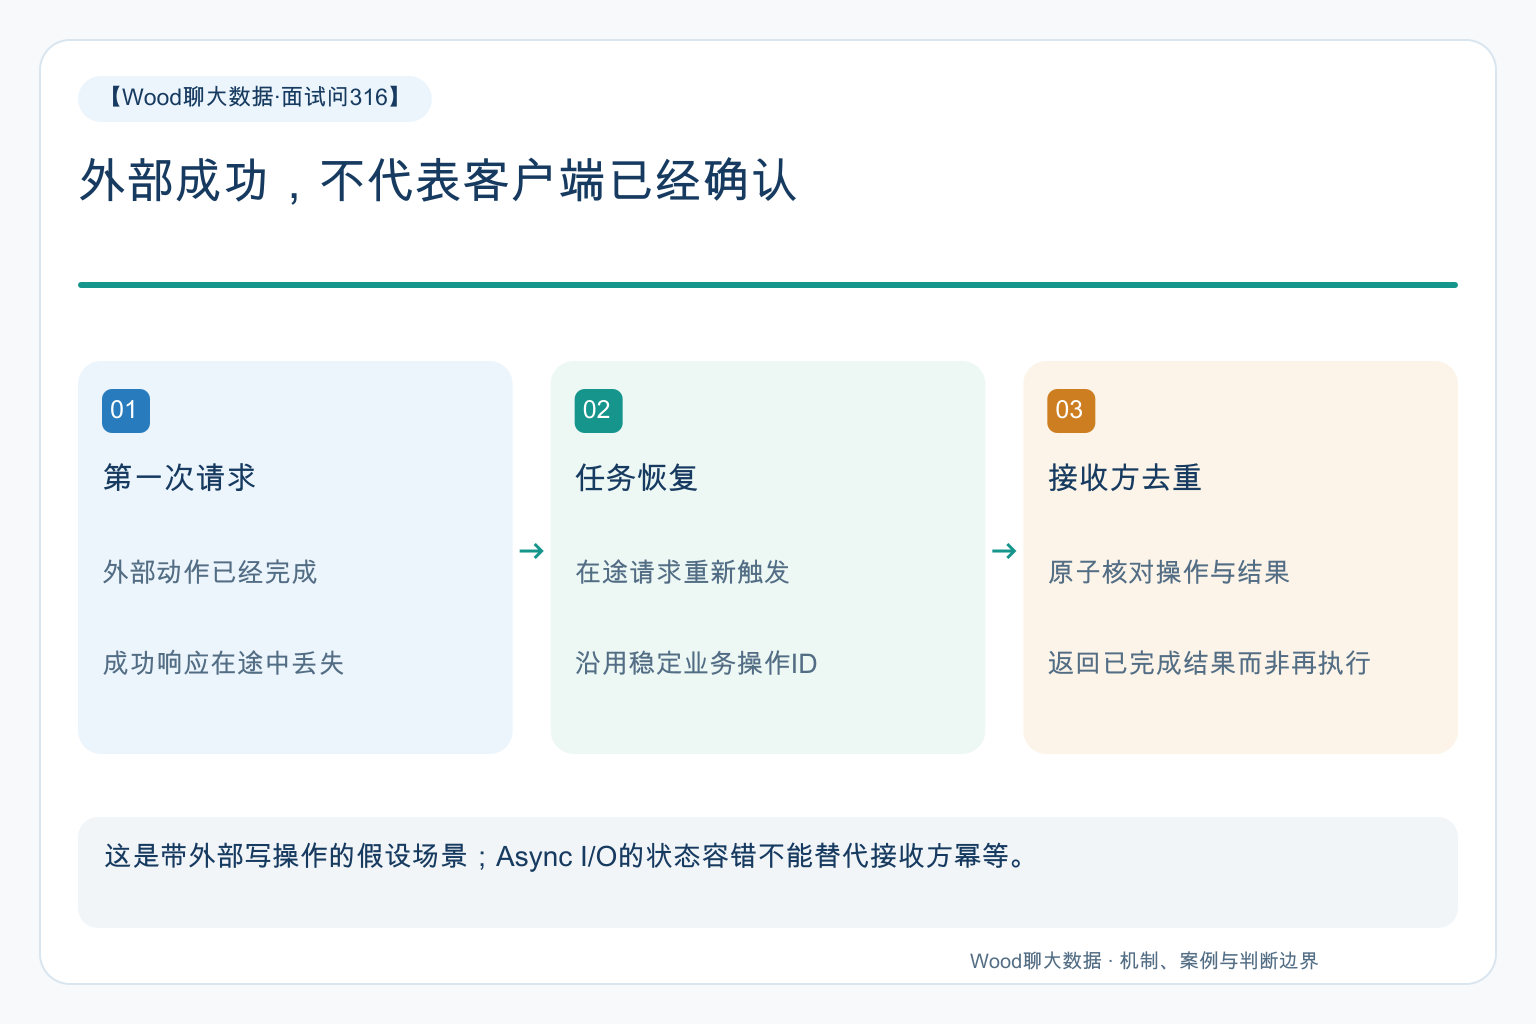
Flink 2.1的Async I/O文档说明,算子会把在途请求对应的记录保存到Checkpoint,故障恢复后重新触发请求。这个机制保证恢复能够继续,但不能让外部系统已经发生的任意动作自动回滚。
因此使用异步算子访问外部系统时,要先分清是在读取信息,还是在改变外部状态。异步只是并发访问方式,不是分布式事务的同义词。
最危险的是成功与确认之间
请求可能没到服务器,也可能执行失败,还可能执行成功但响应在网络中丢失。对客户端来说,三种情况都可能表现为超时。
如果每次重试都生成新请求ID,接收方就无法知道它们属于同一个业务动作。若直接停止重试,又可能漏掉真正未执行的请求。
所以需要一个跨重试、重启和历史回放保持稳定的业务操作ID。它可以由原始事件身份与动作类型构成,但要确认同一事件允许产生的多个合法动作不会被错误合并。
幂等需要在动作发生的一侧落地
只在Flink本地状态里记“已经调用”,不能覆盖所有失败窗口。先记状态再调用可能漏执行;先调用再记状态,崩溃时又可能重复。
接收方应在自己的可靠边界内,把操作ID去重与实际状态变更原子地结合。重复请求返回同一操作结果,而不是再次增加积分。去重记录保留时间也必须覆盖可能的重试与回放窗口。
如果接口提供查询操作状态的能力,超时后可以先核对稳定操作ID;但“查询后再执行”若没有并发保护,依旧可能出现两个调用者同时判断不存在的问题。
没有幂等能力时,要评估改造接口、使用可靠命令队列或适配具有提交协议的Sink。不能把一个普通HTTP调用包装成异步,就给它贴上端到端Exactly-once的标签。
只读查询也有重放边界
只读请求通常没有积分重复这种副作用,却可能在重试时读到已经变化的外部值。今天返回会员等级A,恢复后返回等级B,后续分流结果就可能变化。
需要复现历史规则时,应读取指定版本或时间点的数据,或者把当时使用的查询结果保存为可追溯输入。内部容错正确,不代表外部业务语义天然可重复。
并发量、超时和重试策略还要考虑接收方容量。无限提高并发可能把短暂慢请求放大成服务过载,再产生更多重试。
一个典型场景:故障演练才出现双倍积分
假设正常测试只覆盖成功请求和明确失败请求,所有结果都正确。上线演练模拟响应途中断网,业务却发现部分积分重复增加,最初怀疑Kafka重复消息没有去重。
真正的原因是同一业务事件产生两次外部写入:第一次成功但回执丢失,恢复后请求重发,而接口只按每次新生成的流水号识别请求。
修正后固定业务操作ID,并由积分服务在事务中处理去重和加分。回归测试保留响应丢失、进程退出、并发重复和超出去重保留期等场景,校验最终积分以及操作记录。
面试里能说清这一窗口,就说明你知道保证落在哪一侧。目标不是证明没有重试,而是证明必要的重试不会造成重复业务效果。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。