面试被问数仓分层?这样答才能拿高分
数仓分层这道题,面试出现率大概90%以上。
但真正答得好的人不到10%。大多数人的回答都是这样的:「ODS是原始层,DWD是明细层,DWS是汇总层,ADS是应用层」——四句话说完,面试官面无表情,你心里也知道凉了。
为什么?因为面试官要的不是背书,而是你对分层架构的理解深度和实战经验。
这篇文章,我把数仓分层从"是什么"到"怎么用"到"怎么在面试里讲出彩"一次讲透。
先搞清楚:为什么要分层?
很多人上来就开始背ODS/DWD/DWS/ADS,却说不清分层的目的是什么。
数仓分层的核心思想就四个字:以空间换时间。
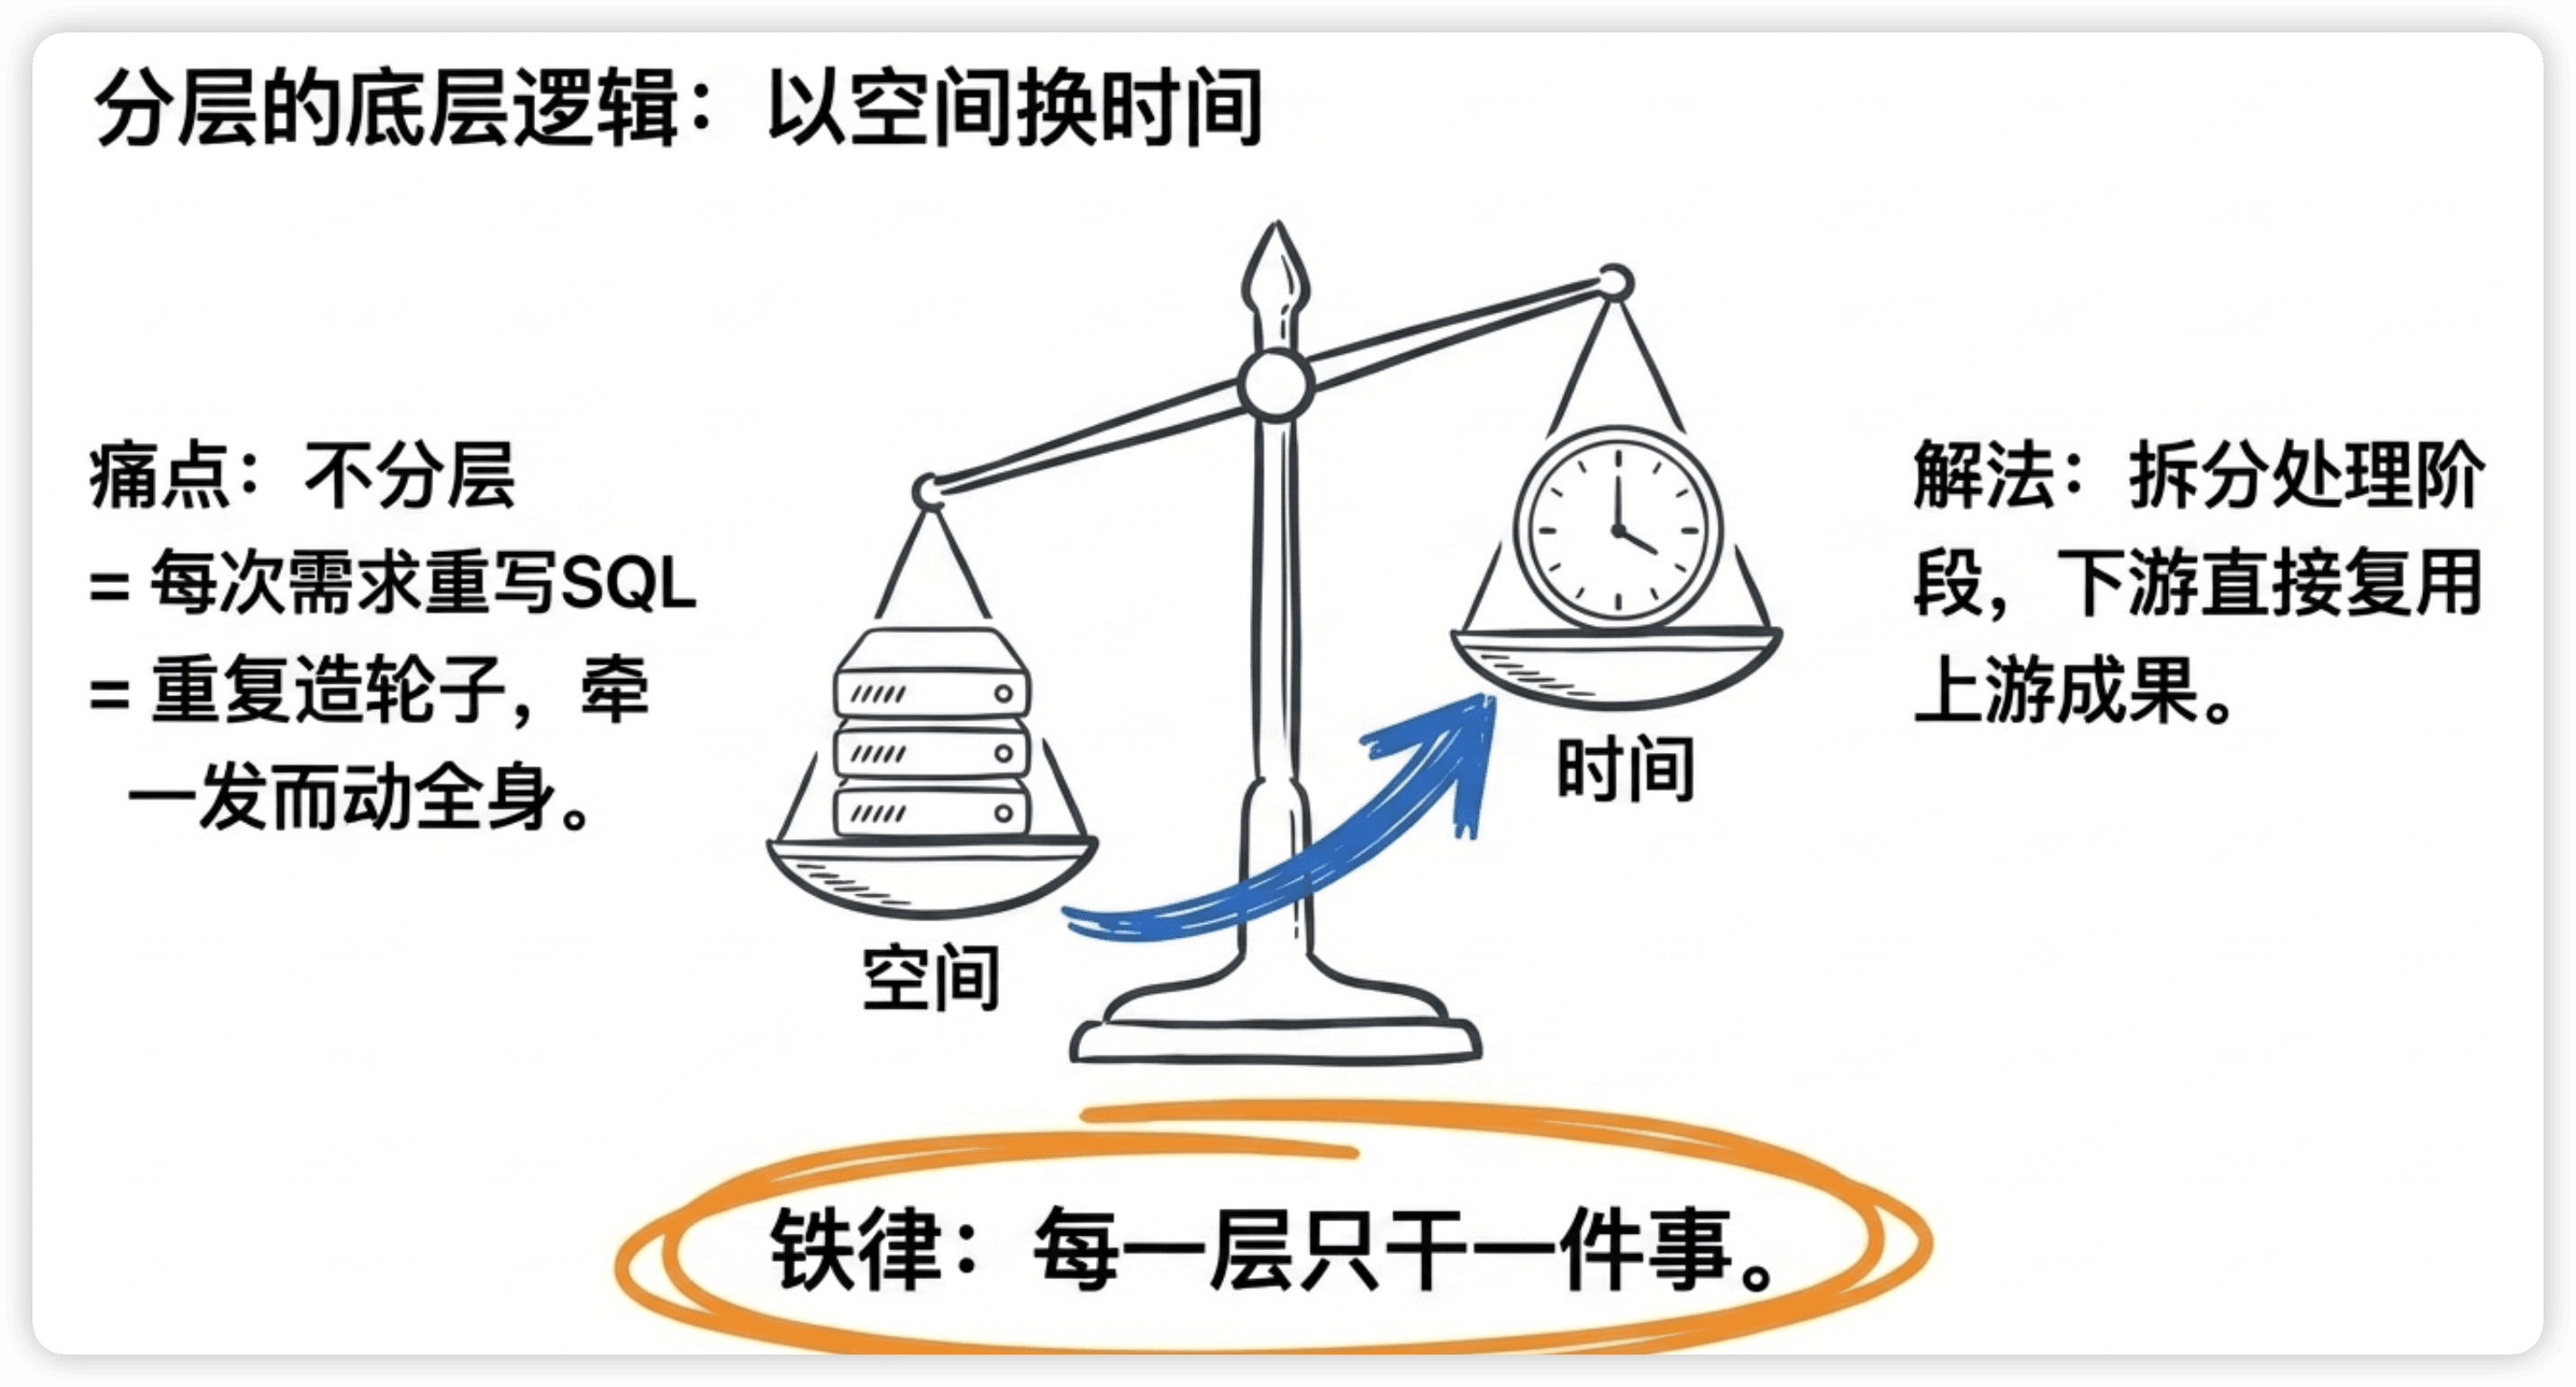
想象一下,如果没有分层,业务方每提一个需求,你就从原始数据开始写一条SQL:清洗、关联、聚合、输出,全部一步到位。第一次还好,第二个需求来了呢?大概率要重复80%的清洗和关联逻辑。再来第三个、第四个……你会发现自己在不停地重复造轮子,而且一旦某个源表的格式变了,你要改十几条SQL。
分层就是把数据处理拆成多个阶段,每一层只干一件事。下游直接复用上游的成果,不用每次从头来。
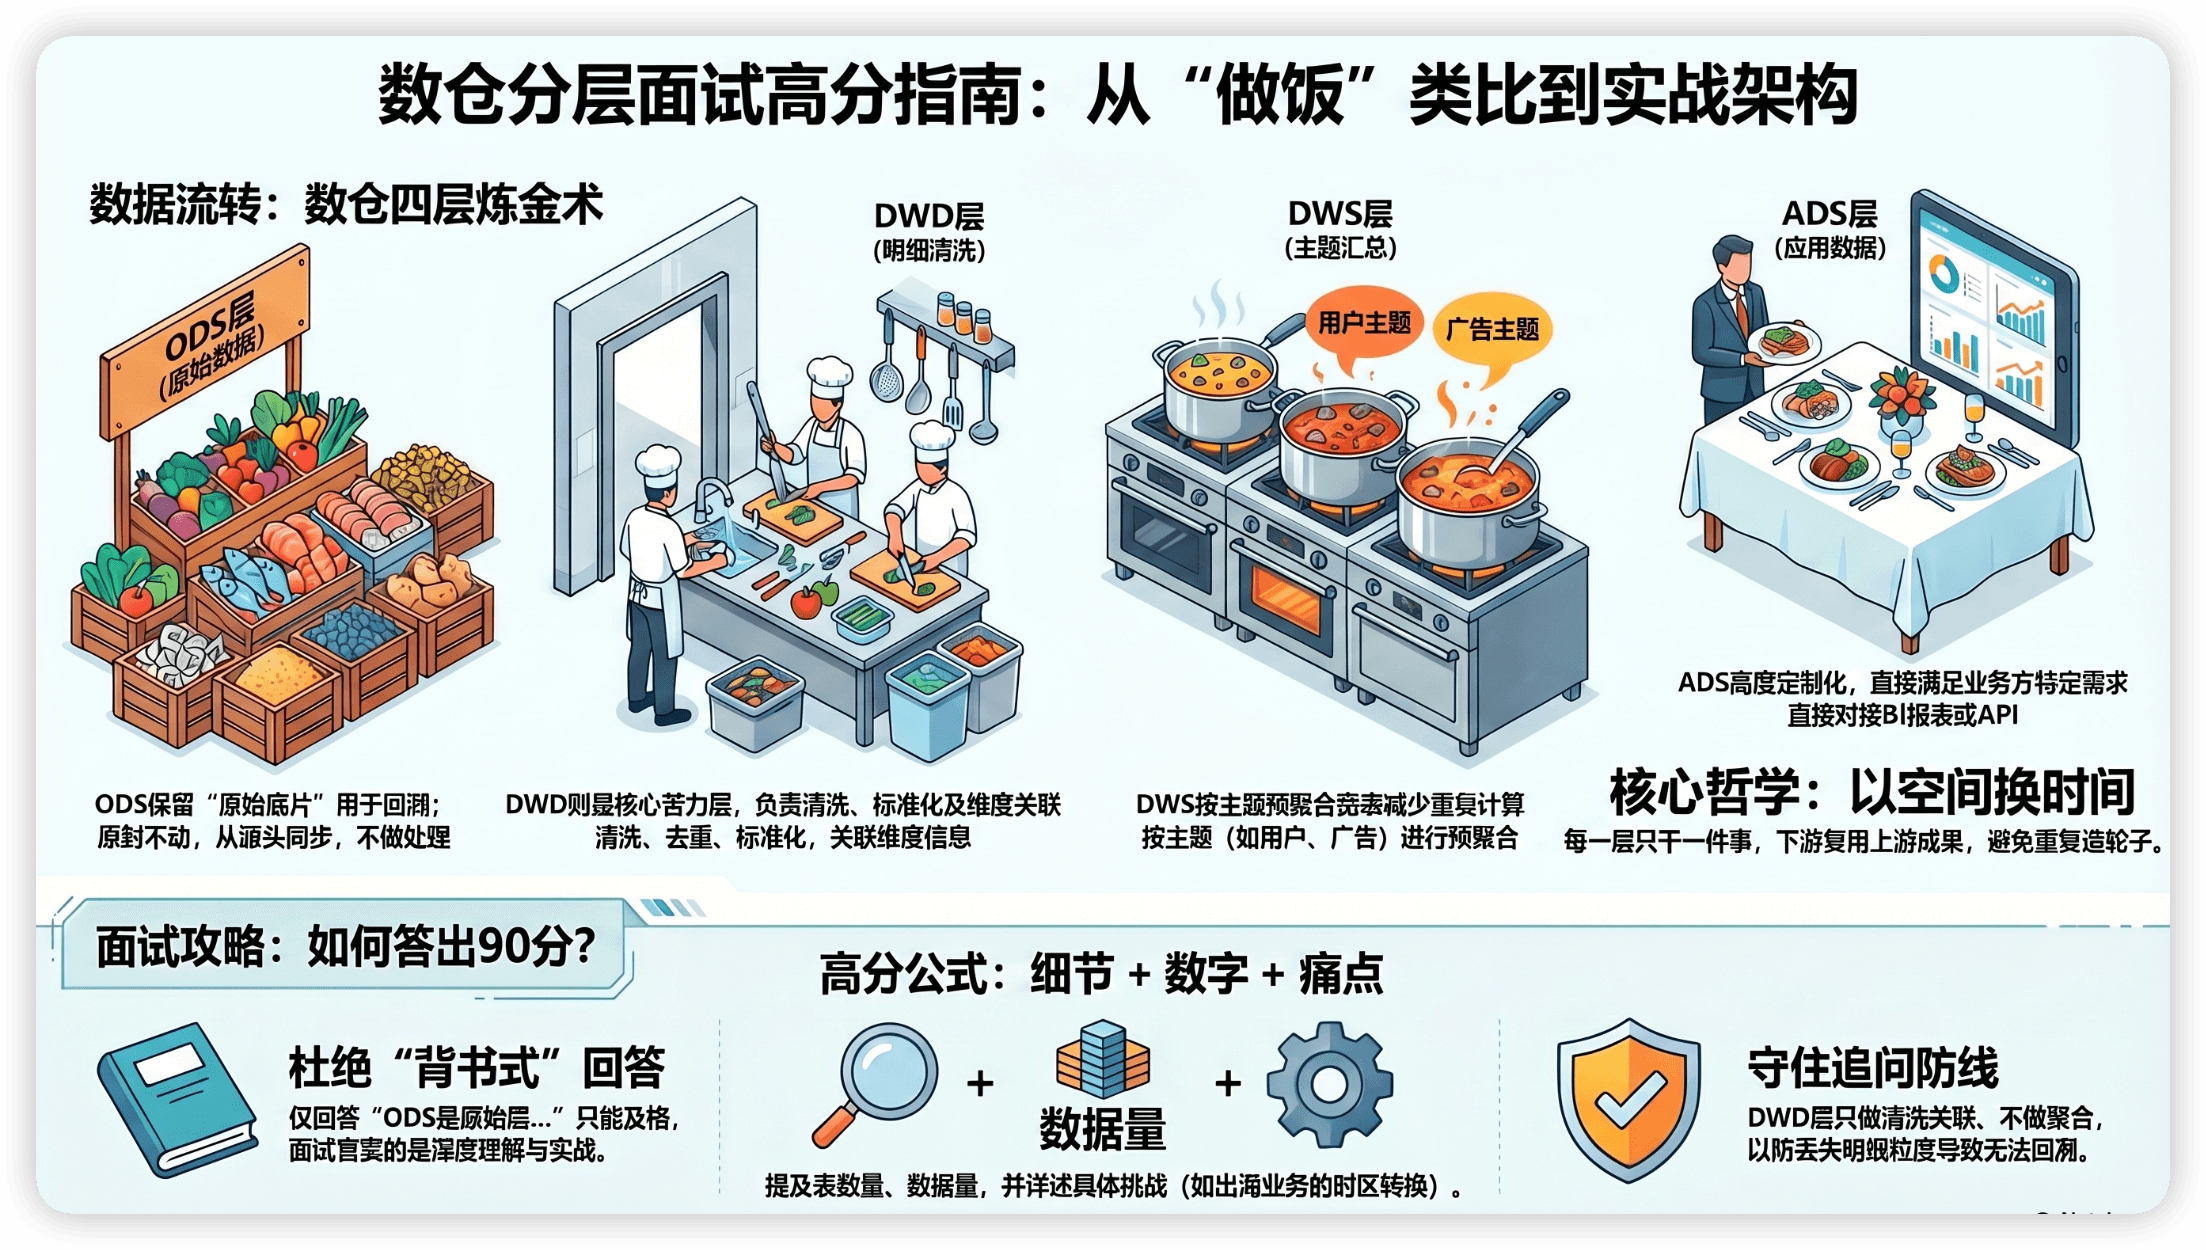
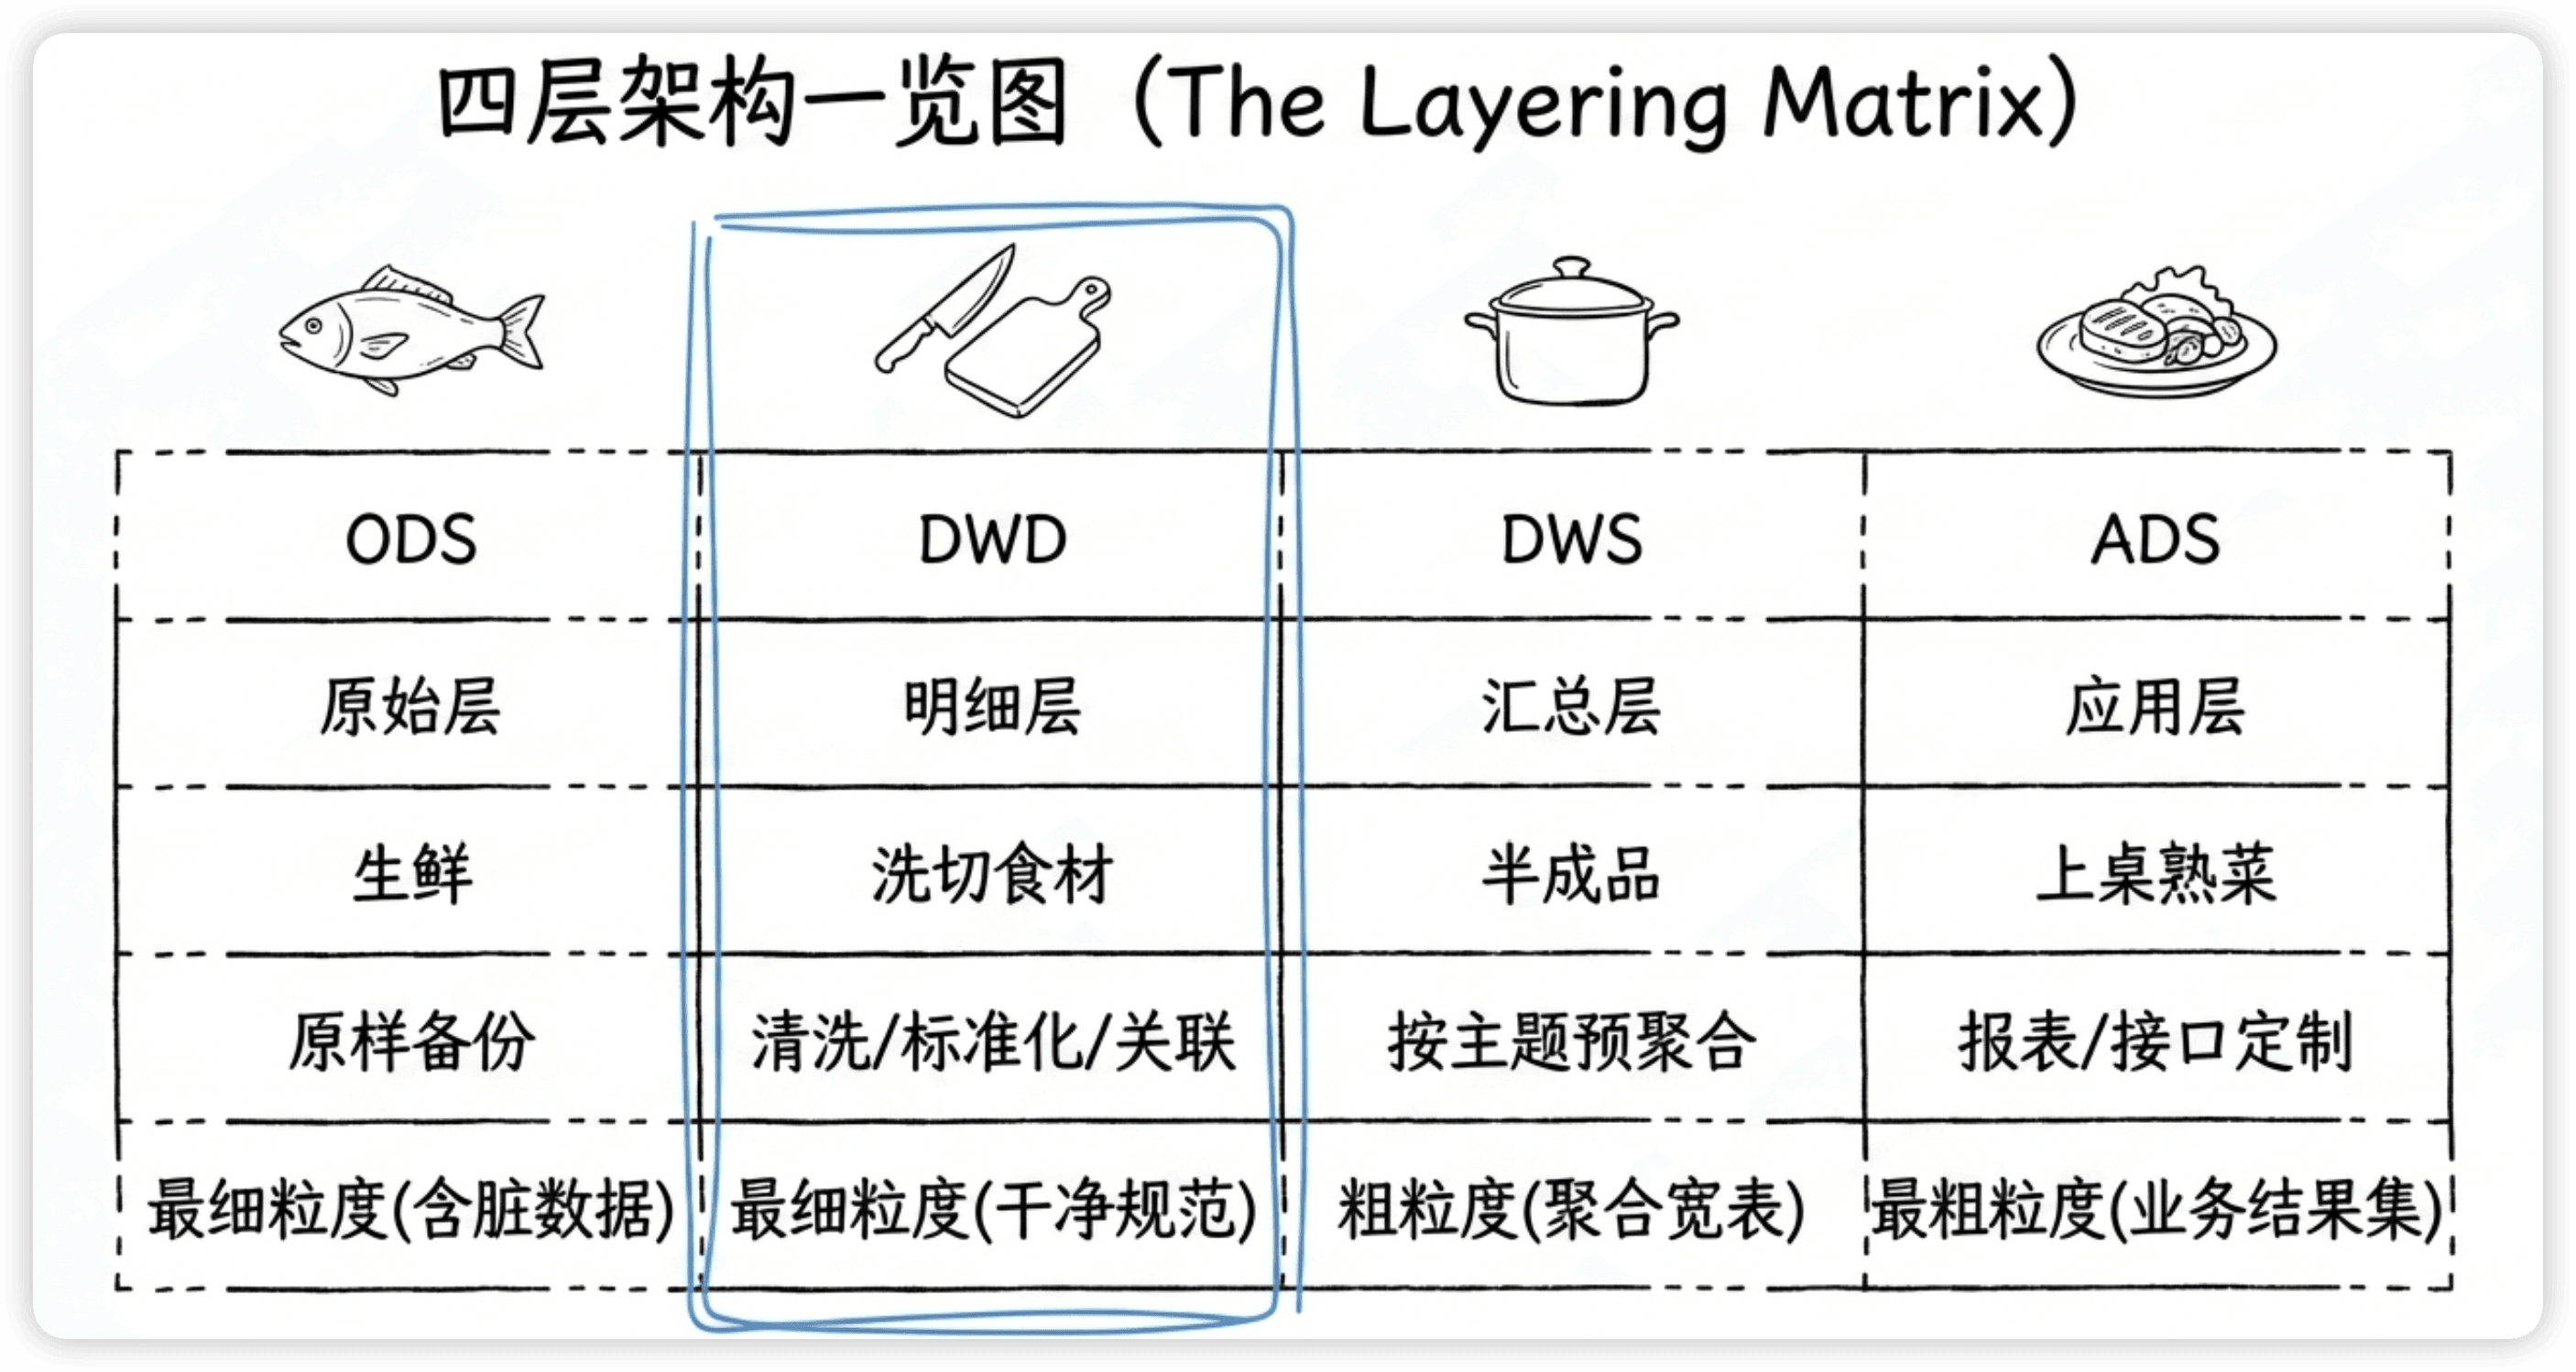
我喜欢用做饭来类比,一下就能记住:
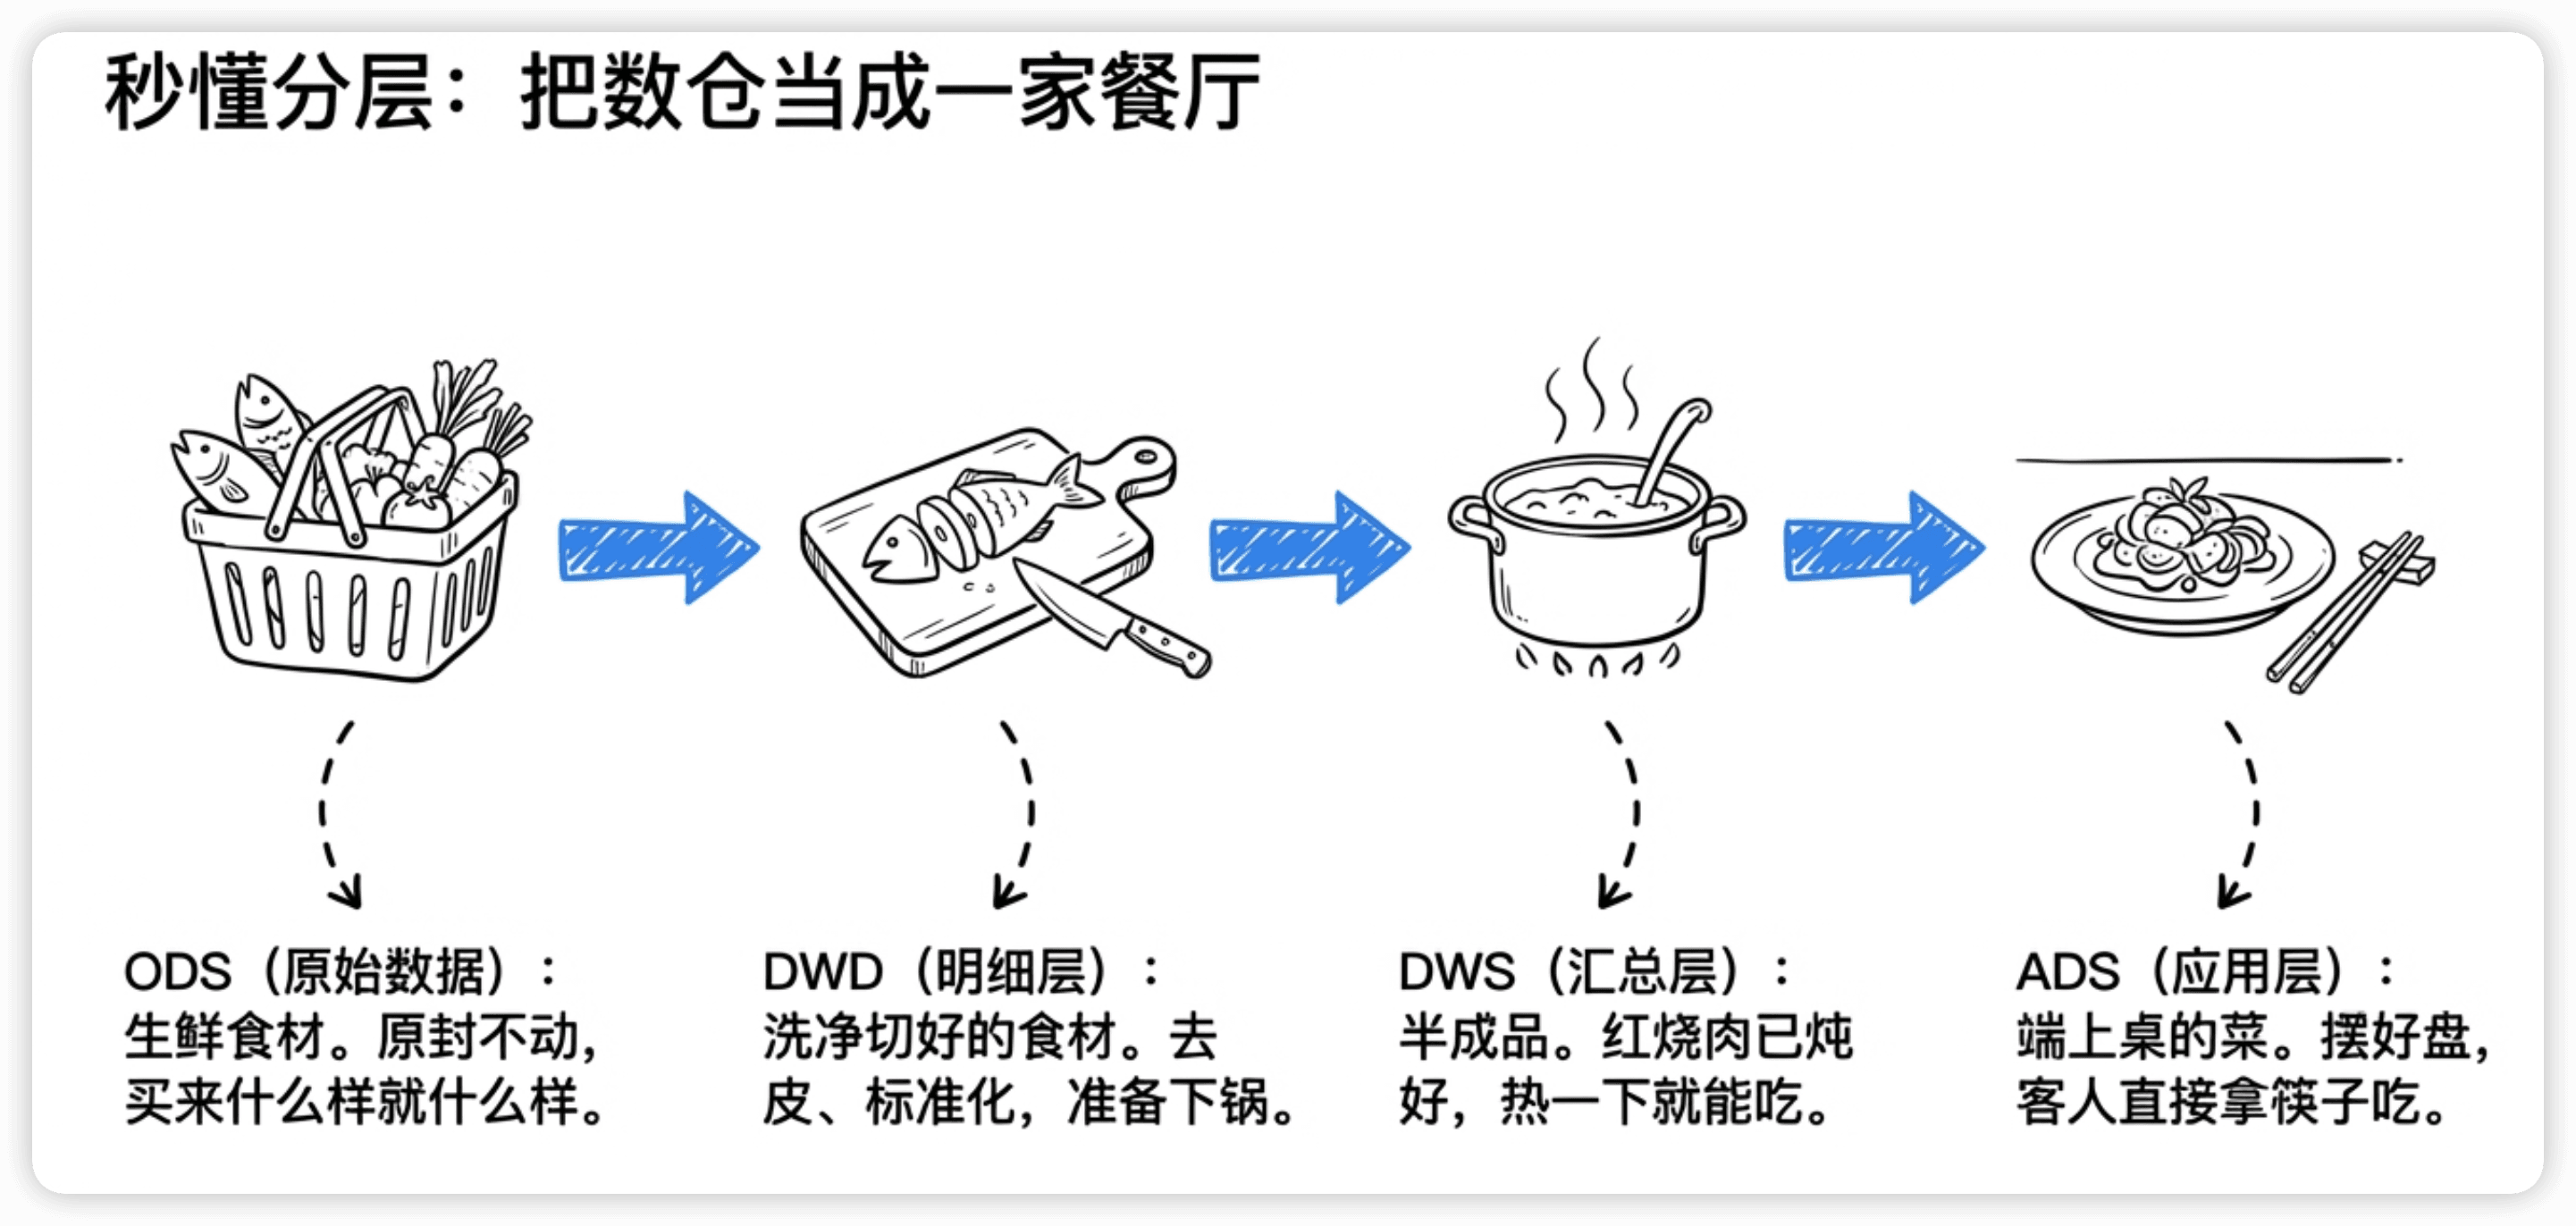
- ODS:菜市场买回来的生鲜——原封不动,什么样就什么样
- DWD:洗净切好的食材——清洗、标准化、该去皮的去皮
- DWS:做好的半成品菜——红烧肉已经炖好了,热一下就能吃
- ADS:端上桌的成品——摆好盘直接上桌,客人拿起筷子就能吃
你不会每次做饭都从杀鸡拔毛开始吧?数仓也一样。
四层架构,每层到底干什么?
ODS层:原始数据快照
ODS的全称是Operational Data Store,操作数据存储层。
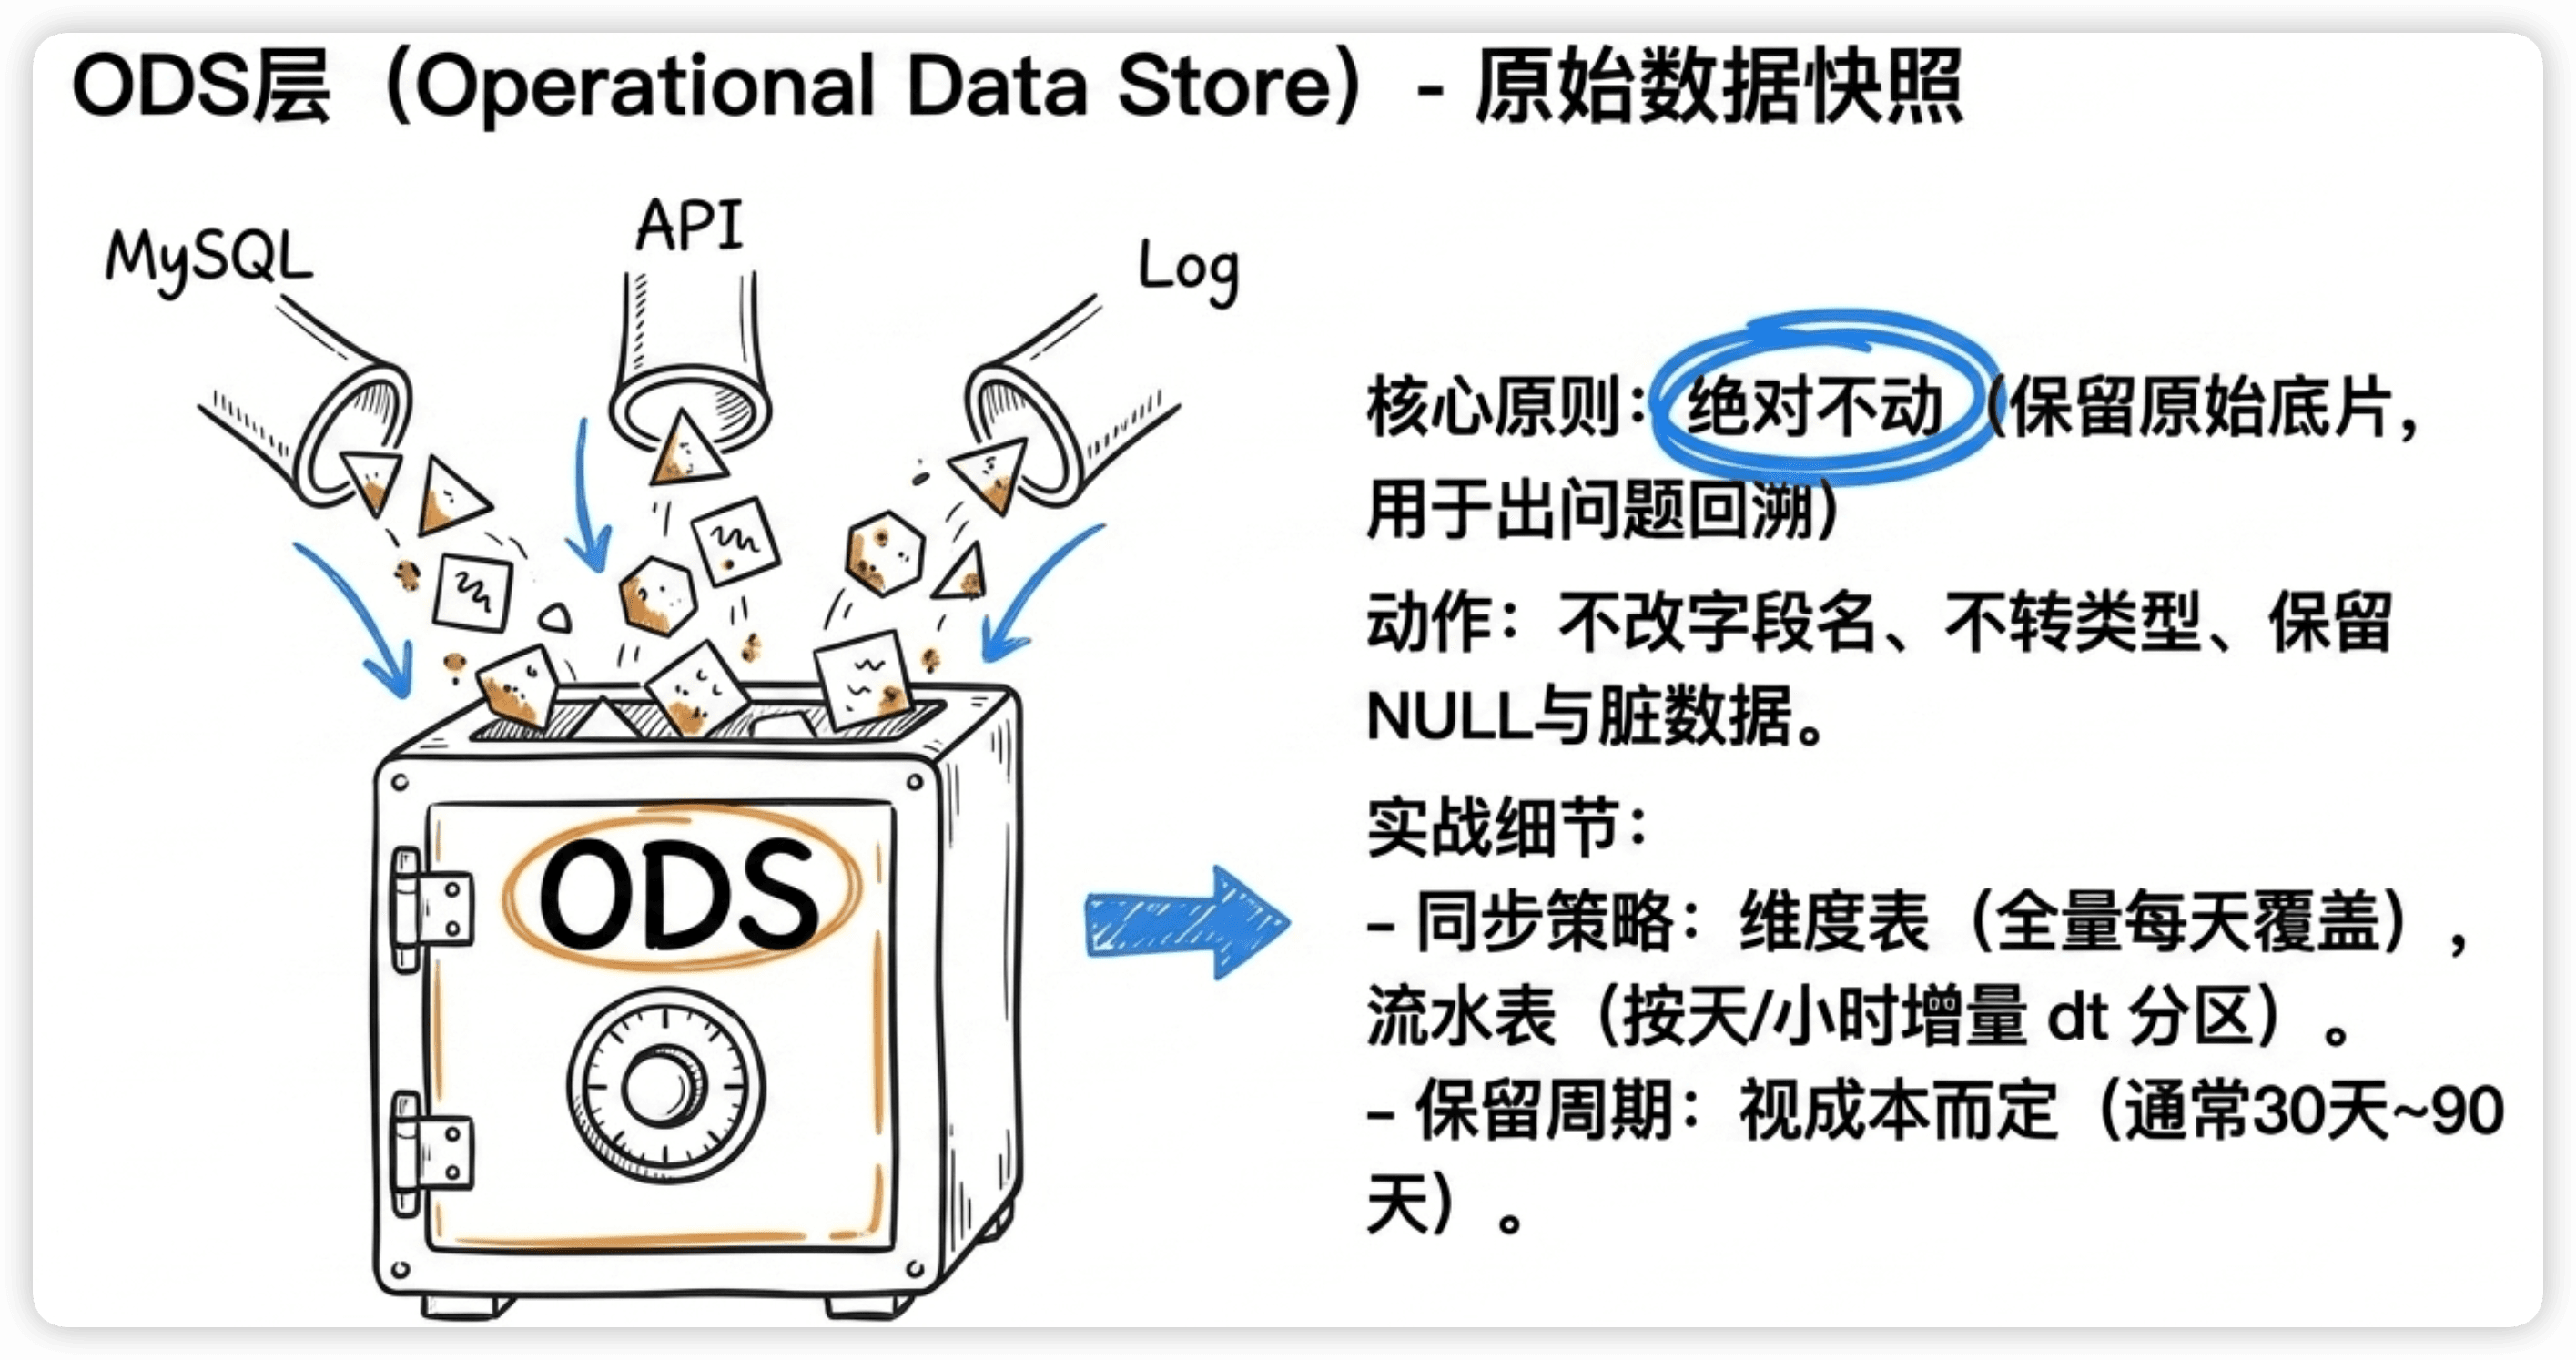
这层的原则就一个字:不动。
从MySQL、埋点日志、第三方API同步过来的数据,原封不动地存进来。字段名不改,数据类型不转,NULL值不处理,脏数据也先留着。它的作用是给数仓留一份"原始底片",任何时候出了问题都能回溯到最原始的数据。
实际工作中的样子:
-- 命名规范:ods_{来源系统}_{表名}_{加载方式}
-- di = daily increment 每日增量
-- df = daily full 每日全量

ods_mysql_order_di          -- MySQL订单表,每日增量同步
ods_mysql_user_df           -- MySQL用户表,每日全量同步
ods_log_click_di            -- 埋点点击日志,每日增量
ods_api_facebook_ads_di     -- Facebook广告数据API,每日拉取
ODS层的几个关键细节:
第一,增量还是全量?数据量小的维度表(比如城市表、渠道表)通常全量同步,每天覆盖就行。数据量大的流水表(比如订单、日志)必须增量同步,不然每天全量拉几十亿行不现实。
第二,保留多久?看公司要求。我在出海硬件品牌的时候ODS保留90天,短剧出海这边保留30天。时间再长的话存储成本扛不住,而且真正需要回溯半年前原始数据的场景极少。
第三,分区怎么设?通常按天分区(dt字段),这是最通用的做法。个别数据量特别大的表(比如每天几亿行的日志)可以加小时分区。
DWD层:明细清洗层(最重要的一层)
DWD的全称是Data Warehouse Detail,明细数据层。
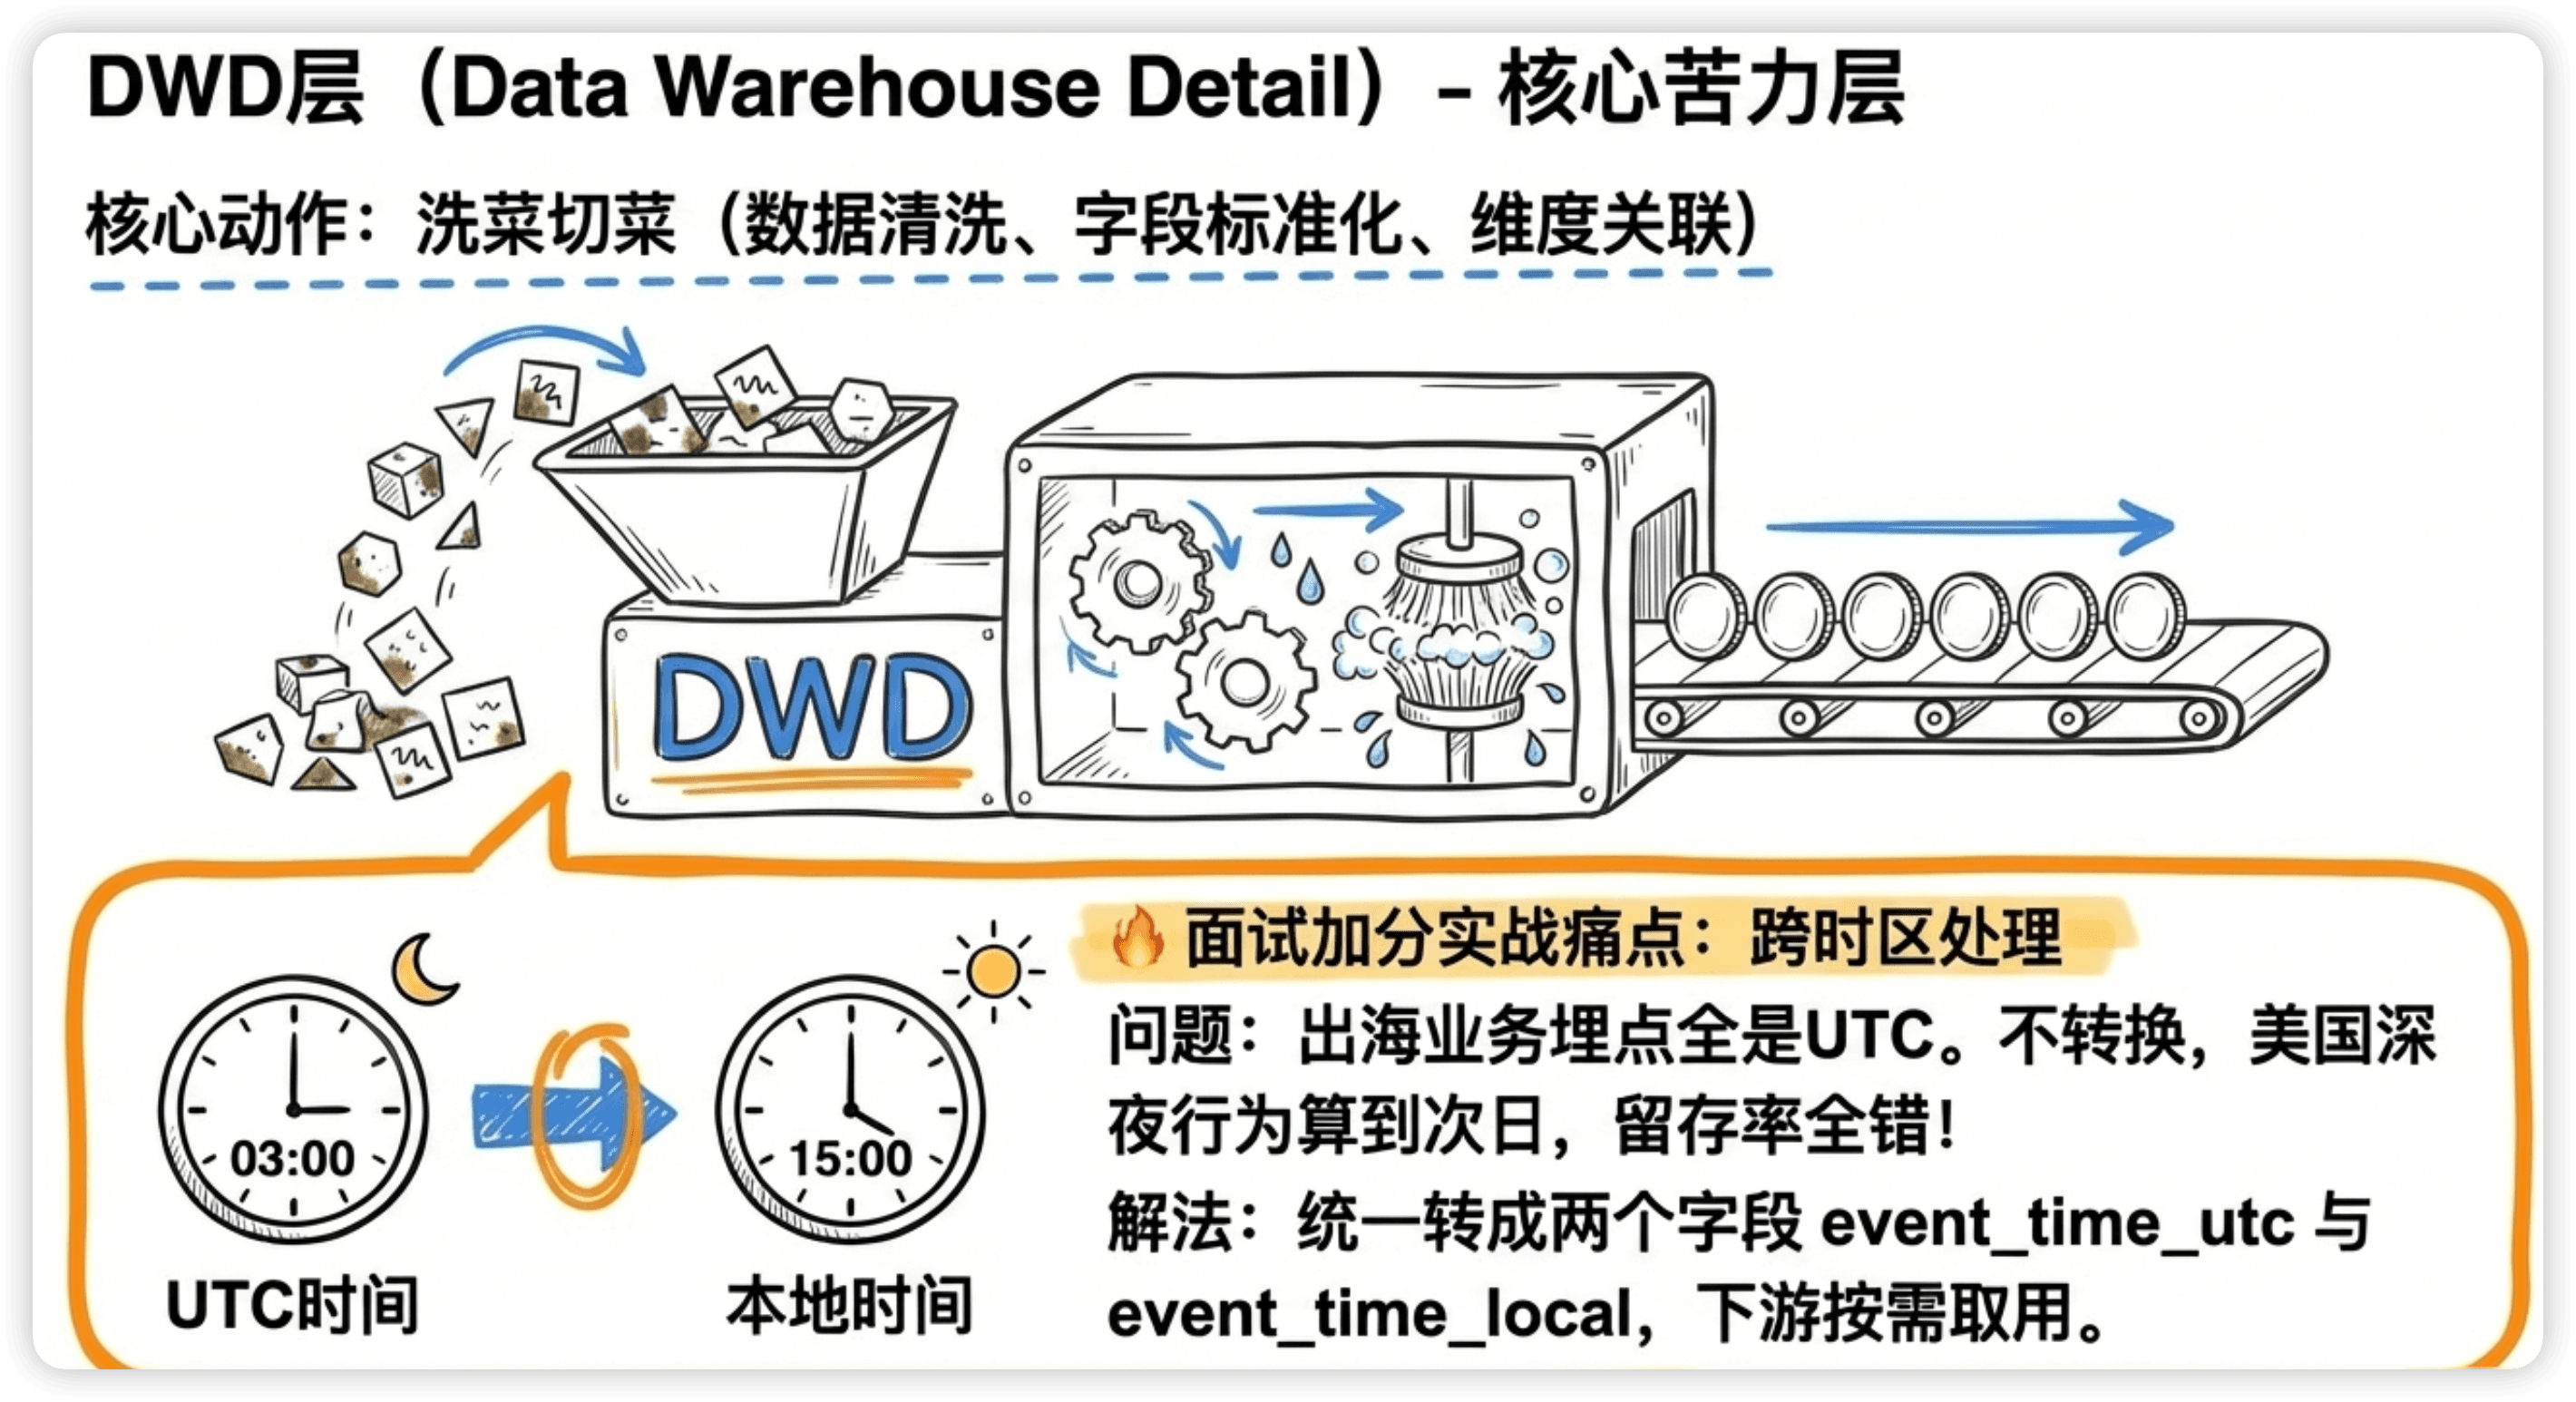
这层是数仓的核心苦力层,干的活最多也最重要。如果ODS是生鲜,DWD就是洗菜切菜——看起来不起眼,但做不好后面全白搭。
DWD层要做的事情:
① 数据清洗
-- NULL值处理
COALESCE(user_name, '未知用户') AS user_name

-- 异常值过滤
WHERE order_amount > 0                   -- 过滤金额为负的异常订单
  AND order_amount < 1000000             -- 过滤明显不合理的大金额

-- 数据去重(同一笔订单可能因为重试被采集两次)
ROW_NUMBER() OVER (PARTITION BY order_id ORDER BY update_time DESC) = 1
② 字段标准化
不同来源系统对同一个概念的命名和格式可能完全不一样,DWD层要统一成一套标准。
-- 性别字段:来源A写的是 M/F,来源B写的是 1/0,来源C写的是 male/female
CASE
    WHEN gender IN ('M', '1', 'male')   THEN '男'
    WHEN gender IN ('F', '0', 'female') THEN '女'
    ELSE '未知'
END AS gender_std

-- 时间格式统一
FROM_UNIXTIME(create_time / 1000, 'yyyy-MM-dd HH:mm:ss') AS create_time_std
③ 维度关联
在DWD层把常用的维度信息关联上来,下游不用每次都去JOIN维度表。
SELECT
    o.order_id,
    o.user_id,
    u.user_name,
    u.city,
    u.register_channel,
    o.product_id,
    p.product_name,
    p.category,
    o.order_amount,
    o.create_time
FROM ods_order_di o
LEFT JOIN dim_user u ON o.user_id = u.user_id
LEFT JOIN dim_product p ON o.product_id = p.product_id
WHERE o.dt = '${bizdate}'
④ 跨时区处理(出海业务的痛点)
这一点我要多说两句,因为这是我在短剧出海公司DWD层花时间最多的部分。
海外用户遍布全球几十个时区,埋点数据和服务端日志的时间戳通常是UTC。如果DWD层不做时区转换,后面的留存率、日活、次日留存这些指标全是错的——美国用户晚上11点的行为被算到了第二天,留存率直接虚高。
-- UTC转用户当地时间
-- 根据用户注册时的IP归属国家确定时区
FROM_UTC_TIMESTAMP(event_time, user_timezone) AS local_event_time

-- 用转换后的本地时间来确定"哪一天"
DATE(FROM_UTC_TIMESTAMP(event_time, user_timezone)) AS local_date这件事看起来简单,但坑特别多:夏令时切换、用户跨国旅行、部分国家有半小时时区偏移(比如印度是UTC+5:30)。我们后来的做法是在DWD层统一转成两个字段:event_time_utc(保留原始UTC)和event_time_local(按用户归属国时区转换),下游按需取用。
DWD层命名规范:
dwd_{业务域}_{数据域}_{加载方式}

dwd_trade_order_detail_di       -- 交易域-订单明细-每日增量
dwd_user_login_detail_di        -- 用户域-登录明细-每日增量
dwd_ad_click_detail_di          -- 广告域-点击明细-每日增量
DWS层:主题汇总层
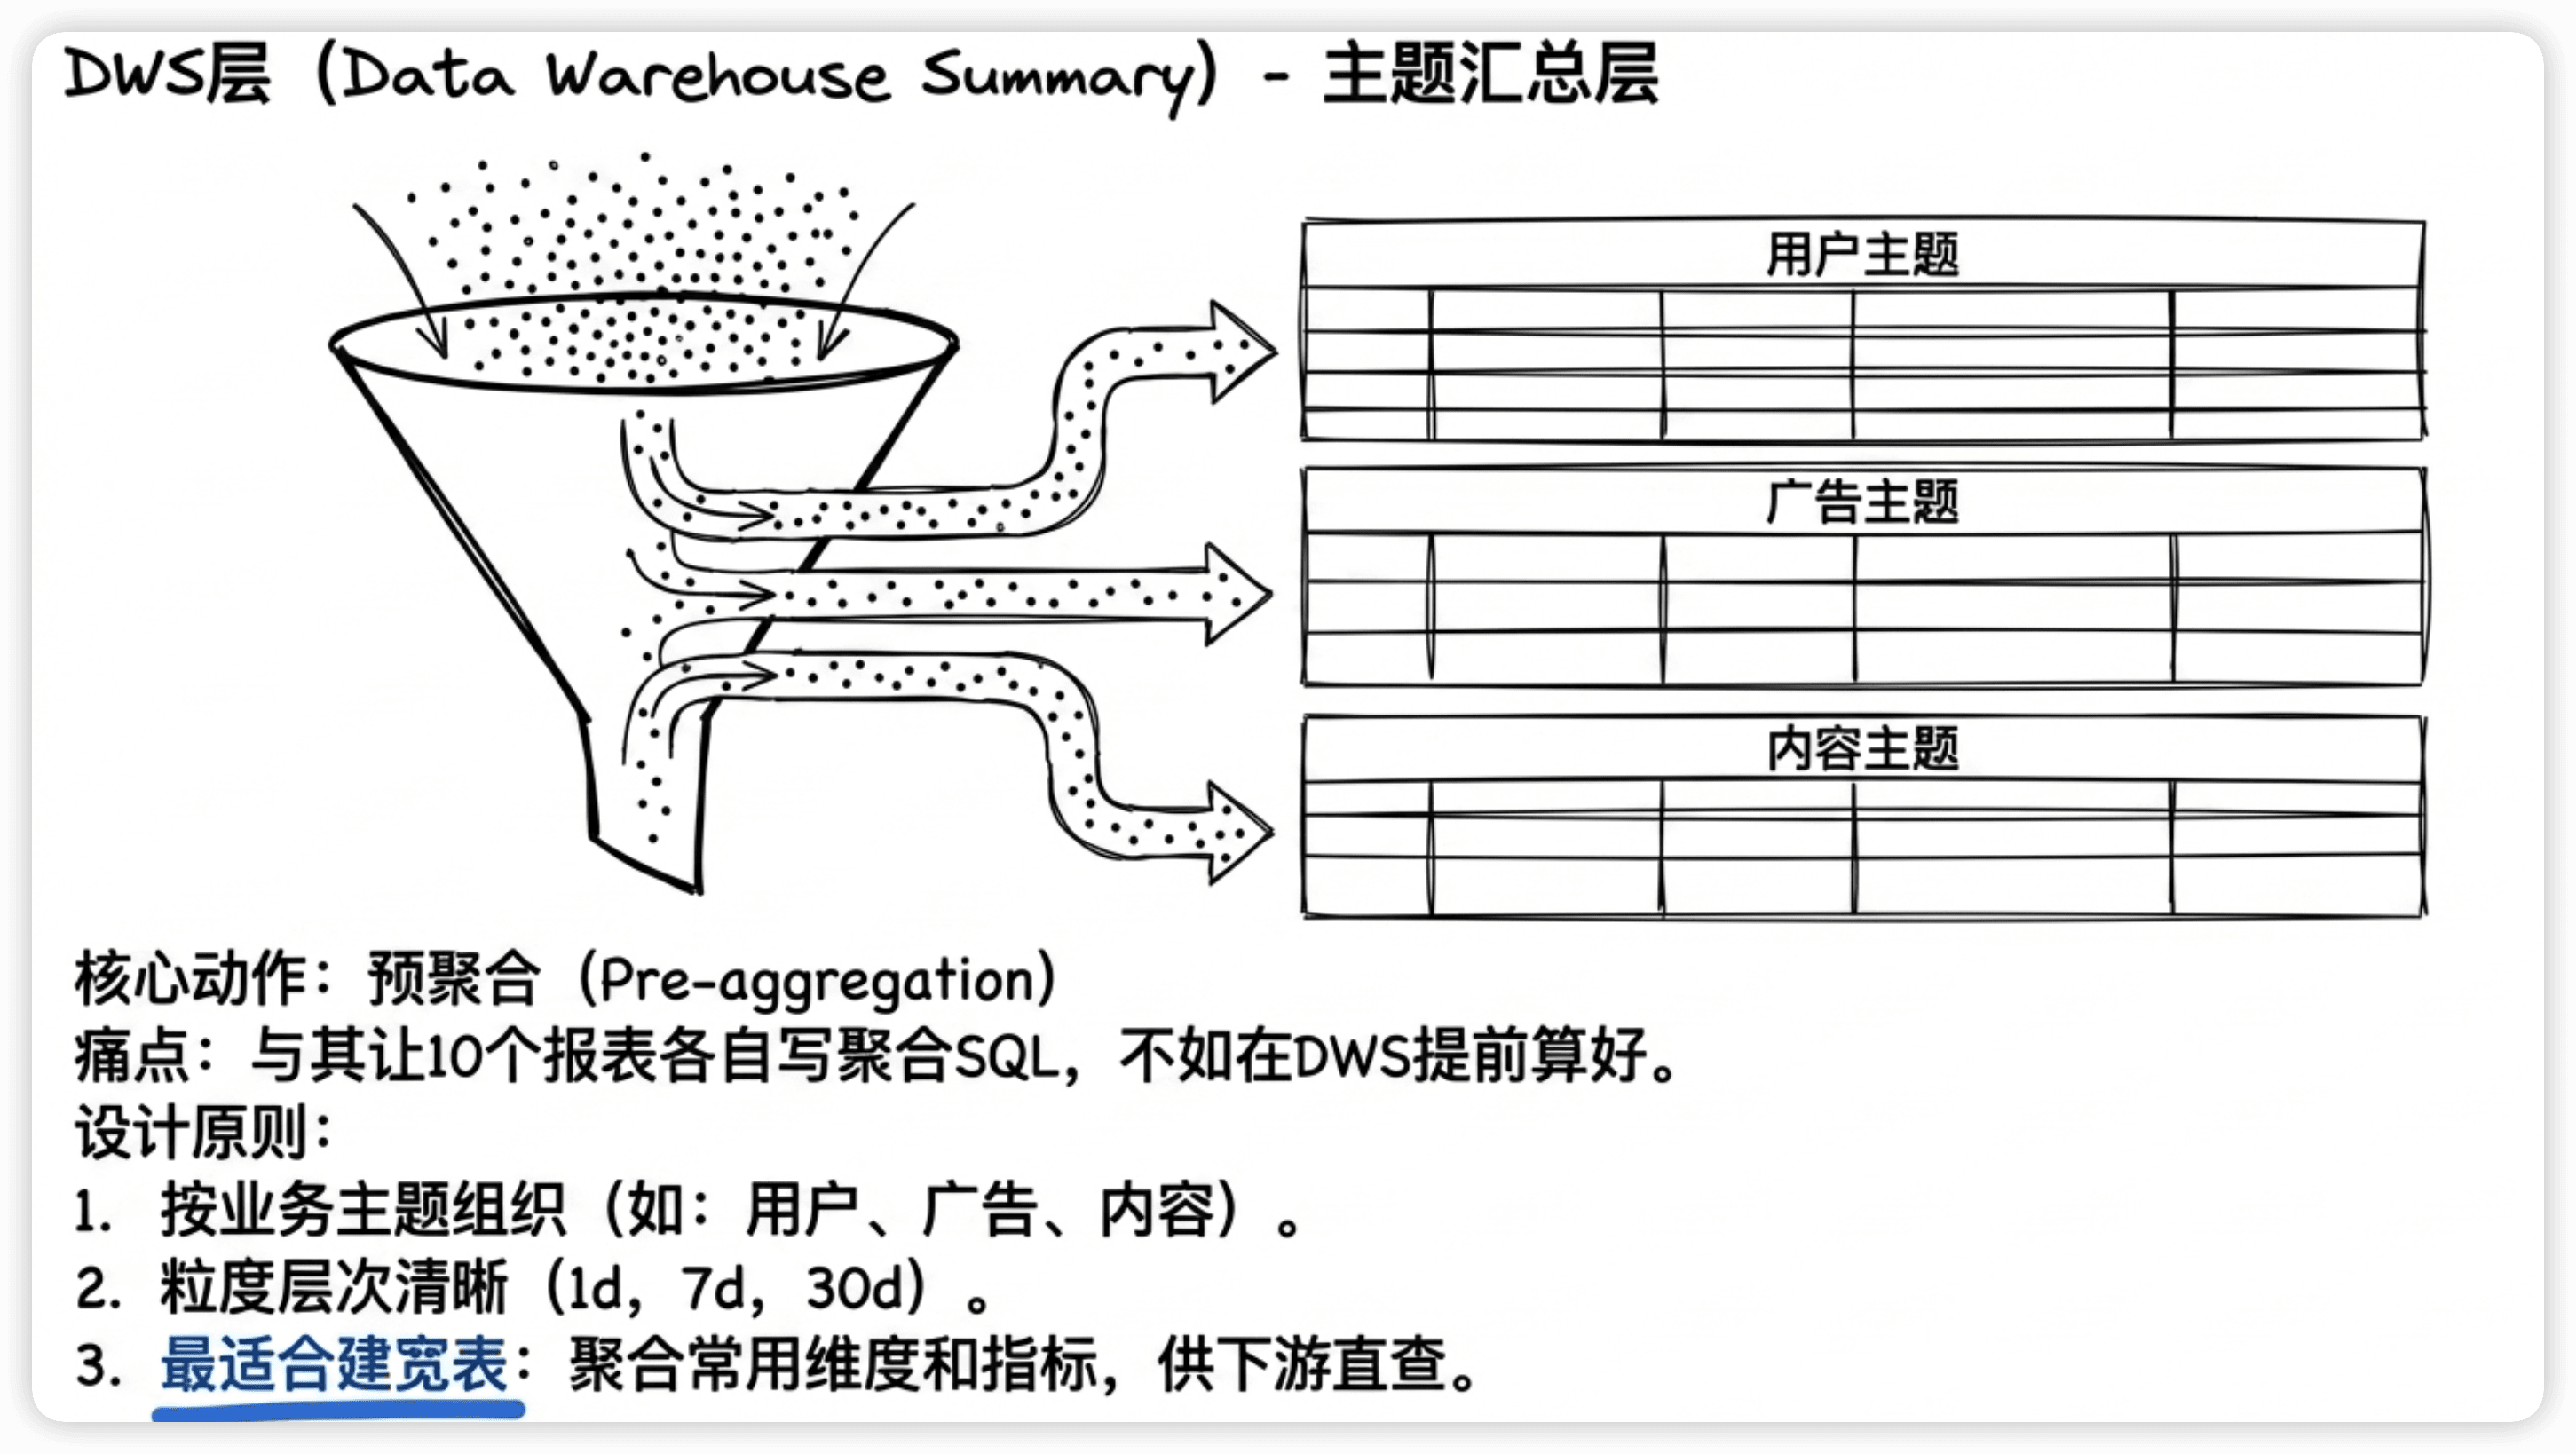
DWS的全称是Data Warehouse Summary,汇总数据层。
DWD层的数据粒度还是很细的(一行一条记录),到了DWS层就要按照业务主题做预聚合。
比如下游经常需要看"每个用户每天的行为汇总",与其让10个报表各自写一遍聚合SQL,不如在DWS层提前算好。
-- 典型DWS表:用户行为日汇总
CREATE TABLE dws_user_behavior_1d AS
SELECT
    user_id,
    dt,
    COUNT(DISTINCT session_id)                       AS session_cnt,      -- 会话数
    SUM(CASE WHEN event = 'click' THEN 1 ELSE 0 END) AS click_cnt,       -- 点击次数
    SUM(CASE WHEN event = 'play' THEN 1 ELSE 0 END)  AS play_cnt,        -- 播放次数
    SUM(play_duration)                                AS total_play_sec,  -- 总播放时长(秒)
    SUM(order_amount)                                 AS total_pay_amount,-- 总支付金额
    MIN(event_time)                                   AS first_active_time,-- 当日首次活跃
    MAX(event_time)                                   AS last_active_time  -- 当日末次活跃
FROM dwd_user_behavior_detail_di
WHERE dt = '${bizdate}'
GROUP BY user_id, dt;
DWS层的设计原则:
第一,按主题组织,不要什么都往一张表里塞。我们短剧出海的DWS层按三个主题建设:用户行为主题、广告投放主题、内容消费主题。
第二,粒度层次要清晰。同一个主题可能有多个粒度的汇总表,命名上要区分开:
dws_user_behavior_1d     -- 用户+天 粒度(每天一行)
dws_user_behavior_7d     -- 用户+周 粒度(最近7天汇总)
dws_user_behavior_30d -- 用户+月 粒度(最近30天汇总)第三,DWS层的表是最适合建宽表的位置。把一个主题下常用的维度和指标都聚合进来,下游直接查。
ADS层:应用数据层
ADS的全称是Application Data Store,应用数据层。
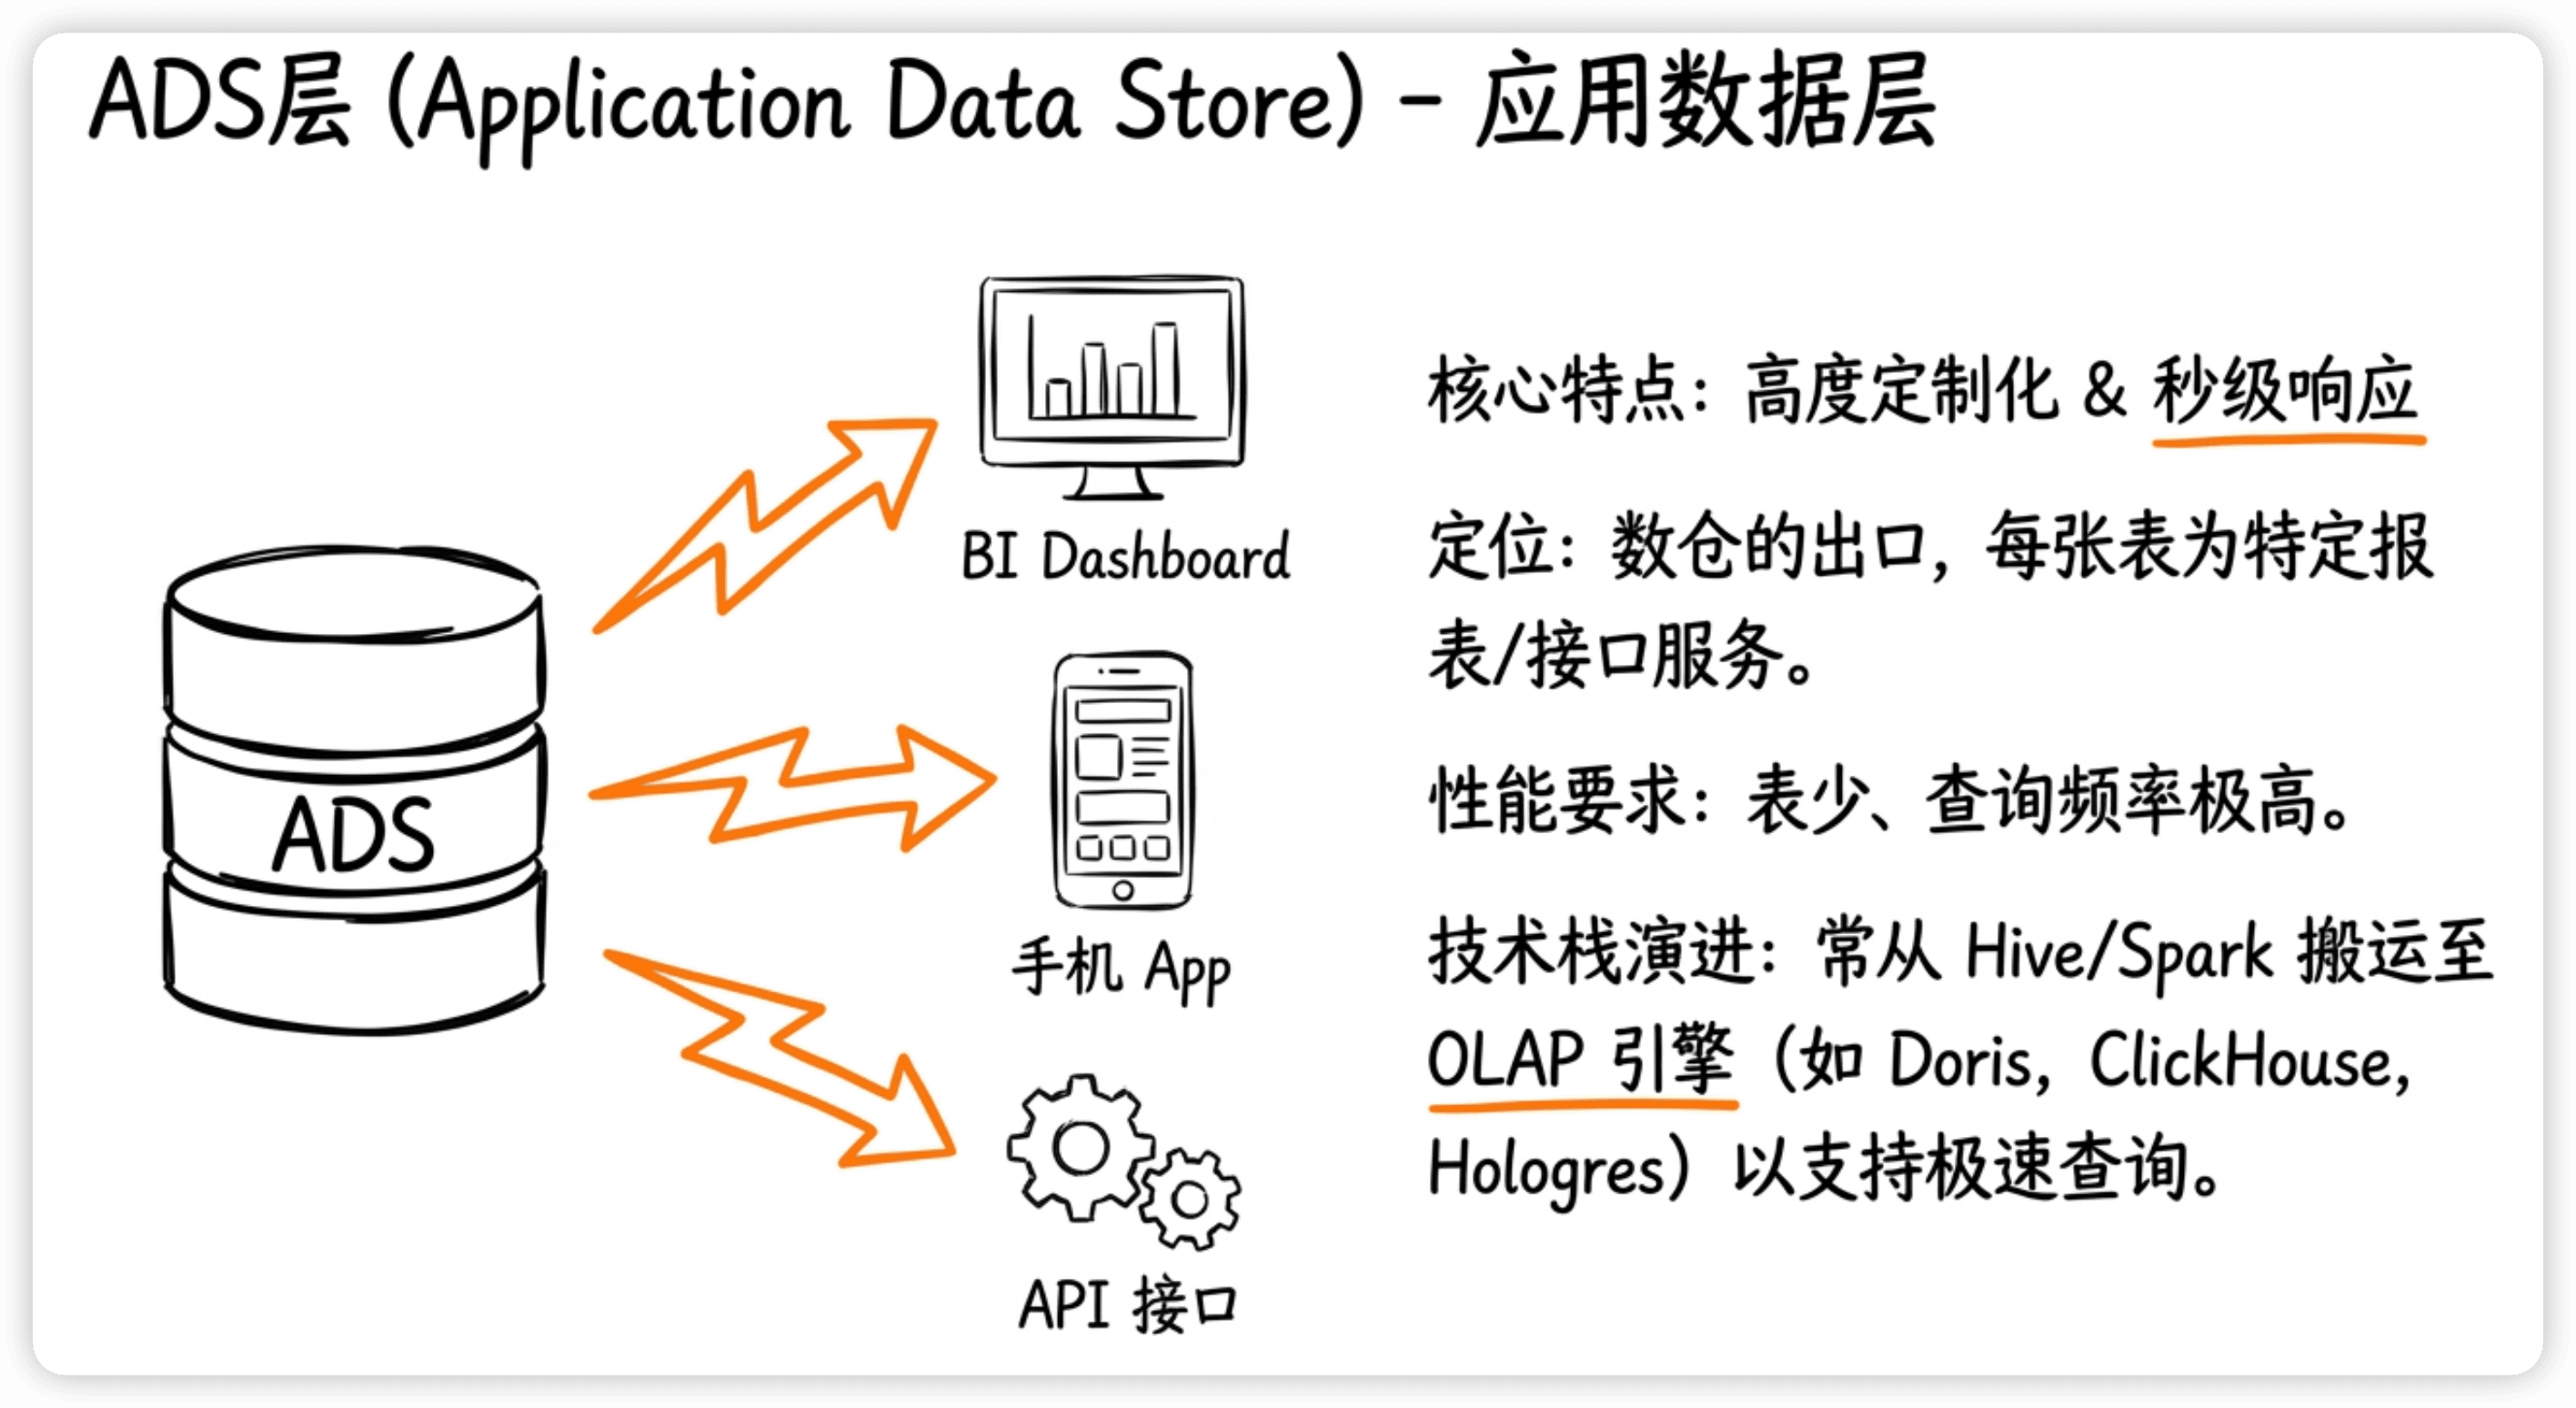
这层是数仓的"出口",直接对接报表平台、BI大屏、数据API、推荐系统等。
ADS层的特点是高度定制化,每张表通常只为一个特定的报表或接口服务。
-- 典型ADS表:每日经营日报
CREATE TABLE ads_daily_business_report AS
SELECT
    dt,
    COUNT(DISTINCT user_id)                          AS dau,
    COUNT(DISTINCT new_user_id)                      AS new_users,
    SUM(revenue)                                     AS total_revenue,
    SUM(ad_cost)                                     AS total_cost,
    ROUND(SUM(revenue) / SUM(ad_cost), 2)            AS roi,
    ROUND(SUM(revenue) / COUNT(DISTINCT user_id), 2) AS arpu
FROM dws_user_revenue_1d
WHERE dt = '${bizdate}'
GROUP BY dt;
ADS层通常表不多但使用频率最高,查询性能要求也最高。很多公司会把ADS层的数据从Hive/Spark搬到OLAP引擎(Doris、ClickHouse、Hologres)里,支持秒级查询响应。
面试怎么答才能拿高分?
低分回答(60分)
「数仓分四层,ODS原始层、DWD明细层、DWS汇总层、ADS应用层。」
面试官内心OS:这你是背的吧,谁都知道。
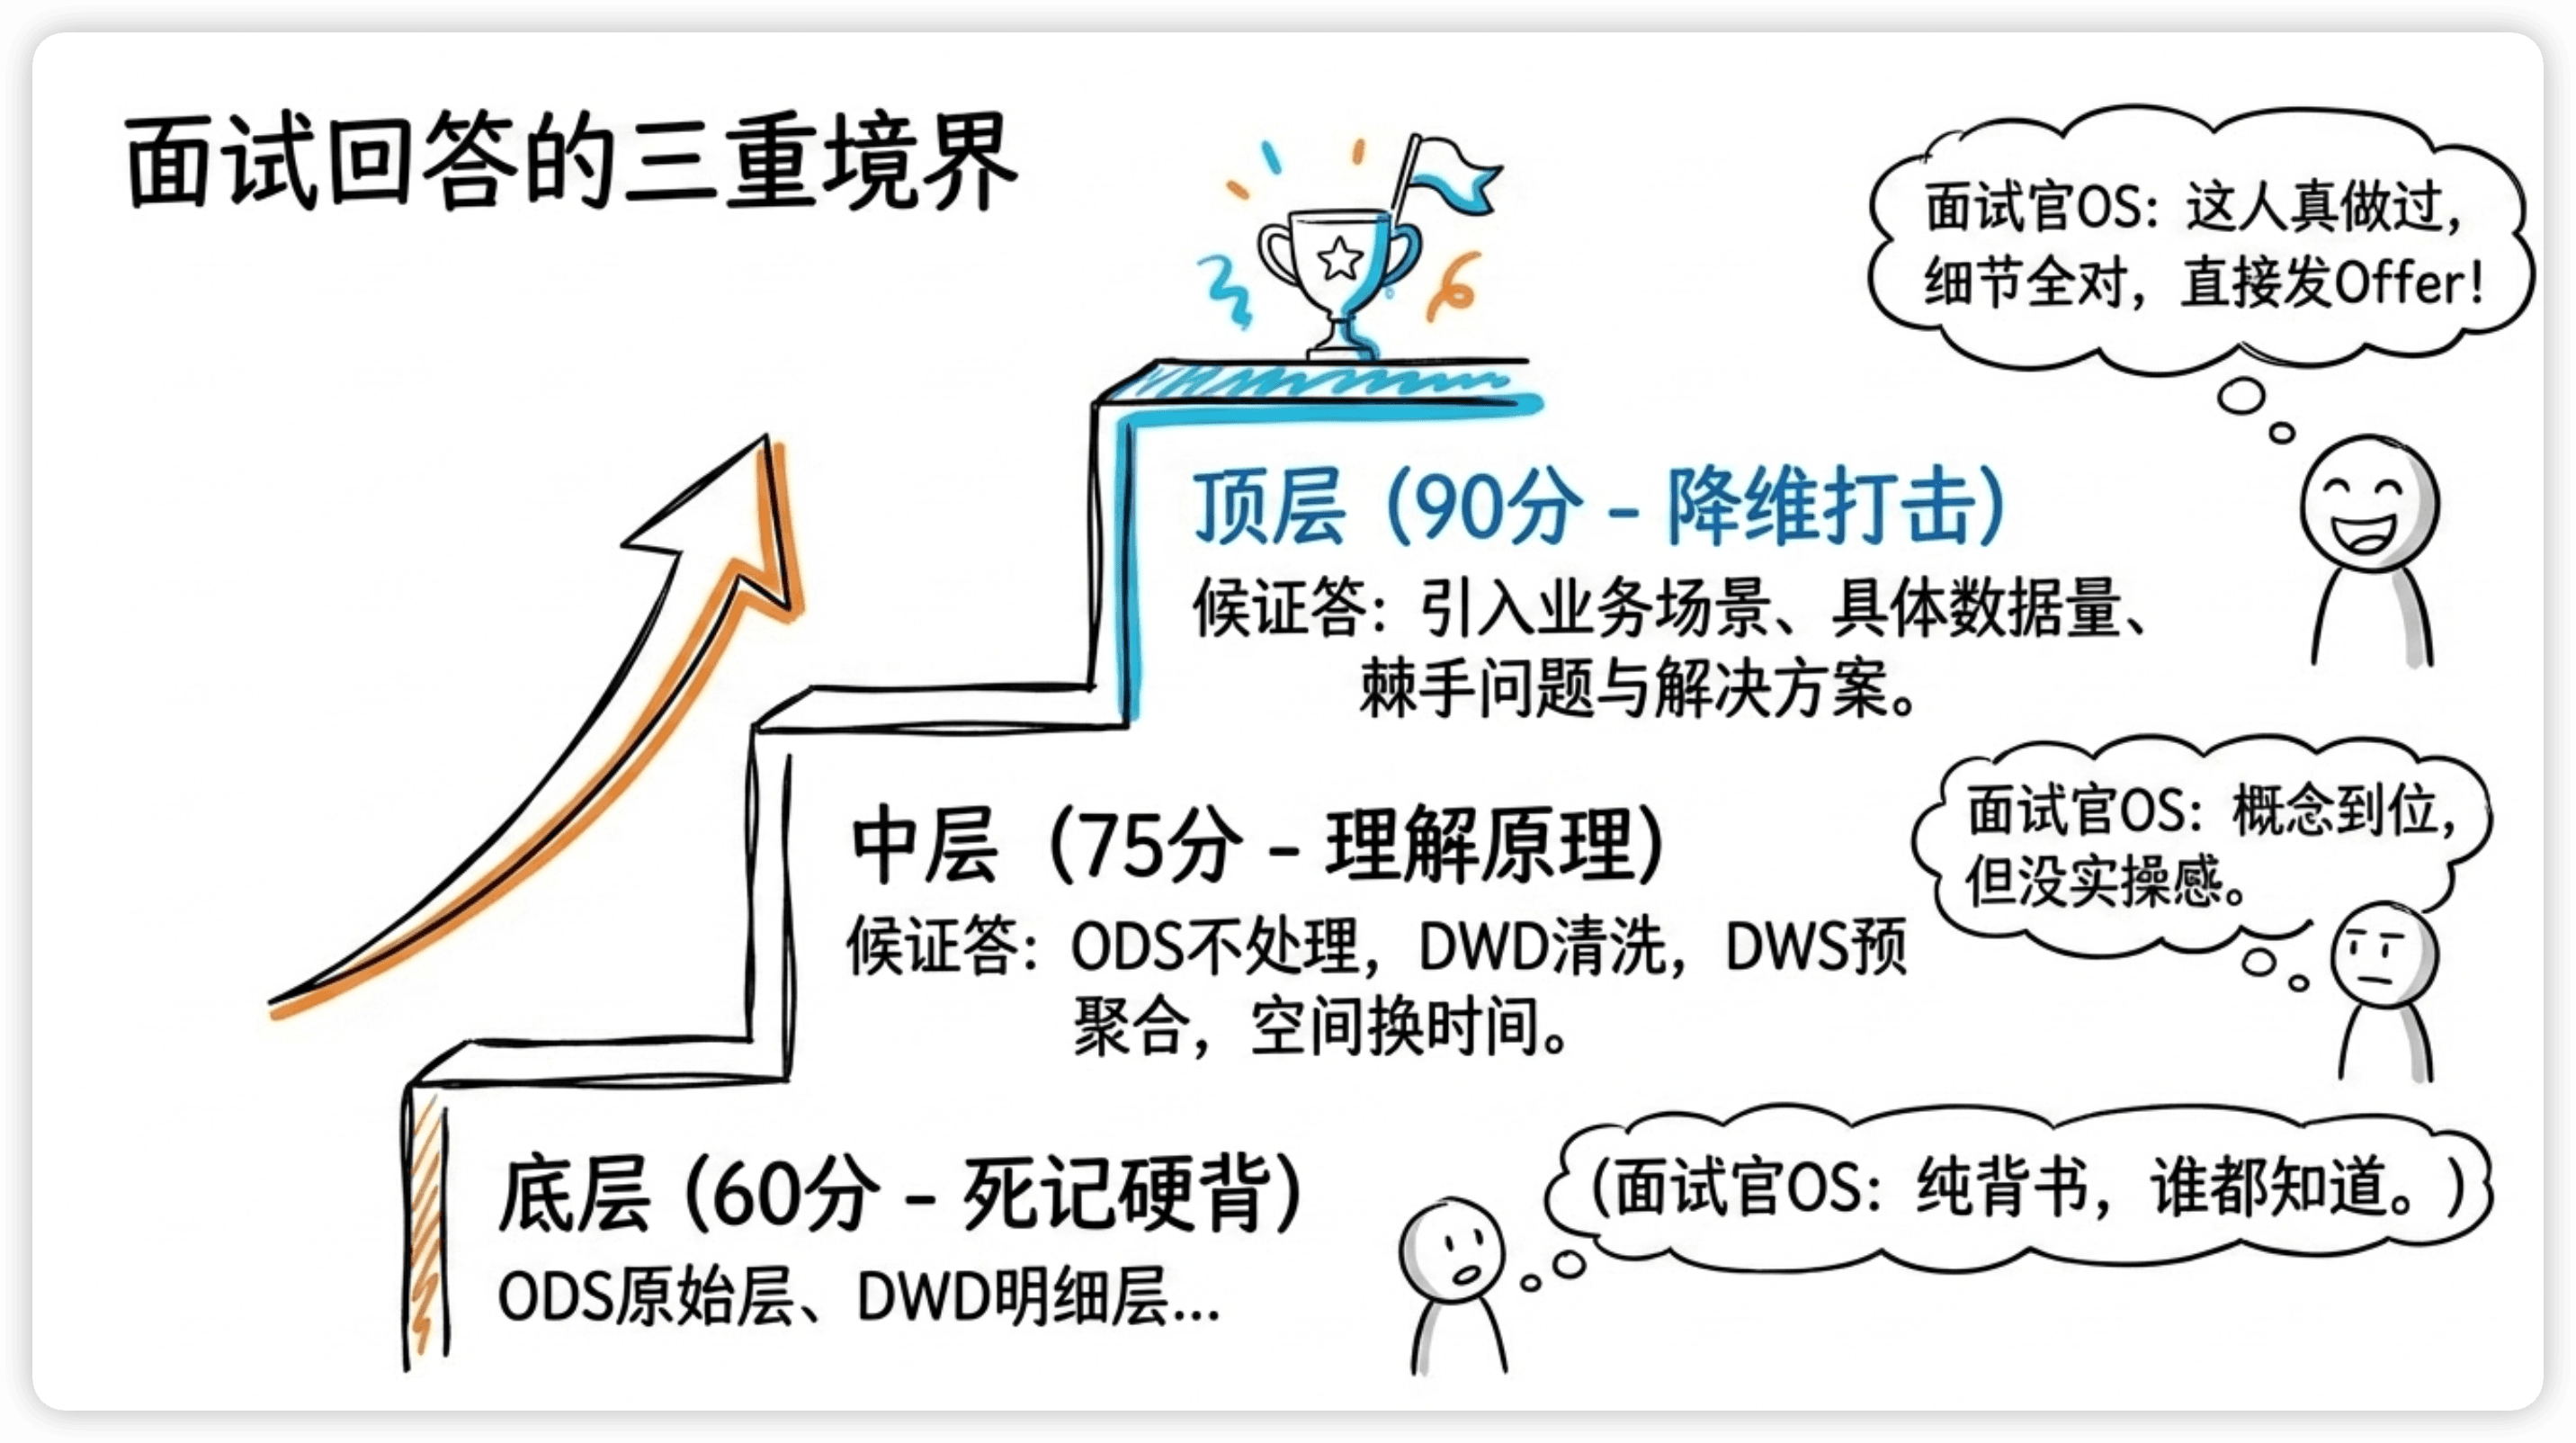
中等回答(75分)
「ODS保留原始数据不做处理,DWD做清洗标准化和维度关联,DWS按主题预聚合,ADS直接给报表用。分层的目的是以空间换时间,让数据处理可复用。」
面试官内心OS:概念理解到位了,但不知道你有没有实际做过。
高分回答(90分)
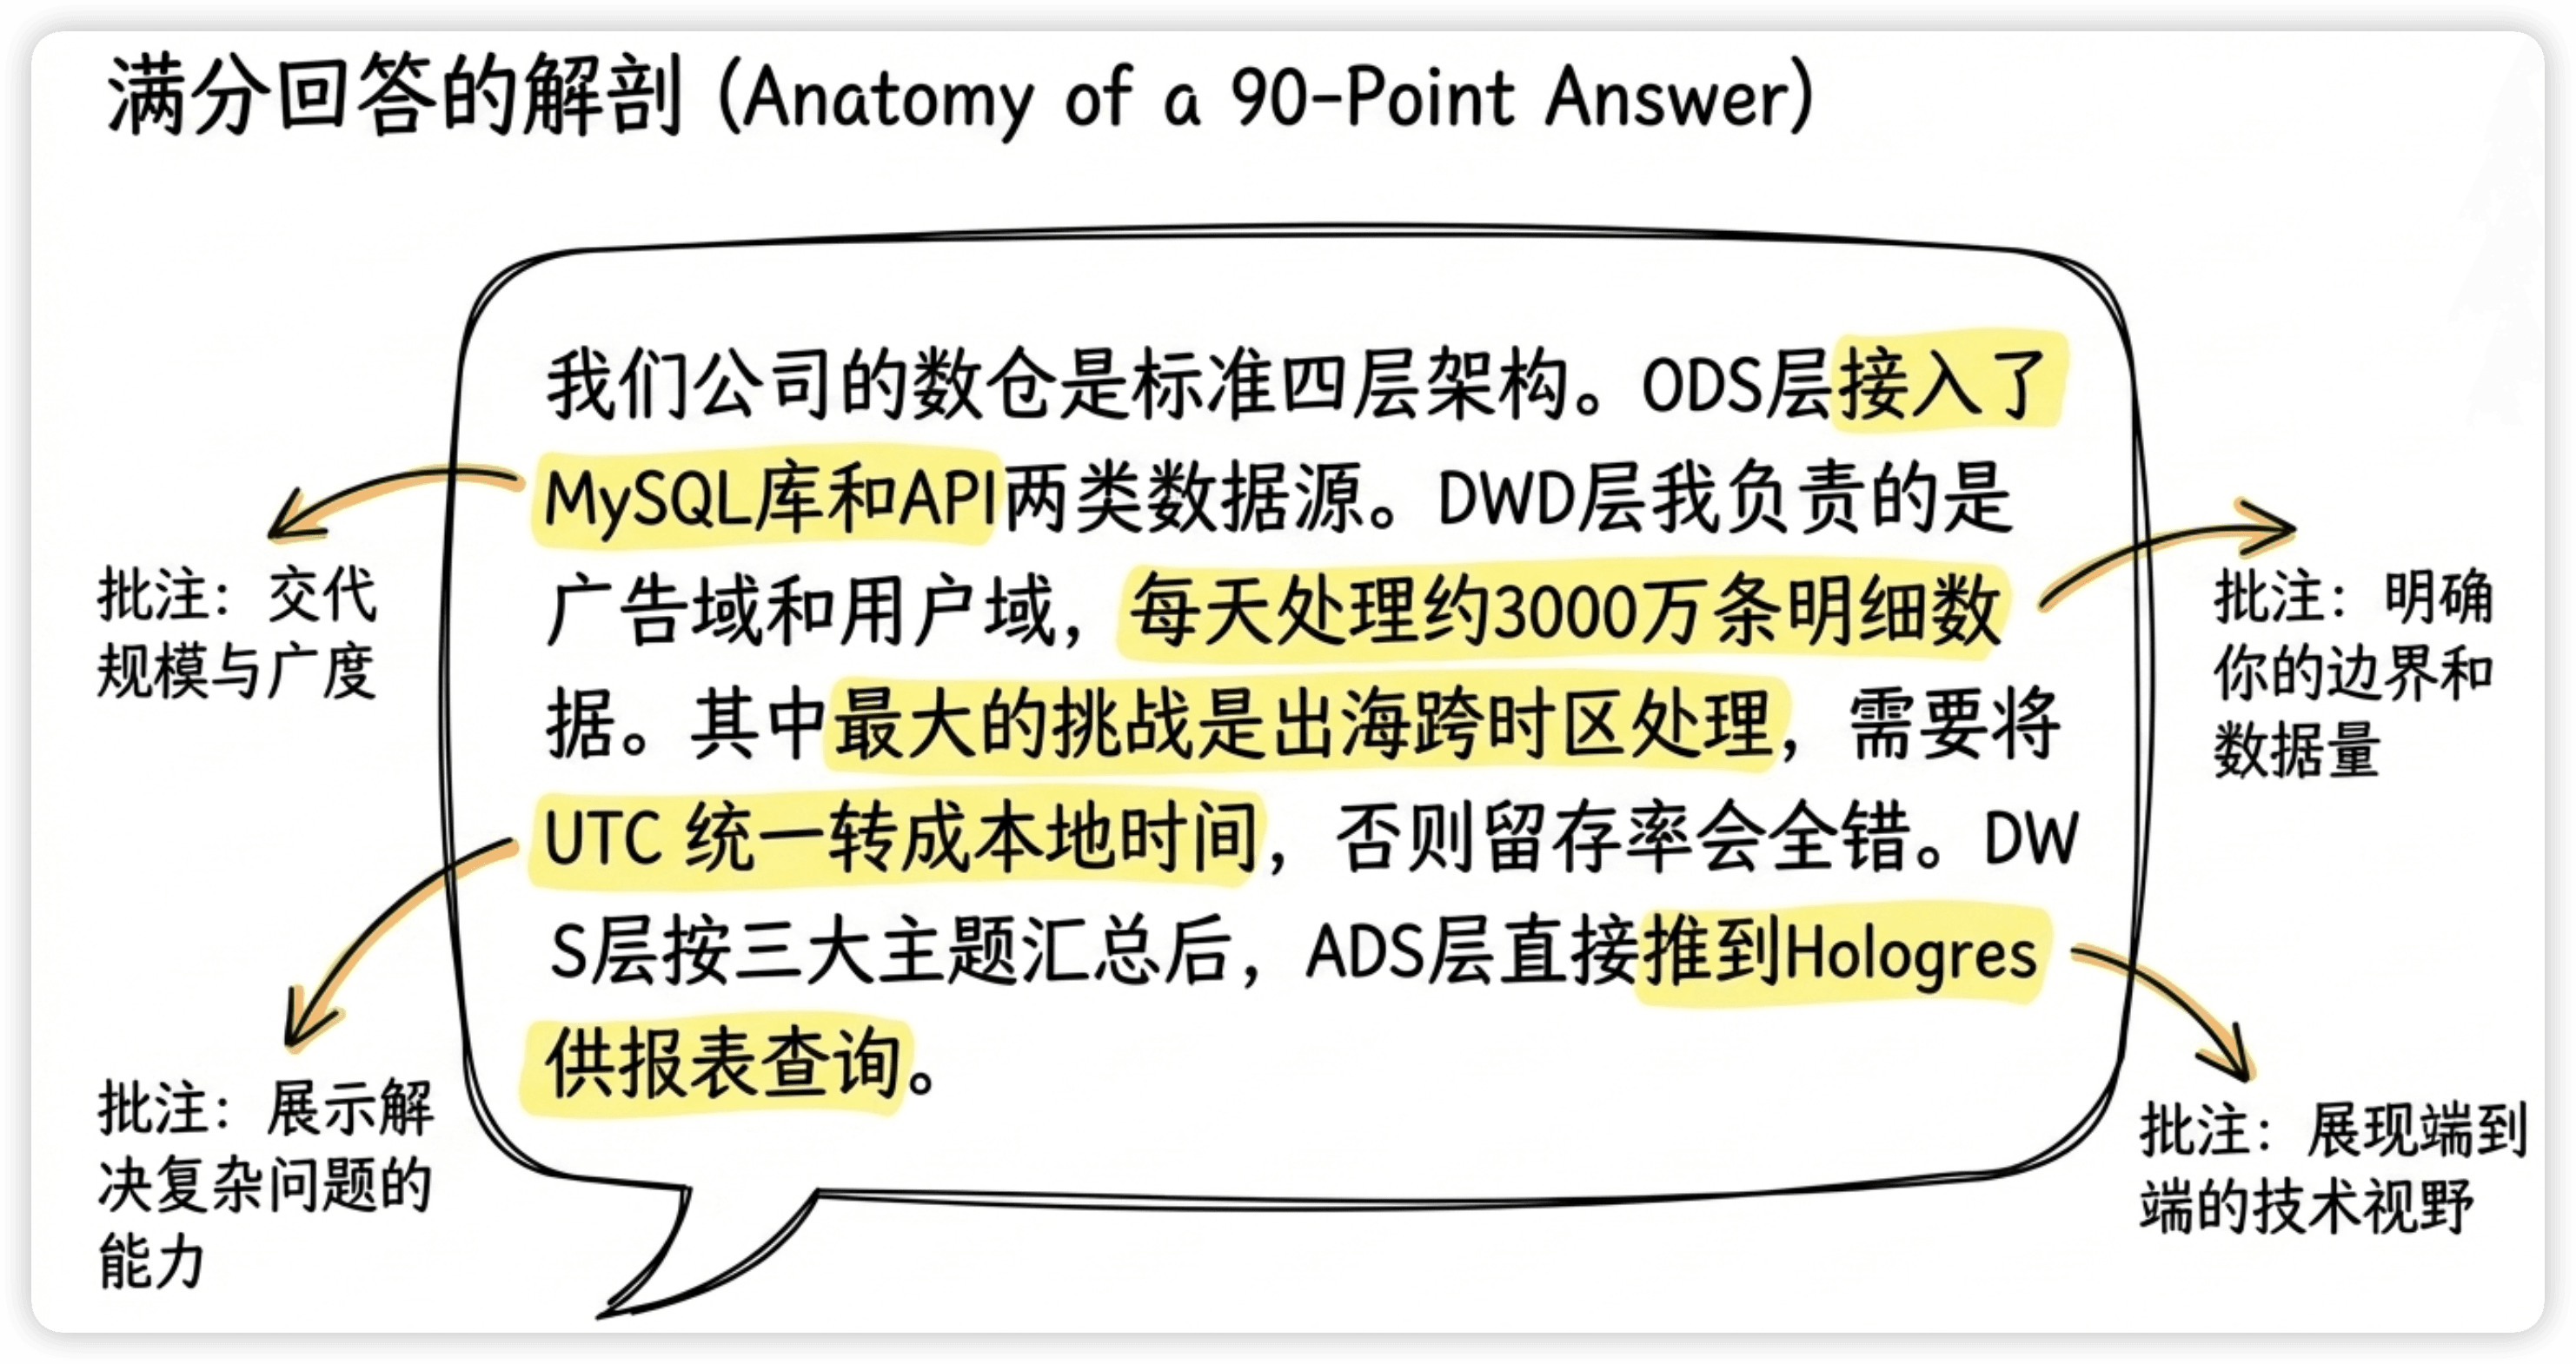
「我们公司的数仓是标准四层架构。ODS层接入了MySQL业务库、埋点日志和Facebook/TikTok广告API三类数据源,大概20多张表。DWD层我负责的是广告域和用户域,大概15张明细表,每天处理的数据量在3000万条左右。其中最大的挑战是跨时区处理——我们是出海业务,用户遍布多个时区,DWD层要把UTC时间转成用户当地时间,不然留存率、日活这些指标全是错的。DWS层按用户行为、广告投放、内容消费三个主题建设,ADS层的数据推到Hologres供报表平台查询。」
面试官内心OS:这人真做过,细节都能说清楚。
高分回答的关键: 有表数量、有数据量、有你负责的部分、有你遇到的具体问题。这些具体的细节是背不出来的,只有实际做过才能说得出来。
追问防线:面试官常见追问
面试不会只问一个问题就结束。当你回答完分层架构后,面试官大概率会追问以下问题:
追问1:DWD层和ODS层有什么区别?我能不能跳过DWD直接从ODS到DWS?
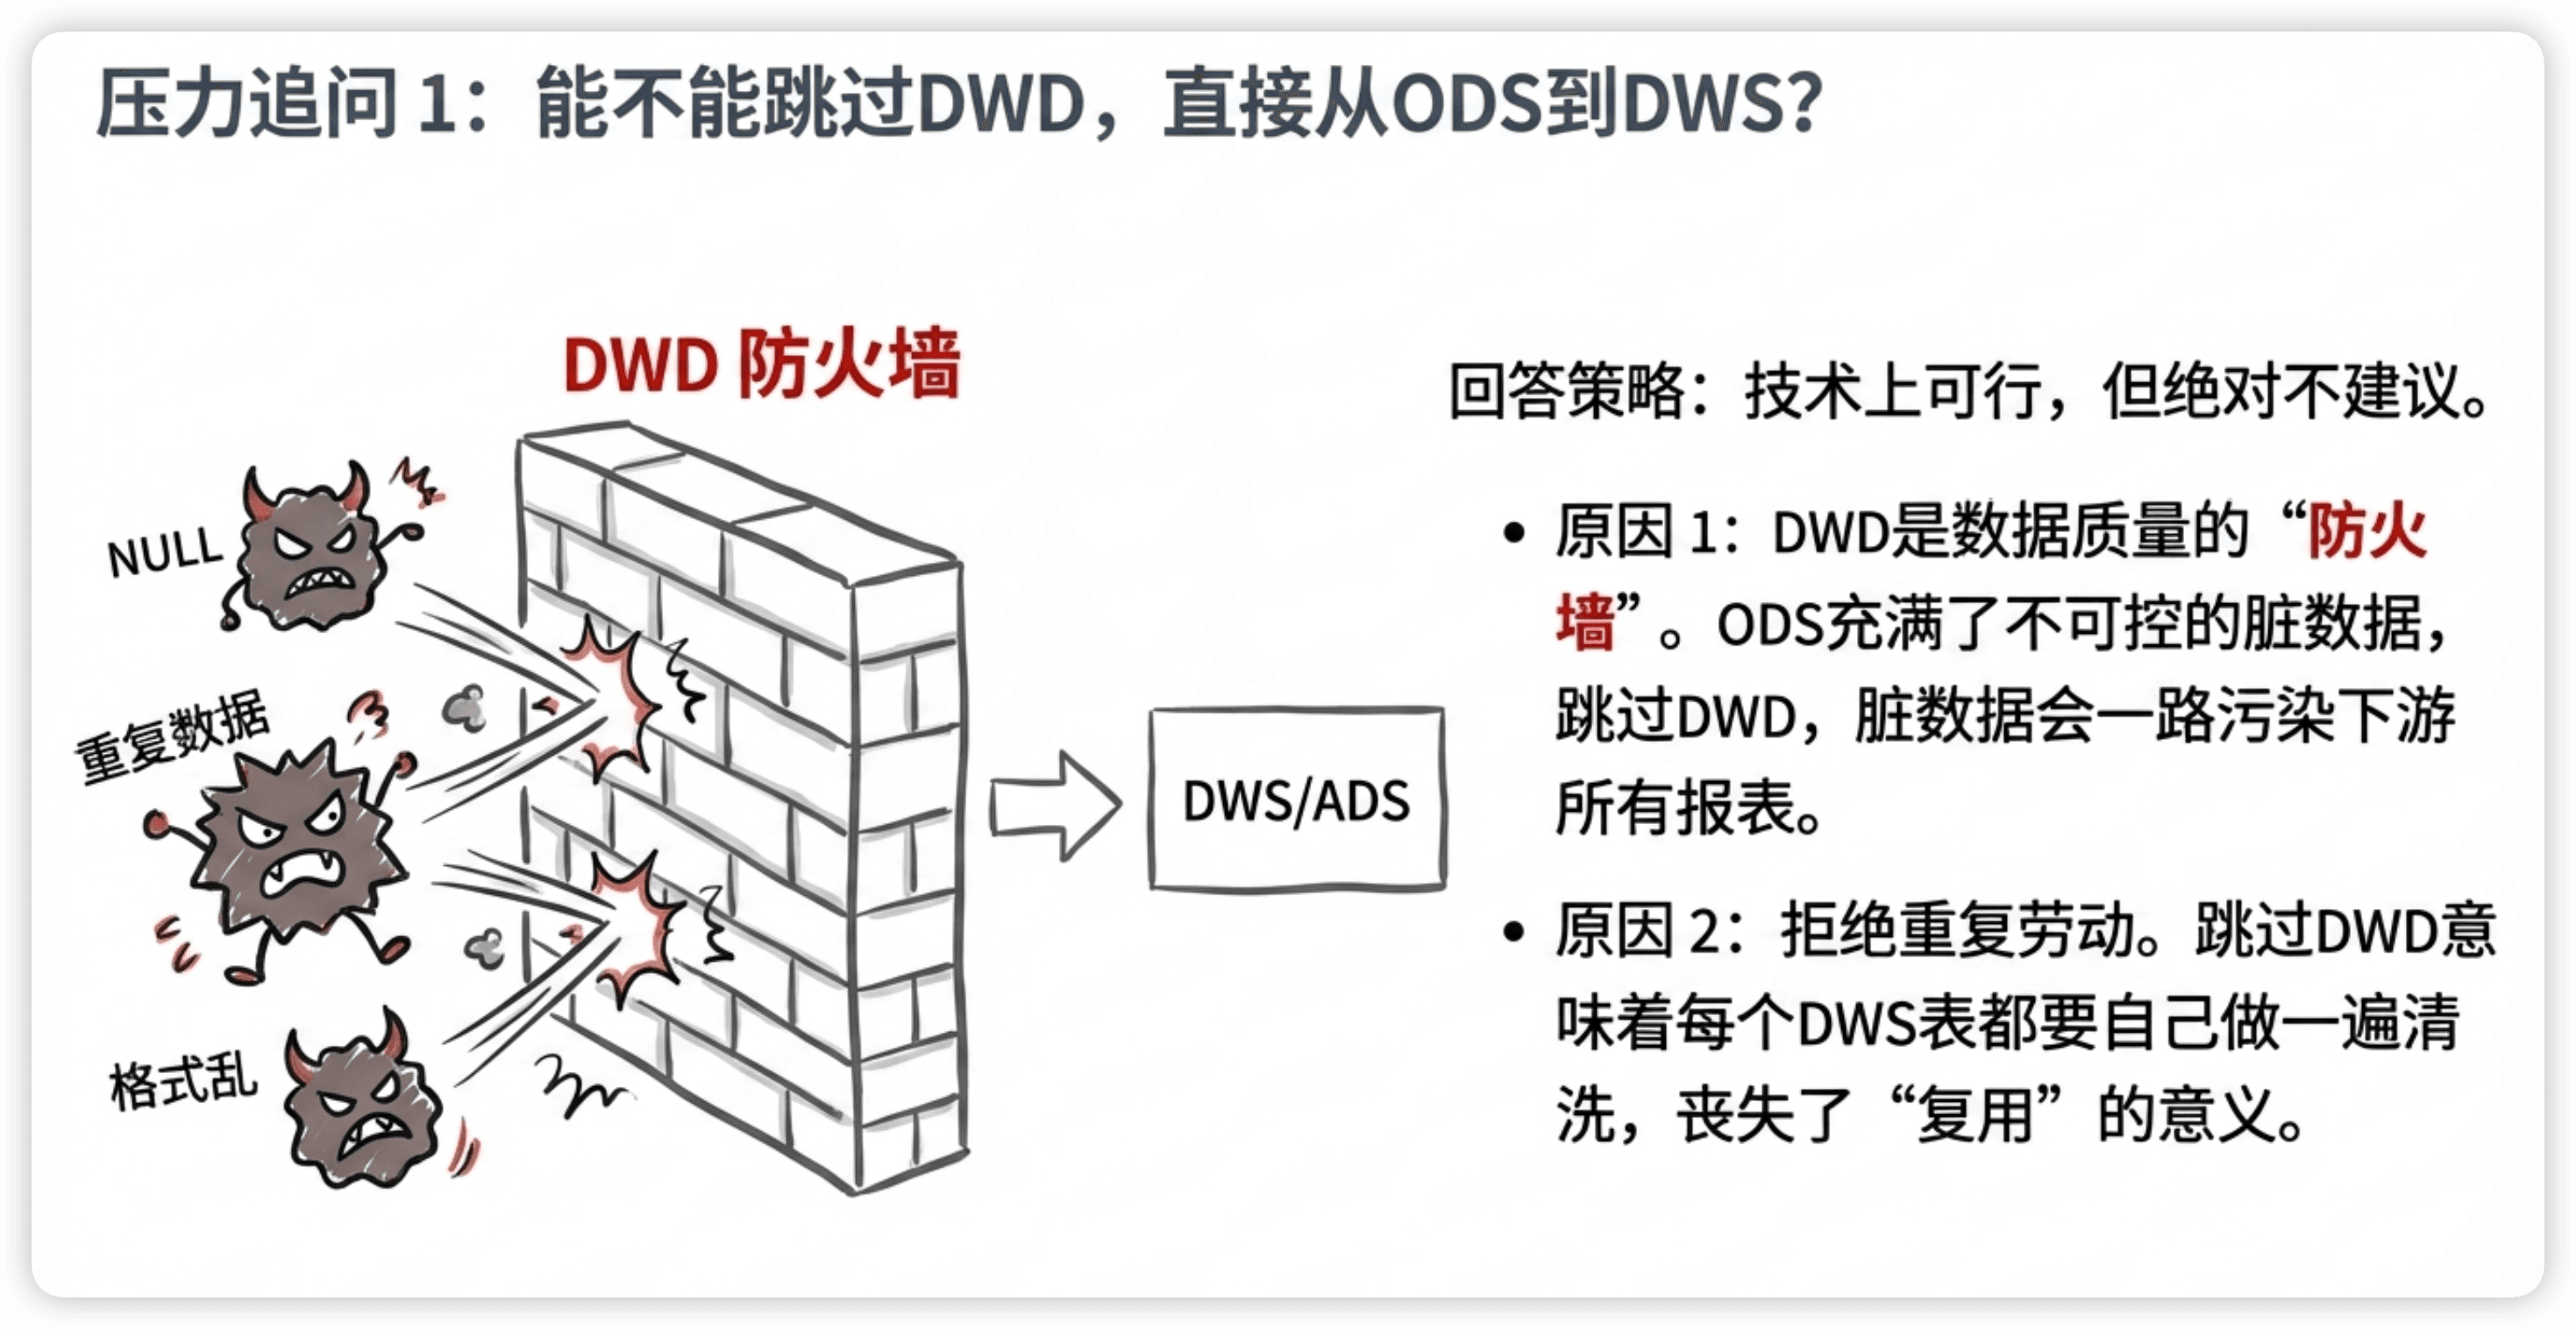
技术上当然可以跳过,但不建议。ODS层的数据质量是不可控的——NULL值、格式不统一、重复数据都有。如果跳过DWD直接聚合,这些脏数据会一路"污染"到下游所有报表。DWD层就是那道"防火墙",保证数据质量有一个统一的出口。
另外,DWD层做的维度关联和标准化,是多个DWS表共享的。跳过DWD意味着每个DWS表都要自己做一遍清洗,重复劳动巨大。
追问2:你们有没有遇到过分层不合理的情况?
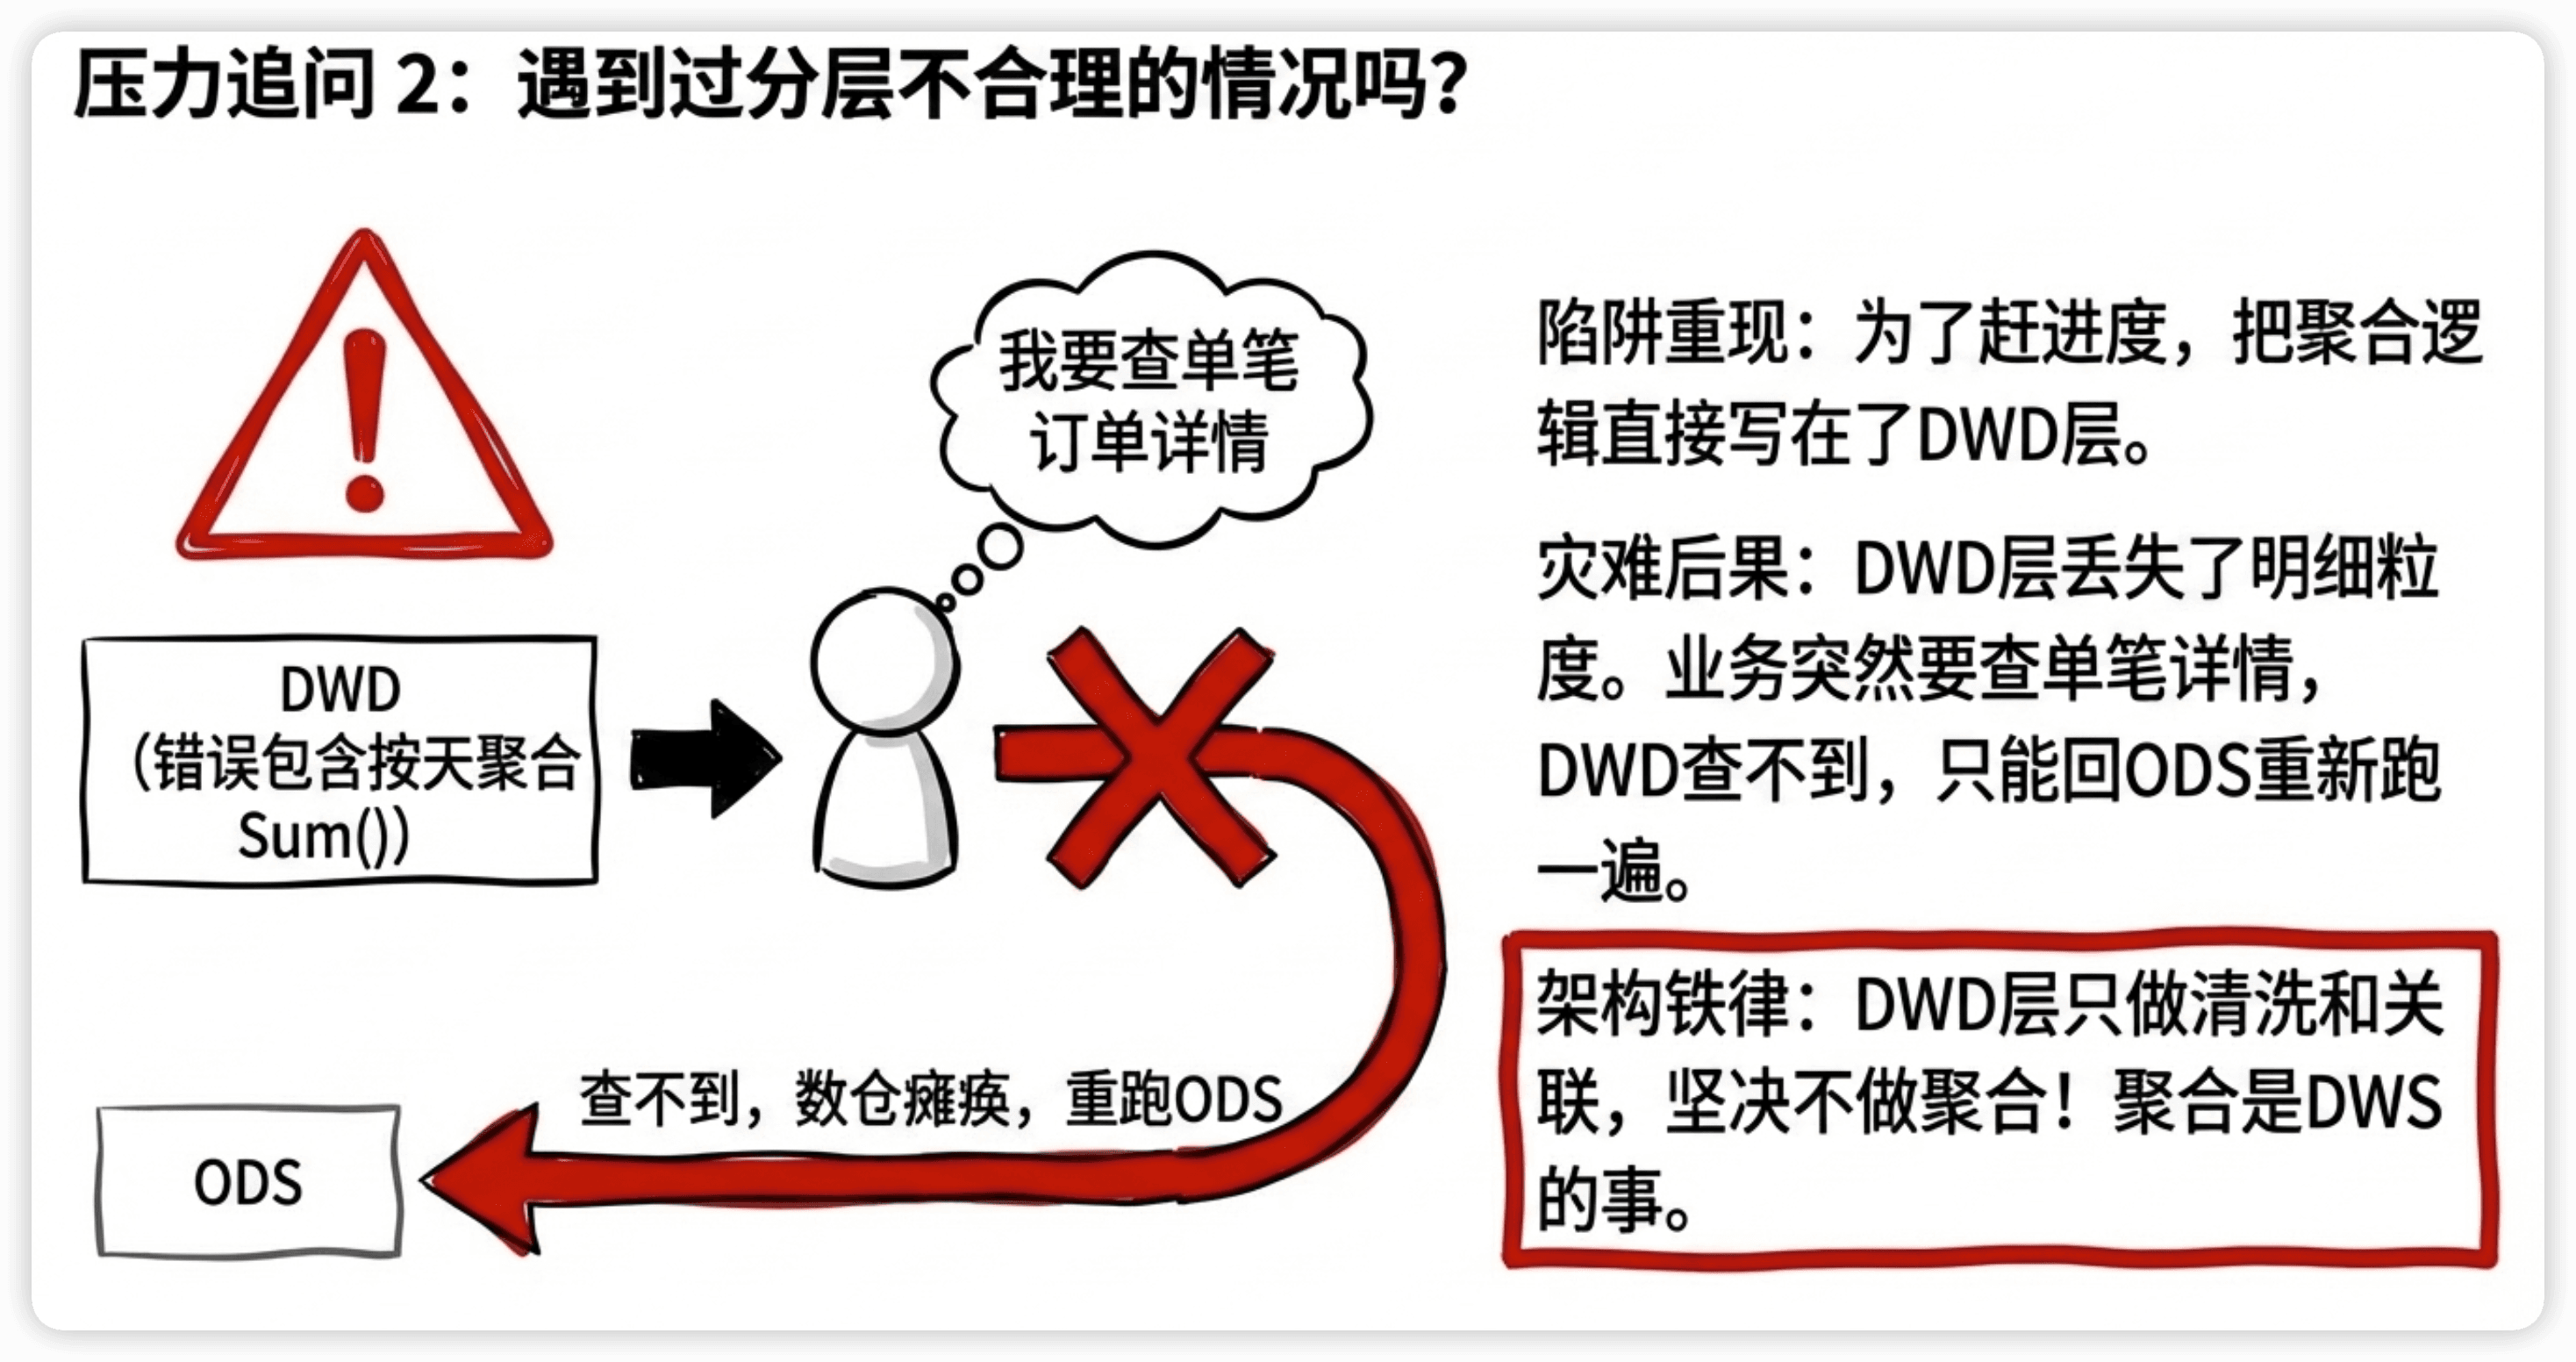
有。之前有同事为了赶进度,把一些聚合逻辑直接写在了DWD层(比如在DWD里就按天聚合了),导致DWD层丢失了明细粒度,后来业务方要查单笔订单详情的时候,DWD层查不到,只能回ODS重新处理。
从那以后我们定了一个规矩:DWD层只做清洗和关联,不做聚合。聚合是DWS的事。
追问3:分层之间的依赖关系怎么管理?
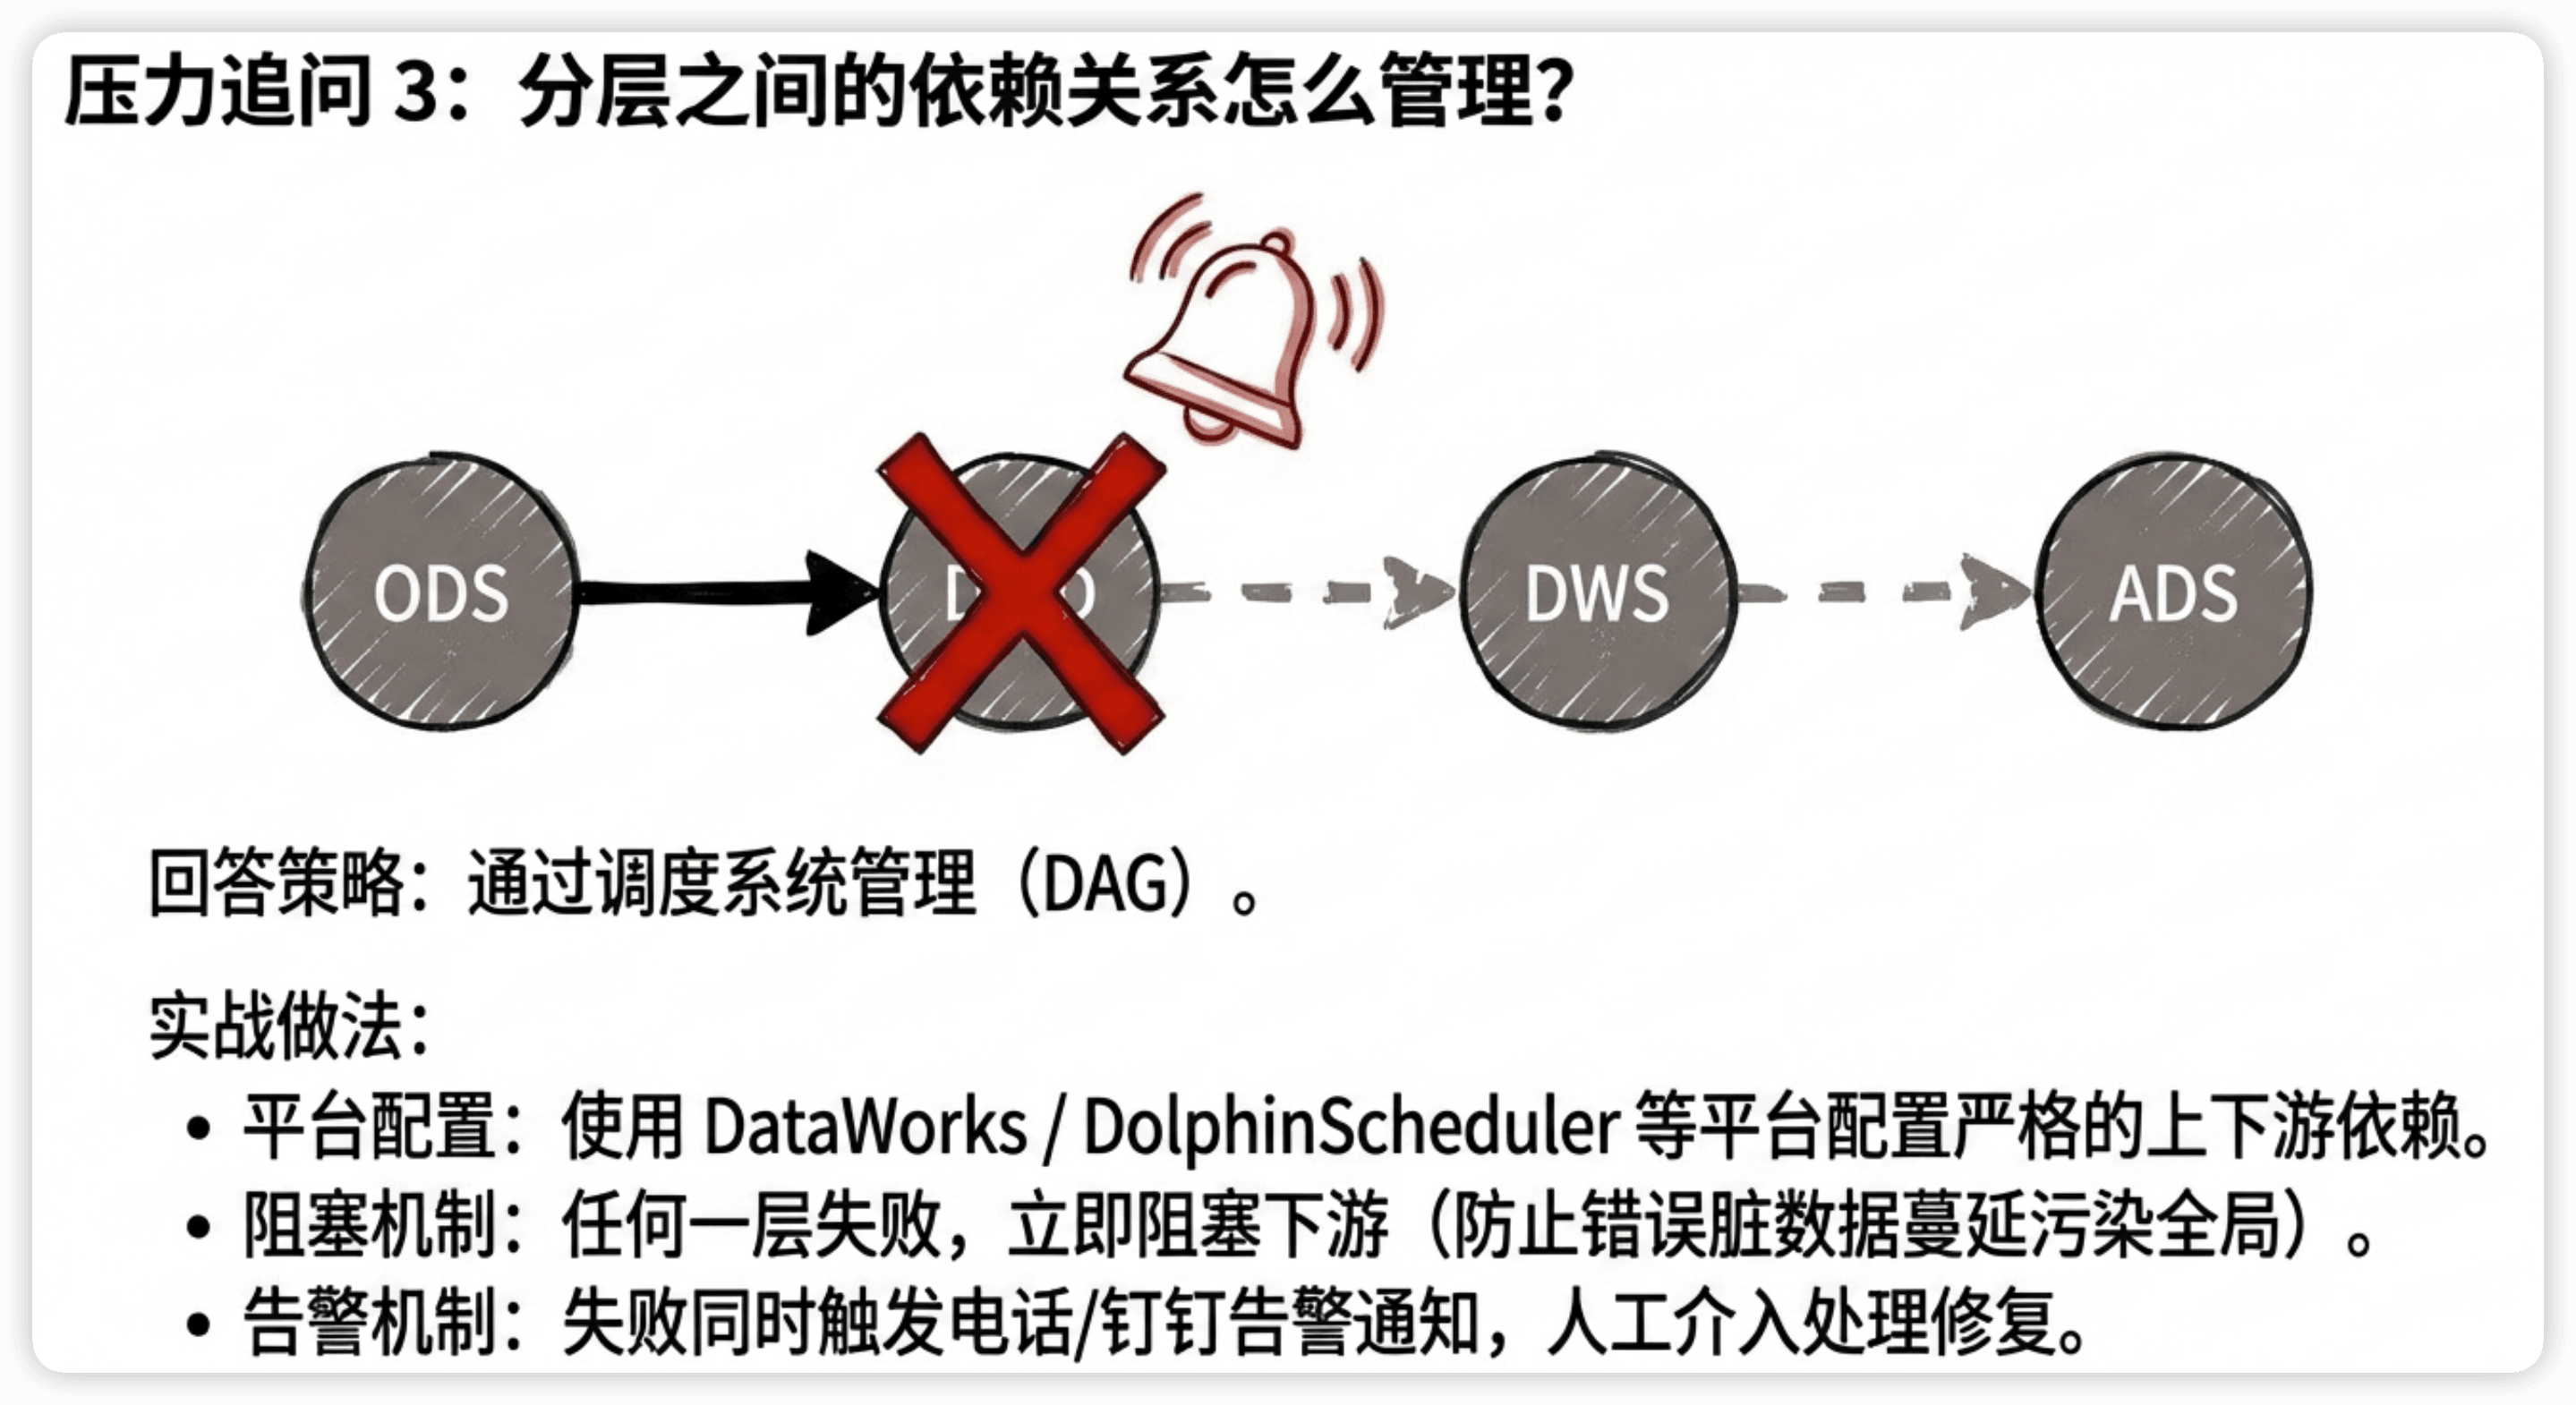
通过调度系统来管理。我们用的是DataWorks(阿里云的调度平台),DAG上配好依赖关系:ODS任务跑完才触发DWD,DWD跑完才触发DWS,DWS跑完才触发ADS。任何一层失败会阻塞下游,同时发告警通知。
总结
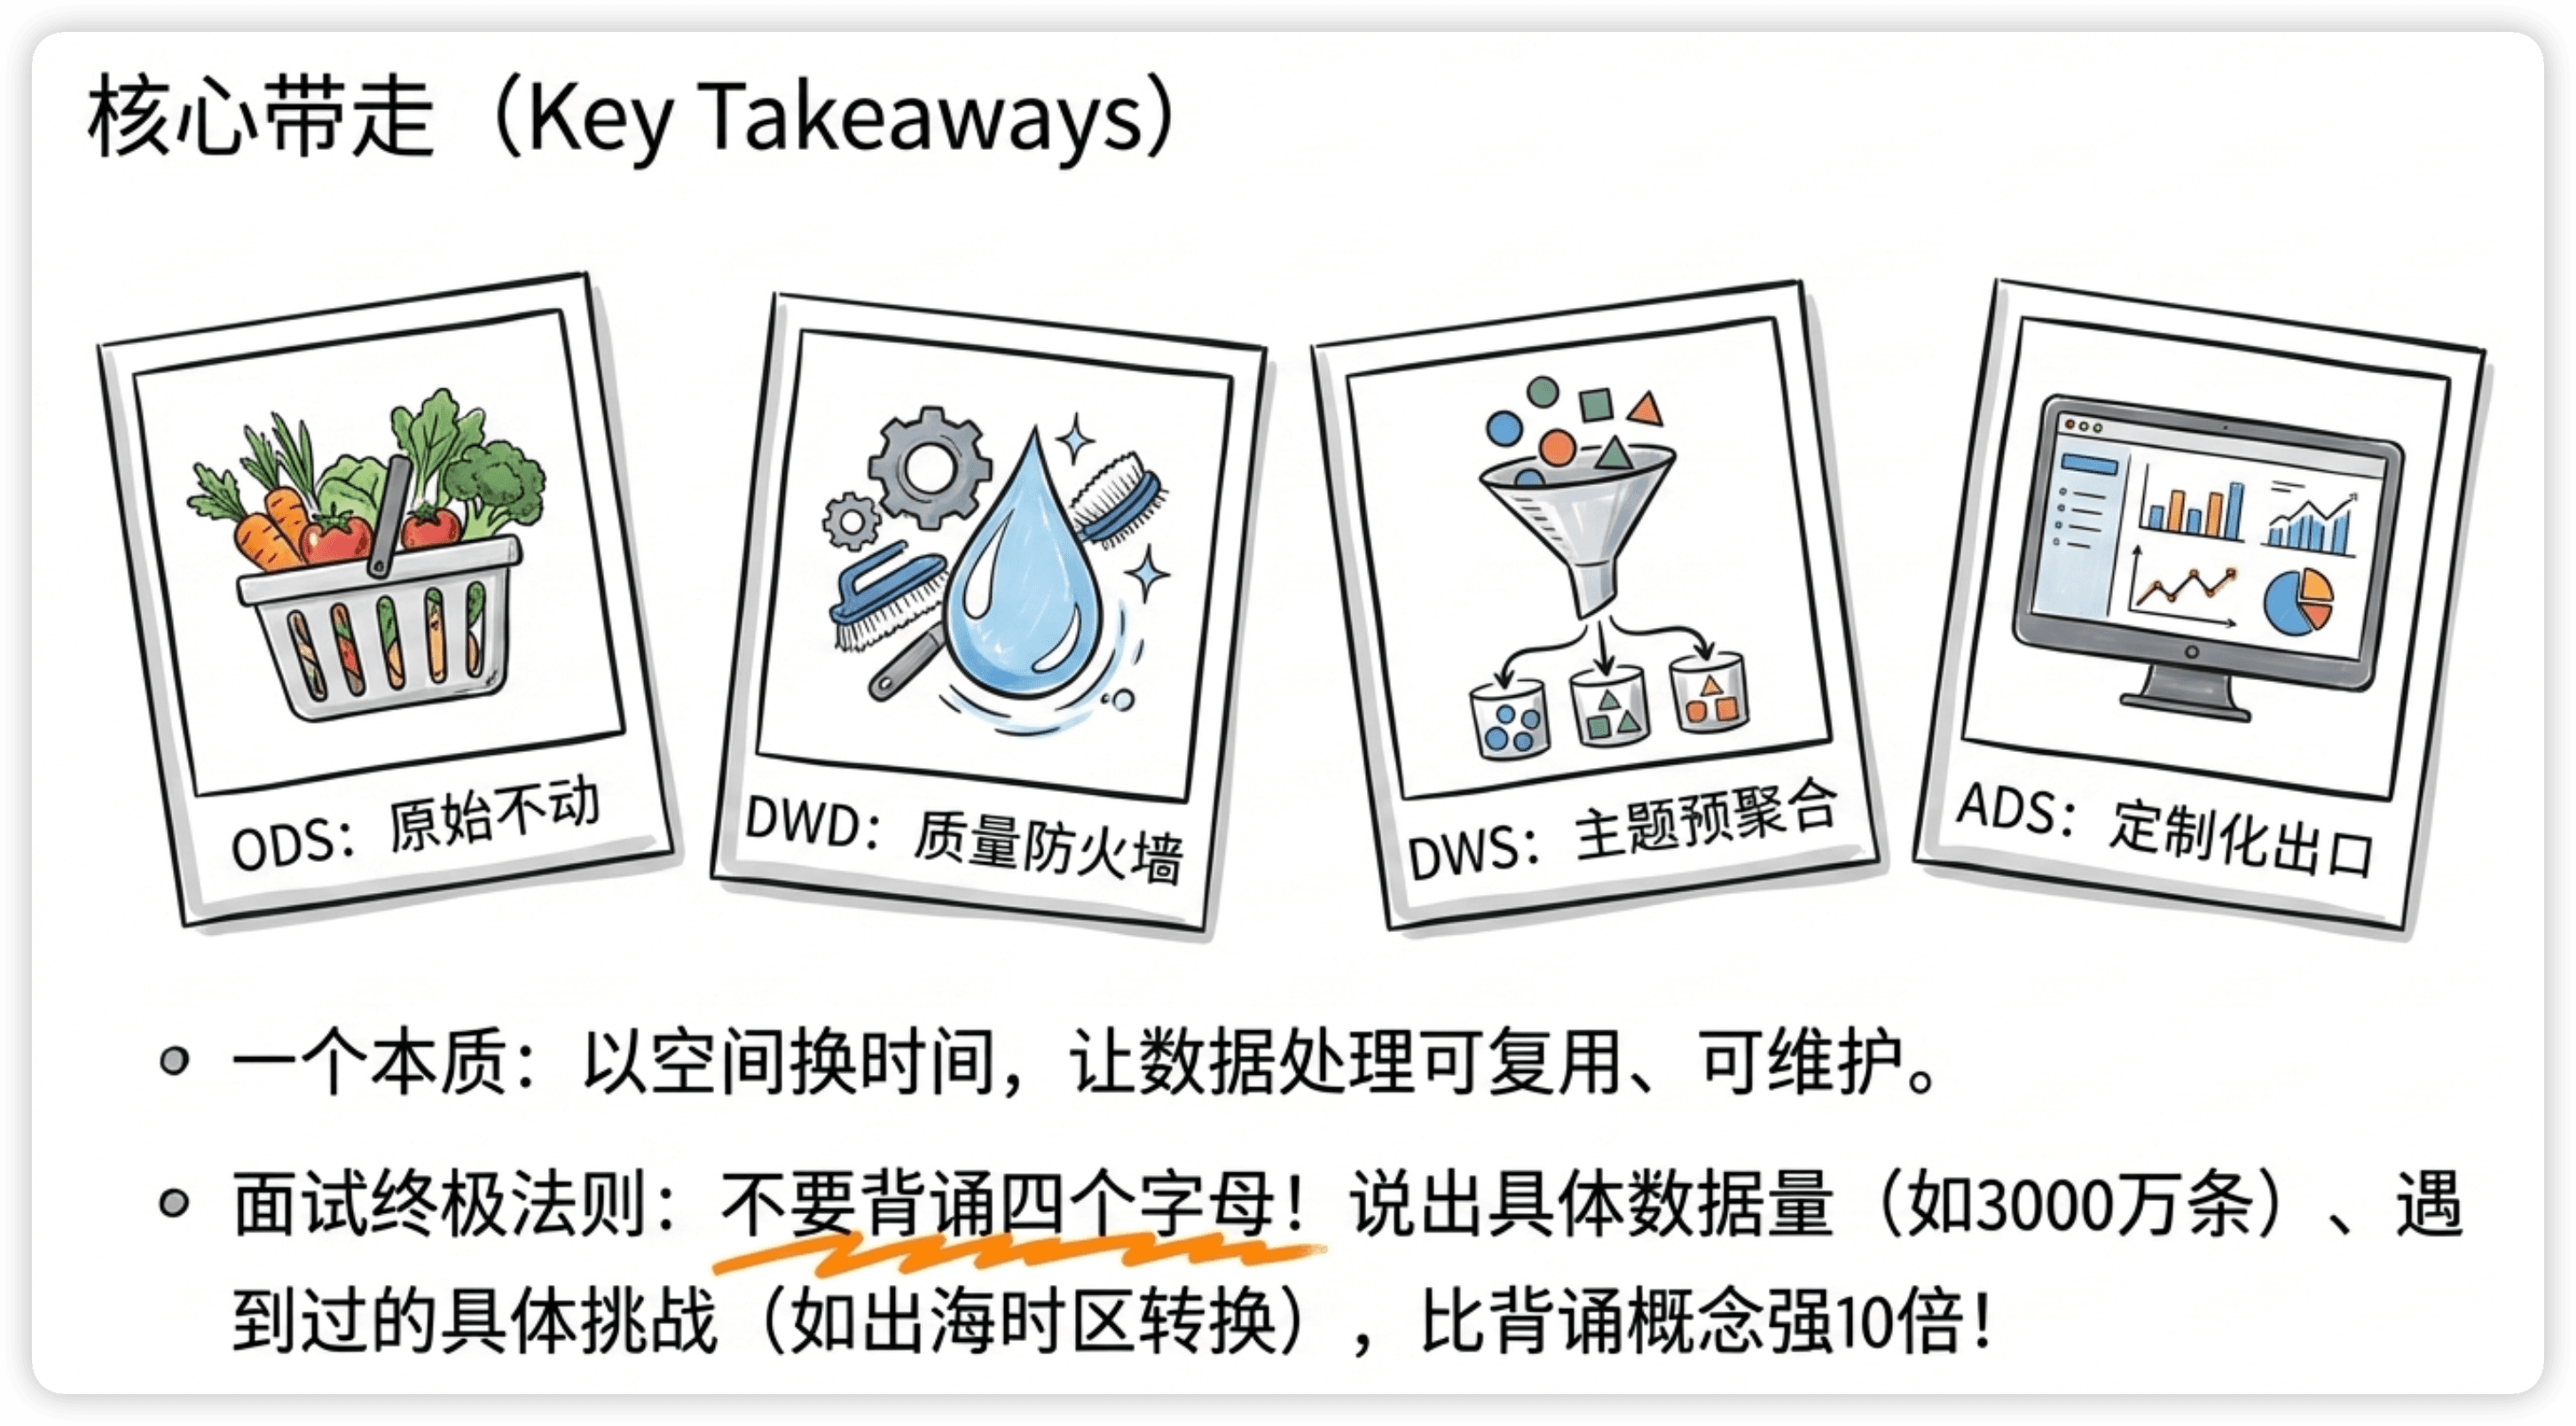
- 分层的本质是以空间换时间,让数据处理可复用、可维护
- ODS:原始数据不动,留底用于回溯
- DWD:清洗+标准化+维度关联,是数仓质量的防火墙(最核心)
- DWS:按主题预聚合,减少下游重复计算
- ADS:直接给应用层使用,高度定制化
- 面试时能说出具体数字和你负责的部分,比背概念强10倍