写入数据幂等设计
我刚入行的时候犯过一个事故级别的错误。
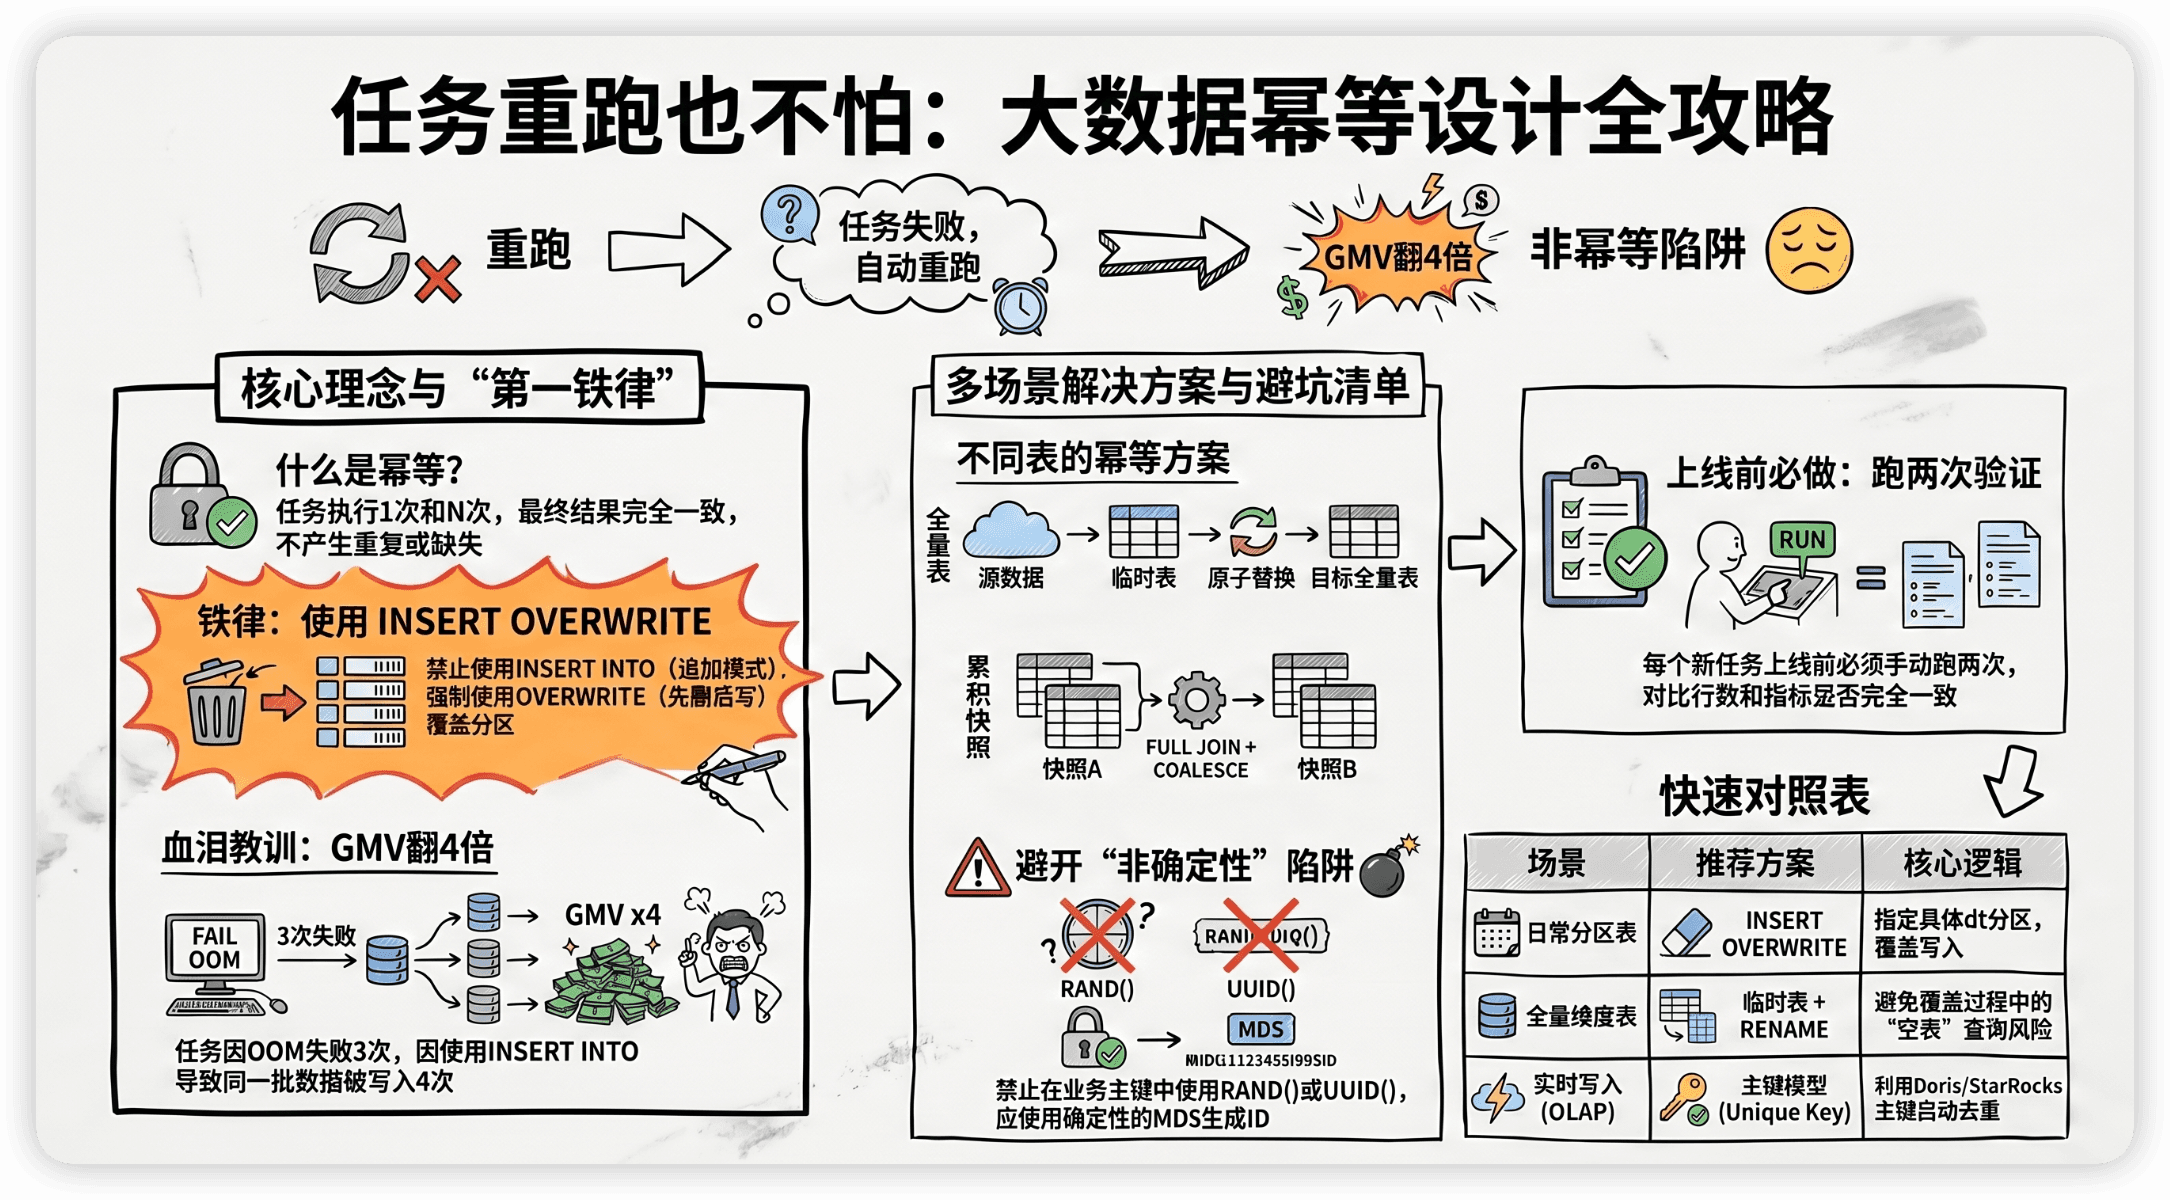
一个写入DWS表的任务,用了INSERT INTO(追加模式)。任务跑到一半OOM了,调度系统自动重试,连续失败了3次后终于成功了。我以为没事了,第二天运营来找我——"昨天GMV怎么是平时的4倍?"
排查后发现:任务失败了3次,每次失败前已经写入了部分数据。加上最后成功的那次,同一批数据写了4遍。INSERT INTO是追加模式,不会清除已有数据,4遍数据累加起来,GMV自然翻了4倍。
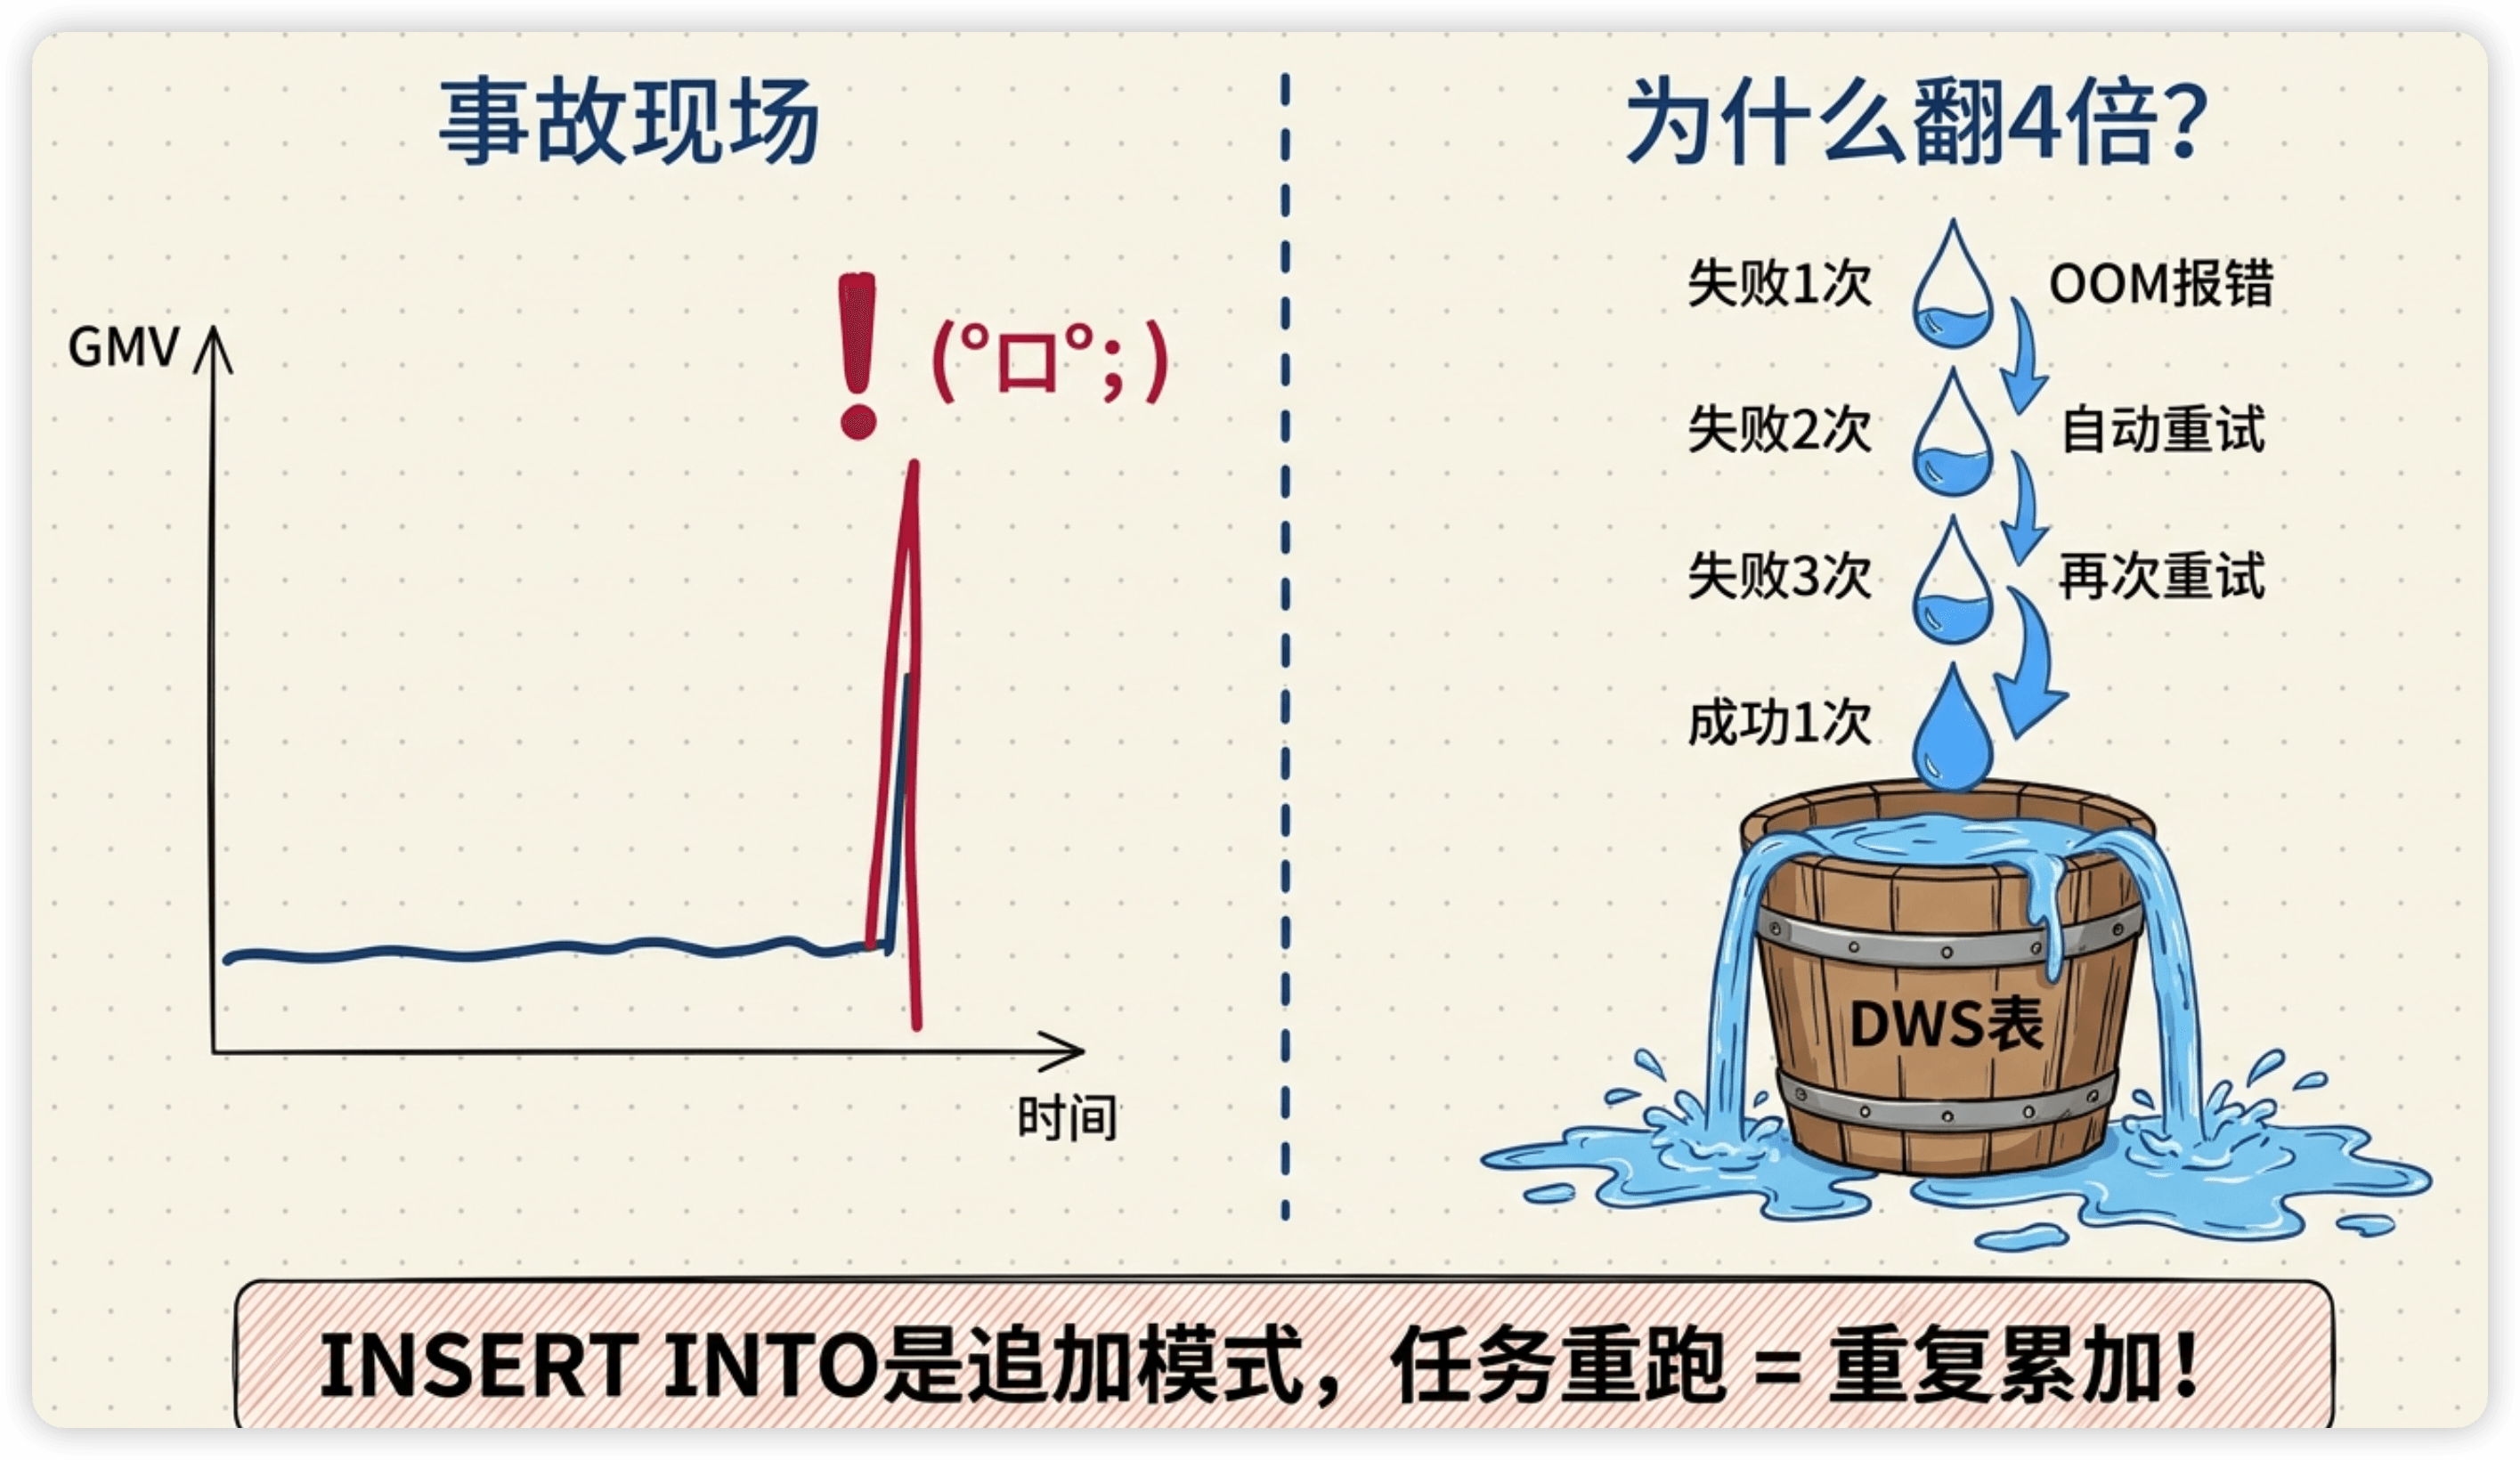
从那以后,我所有的离线任务都用INSERT OVERWRITE。这个教训让我深刻理解了一个词——幂等。
什么是幂等?
一个操作执行1次和执行N次,最终结果完全一样,就叫幂等。
对数仓来说:同一个ETL任务重跑1遍或者跑10遍,数据都是一样的,不会多也不会少。
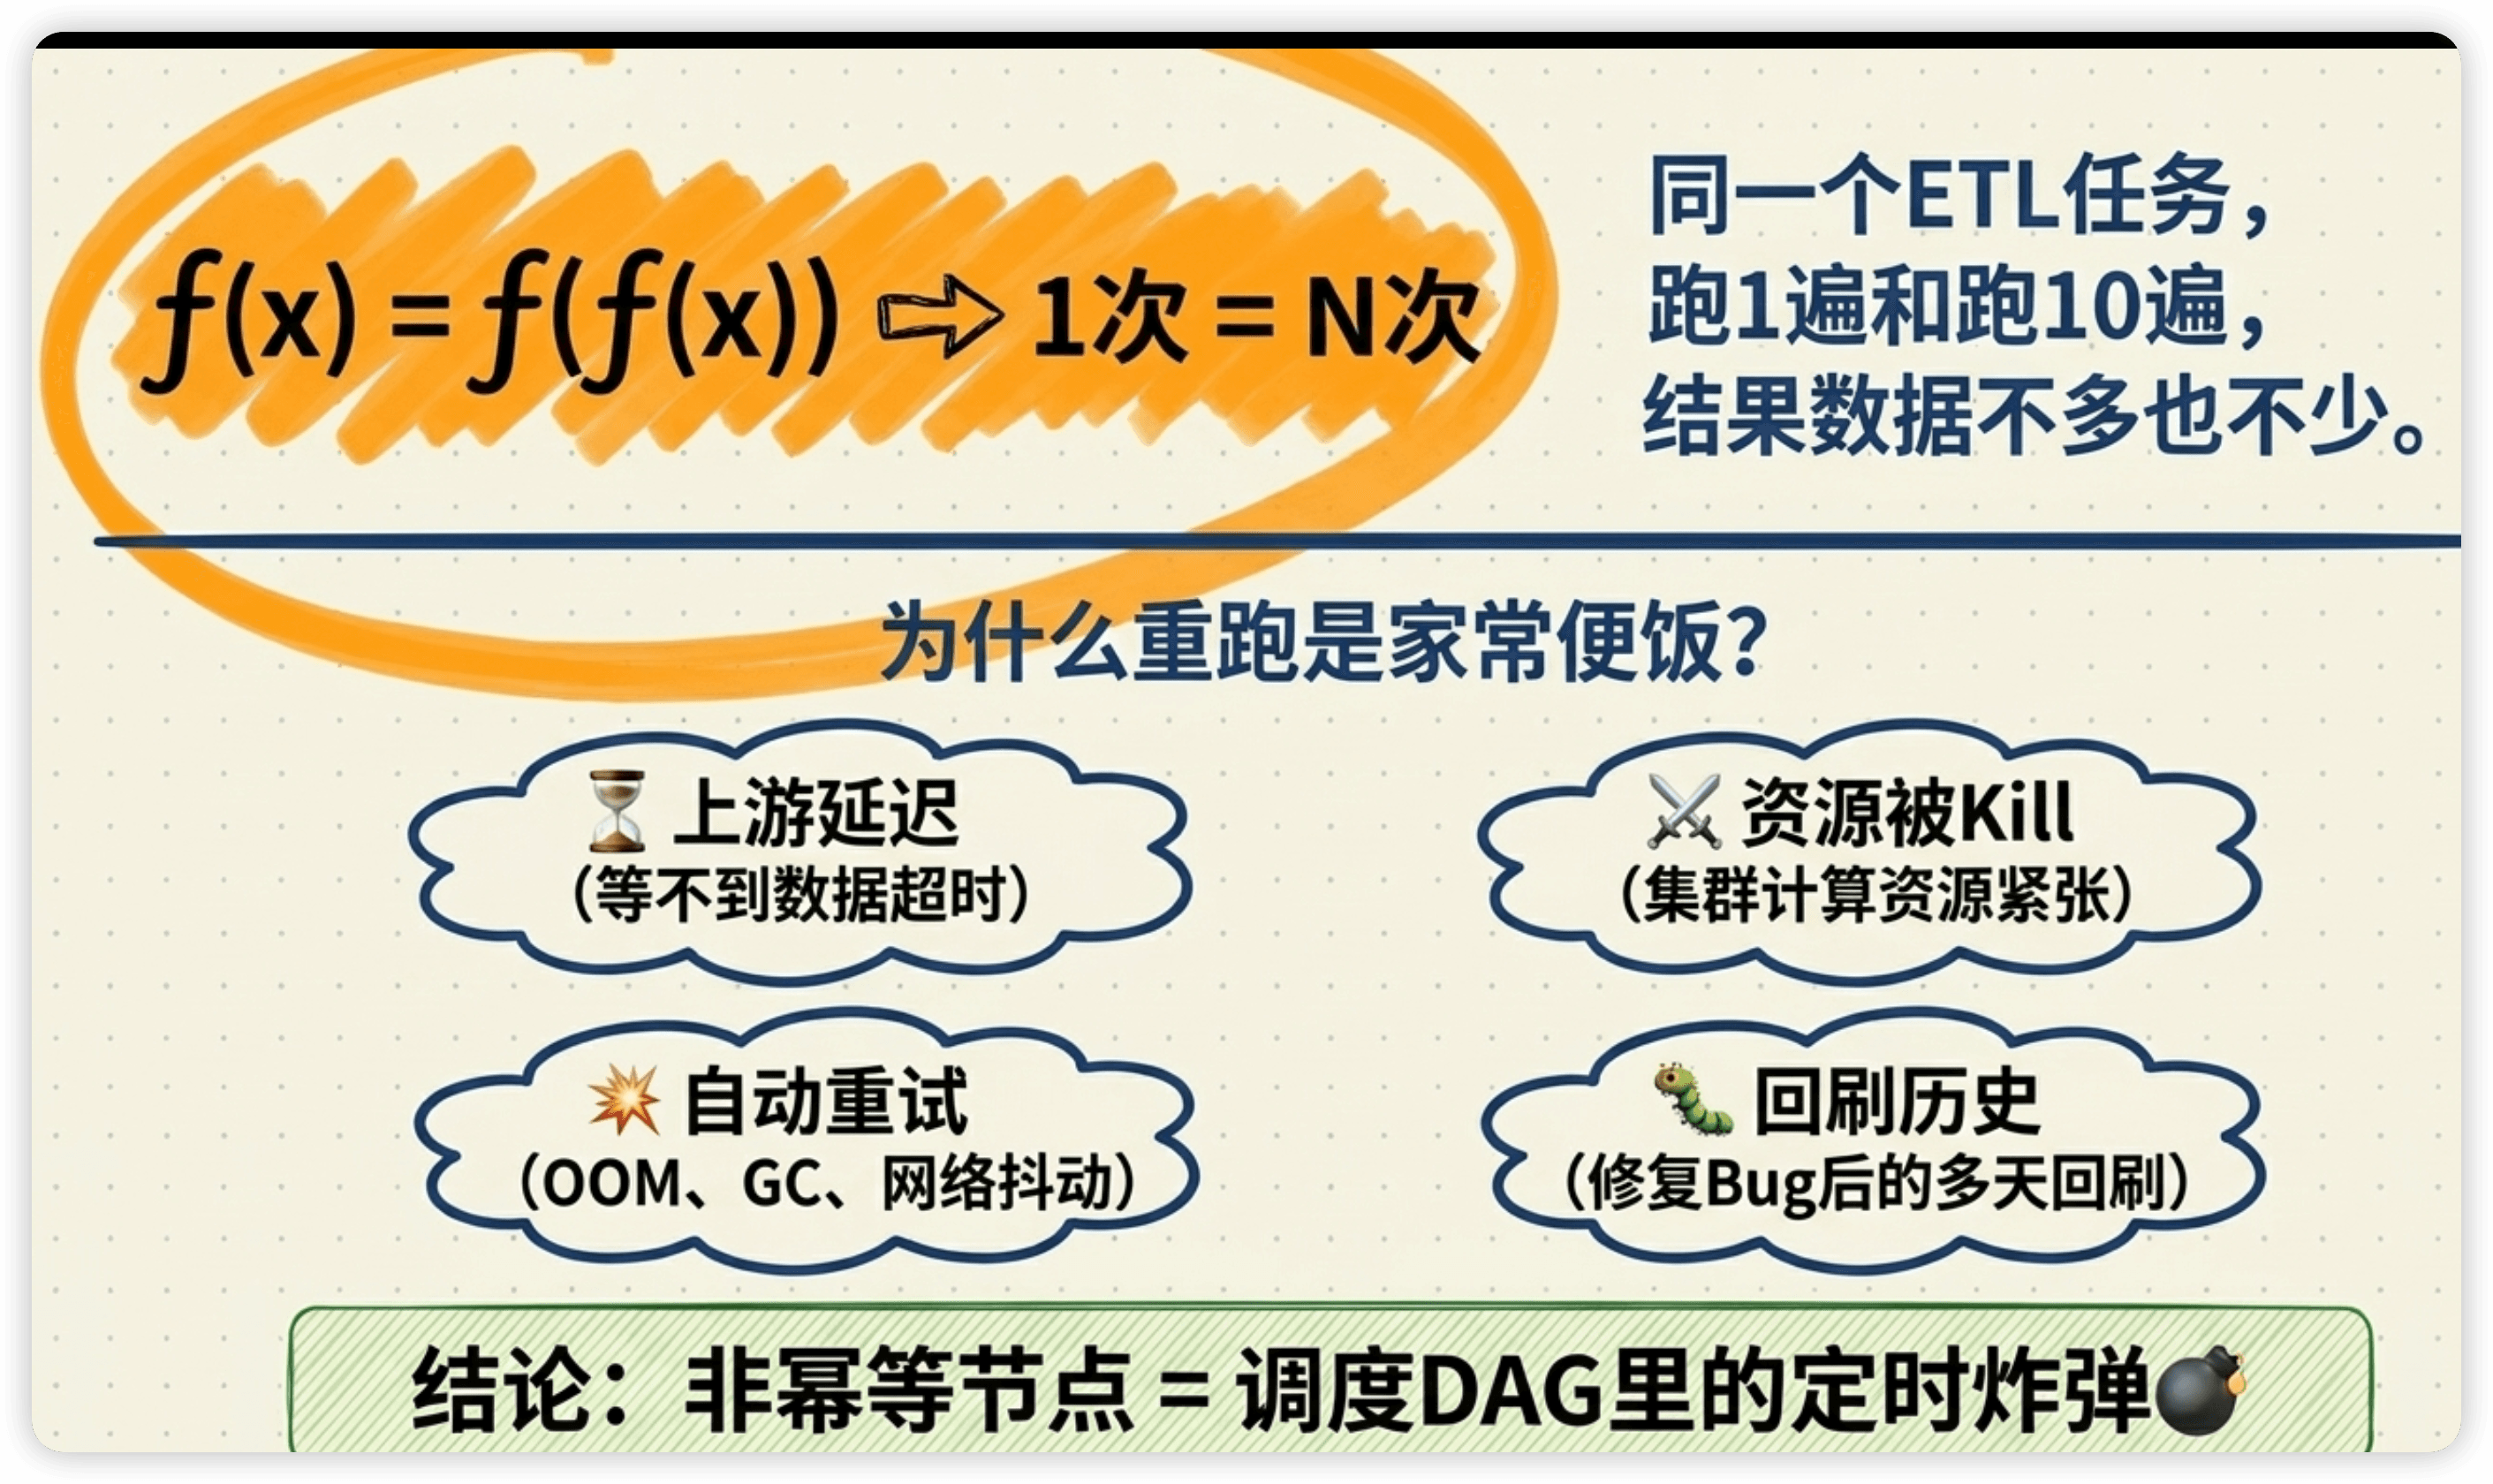
为什么幂等这么重要?因为在生产环境中,任务失败重跑是家常便饭:
- 上游数据延迟了,任务等不到数据超时失败,需要重跑
- 集群资源紧张,任务被kill了,需要重跑
- OOM了、GC了、网络抖了,自动重试
- 发现Bug修复后,需要回刷历史数据(手动重跑多天)
如果任务不是幂等的,每次重跑都会引入重复数据或数据不一致。在一个有几百个任务的调度DAG里,任何一个非幂等的节点都是定时炸弹。
离线数仓幂等的第一铁律:INSERT OVERWRITE
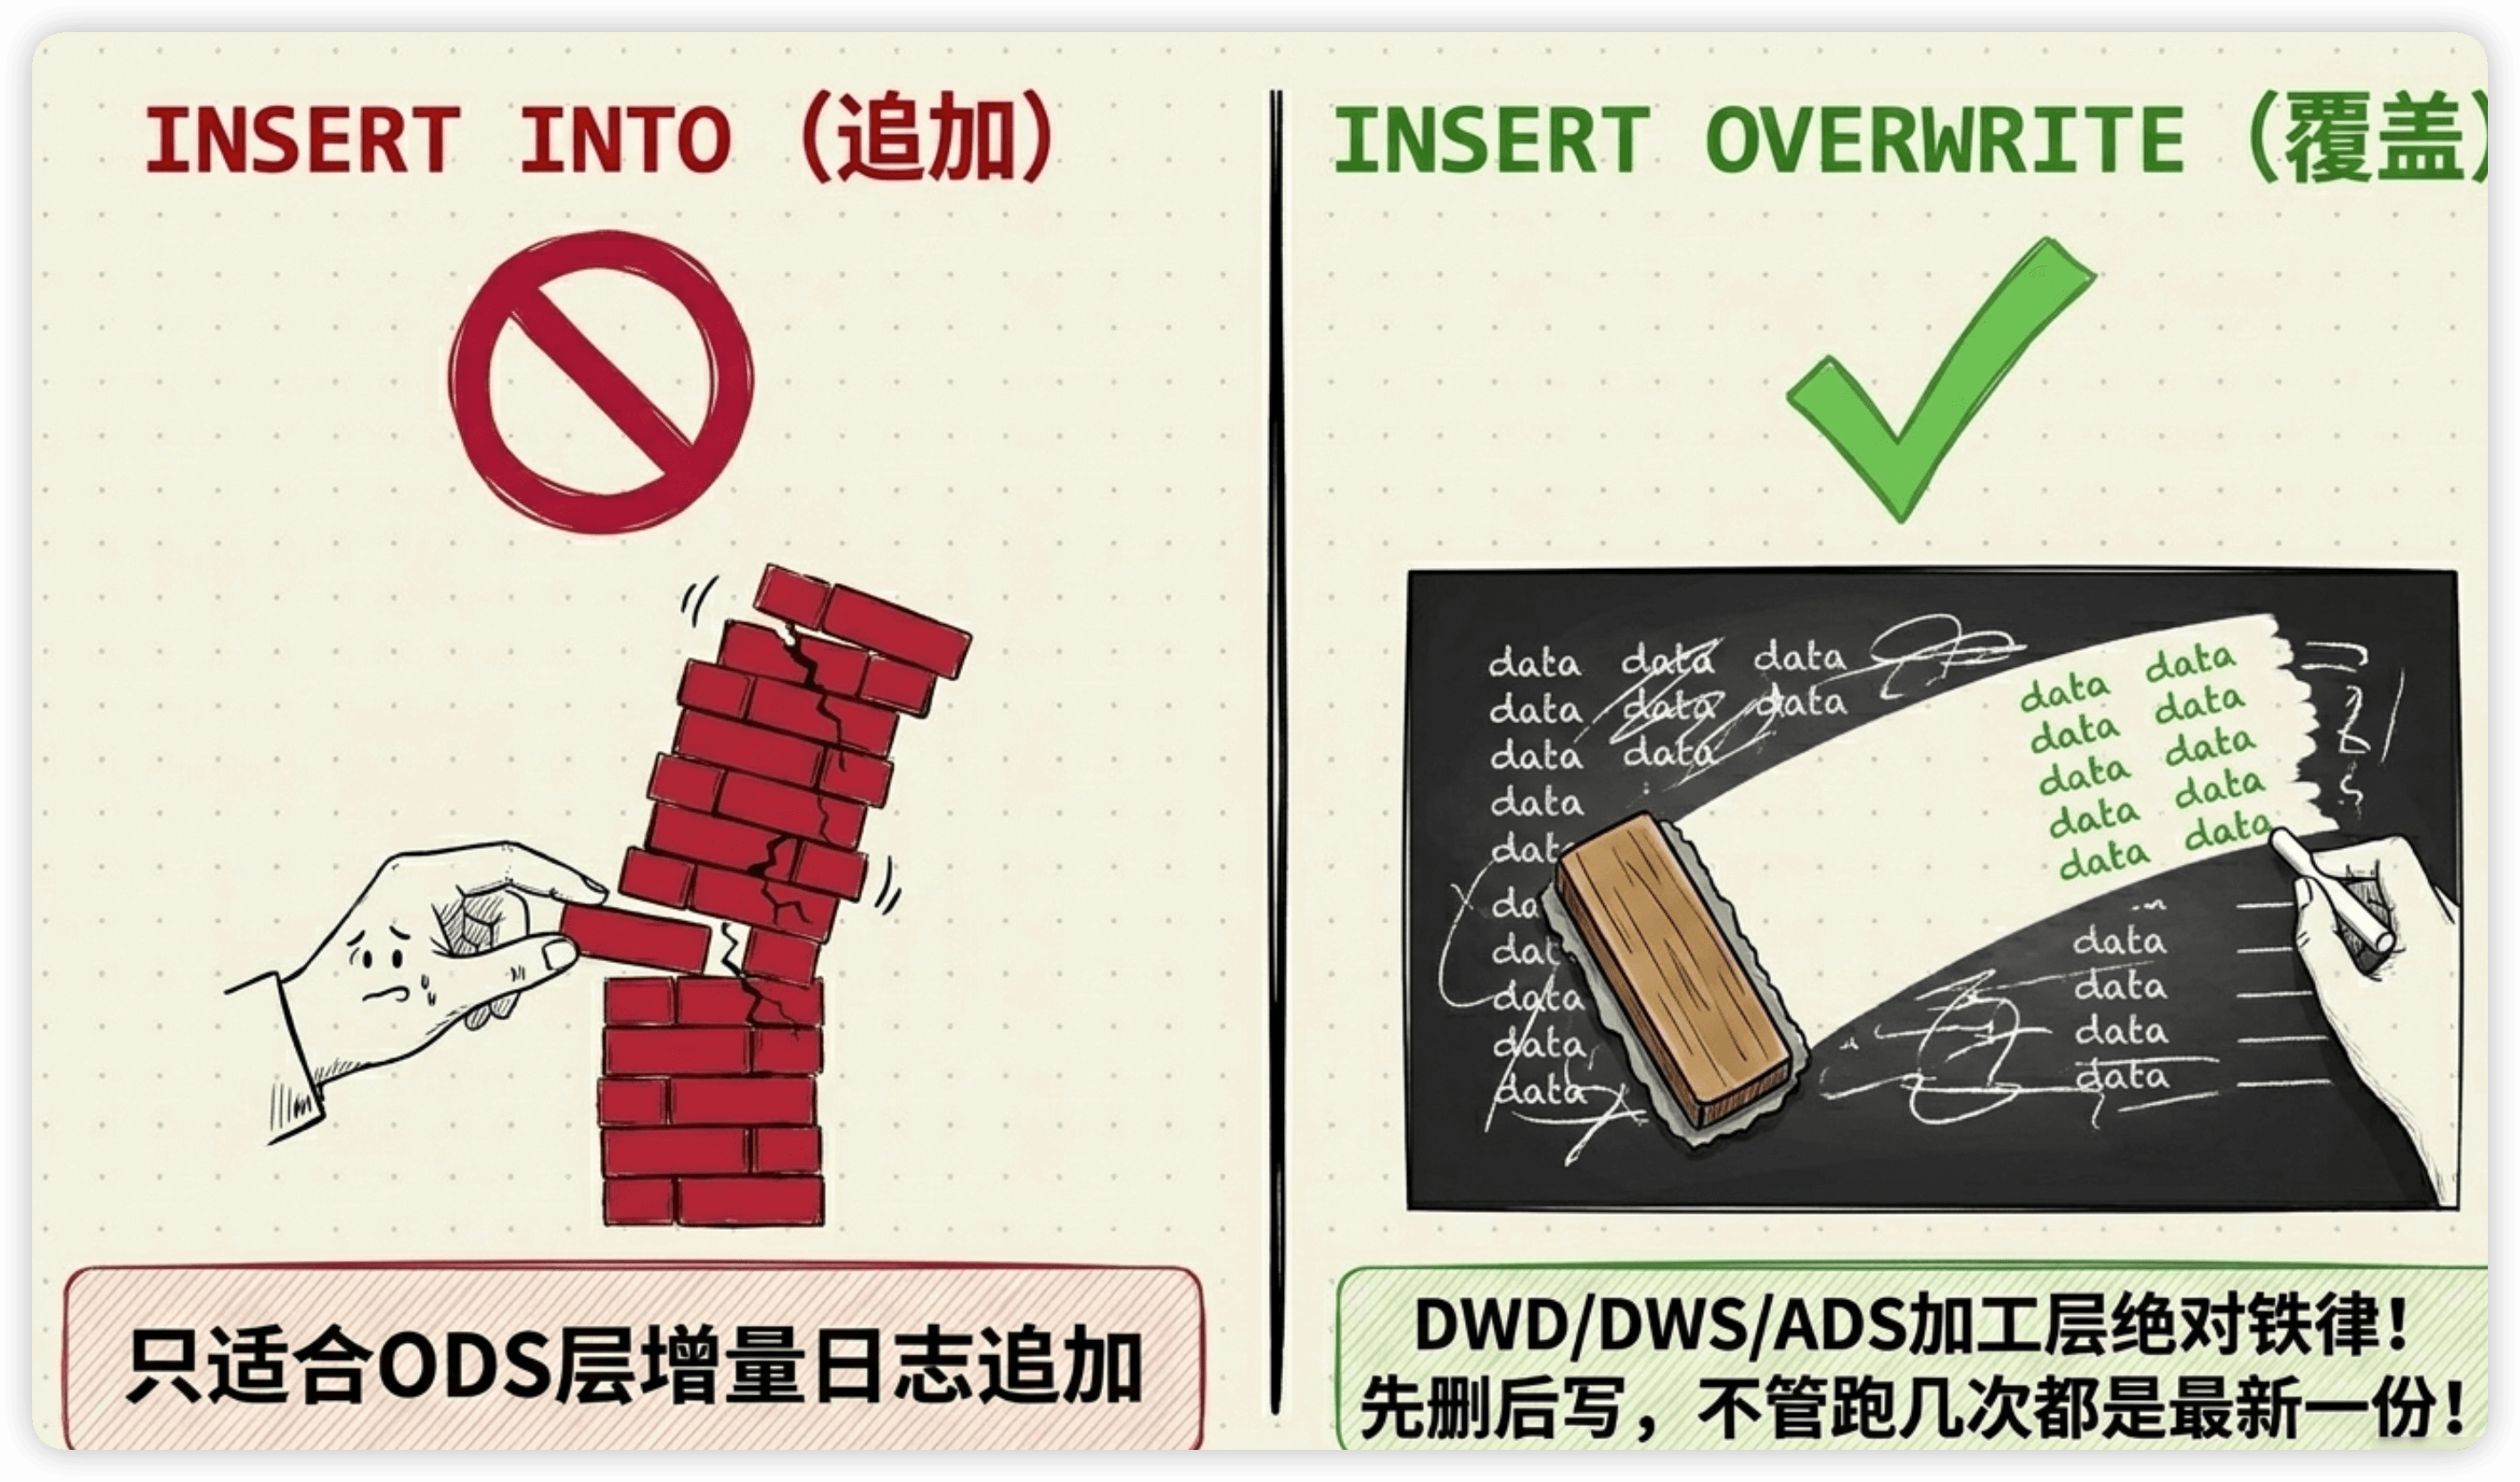
INSERT INTO vs INSERT OVERWRITE
两者的区别就一个字——追加 vs 覆盖。
-- ❌ INSERT INTO:追加模式
-- 在已有数据的基础上增加新行
INSERT INTO TABLE dws_order PARTITION(dt='2025-01-15')
SELECT * FROM dwd_order WHERE dt='2025-01-15';

-- 第一次跑:分区里有100万行 ✅
-- 重跑一次:100万+100万=200万行 ❌(重复了!)
-- 再重跑:300万行 ❌❌
-- ✅ INSERT OVERWRITE:覆盖模式
-- 先清空目标分区,再写入新数据
INSERT OVERWRITE TABLE dws_order PARTITION(dt='2025-01-15')
SELECT * FROM dwd_order WHERE dt='2025-01-15';
-- 第一次跑:分区里有100万行 ✅
-- 重跑一次:清空后重写,还是100万行 ✅
-- 再重跑:还是100万行 ✅INSERT OVERWRITE的语义是先删后写——先把目标分区的所有数据清掉,然后写入新数据。不管跑几次,结果都是最新的一份数据。
这是离线数仓幂等设计的第一铁律:所有写入操作用INSERT OVERWRITE,禁止INSERT INTO。
为什么INSERT INTO会存在?它在追加日志型数据的场景下有用(比如ODS层每小时追加一批增量数据)。但在DWD/DWS/ADS这些加工层,绝对应该用OVERWRITE。
不同场景的幂等方案
场景一:分区表的日常ETL(最常见)
按天分区的表,INSERT OVERWRITE只影响当天分区,其他分区的数据完全不受影响:
-- 标准幂等写法:OVERWRITE + 指定分区
INSERT OVERWRITE TABLE dws_trade_user_pay_1d PARTITION(dt='${bizdate}')
SELECT
    user_id,
    SUM(pay_amount) AS pay_amount,
    COUNT(*) AS pay_cnt
FROM dwd_trade_order_detail_di
WHERE dt = '${bizdate}'
  AND status = 'paid'
GROUP BY user_id;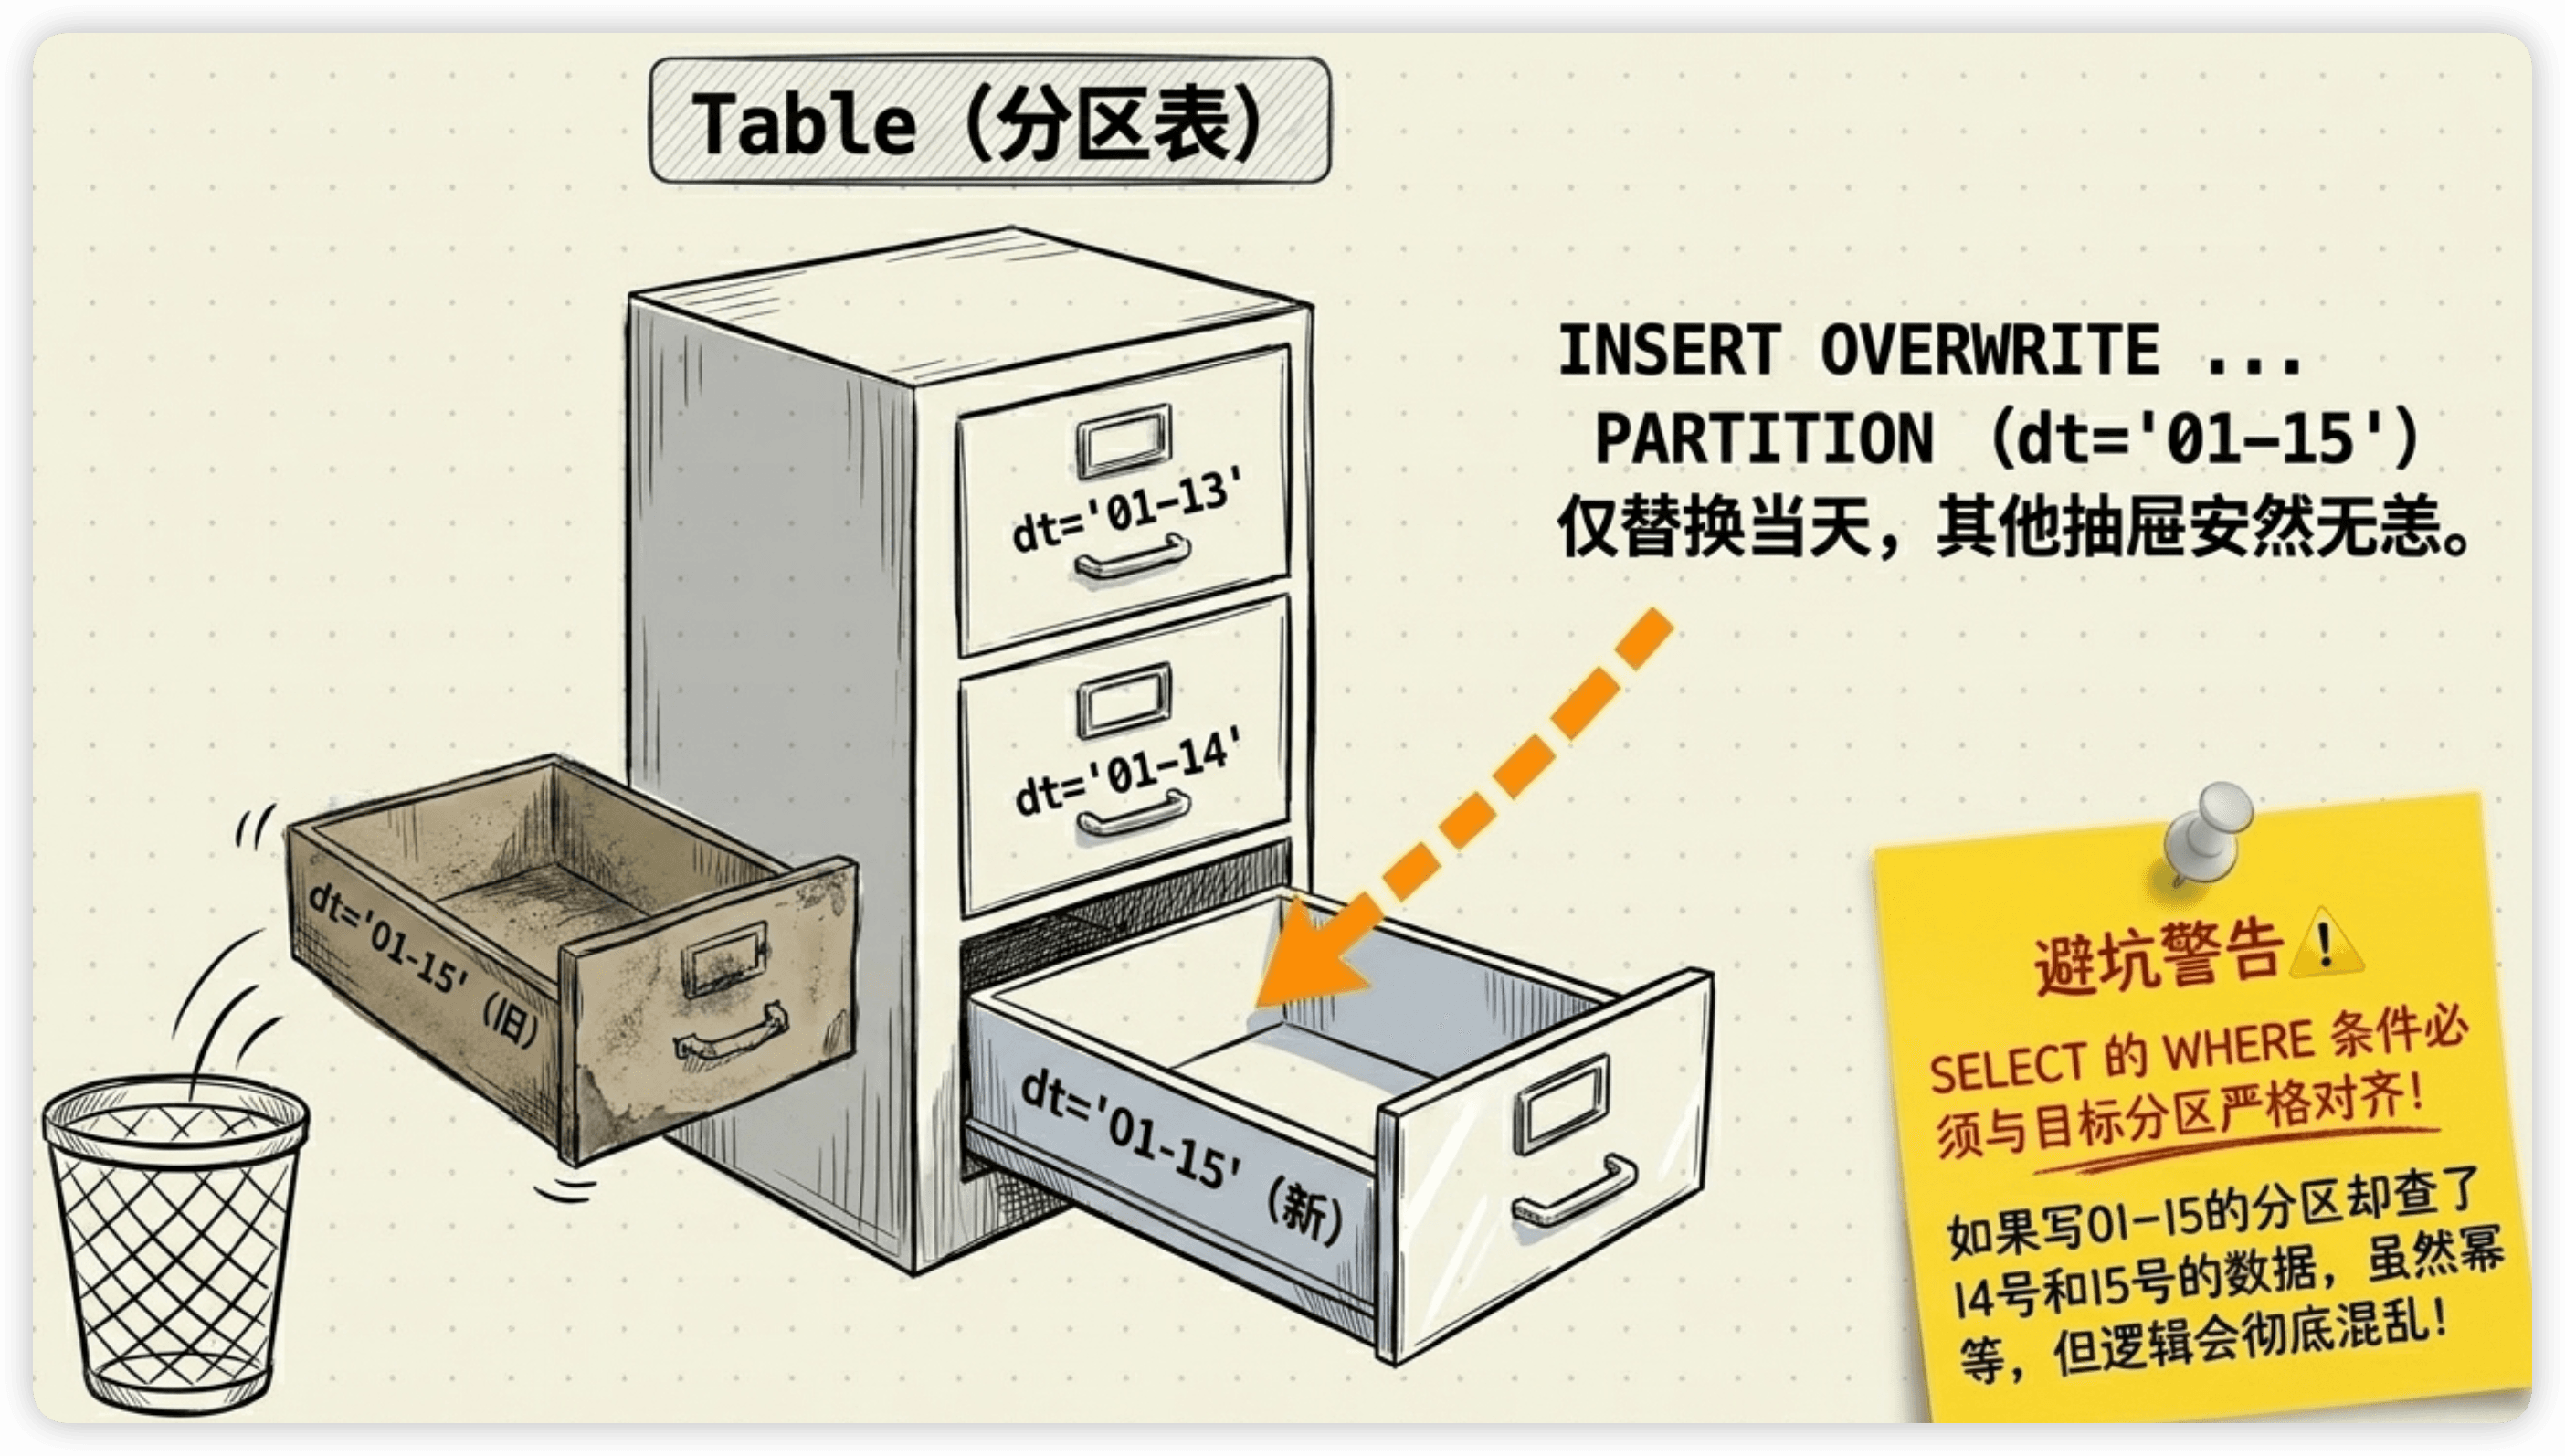
注意: SELECT的WHERE条件和目标分区必须对齐。如果目标分区是dt='2025-01-15'但SELECT里查了dt='2025-01-14'和dt='2025-01-15'两天的数据,重跑时数据还是对的(因为OVERWRITE),但逻辑上不清晰,容易引发困惑。
场景二:全量维度表(无分区)
有些维度表是全量快照,没有分区——每天全量覆盖整张表:
-- 全表OVERWRITE
INSERT OVERWRITE TABLE dim_product
SELECT product_id, product_name, category, brand, unit_price
FROM ods_product
WHERE is_latest = 1;
这也是幂等的——重跑多少次都只有一份完整数据。
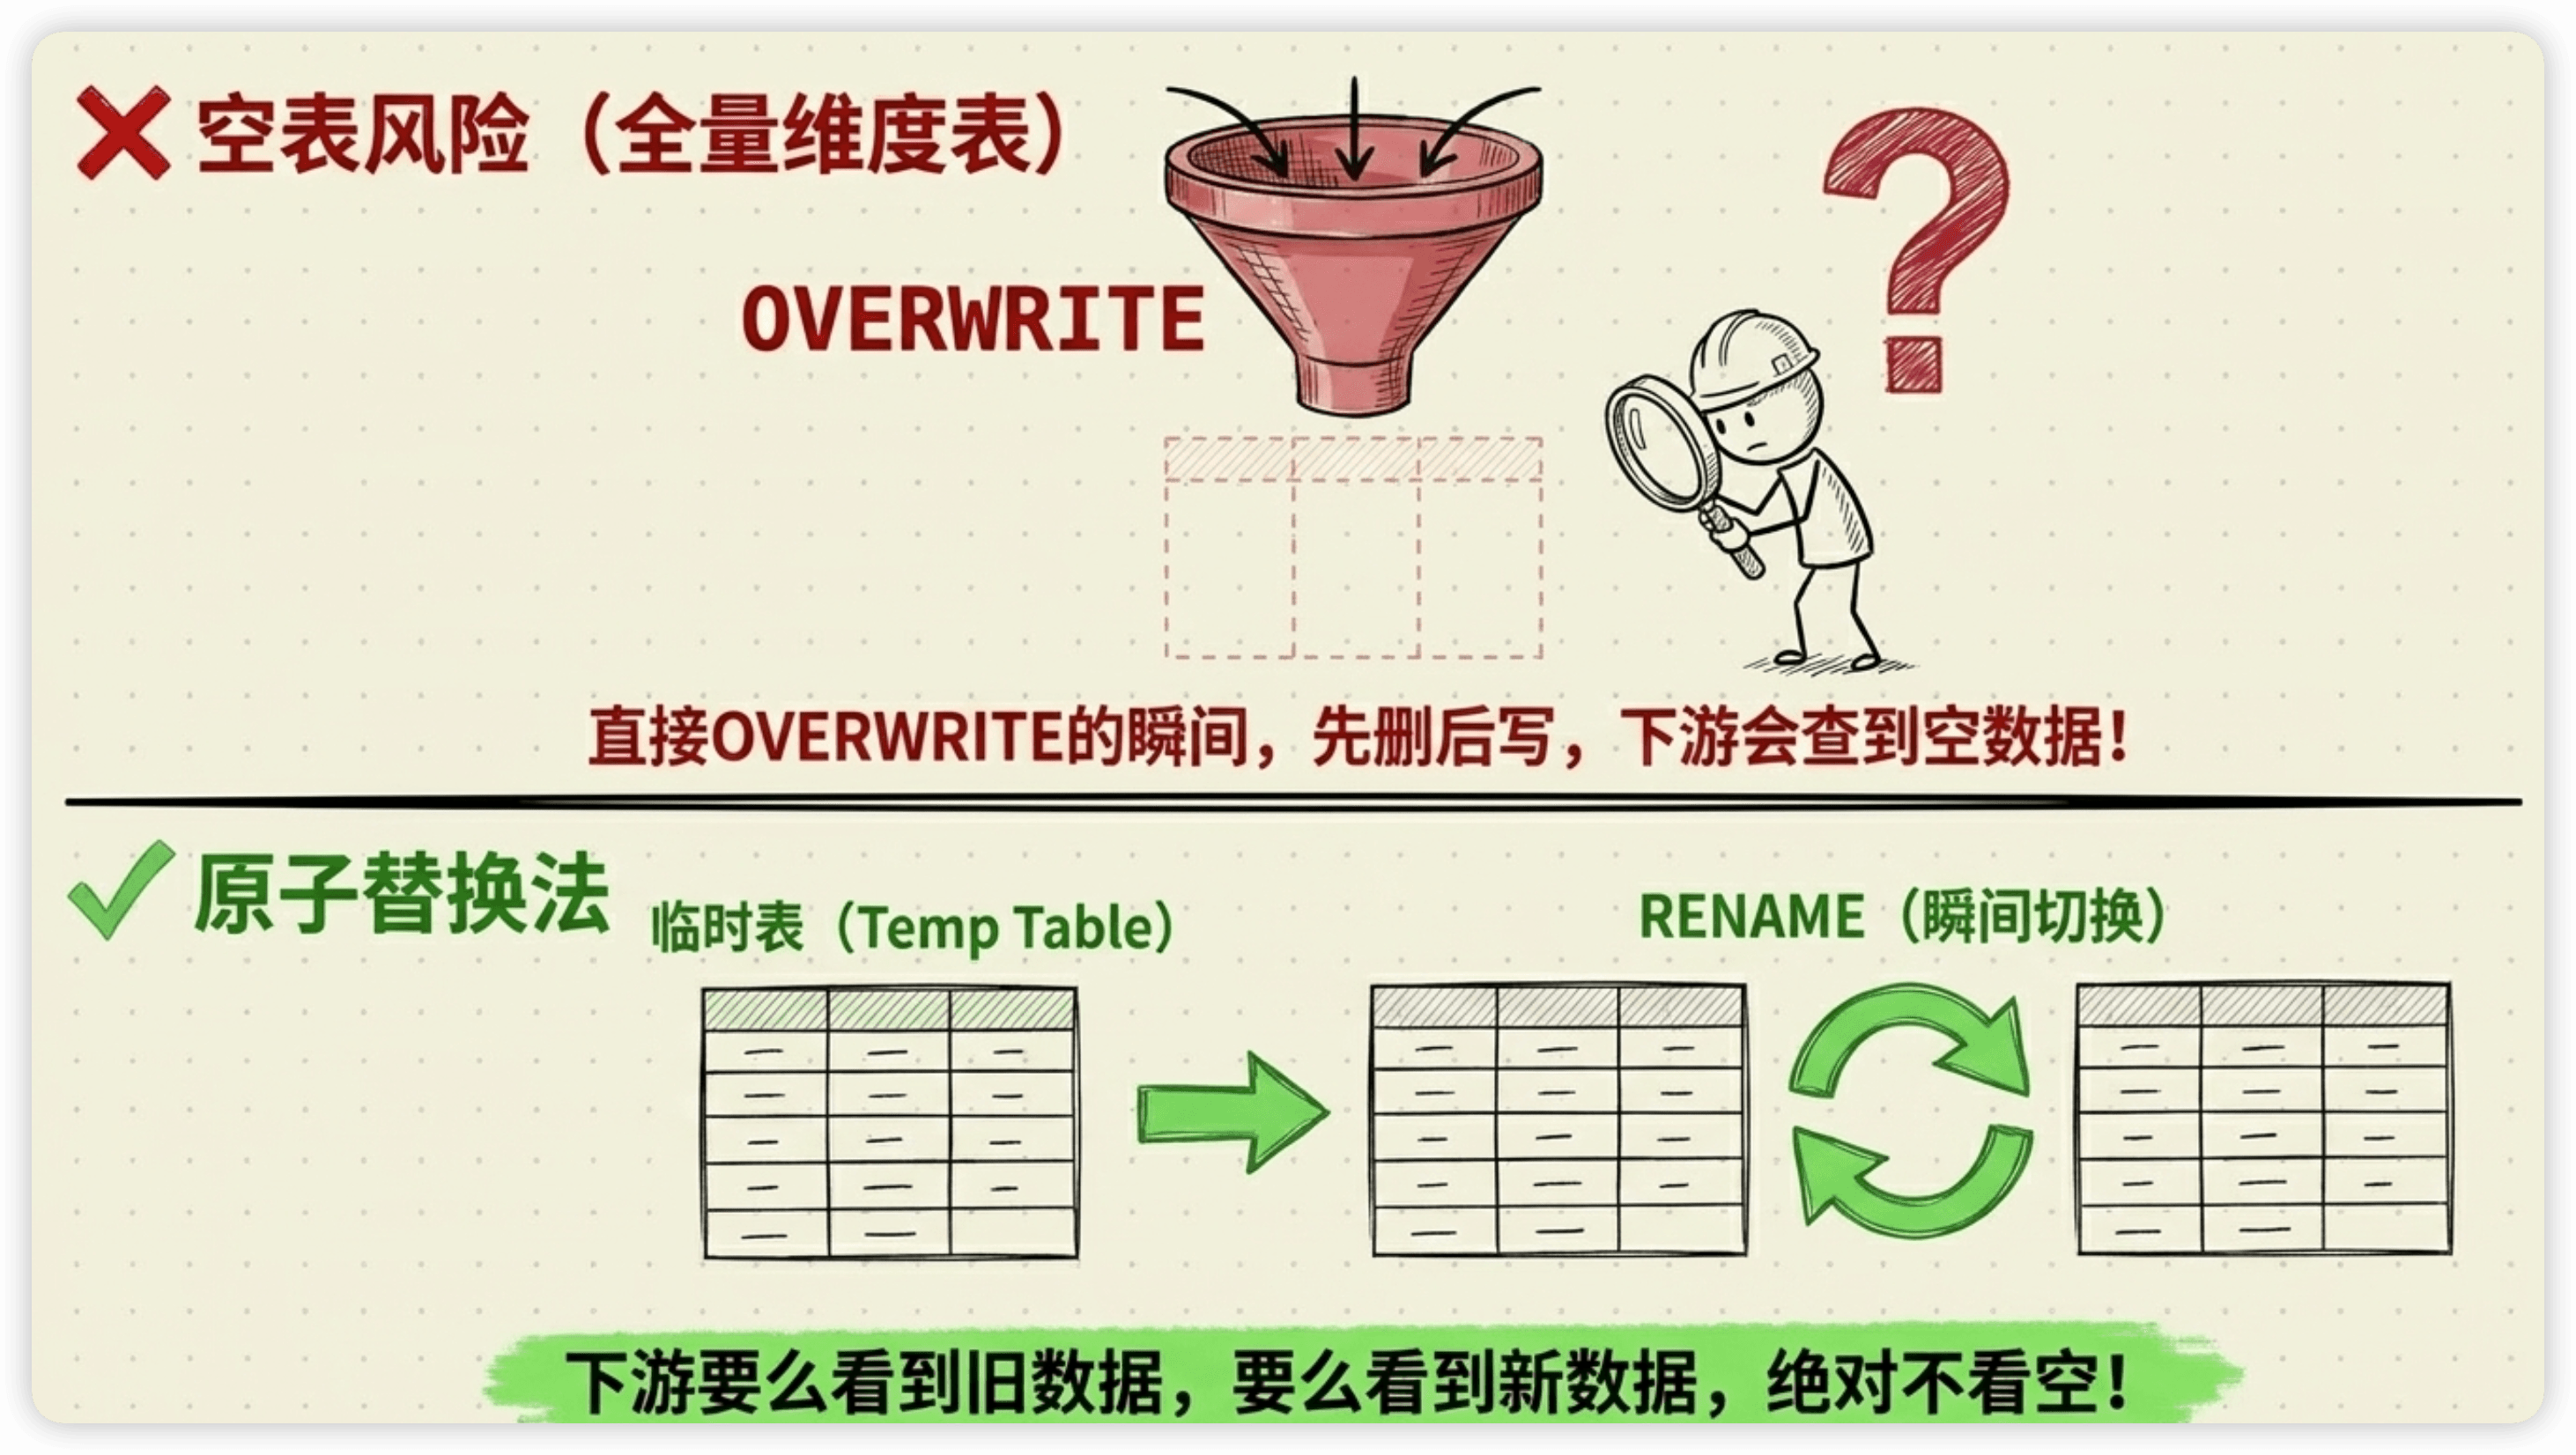
但有一个风险: INSERT OVERWRITE执行过程中,目标表是"空"的(先删后写)。如果此时有下游任务正在查这张表,会查到空表或不完整的数据。
优化方案:写临时表 → 原子替换
-- 第一步:写入临时表
CREATE TABLE dim_product_tmp AS
SELECT product_id, product_name, category, brand, unit_price
FROM ods_product WHERE is_latest = 1;

-- 第二步:原子替换(瞬间完成,下游无感知)
ALTER TABLE dim_product RENAME TO dim_product_bak;
ALTER TABLE dim_product_tmp RENAME TO dim_product;

-- 第三步:确认无误后删除备份
DROP TABLE dim_product_bak;
这样在替换的瞬间,下游要么看到旧表要么看到新表,不会看到空表。
场景三:累积快照型事实表
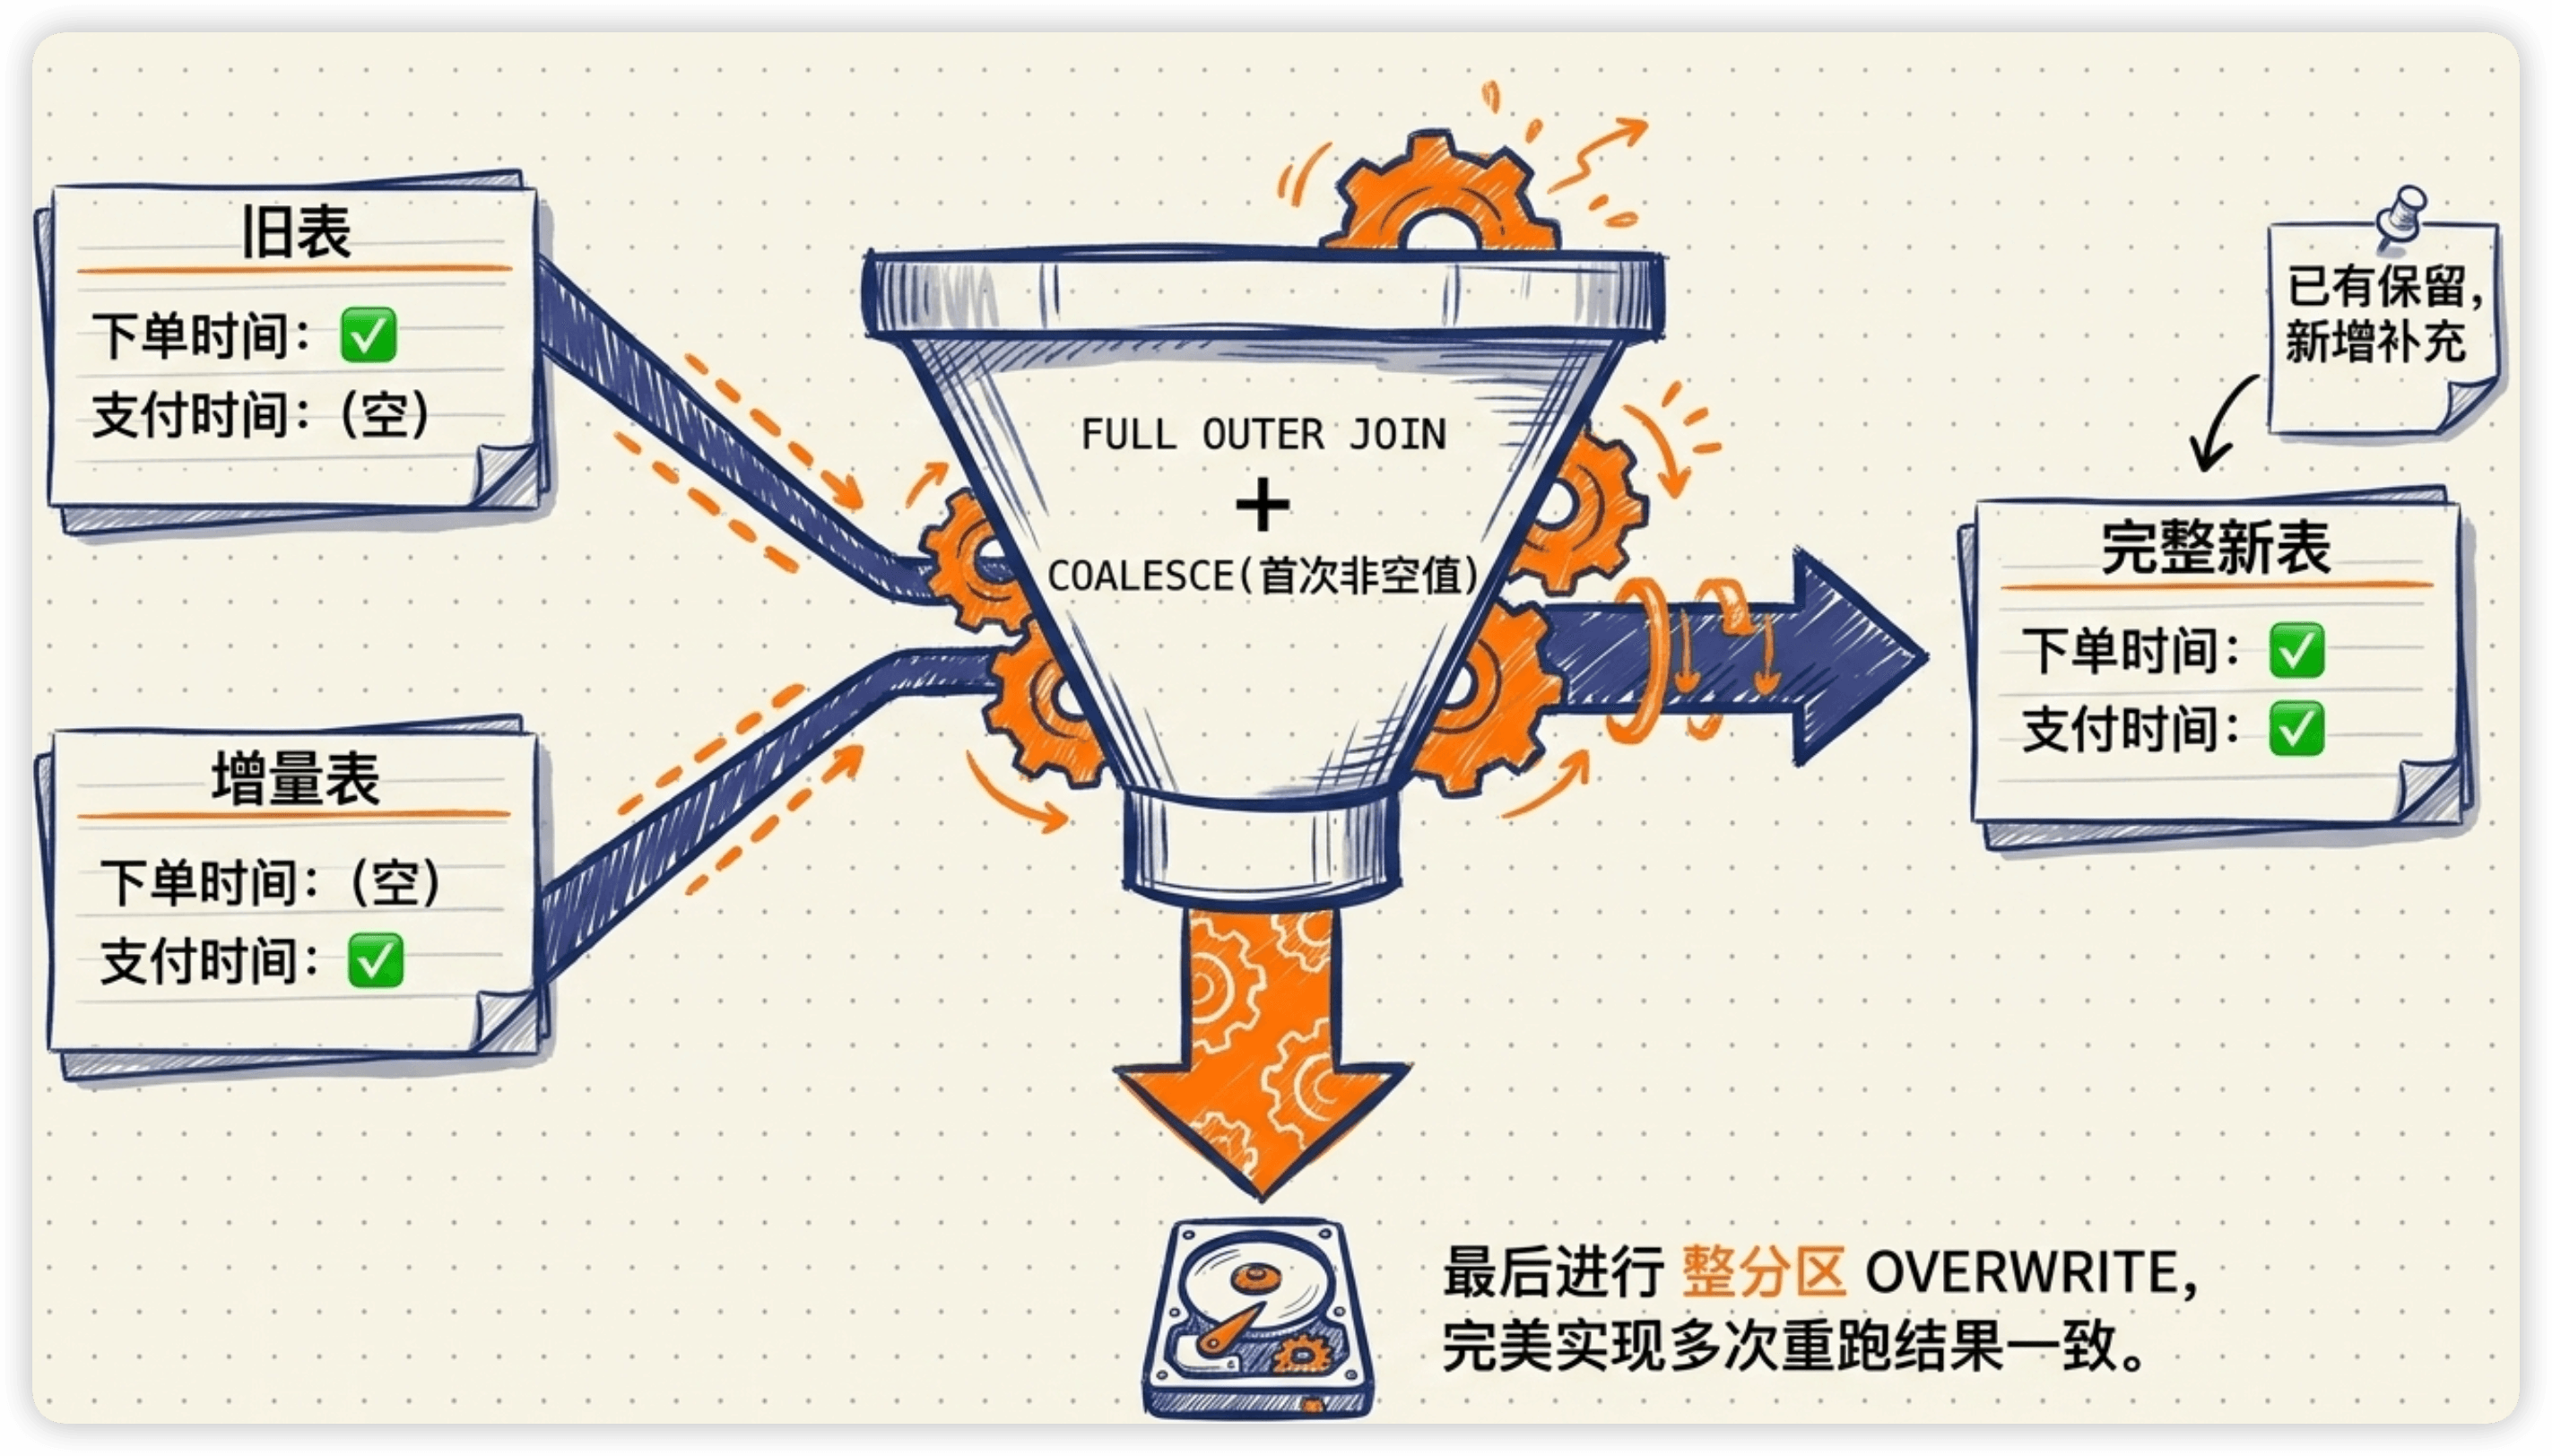
DAY 4讲过的累积快照型事实表,一行数据会被多次更新(订单从下单到支付到发货到签收)。这种表的幂等方案是FULL OUTER JOIN + COALESCE + 整分区OVERWRITE:
INSERT OVERWRITE TABLE fact_order_lifecycle PARTITION(dt='${bizdate}')
SELECT
    COALESCE(new.order_id, old.order_id)     AS order_id,
    COALESCE(old.order_time, new.order_time) AS order_time,
    -- 里程碑字段:优先保留已有值,否则用新值
    COALESCE(old.pay_time, new.pay_time)     AS pay_time,
    COALESCE(old.ship_time, new.ship_time)   AS ship_time,
    COALESCE(new.receive_time, old.receive_time) AS receive_time,
    COALESCE(new.order_status, old.order_status) AS order_status,
    COALESCE(old.order_amount, new.order_amount) AS order_amount
FROM fact_order_lifecycle old
FULL OUTER JOIN (
    SELECT * FROM ods_order_update WHERE dt = '${bizdate}'
) new ON old.order_id = new.order_id;
核心逻辑:旧表和增量表做FULL OUTER JOIN,COALESCE取"第一个非空值"——已有的里程碑保留,新增的里程碑补充进来。整个分区OVERWRITE,重跑多次结果一样。
场景四:实时写入OLAP引擎
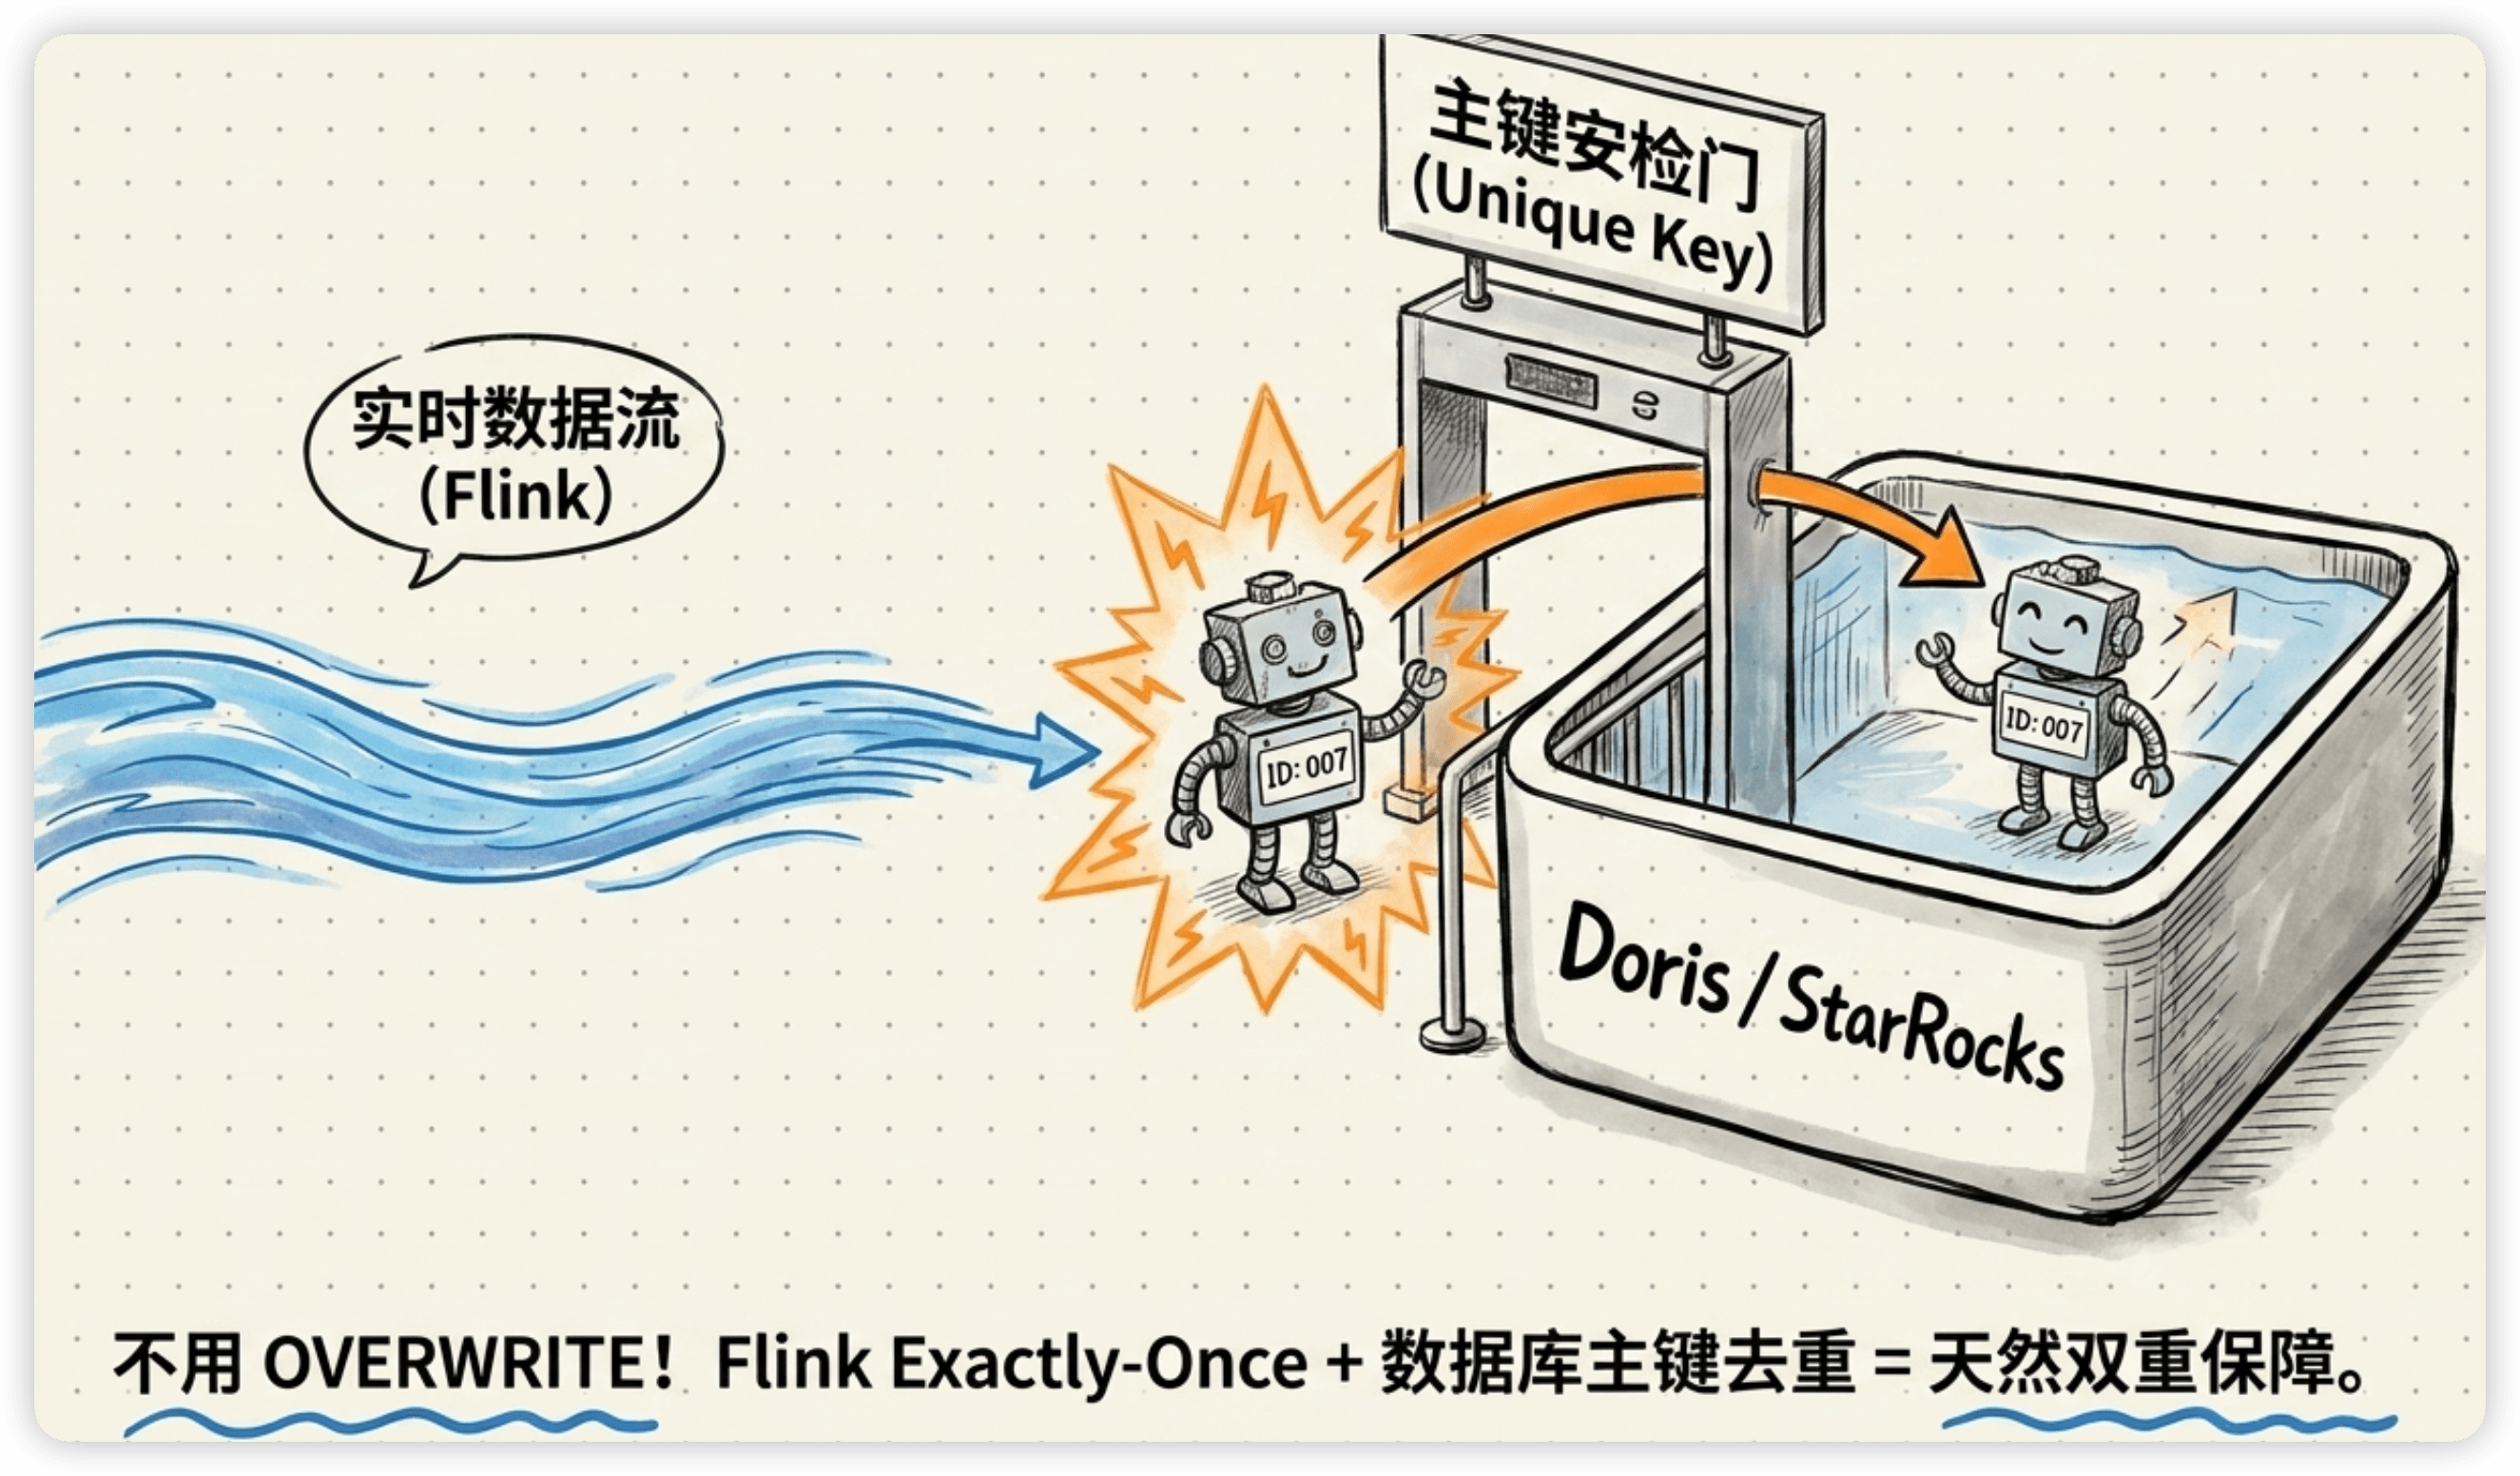
Flink写Doris、StarRocks、Hologres等OLAP引擎时,幂等靠的是主键去重,而不是OVERWRITE:
-- Doris Unique Key模型:相同主键自动覆盖旧值
CREATE TABLE fact_order_rt (
    order_id    BIGINT,
    user_id     BIGINT,
    amount      DECIMAL(10,2),
    status      STRING,
    update_time DATETIME
) ENGINE=OLAP
UNIQUE KEY(order_id)           -- 主键
DISTRIBUTED BY HASH(order_id);

-- 写入相同order_id的数据时,新值自动覆盖旧值
-- 重复写入不会产生重复行
Flink的Exactly-Once语义 + Doris的Unique Key模型,双重保障幂等。
容易忽略的幂等陷阱
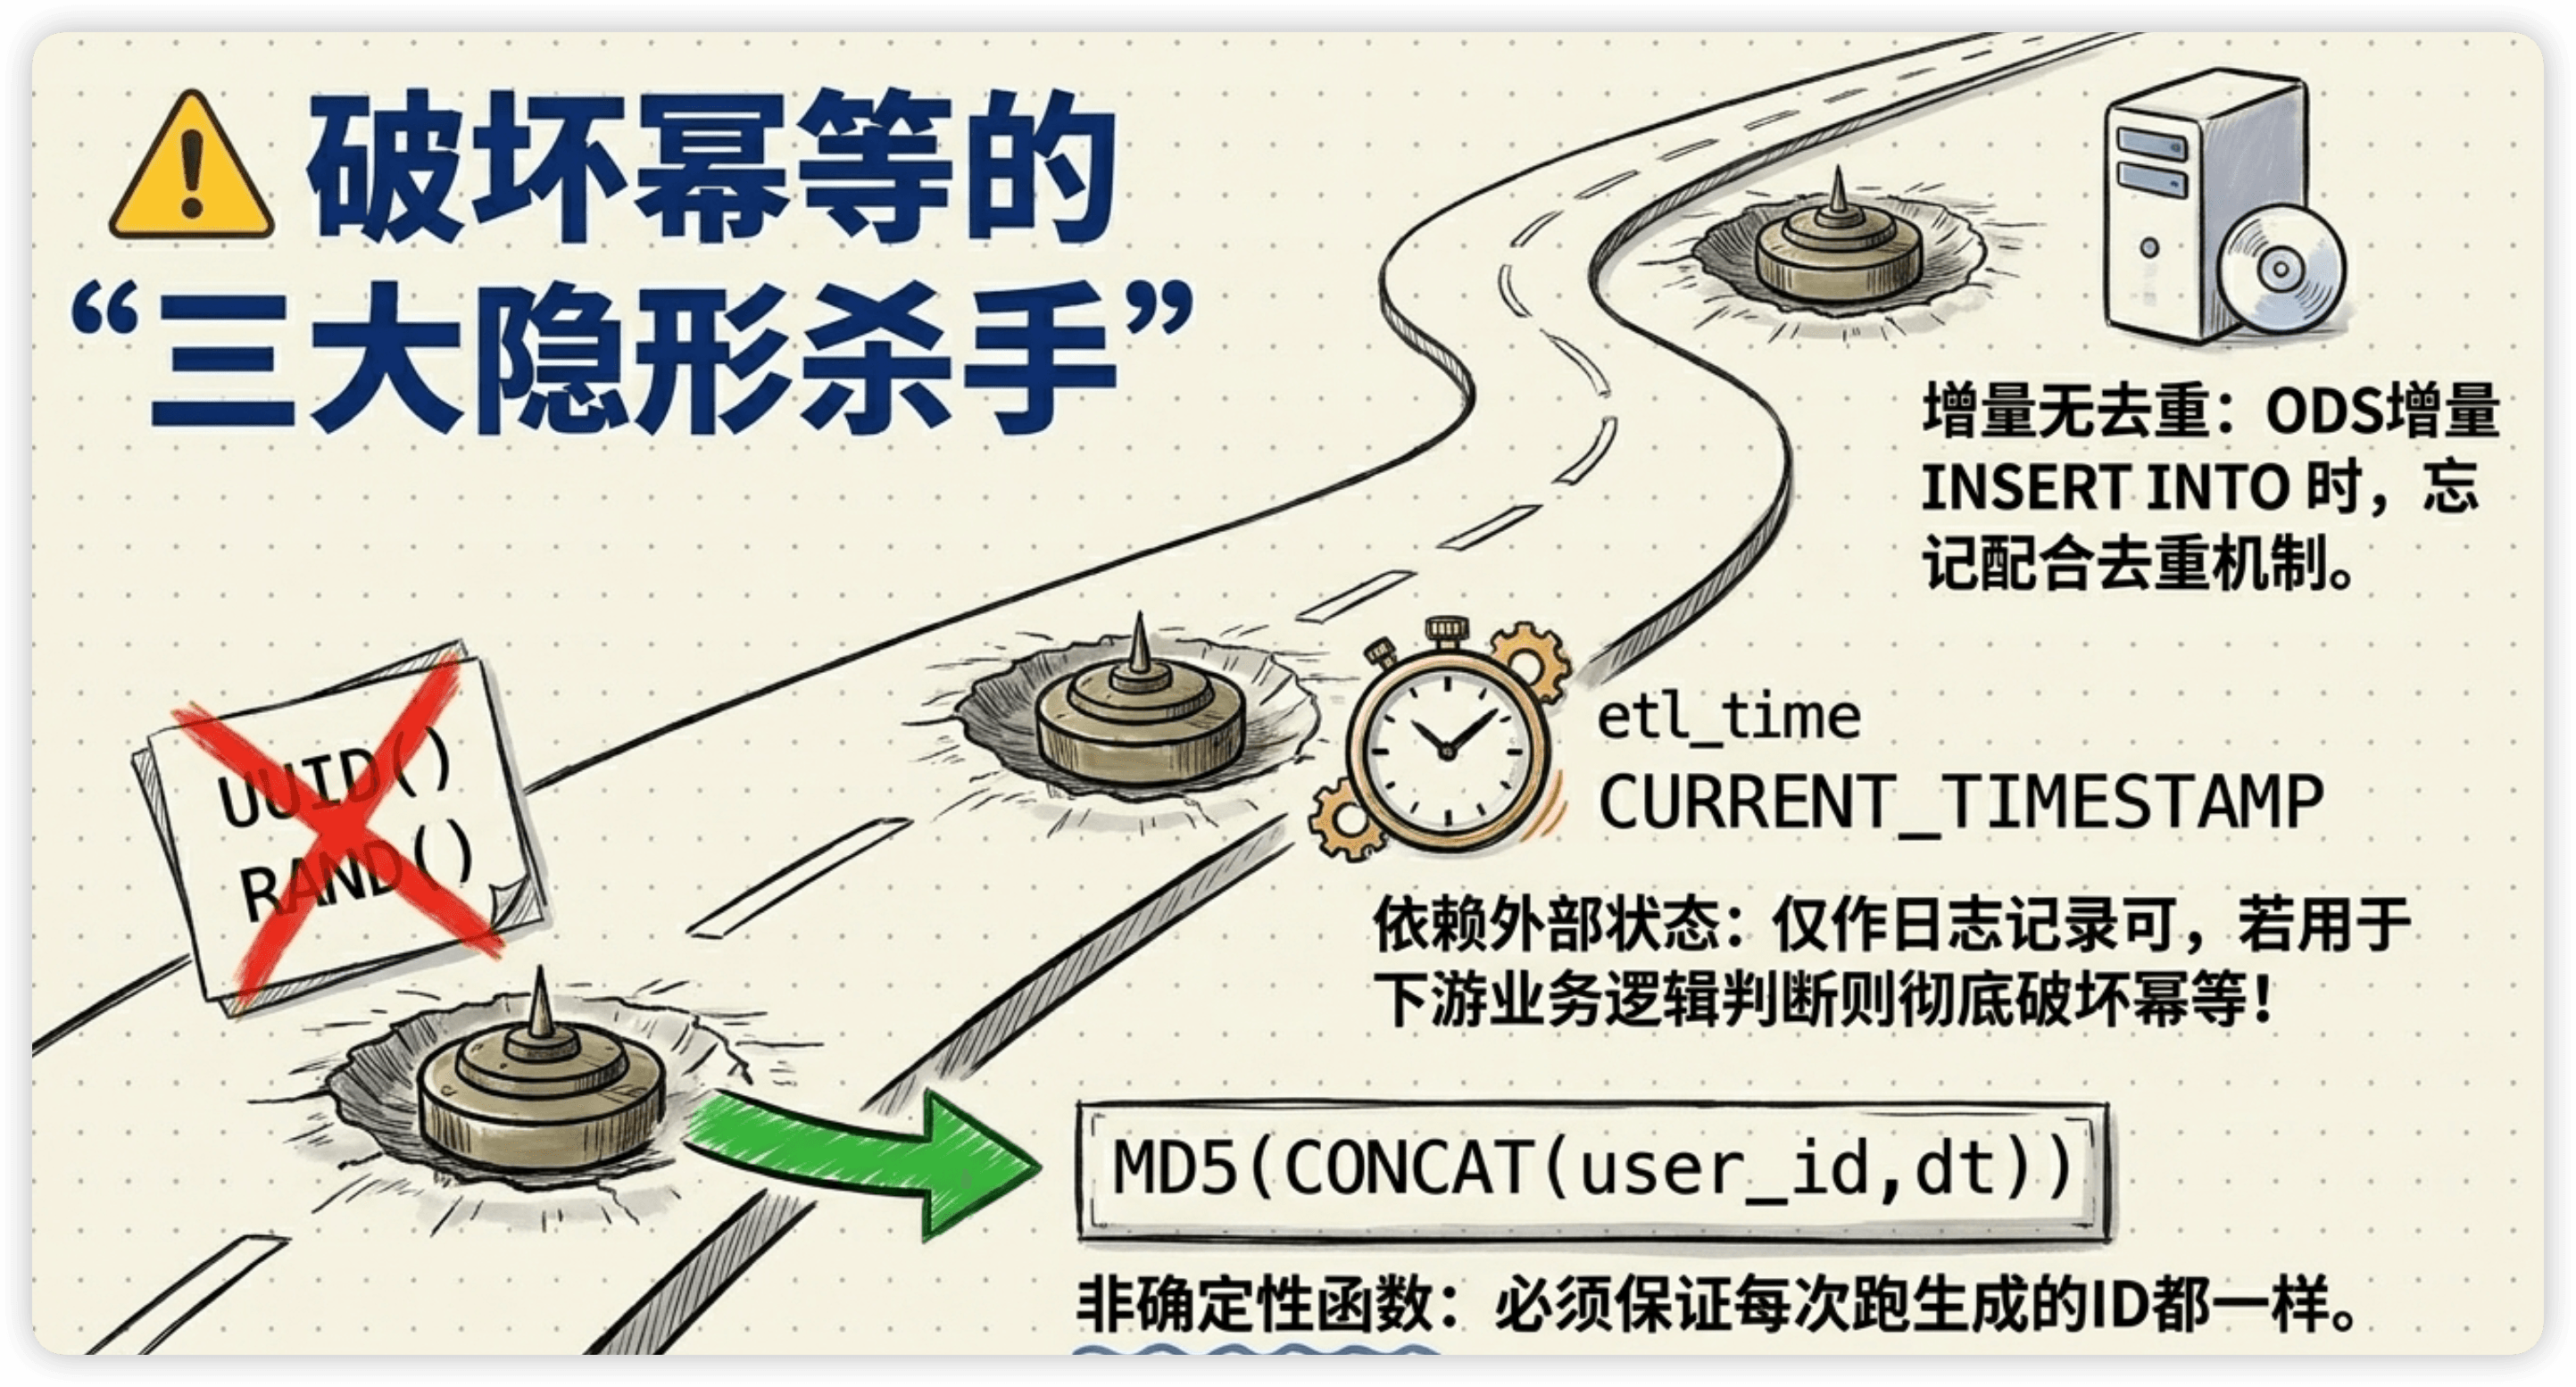
陷阱一:SELECT里有非确定性函数
-- ❌ 有问题:RAND()和UUID()每次运行结果不同
INSERT OVERWRITE TABLE dws_xxx PARTITION(dt='2025-01-15')
SELECT user_id, UUID() AS trace_id, RAND() AS sample_flag
FROM dwd_xxx;
-- 重跑后trace_id和sample_flag的值变了,虽然行数一样,但数据不一样如果下游依赖trace_id的具体值(比如做去重),重跑就会出问题。解决方案是用确定性的方法生成ID——比如用MD5(CONCAT(user_id, dt))代替UUID()。
陷阱二:依赖外部状态
-- ❌ 有问题:CURRENT_TIMESTAMP每次运行的值不同
INSERT OVERWRITE TABLE dws_xxx PARTITION(dt='2025-01-15')
SELECT user_id, CURRENT_TIMESTAMP AS etl_time
FROM dwd_xxx;
-- 重跑后etl_time变了
如果etl_time只是记录日志用途,问题不大。但如果下游用etl_time做业务逻辑判断,就不幂等了。
陷阱三:增量+全量混合写入
-- ❌ 有问题:ODS层用INSERT INTO追加增量数据
-- 如果任务重跑,同一批增量会被追加两次
INSERT INTO TABLE ods_order PARTITION(dt='2025-01-15')
SELECT * FROM kafka_order_topic WHERE dt='2025-01-15';
ODS层的增量写入确实需要用INSERT INTO,但要配合去重机制:
-- 写入时做去重
INSERT OVERWRITE TABLE ods_order PARTITION(dt='2025-01-15')
SELECT * FROM (
    SELECT *, ROW_NUMBER() OVER(PARTITION BY order_id ORDER BY kafka_offset DESC) AS rn
    FROM ods_order_raw
    WHERE dt='2025-01-15'
) t WHERE rn = 1;
幂等设计Checklist
每写一个ETL任务之前,过一遍这个清单:
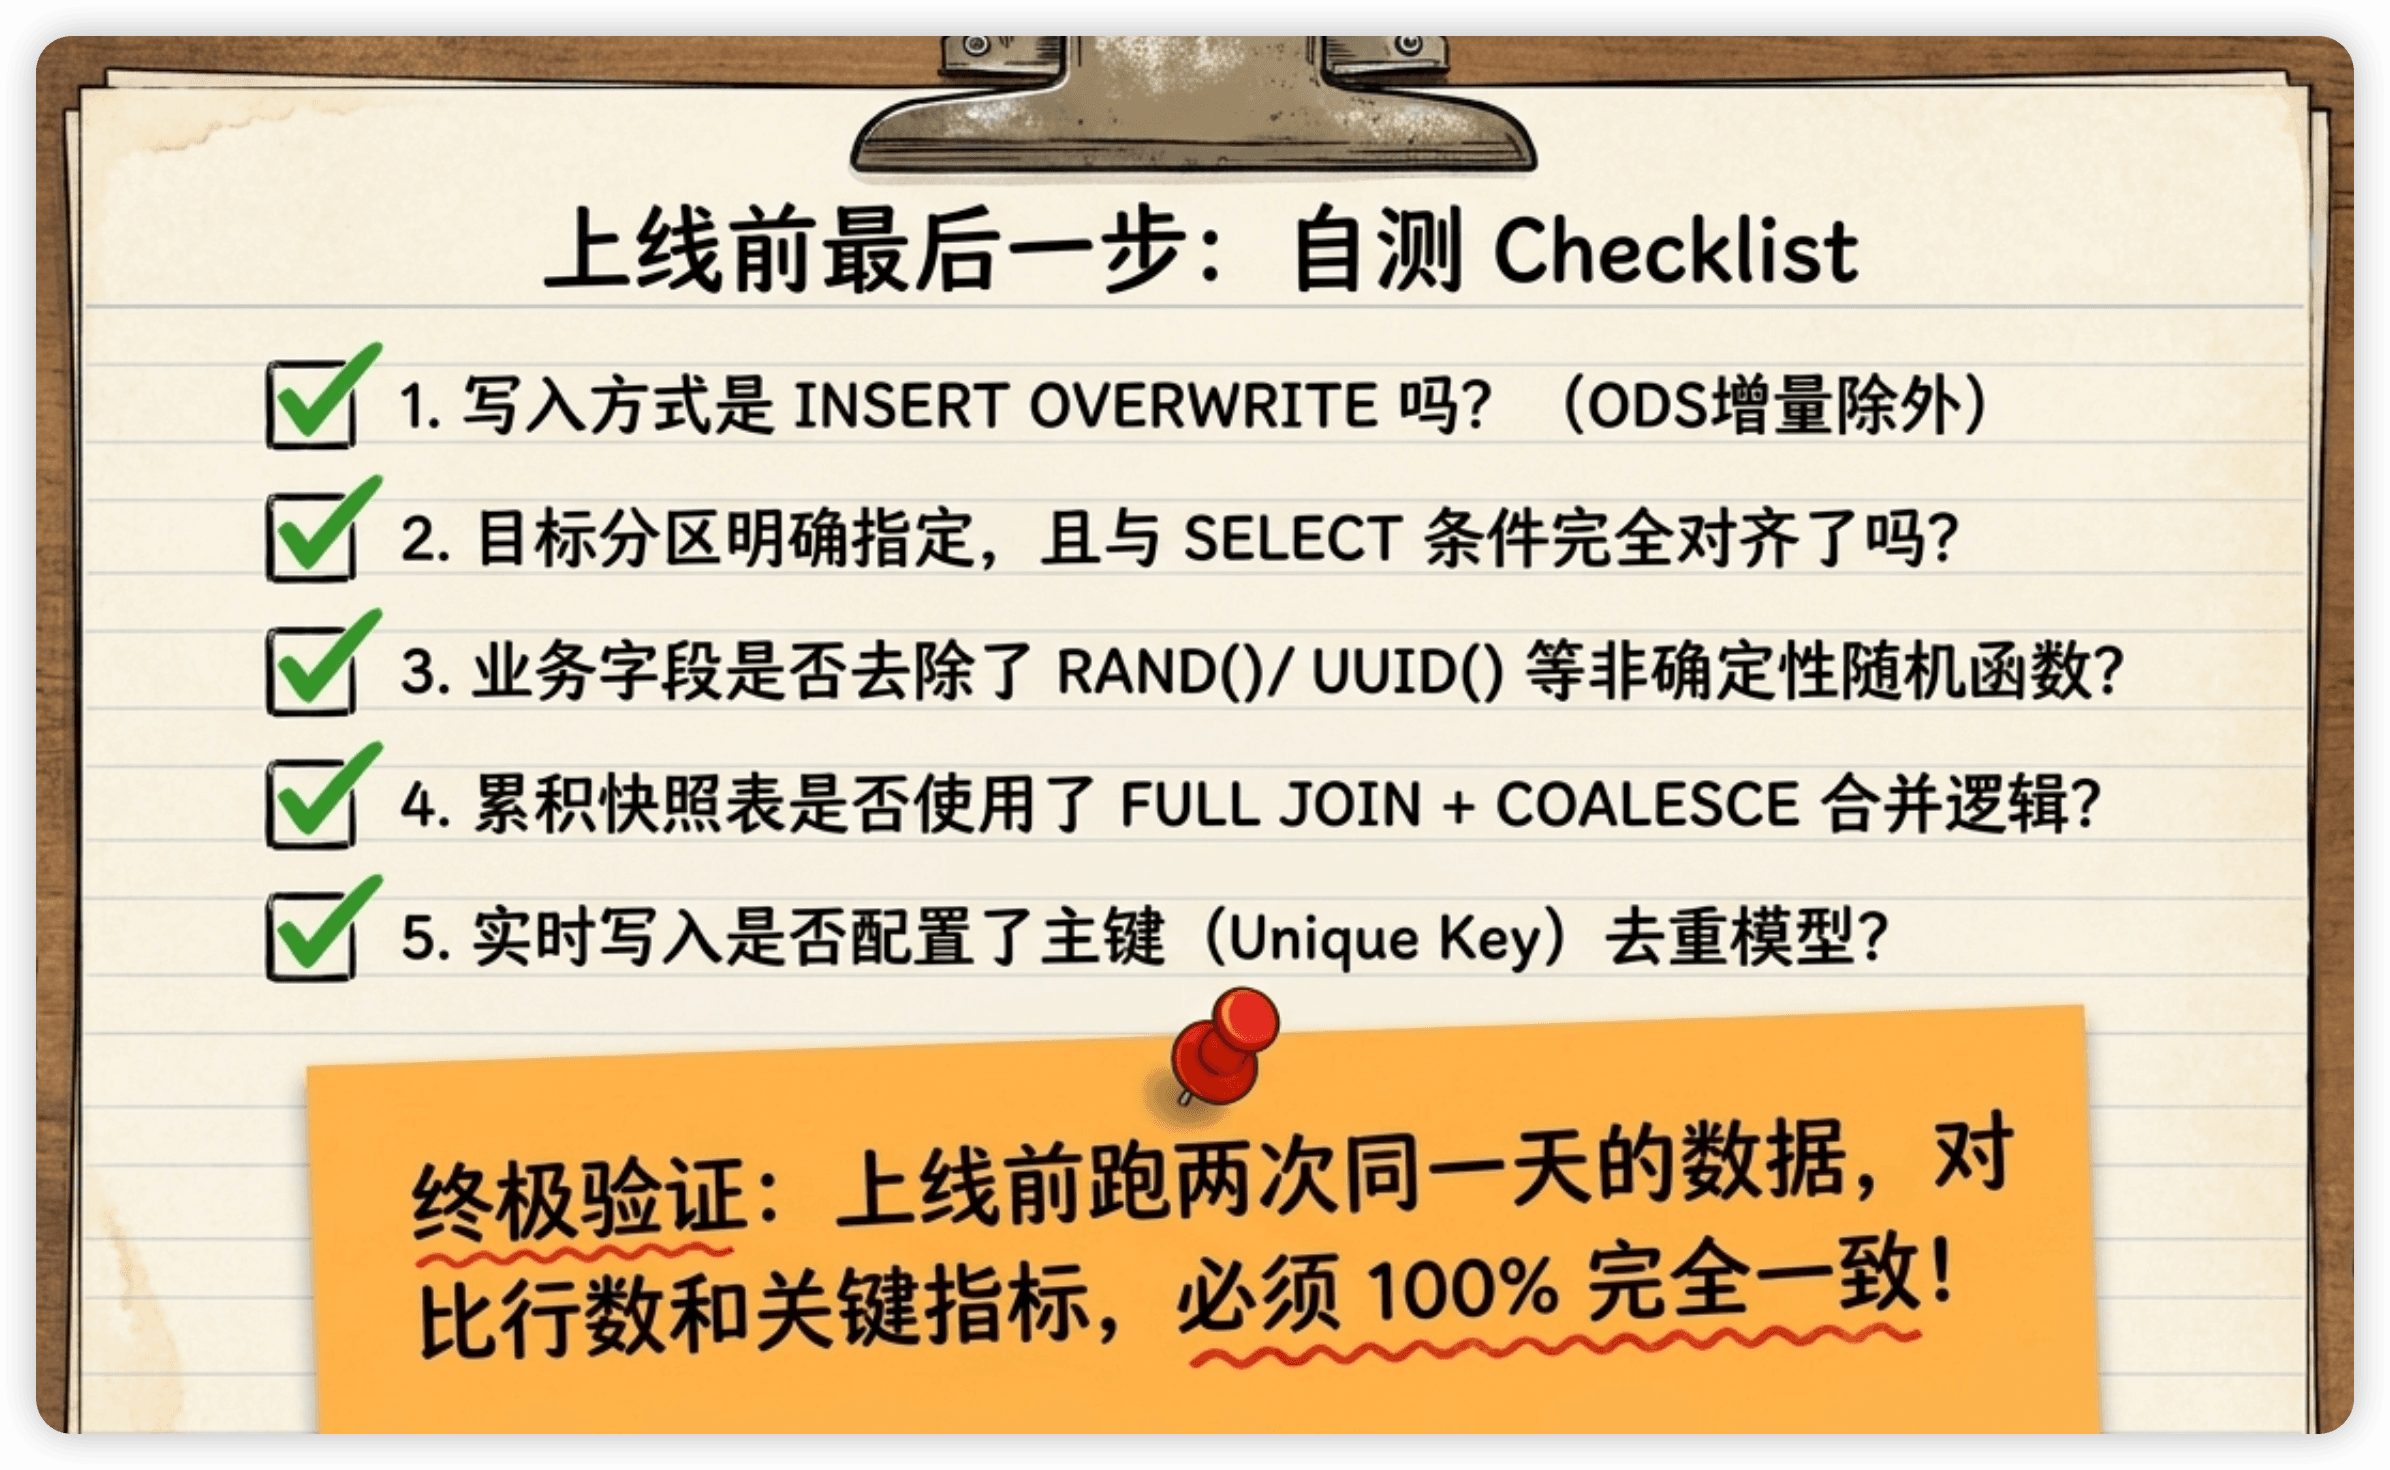
| 检查项 | 标准 |
|---|---|
| 写入方式 | INSERT OVERWRITE,禁止INSERT INTO(ODS除外) |
| 分区指定 | 明确指定目标分区 |
| SELECT范围 | WHERE条件和目标分区对齐 |
| 非确定性函数 | 不使用RAND()、UUID()做业务字段 |
| 累积表 | FULL JOIN + COALESCE合并逻辑 |
| 实时表 | 利用主键模型做去重 |
| 上线验证 | 跑两次,对比行数和关键指标,必须完全一致 |
最后一项是最关键的验证手段。每个新任务上线前,我都要求开发者跑两次同一天的数据,对比结果:
-- 跑第一次后记录结果
SELECT COUNT(*) AS row_cnt, SUM(pay_amount) AS total_pay
FROM dws_xxx WHERE dt = '2025-01-15';
-- 结果:1,000,000行,总金额 5,234,567.89

-- 跑第二次(重跑)后再查
SELECT COUNT(*) AS row_cnt, SUM(pay_amount) AS total_pay
FROM dws_xxx WHERE dt = '2025-01-15';
-- 结果必须是:1,000,000行,总金额 5,234,567.89
-- 如果不一样,说明幂等设计有问题
面试怎么答?
高分回答
「我们所有离线任务都用INSERT OVERWRITE加分区指定来保证幂等。这是入职第一天就会告诉新人的铁律。我自己入行时踩过坑——用INSERT INTO写了一个DWS任务,失败重试3次后数据翻了4倍。从那以后,我在Code Review时会重点检查写入方式,每个新任务上线前都必须跑两次验证幂等性。」
「对于累积快照型的表,用FULL OUTER JOIN + COALESCE做merge逻辑,整分区OVERWRITE,同样保证重跑结果一致。实时写入Doris用的是Unique Key模型,主键相同自动覆盖,天然幂等。」
追问防线
追问1:INSERT OVERWRITE执行过程中下游查到空数据怎么办?
对分区表来说,OVERWRITE只影响目标分区,其他分区的数据不受影响。下游如果正好查的是正在被OVERWRITE的分区,确实可能查到空数据或不完整数据。解决方案是通过调度依赖保证——下游任务在上游任务完成之后才触发,不会在写入过程中查询。
对无分区的全量表,用临时表+RENAME做原子替换。
追问2:Spark的SaveMode.Overwrite和INSERT OVERWRITE有什么区别?
Spark的SaveMode.Overwrite比较"激进"——如果不指定分区,它会覆盖整张表的所有分区。INSERT OVERWRITE TABLE xxx PARTITION(dt='2025-01-15')只覆盖指定分区。这是一个经典的坑:有人用Spark写数据时忘了指定分区,SaveMode.Overwrite把全表所有分区都清了,丢了一年的数据。
所以用Spark写分区表时,一定要指定partitionBy和分区条件:df.write.mode("overwrite").partitionBy("dt").saveAsTable("xxx"),并且设置spark.sql.sources.partitionOverwriteMode=dynamic。
追问3:数据回刷多天怎么保证幂等?
回刷和日常调度没有本质区别——每天的分区各自OVERWRITE就行。关键是保证回刷脚本和日常调度用的是同一份SQL逻辑。我见过有人为了回刷专门写了一个脚本,逻辑和日常调度不一样,导致回刷出来的数据和正常跑出来的不一致。
我们的做法是调度脚本本身就支持传入日期参数——日常调度传当天日期,回刷时传历史日期,同一份代码两种用法。
总结
- 幂等 = 跑1次和跑N次结果一样,是数仓工程化的基本要求
- 第一铁律:INSERT OVERWRITE + 指定分区,禁止INSERT INTO(ODS增量除外)
- 全量表:全表OVERWRITE或临时表+RENAME原子替换
- 累积快照表:FULL JOIN + COALESCE 合并逻辑
- 实时写入:利用OLAP引擎的主键模型自动去重
- 上线验证:跑两次对比结果,行数和关键指标必须完全一致
- 避免陷阱:不用RAND()/UUID()做业务字段,不依赖CURRENT_TIMESTAMP做业务逻辑
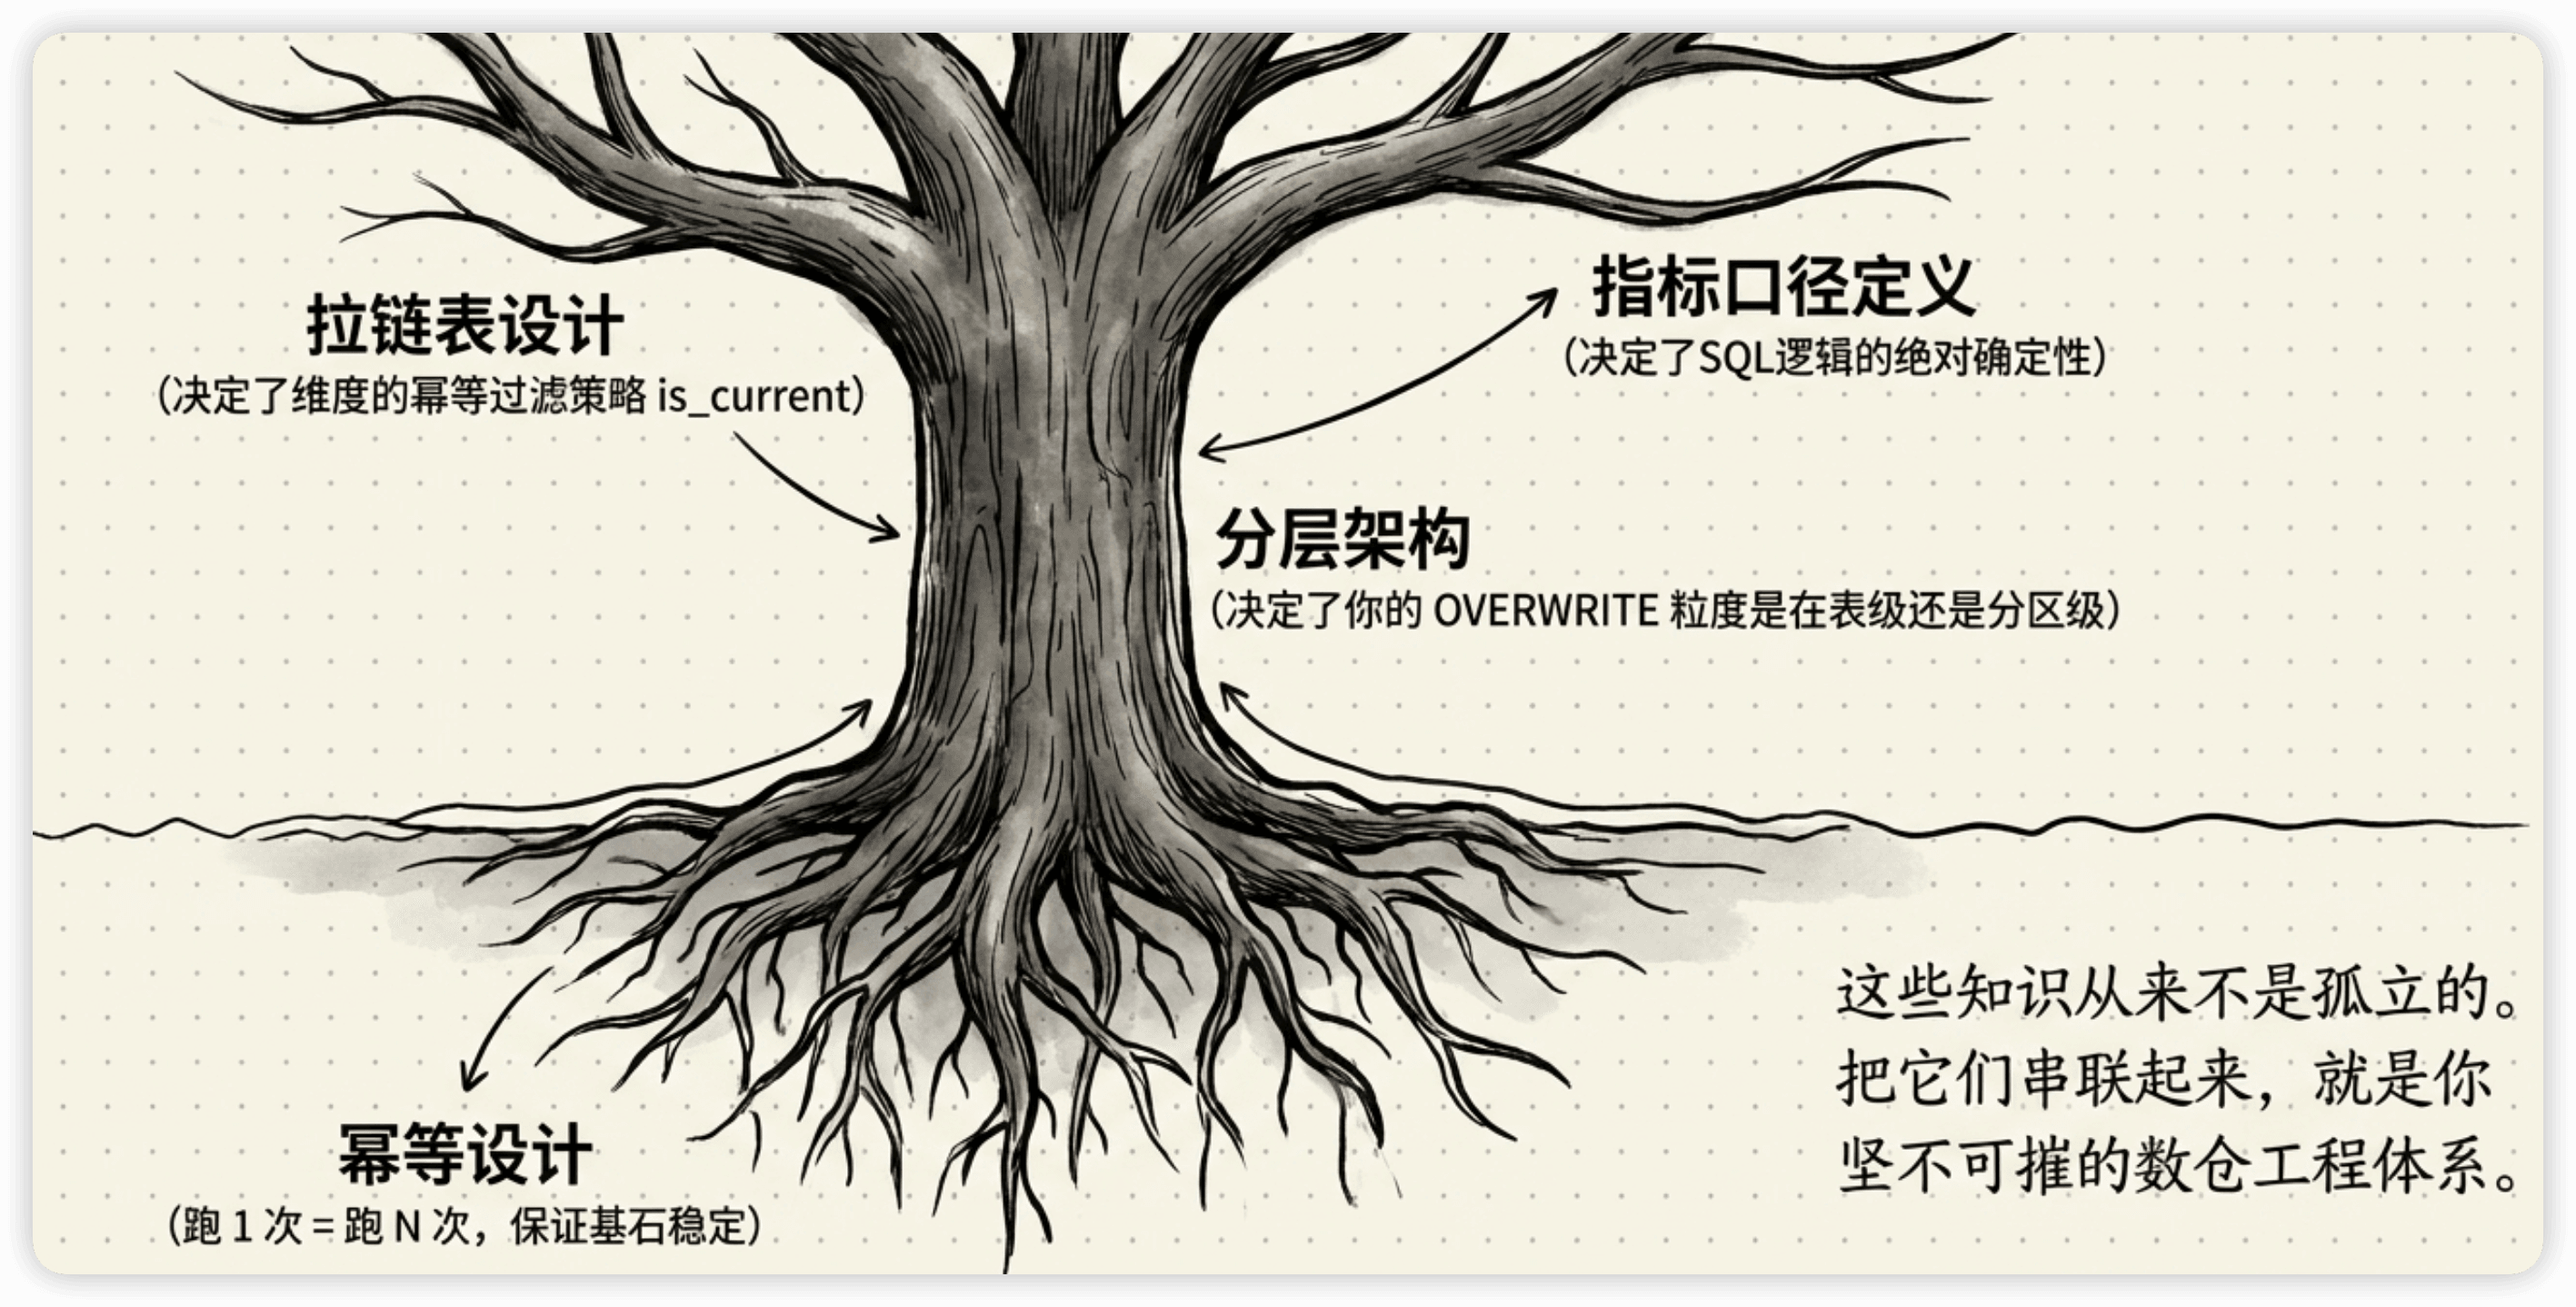
数仓建模系列到DAY 15,从分层架构到幂等设计,覆盖了数仓建设从设计到运维的完整链条。这些知识不是孤立的——分层决定了你的OVERWRITE粒度(按分区),拉链表决定了维度的幂等策略(is_current过滤),指标口径决定了SQL的确定性。把它们串联起来,就是一个完整的数仓工程体系。