数据倾斜
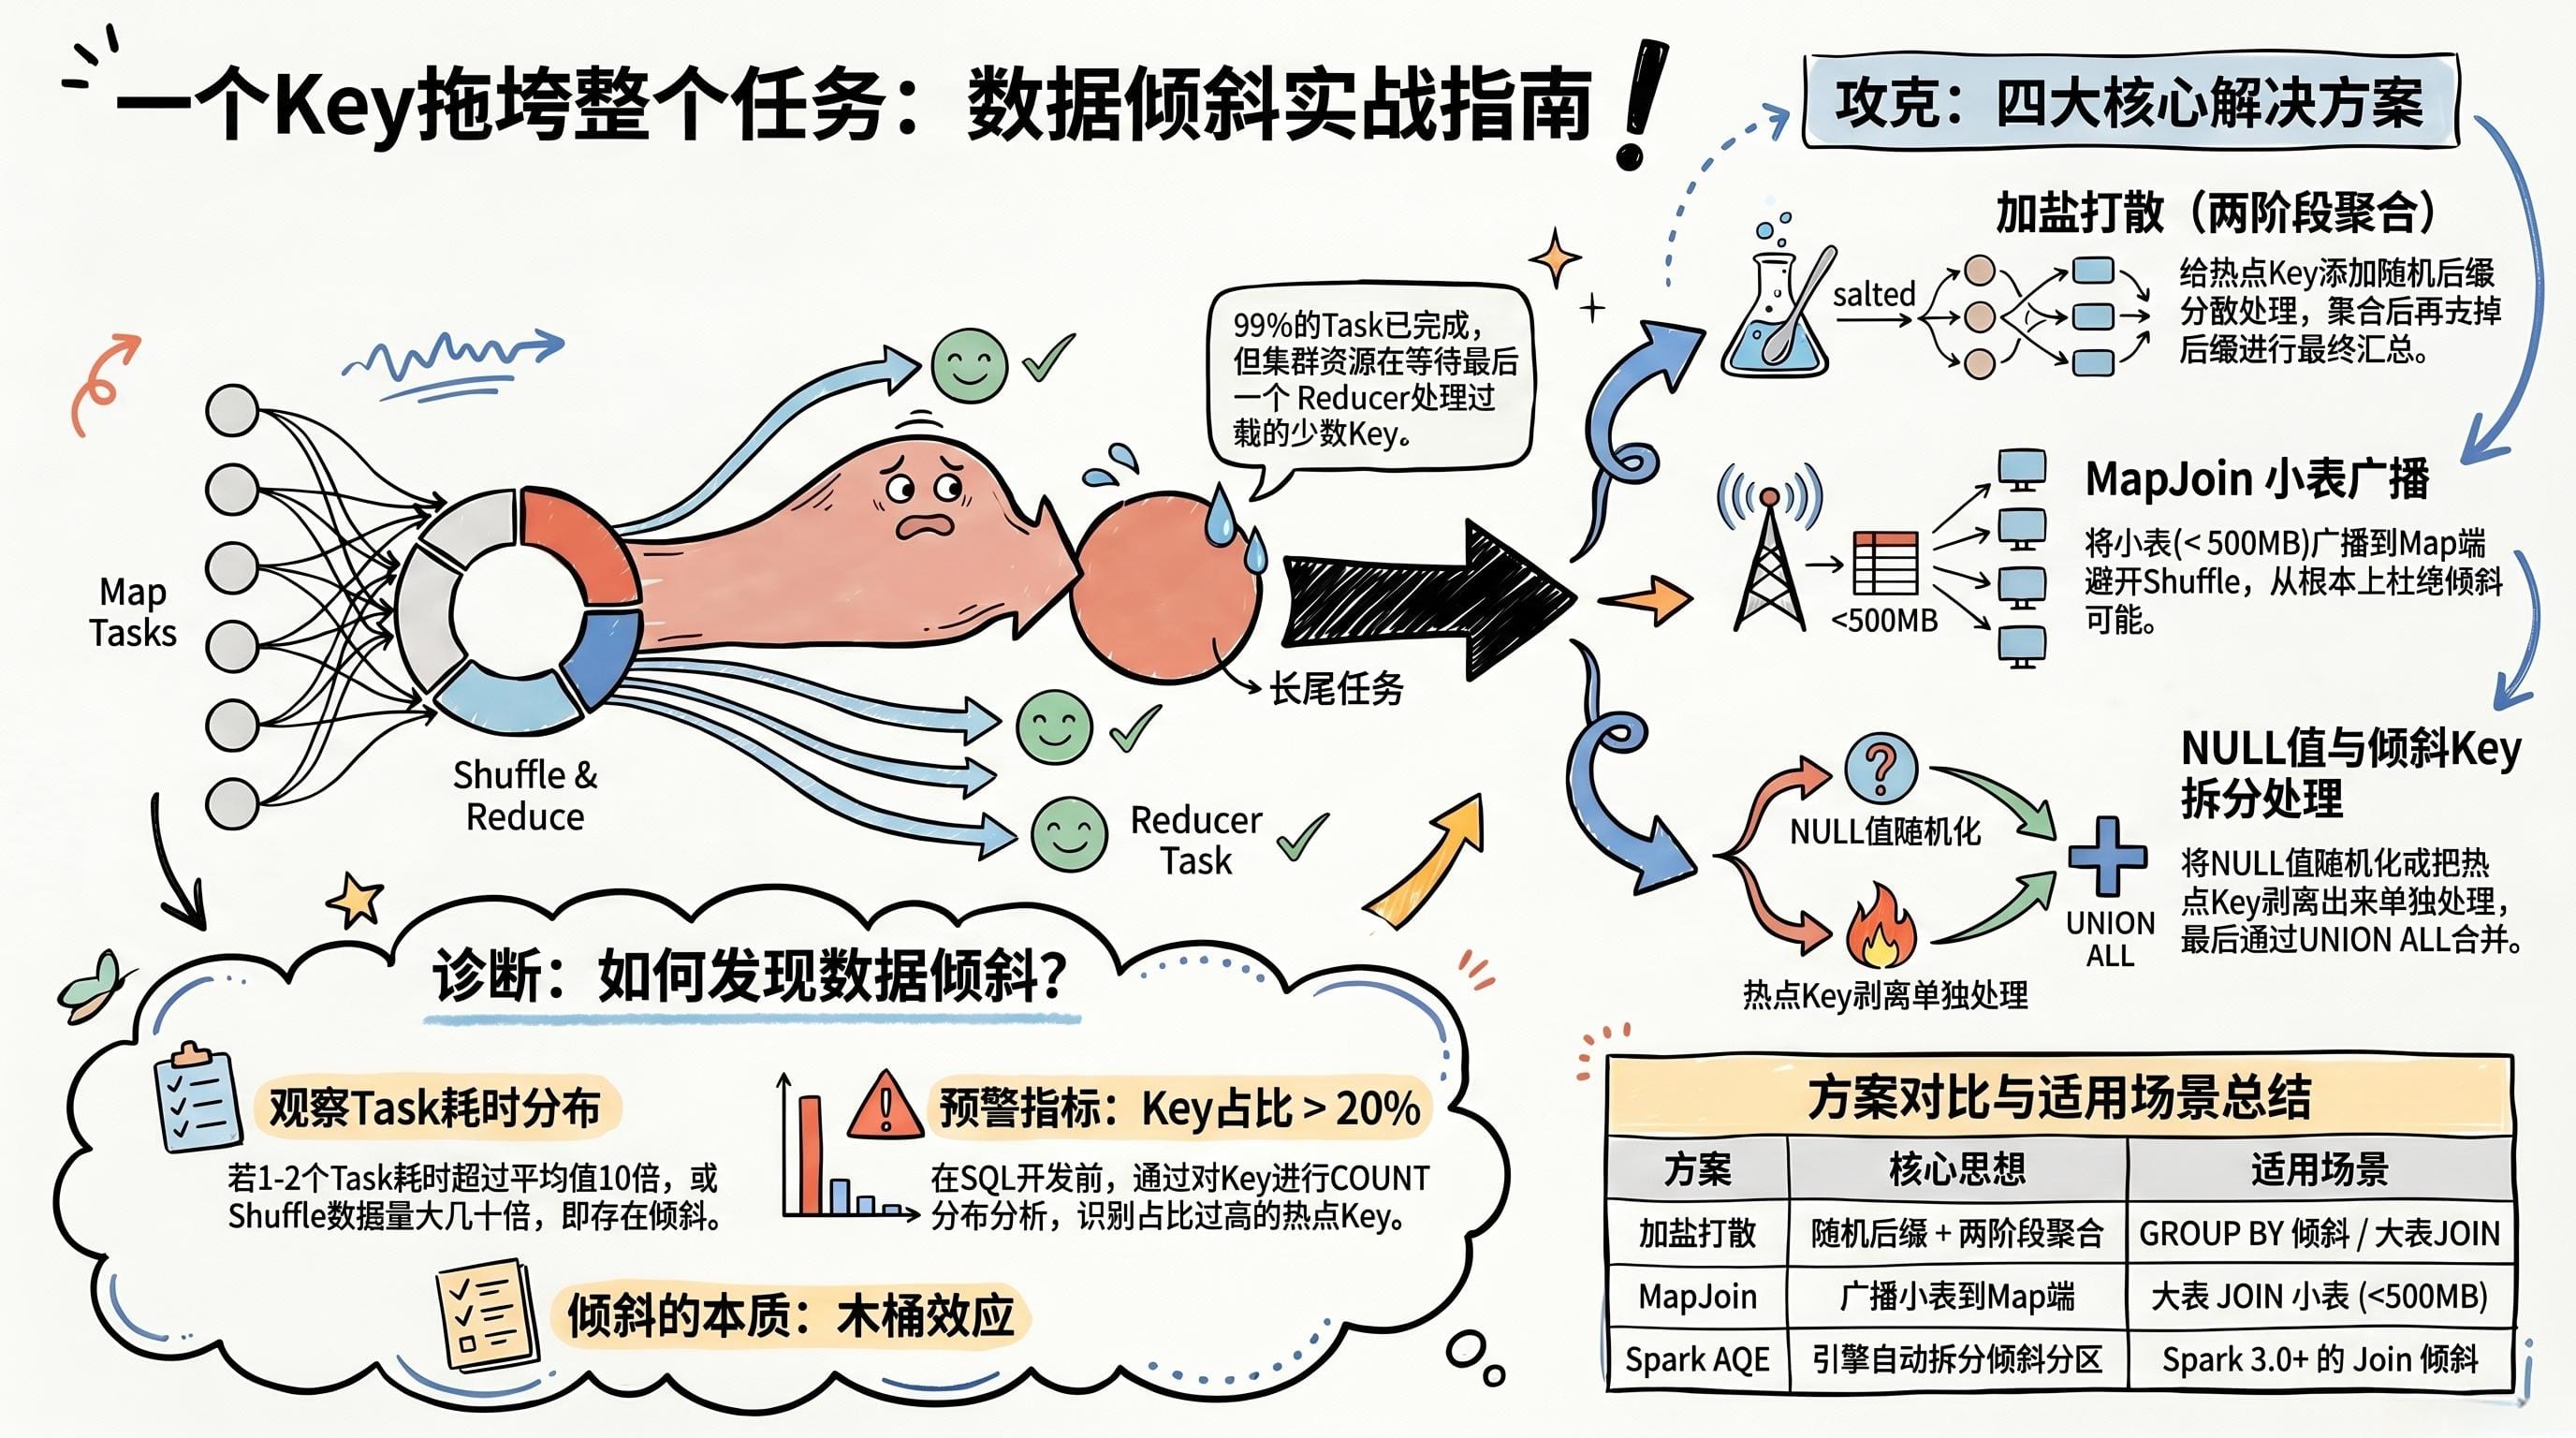
你有没有遇到过这种情况:一个ETL任务,大部分Task在3分钟内跑完了,但有1-2个Task卡了40分钟。整个任务的耗时取决于最慢的那个Task——其他99个Task早就结束了,大家都在等最后一个。
这就是数据倾斜。
数据倾斜不是一个理论问题,而是数仓开发中最常遇到的性能问题之一。我在4家公司都遇到过,解决方法也积累了一整套。这篇文章我把倾斜的原理、发现方法、4种解决方案讲透,配上完整的SQL和真实案例。
倾斜的本质:一句话说清楚
大部分数据集中在少数几个Key上,导致Shuffle之后个别Reducer处理的数据量远超其他Reducer。
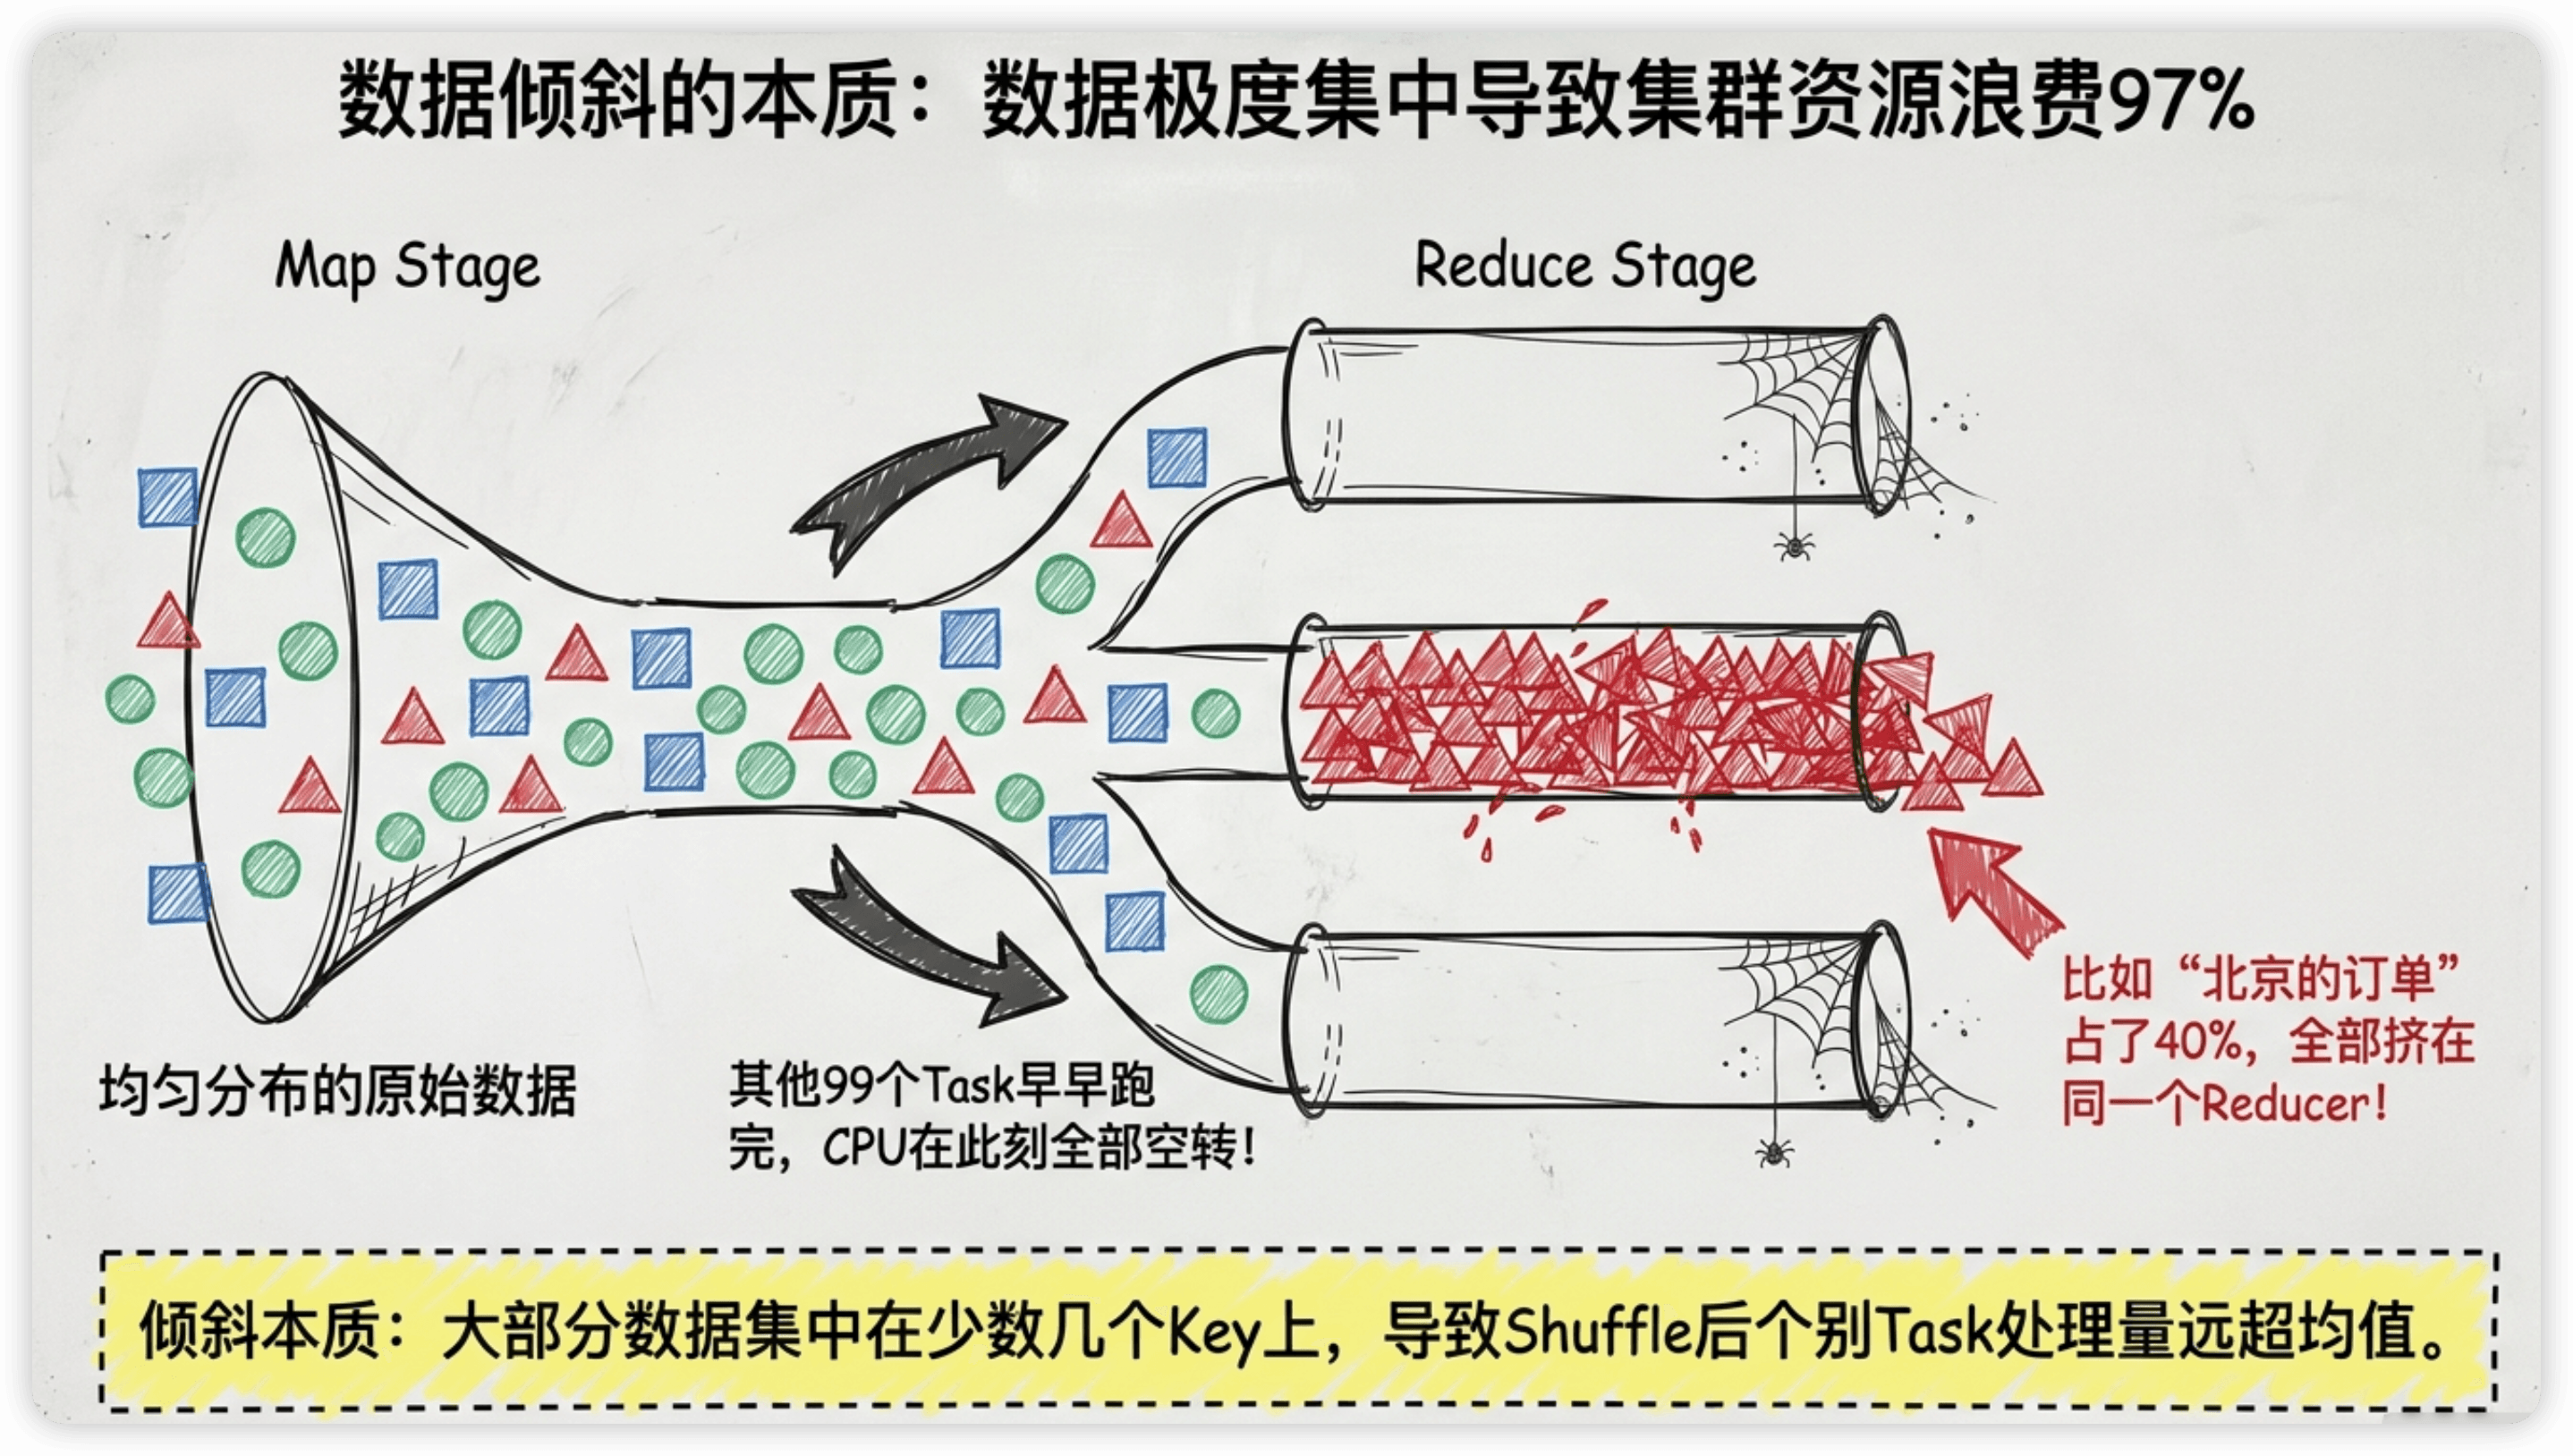
MapReduce/Spark/Flink的分布式计算模型,核心是把数据按Key分发到不同的Reducer/Task去并行处理。如果数据在Key上的分布严重不均匀——比如北京的订单占了总量的40%——那处理北京的那个Task数据量是其他城市的几十倍,自然就慢了。
正常分布:每个Task处理约100万条数据,3分钟完成
  Task-0 (北京):    100万条 → 3分钟 ✅
  Task-1 (上海):     90万条 → 3分钟 ✅
  Task-2 (广州):     80万条 → 2分钟 ✅
  ...

倾斜分布:北京的Task数据量是其他的40倍
  Task-0 (北京):   4000万条 → 40分钟 ❌ ← 整个任务卡在这里
  Task-1 (上海):     90万条 → 3分钟 ✅
  Task-2 (广州):     80万条 → 2分钟 ✅
  ...
其他99个Task早就完成了,CPU空闲着在等。集群资源白白浪费了97%。
怎么发现倾斜?
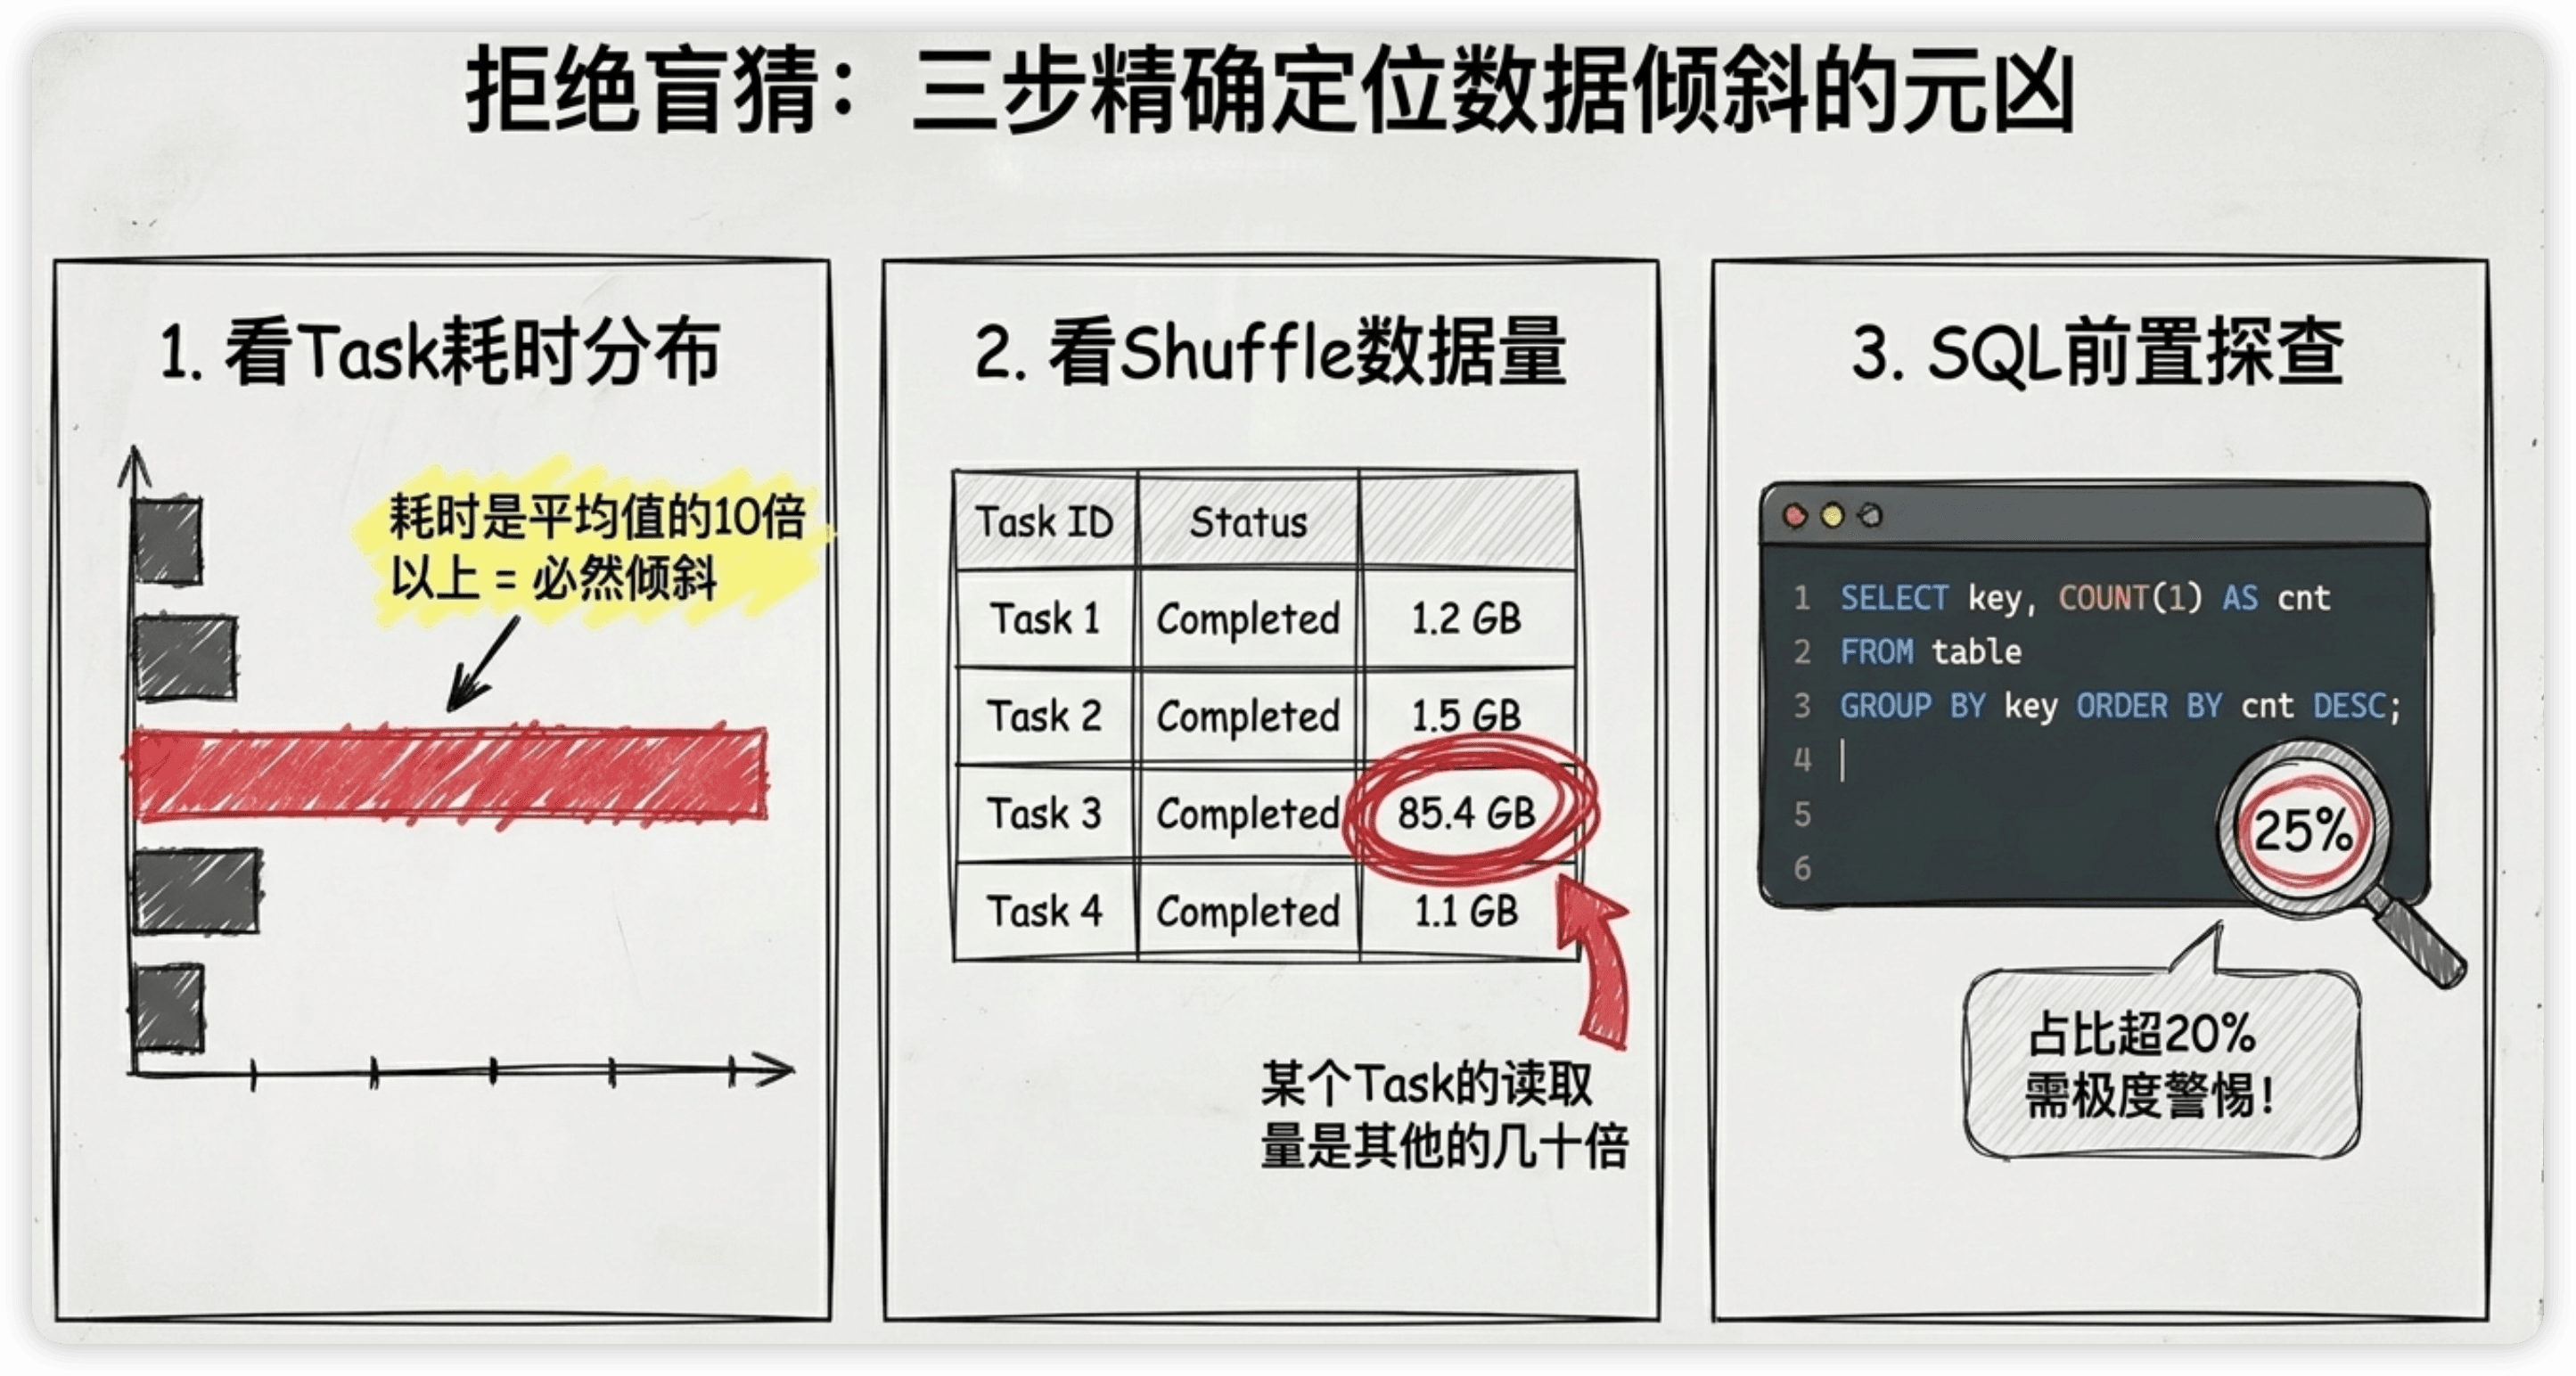
方法一:看Task耗时分布
在Spark/Hive的Web UI里,找到对应的Stage,看每个Task的执行时间和处理数据量。
如果大部分Task在几分钟内完成,但有1-2个Task耗时是平均值的10倍以上,基本就是倾斜了。
方法二:看Shuffle数据量分布
Spark Web UI的Stage详情里有每个Task的Shuffle Read Size。正常情况各Task应该差不多,如果某个Task的Shuffle Read是其他的几十倍,就是倾斜Key。
方法三:SQL分析Key分布
在写SQL之前,先分析一下Key的分布:
-- 分析GROUP BY / JOIN 键的数据分布
SELECT
    city,
    COUNT(*) AS cnt,
    ROUND(COUNT(*) * 100.0 / SUM(COUNT(*)) OVER(), 2) AS pct
FROM fact_order
WHERE dt = '2025-01-15'
GROUP BY city
ORDER BY cnt DESC
LIMIT 20;

-- 结果可能是:
-- 北京   4000万  40%  ← 热点Key!
-- 上海   2000万  20%
-- 广州    500万   5%
-- ...
-- 其他300个城市各几万条
看到某个Key占比超过20%,就要警惕倾斜风险了。
三种常见倾斜场景
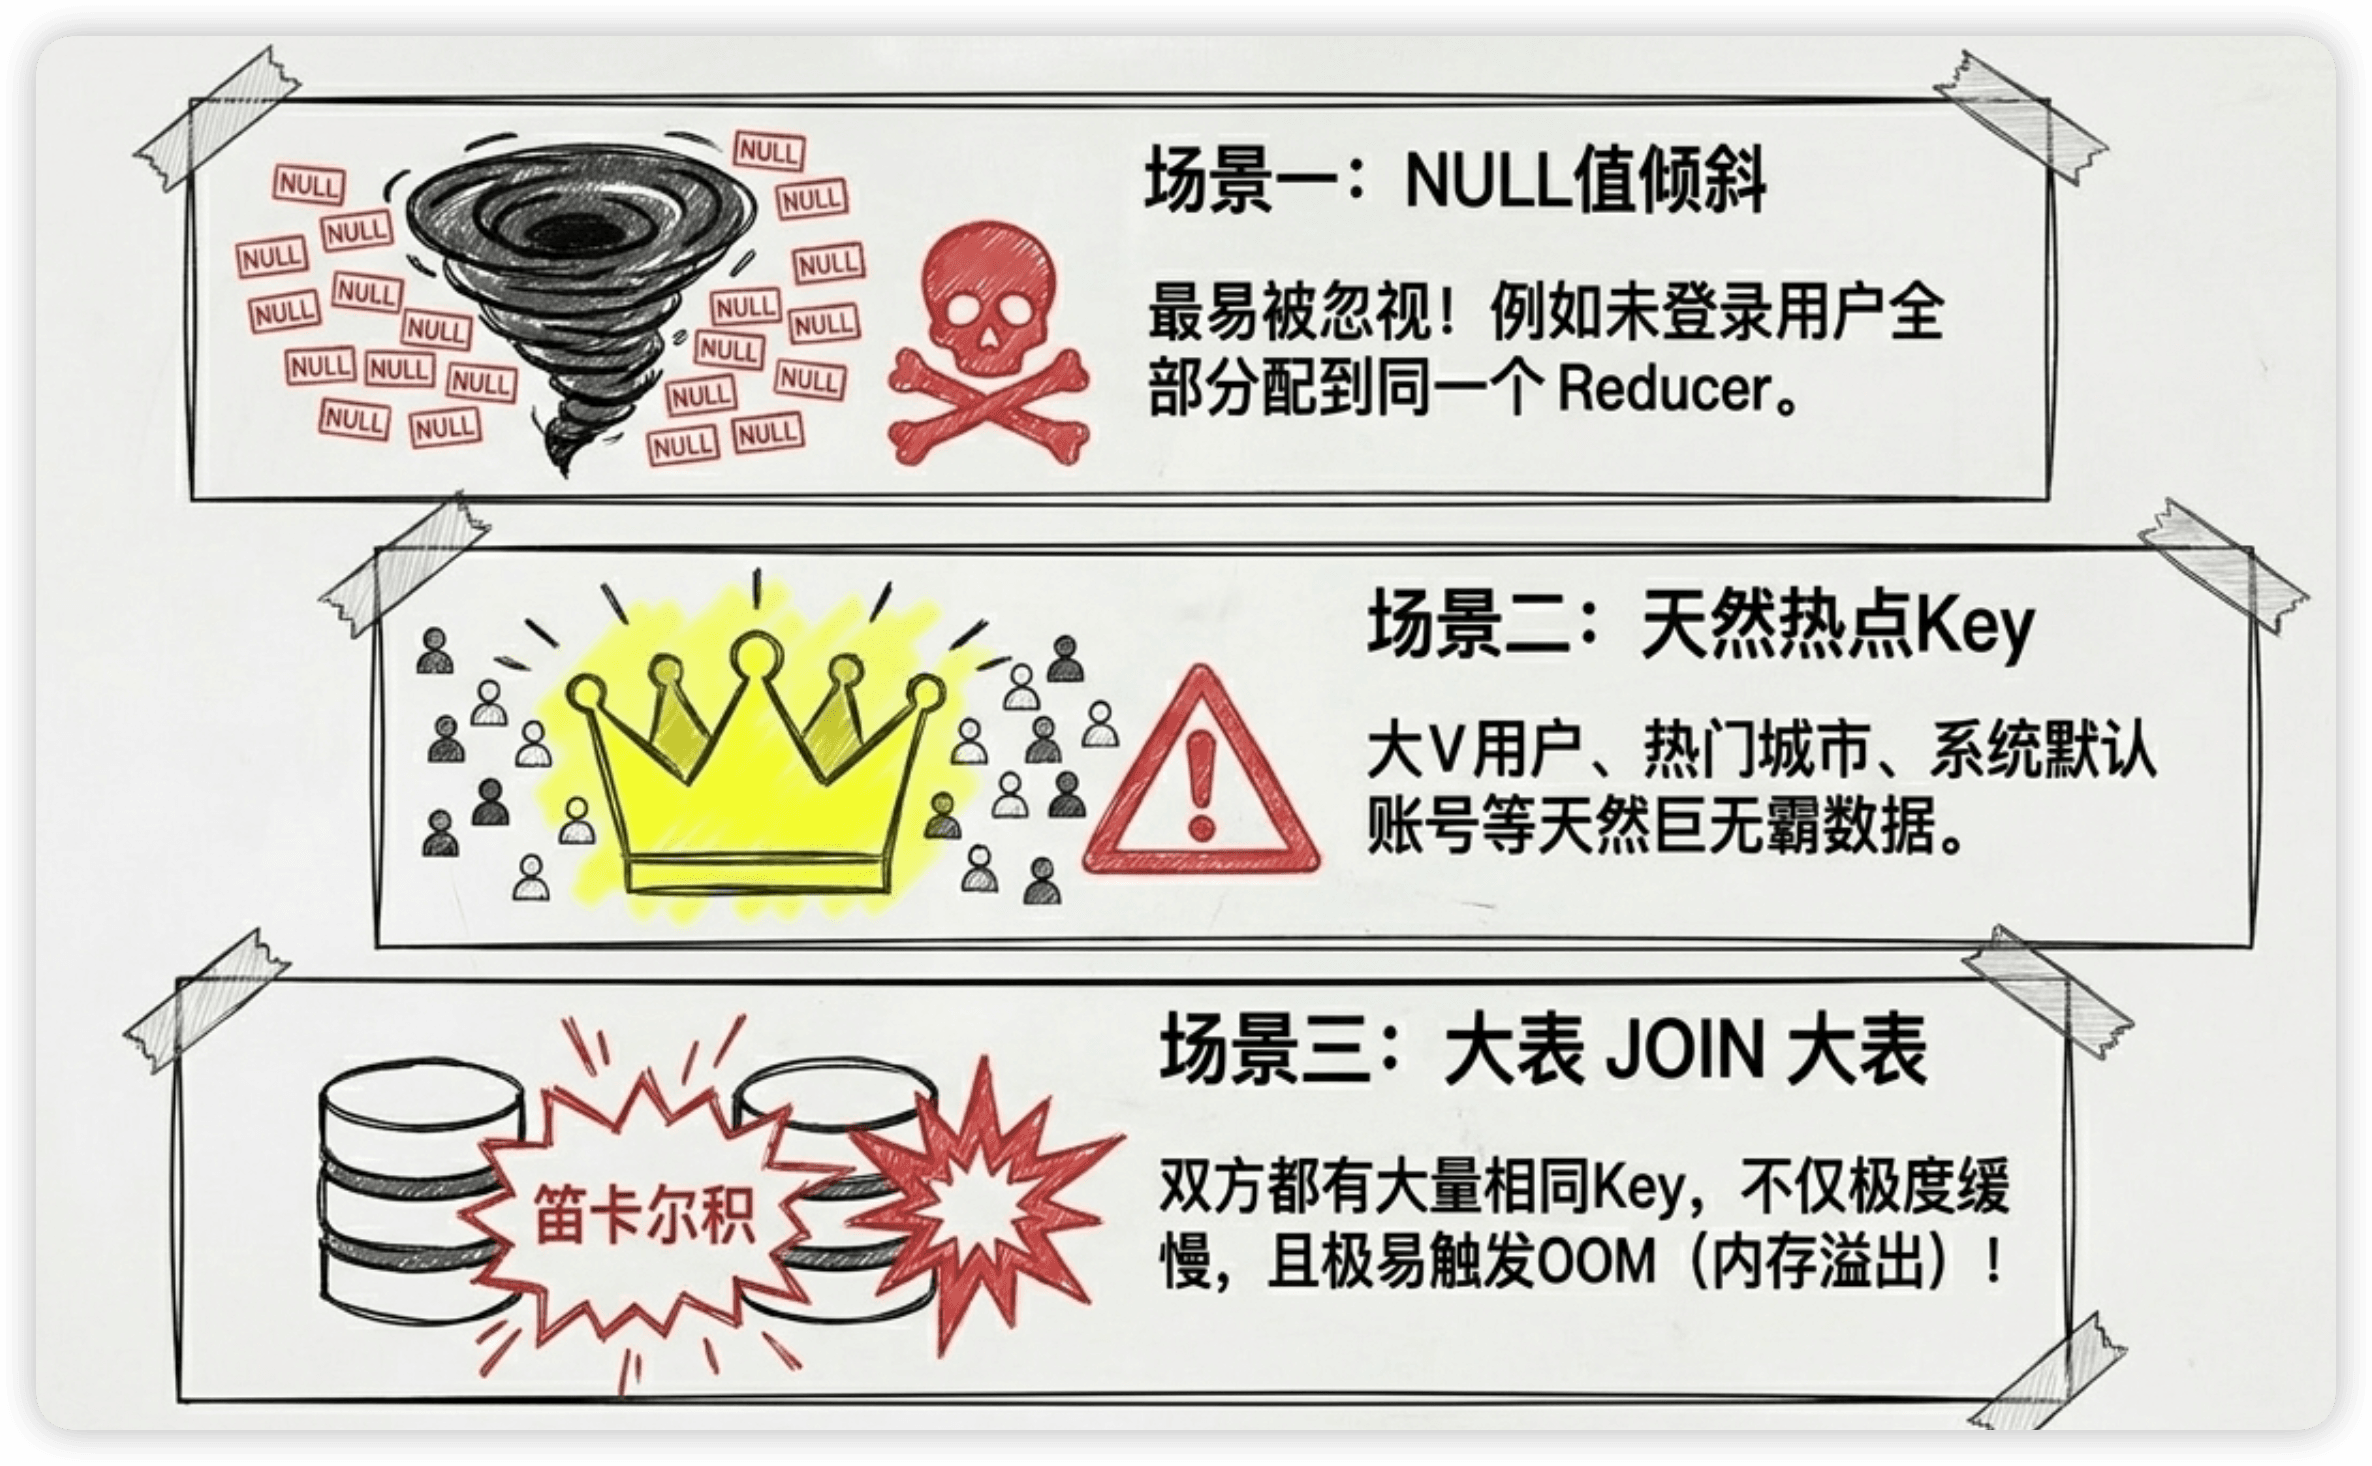
场景一:NULL值倾斜
这是最容易被忽视的倾斜场景。事实表的某个外键有大量NULL(比如未登录用户没有user_id),JOIN的时候所有NULL被分到同一个Reducer。
-- 表A有1亿行,其中user_id为NULL的有1500万行
-- LEFT JOIN时,1500万条NULL全部分到一个Reducer处理
SELECT a.*, b.user_name
FROM fact_event a
LEFT JOIN dim_user b ON a.user_id = b.user_id;
-- NULL的那个Reducer处理1500万行,其他Reducer各处理几十万行
我在短剧出海公司的埋点数据里遇到过这个问题。未登录用户的事件大约占总事件的15%,全部user_id为NULL。JOIN用户维度表的时候,NULL那个Task跑了30多分钟,其他Task都在5分钟内完成。
场景二:热点Key倾斜
某些Key的数据量天然就很大——大V用户、系统账号、默认分类、热门城市。
-- GROUP BY city统计GMV
-- 北京 4000万条、上海 2000万条、其他城市各几万条
SELECT city, SUM(amount) AS gmv
FROM fact_order
GROUP BY city;
-- 北京的Reducer要处理4000万条,其他Reducer只处理几万条
场景三:大表JOIN大表的笛卡尔积倾斜
两张大表JOIN,某些Key在两边都有大量数据,JOIN之后产生笛卡尔积:
表A中 user_id=1001 有 1000 条记录
表B中 user_id=1001 有 500 条记录
JOIN之后:1000 × 500 = 50万条(这一个Key就产生了50万行)
而其他Key可能JOIN后只有1-2行
这种情况不仅倾斜,还容易OOM。
四种解决方案
方案一:NULL值单独处理
思路: 把NULL值用随机数打散,避免集中到一个Reducer。
-- 方法A:COALESCE随机打散
SELECT a.*, b.user_name
FROM fact_event a
LEFT JOIN dim_user b
ON COALESCE(a.user_id, CONCAT('null_', CAST(RAND() * 1000 AS INT))) = b.user_id;
-- NULL被打散成null_0, null_1, ..., null_999,分布到1000个Reducer
-- 因为dim_user里没有这些Key,LEFT JOIN结果还是NULL,逻辑正确

-- 方法B:拆成两部分(更清晰)
-- Part1: user_id不为NULL → 正常JOIN
SELECT a.*, b.user_name
FROM fact_event a
JOIN dim_user b ON a.user_id = b.user_id
WHERE a.user_id IS NOT NULL

UNION ALL

-- Part2: user_id为NULL → 不JOIN,维度字段直接设默认值
SELECT a.*, '未登录用户' AS user_name
FROM fact_event a
WHERE a.user_id IS NULL;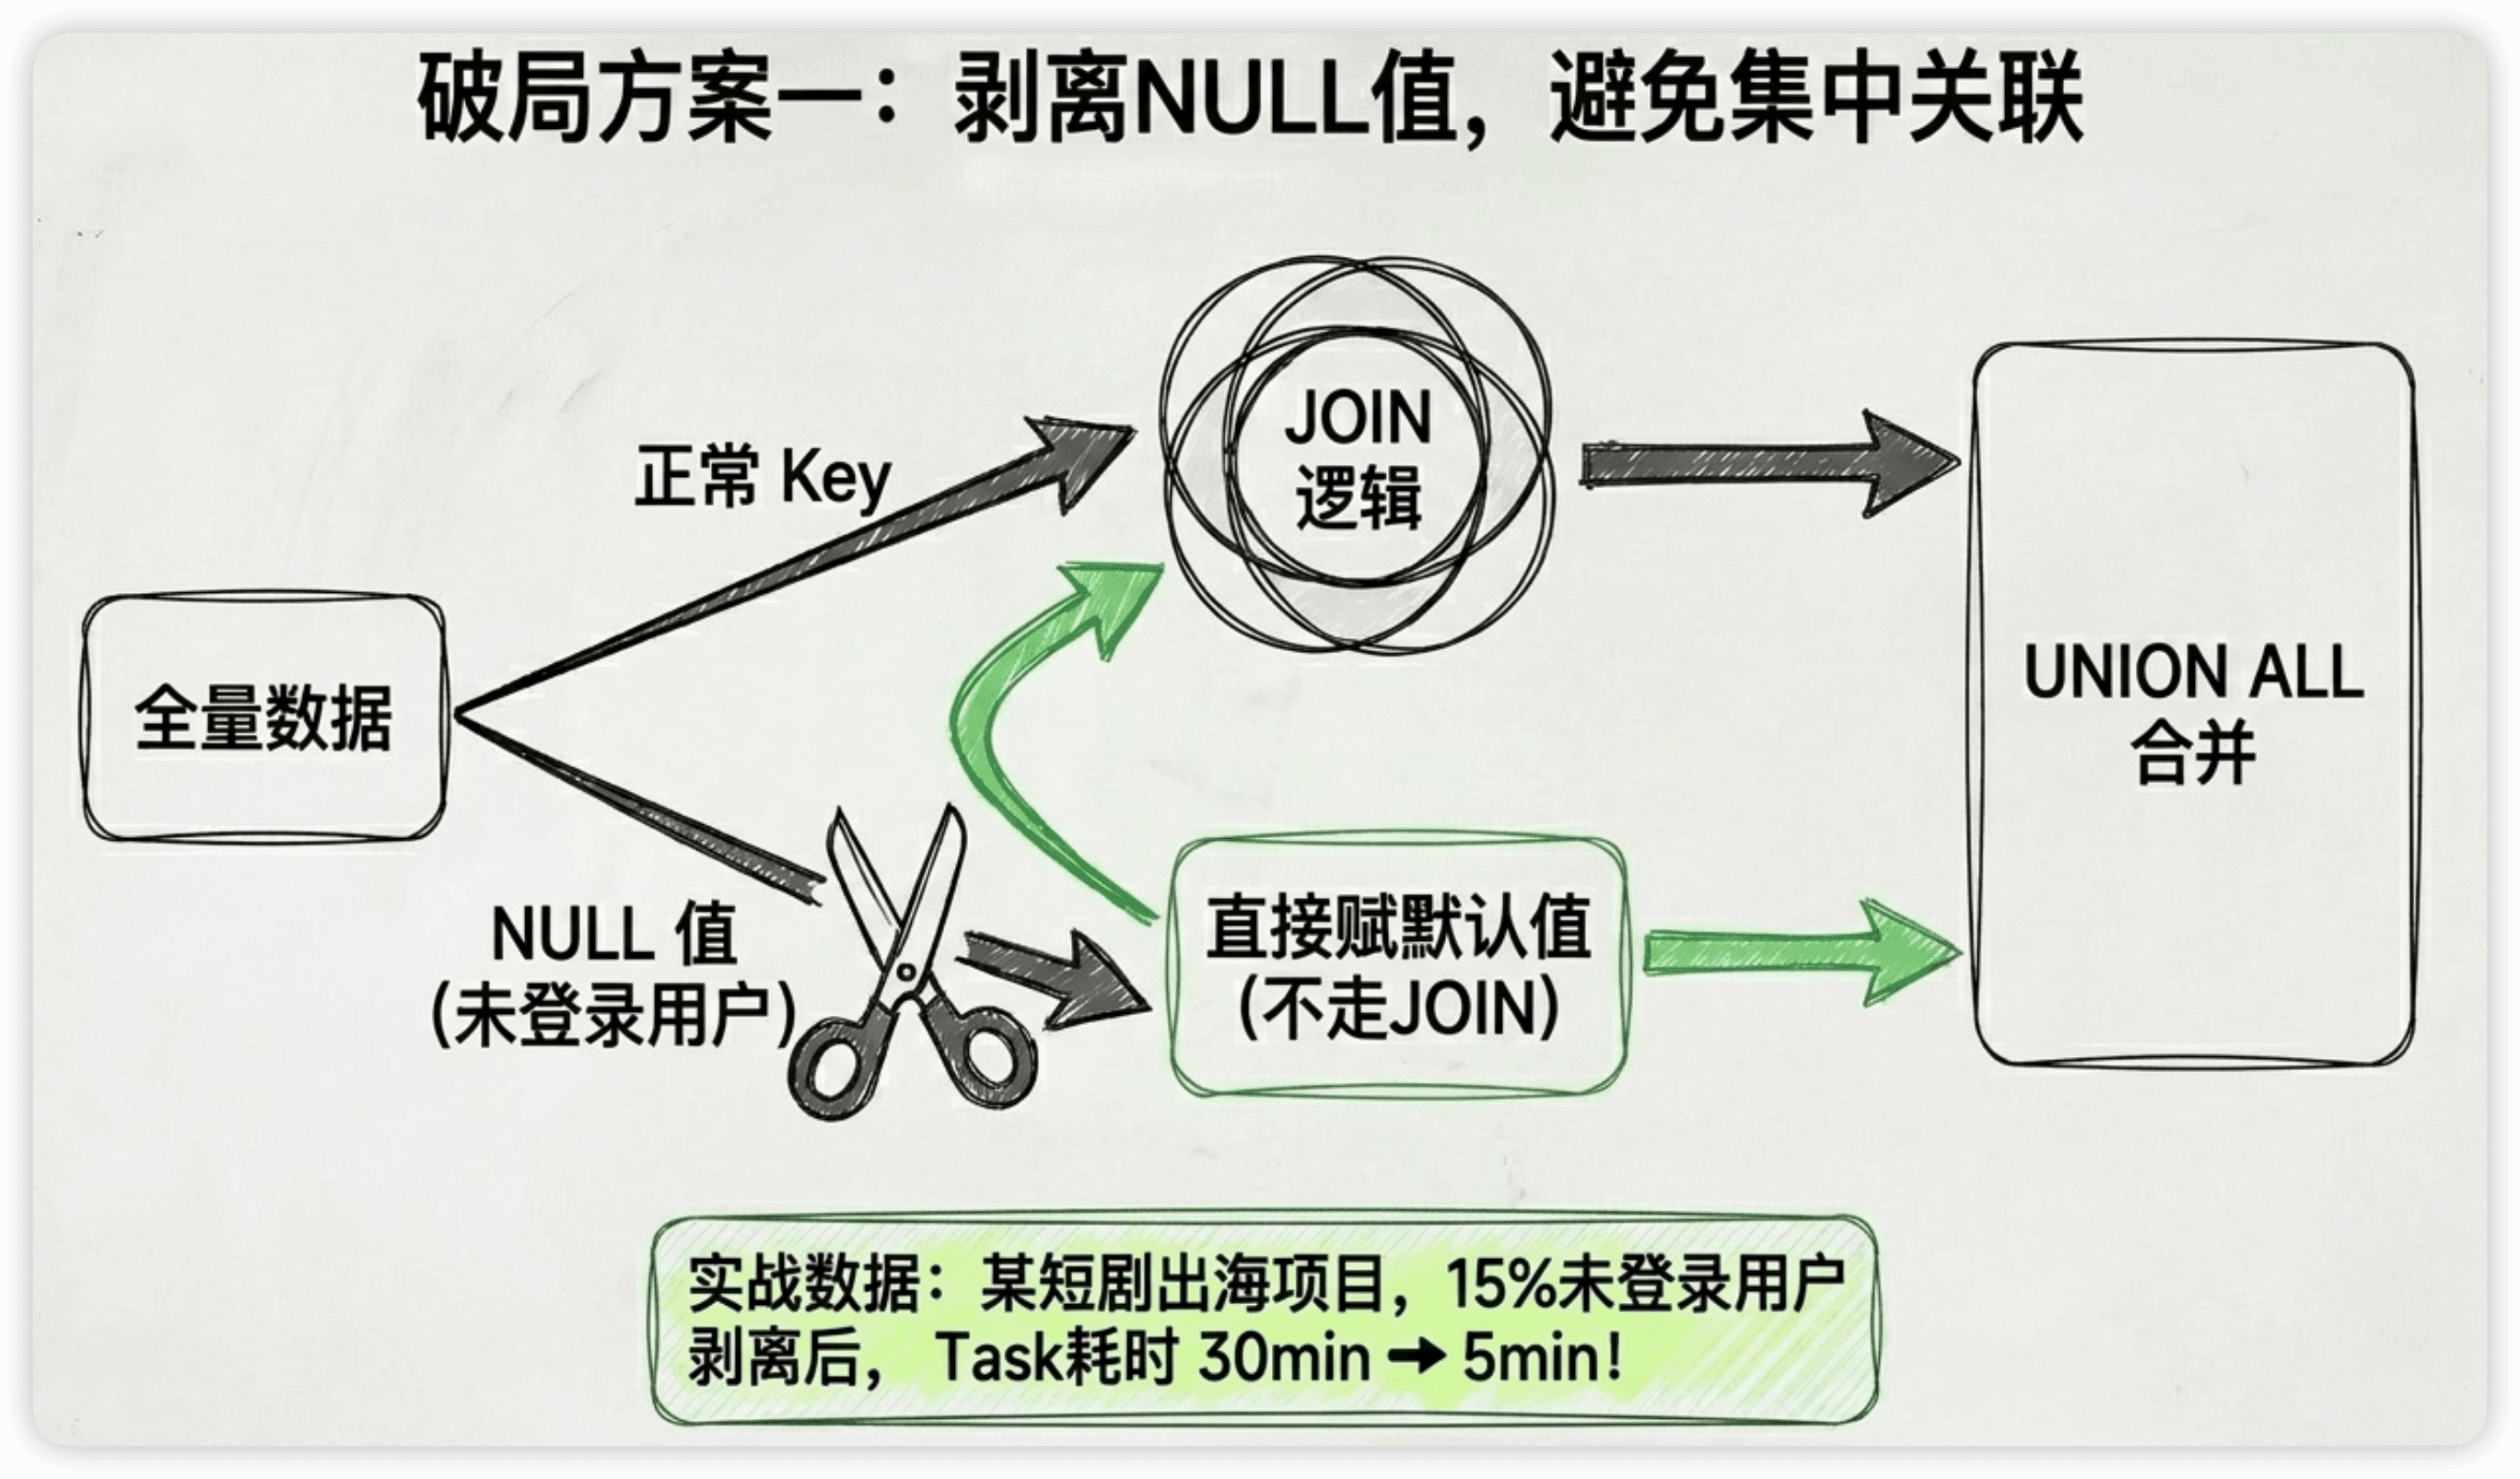
方法B更清晰、性能也更好——NULL的部分压根不走JOIN了。
方案二:MapJoin小表广播
思路: 如果JOIN的一方是小表(< 500MB),直接把小表广播到每个Map端,在Map阶段完成JOIN,不走Shuffle。没有Shuffle就没有倾斜。
-- Hive设置
SET hive.auto.convert.join=true;
SET hive.mapjoin.smalltable.filesize=500000000;  -- 500MB以内的表自动MapJoin

-- 小表会被加载到内存,不走Shuffle
SELECT /*+ MAPJOIN(dim) */ f.*, d.user_name, d.city
FROM fact_order f
JOIN dim_user d ON f.user_id = d.user_id;
// Spark设置
spark.conf.set("spark.sql.autoBroadcastJoinThreshold", 500 * 1024 * 1024) // 500MB
// 或者手动广播
import org.apache.spark.sql.functions.broadcast
val result = factDF.join(broadcast(dimDF), "user_id")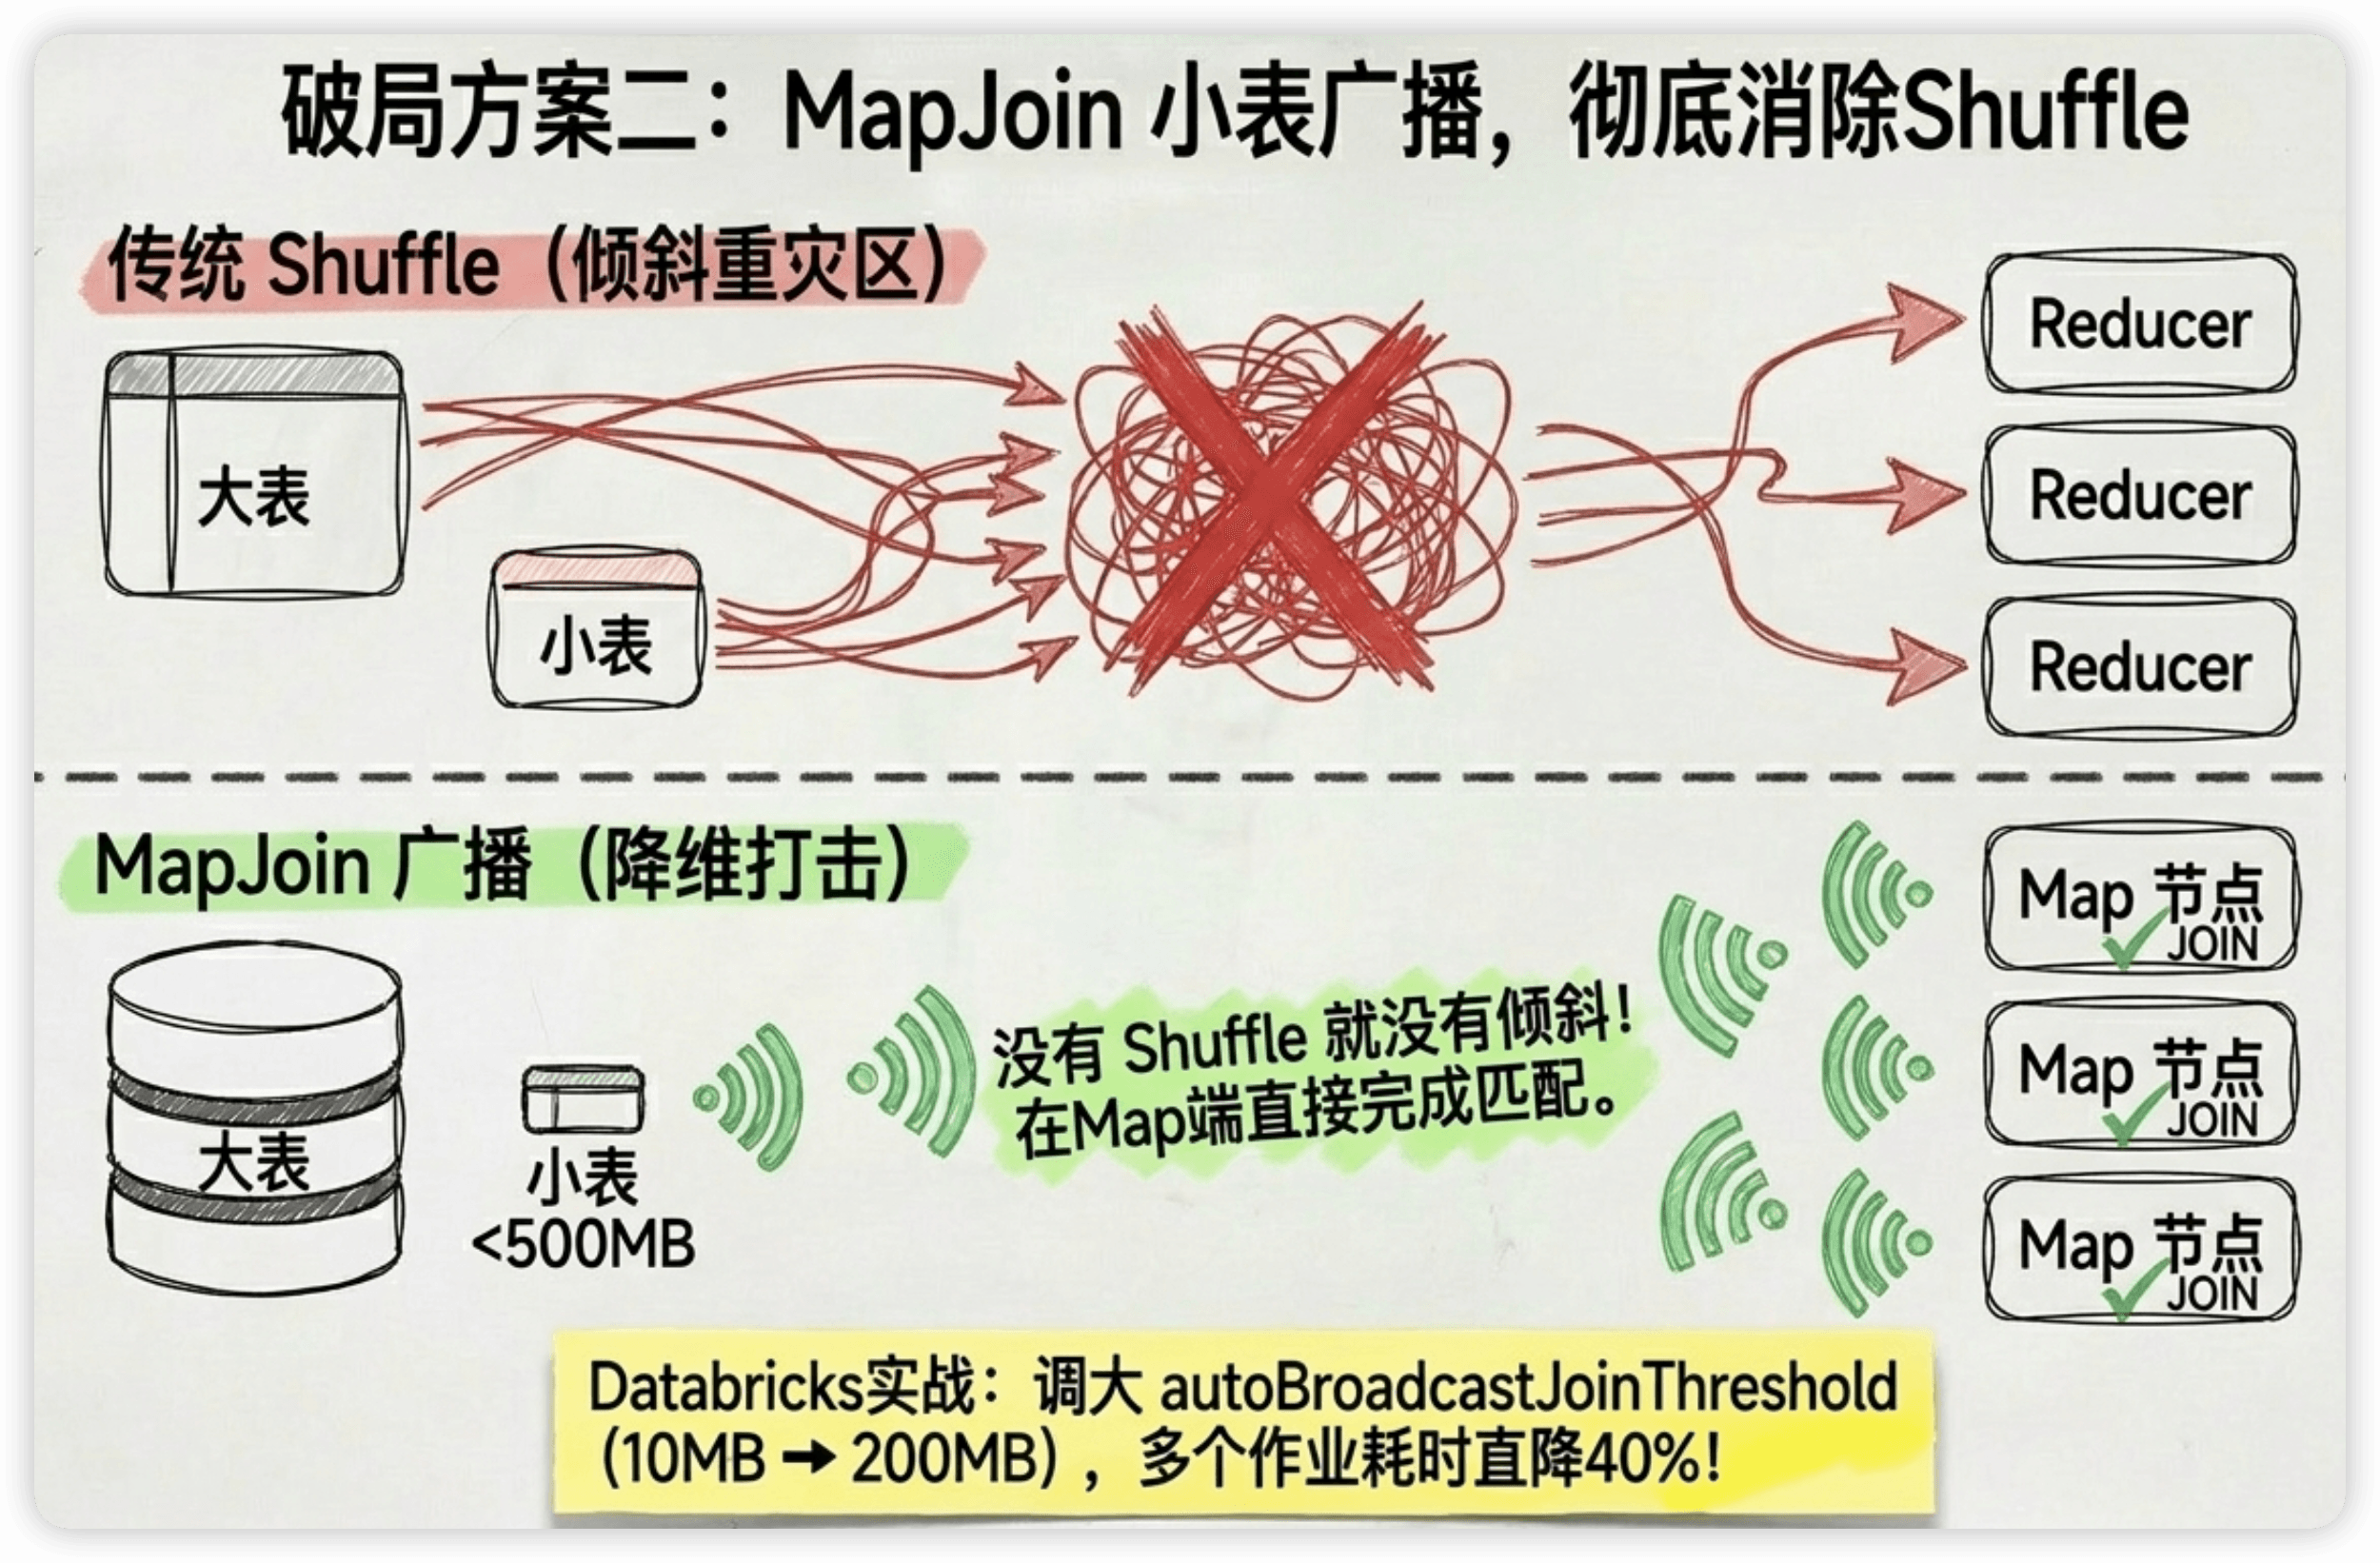
我在出海硬件品牌做Databricks优化时,把
autoBroadcastJoinThreshold从默认10MB调到了200MB。很多维度表的大小在10-200MB之间,调整后这些JOIN自动变成了Broadcast Join,多个作业的执行时间减少了40%。
适用条件: JOIN的一方足够小(通常< 500MB)能放进每个Executor的内存。
方案三:加盐打散(两阶段聚合)
思路: 给热点Key加随机后缀,分散到多个Reducer并行处理,然后再去掉后缀做最终聚合。
这是解决GROUP BY倾斜最经典的方法:
-- 原始SQL(有倾斜):
SELECT city, SUM(amount) AS gmv
FROM fact_order GROUP BY city;
-- 北京的4000万条全在一个Reducer,40分钟

-- 优化:两阶段聚合

-- 第一阶段:加盐分散
SELECT
    CONCAT(city, '_', CAST(FLOOR(RAND() * 10) AS STRING)) AS city_salt,
    SUM(amount) AS partial_sum
FROM fact_order
GROUP BY CONCAT(city, '_', CAST(FLOOR(RAND() * 10) AS STRING));
-- 北京被分散成 北京_0, 北京_1, ..., 北京_9
-- 每个"子Key"各处理约400万条,分布到10个Reducer并行
-- 第一阶段产出:北京_0: 500万, 北京_1: 480万, ..., 共10行

-- 第二阶段:去盐汇总
SELECT
    SPLIT(city_salt, '_')[0] AS city,
    SUM(partial_sum) AS gmv
FROM stage1_result
GROUP BY SPLIT(city_salt, '_')[0];
-- 去掉盐值,合并10个partial_sum为最终结果
-- 第二阶段只处理10行,瞬间完成
优化效果: 北京原来40分钟一个Reducer扛,现在分散到10个Reducer各4分钟,总耗时从40分钟降到约4-6分钟。
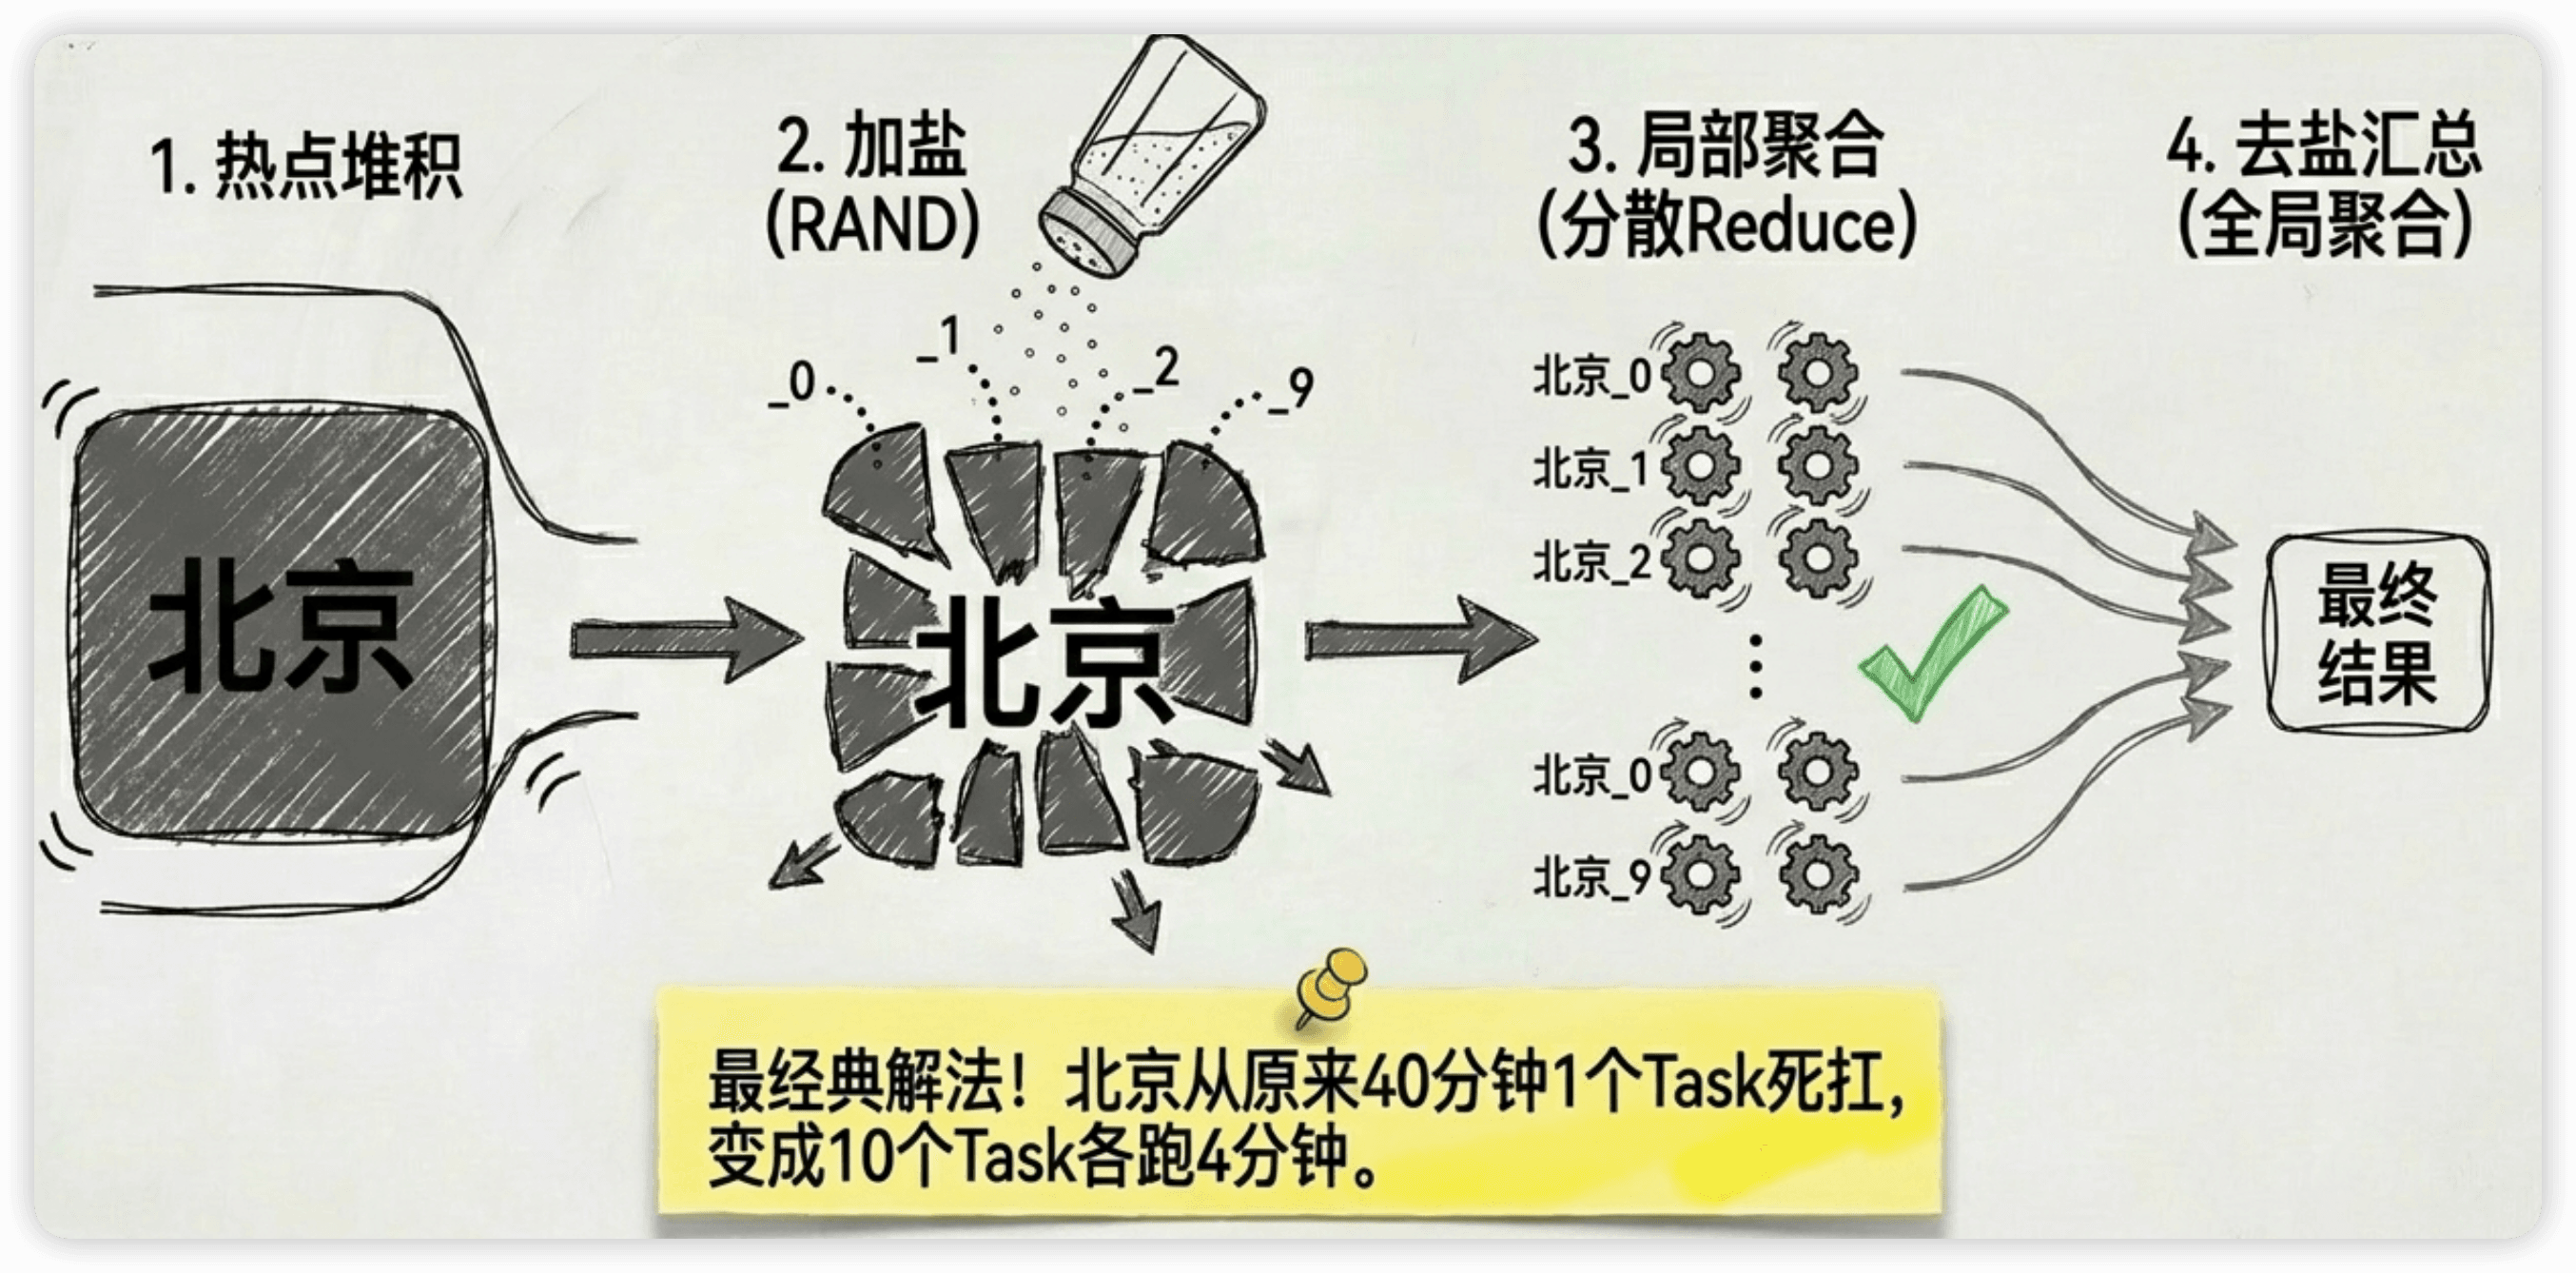
这个方法也适用于JOIN倾斜——给大表的热点Key加盐,同时把小表的对应Key复制N份(每份带一个盐值),让JOIN也能分散。
方案四:倾斜Key单独处理
思路: 把热点Key单独拎出来,用特殊方式处理(比如MapJoin),普通Key正常处理,最后UNION ALL合并。
-- 第一步:找出热点Key
-- 通过分析发现 city IN ('北京','上海') 占了60%的数据
-- 这两个Key的dim_city数据可以直接硬编码

-- 第二步:分开处理

-- Part1: 热点Key → 直接赋值维度,不走JOIN
SELECT f.order_id, f.amount, f.city,
    CASE f.city
        WHEN '北京' THEN '华北'
        WHEN '上海' THEN '华东'
    END AS region
FROM fact_order f
WHERE f.city IN ('北京', '上海')

UNION ALL

-- Part2: 普通Key → 正常JOIN(数据量小,不倾斜)
SELECT f.order_id, f.amount, f.city, d.region
FROM fact_order f
JOIN dim_city d ON f.city = d.city
WHERE f.city NOT IN ('北京', '上海');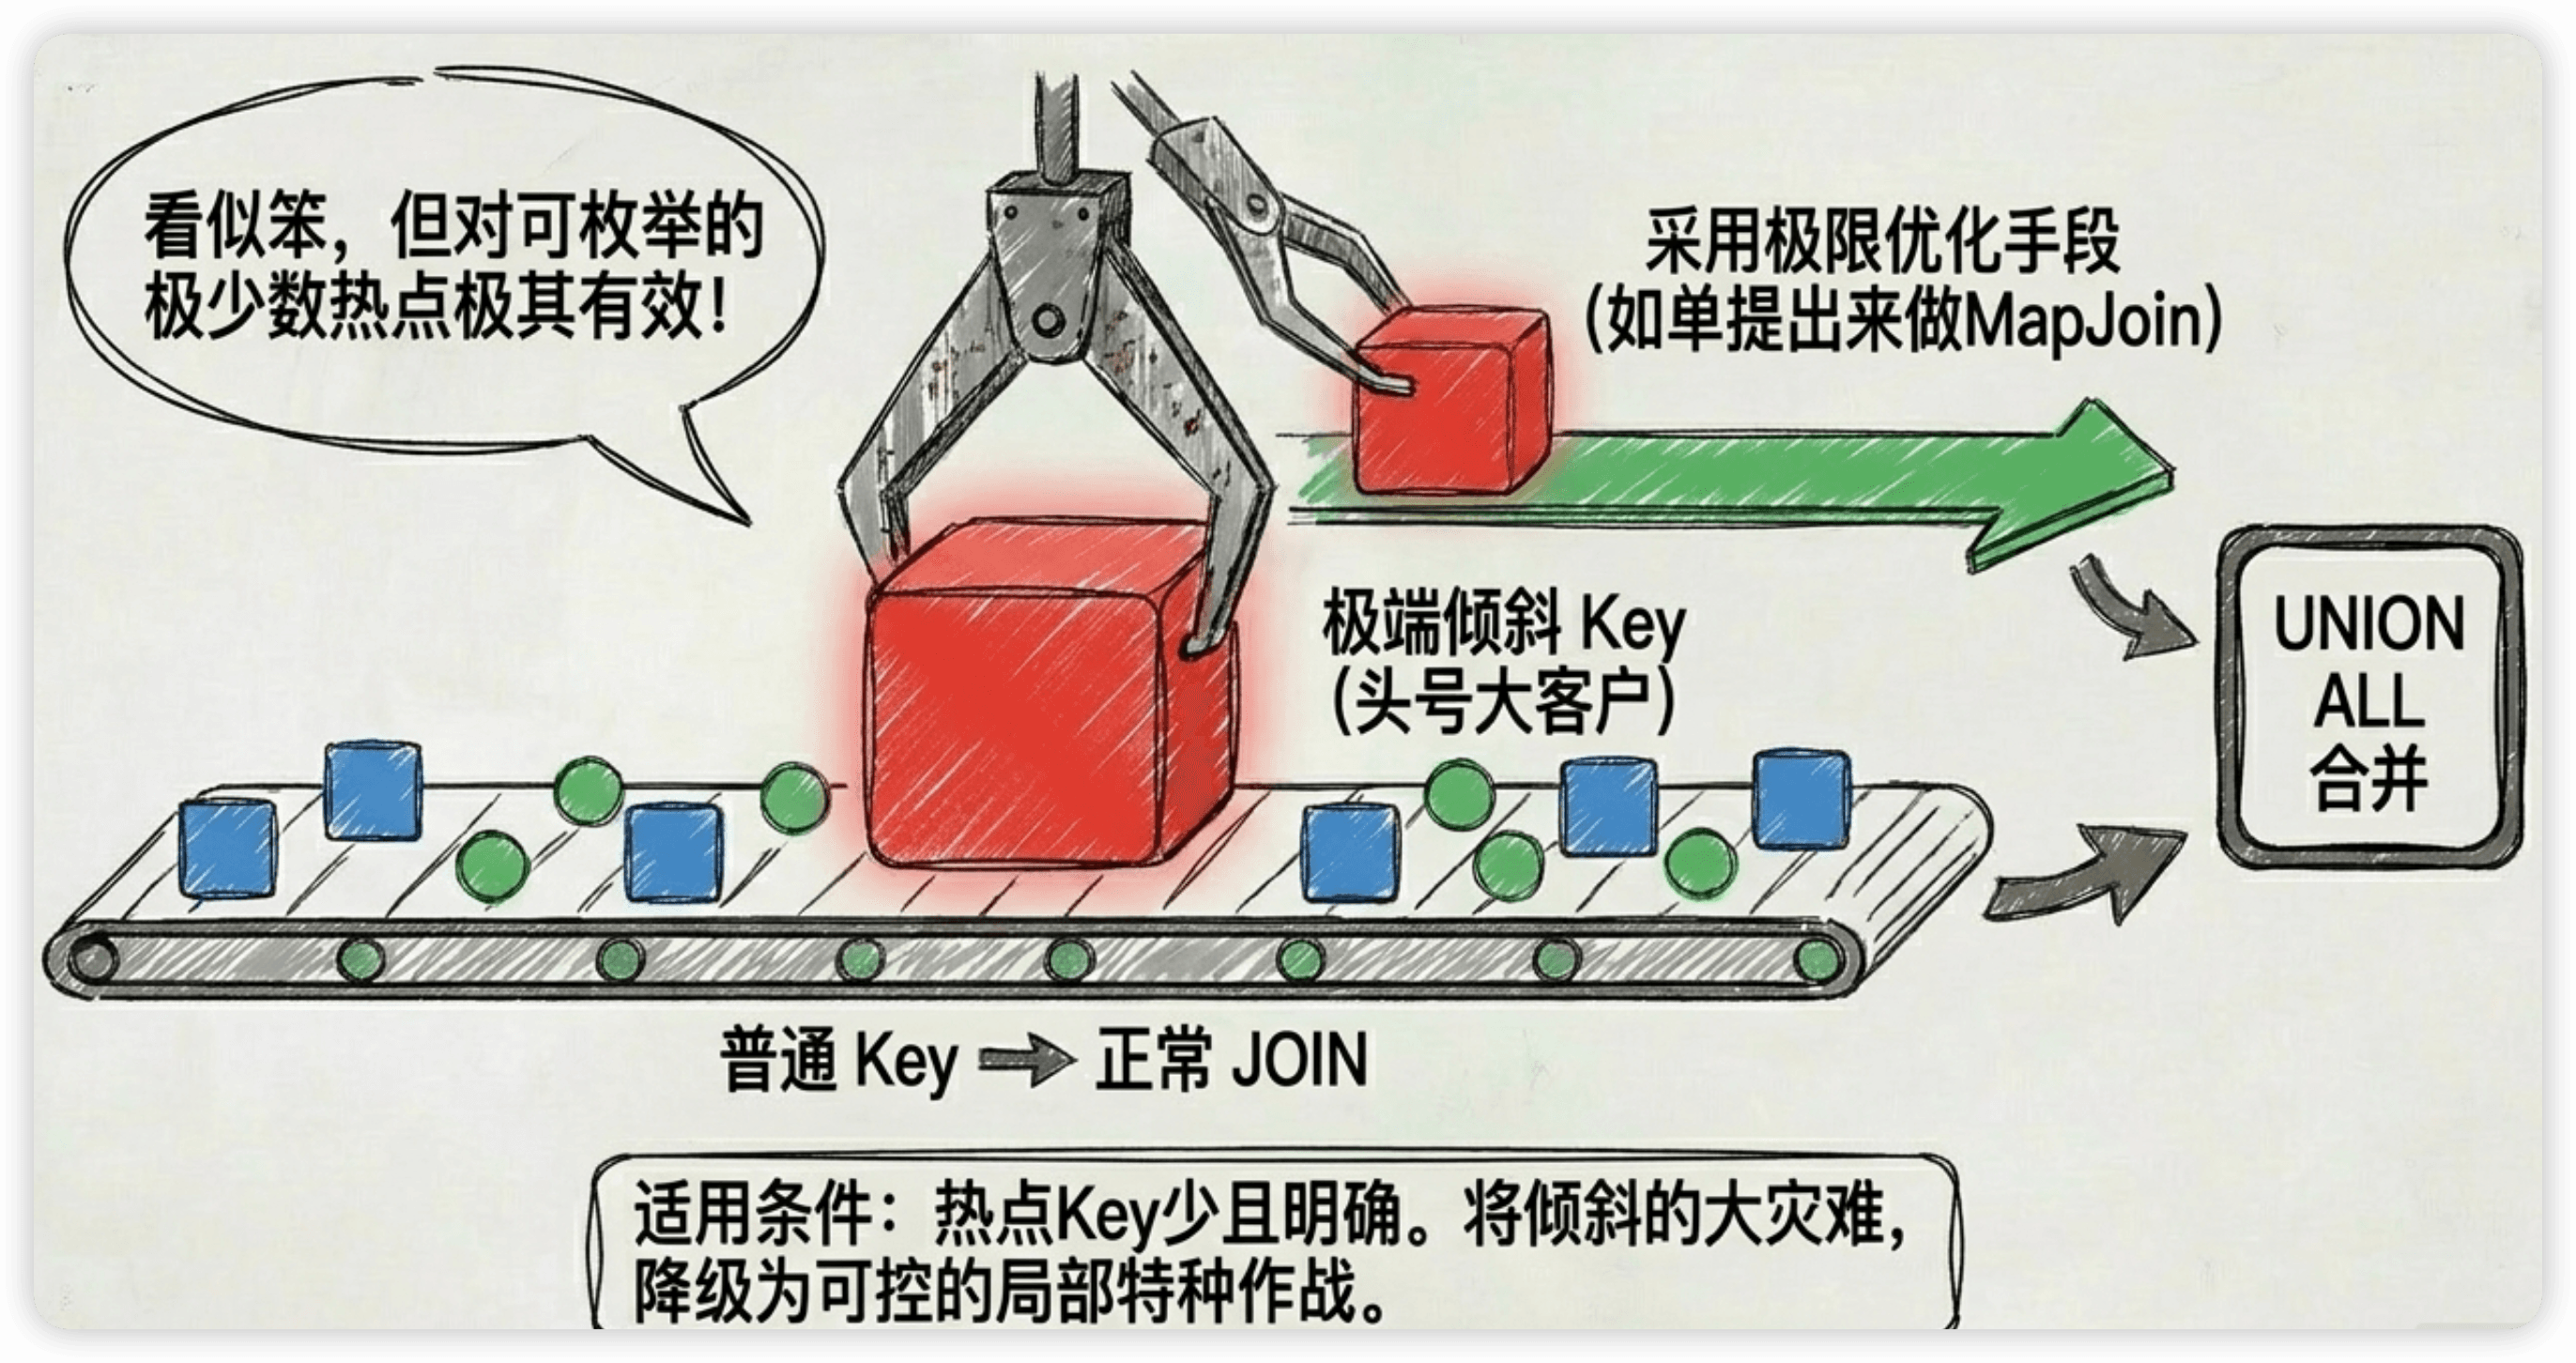
这种方案看起来"笨",但在某些场景下非常有效——尤其是热点Key只有几个、且维度信息可以枚举的时候。
Spark AQE:自动处理倾斜
Spark 3.0之后引入了AQE(Adaptive Query Execution),可以自动检测和处理倾斜。
// 开启AQE和倾斜Join优化
spark.conf.set("spark.sql.adaptive.enabled", true)
spark.conf.set("spark.sql.adaptive.skewJoin.enabled", true)
spark.conf.set("spark.sql.adaptive.skewJoin.skewedPartitionFactor", 5)
spark.conf.set("spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes", "256MB")
AQE会在运行时自动检测倾斜的Partition,把它拆成多个小Partition重新分配。相当于引擎帮你做了"加盐打散"。
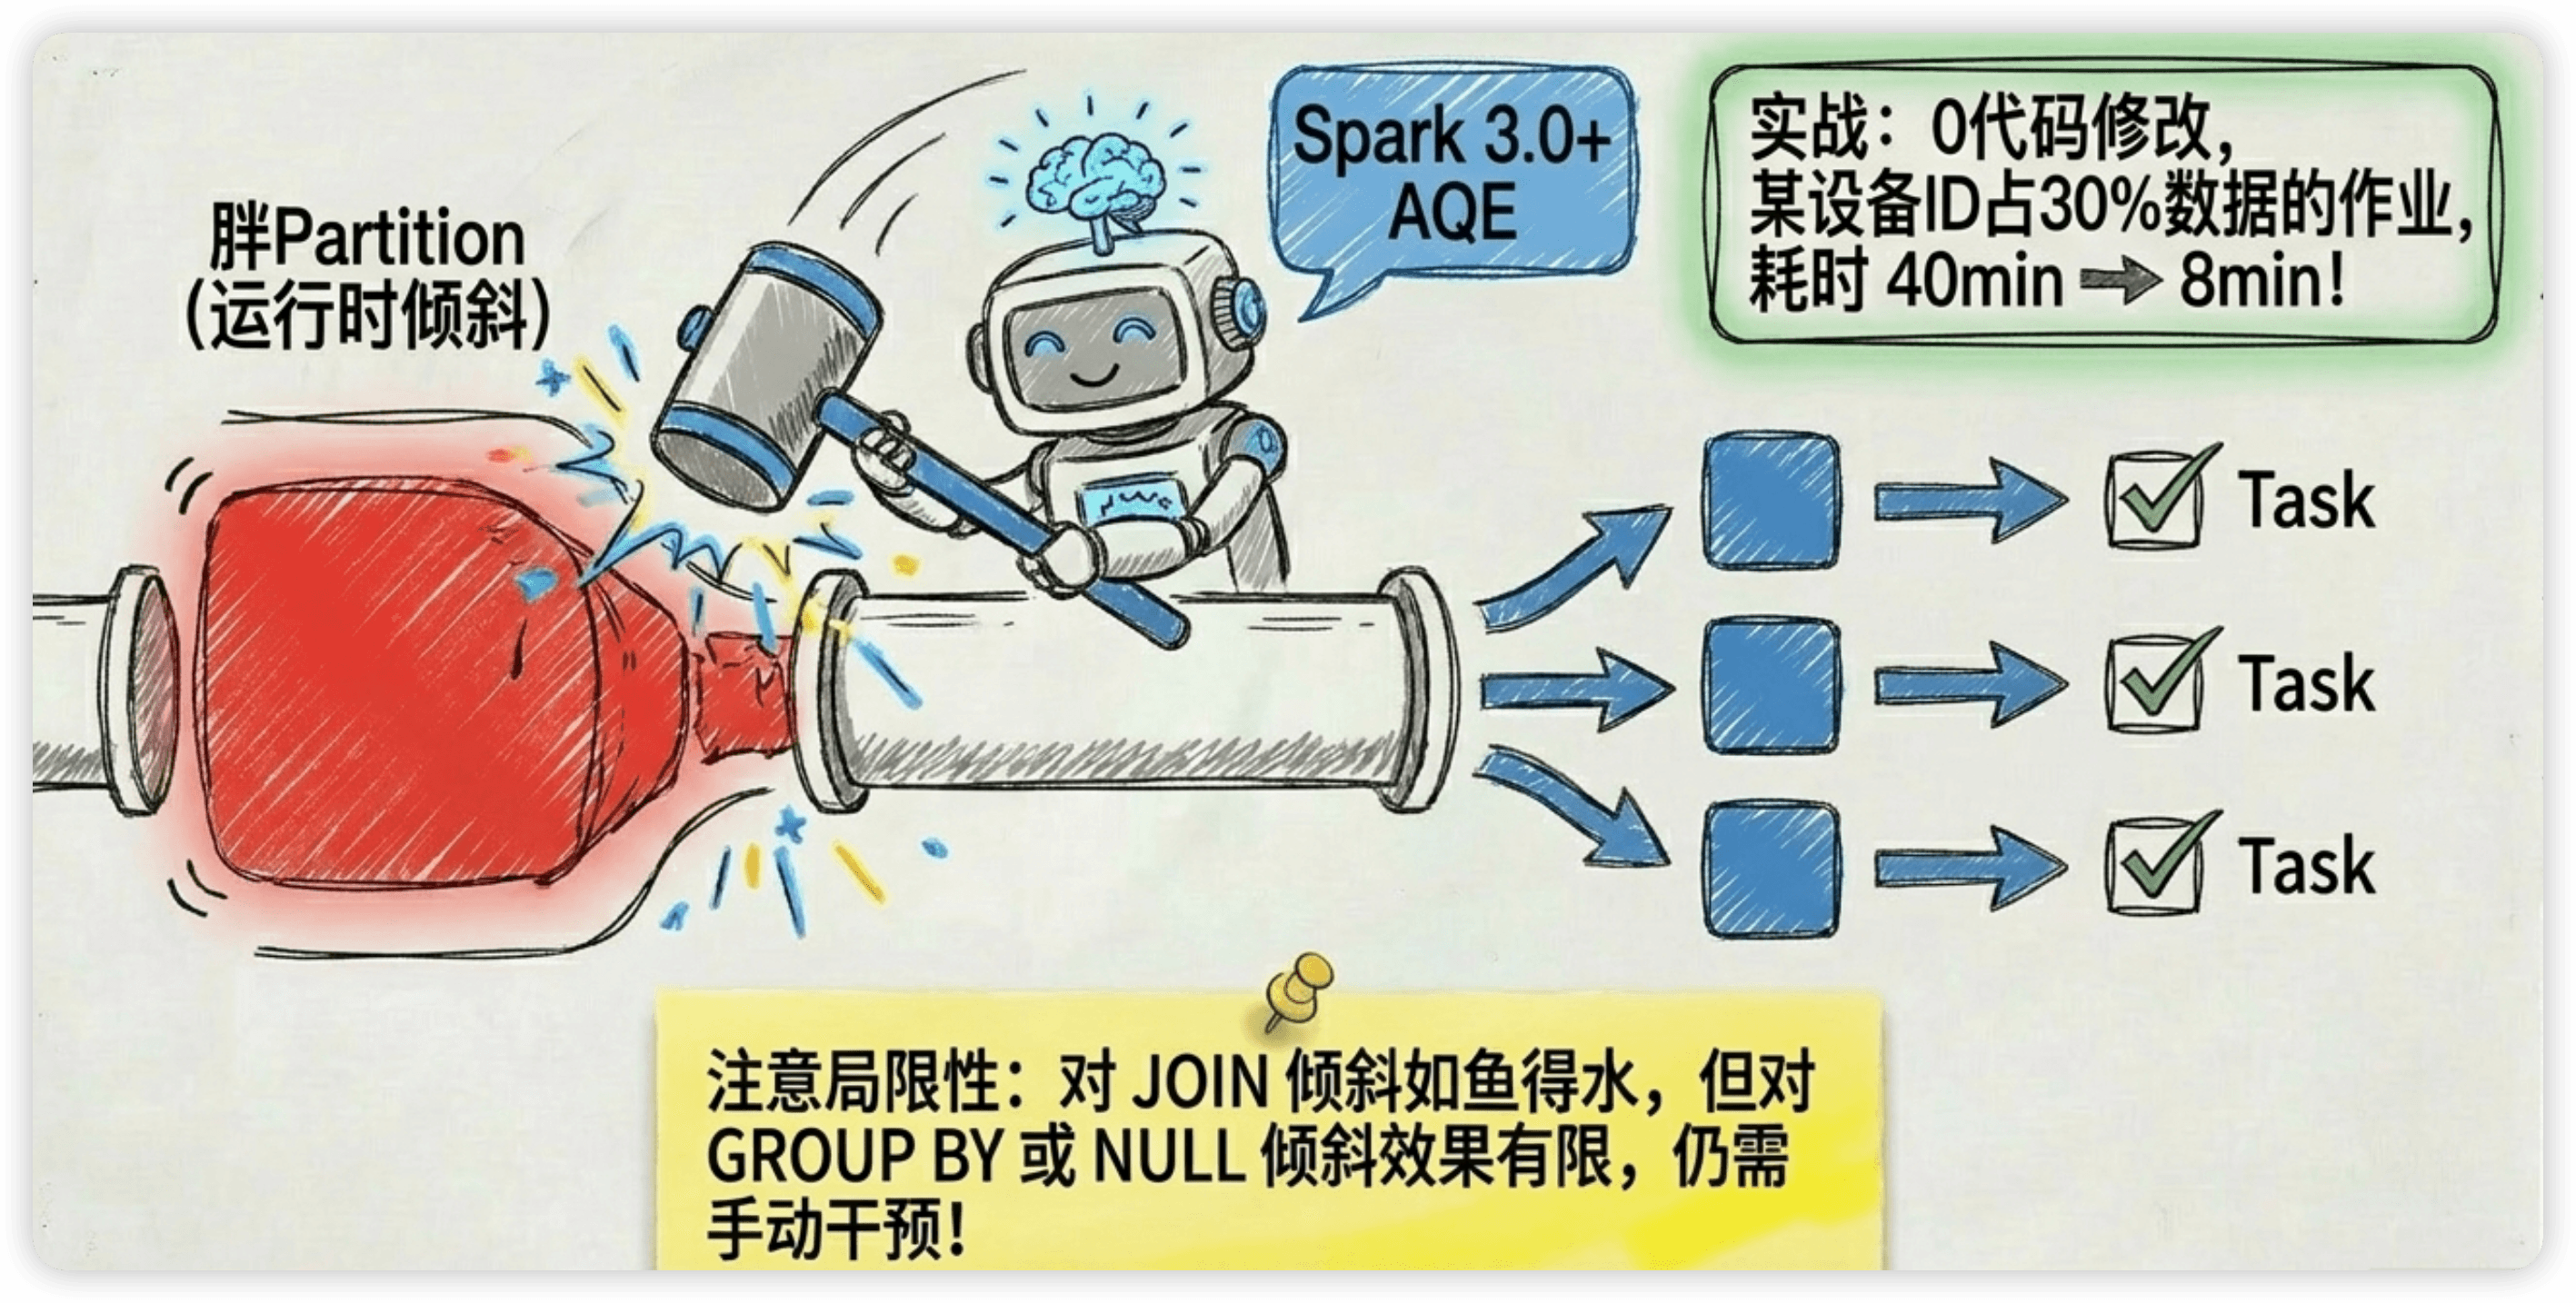
我在Databricks上把AQE打开之后,之前那个数据倾斜的作业(某设备ID占30%数据)从40分钟自动降到了8分钟,不用改一行SQL。AQE是Spark最实用的优化特性之一。
但AQE不是万能的——它只能处理Join倾斜,对GROUP BY倾斜和NULL倾斜效果有限。了解原理、知道什么时候需要手动优化,依然是必要的。
面试怎么答?
高分回答
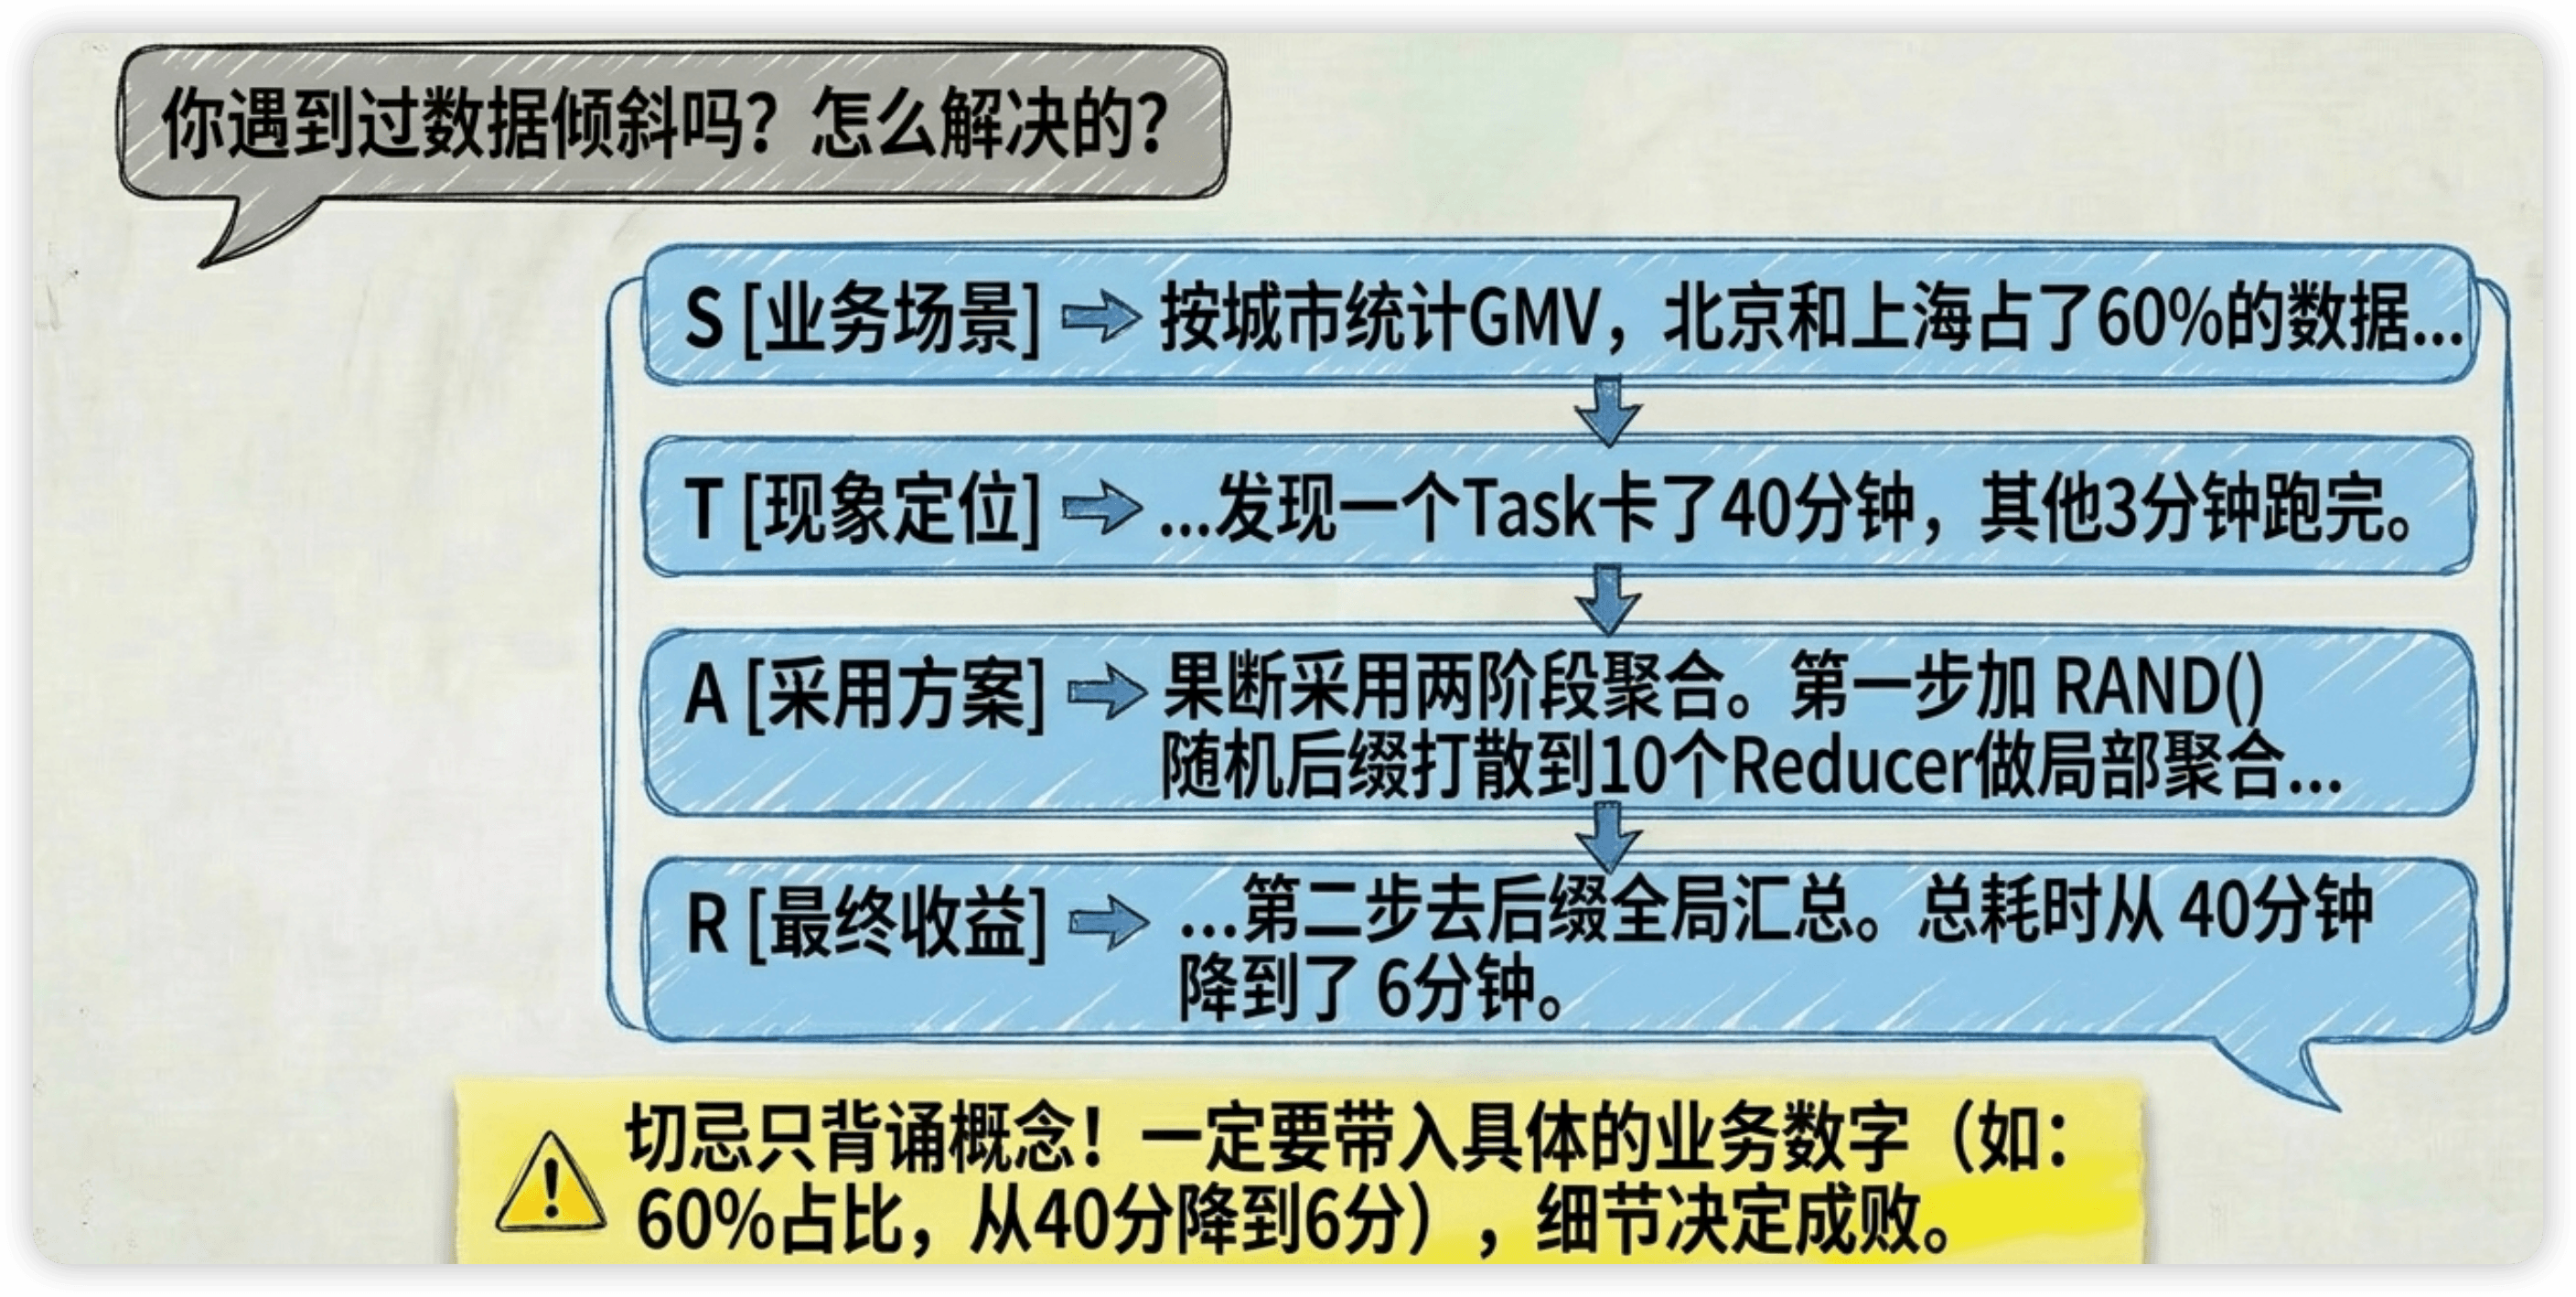
「我遇到过两次典型的倾斜问题。一次是GROUP BY倾斜——按城市统计GMV,北京和上海占了60%的数据,Task耗时从3分钟变成40分钟。我用两阶段聚合解决:第一步给城市Key加RAND()后缀打散到10个Reducer分别求和,第二步去掉后缀做最终汇总。优化后从40分钟降到6分钟。」
「另一次是NULL值倾斜——未登录用户的事件约占15%,user_id全部为NULL,JOIN时集中到一个Reducer。我把NULL的数据拆出来单独处理——不走JOIN,维度字段直接赋默认值,再UNION ALL合并回去。此外在Databricks上开启了AQE自动倾斜优化,覆盖了大部分Join倾斜场景。」
追问防线
追问1:怎么提前预防倾斜?
三个层面。第一,设计阶段——了解数据分布,如果知道某些Key数据量特别大,ETL逻辑提前考虑。第二,开发阶段——写JOIN前先跑一下Key分布分析(前面的SQL),识别潜在热点。第三,运行阶段——开启AQE让引擎自动处理,同时在监控中设置Task耗时不均匀的告警。
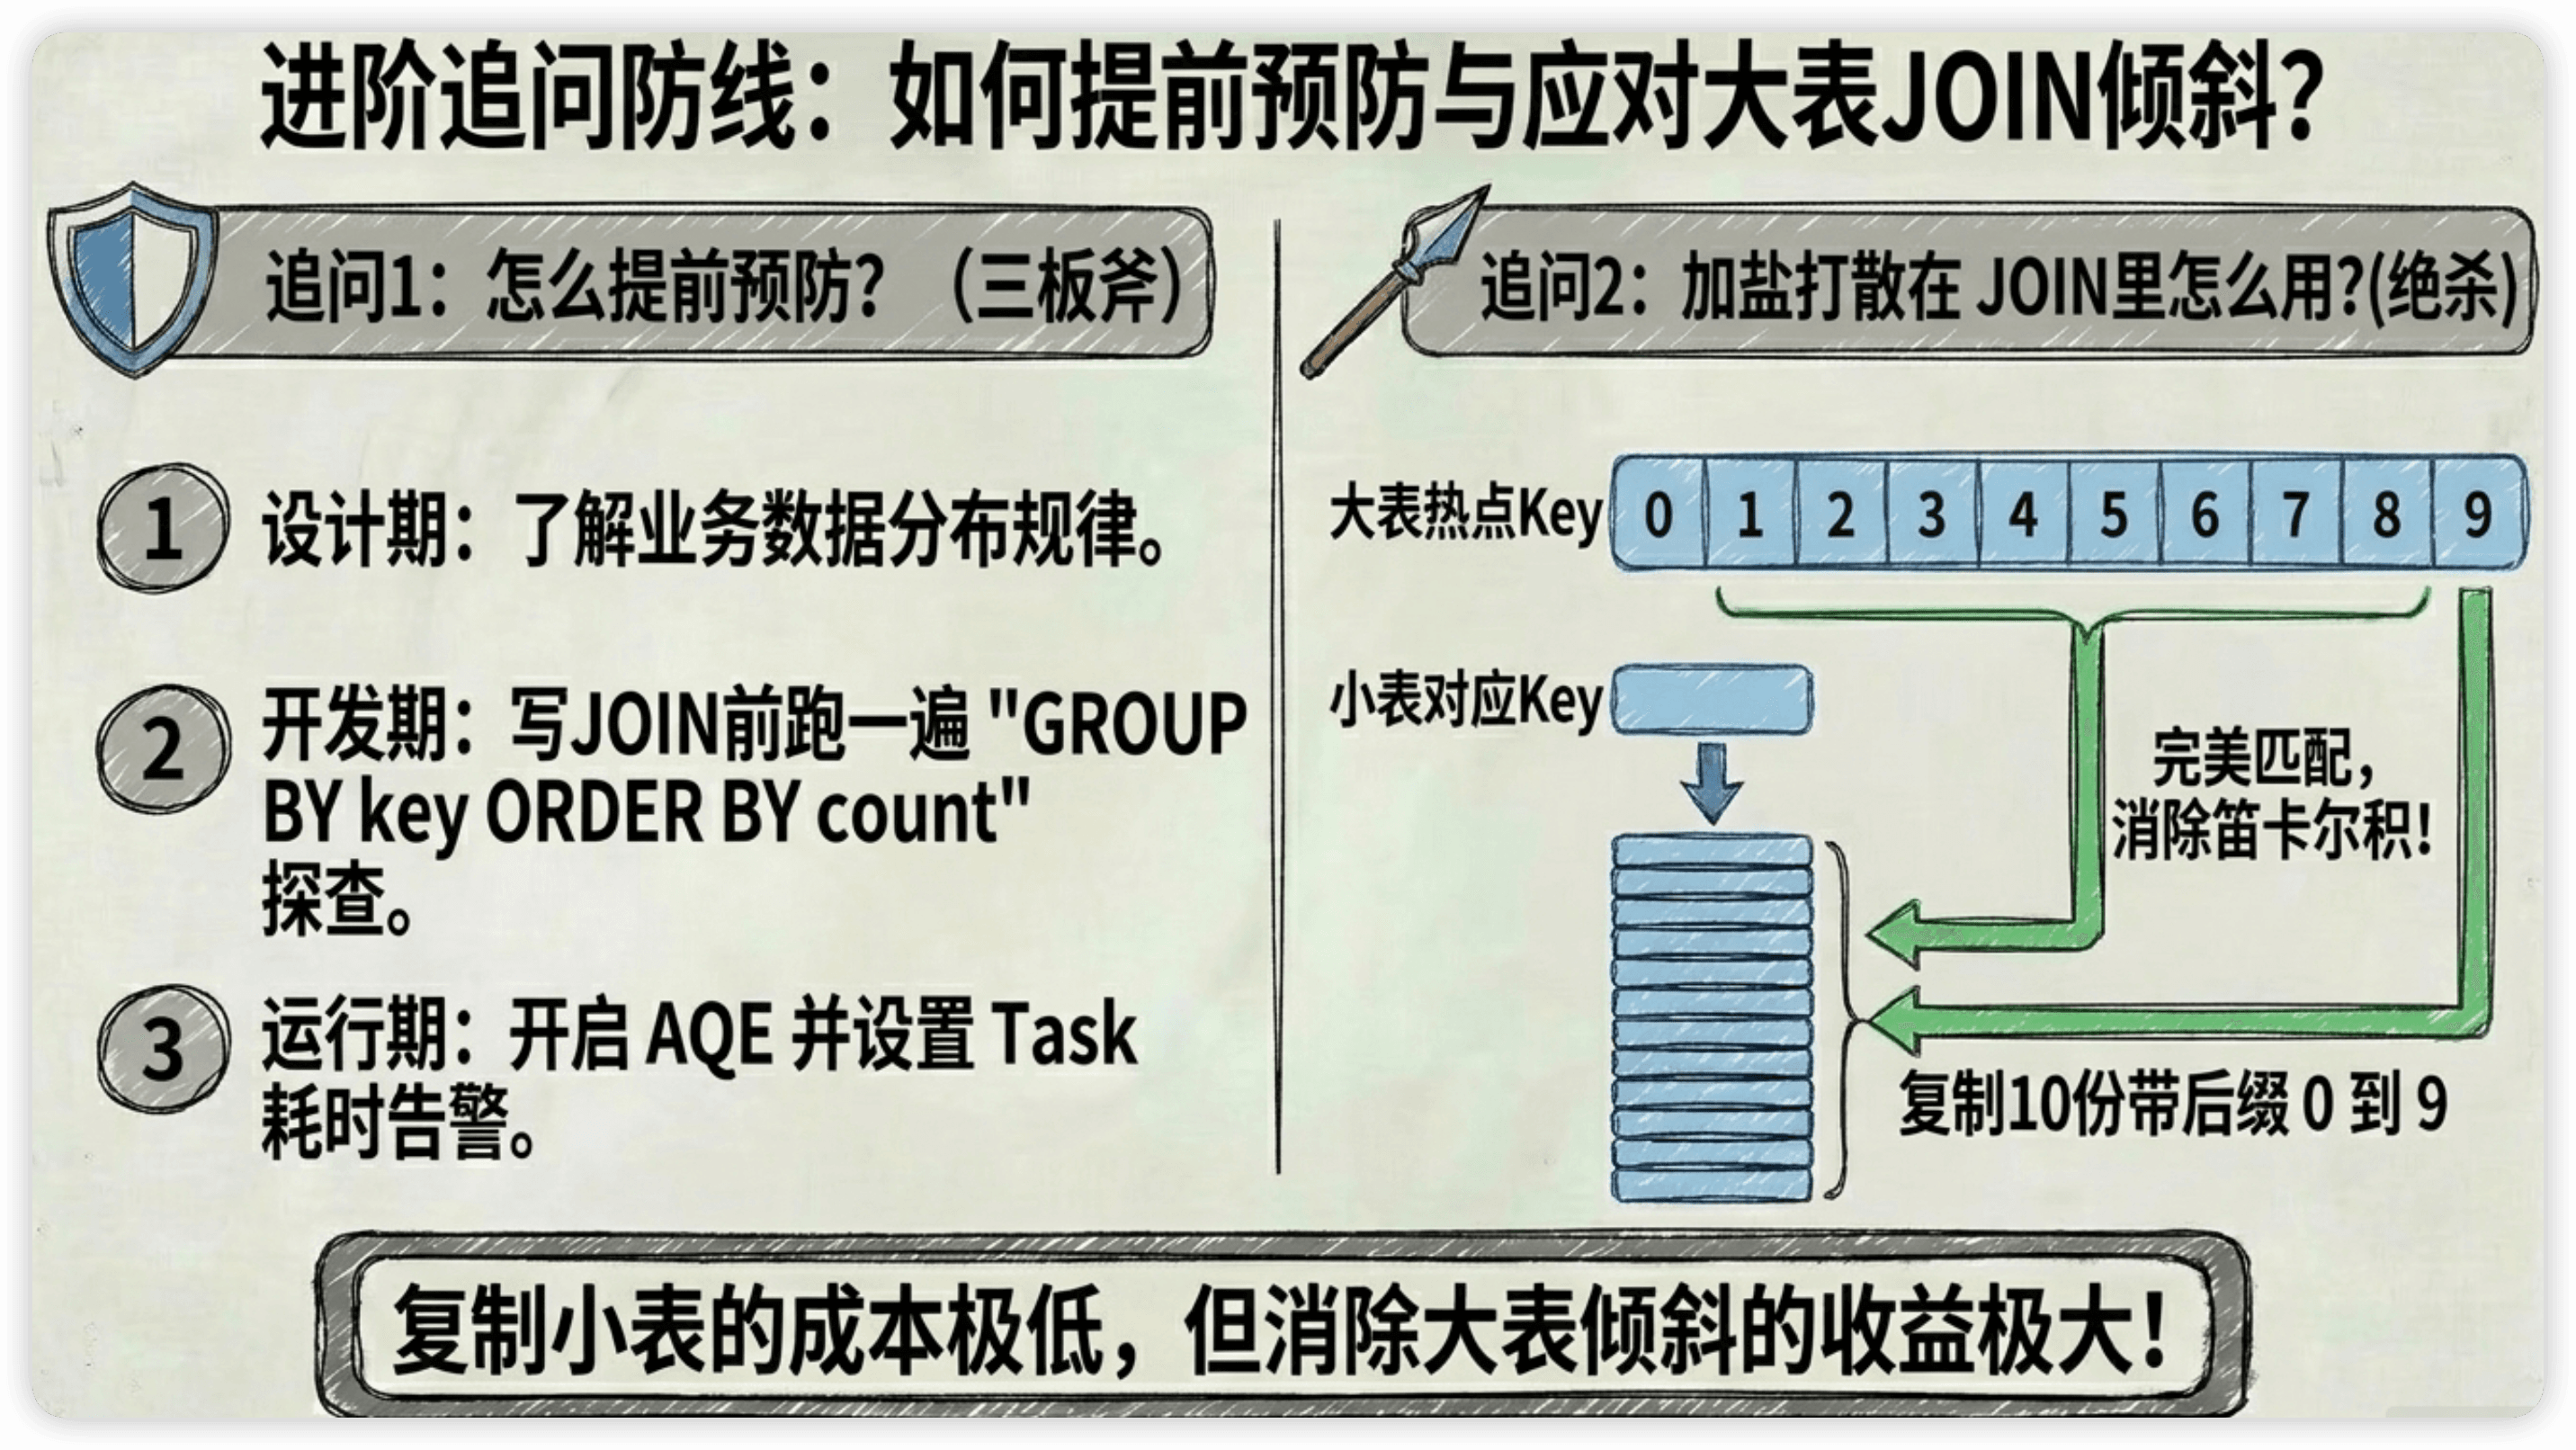
追问2:加盐打散对JOIN场景怎么用?
大表的热点Key加盐(比如user_id变成user_id_0到user_id_9),小表对应的记录复制10份(每份带一个盐值0到9)。这样JOIN的时候热点Key被分散到10个Reducer。复制小表的成本很低(只是热点Key对应的几行数据复制了10份),但倾斜的消除效果很好。
总结
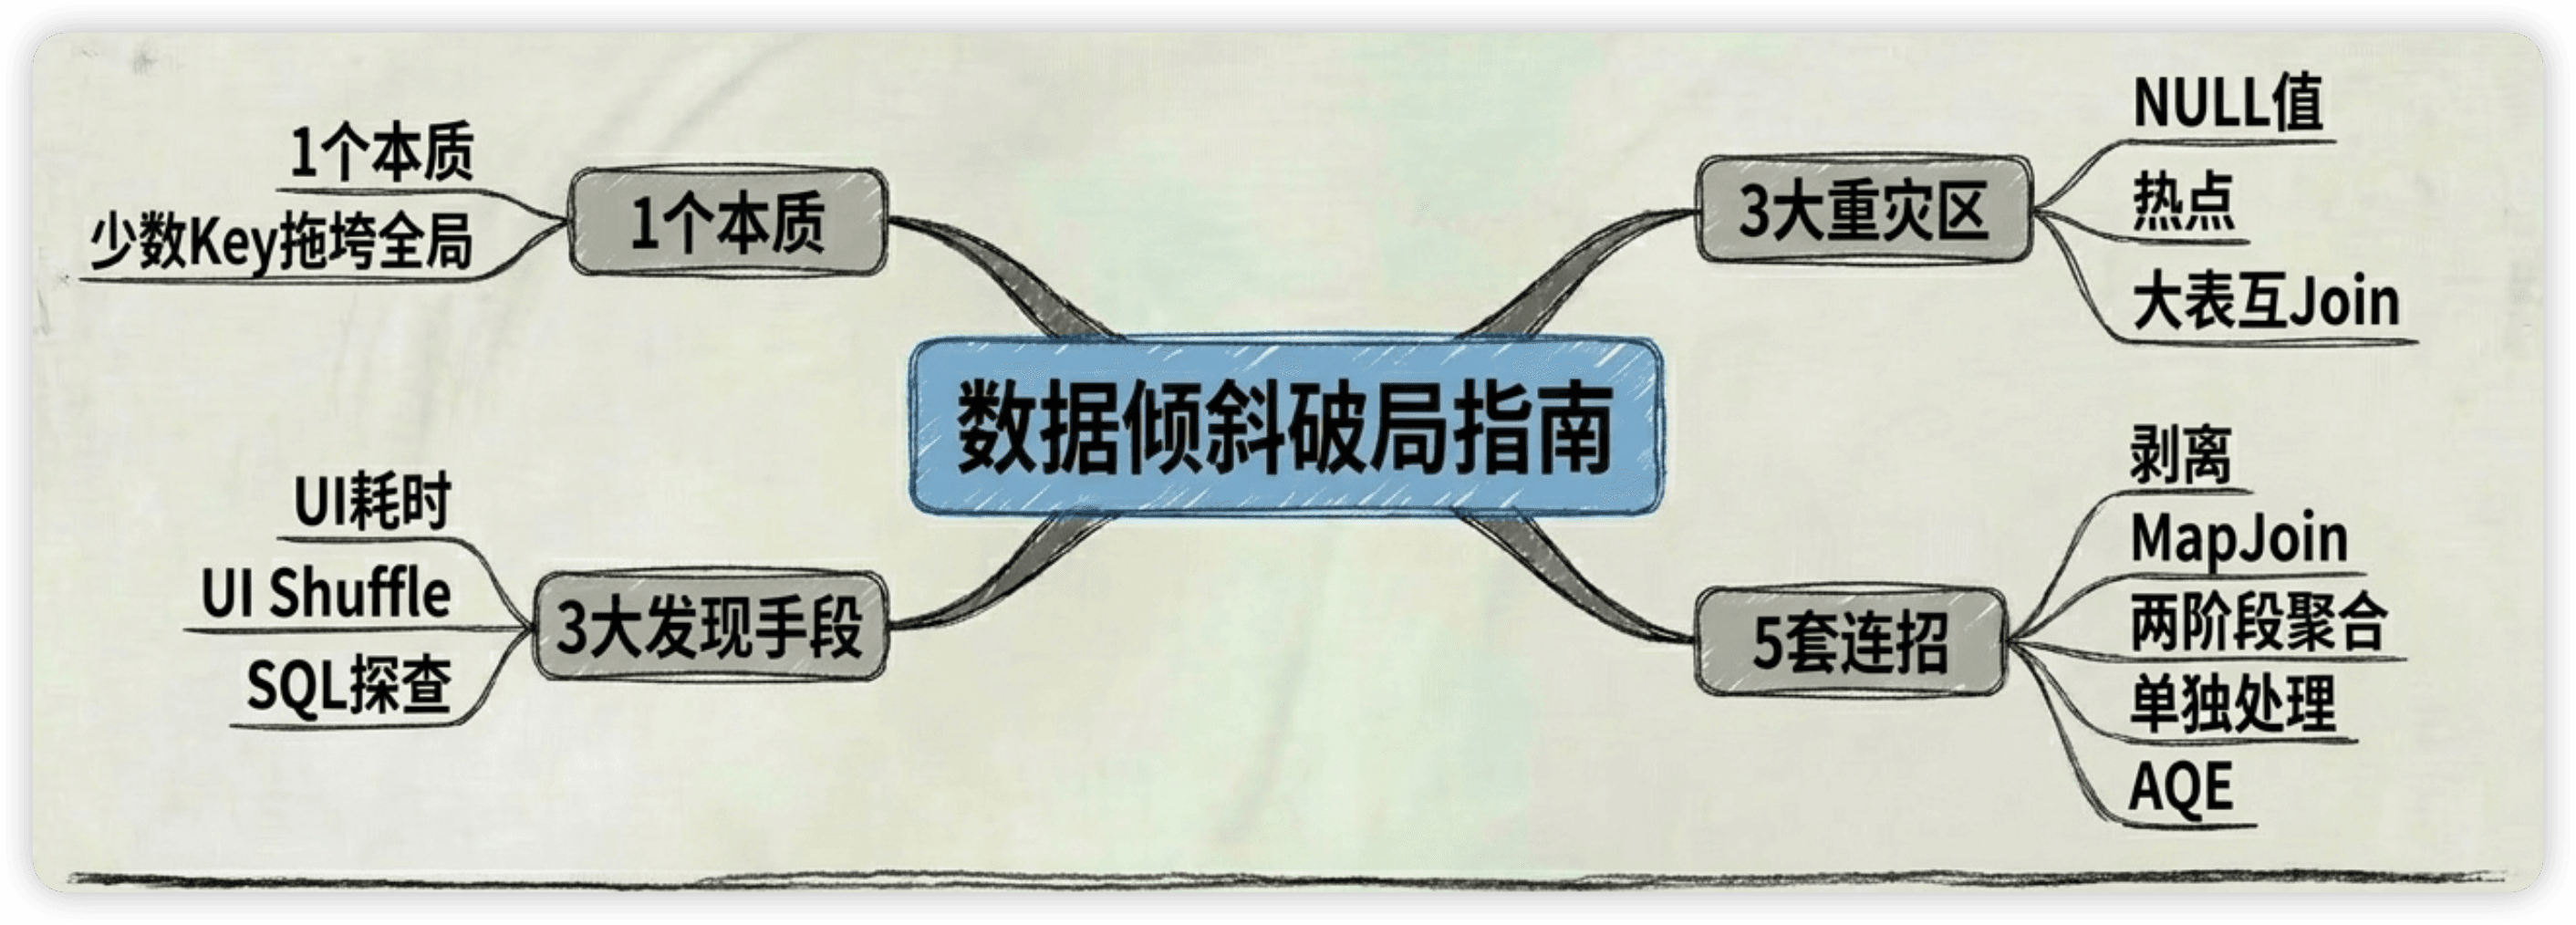
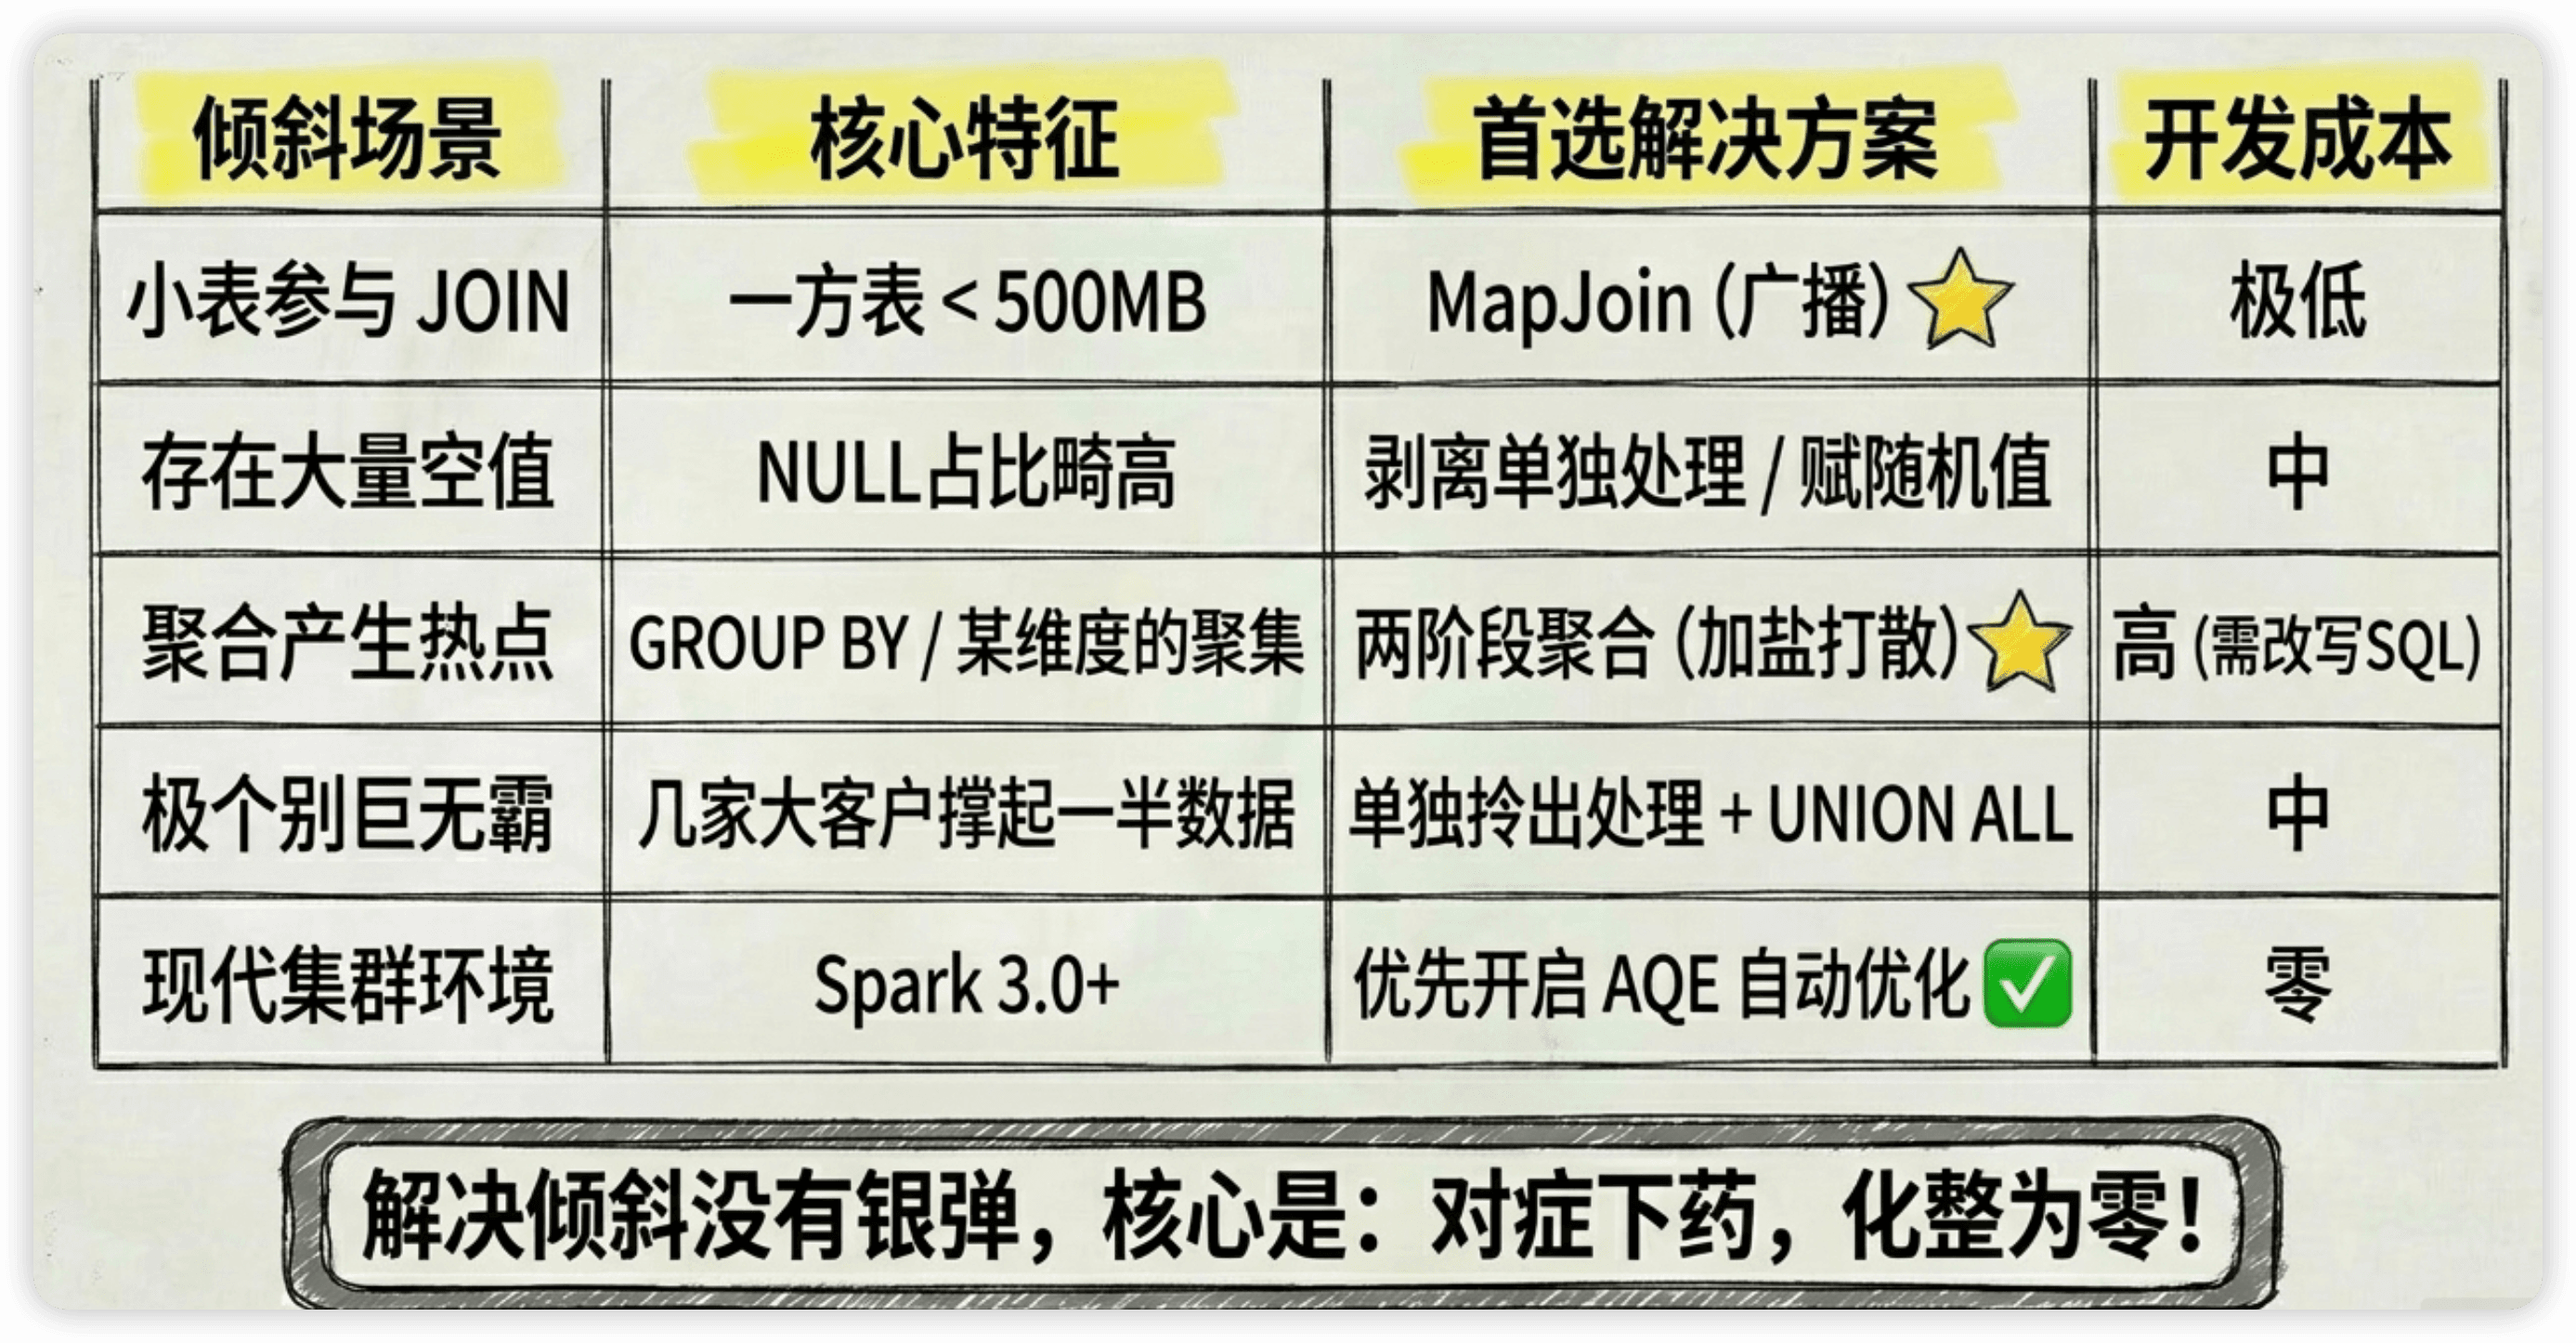
- 倾斜的本质:少数Key数据量远超其他,个别Task被拖慢
- 发现方法:看Task耗时分布 + SQL分析Key分布
- NULL倾斜:COALESCE随机打散或拆分单独处理
- 小表JOIN:MapJoin广播到Map端,不走Shuffle
- 热点Key:加盐打散两阶段聚合,经典有效
- 倾斜Key:单独拎出来特殊处理,UNION ALL合并
- Spark AQE:自动倾斜优化,能覆盖大部分Join场景