事实表三种类型
面试问"事实表有哪几种类型",90%的人只能答出事务型。追问"周期快照型和累积快照型有什么区别",基本就卡住了。
其实这道题不难,难的是很多人在工作中只接触过事务型事实表(订单流水、点击日志),对另外两种缺乏实战感知。
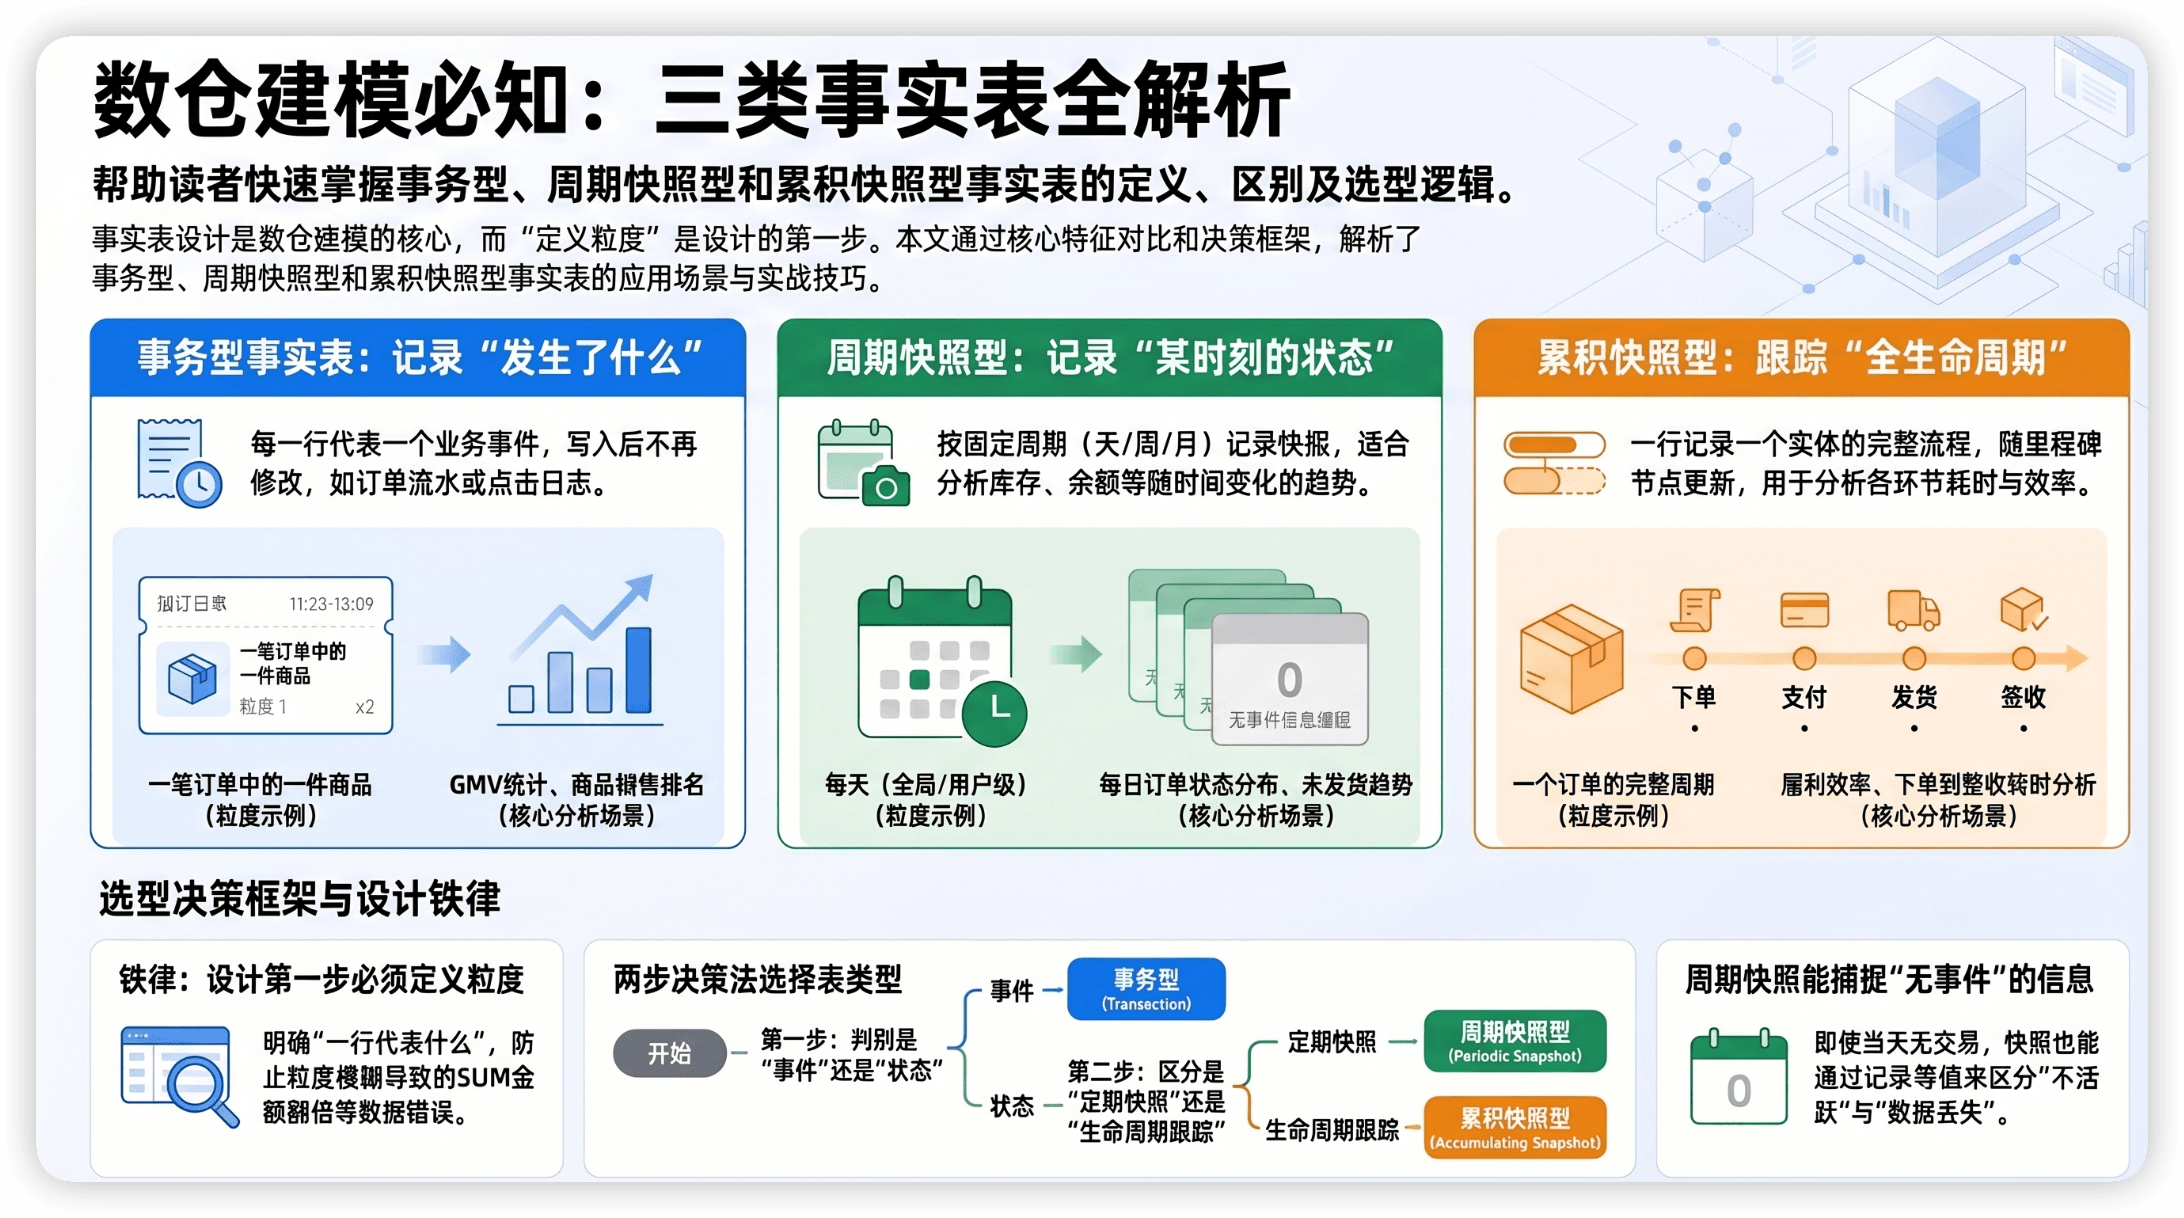
这篇文章我把三种事实表的概念、适用场景、建表示例和面试回答策略全部讲清楚。重点是帮你建立一个判断框架——拿到一个业务需求,能快速判断该用哪种事实表。
在聊类型之前,先记住一条铁律
设计事实表的第一步是定义粒度。
粒度 = 一行数据代表什么。
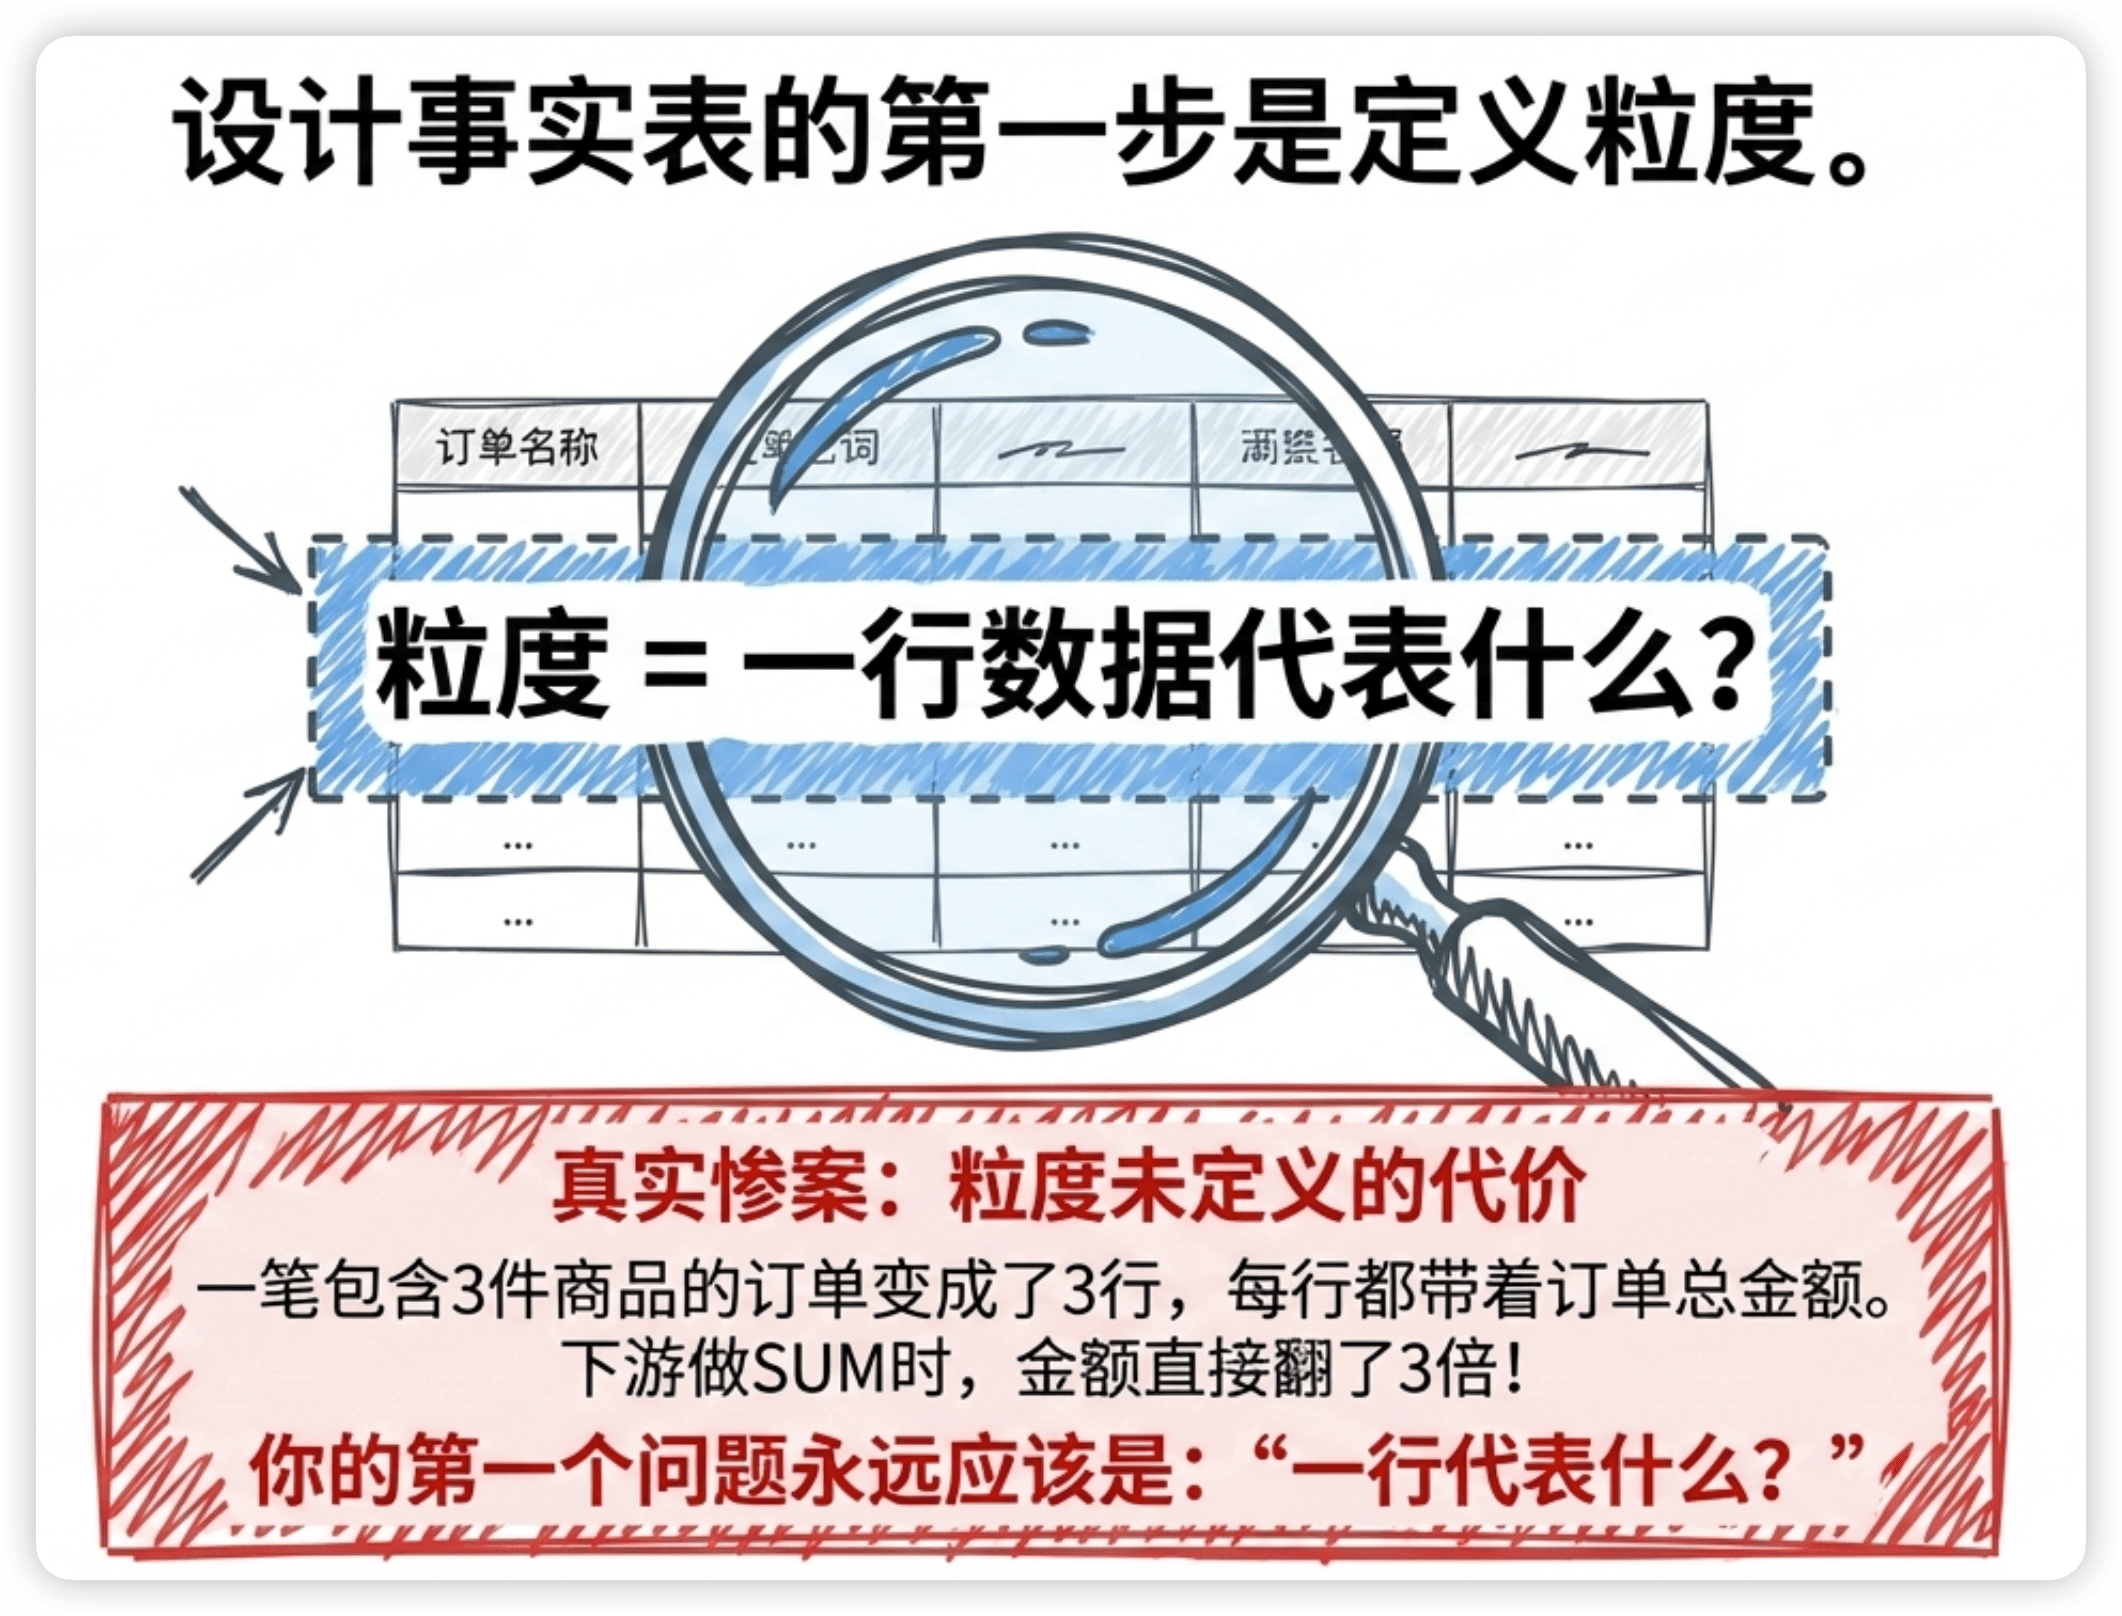
这个问题答不清楚,后面所有的事情都是错的。我见过一个真实的案例:有人设计订单事实表时没有明确粒度——到底是"一行一个订单"还是"一行一个订单里的一件商品"?
结果数据进来后,一笔包含3件商品的订单变成了3行,每行都带着订单总金额。下游做SUM的时候,金额直接翻了3倍。排查了两天才发现,根源就是粒度没定义清楚。
所以任何人来跟你讨论事实表设计,你的第一个问题永远应该是:"一行代表什么?"
事务型事实表:最常见的那种
核心思想
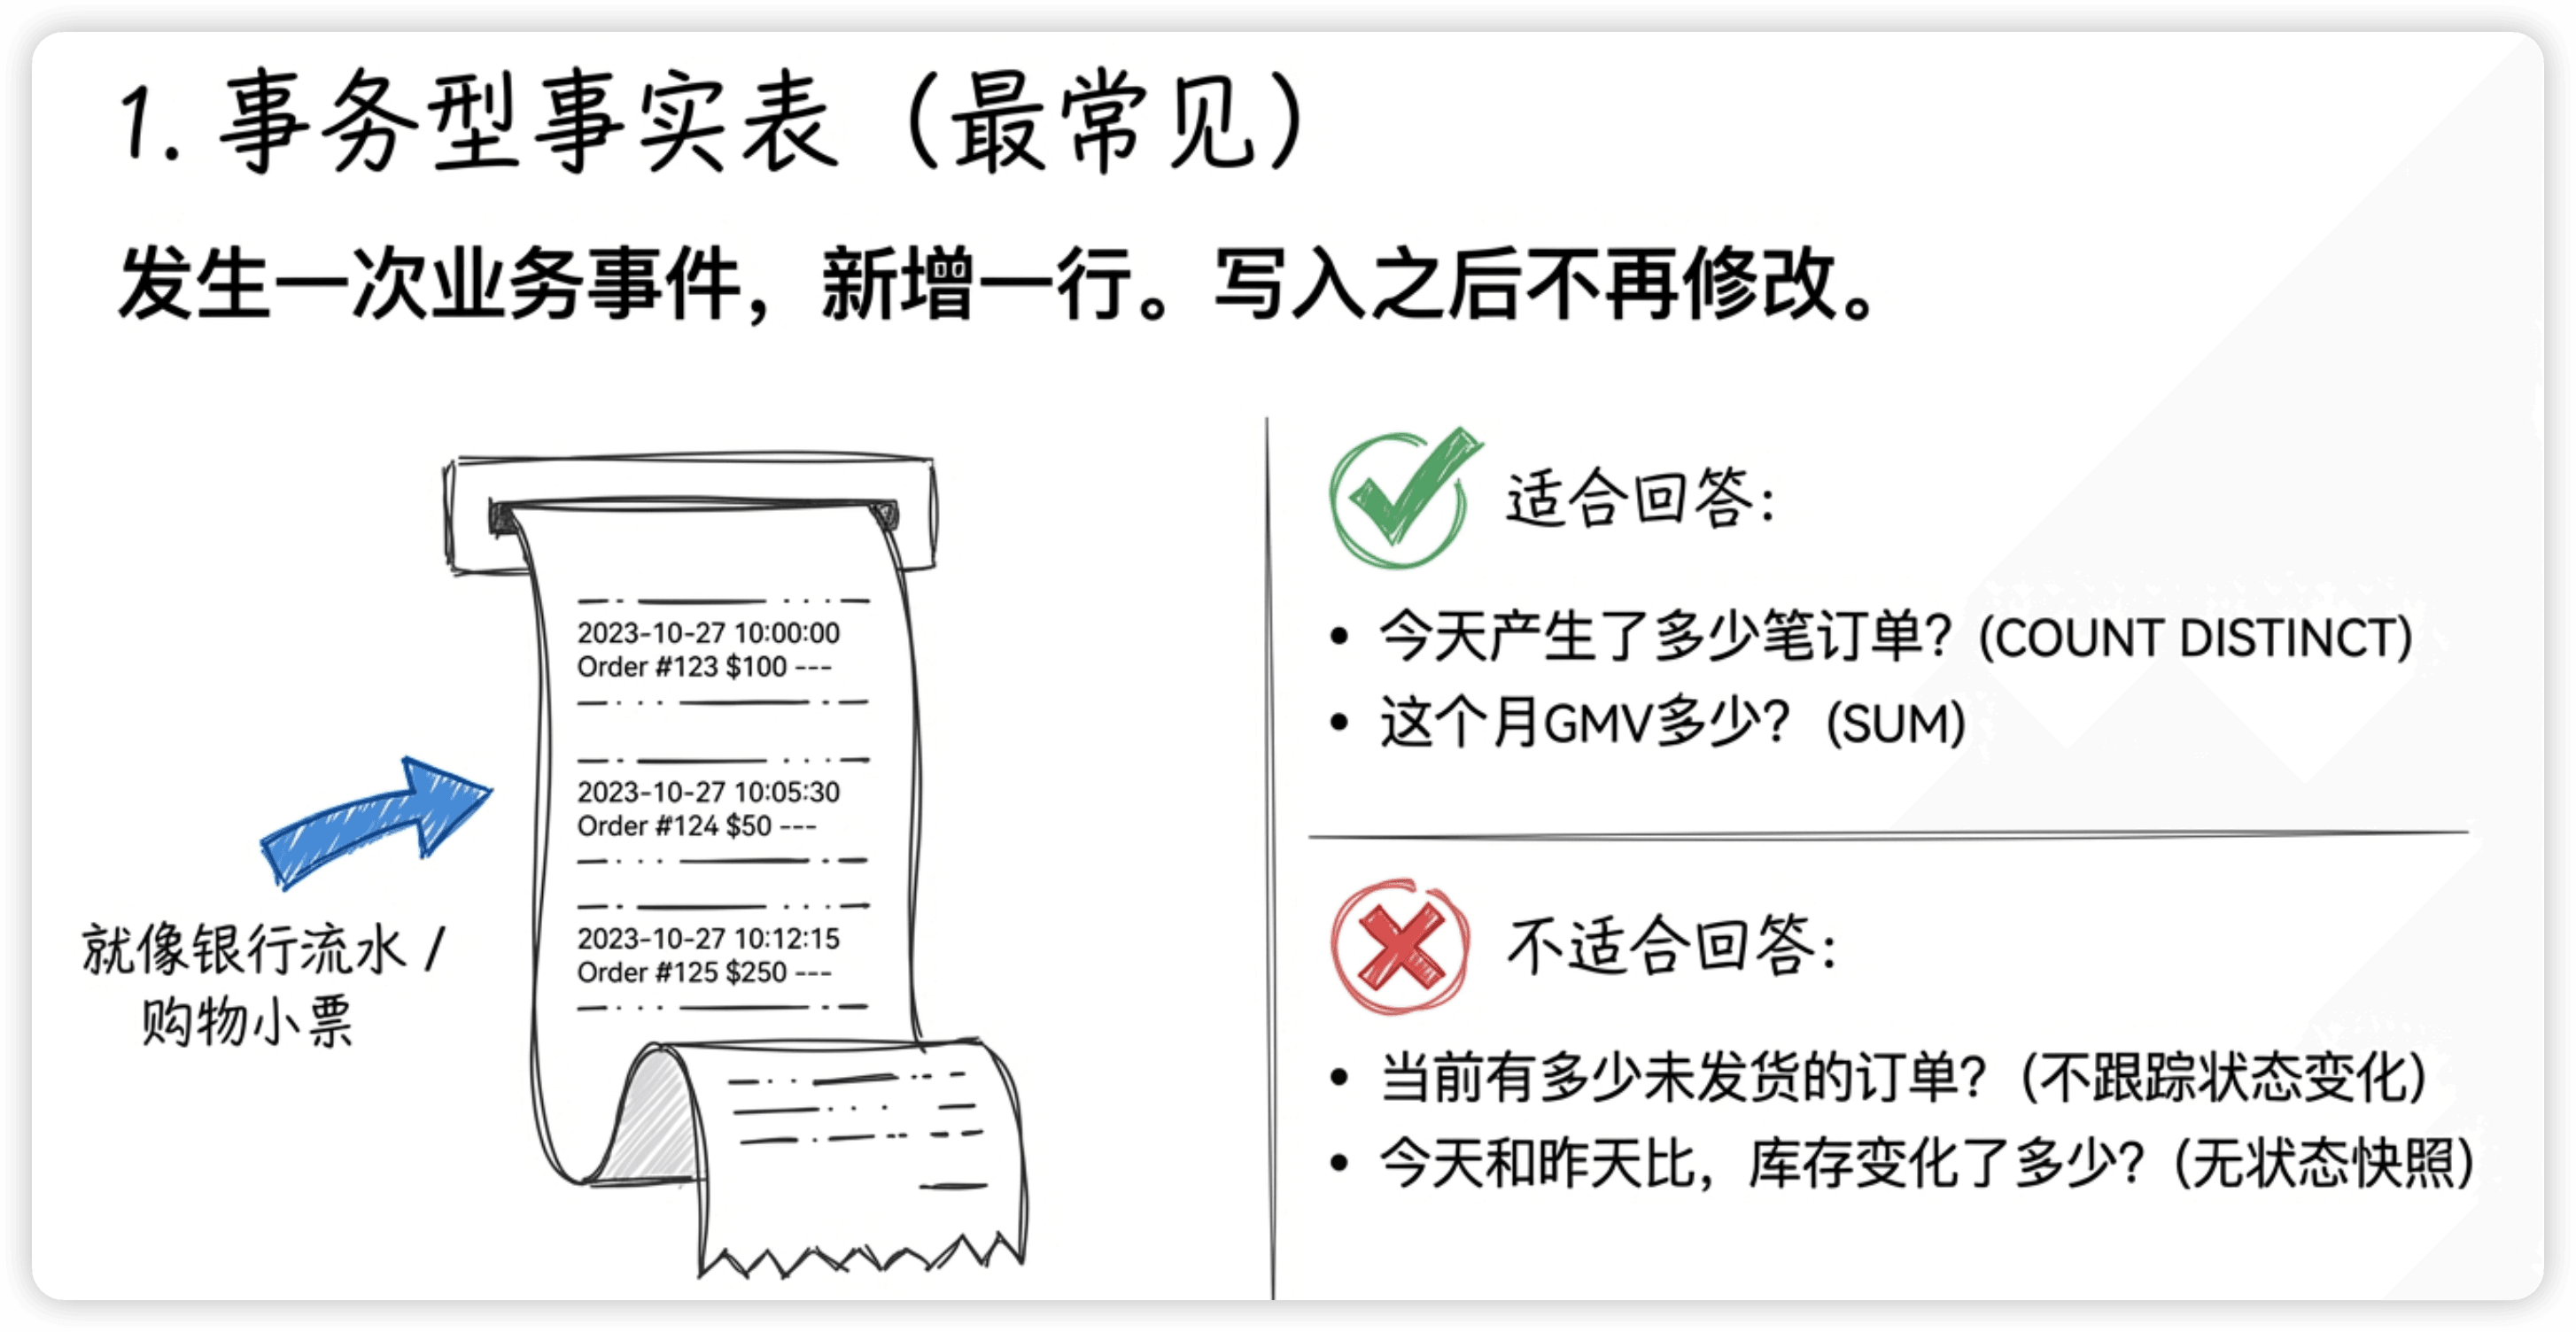
每发生一次业务事件,新增一行记录。写入之后不再修改。
就像银行流水——每笔存取款是一行,存进去就不会改了。你的订单流水表、点击日志、支付记录、广告曝光日志,基本上都是事务型事实表。
建表示例
-- 事务型事实表:订单明细
-- 粒度:一笔订单中的一件商品(注意不是一笔订单)
CREATE TABLE fact_order_detail (
    order_id       BIGINT,        -- 订单ID
    order_detail_id BIGINT,       -- 订单明细ID(业务主键)
    user_id        BIGINT,        -- 维度外键
    product_id     BIGINT,        -- 维度外键
    channel_id     INT,           -- 维度外键
    quantity       INT,           -- 度量:购买数量
    unit_price     DECIMAL(10,2), -- 度量:商品单价
    detail_amount  DECIMAL(10,2), -- 度量:明细金额
    discount       DECIMAL(10,2), -- 度量:优惠金额
    pay_amount     DECIMAL(10,2), -- 度量:实付金额
    order_time     TIMESTAMP,     -- 事件时间
    dt             STRING         -- 分区字段(按天)
);注意粒度声明:这张表的粒度是"一笔订单中的一件商品",不是"一笔订单"。同一个order_id可能有多行。所以统计"订单总金额"时要先按order_id去重,或者另建一张订单粒度的事实表。
适合回答的问题
- 今天产生了多少笔订单?(COUNT DISTINCT order_id)
- 这个月GMV多少?(SUM pay_amount)
- 哪个渠道带来的点击最多?(按channel分组COUNT)
- 某个用户最近买了什么?(WHERE user_id = xxx)
不适合回答的问题
- 当前有多少未发货的订单?——事务型只记录"发生了什么",不跟踪状态变化
- 今天和昨天比,库存变化了多少?——事务型没有"状态快照"的概念
我们短剧出海业务的广告点击事实表就是典型的事务型——每天几千万条点击记录,只追加不更新,按天分区存储。这类日志型数据天然适合事务型事实表。
周期快照型事实表:记录"某个时刻的状态"
核心思想
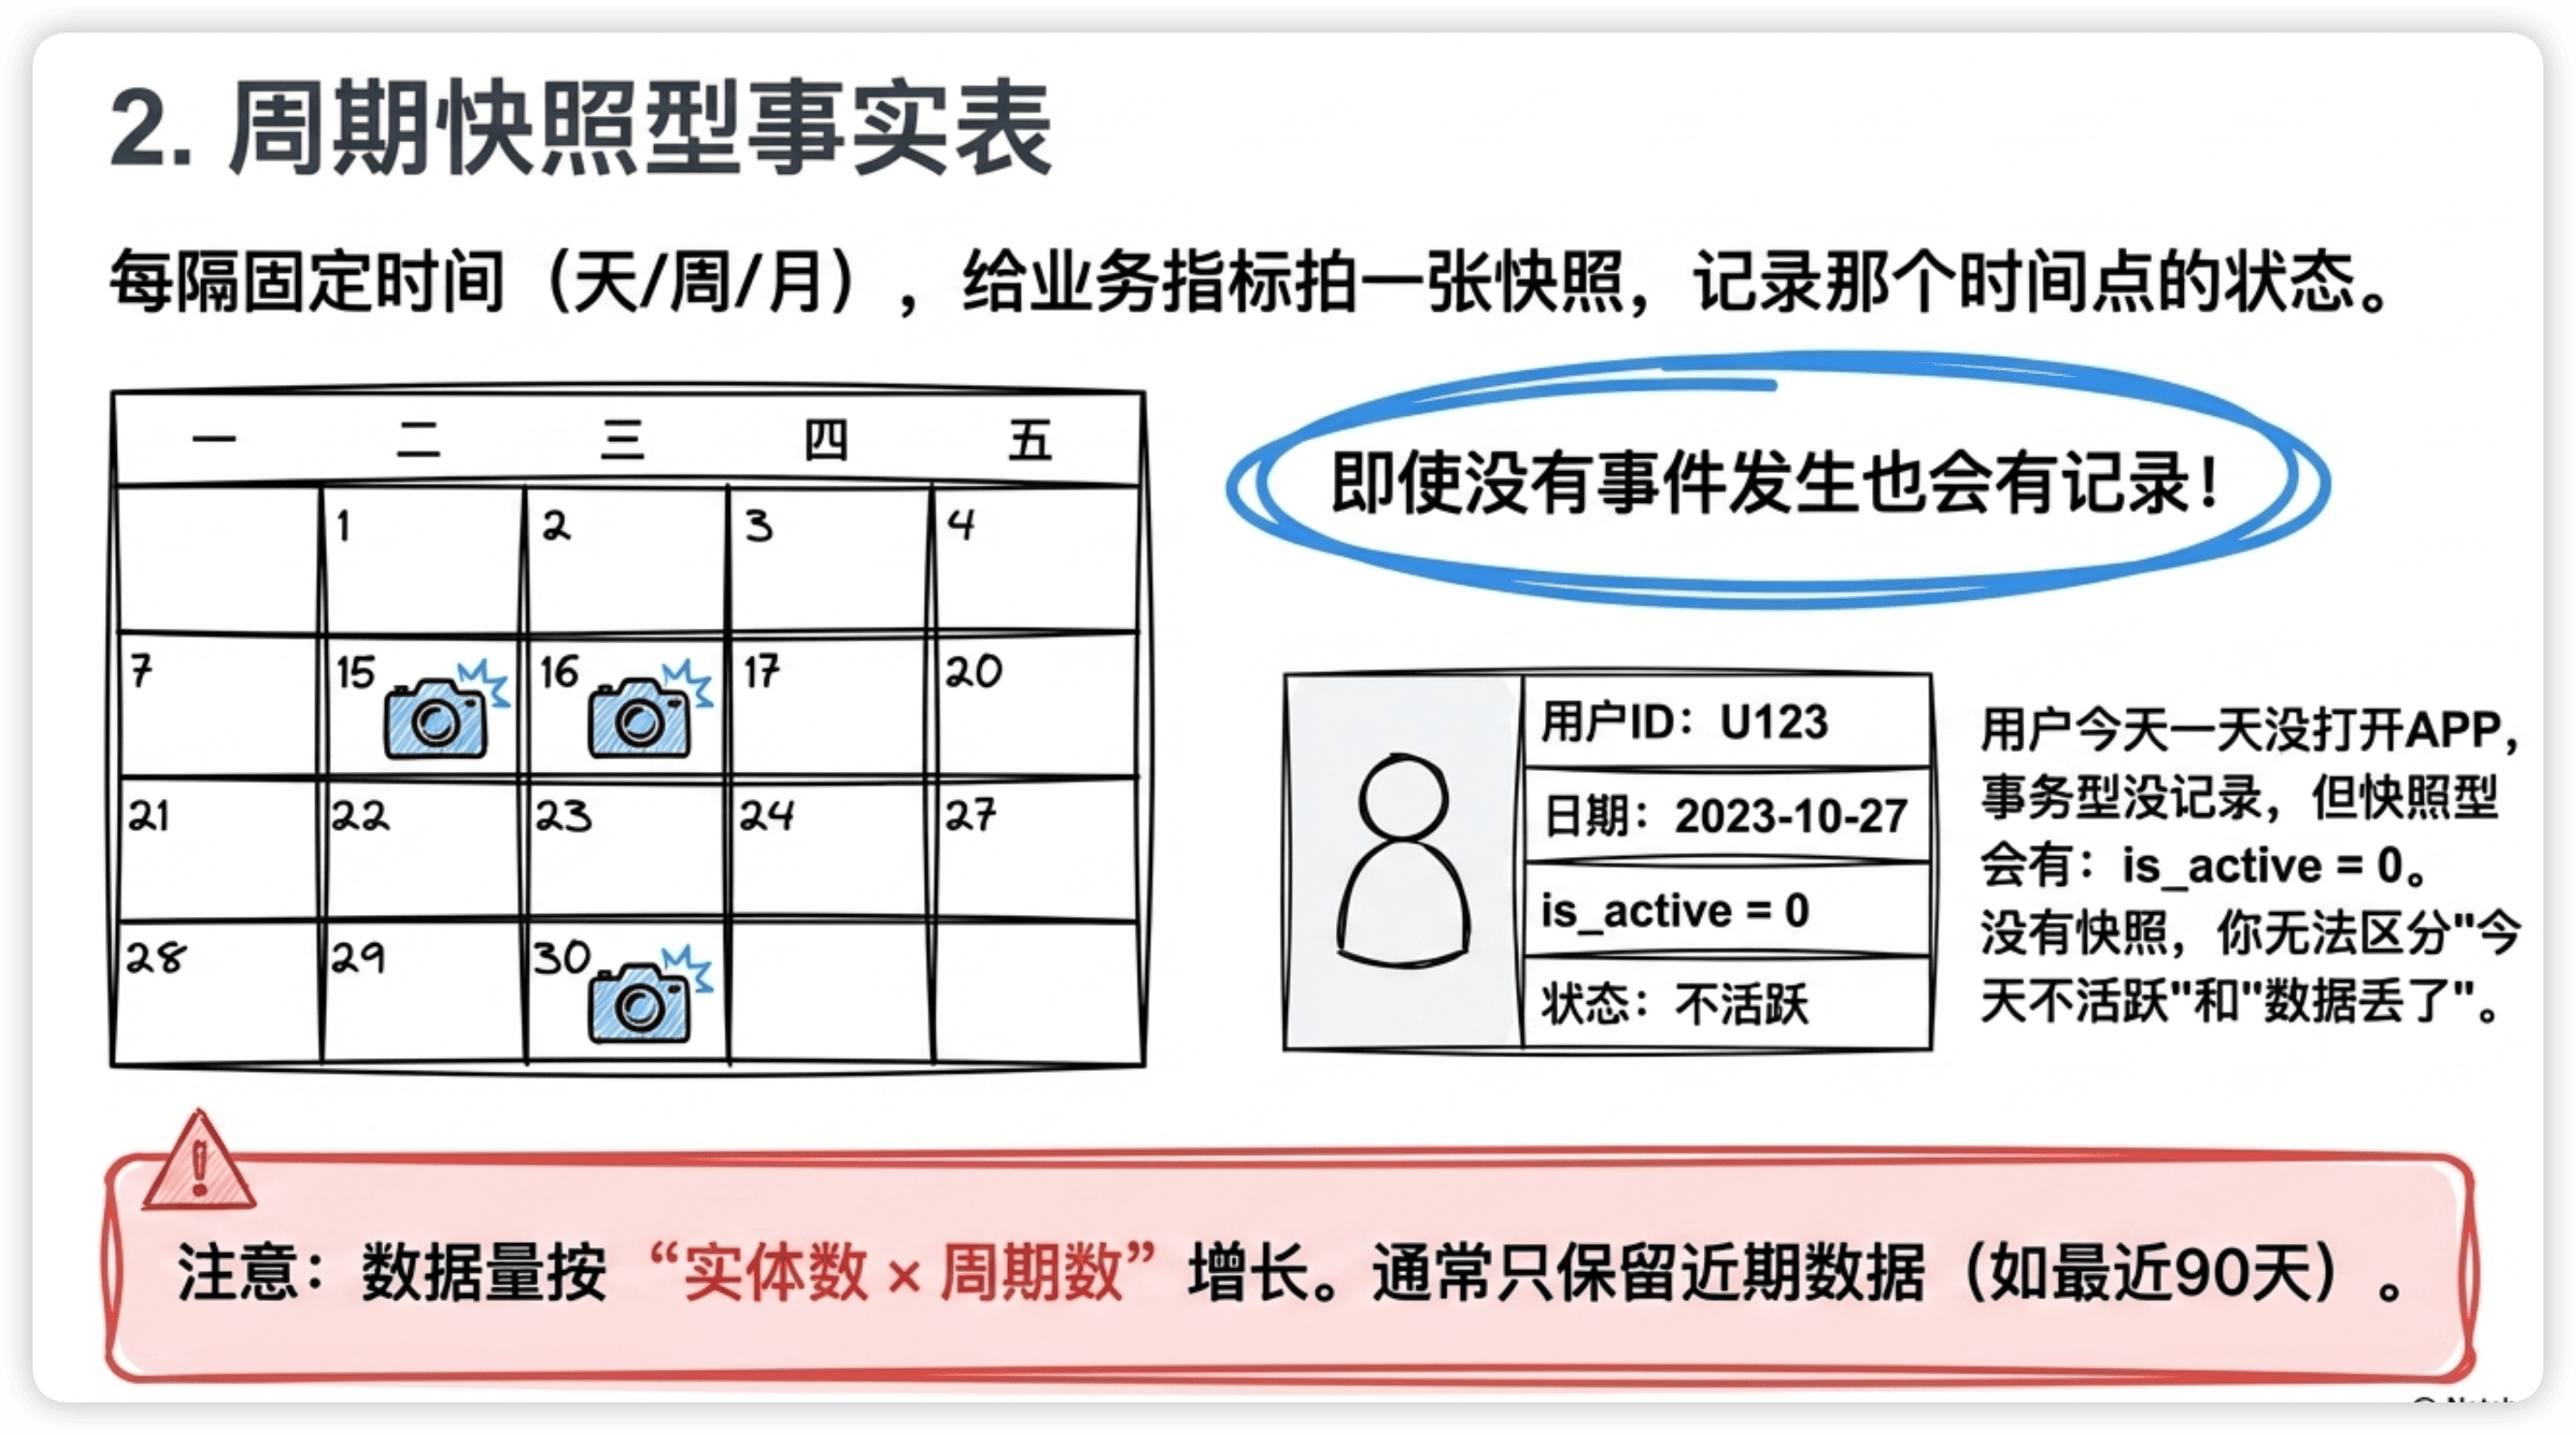
每隔固定时间(天、周、月),给某个业务指标拍一张快照,记录那个时间点的状态。
关键区别:事务型记录的是"发生了什么事件",周期快照型记录的是"在那个时间点状态是什么"。
最直观的例子是银行账户余额。你的余额每天在变,但不一定每天都有交易——也许今天一笔交易都没有,但你的余额依然是一个确定的数字。事务型记录不了"今天没有交易"这件事,但周期快照型可以——不管有没有事件发生,每天都会拍一行快照。
建表示例
-- 周期快照型事实表:用户每日行为汇总
-- 粒度:一个用户 × 一天
-- 快照周期:每天
CREATE TABLE fact_user_active_snapshot_1d (
    user_id          BIGINT,
    snapshot_date    STRING,        -- 快照日期
    is_active        INT,           -- 当天是否活跃(0/1)
    session_cnt      INT,           -- 当天会话次数
    play_duration    BIGINT,        -- 当天播放时长(秒)
    active_days_7d   INT,           -- 最近7天活跃天数
    active_days_30d  INT,           -- 最近30天活跃天数
    total_orders     INT,           -- 累计下单数
    total_pay_amount DECIMAL(10,2), -- 累计支付金额
    user_level       STRING,        -- 当天的用户等级
    dt               STRING         -- 分区字段
);
周期快照型的关键特征
第一,即使没有事件发生也会有记录。
这是和事务型最本质的区别。假设用户张三今天一天都没打开APP,事务型事实表里今天不会有他的记录。但周期快照型里会有一行:is_active = 0, session_cnt = 0, play_duration = 0。
为什么这很重要?因为很多分析需要知道"没有发生"的信息。比如计算"连续不活跃天数"——没有快照记录你就没法判断用户到底是"今天不活跃"还是"数据丢了"。
第二,数据量按"实体数 × 周期数"增长。
如果你有500万用户,每天拍一次快照,一个月就是1.5亿行,一年18亿行。存储成本不低,所以周期快照表通常只保留近期数据(比如最近90天),历史数据归档或降低粒度(周级、月级)。
第三,适合做时间趋势对比。
「这个用户上周和这周的活跃度对比」「这个商品上个月和这个月的库存变化」
这类"不同时间点的状态对比",事务型做起来非常麻烦(需要按时间窗口聚合计算),周期快照型直接查两天的快照就行。
-- 对比用户上周和这周的活跃情况
SELECT
    a.user_id,
    a.active_days_7d AS last_week_active_days,
    b.active_days_7d AS this_week_active_days,
    b.active_days_7d - a.active_days_7d AS change
FROM fact_user_active_snapshot_1d a
JOIN fact_user_active_snapshot_1d b
  ON a.user_id = b.user_id
WHERE a.snapshot_date = '2025-01-08'  -- 上周
  AND b.snapshot_date = '2025-01-15'; -- 这周
累积快照型事实表:跟踪全生命周期
核心思想
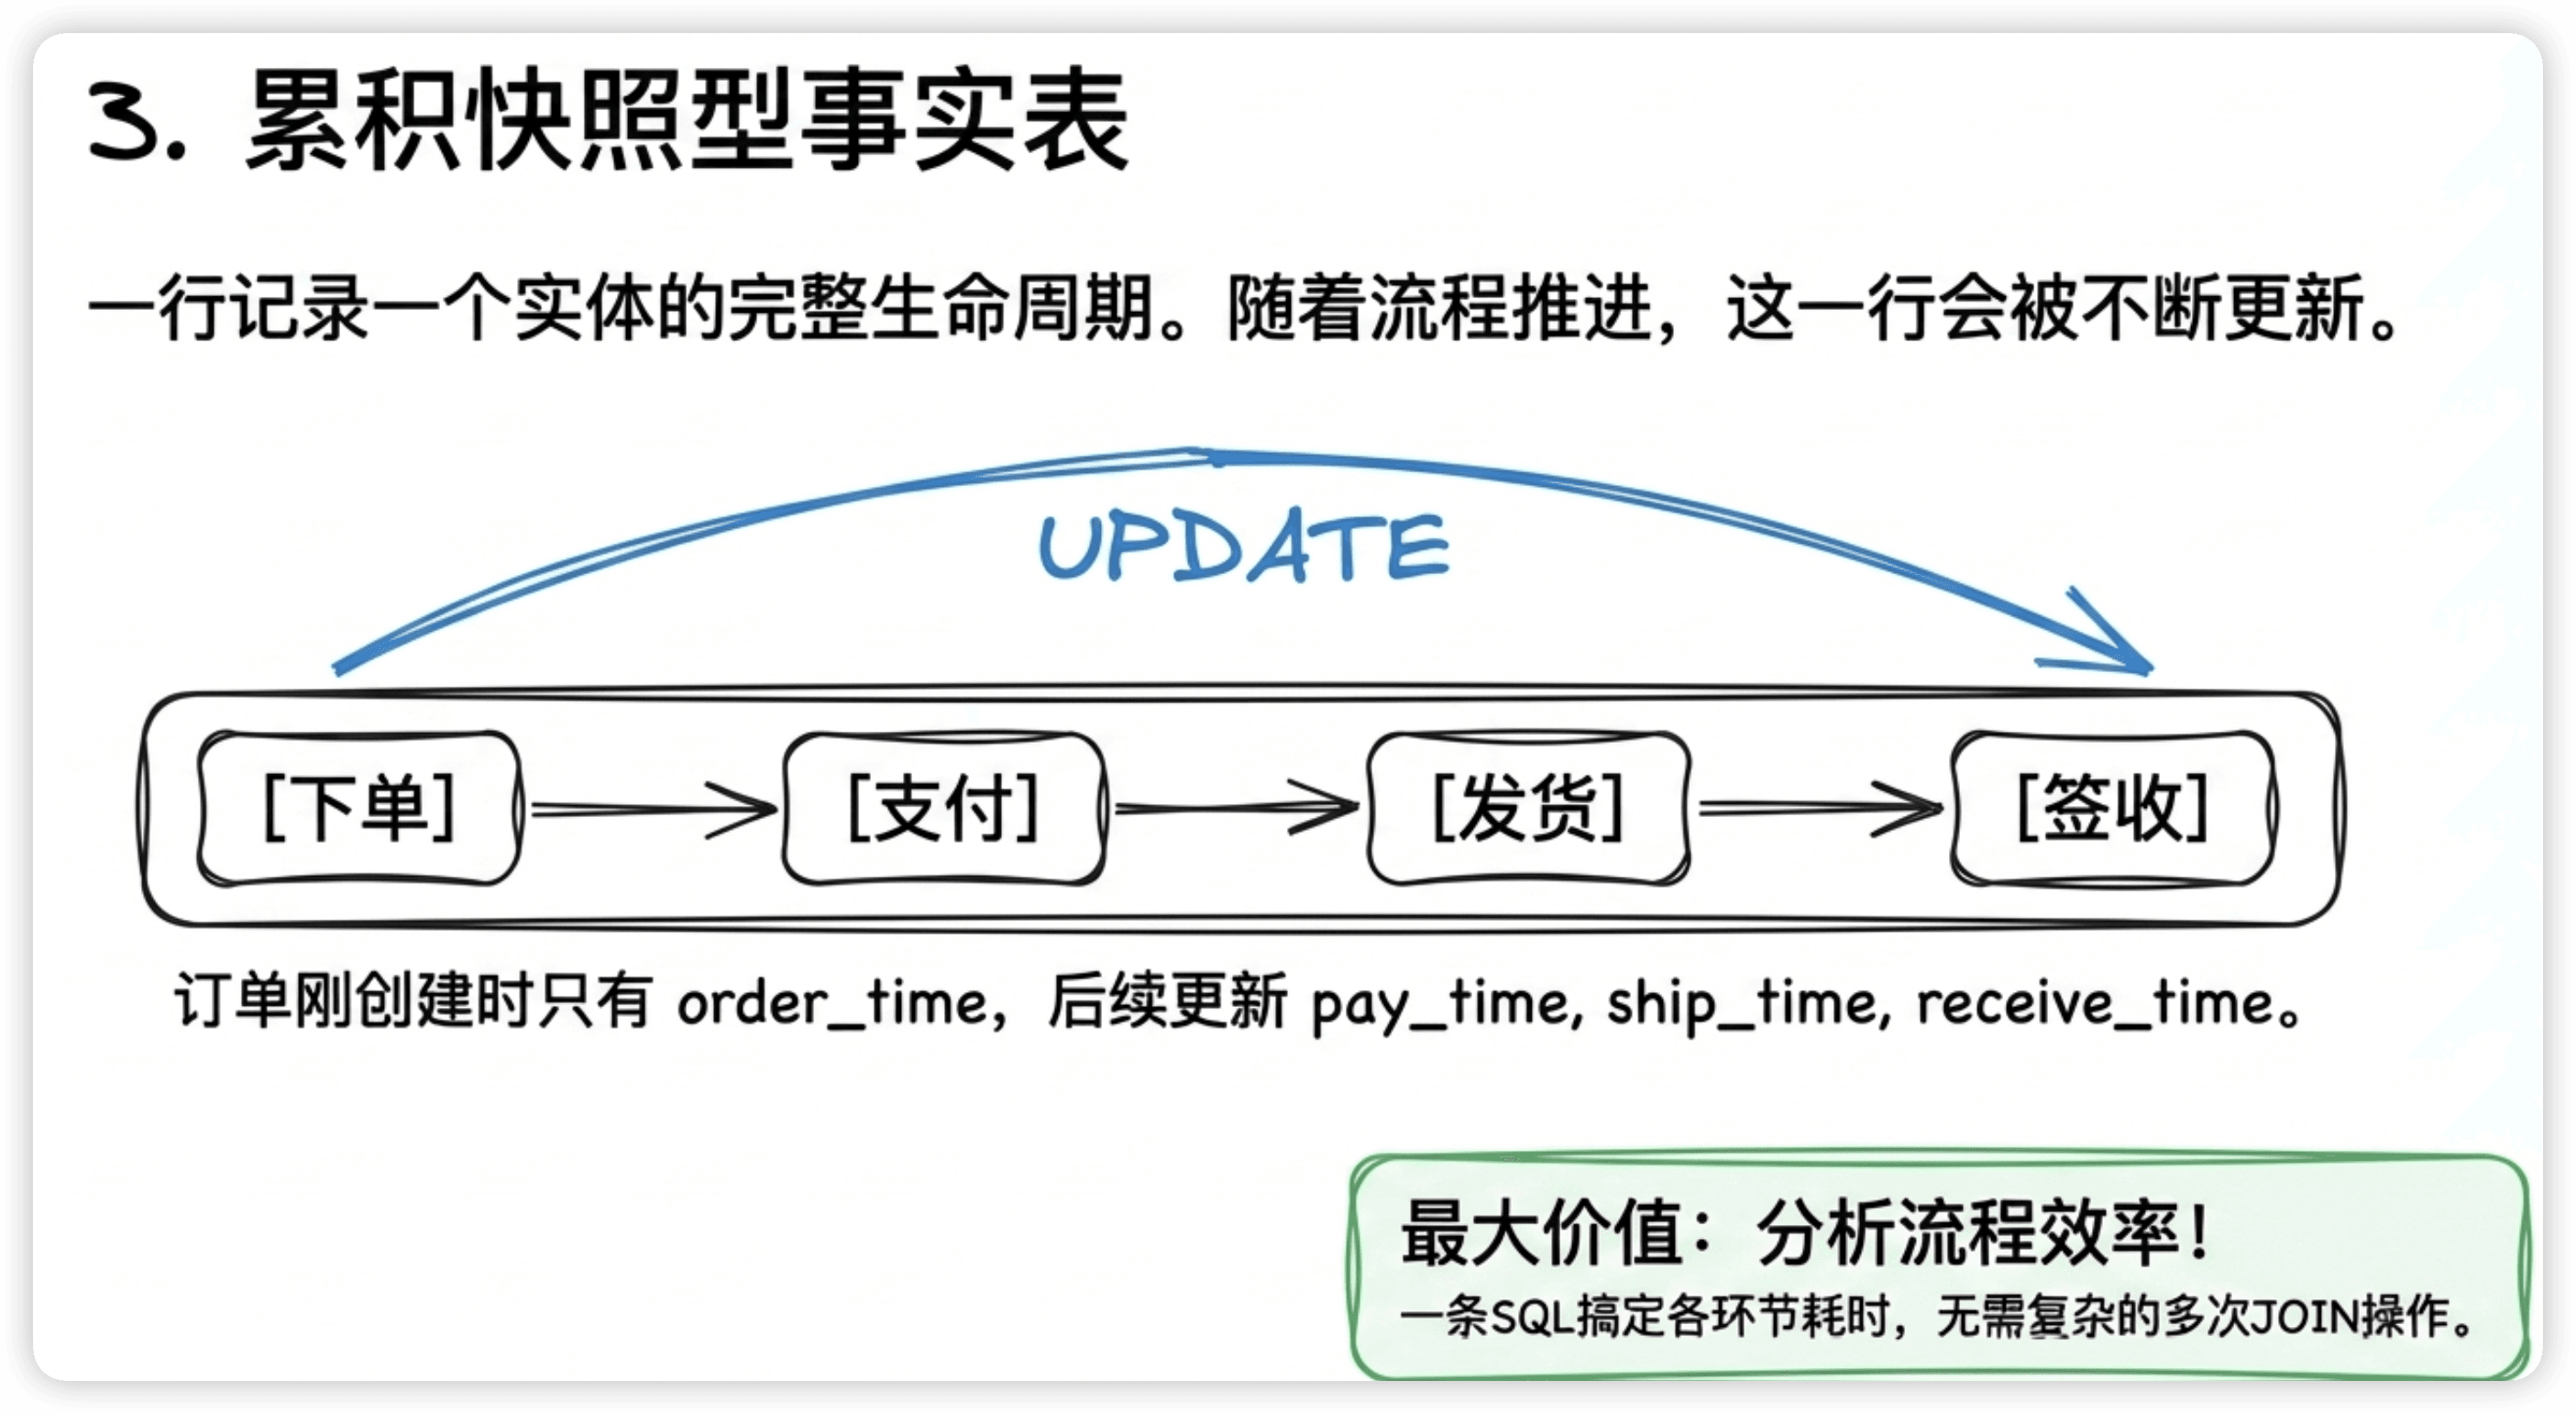
一行记录一个业务实体的完整生命周期,包含多个里程碑时间节点。随着流程推进,这一行会被不断更新。
最典型的场景:订单履约流程。一个订单从下单→支付→发货→签收,经历4个阶段,每个阶段发生时更新对应的时间字段。
建表示例
-- 累积快照型事实表:订单履约跟踪
-- 粒度:一个订单(全生命周期只有一行)
CREATE TABLE fact_order_lifecycle (
    order_id       BIGINT,
    user_id        BIGINT,
    product_id     BIGINT,
    order_time     TIMESTAMP,     -- 里程碑1:下单时间
    pay_time       TIMESTAMP,     -- 里程碑2:支付时间(初始为NULL)
    ship_time      TIMESTAMP,     -- 里程碑3:发货时间(初始为NULL)
    receive_time   TIMESTAMP,     -- 里程碑4:签收时间(初始为NULL)
    cancel_time    TIMESTAMP,     -- 里程碑X:取消时间(可选)
    order_status   STRING,        -- 当前状态
    order_amount   DECIMAL(10,2),
    dt             STRING
);订单刚创建时,只有order_time有值,其他里程碑字段都是NULL。支付了之后更新pay_time,发货了更新ship_time,签收了更新receive_time。
累积快照型的价值
它最大的价值是分析流程效率:
-- 分析各环节耗时
SELECT
    AVG(UNIX_TIMESTAMP(pay_time) - UNIX_TIMESTAMP(order_time)) / 60
        AS avg_order_to_pay_minutes,      -- 下单到支付平均多少分钟
    AVG(UNIX_TIMESTAMP(ship_time) - UNIX_TIMESTAMP(pay_time)) / 3600
        AS avg_pay_to_ship_hours,         -- 支付到发货平均多少小时
    AVG(UNIX_TIMESTAMP(receive_time) - UNIX_TIMESTAMP(ship_time)) / 86400
        AS avg_ship_to_receive_days       -- 发货到签收平均多少天
FROM fact_order_lifecycle
WHERE receive_time IS NOT NULL            -- 只看已签收的订单
  AND dt >= '2025-01-01';
这种分析用事务型事实表也能做,但需要多次JOIN(订单表JOIN支付表JOIN发货表JOIN签收表),逻辑复杂且性能差。累积快照型把所有里程碑放在一行里,一条SQL就搞定。
实现上的注意事项
累积快照型事实表需要更新,但Hive/Spark这类离线数仓不支持行级UPDATE。通常的做法是:
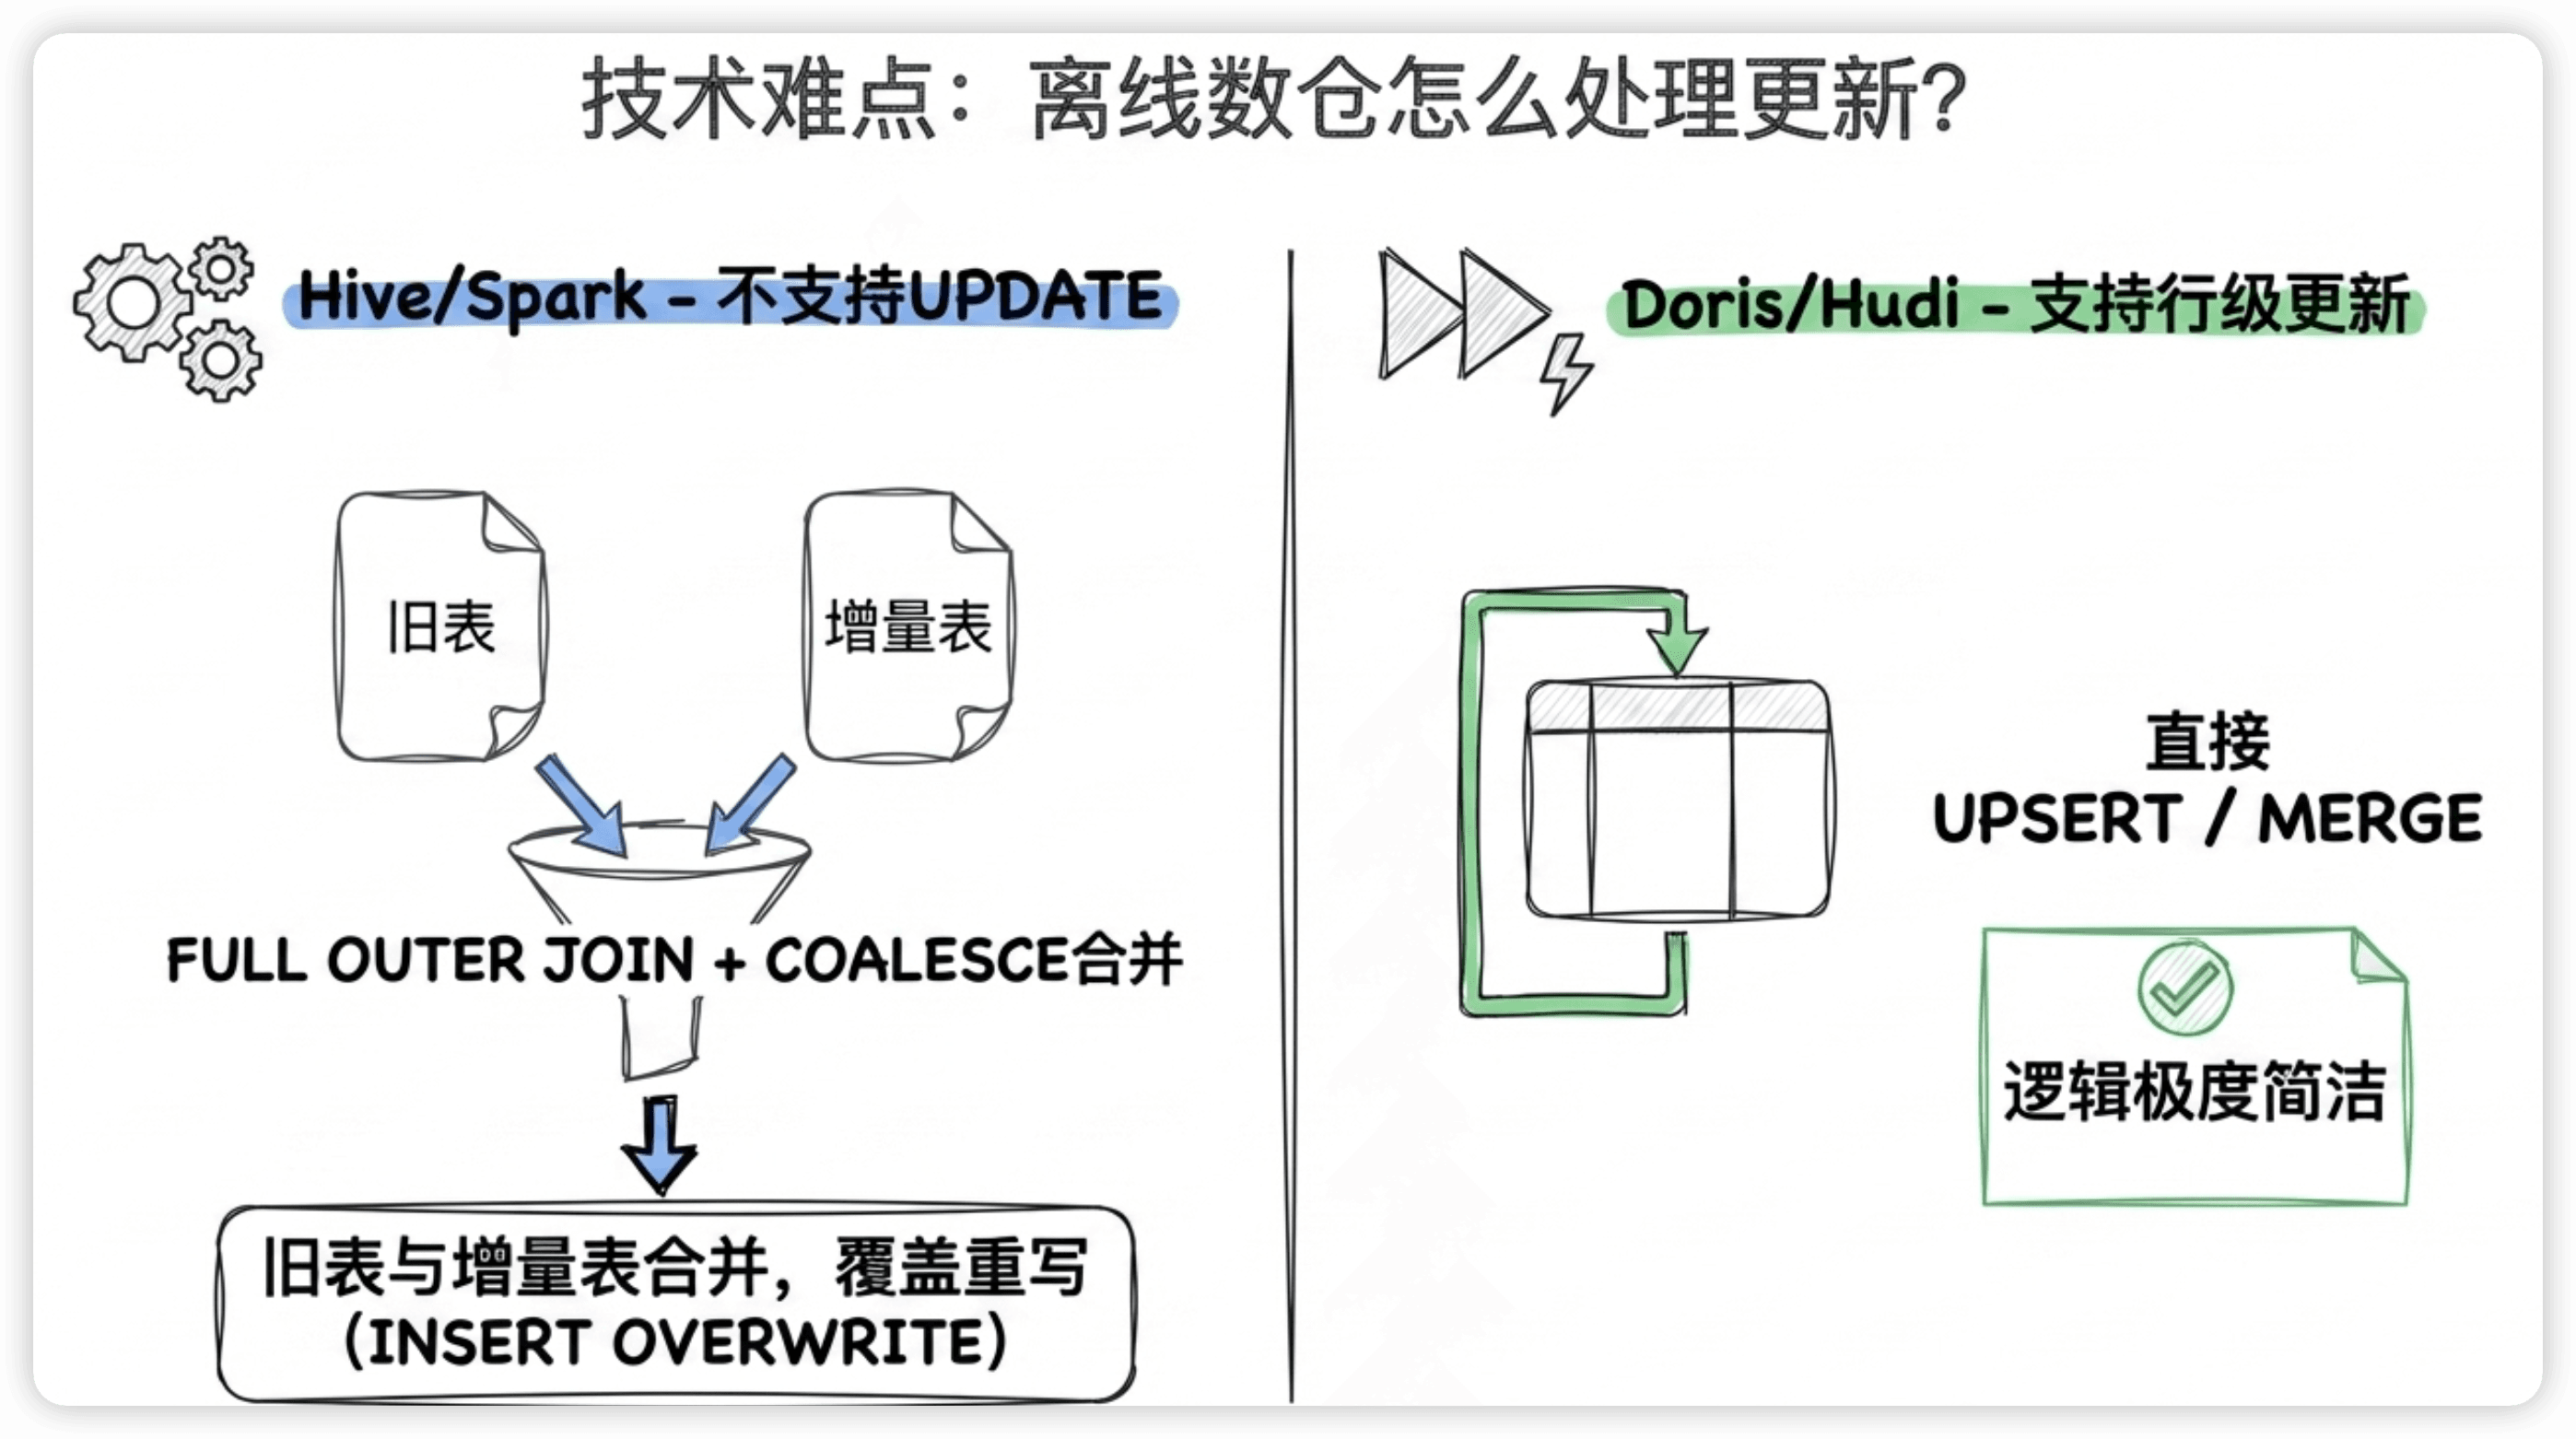
-- 每天用INSERT OVERWRITE重跑
INSERT OVERWRITE TABLE fact_order_lifecycle PARTITION (dt)
SELECT
    COALESCE(new.order_id, old.order_id) AS order_id,
    COALESCE(new.user_id, old.user_id) AS user_id,
    COALESCE(new.product_id, old.product_id) AS product_id,
    COALESCE(old.order_time, new.order_time) AS order_time,
    -- 里程碑字段:如果已经有值就保留旧值,否则用新值
    COALESCE(old.pay_time, new.pay_time) AS pay_time,
    COALESCE(old.ship_time, new.ship_time) AS ship_time,
    COALESCE(old.receive_time, new.receive_time) AS receive_time,
    COALESCE(new.cancel_time, old.cancel_time) AS cancel_time,
    COALESCE(new.order_status, old.order_status) AS order_status,
    COALESCE(old.order_amount, new.order_amount) AS order_amount,
    COALESCE(new.dt, old.dt) AS dt
FROM fact_order_lifecycle old
FULL OUTER JOIN ods_order_update new
  ON old.order_id = new.order_id;
核心逻辑是FULL OUTER JOIN + COALESCE:旧表和增量表合并,里程碑字段取"第一次出现的值"。
如果用Doris、Hudi这类支持行级更新的引擎,就简单多了,直接UPSERT就行。
三种事实表怎么选?一个判断框架
拿到一个业务需求时,按照这个决策路径来判断:
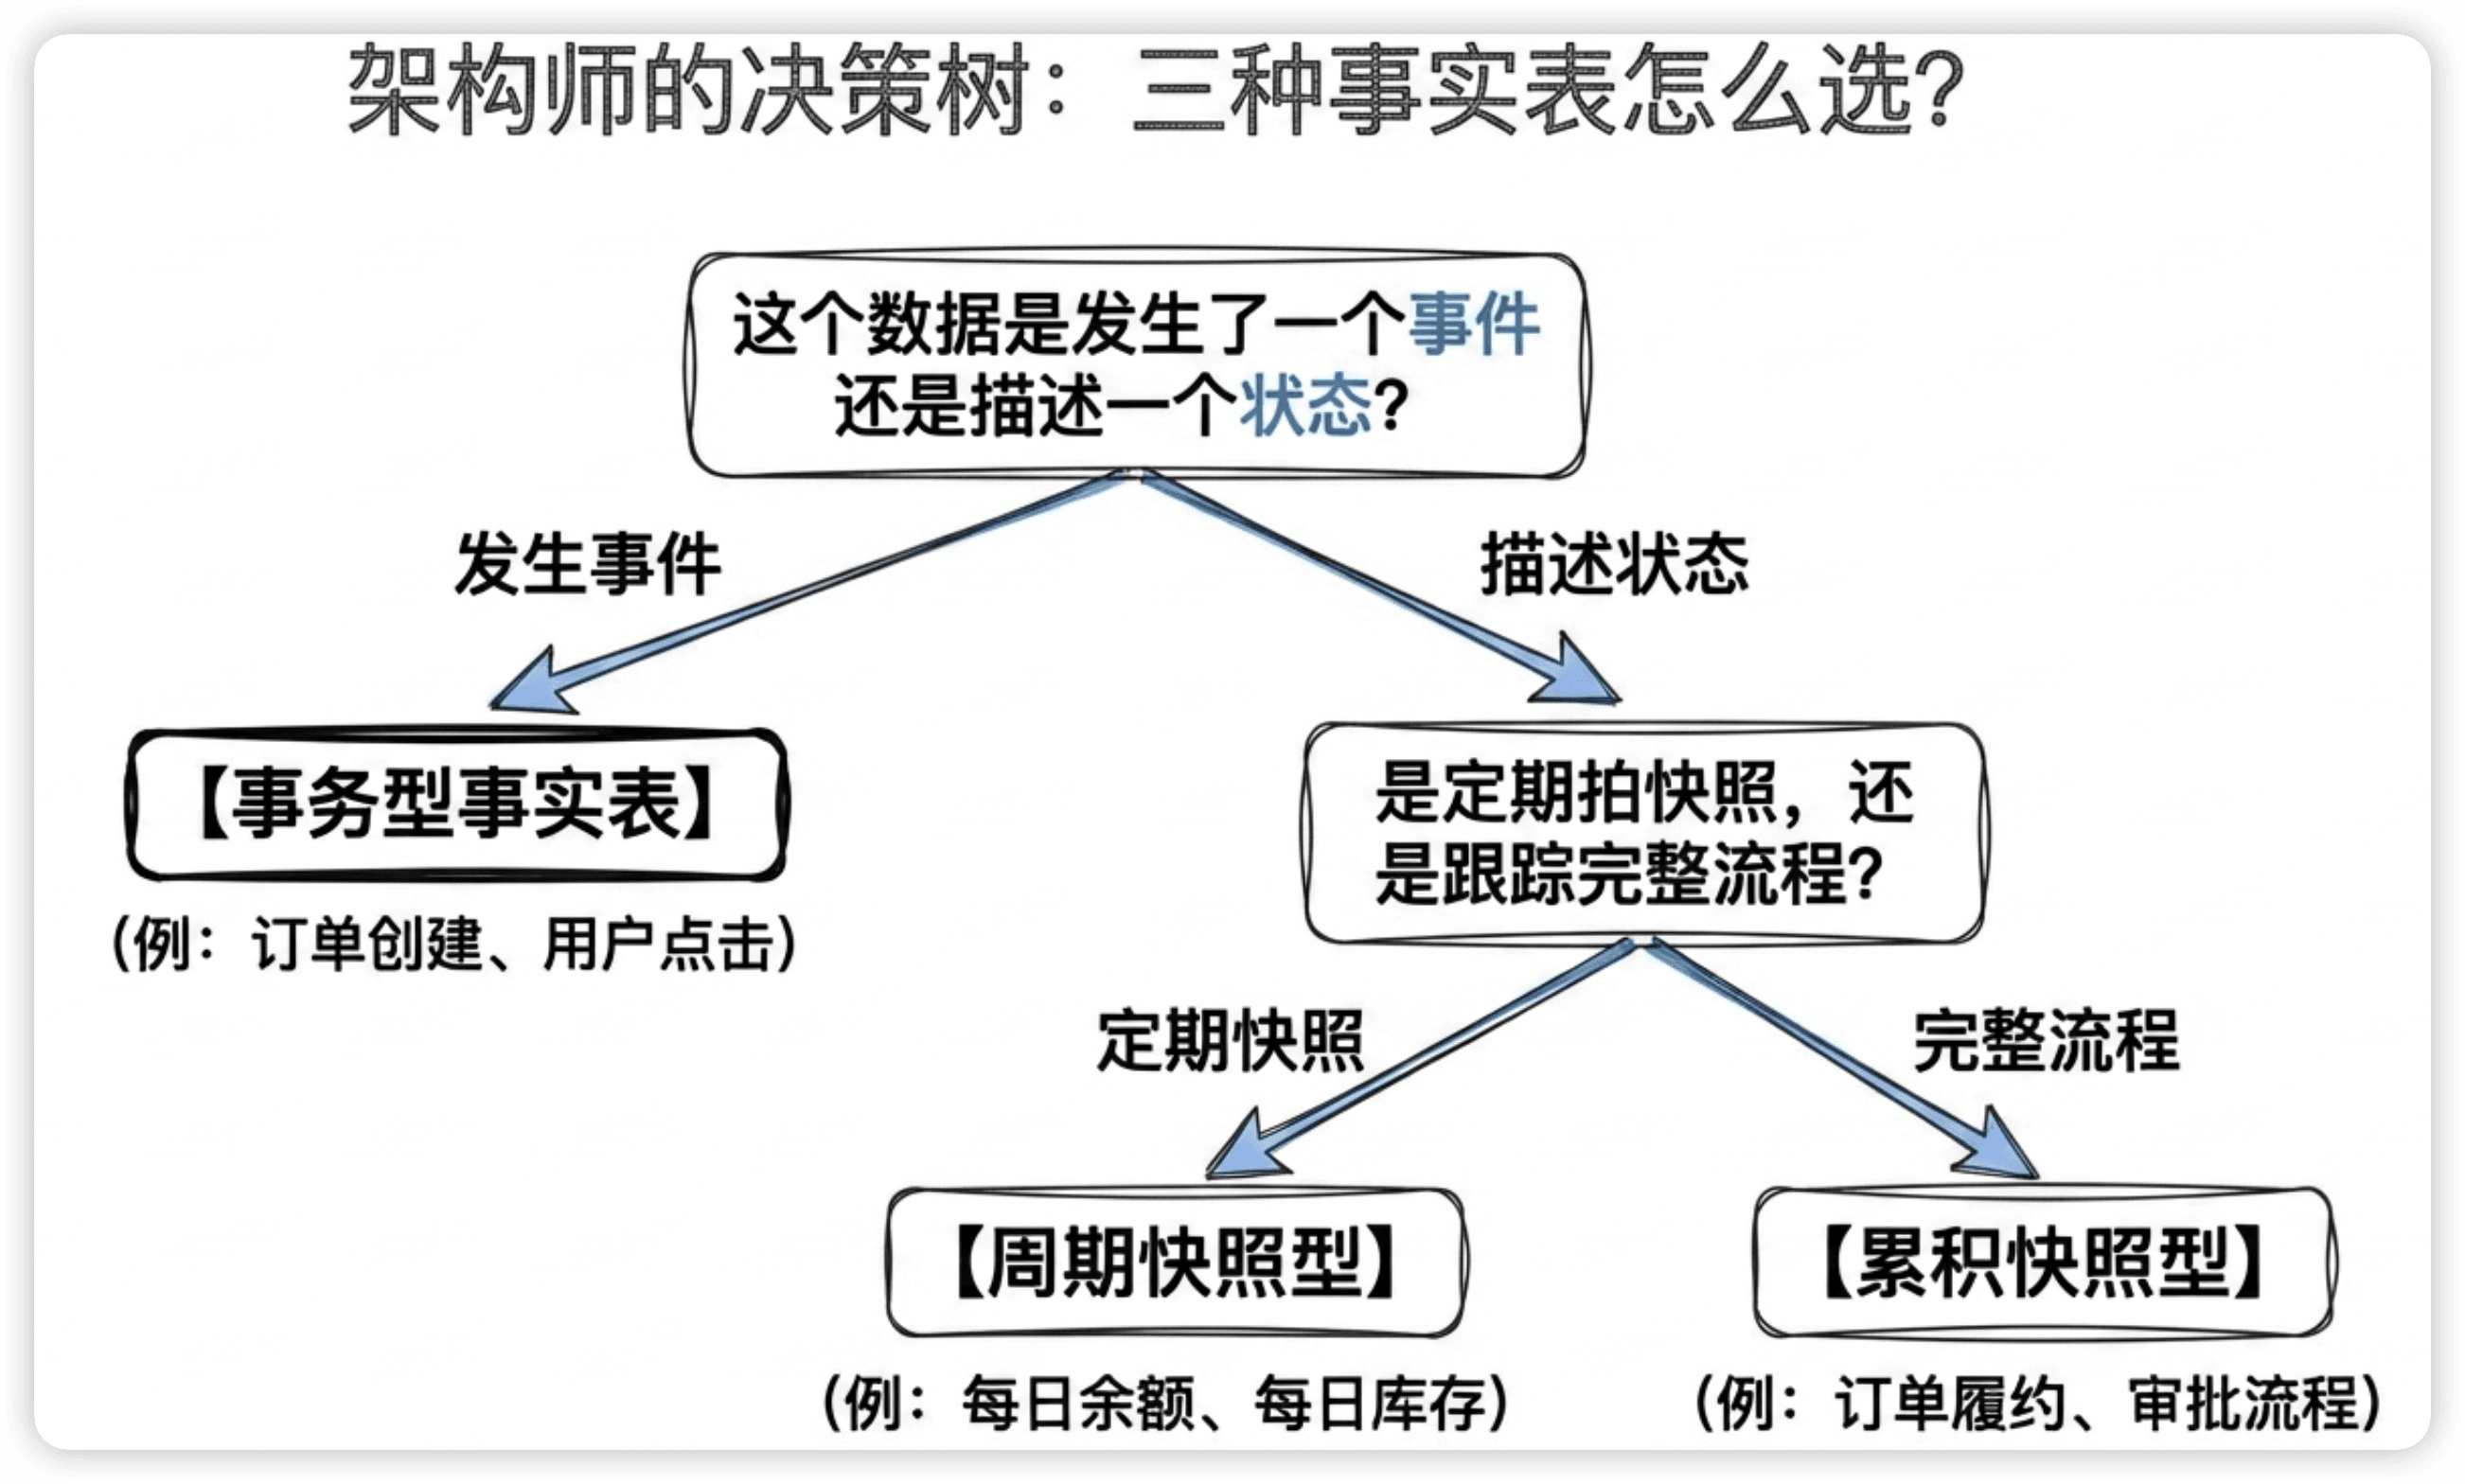
问题1:这个数据是"发生了一个事件"还是"描述一个状态"?
- 发生了一个事件 → 事务型(订单创建、用户点击、支付完成)
- 描述一个状态 → 继续问下一个问题
问题2:这个状态是定期拍快照,还是跟踪一个完整流程?
- 定期拍快照 → 周期快照型(每日余额、每日库存、每日活跃度)
- 跟踪完整流程 → 累积快照型(订单从下单到签收、审批从提交到通过)
                  业务需求
                    │
            ┌───────┴───────┐
          事件型            状态型
            │           ┌───┴───┐
         事务型       定期拍快照  跟踪流程
                        │         │
                   周期快照型   累积快照型
同一个业务可以有多种事实表
这一点非常重要,也是面试加分项。同一个订单业务,完全可以建三张不同类型的事实表:
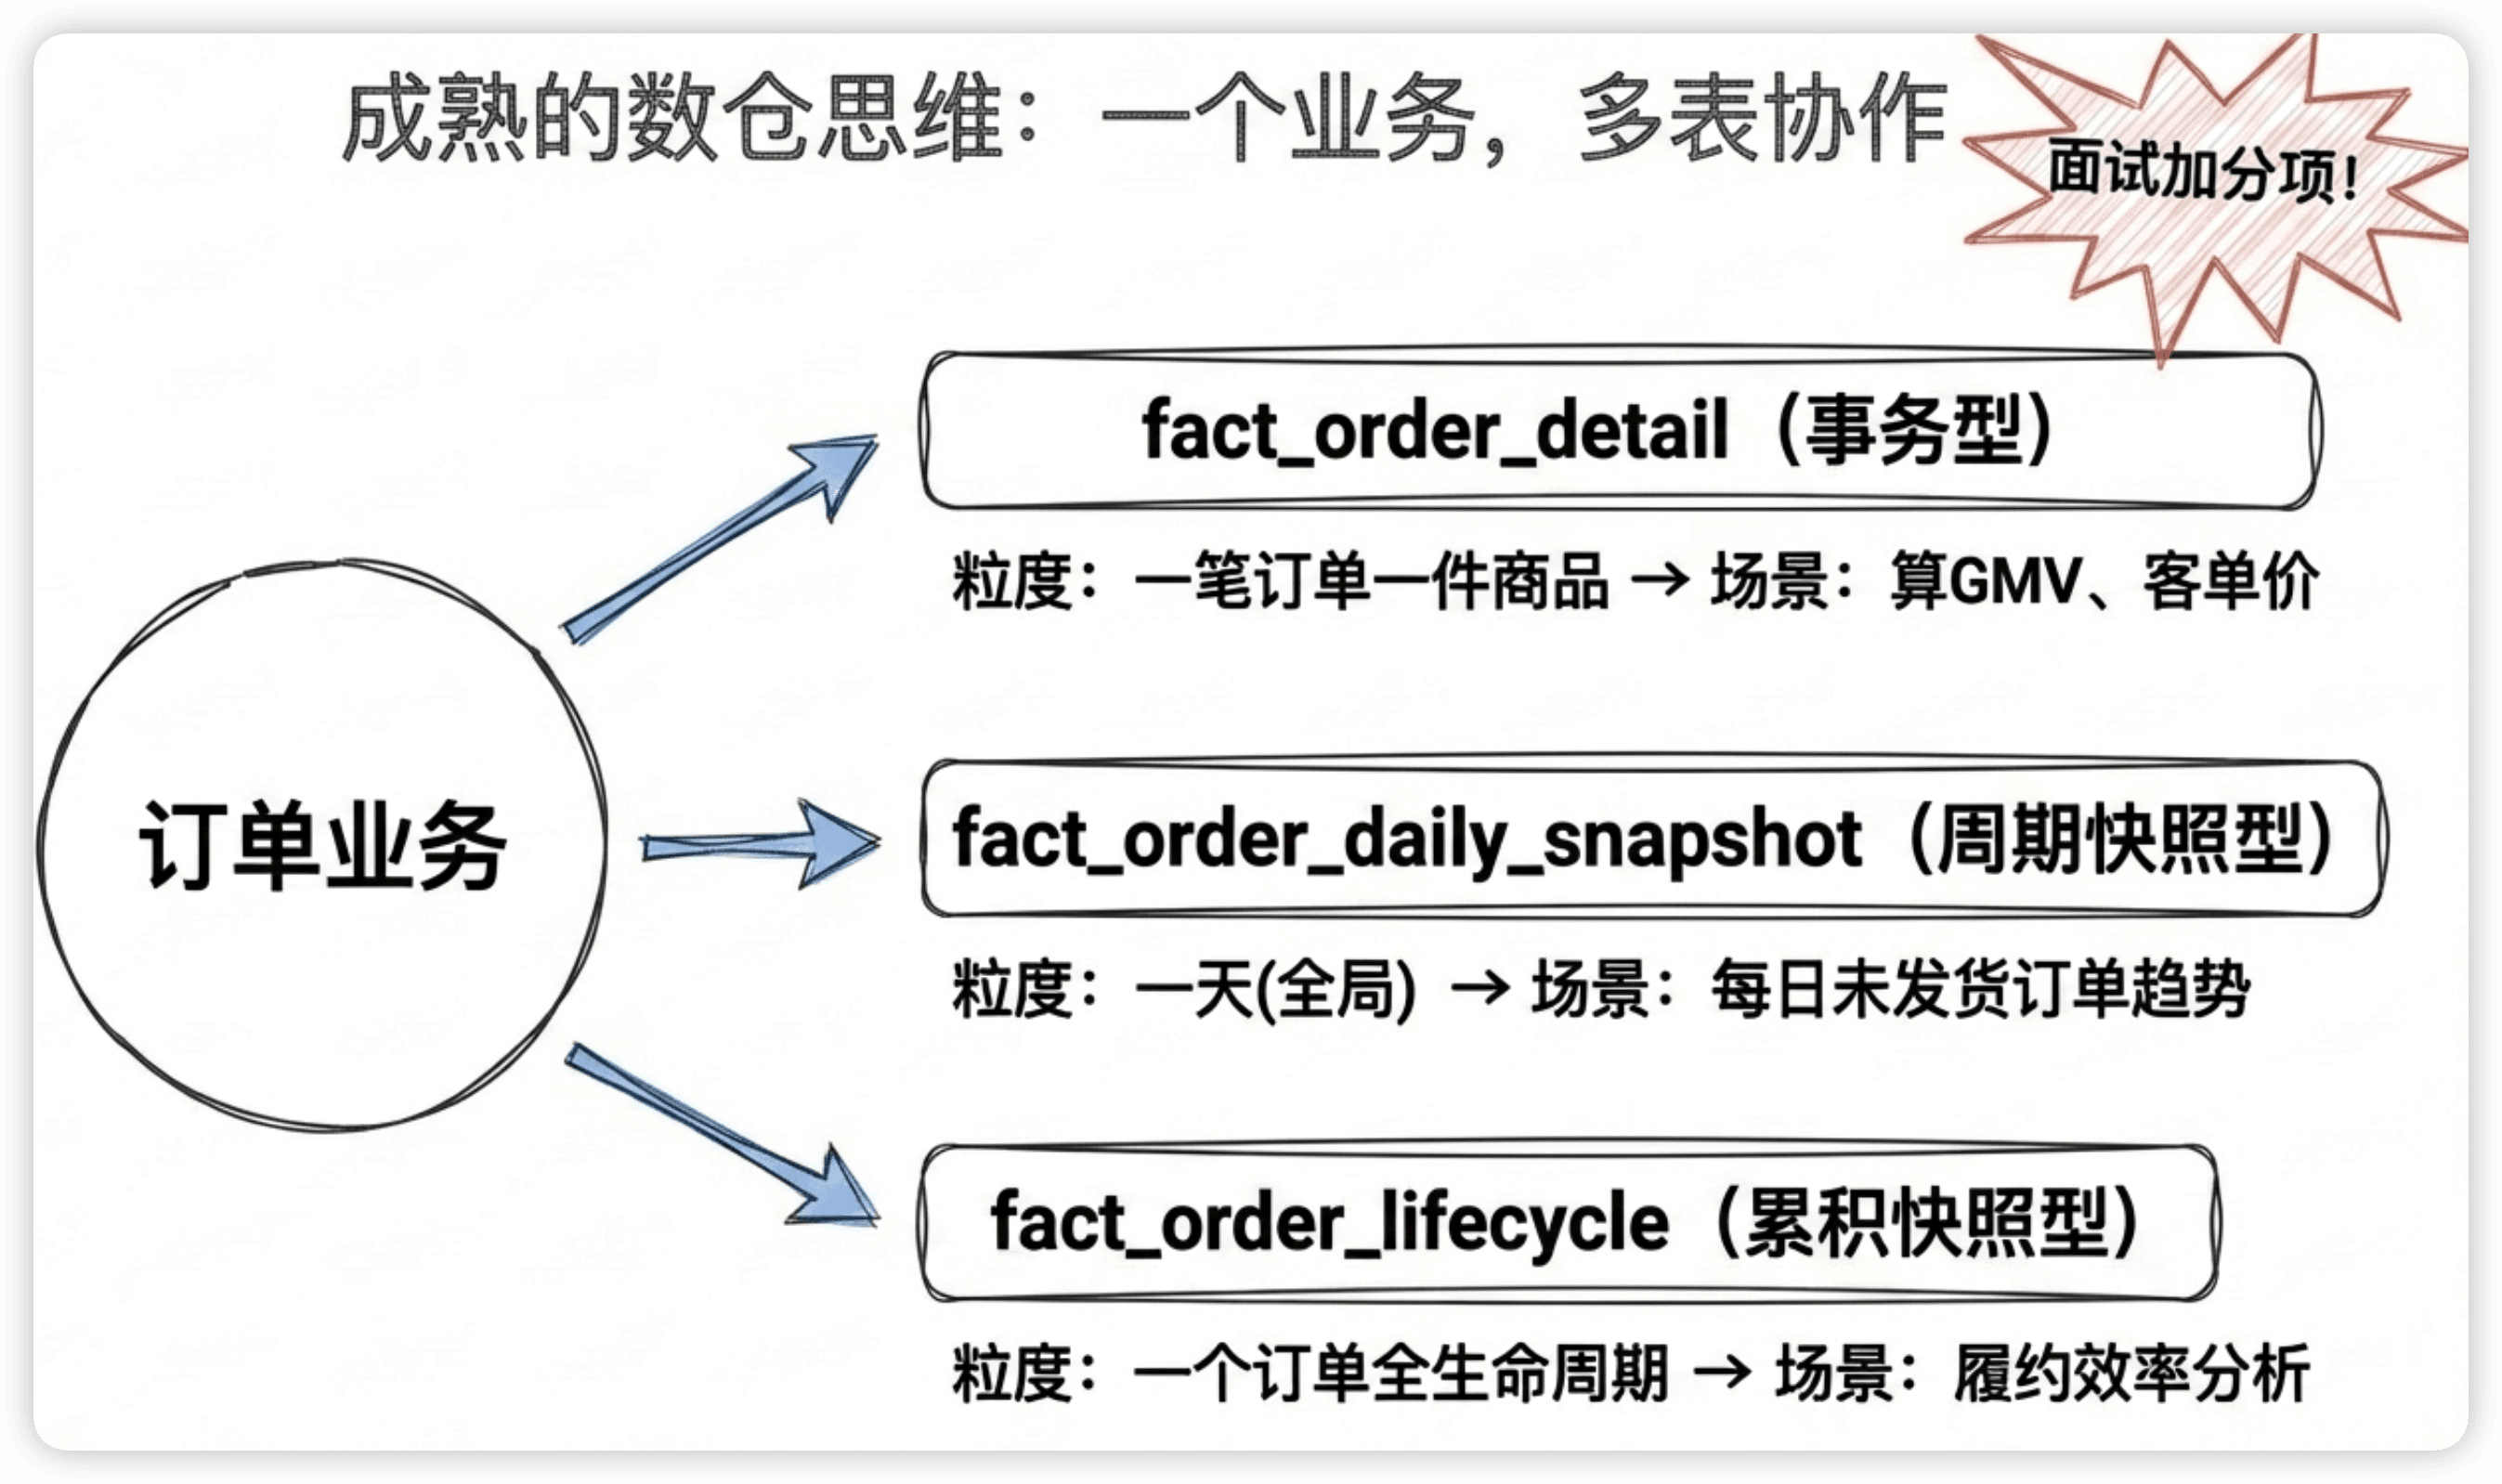
| 表名 | 类型 | 粒度 | 服务的分析场景 |
|---|---|---|---|
| fact_order_detail | 事务型 | 一笔订单×一件商品 | GMV、客单价、商品销售排名 |
| fact_order_daily_snapshot | 周期快照型 | 一天(全局) | 每日订单状态分布、未发货订单趋势 |
| fact_order_lifecycle | 累积快照型 | 一个订单全生命周期 | 履约效率、各环节耗时分析 |
面试怎么答?
高分回答模板
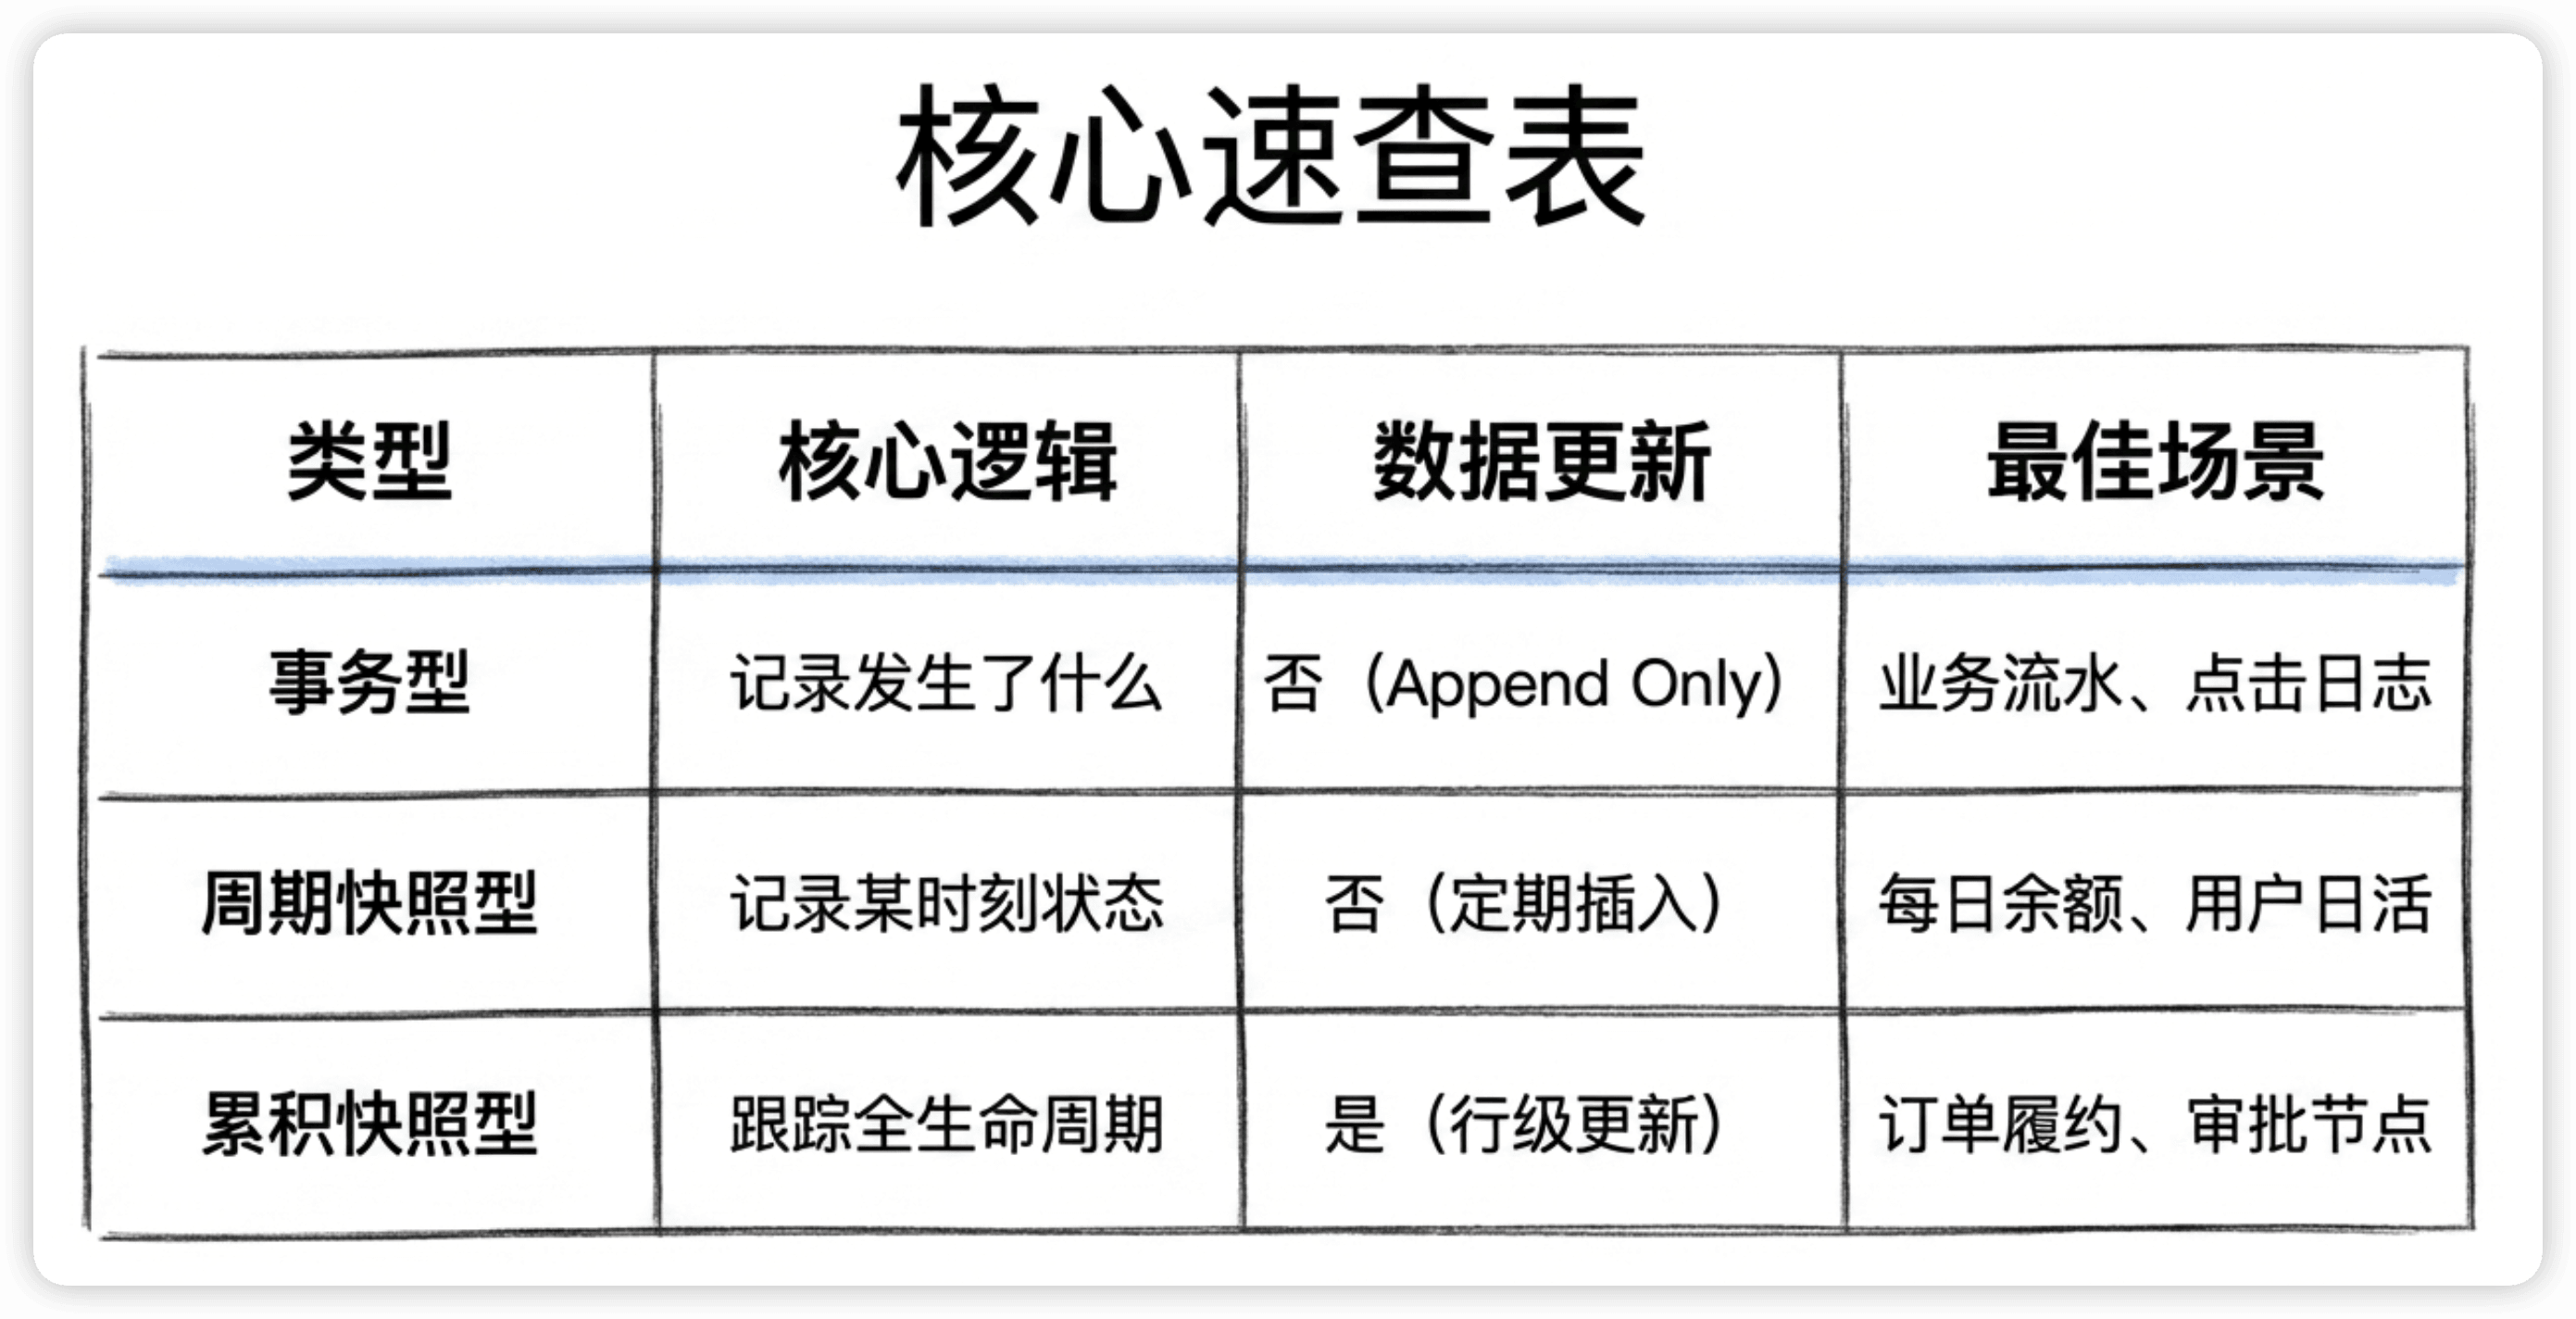
「事实表有三种类型。事务型最常见,一个事件一行,不更新,我们的订单明细表和点击日志都是这种。周期快照型是定期拍快照记录状态,比如我们有一张用户日活快照表,每天每个用户一行,即使当天不活跃也有记录,用来做活跃度趋势分析。累积快照型跟踪业务全生命周期,比如我们的订单履约表,一个订单一行,从下单到签收的时间都在一行里,用来分析履约效率。」
「同一个业务域我们建了多种事实表——订单相关就有3张:一张事务型的明细表看GMV,一张快照型的看订单状态分布,一张累积型的看履约效率。不同分析需求用不同的表。」
追问防线
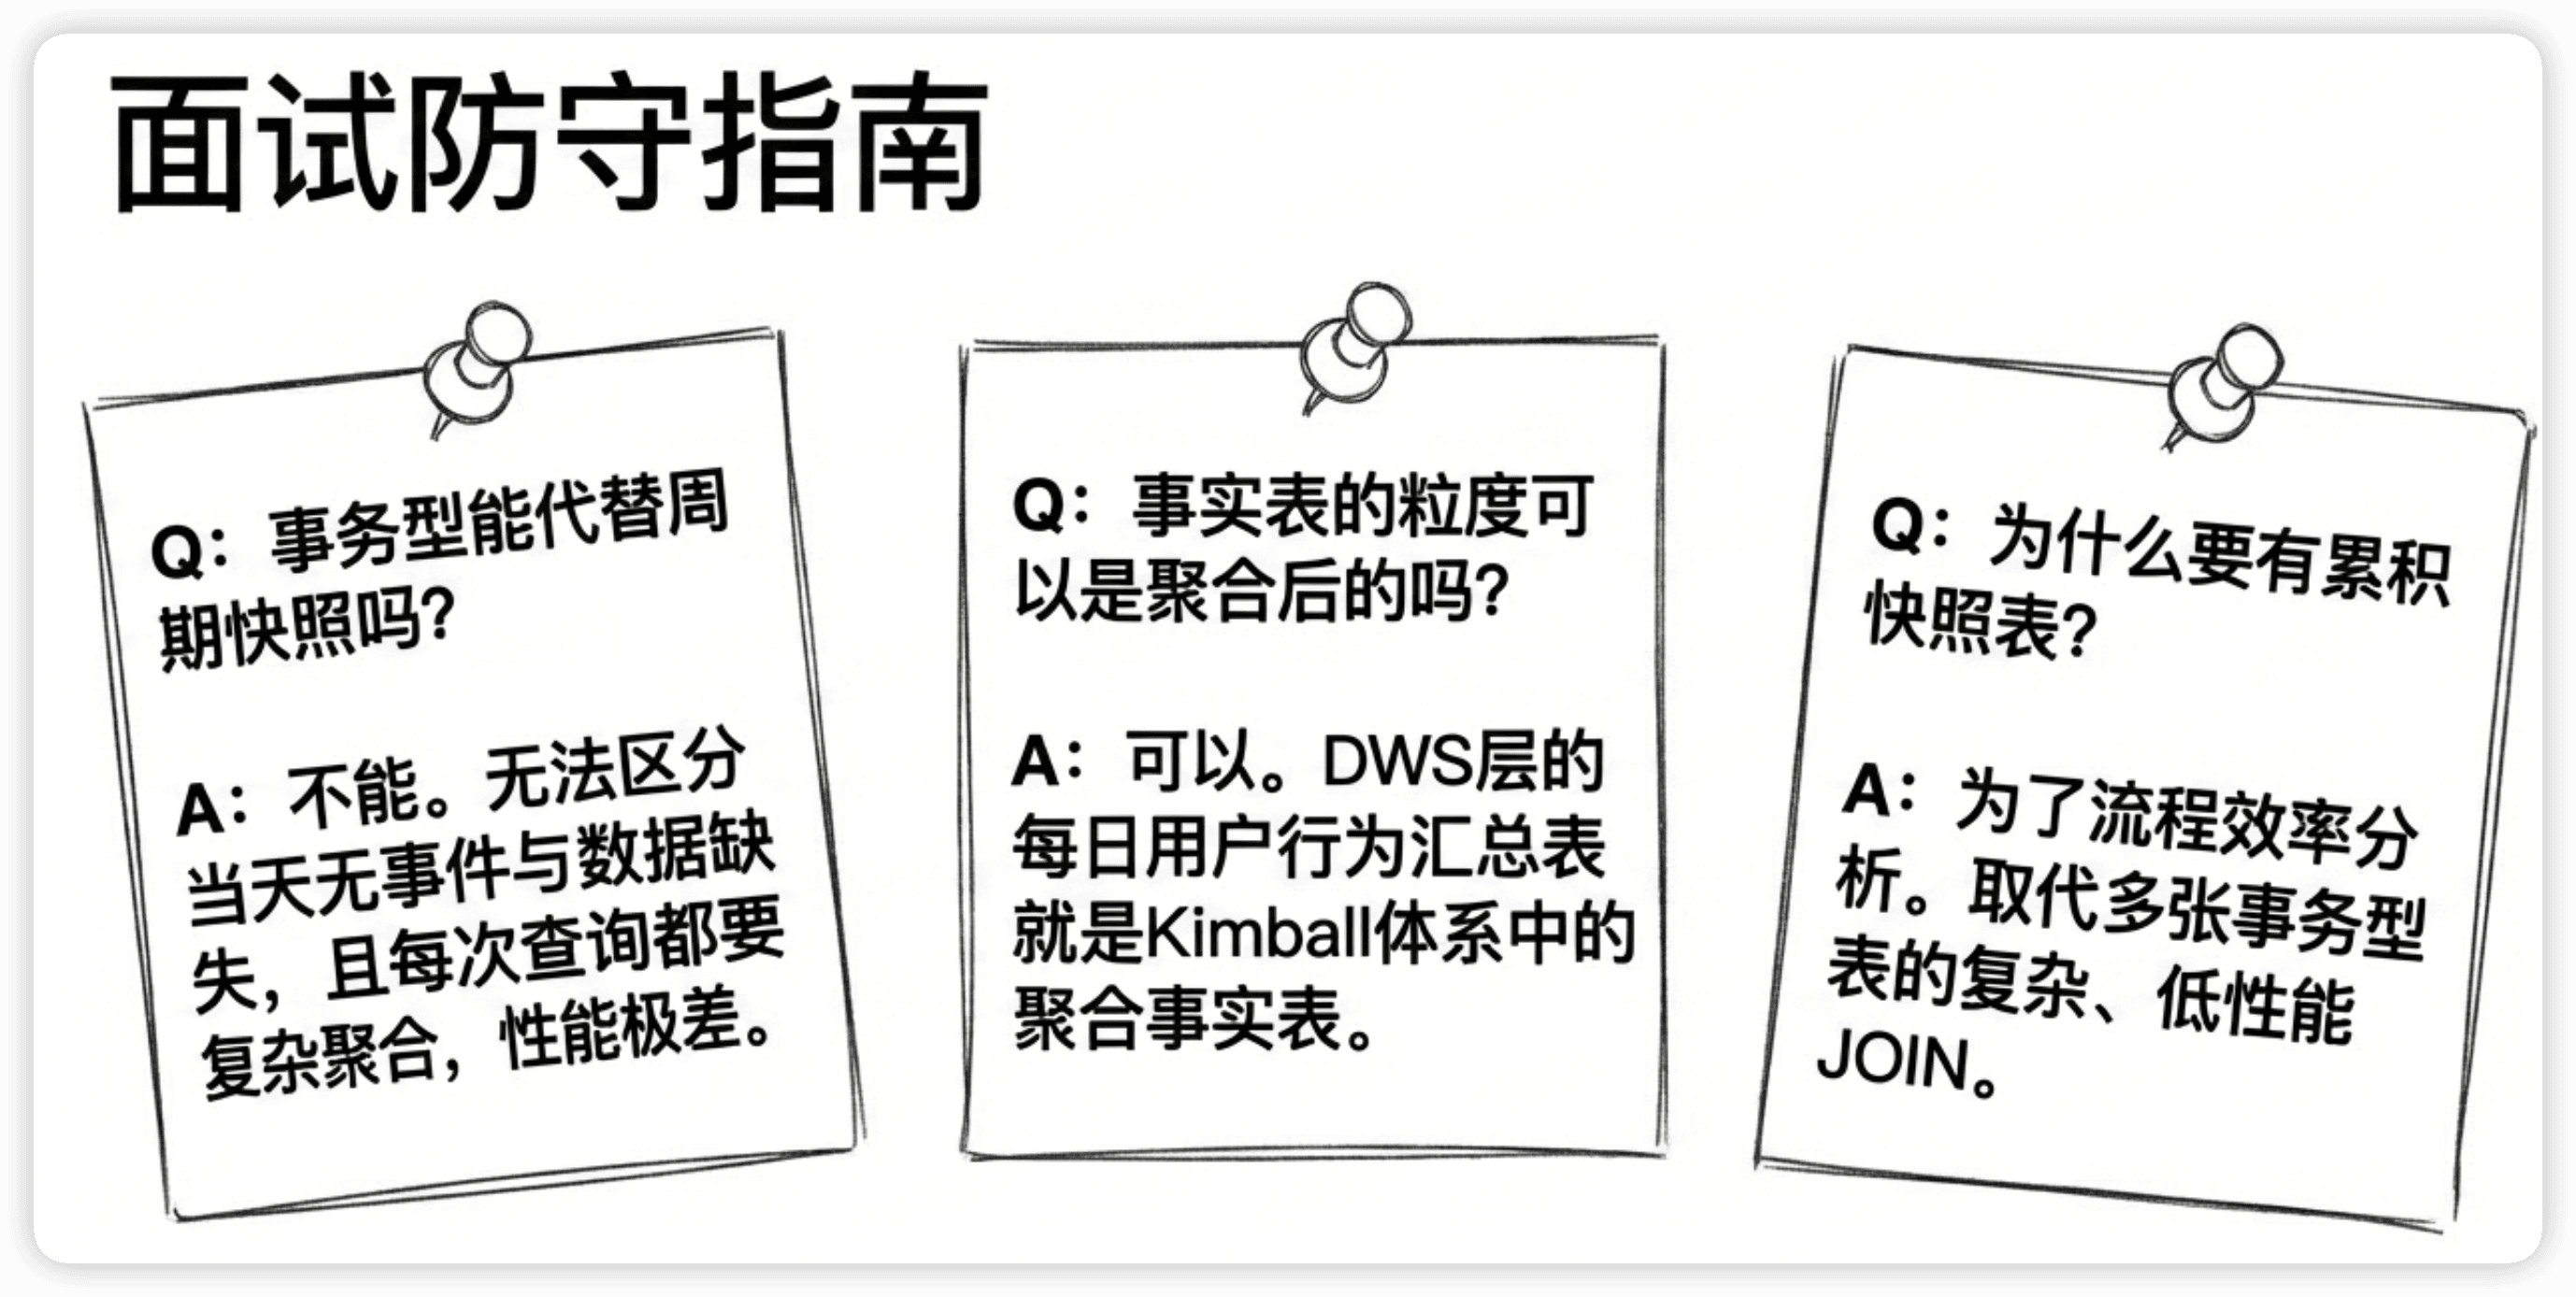
追问1:事务型事实表能不能代替周期快照型?
技术上可以通过对事务型做聚合来模拟快照效果。但有两个问题:第一,事务型记录的是"事件",没有事件发生的时间段不会有记录,无法区分"今天不活跃"和"数据缺失";第二,每次查询都要做聚合计算,性能远不如直接查快照表。所以高频的状态查询场景还是建议单独建快照表。
追问2:累积快照型在离线数仓里怎么处理更新?
离线数仓(Hive/Spark)不支持UPDATE,所以用INSERT OVERWRITE做全量重写。每天把旧表和增量数据做FULL OUTER JOIN,用COALESCE合并里程碑字段。如果用Doris或Hudi这类支持UPSERT的引擎,直接按order_id做MERGE更新就行,逻辑更简洁。
追问3:事实表的粒度可以是聚合后的吗?
可以。比如DWS层的"每日用户行为汇总表",粒度是"一个用户×一天",里面的指标已经是聚合后的。这在Kimball体系里叫"聚合事实表",本质还是事实表,只是粒度从明细变成了汇总。建DWS表的时候会经常遇到这种情况。
总结
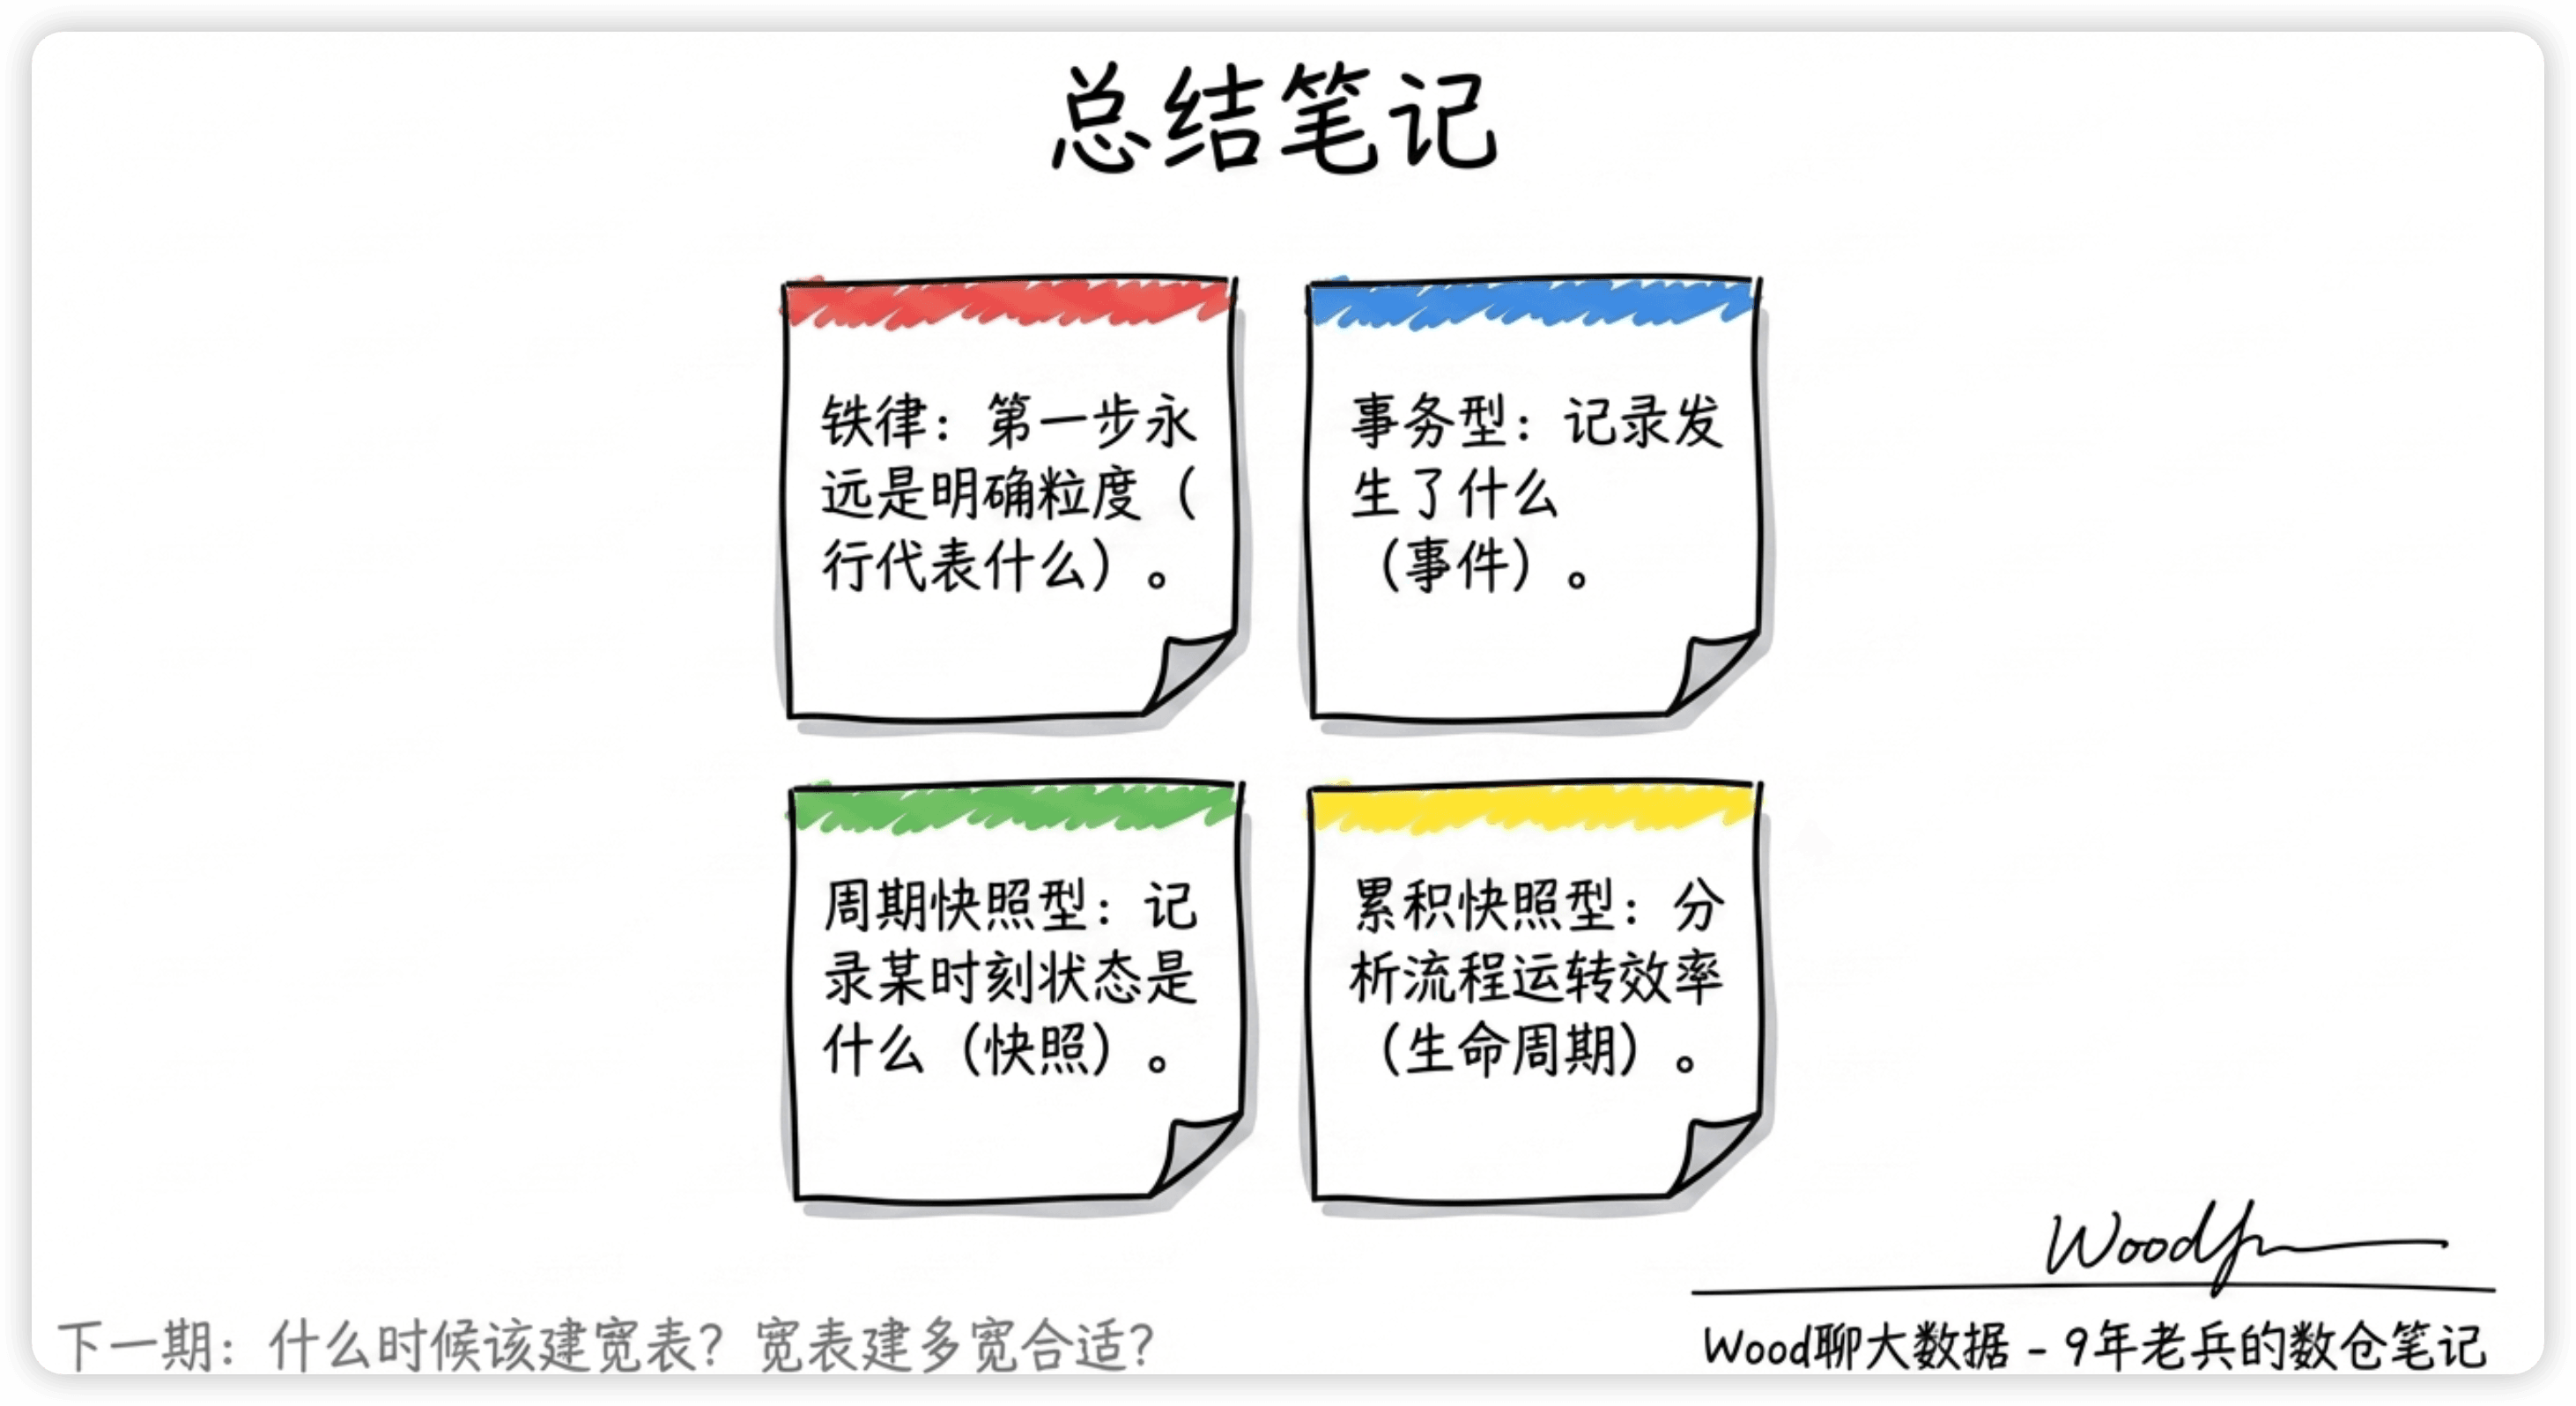
- 设计事实表的第一步永远是定义粒度:一行代表什么
- 事务型:一事件一行,不更新,最常见,适合"发生了什么"的分析
- 周期快照型:定期拍快照,即使无事件也有记录,适合"某时刻状态是什么"
- 累积快照型:跟踪全生命周期,多个里程碑时间在一行里,适合"流程效率分析"
- 同一个业务域完全可以建多种事实表,服务不同分析需求——这才是成熟的数仓设计思维