缓慢变化维怎么处理
这道题我被问过至少5次,而且每次面试官的追问角度都不一样。
有人问"缓慢变化维有几种处理方式",有人问"拉链表怎么实现",有人问"拉链表数据膨胀了怎么办",还有人直接丢一个场景——"用户改了收货地址,半年前的订单报表应该显示旧地址还是新地址?"
如果你只是背了三种类型的定义,这些追问很难接住。这篇文章我把缓慢变化维从概念到实现到踩坑全部讲透,保证你面试不虚。
什么是缓慢变化维?
维度表的数据不是一成不变的——用户会改手机号、改收货地址,商品会调价格、换分类,店铺会改名字、换经营类目。这些变化不会每天发生,但隔三差五就会来一次,这就叫缓慢变化维(Slowly Changing Dimension,SCD)。
SCD要回答的核心问题只有一个:维度变了,历史数据要不要保留?
你的回答决定了用哪种SCD类型:
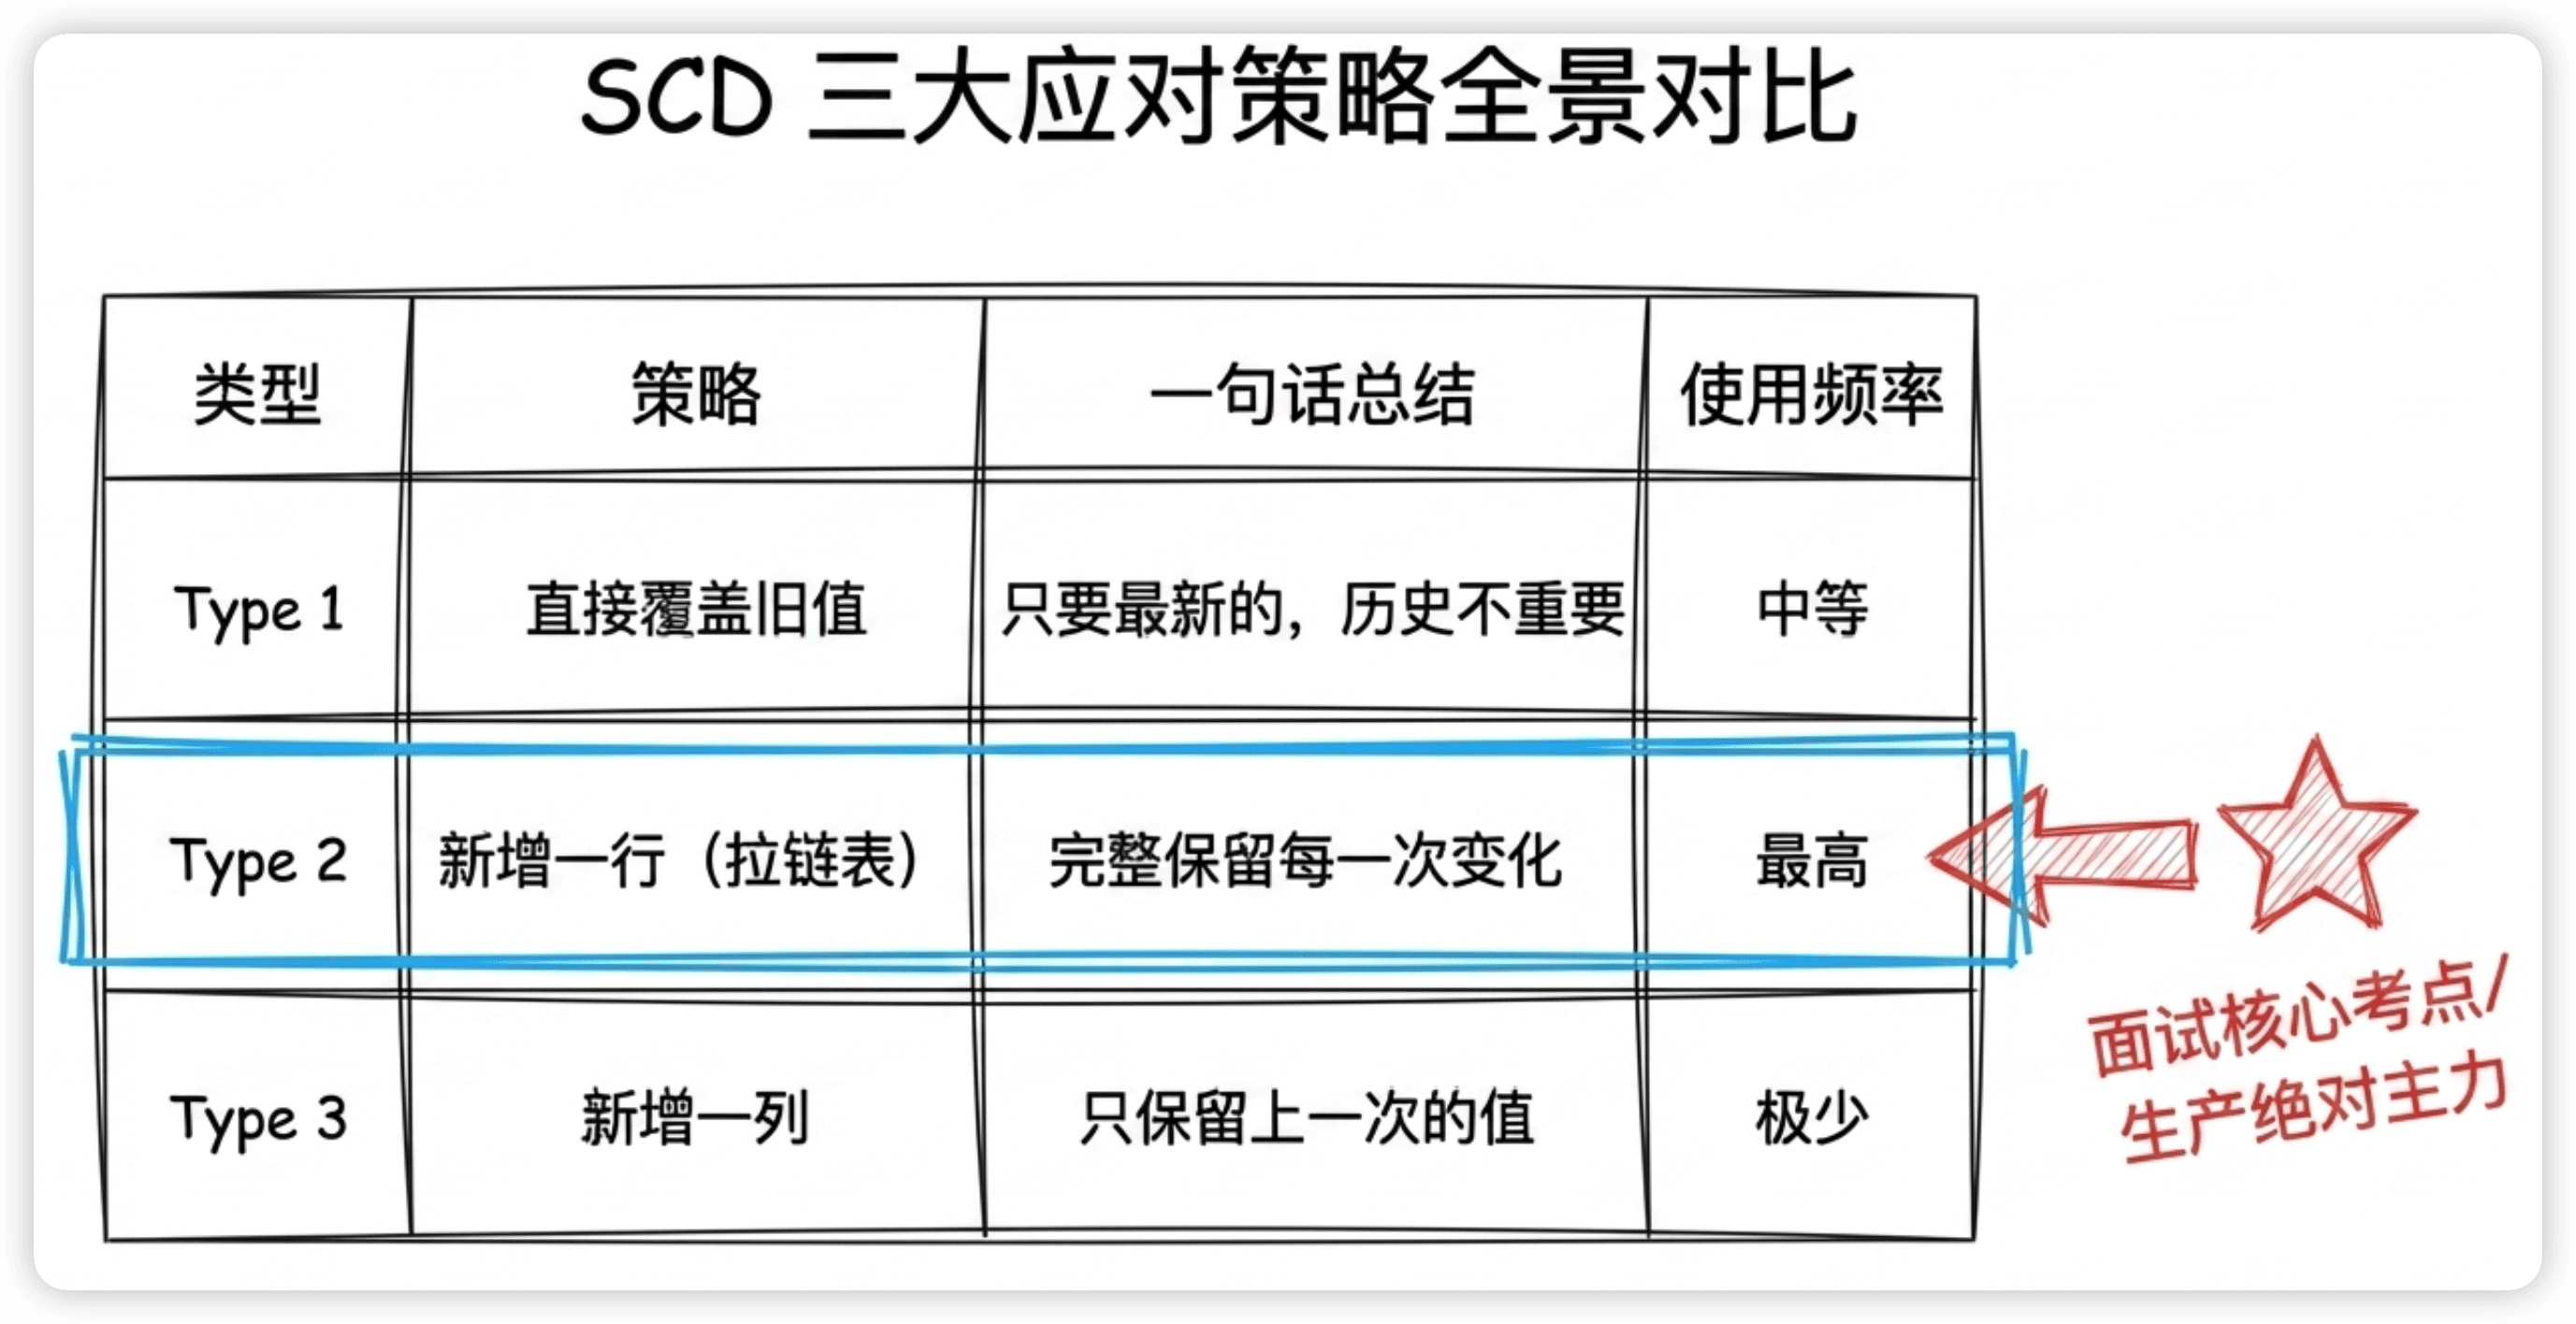
| 类型 | 策略 | 一句话总结 | 使用频率 |
|---|---|---|---|
| Type 1 | 直接覆盖旧值 | 只要最新的,历史不重要 | 中等 |
| Type 2 | 新增一行(拉链表) | 完整保留每一次变化 | 最高 |
| Type 3 | 新增一列 | 只保留上一次的值 | 极少 |
Type 1:直接覆盖
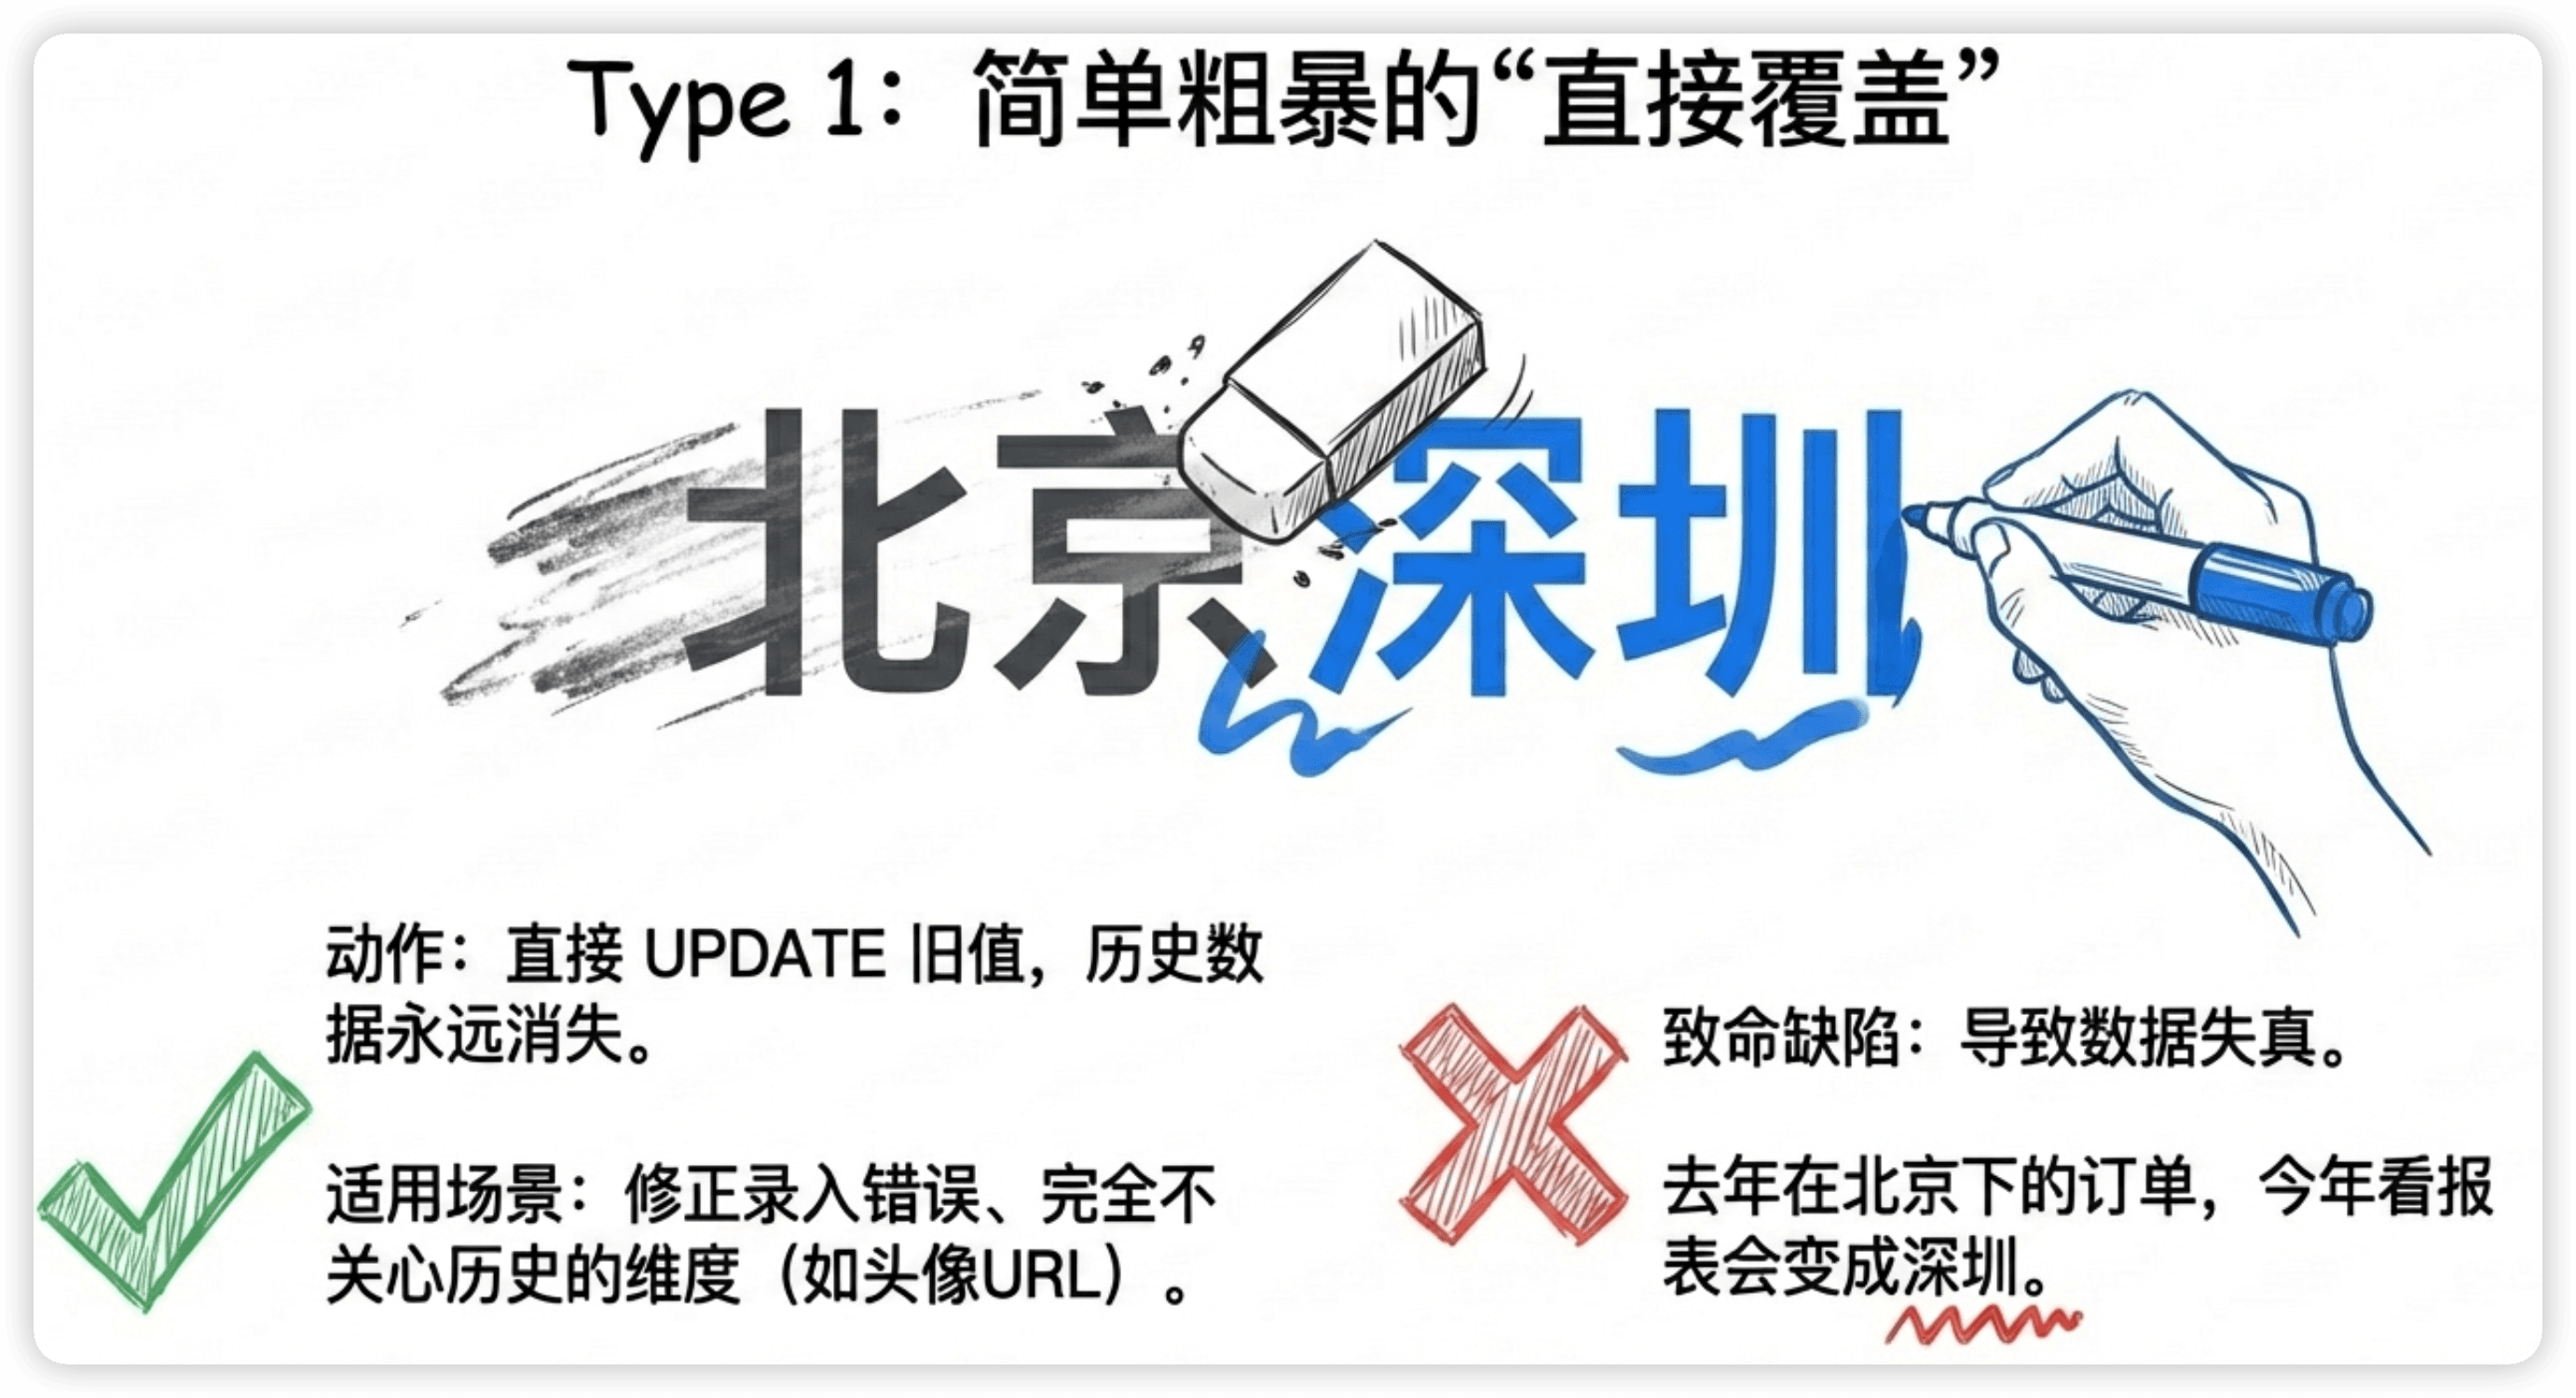
最简单粗暴的做法——用户换了手机号,直接UPDATE掉旧值。
-- Type 1:直接覆盖
UPDATE dim_user
SET phone = '13900001111',
    city = '深圳'
WHERE user_id = 1001;
执行之后,旧手机号永远消失了。你查dim_user永远只能看到最新状态。
什么时候用Type 1?
- 修正数据录入错误(本来就应该是新值,旧值是错的)
- 业务上完全不关心历史状态的维度(比如用户的头像URL、昵称等)
- 维度变化对分析结果没有影响的场景
什么时候不能用?
如果你的业务需要回答"用户下单时住在哪个城市"这类问题,Type 1就不行了。因为用户可能是去年在北京下的单,今年搬到了深圳,Type 1覆盖之后,去年的订单报表会显示"深圳"——这就是数据失真。
Type 2:拉链表(面试必考重点)
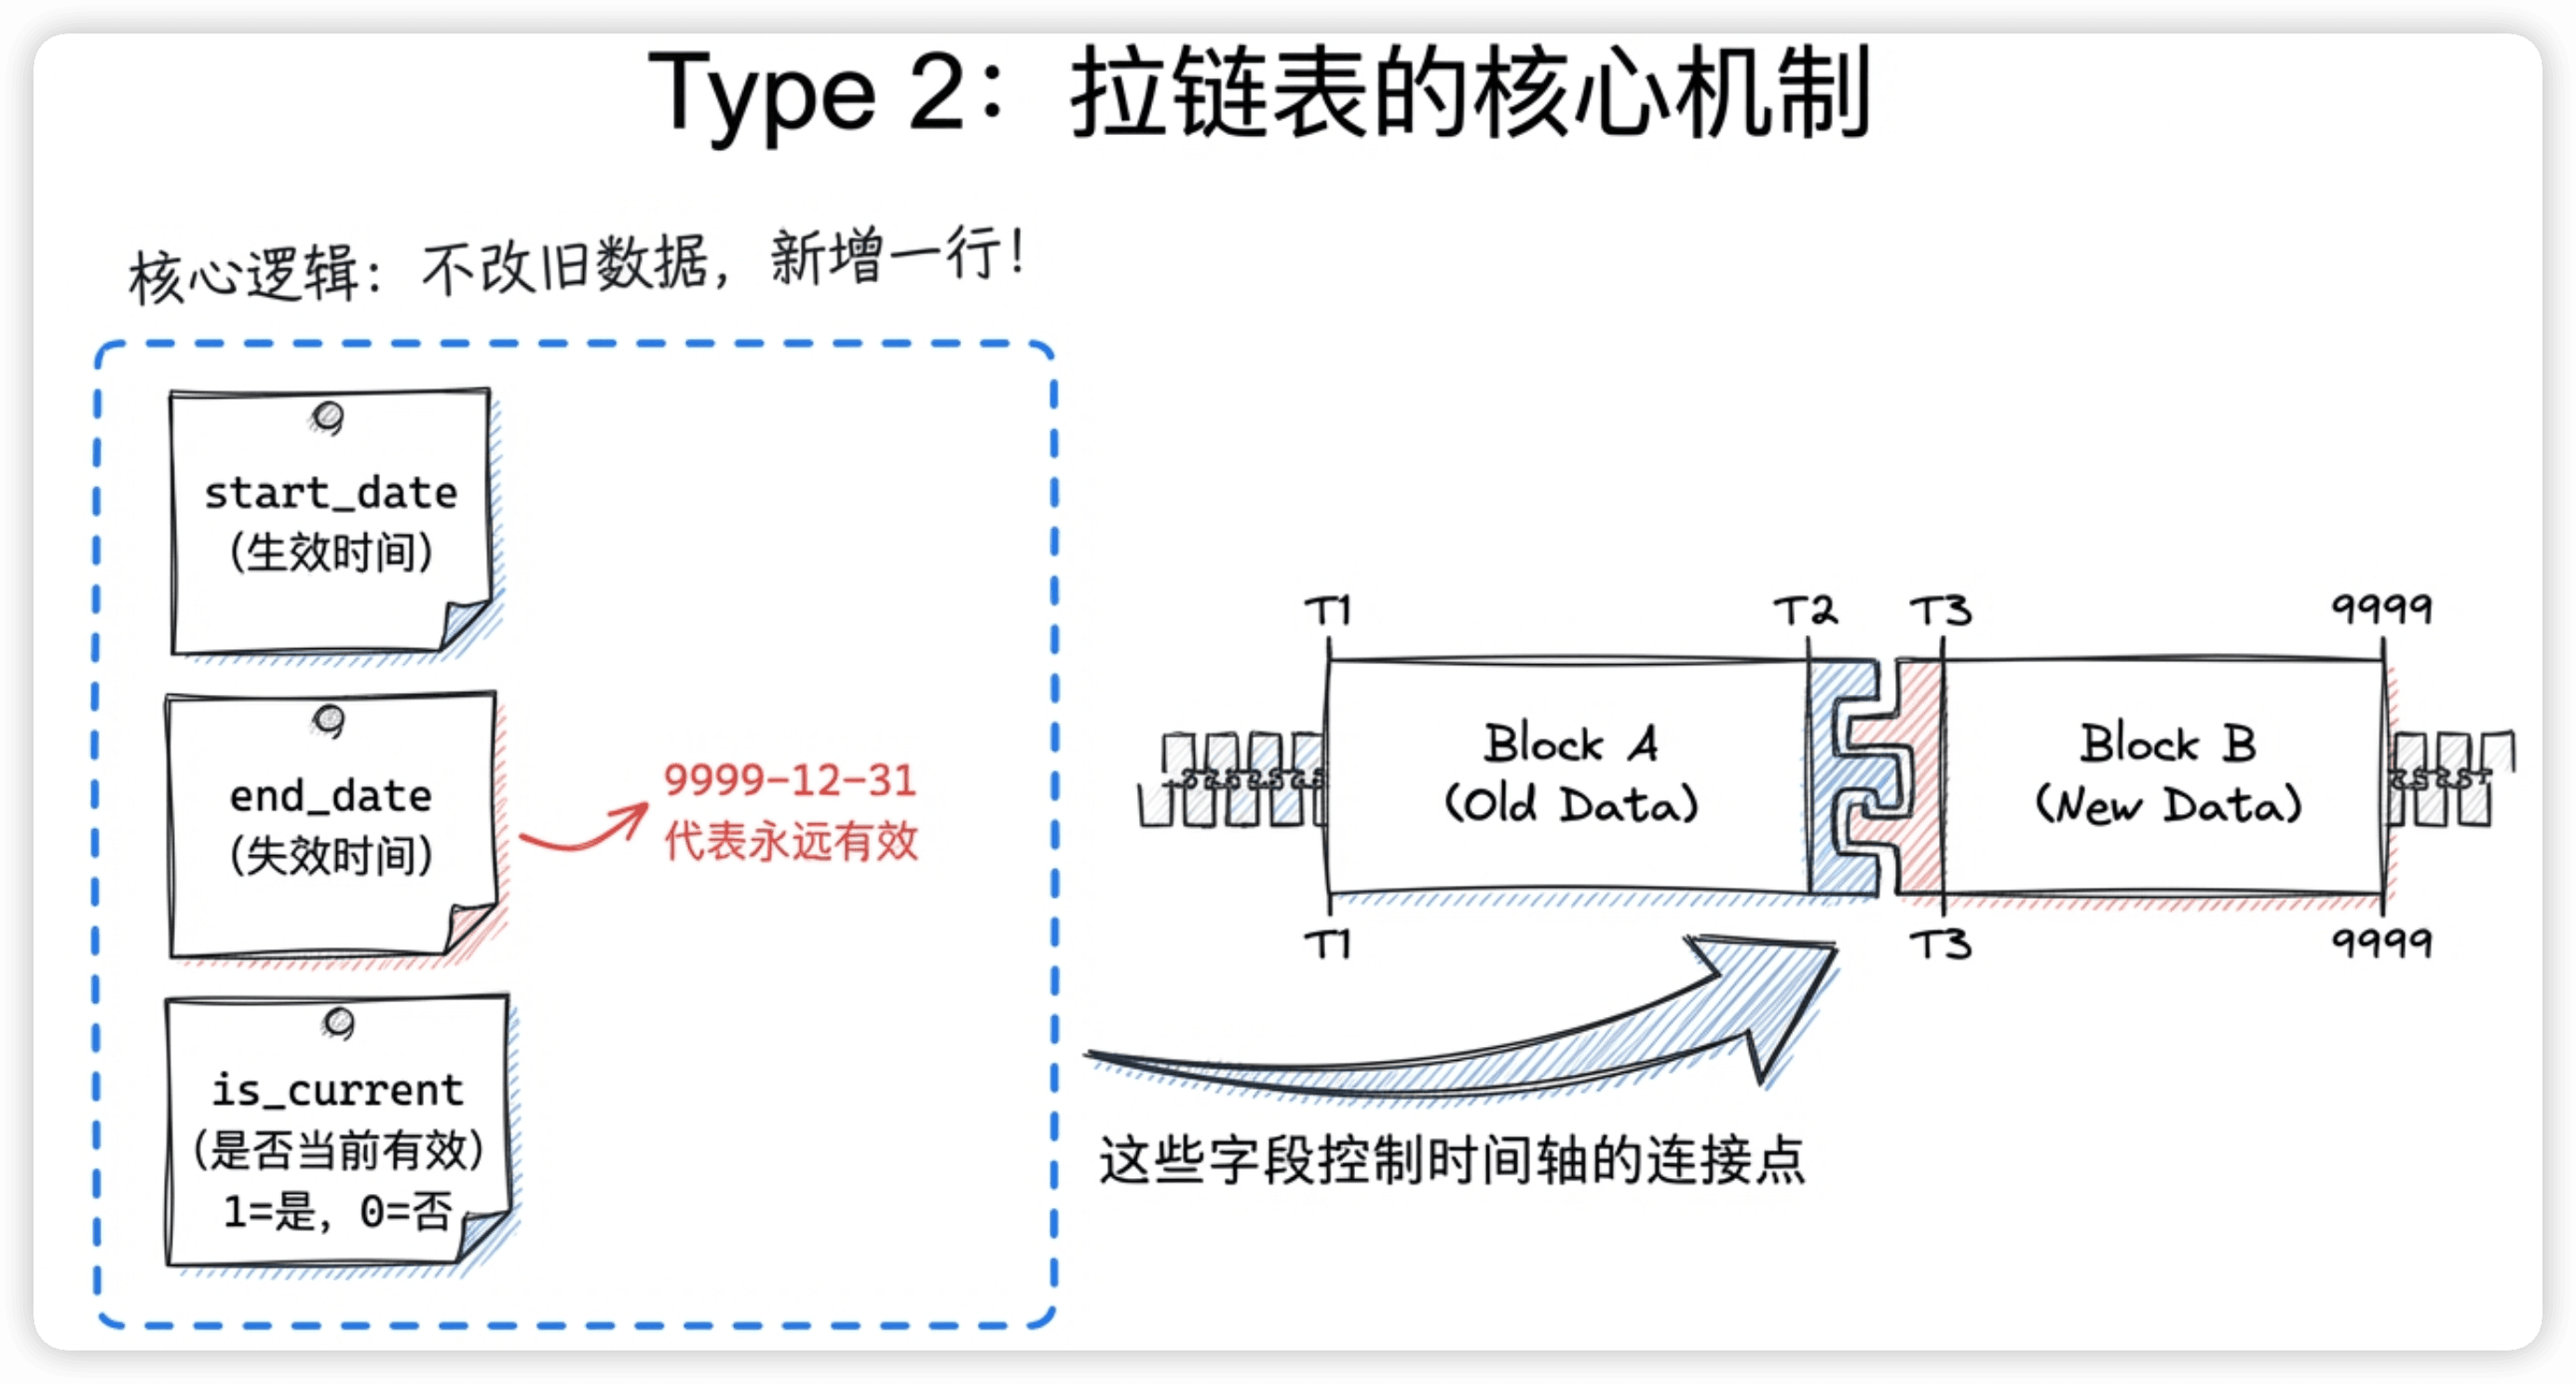
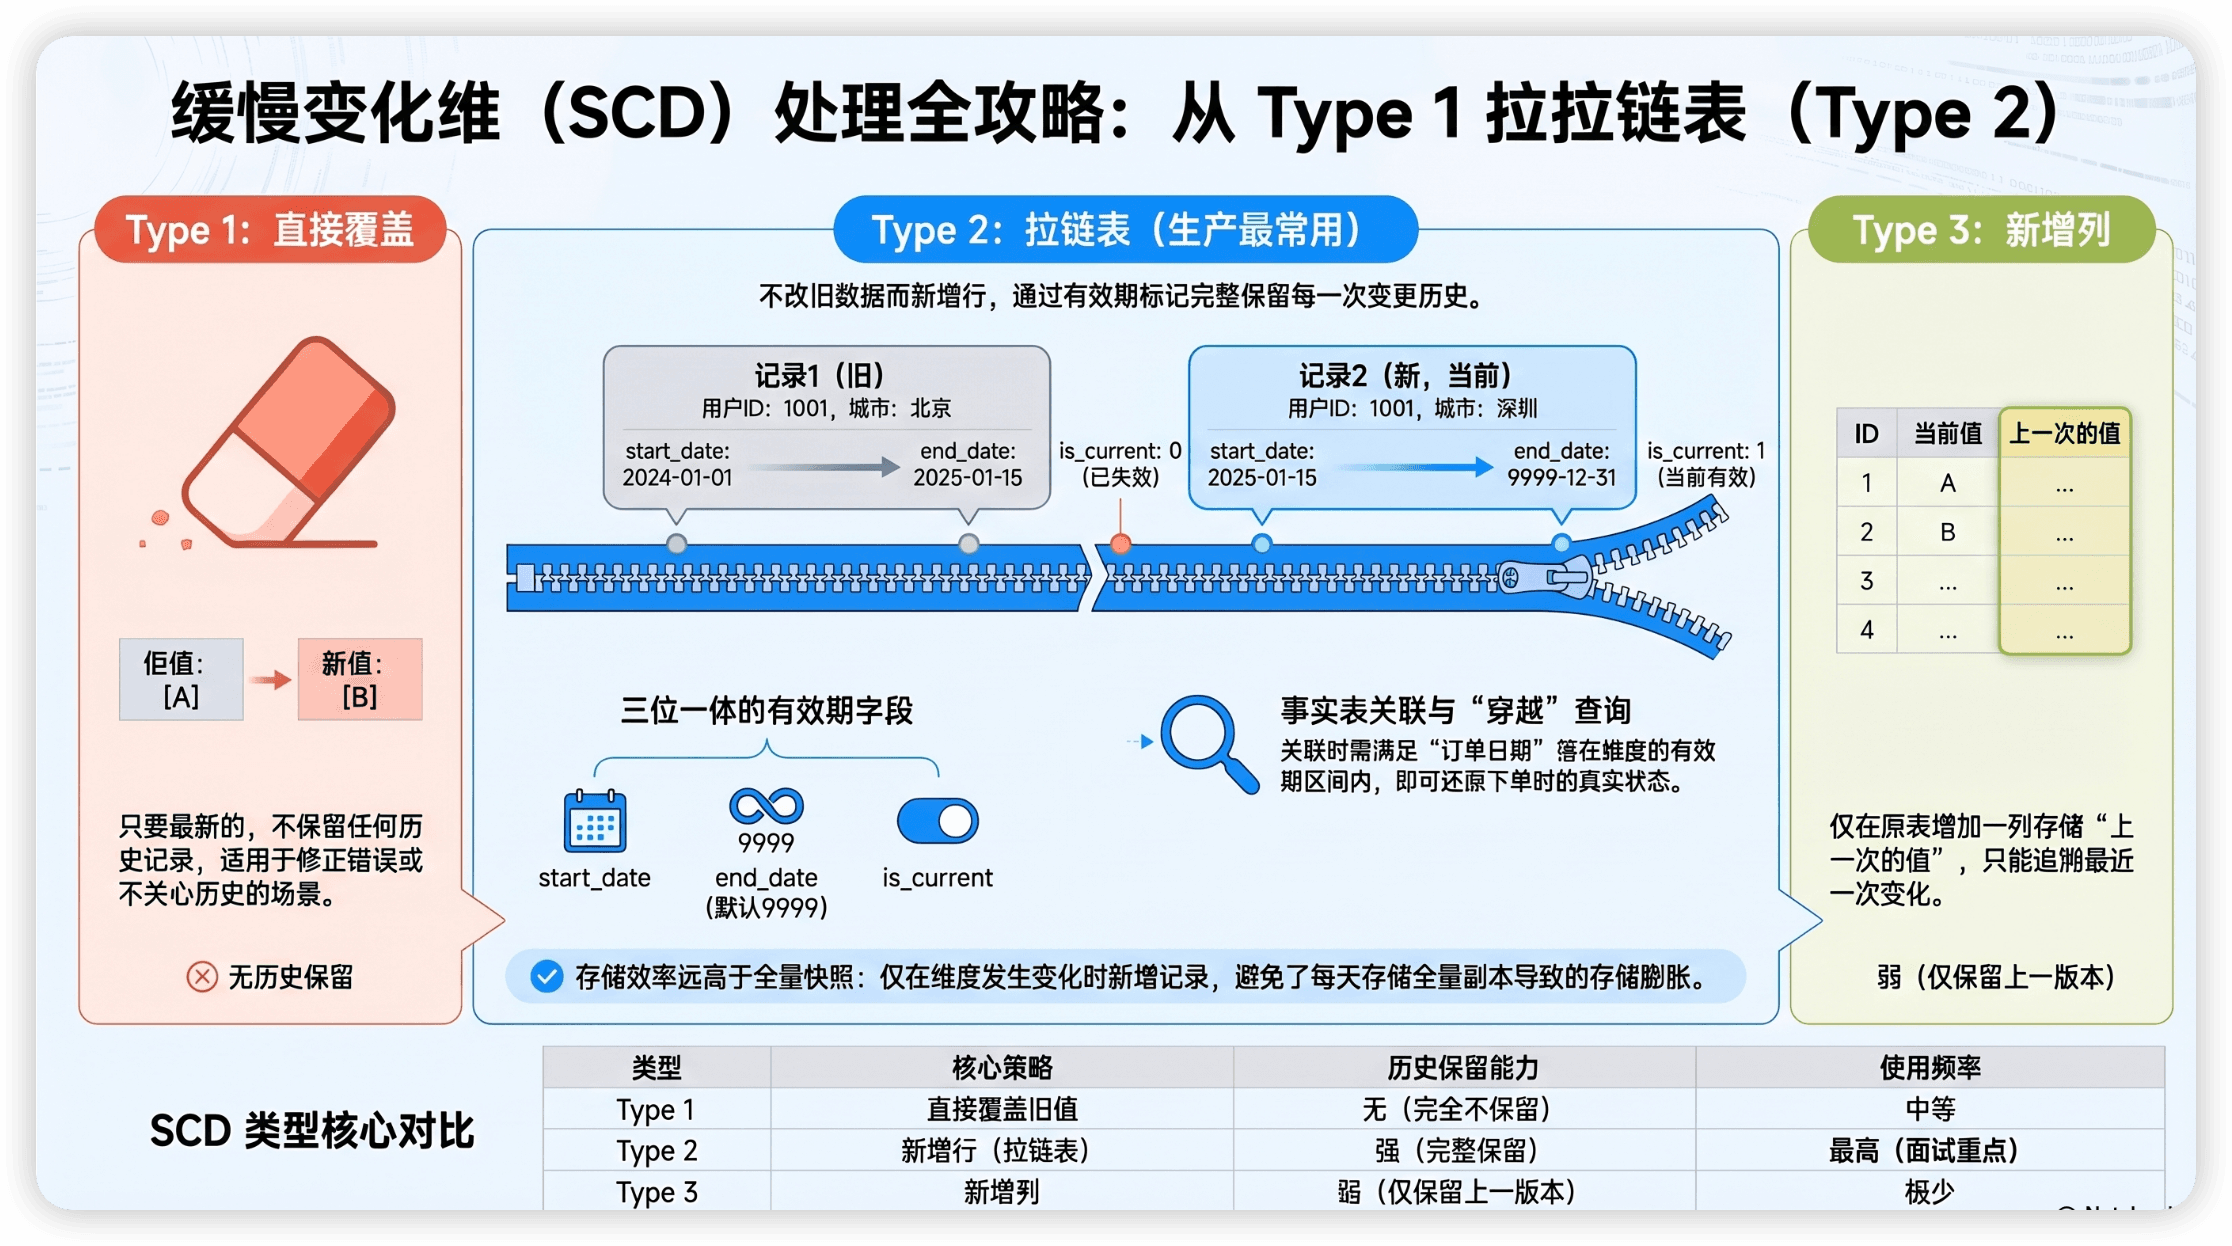
Type 2是面试考得最多的类型,也是生产中用得最多的方案。核心思路很简单:不改旧数据,新增一行。
通过三个字段来标记每行数据的有效期:
start_date:这行数据从什么时候开始生效end_date:这行数据到什么时候失效is_current:是否是当前有效记录(1=是,0=否)
完整示例:用户张三换了手机号
变更前,表里只有一行:
| user_id | name | phone | city | start_date | end_date | is_current |
|---|---|---|---|---|---|---|
| 1001 | 张三 | 138xxxx | 北京 | 2024-01-01 | 9999-12-31 | 1 |
end_date = 9999-12-31 表示"一直有效到永远",这是拉链表的通用约定。
2025年1月15日,张三换了手机号并搬到了深圳。变更后:
| user_id | name | phone | city | start_date | end_date | is_current |
|---|---|---|---|---|---|---|
| 1001 | 张三 | 138xxxx | 北京 | 2024-01-01 | 2025-01-15 | 0 |
| 1001 | 张三 | 139xxxx | 深圳 | 2025-01-15 | 9999-12-31 | 1 |
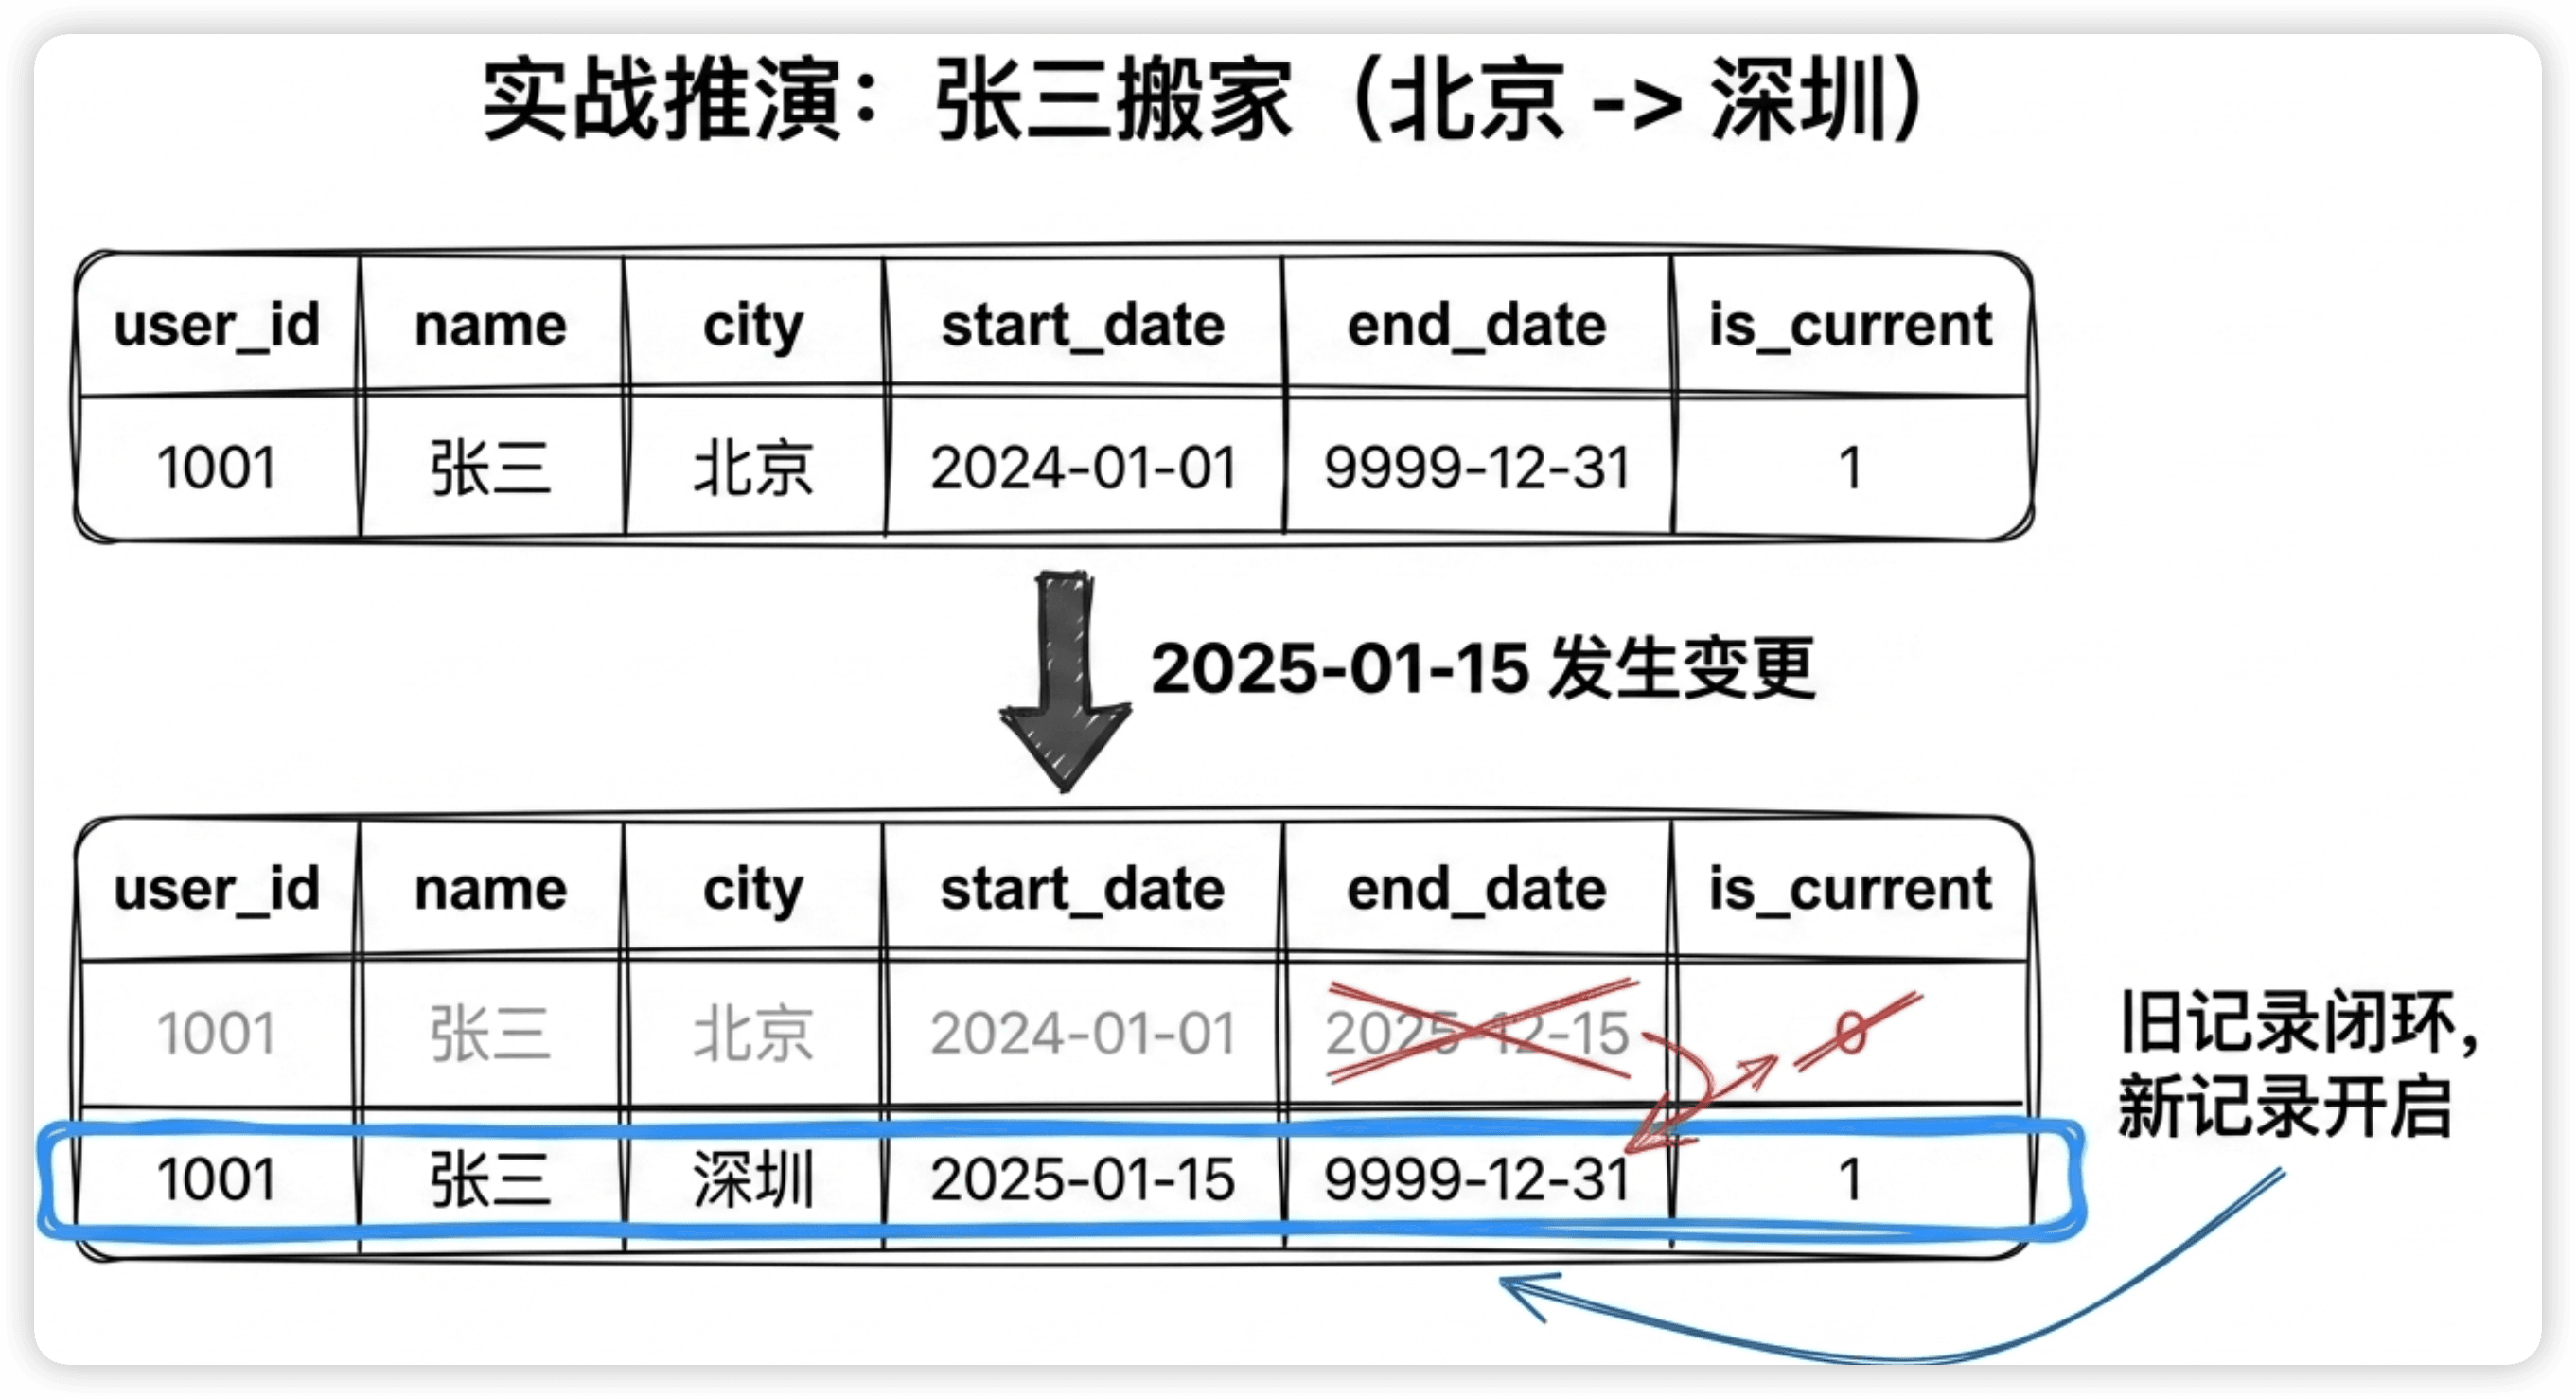 |
操作很清楚:旧记录的end_date改成变更日期,is_current改成0;新增一行记录当前状态,start_date为变更日期,end_date为9999-12-31。
拉链表的三种查询场景
这是面试高频考点,必须熟练掌握。
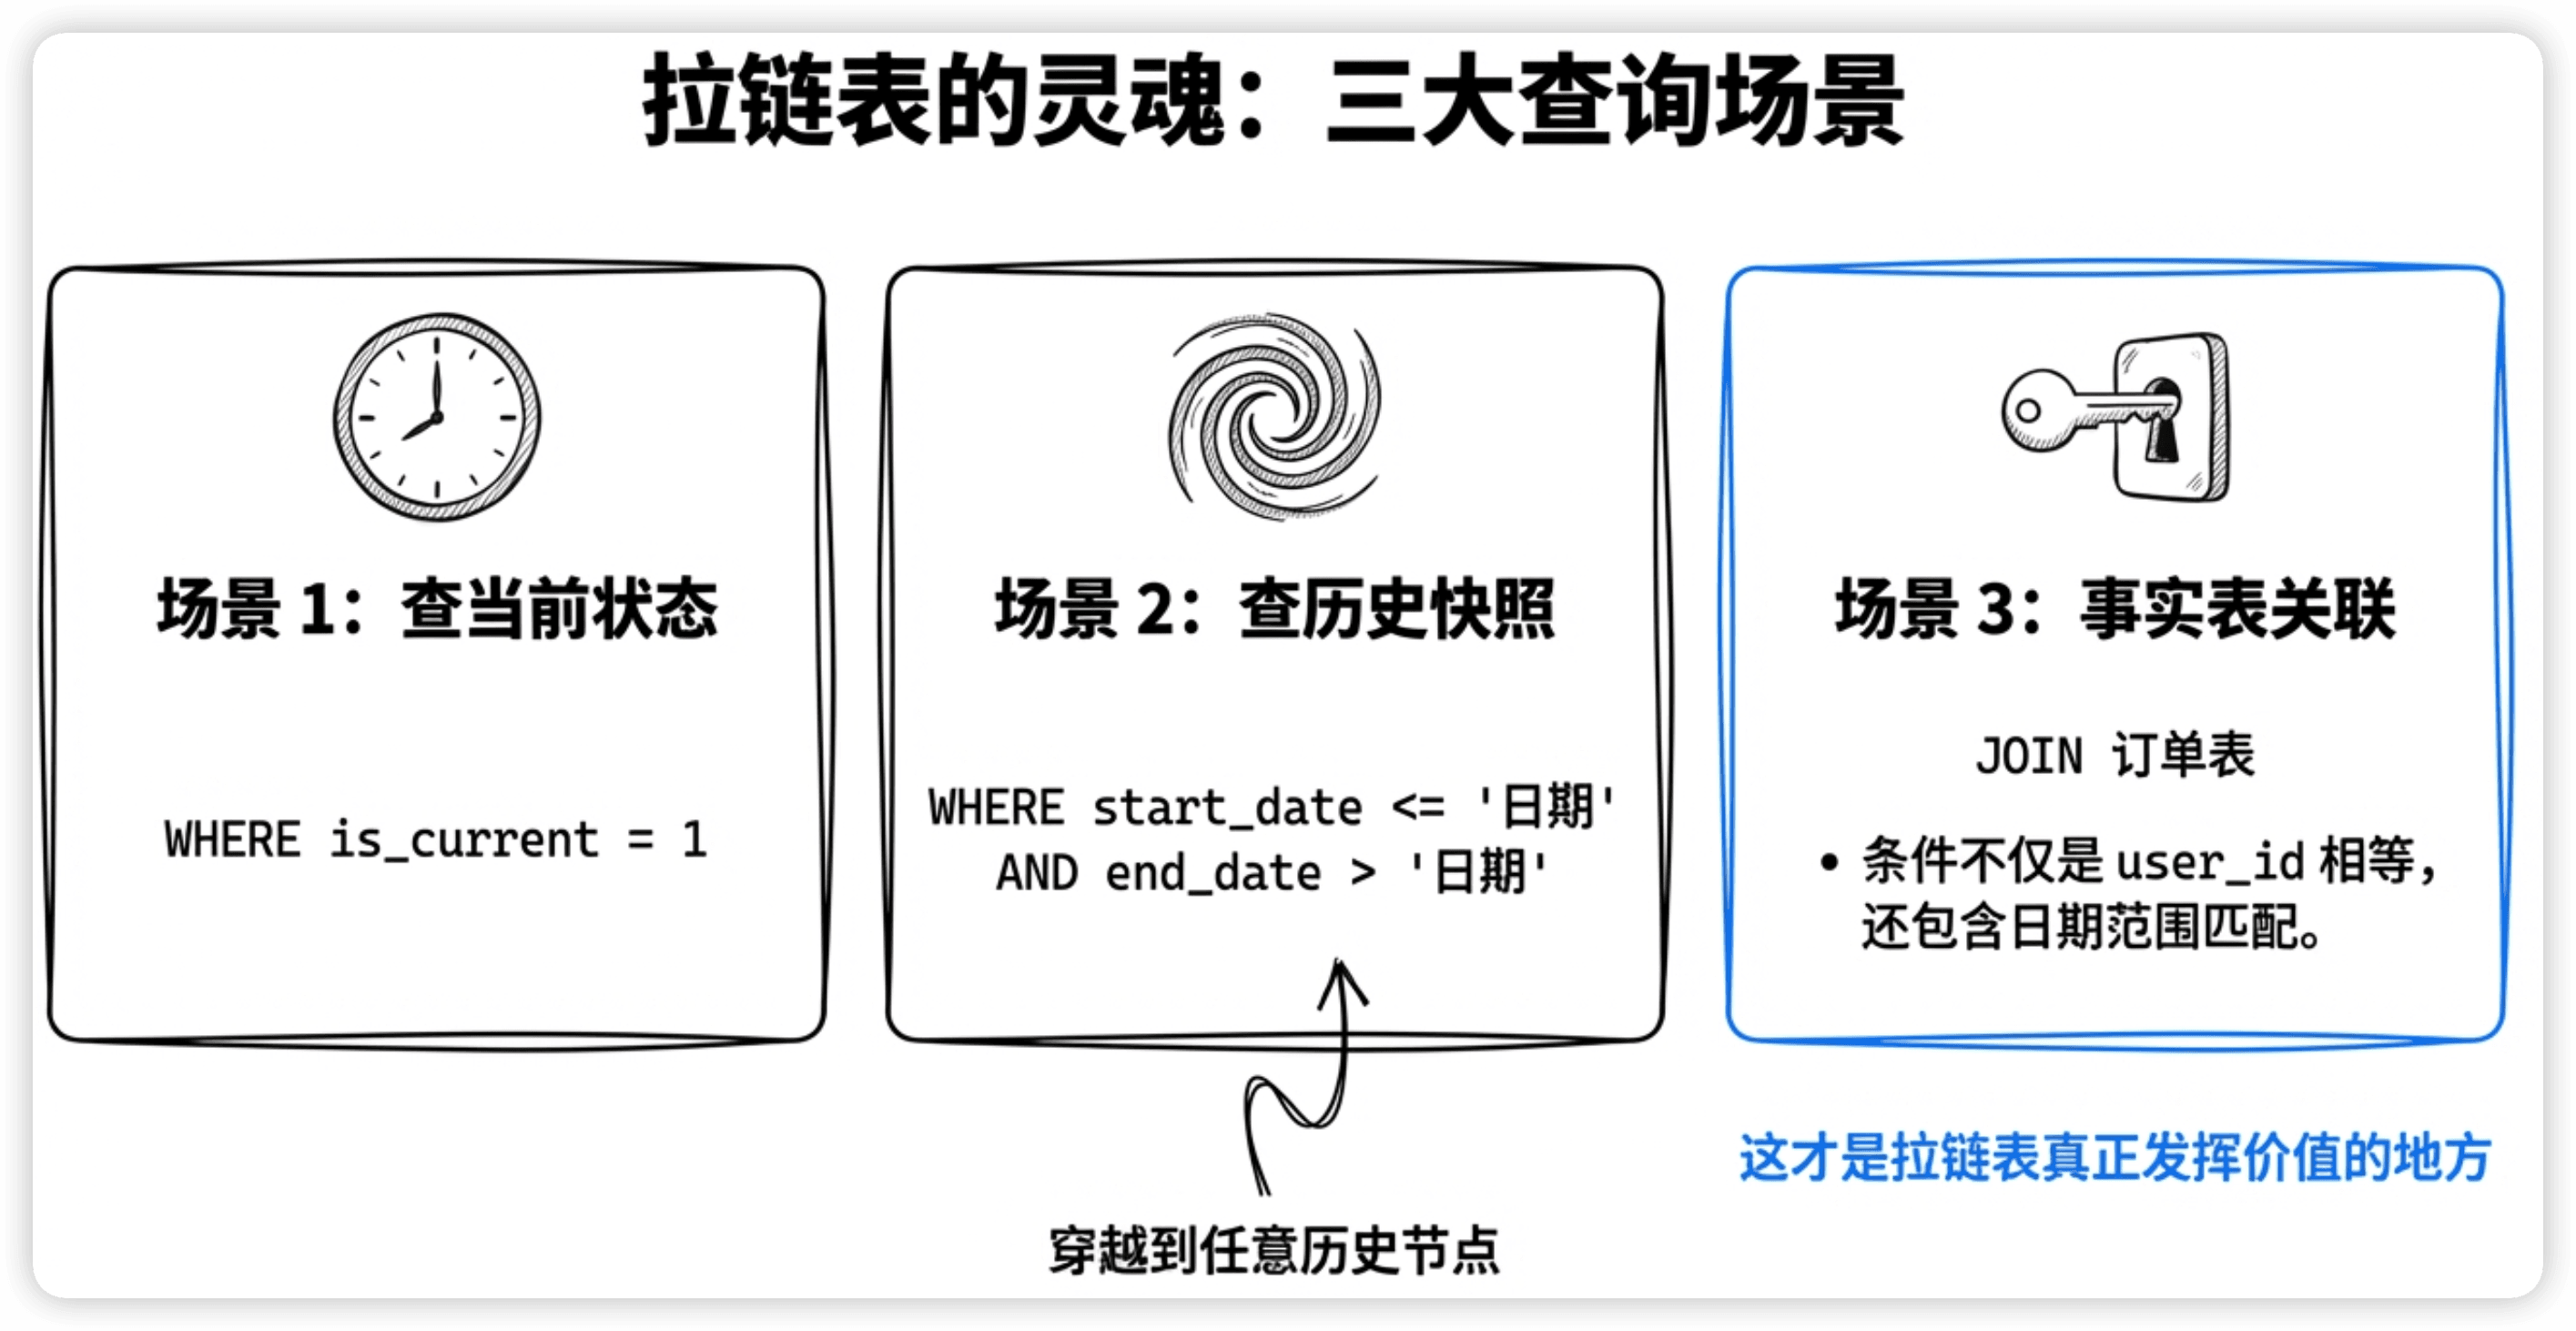
场景一:查当前最新状态
-- 方法1:用is_current标记
SELECT * FROM dim_user WHERE is_current = 1;

-- 方法2:用end_date判断(更通用,不依赖is_current字段)
SELECT * FROM dim_user WHERE end_date = '9999-12-31';
场景二:查某个历史时间点的状态快照
比如想知道2024年6月1日的时候,用户张三的状态是什么:
-- 查历史快照:2024年6月1日的维度状态
SELECT * FROM dim_user
WHERE start_date <= '2024-06-01'
  AND end_date > '2024-06-01';
这条SQL就是拉链表的灵魂——通过日期范围过滤,可以"穿越"到任意历史时间点查看当时的维度状态。
场景三:事实表关联历史维度(最重要)
这才是拉链表真正发挥价值的场景。订单是2024年6月下的,那报表里应该显示用户下单时的地址(北京),而不是当前地址(深圳)。
-- 订单关联下单时的用户维度
SELECT
    f.order_id,
    f.order_amount,
    f.order_date,
    d.phone,
    d.city        -- 这里会拿到下单时的城市,不是当前城市
FROM fact_order f
JOIN dim_user d
  ON f.user_id = d.user_id
  AND f.order_date >= d.start_date
AND f.order_date < d.end_date;注意JOIN条件:不只是user_id相等,还要求订单日期落在维度记录的有效期范围内。这个范围JOIN是拉链表查询的标志性写法。
拉链表的ETL实现
面试官可能会追问"拉链表的更新逻辑怎么实现"。在离线数仓里,通常是每天跑一个调度任务,核心逻辑如下:
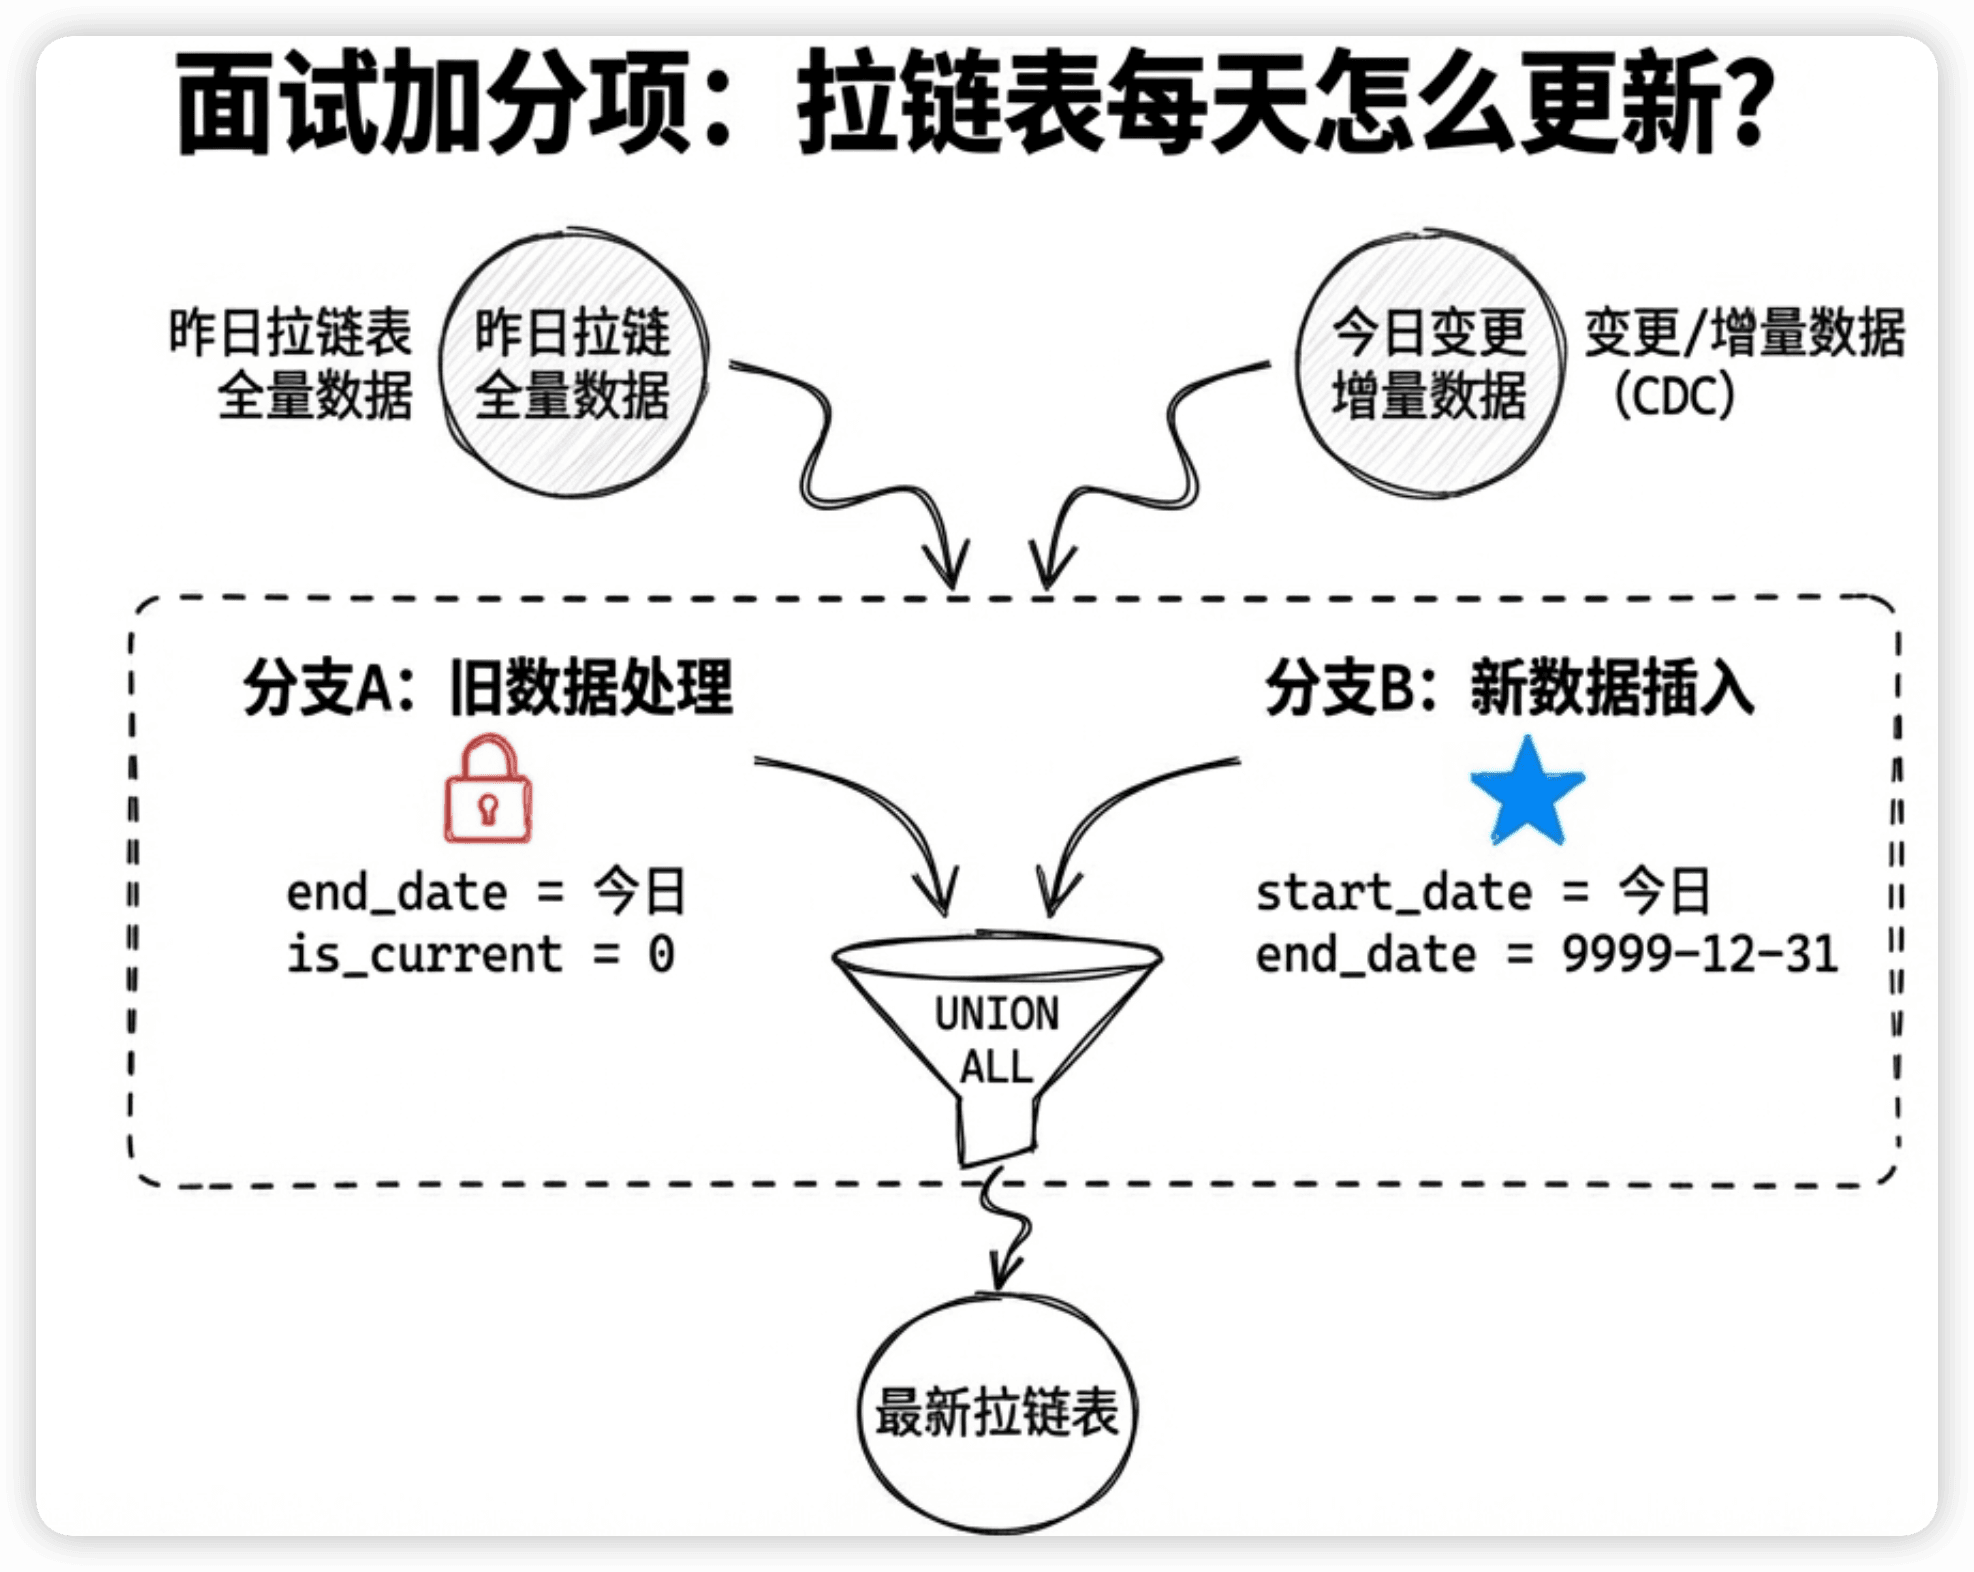
-- 拉链表每日更新逻辑(Hive/Spark SQL)
-- 第一步:找出今天有变化的记录
-- 第二步:关闭旧记录 + 新增新记录

INSERT OVERWRITE TABLE dim_user
-- 情况1:未发生变化的记录,原封不动保留
SELECT user_id, name, phone, city, start_date, end_date, is_current
FROM dim_user
WHERE user_id NOT IN (SELECT user_id FROM ods_user_update WHERE dt = '${bizdate}')

UNION ALL

-- 情况2:发生变化的旧记录 → 关闭有效期
SELECT user_id, name, phone, city, start_date,
       '${bizdate}' AS end_date,       -- 关闭到今天
       0 AS is_current                  -- 标记为非当前
FROM dim_user
WHERE is_current = 1
  AND user_id IN (SELECT user_id FROM ods_user_update WHERE dt = '${bizdate}')

UNION ALL

-- 情况3:发生变化的新记录 → 新增一行
SELECT user_id, name, phone, city,
       '${bizdate}' AS start_date,     -- 从今天开始生效
       '9999-12-31' AS end_date,       -- 一直有效
       1 AS is_current                 -- 标记为当前
FROM ods_user_update
WHERE dt = '${bizdate}';
这段SQL是拉链表的经典实现,面试时能写出来或者说清楚思路,加分非常大。
踩坑经验:end_date的开闭区间
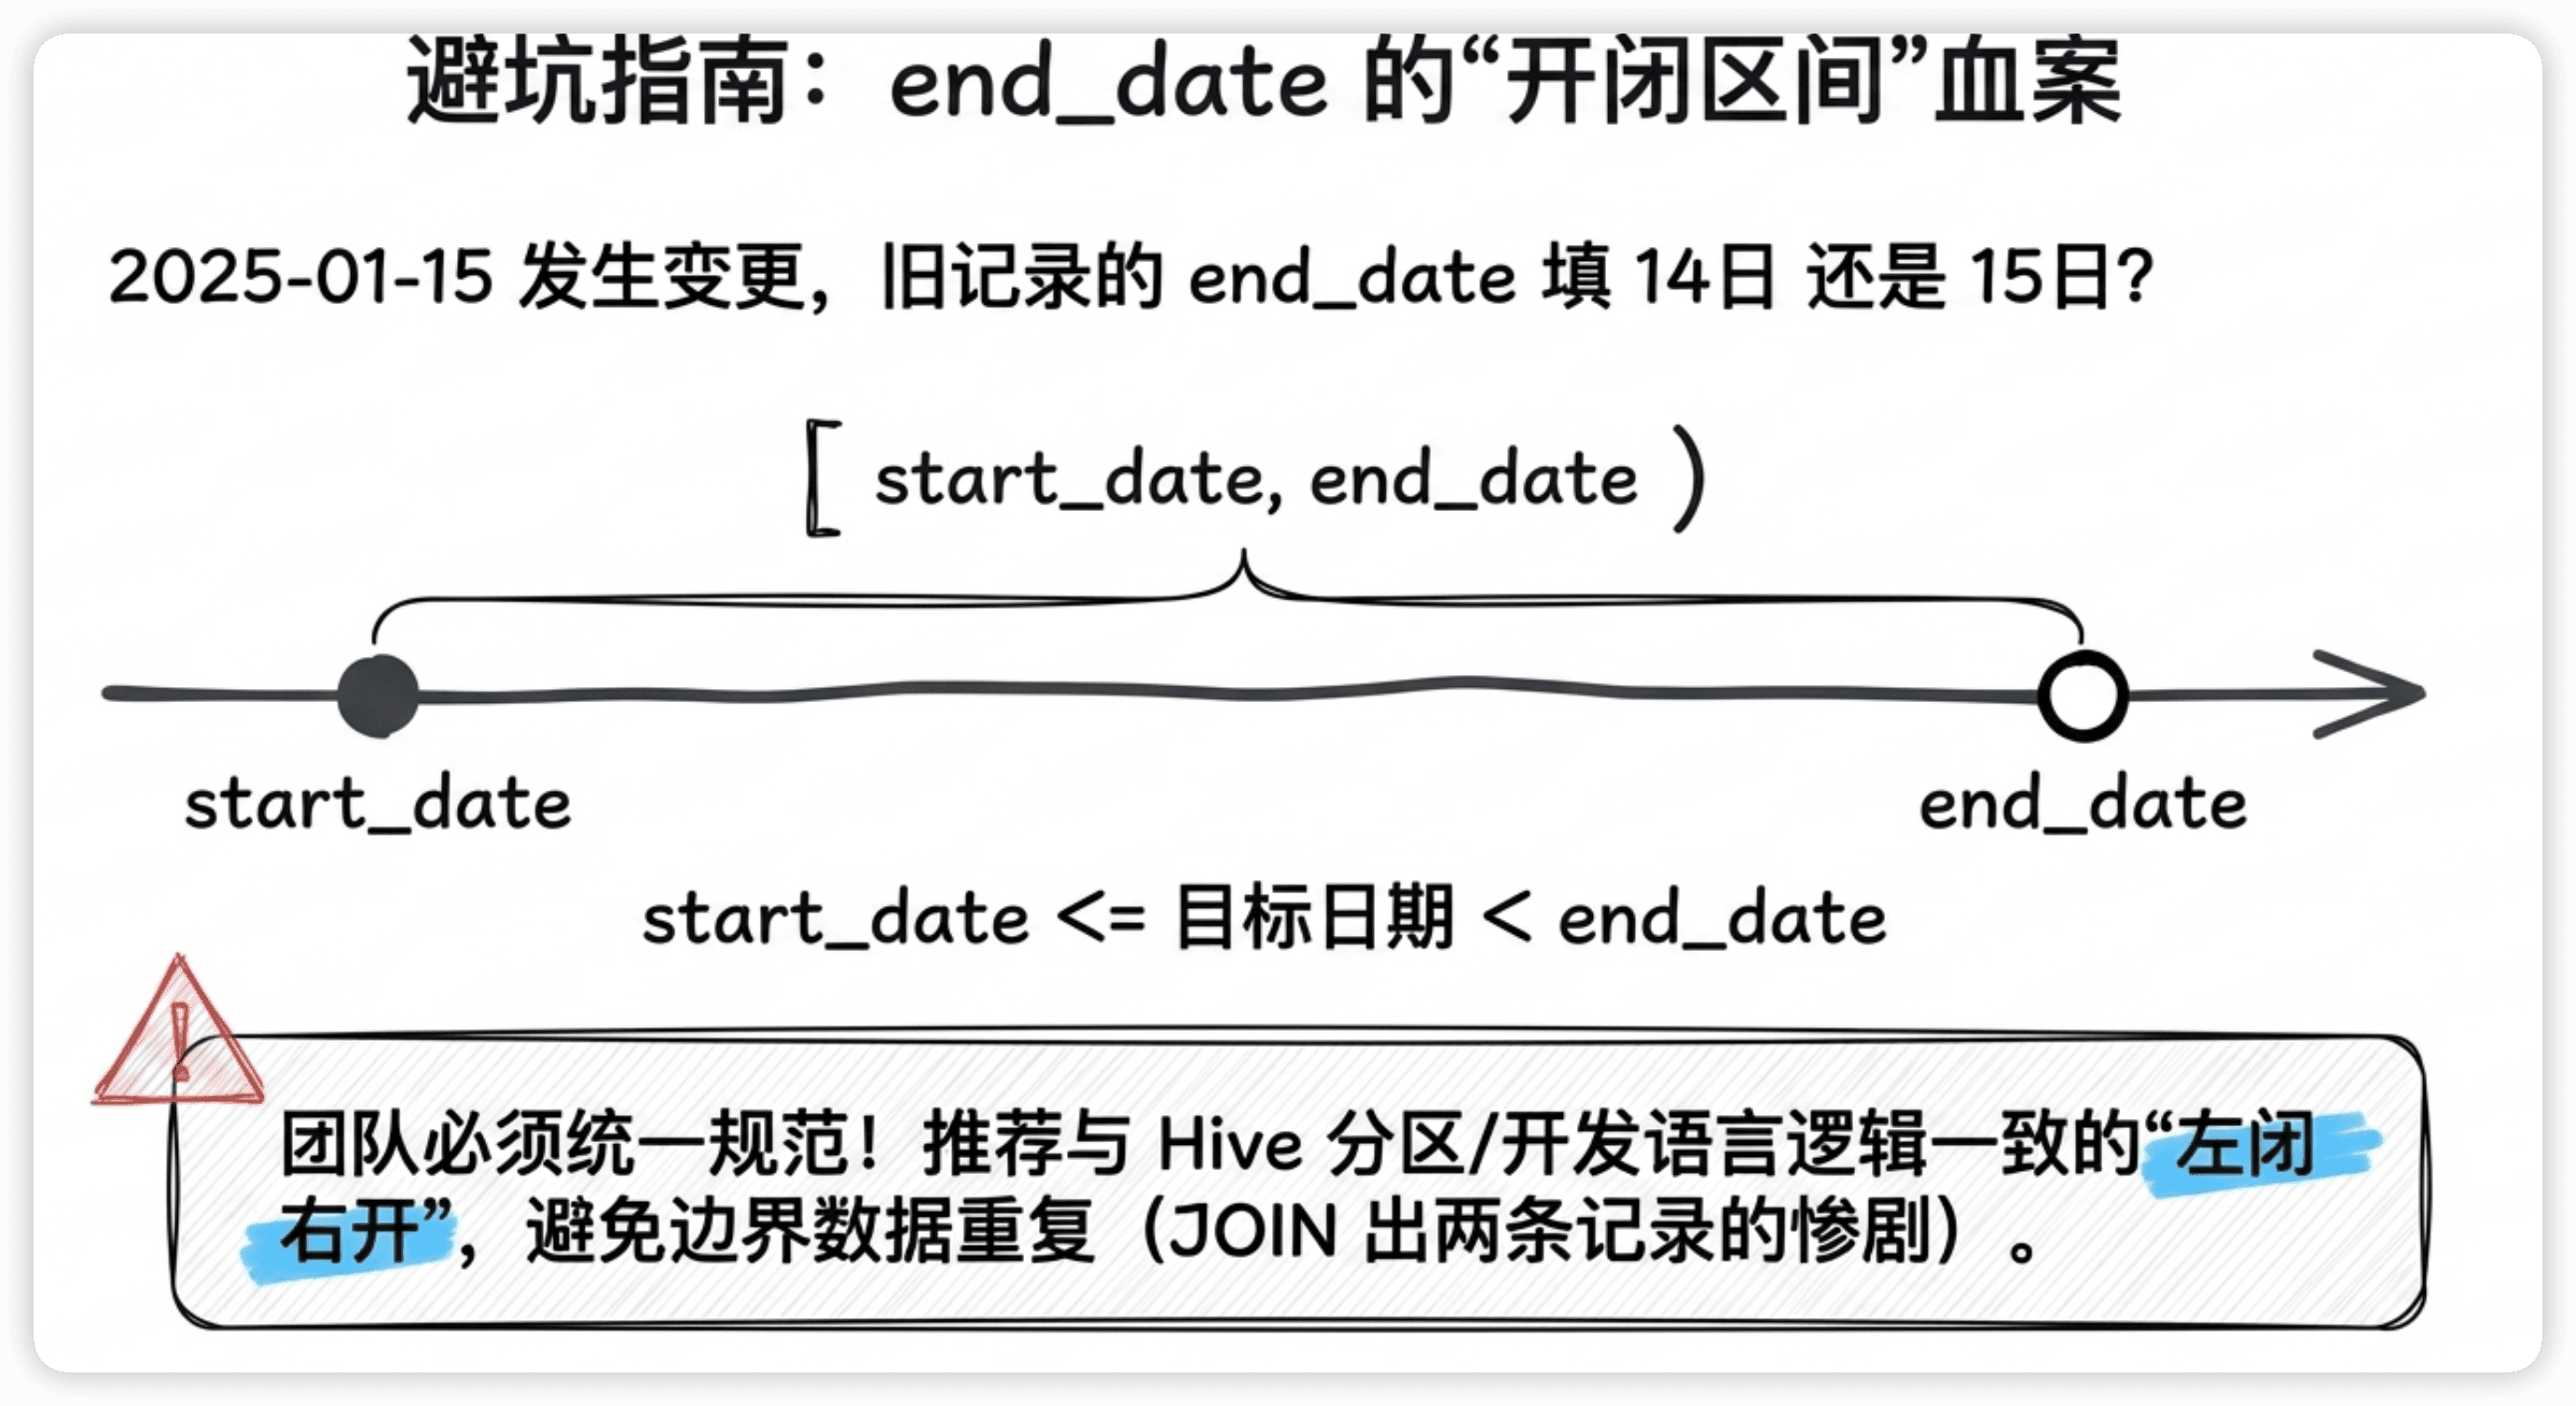
这是一个看起来很小但实际上能引发严重Bug的问题。
end_date到底是闭区间还是开区间?也就是说,用户在2025-01-15换了手机号,旧记录的end_date是写2025-01-14(最后一天有效)还是2025-01-15(从这天开始无效)?
两种做法都有人用,但团队内部必须统一。我们团队吃过亏——一个同事用闭区间,另一个同事用开区间,结果JOIN的时候边界那一天的数据出了两条,报表数字对不上,排查了大半天才发现。
我们后来统一用左闭右开:start_date <= 目标日期 < end_date。理由是这和Hive分区、Java/Python的日期区间处理逻辑一致,减少心智负担。
Type 3:新增列
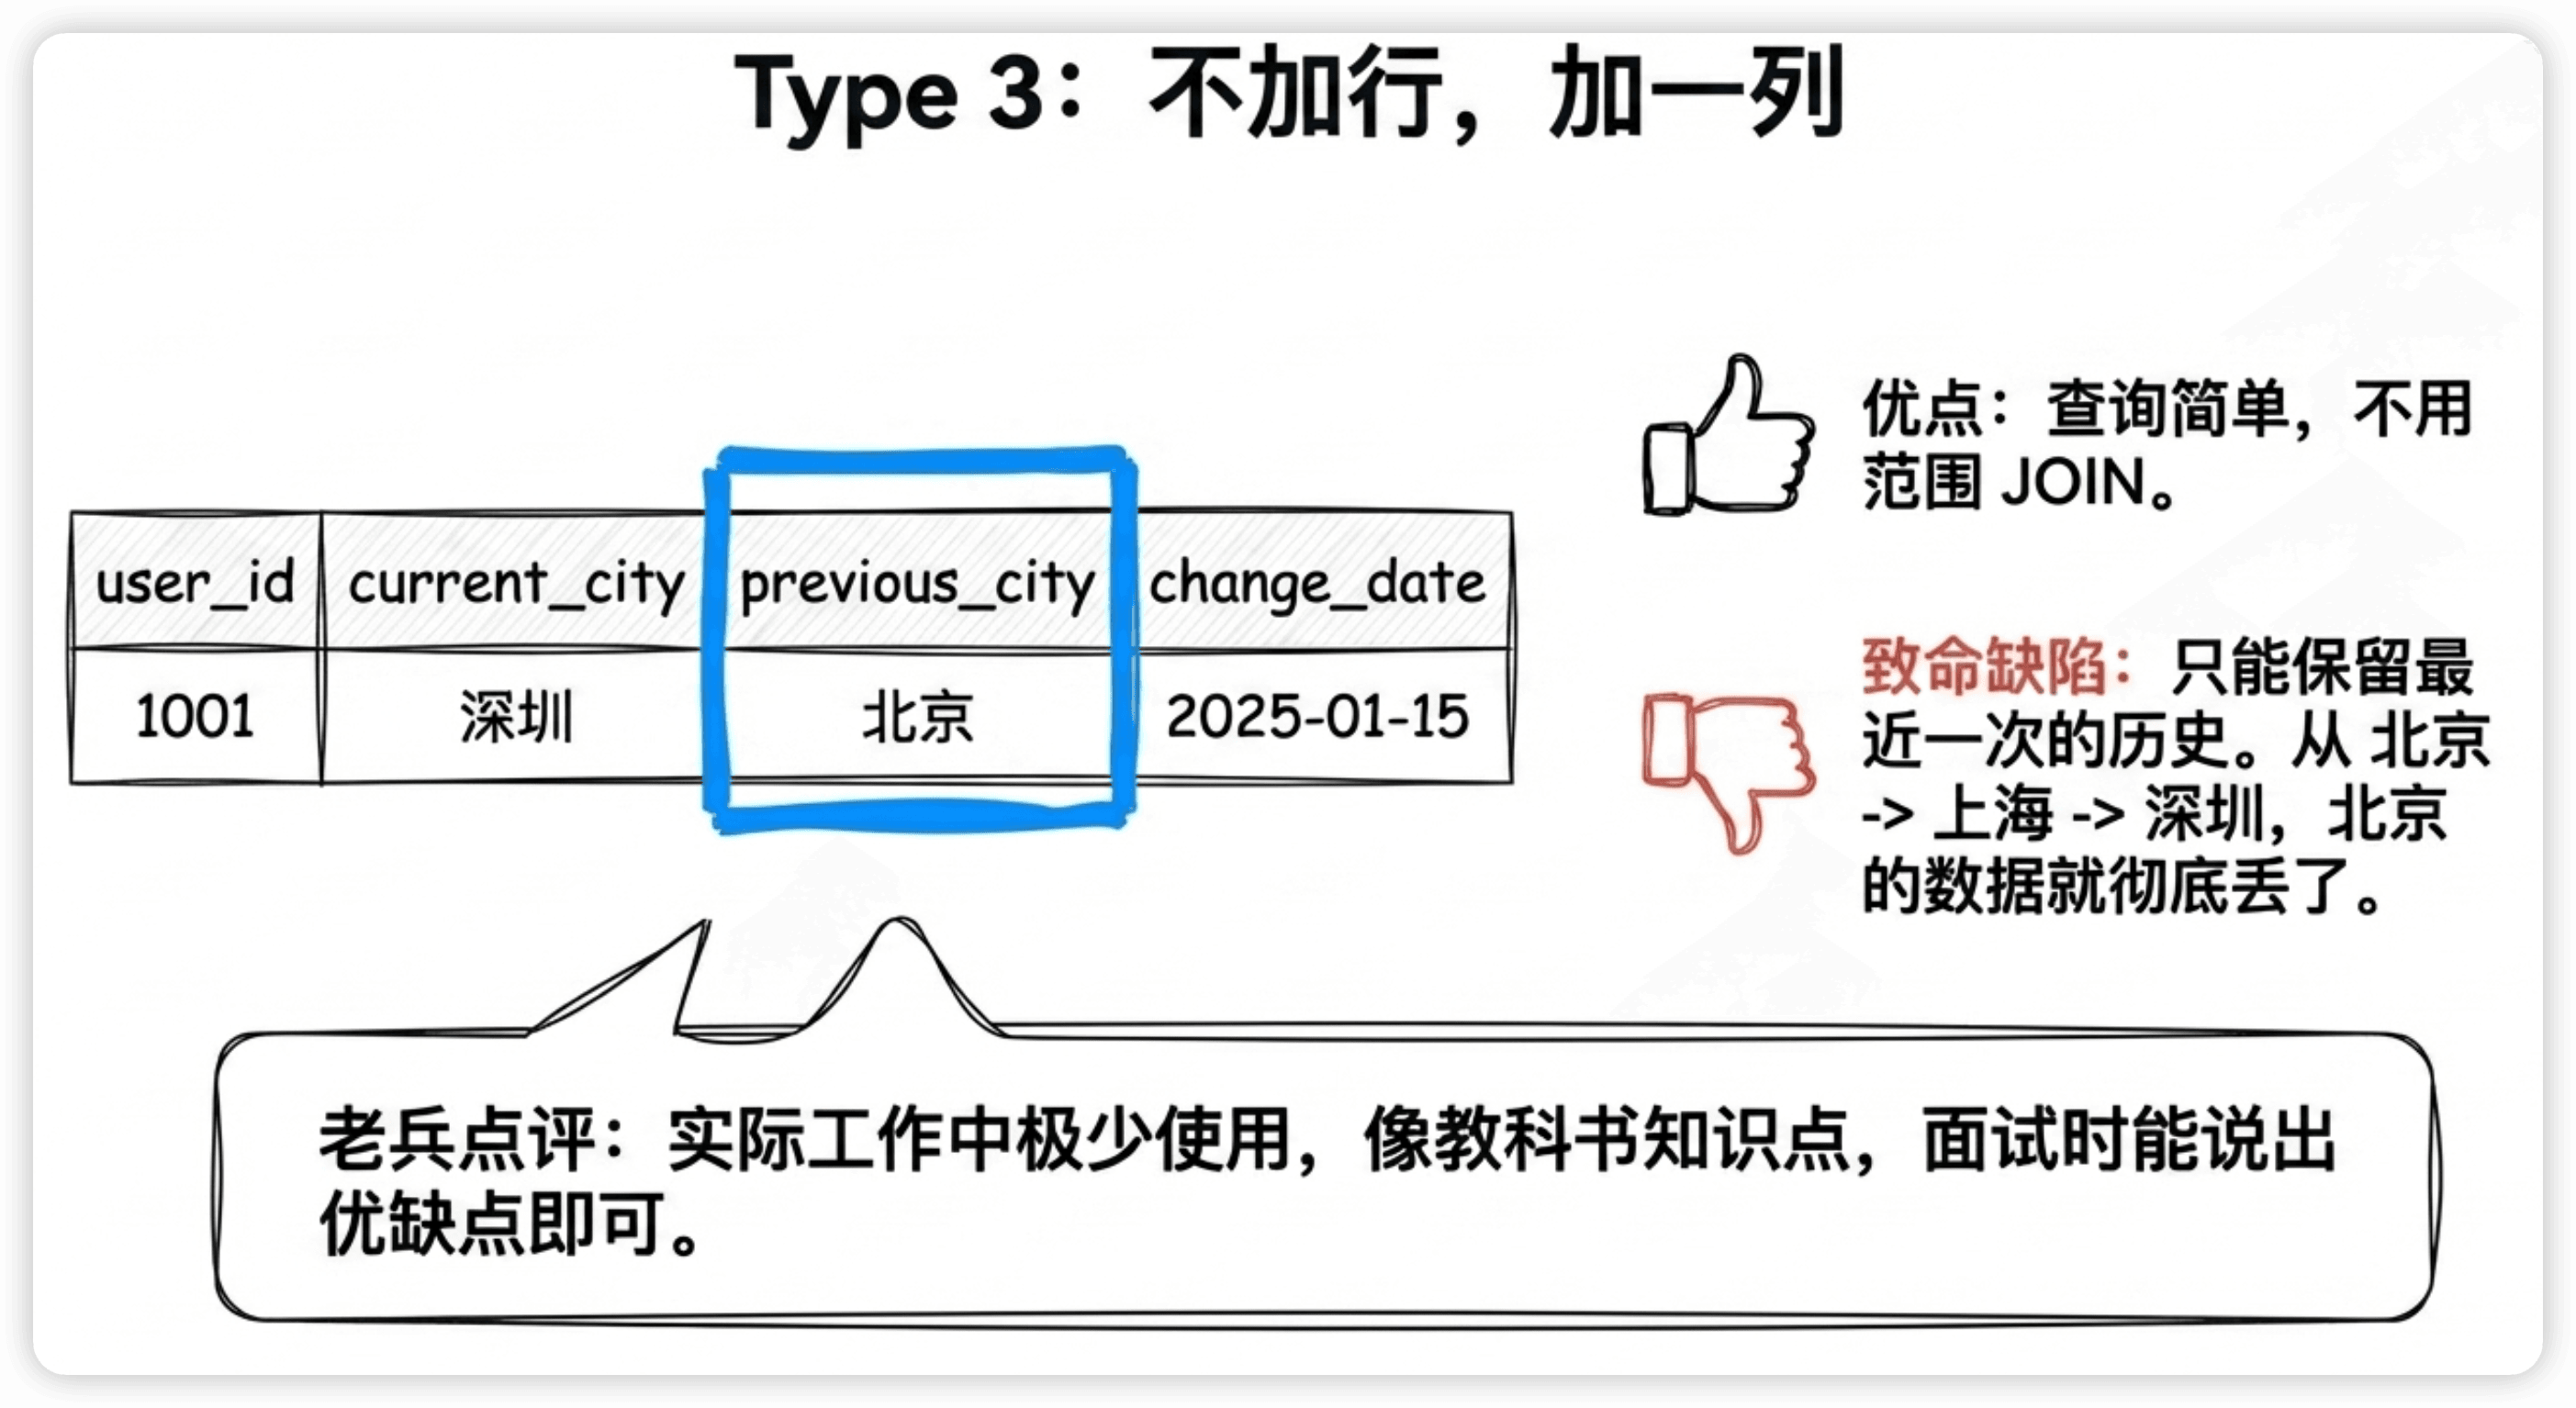
Type 3的思路完全不同——不是加行,而是加列。在维度表里增加一个previous_xxx字段,存上一次的值。
| user_id | current_city | previous_city | city_change_date |
|---|---|---|---|
| 1001 | 深圳 | 北京 | 2025-01-15 |
优点: 简单直观,不增加行数,查询不需要范围JOIN。
缺点: 只能保留最近一次的历史值。如果用户从北京搬到上海,再从上海搬到深圳,北京的记录就丢了。
适用场景: 只需要对比"变更前后"两个状态的分析(极少见)。
说实话,我在实际工作中从来没用过Type 3。它更像是教科书上的知识点,实际价值有限。面试时知道有这个类型、能说出优缺点就够了。
面试怎么答?
标准回答框架
「SCD有三种类型。Type 1直接覆盖,适合不关心历史的场景。Type 3新增列,只能保留上一次值,用得很少。我们主要用Type 2拉链表——比如用户维度表,用户可能改手机号、改收货地址,我们需要在分析订单时关联到下单时的用户状态,所以必须保留历史。实现上用start_date/end_date做有效期标记,事实表通过日期范围JOIN来匹配当时的维度快照。」
追问防线
追问1:拉链表数据量会不会膨胀很快?
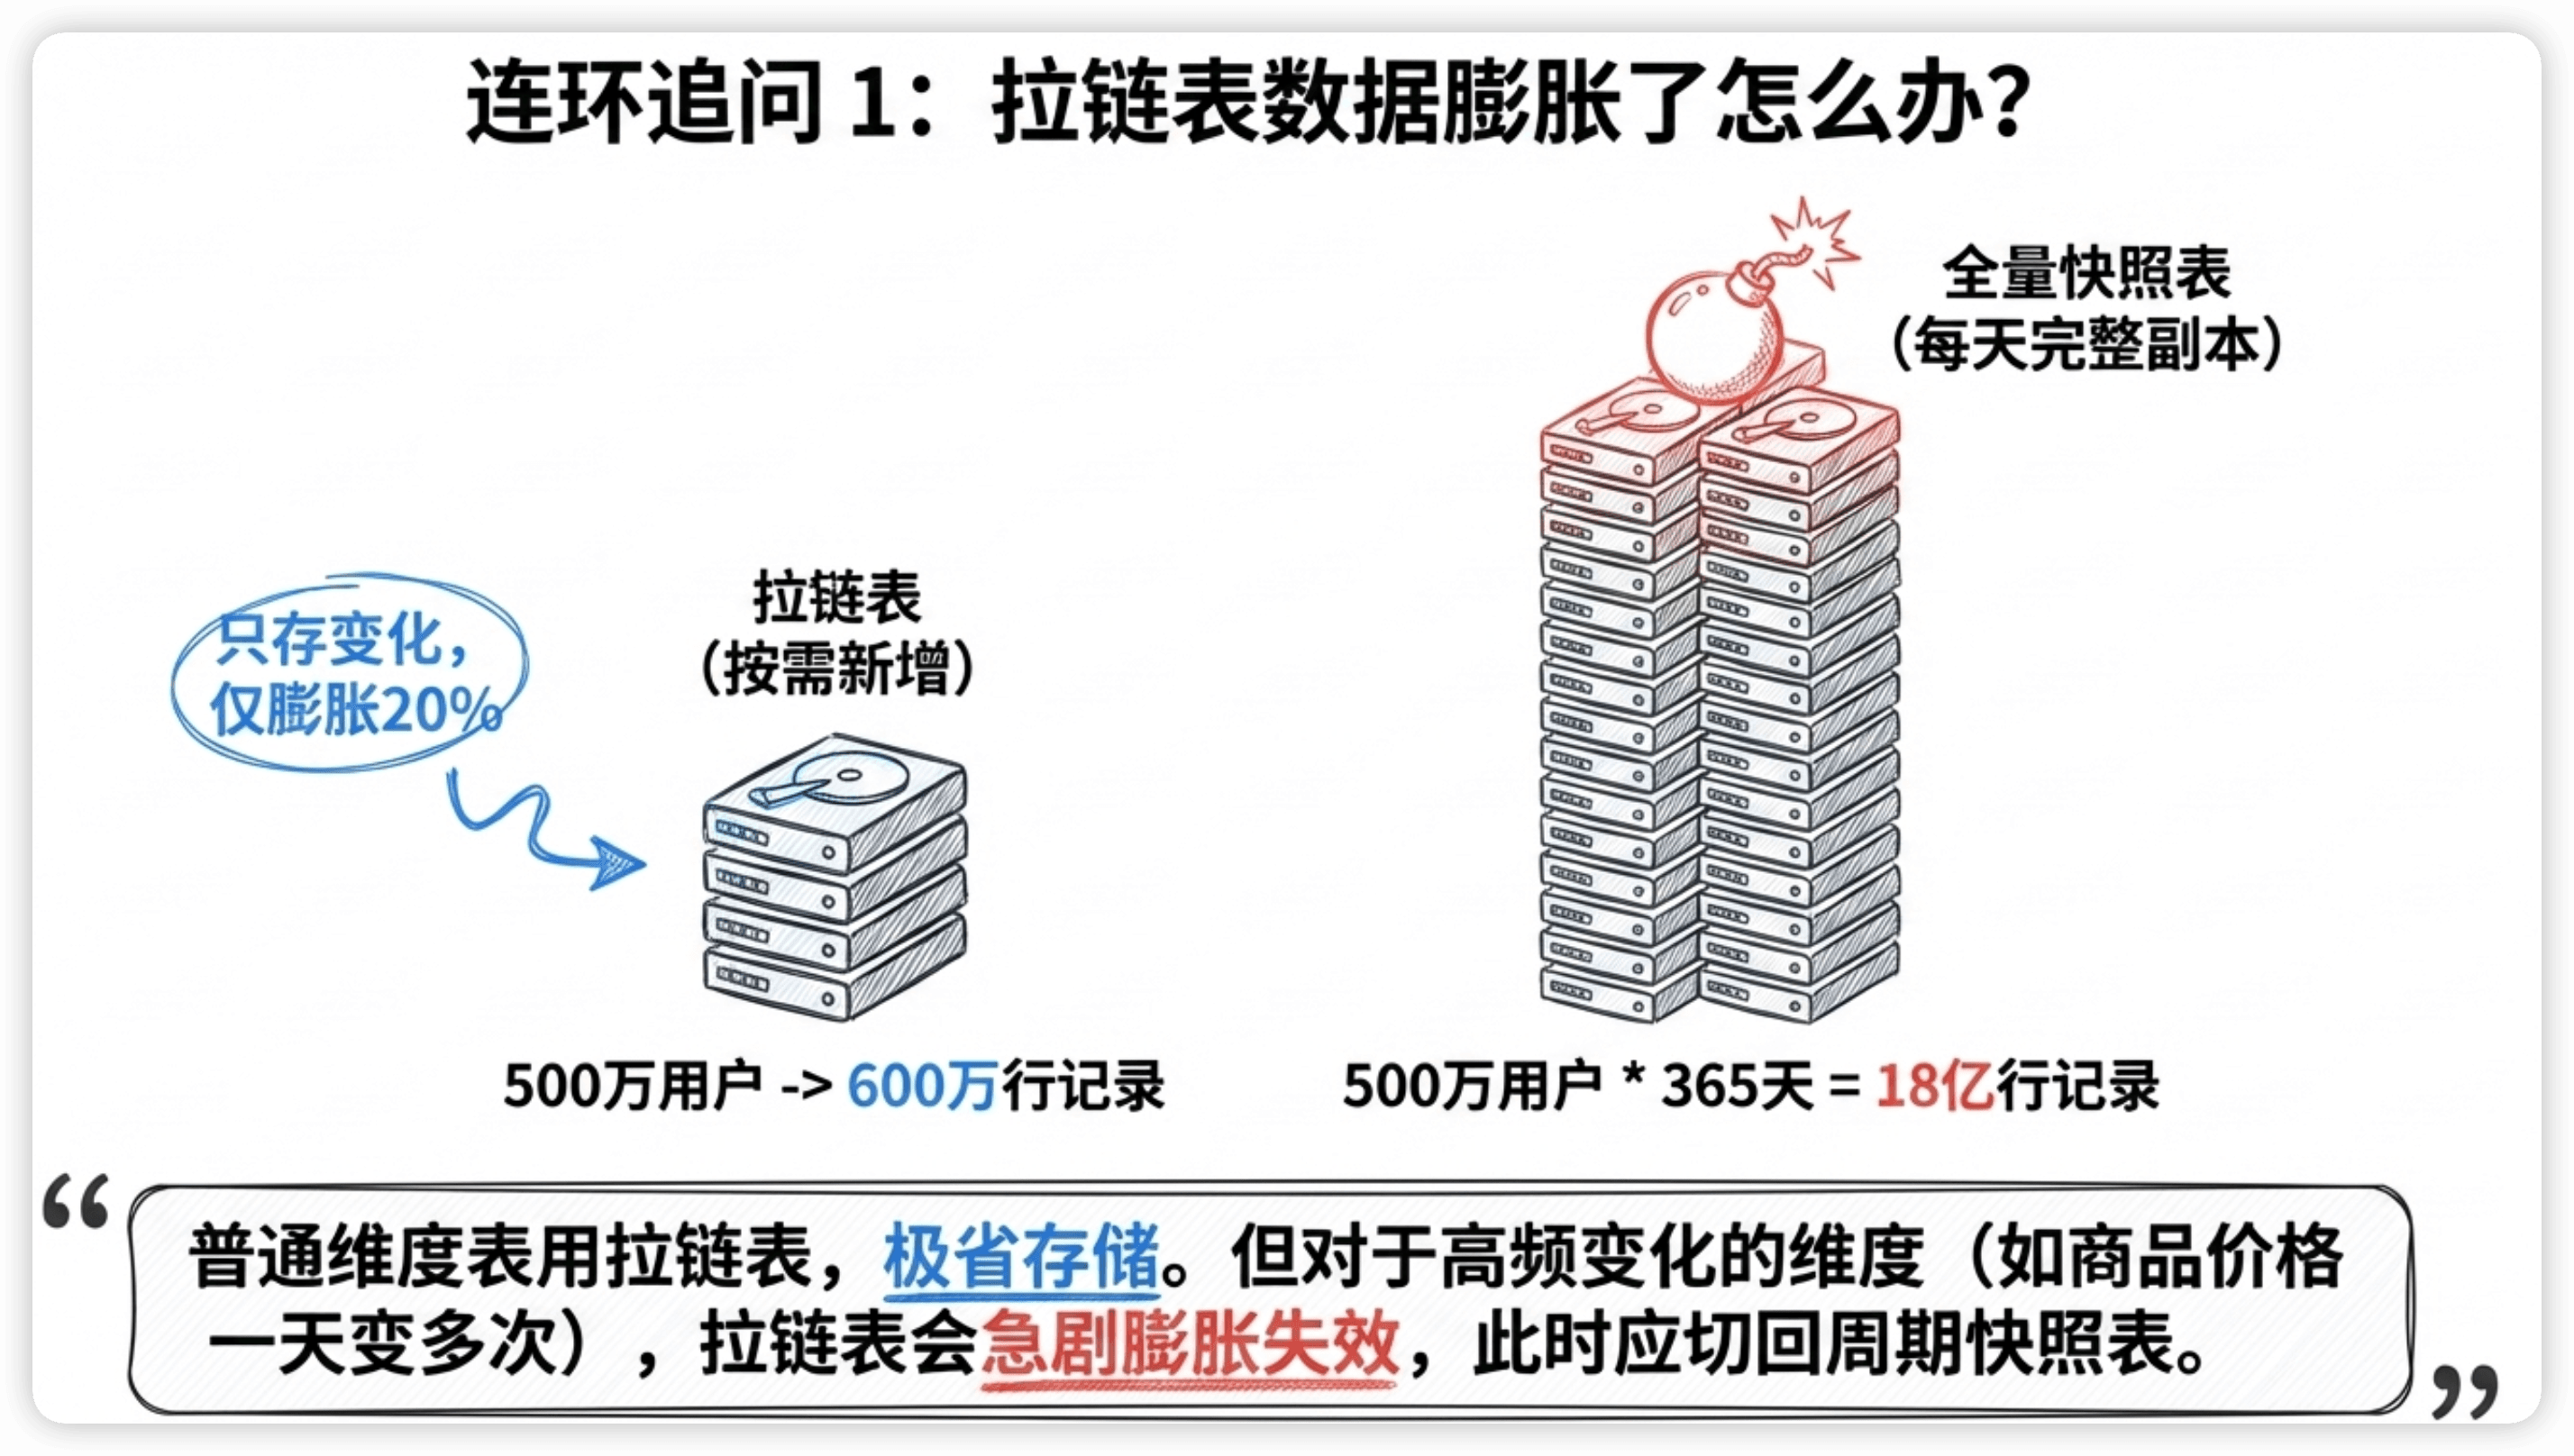
不会。只有发生变化的维度记录才会新增一行。如果一个用户从注册到现在什么信息都没改过,拉链表里永远只有一行。
实际上,大部分用户的维度信息变化频率很低——可能一年都不改一次手机号或地址。我们的用户维度表大概有500万用户,拉链表里总共也就600多万行,膨胀比例只有20%左右。
但有个例外:高频变化的维度不适合用拉链表。比如商品价格如果一天改好几次,拉链表会急剧膨胀。这种场景更适合用周期快照表——每天拍一次快照,记录当天的价格状态。
追问2:拉链表和全量快照表有什么区别?
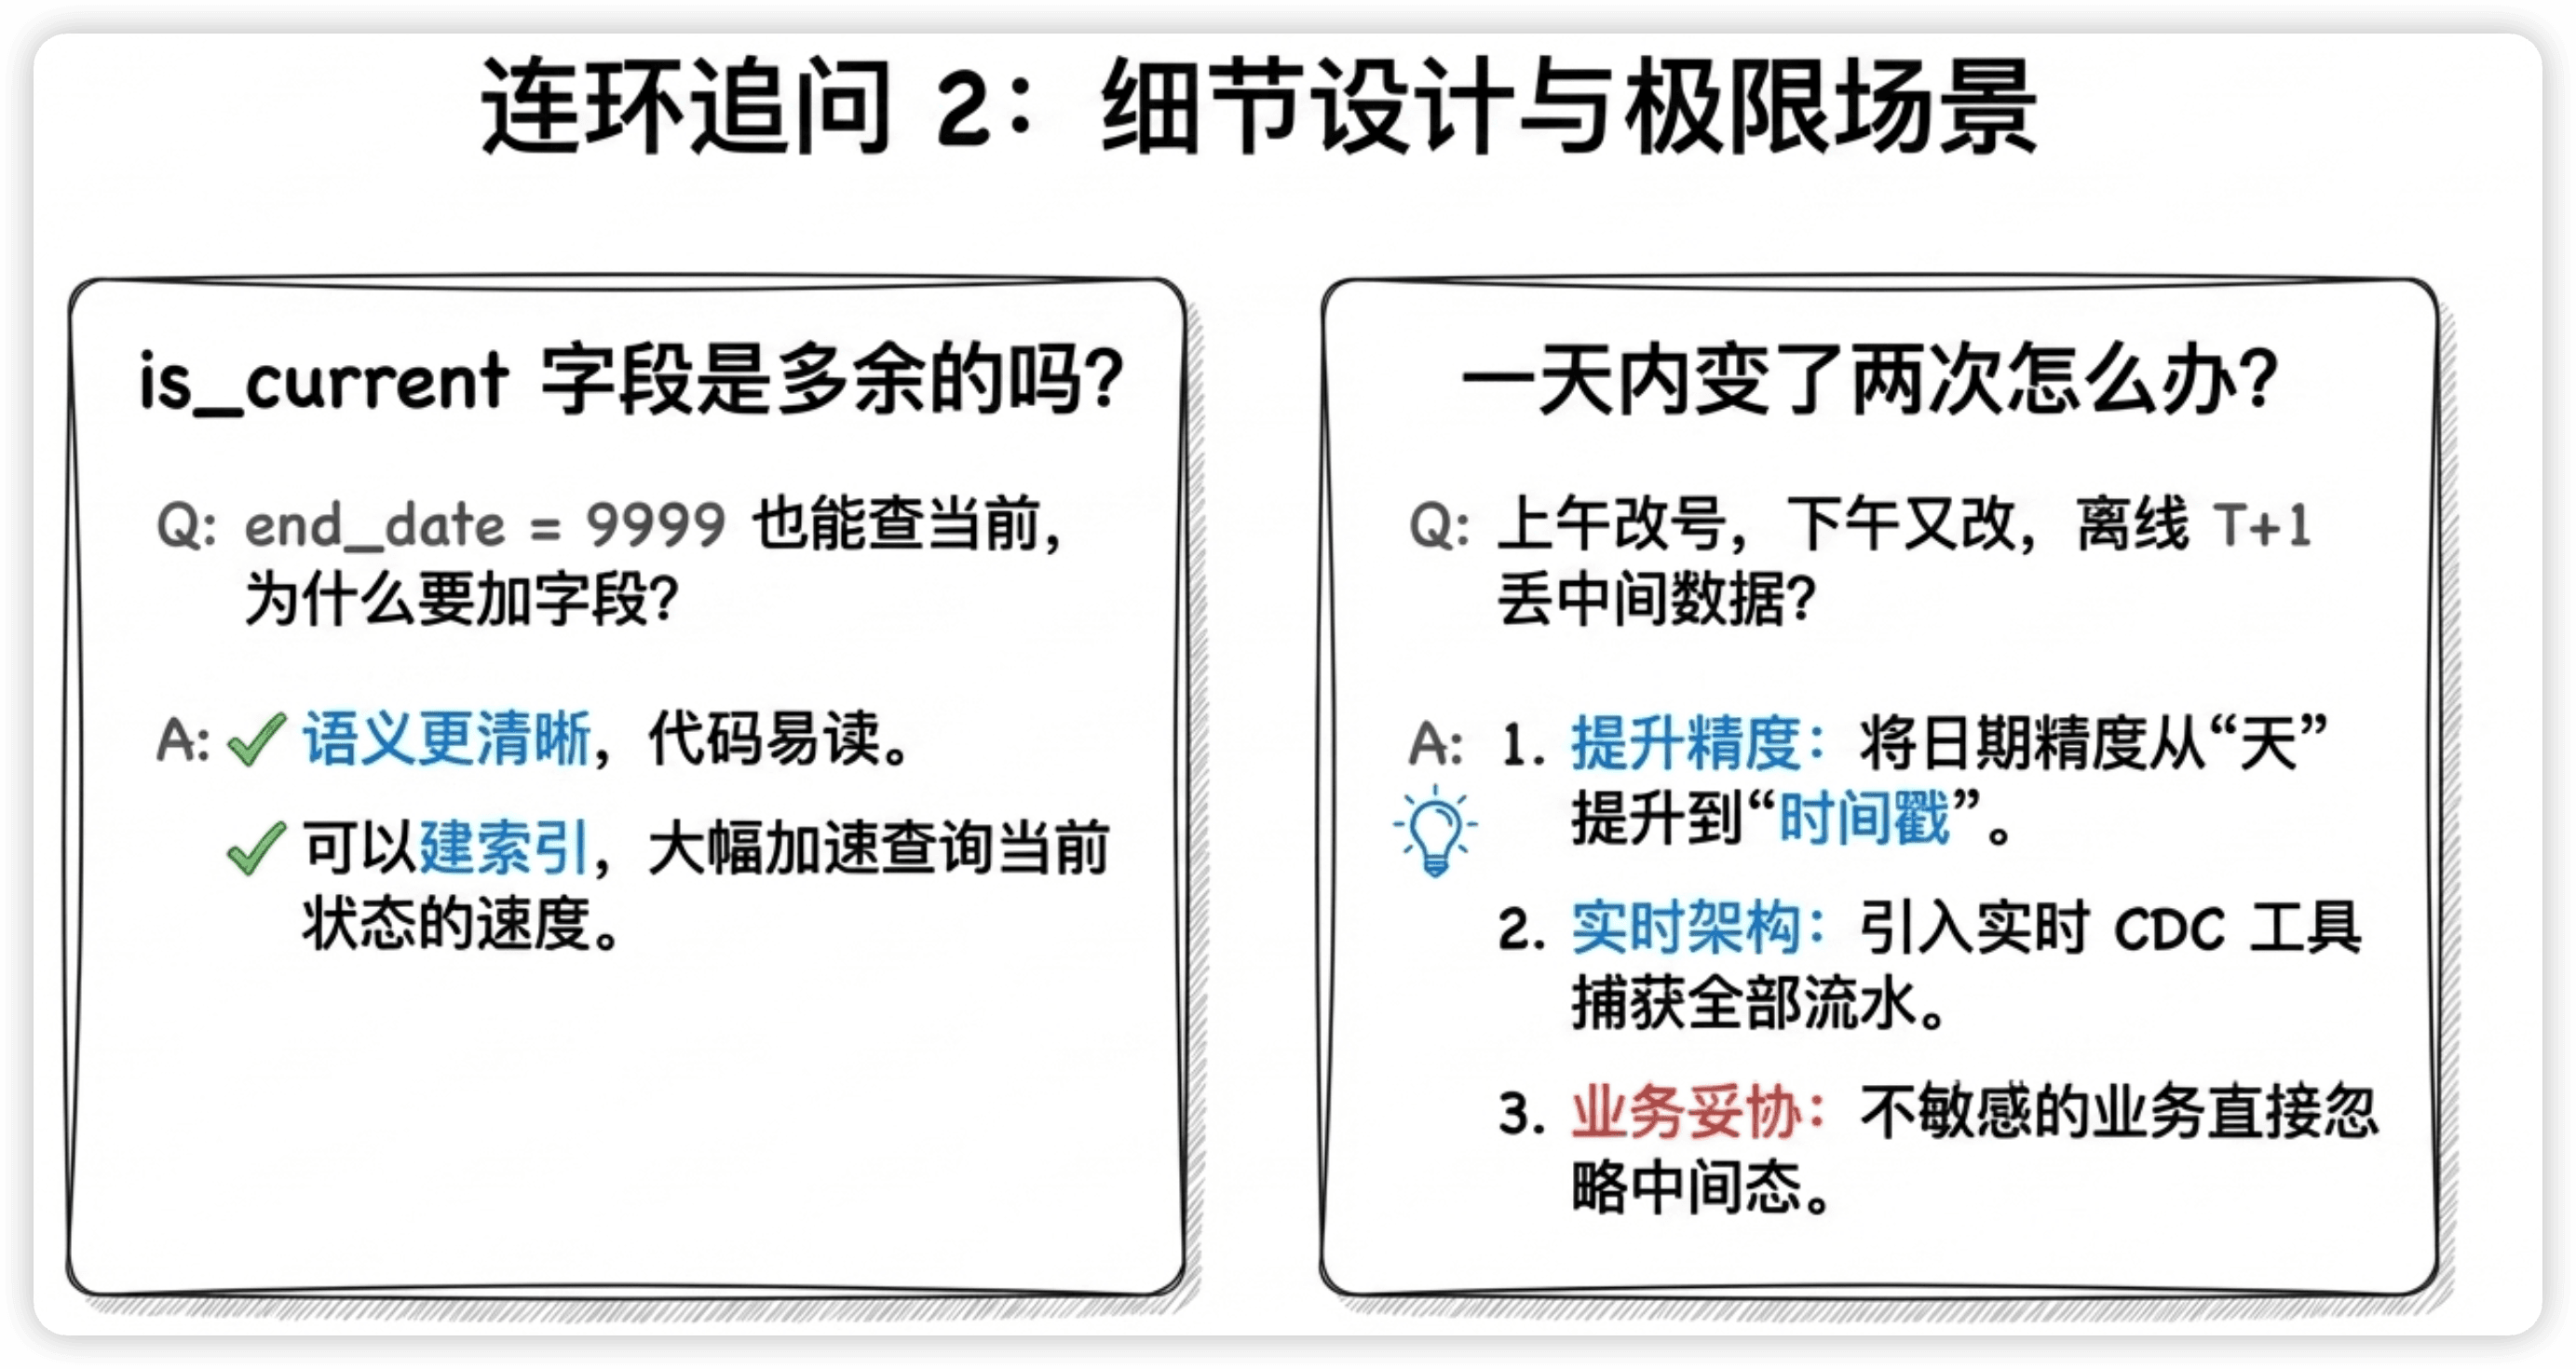
全量快照表是每天存一份完整的维度表副本。500万用户的表,每天500万行,一年就是18亿行——存储成本巨大。
拉链表只存"变化",同一个用户如果信息没变,只存一行。存储效率远高于全量快照。
但全量快照表也有优势:查询简单(WHERE dt = '目标日期'就行),不需要范围JOIN。所以实际工作中两者都在用——维度表用拉链表节省存储,某些DWS层的汇总表用全量快照简化查询。
追问3:is_current字段有必要吗?不用end_date判断就行了吗?
技术上用end_date = '9999-12-31'完全可以代替is_current = 1。但加上is_current有两个好处:第一,语义更清晰,代码可读性好;第二,可以在is_current上建索引,加速"只查当前有效记录"的场景。
不过也有团队不加这个字段,认为是冗余信息。这个没有对错,团队统一就行。
追问4:如果一天之内维度变了两次怎么办?
好问题。比如用户上午改了手机号,下午又改了一次。如果你的调度任务是每天跑一次,拉链表只能捕捉到最终状态(下午的手机号),中间状态会丢失。
如果业务对"一天多次变化"敏感(说实话大部分业务不敏感),有两种解决方案:一是把start_date/end_date的精度从"天"改成"时间戳";二是用CDC(变更数据捕获)工具实时捕获变更,写入实时拉链表。
我的经验是,除非是金融交易类业务,否则天级别的拉链表粒度已经够用了。
总结
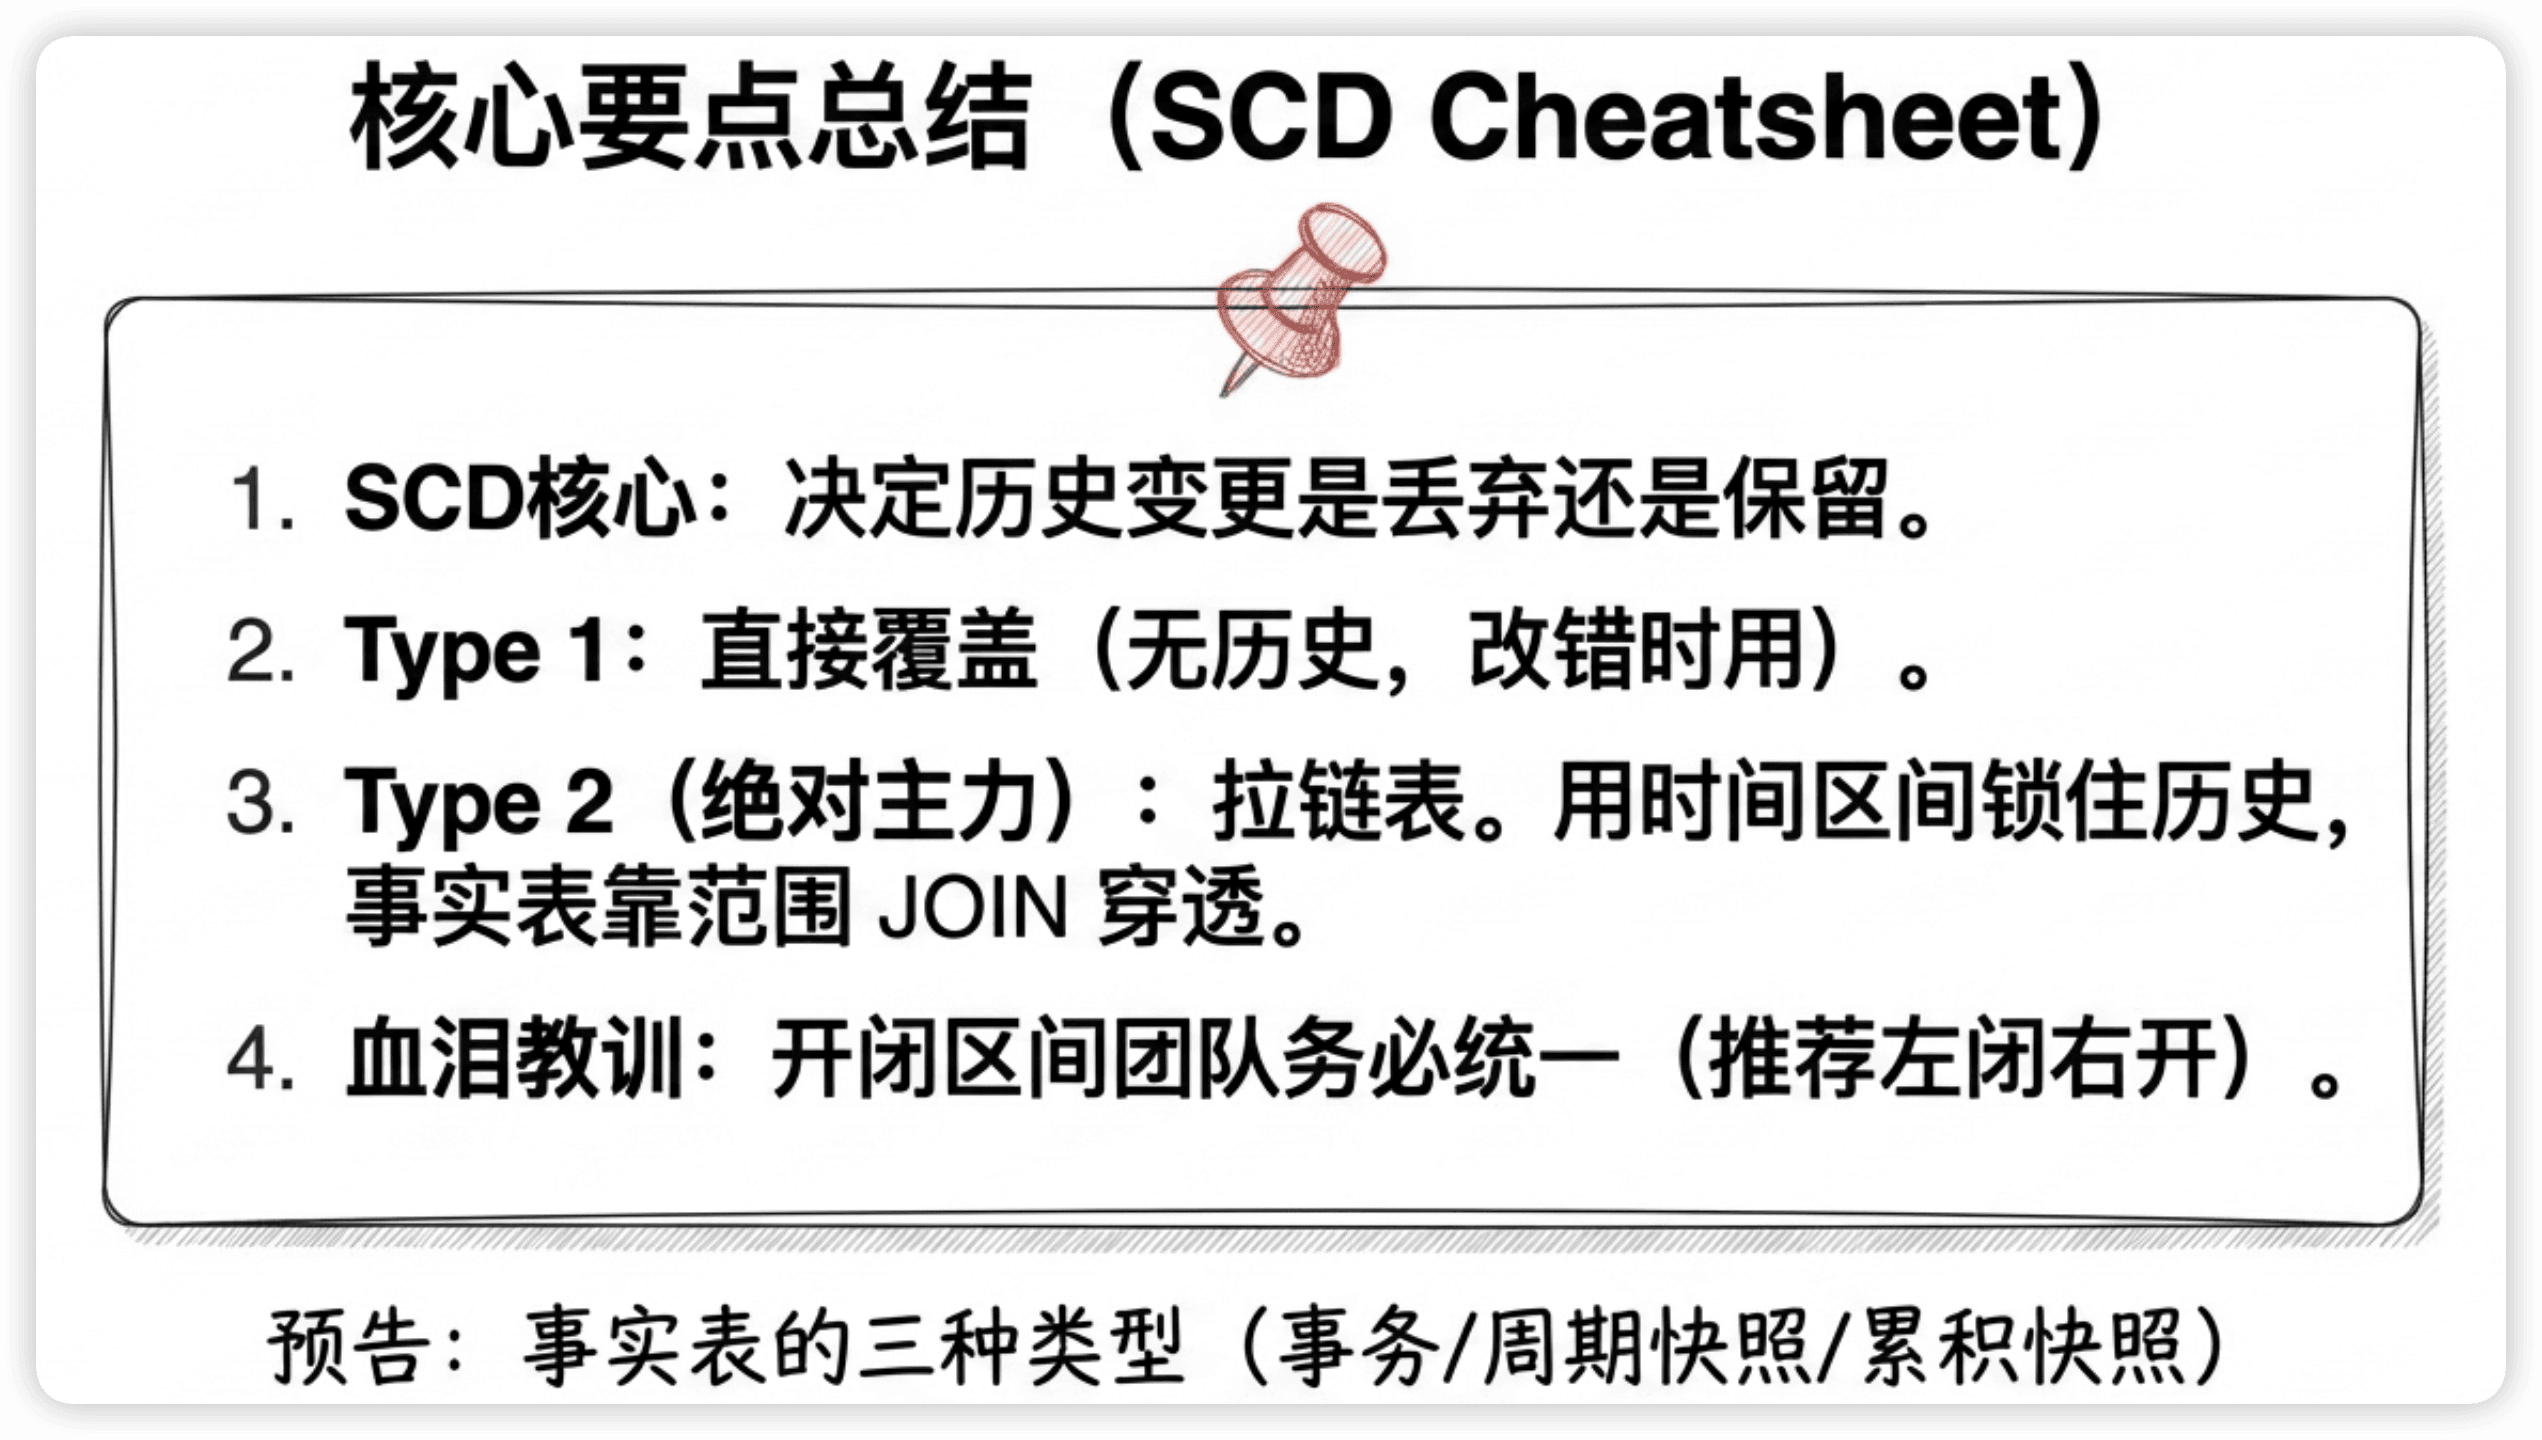
- SCD的核心问题:维度变了,历史要不要保留
- Type 1(直接覆盖):简单但丢历史,适合修正错误或不关心历史的场景
- Type 2(拉链表):保留完整变化历史,用start_date/end_date标记有效期,生产中最常用
- Type 3(新增列):只存上一次值,实际很少用
- 拉链表三个关键能力:查当前状态、查历史快照、事实表关联历史维度
- 团队必须统一end_date的开闭区间规则,不然一定会踩坑