数据质量监控
广告ROI报表突然翻了3倍,投放团队兴奋了一上午,结果是数据错了。
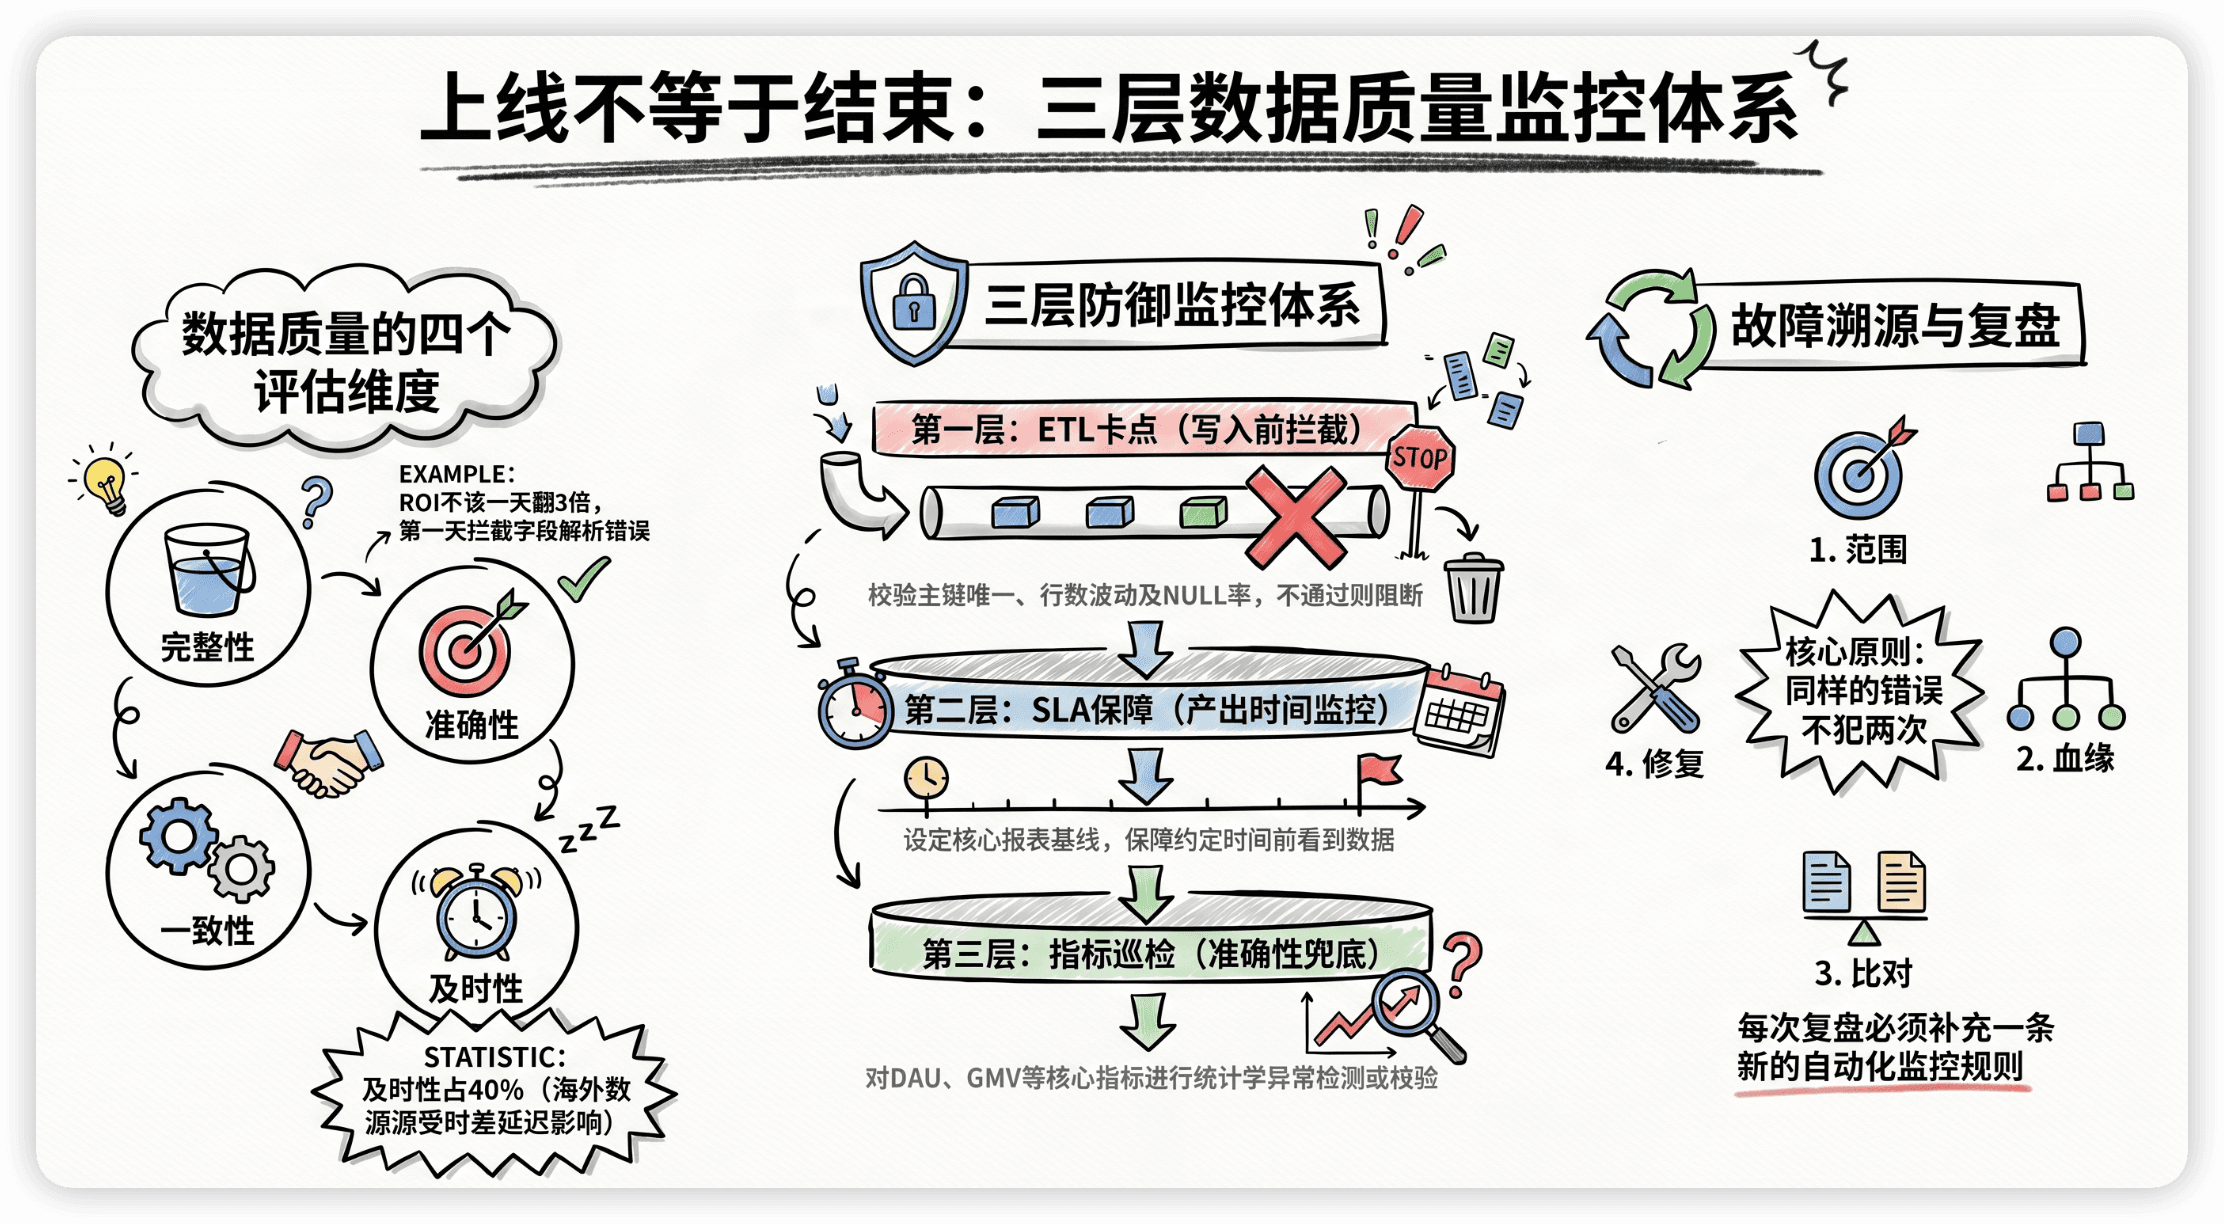
排查下来,原因是广告平台的API更新了字段名,我们的解析脚本没同步更新,把"展示次数"字段的值解析到了"收入金额"字段上。展示次数比收入金额大得多,ROI自然"暴涨"。
| 维度 | 定义 | 对应的问题 | 监控方式 |
|---|---|---|---|
| 完整性 | 数据有没有漏 | 行数变少了?字段大面积NULL? | 行数对比、NULL率检查 |
| 准确性 | 数据对不对 | 金额翻倍了?比率超过100%? | 关键指标波动检查、逻辑合理性校验 |
| 一致性 | 多处数据一不一样 | DWS和ADS的GMV对不上? | 跨表/跨层对数 |
| 及时性 | 数据准不准时到 | 报表8点该出但9点还是空的? | 分区产出时间监控 |
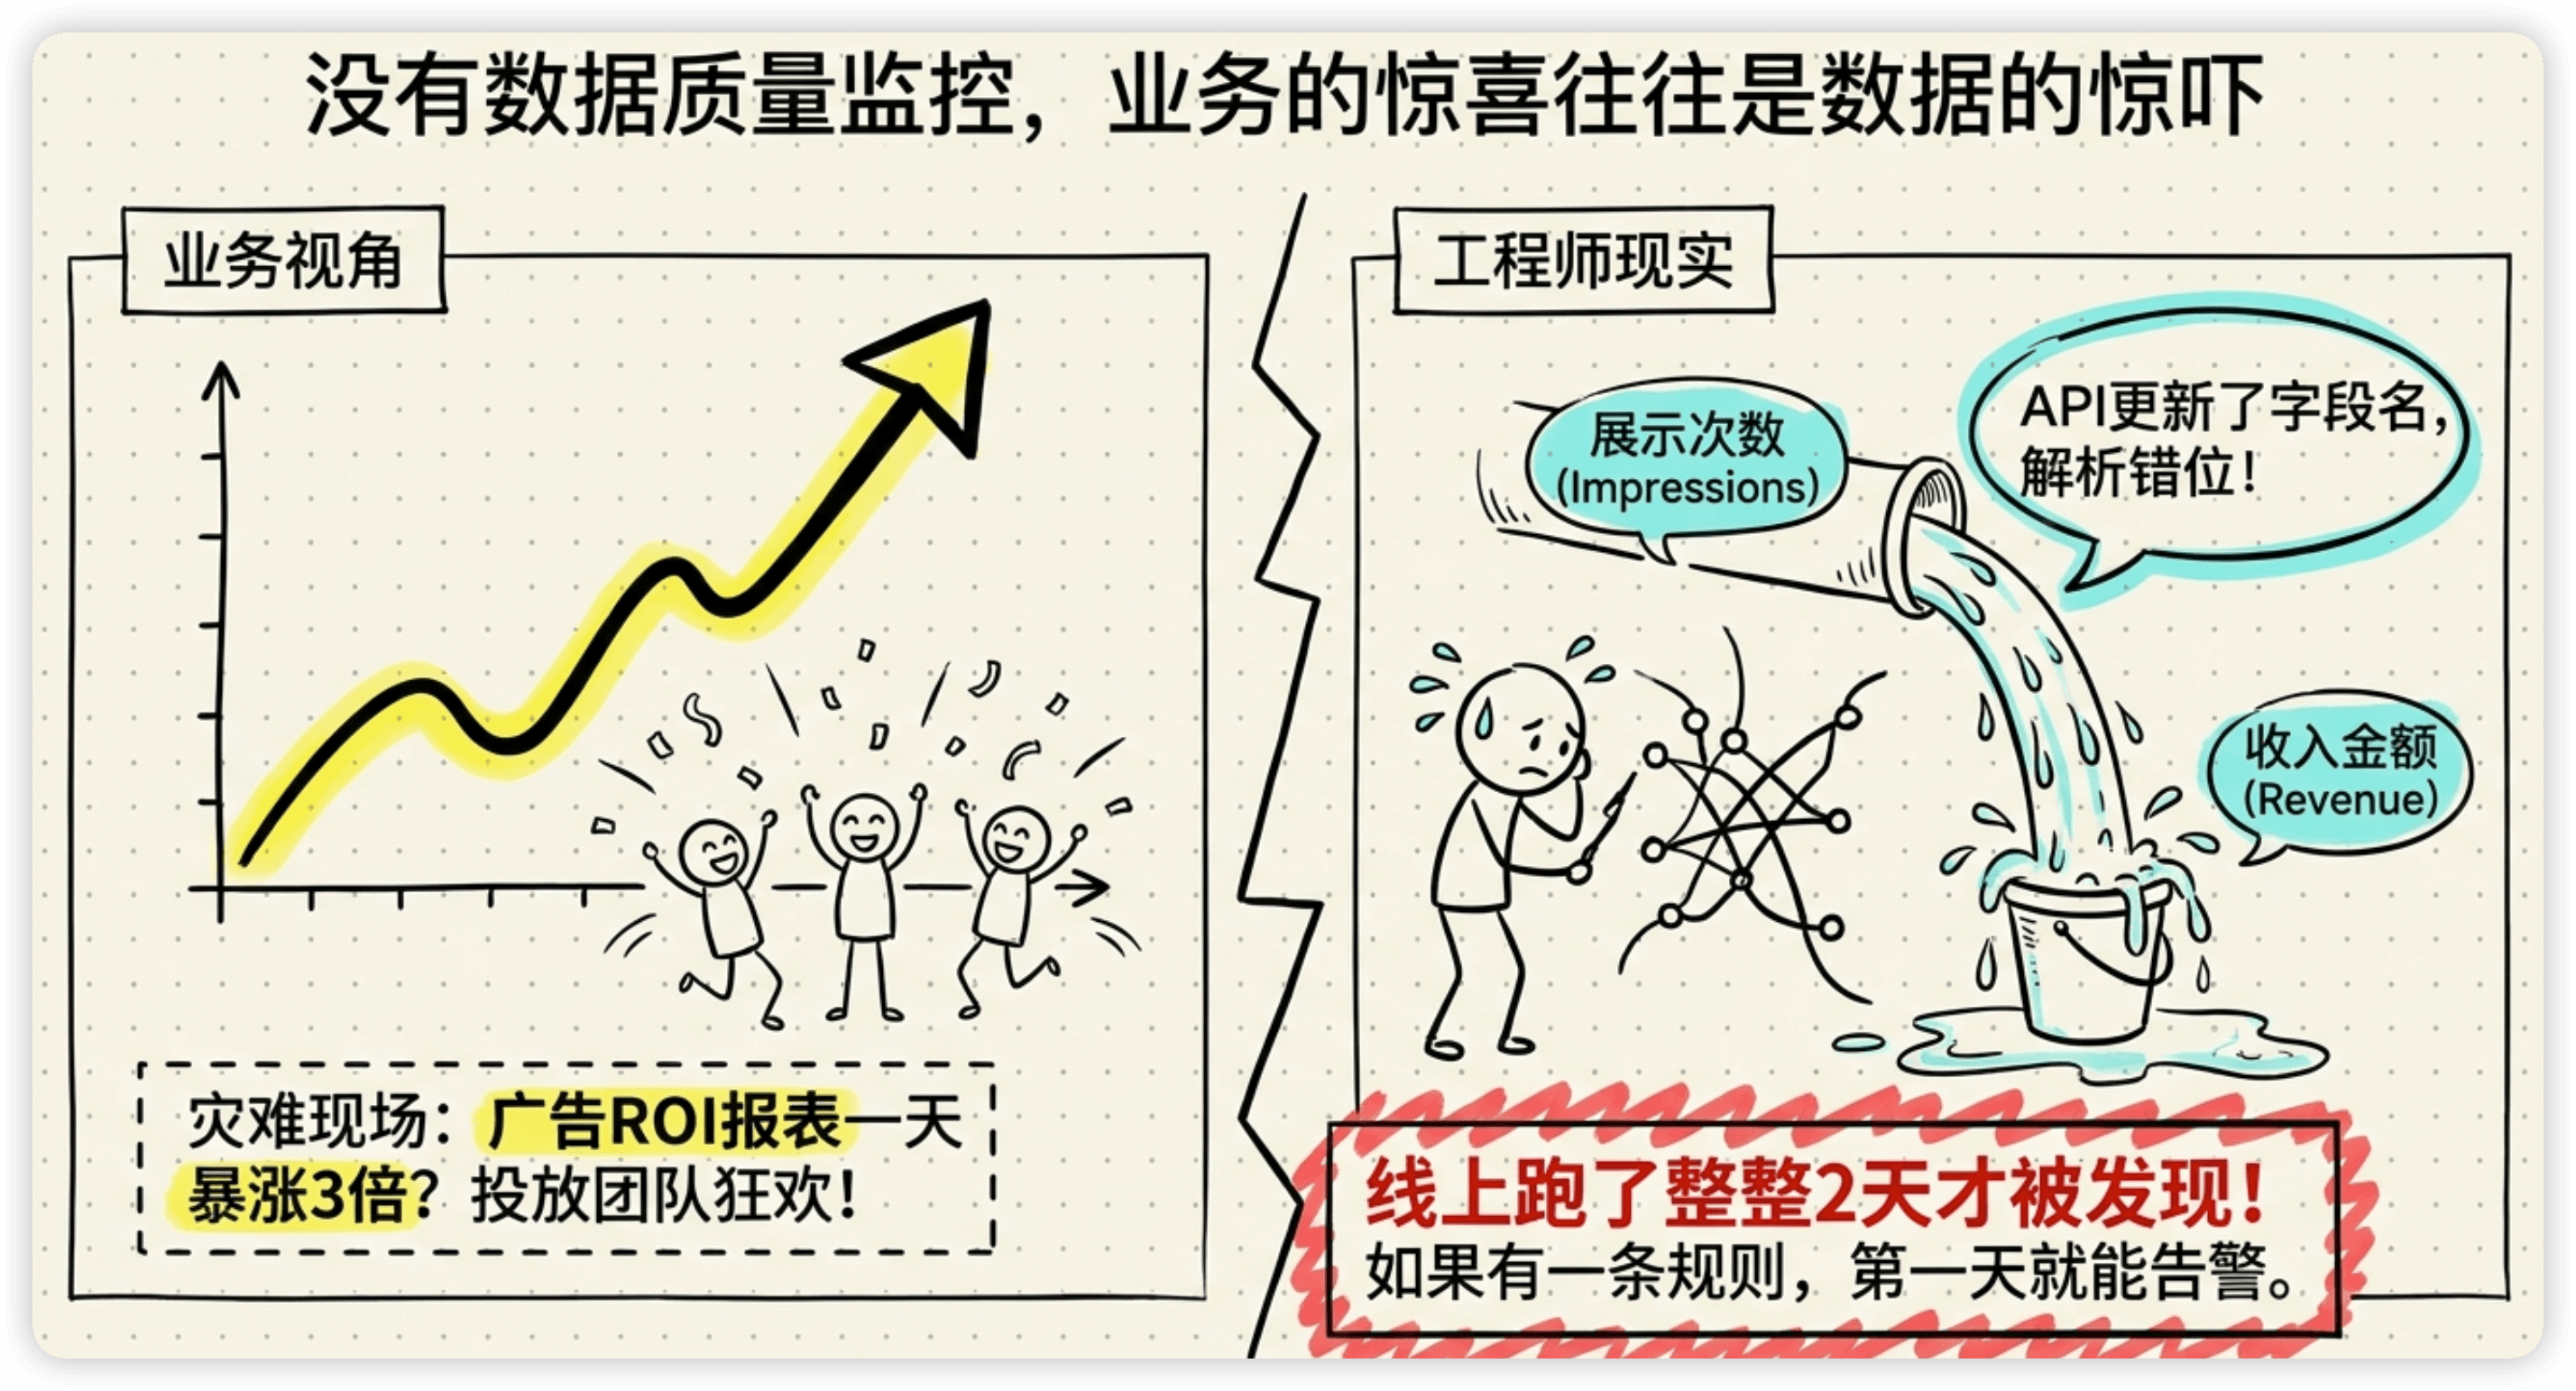
这个问题在线上跑了整整两天才被发现——因为没有数据质量监控。如果有一个"ROI不可能一天翻3倍"的合理性校验,第一天就能告警。
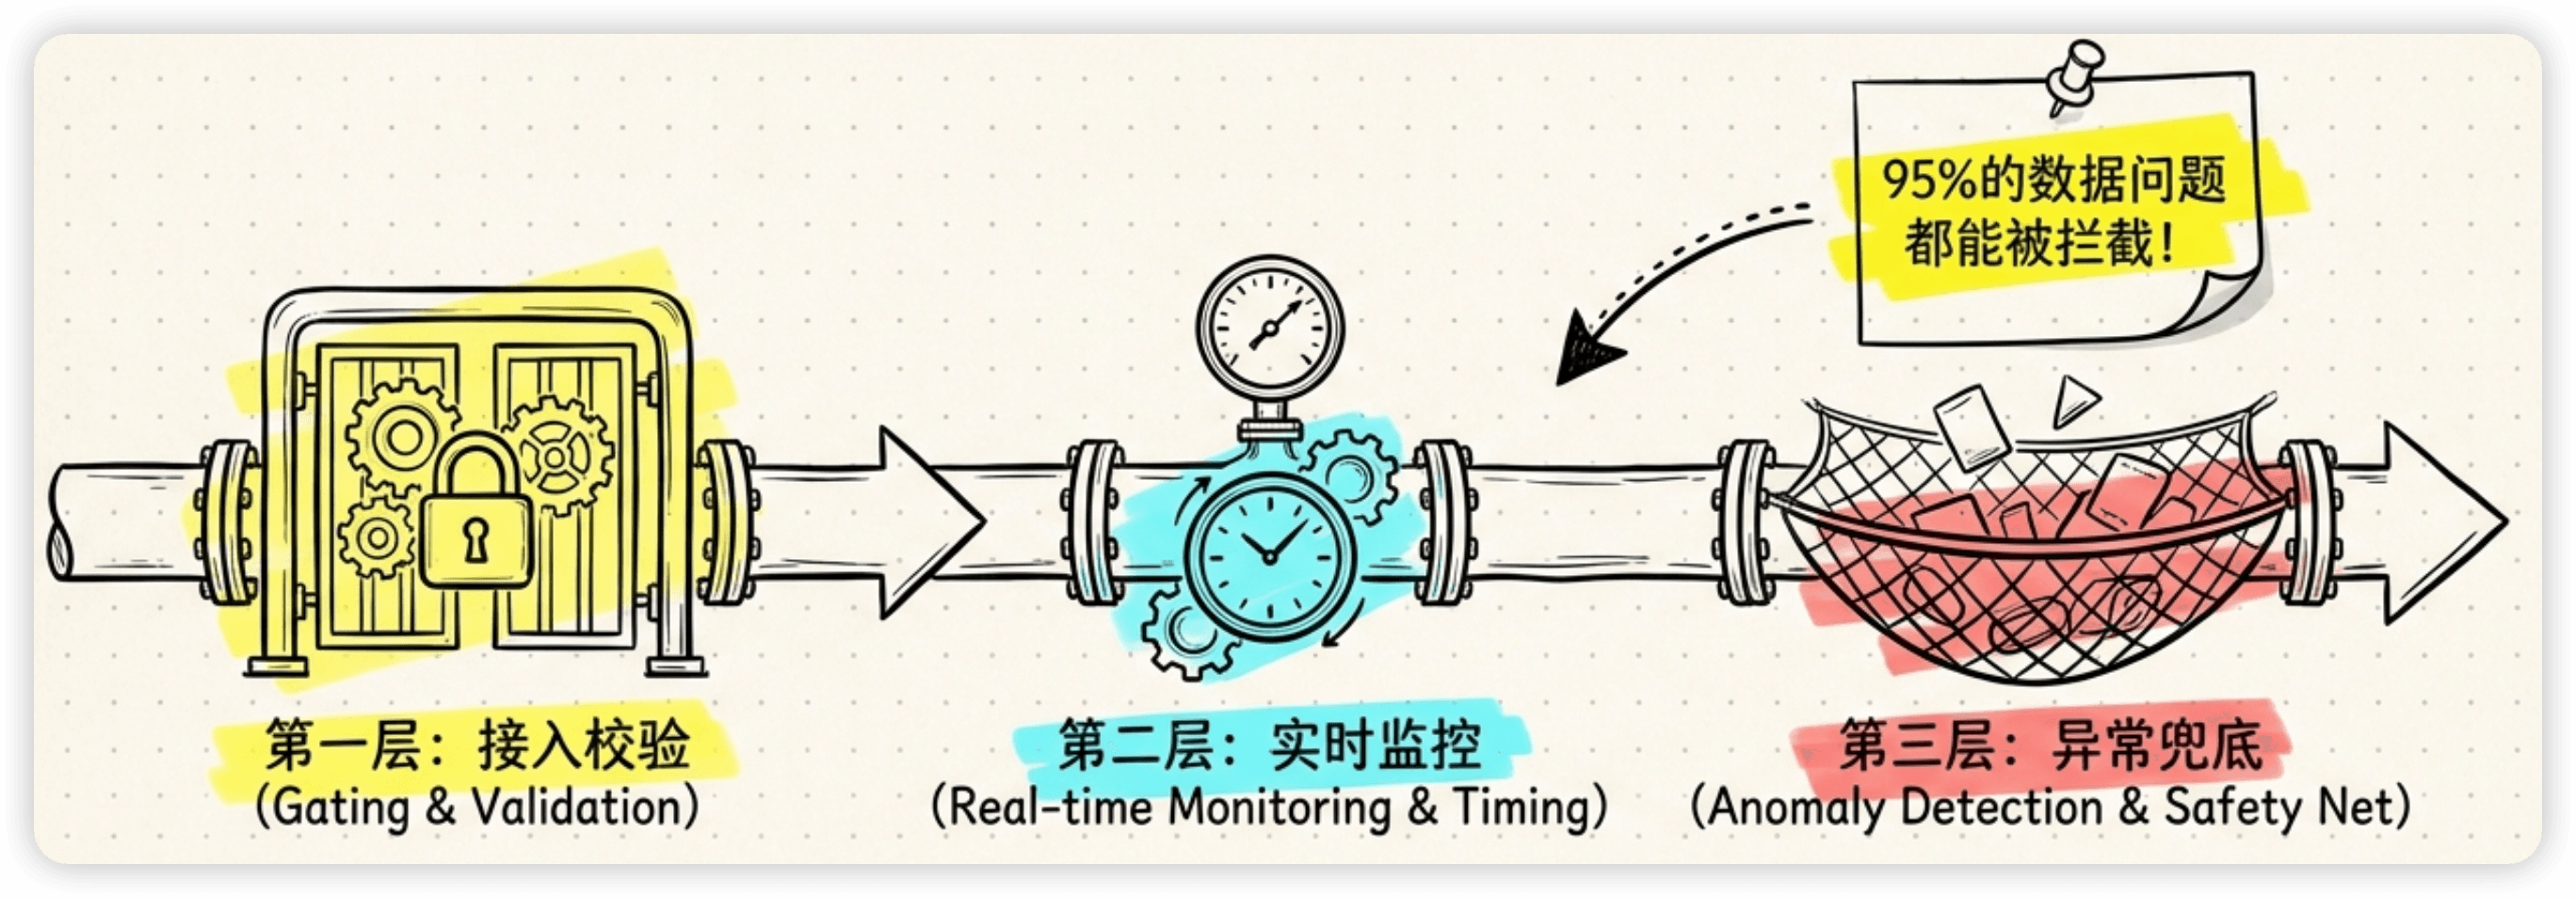
从那次事故之后,我在团队里建了一套三层质量监控体系。这篇文章完整分享出来。
数据质量不是抽象概念,是四个可量化的维度
这四个维度覆盖了95%以上的数据质量问题。每个维度都有具体的、可自动化的检查方法。
我在短剧出海公司遇到的质量问题分布:及时性问题占40%(海外数据源有时差+网络延迟),准确性问题占30%(上游字段变更、ETL逻辑Bug),完整性问题占20%(源系统丢数据、分区漏跑),一致性问题占10%(口径不统一,DAY 6已经讲过治理方案)。

三层监控体系
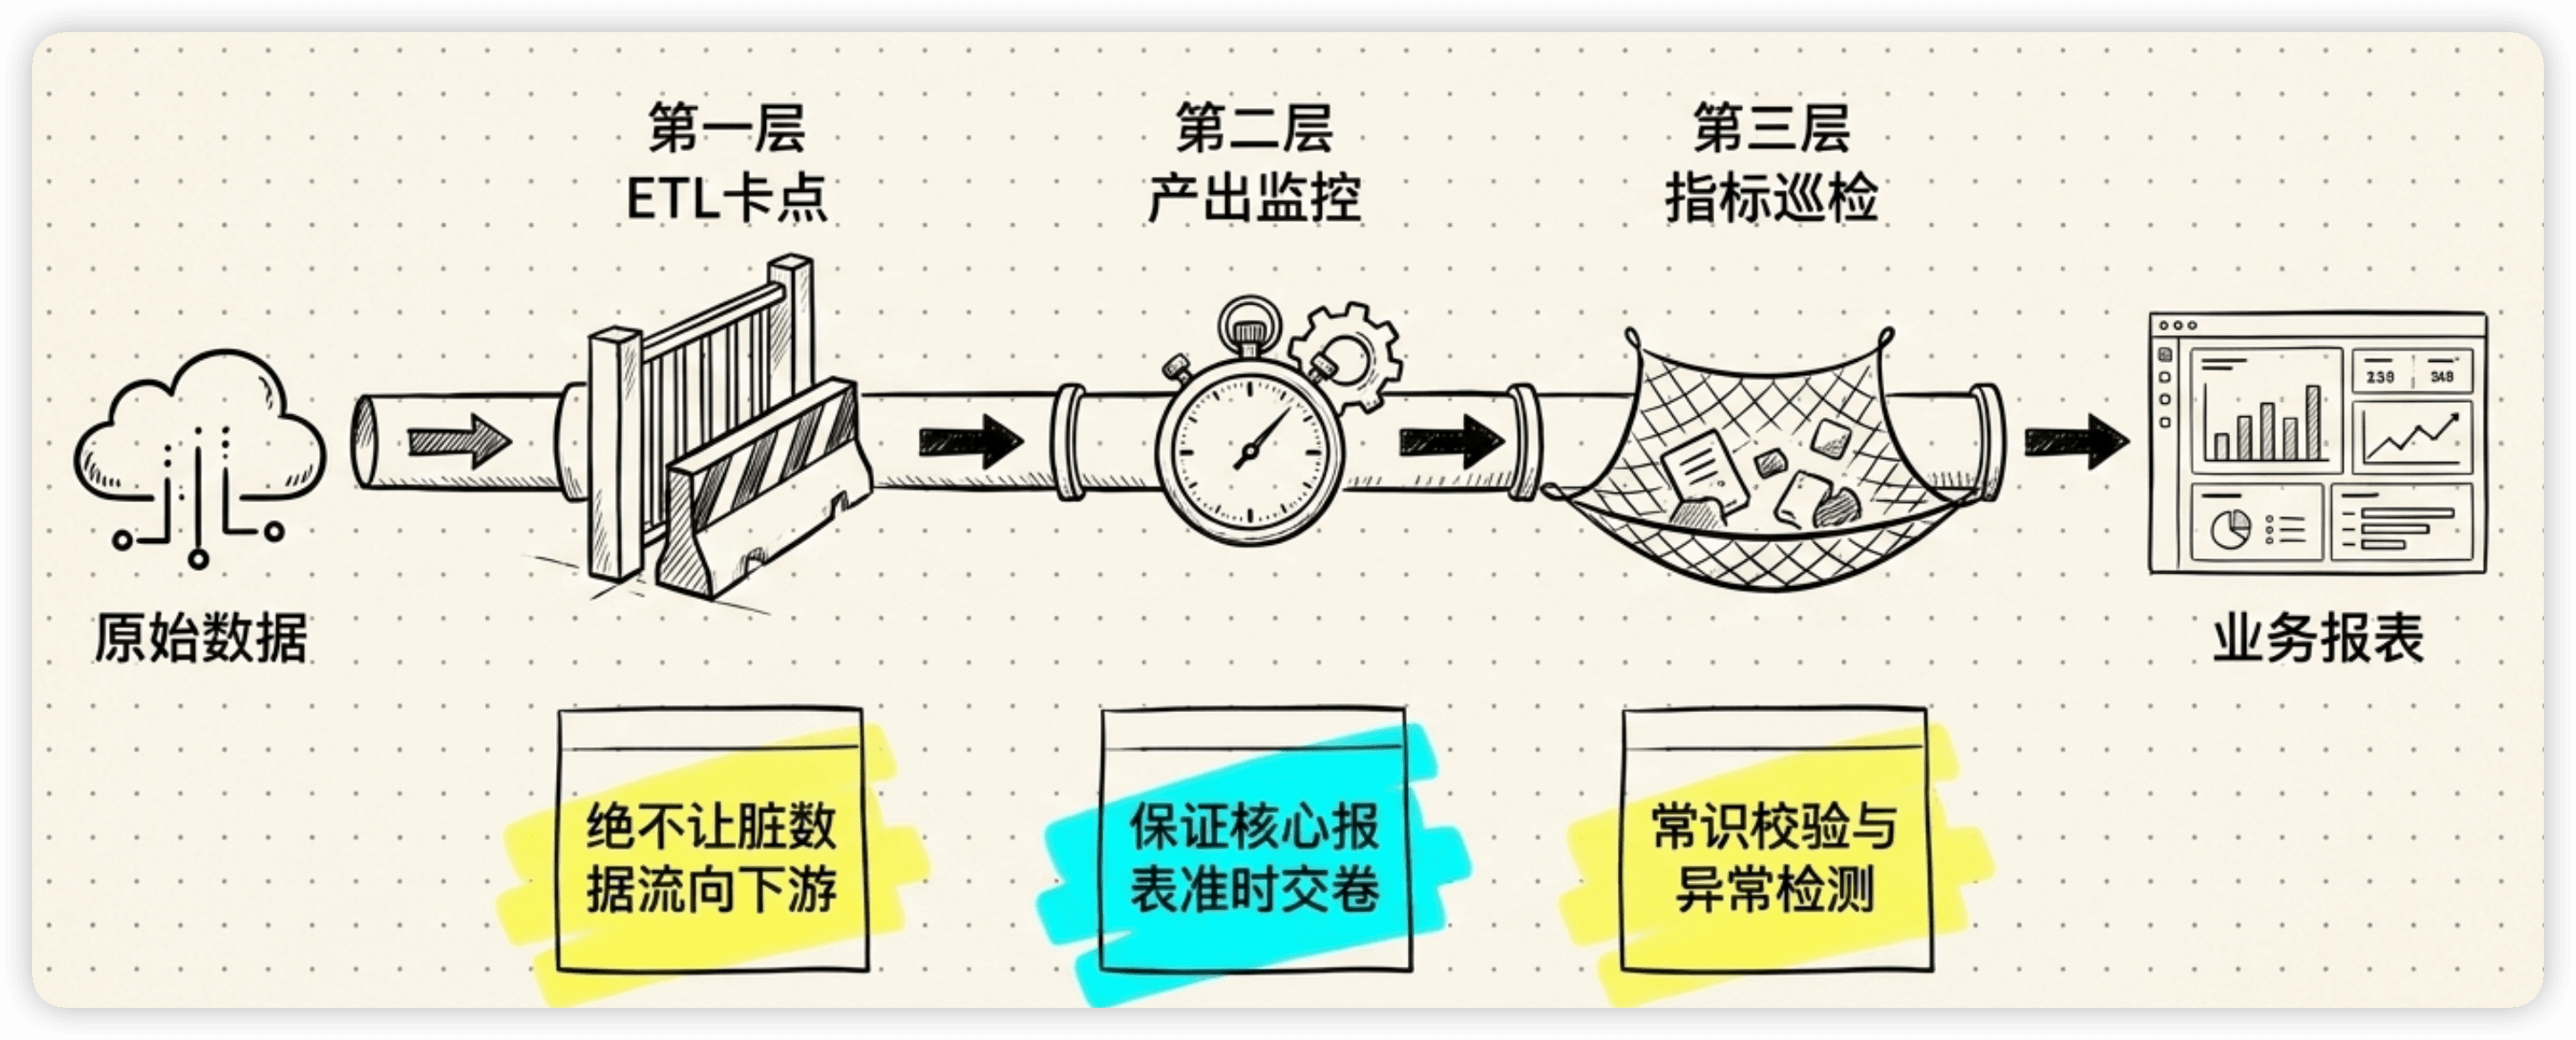
我设计的监控体系分三层,从"写入前拦截"到"产出保障"到"准确性兜底",层层递进:
第一层:ETL卡点(写入前拦截)
在每个ETL任务写入目标表之前,先跑一组校验。不通过就阻断写入,不让脏数据流入下游。
检查1:主键唯一性
-- DWS表的粒度是 user_id × dt
-- 主键不应该有重复
SELECT user_id, dt, COUNT(*) AS cnt
FROM dws_trade_user_pay_1d_staging  -- 先写到staging表
WHERE dt = '${bizdate}'
GROUP BY user_id, dt
HAVING cnt > 1;

-- 如果有结果 → 说明ETL逻辑有问题(大概率是DAY 7的数据膨胀)
-- 阻断写入,发告警通知开发者
检查2:行数波动
-- 对比今天和昨天的行数
WITH today AS (
    SELECT COUNT(*) AS cnt FROM dws_xxx_staging WHERE dt = '${bizdate}'
),
yesterday AS (
    SELECT COUNT(*) AS cnt FROM dws_xxx WHERE dt = DATE_SUB('${bizdate}', 1)
)
SELECT
    today.cnt AS today_cnt,
    yesterday.cnt AS yesterday_cnt,
    ROUND(ABS(today.cnt - yesterday.cnt) * 100.0 / NULLIF(yesterday.cnt, 0), 2) AS change_rate
FROM today, yesterday;

-- change_rate > 20% → 告警(行数波动超过20%不正常)
-- change_rate > 50% → 阻断(大概率有严重问题)
检查3:关键字段NULL率
-- 核心指标字段不应该有大面积NULL
SELECT
    COUNT(*) AS total,
    SUM(CASE WHEN pay_amount IS NULL THEN 1 ELSE 0 END) AS pay_null_cnt,
    SUM(CASE WHEN user_id IS NULL THEN 1 ELSE 0 END) AS uid_null_cnt,
    ROUND(SUM(CASE WHEN pay_amount IS NULL THEN 1 ELSE 0 END) * 100.0 / COUNT(*), 2) AS pay_null_rate
FROM dws_xxx_staging WHERE dt = '${bizdate}';

-- pay_null_rate > 5% → 告警
-- user_id NULL率 > 0% (主键不应该为NULL) → 阻断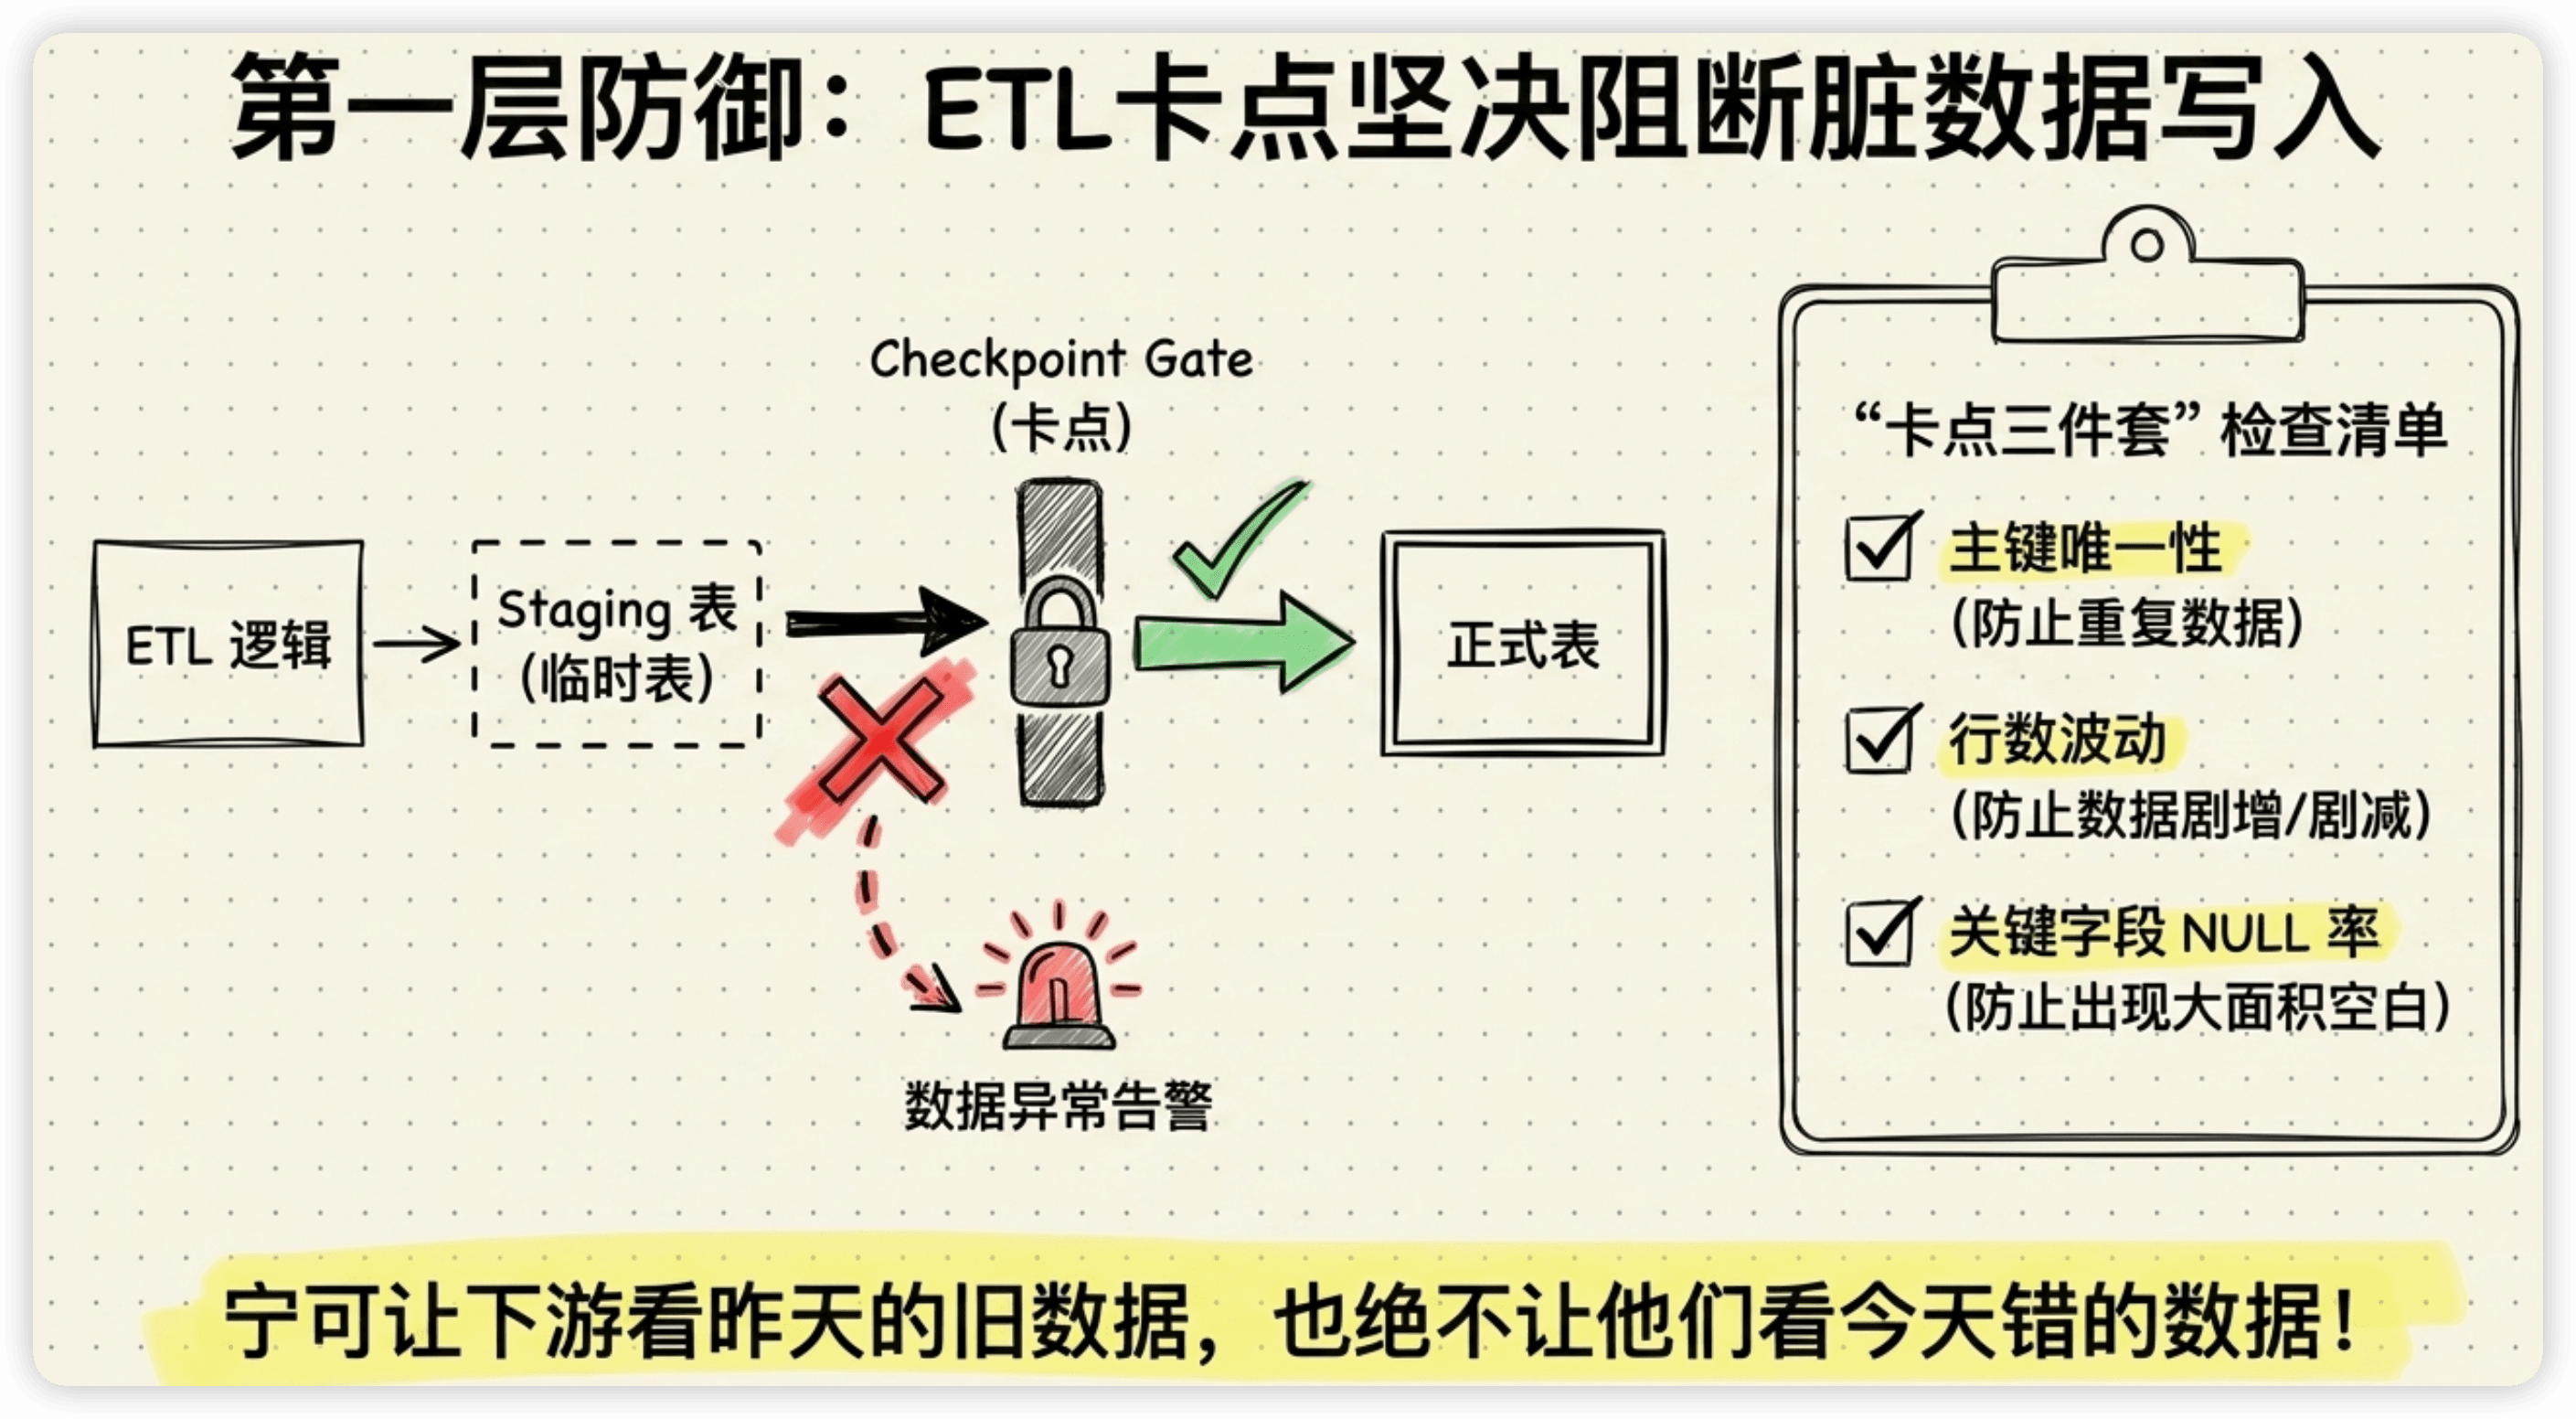
实现方式: 在调度任务中,ETL逻辑先写入staging表,跑完校验后再INSERT OVERWRITE到正式表。如果校验不通过,staging数据不会写入正式表,下游任务看到的还是昨天的数据(虽然不是最新的,但至少不是错的)。
ETL流程:
源表 → SQL加工 → staging表 → 质量校验 → 通过?
                                         ├── 是 → INSERT OVERWRITE到正式表
                                         └── 否 → 阻断 + 告警 + 保留staging供排查
第二层:产出监控(SLA保障)
核心报表必须在约定时间前产出,否则业务方早上看到空白报表会很抓狂。
SLA设计原则:
业务方要求:8:00 AM 看到报表
你的SLA:7:30 AM 前数据必须就绪(留30分钟buffer处理突发)

告警分级:
  7:30 AM 未完成 → 黄色预警(通知数据开发,开始排查)
  8:00 AM 未完成 → 红色告警(通知数据开发 + 业务方数据组)
  8:30 AM 未完成 → 升级告警(通知Leader / On-call负责人)
实现方式:
在调度平台里配置任务的预期完成时间。DataWorks有内置的基线监控功能,Airflow可以用SLA参数或自定义Sensor实现:
# Airflow SLA配置
with DAG('dws_daily_pipeline', sla_miss_callback=alert_on_sla_miss) as dag:
    dws_task = SparkSubmitOperator(
        task_id='dws_trade_summary',
        sla=timedelta(hours=7, minutes=30),  # 7:30 AM前完成
    )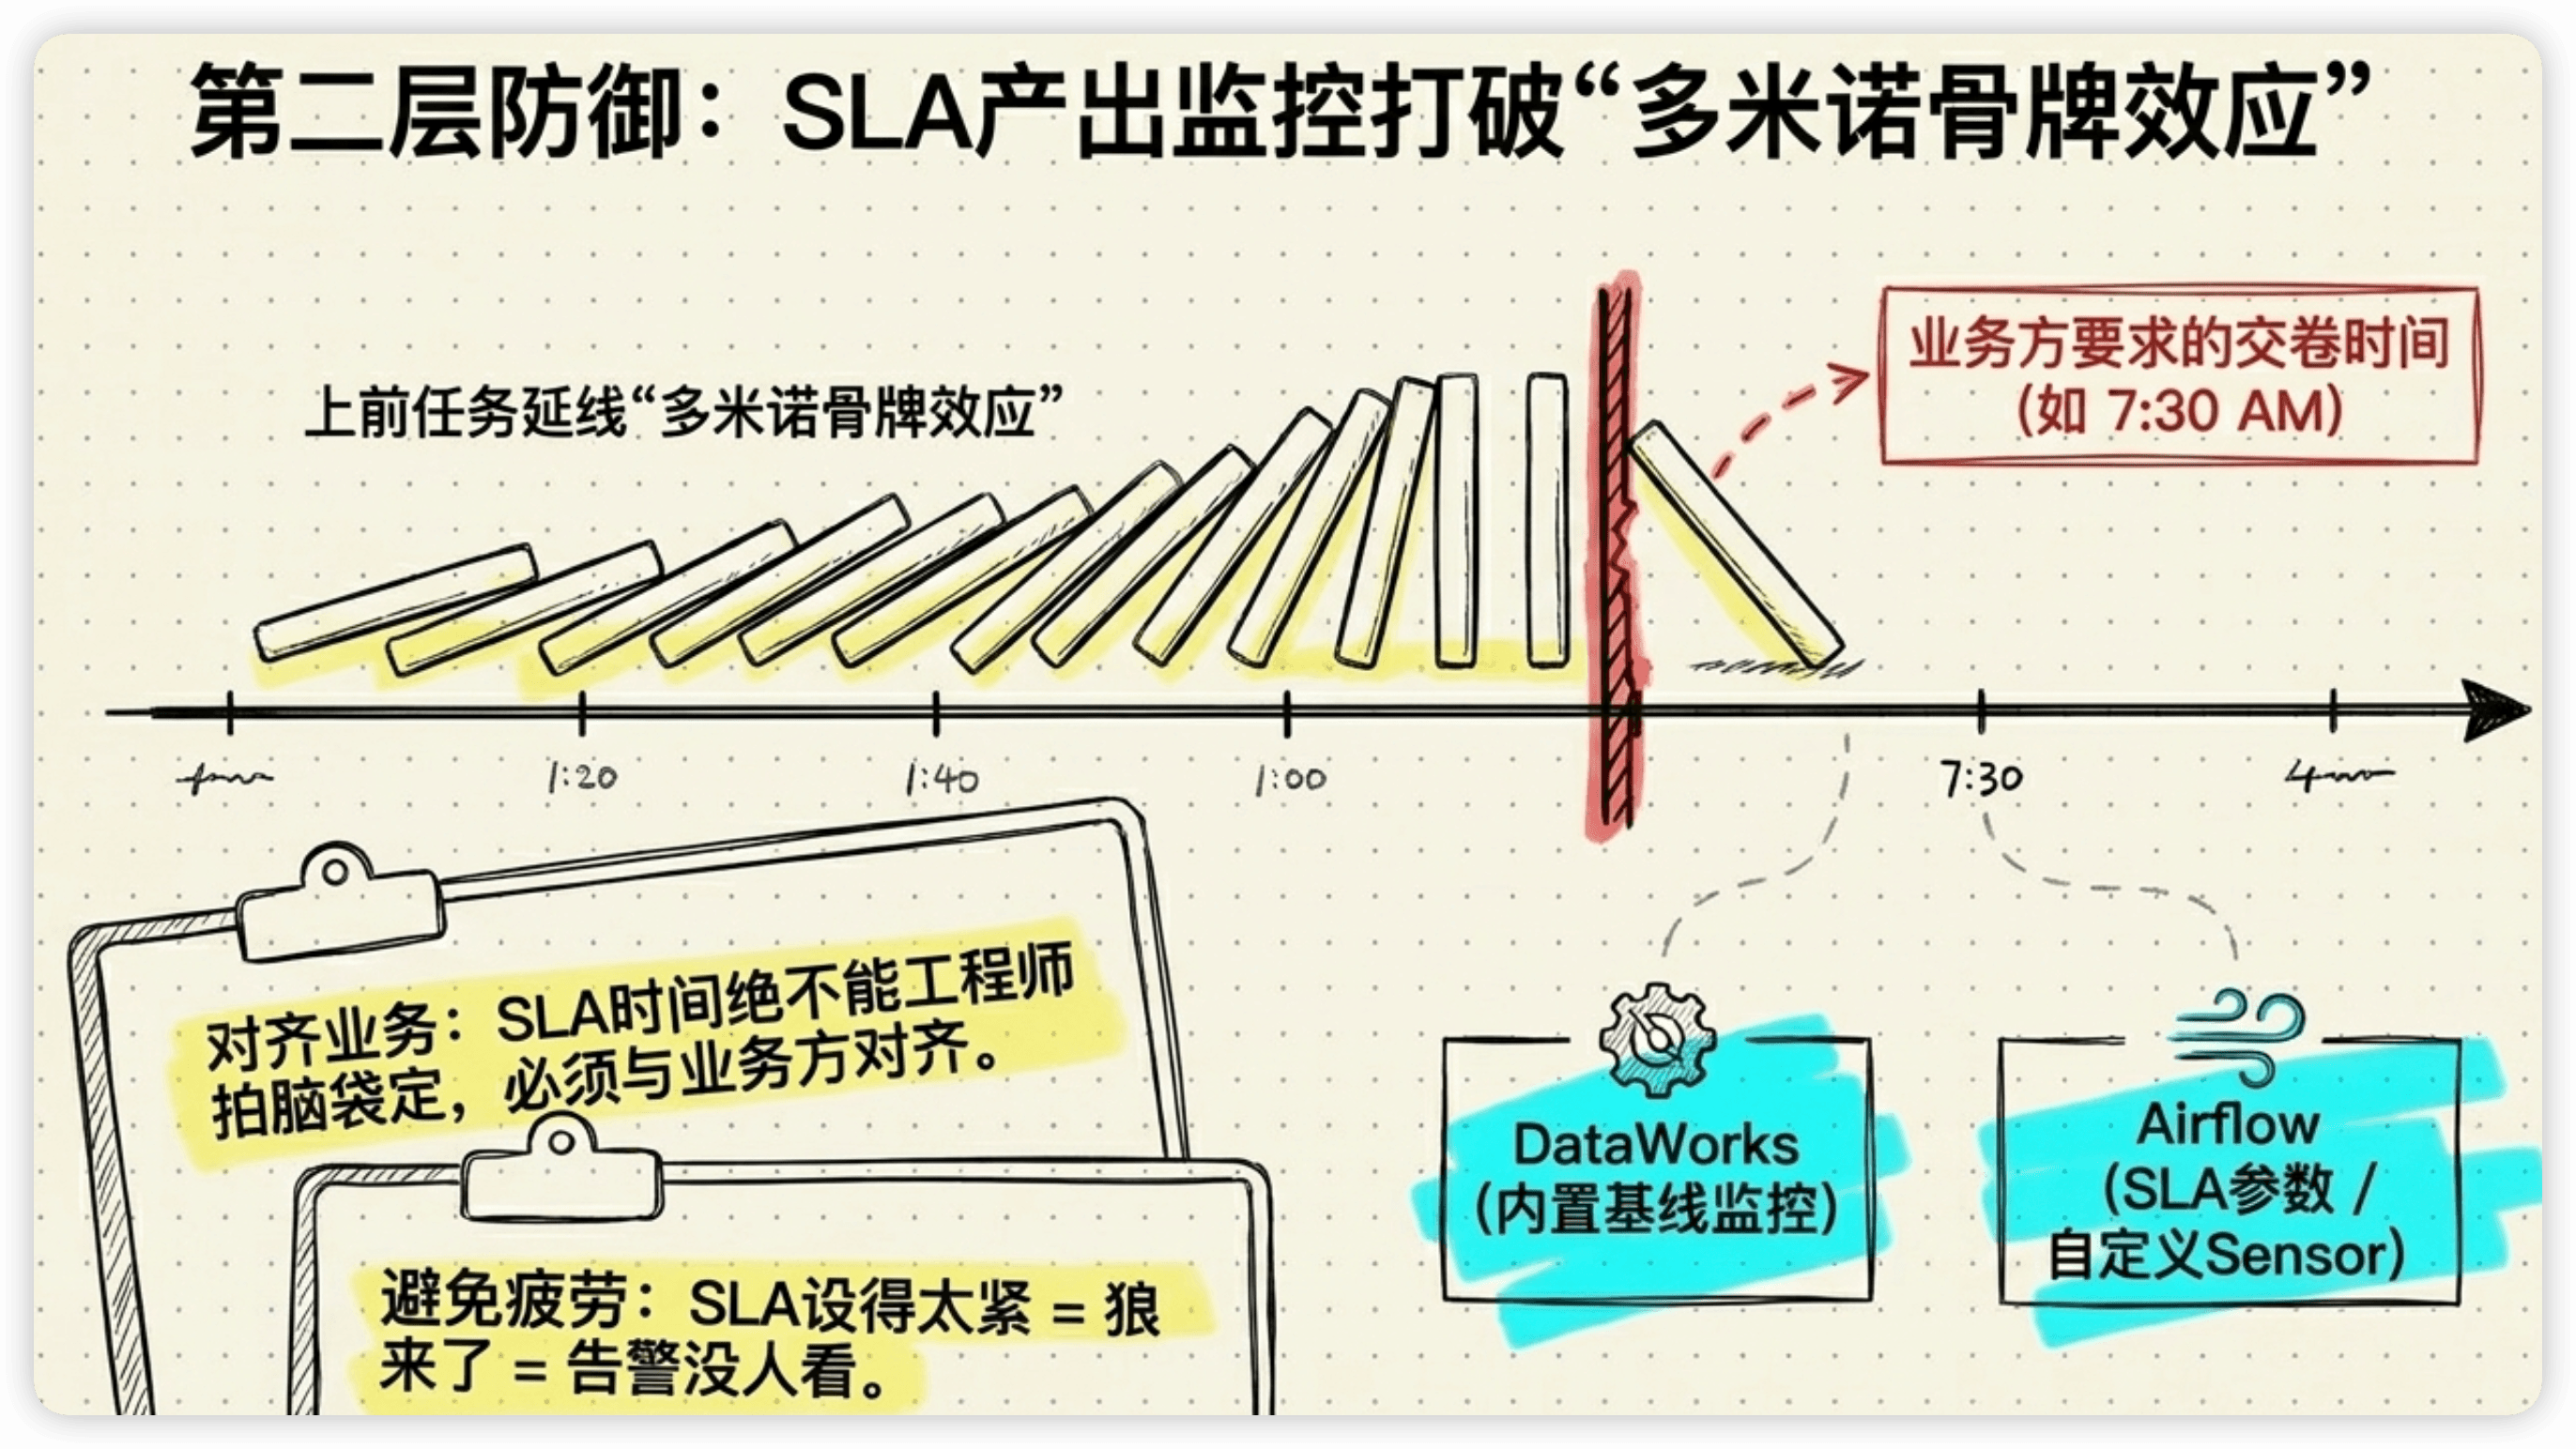
经验:SLA时间一定要和业务方对齐,不能自己拍脑袋定。我见过有人把SLA设得太紧(6:00 AM),结果上游数据延迟一点就天天告警,告警疲劳之后大家都不看了——更危险。合理的SLA是"大部分时间能达成,偶尔达不成时真的需要处理"。
第三层:指标巡检(准确性兜底)
前两层保证了"数据有、数据准时",但不保证"数据对"。第三层就是对核心指标做合理性校验——不需要知道准确值是多少,只需要知道"不可能是这个值"。
-- 每天自动跑一遍核心指标的合理性检查
INSERT INTO data_quality_log
SELECT
    '${bizdate}' AS check_date,
    CASE
        WHEN dau < 0 THEN 'FAIL: DAU为负数'
        WHEN dau > dau_yesterday * 5 THEN 'FAIL: DAU暴增5倍以上'
        WHEN gmv < 0 THEN 'FAIL: GMV为负数'
        WHEN gmv > gmv_yesterday * 10 THEN 'FAIL: GMV暴增10倍'
        WHEN pay_rate > 1 THEN 'FAIL: 支付率超过100%'
        WHEN pay_rate < 0 THEN 'FAIL: 支付率为负数'
        WHEN arpu > 10000 THEN 'FAIL: ARPU超过1万(不合理)'
        ELSE 'PASS'
    END AS check_result,
    dau, gmv, pay_rate, arpu
FROM ads_daily_summary
WHERE dt = '${bizdate}';

-- 任何一项FAIL → 告警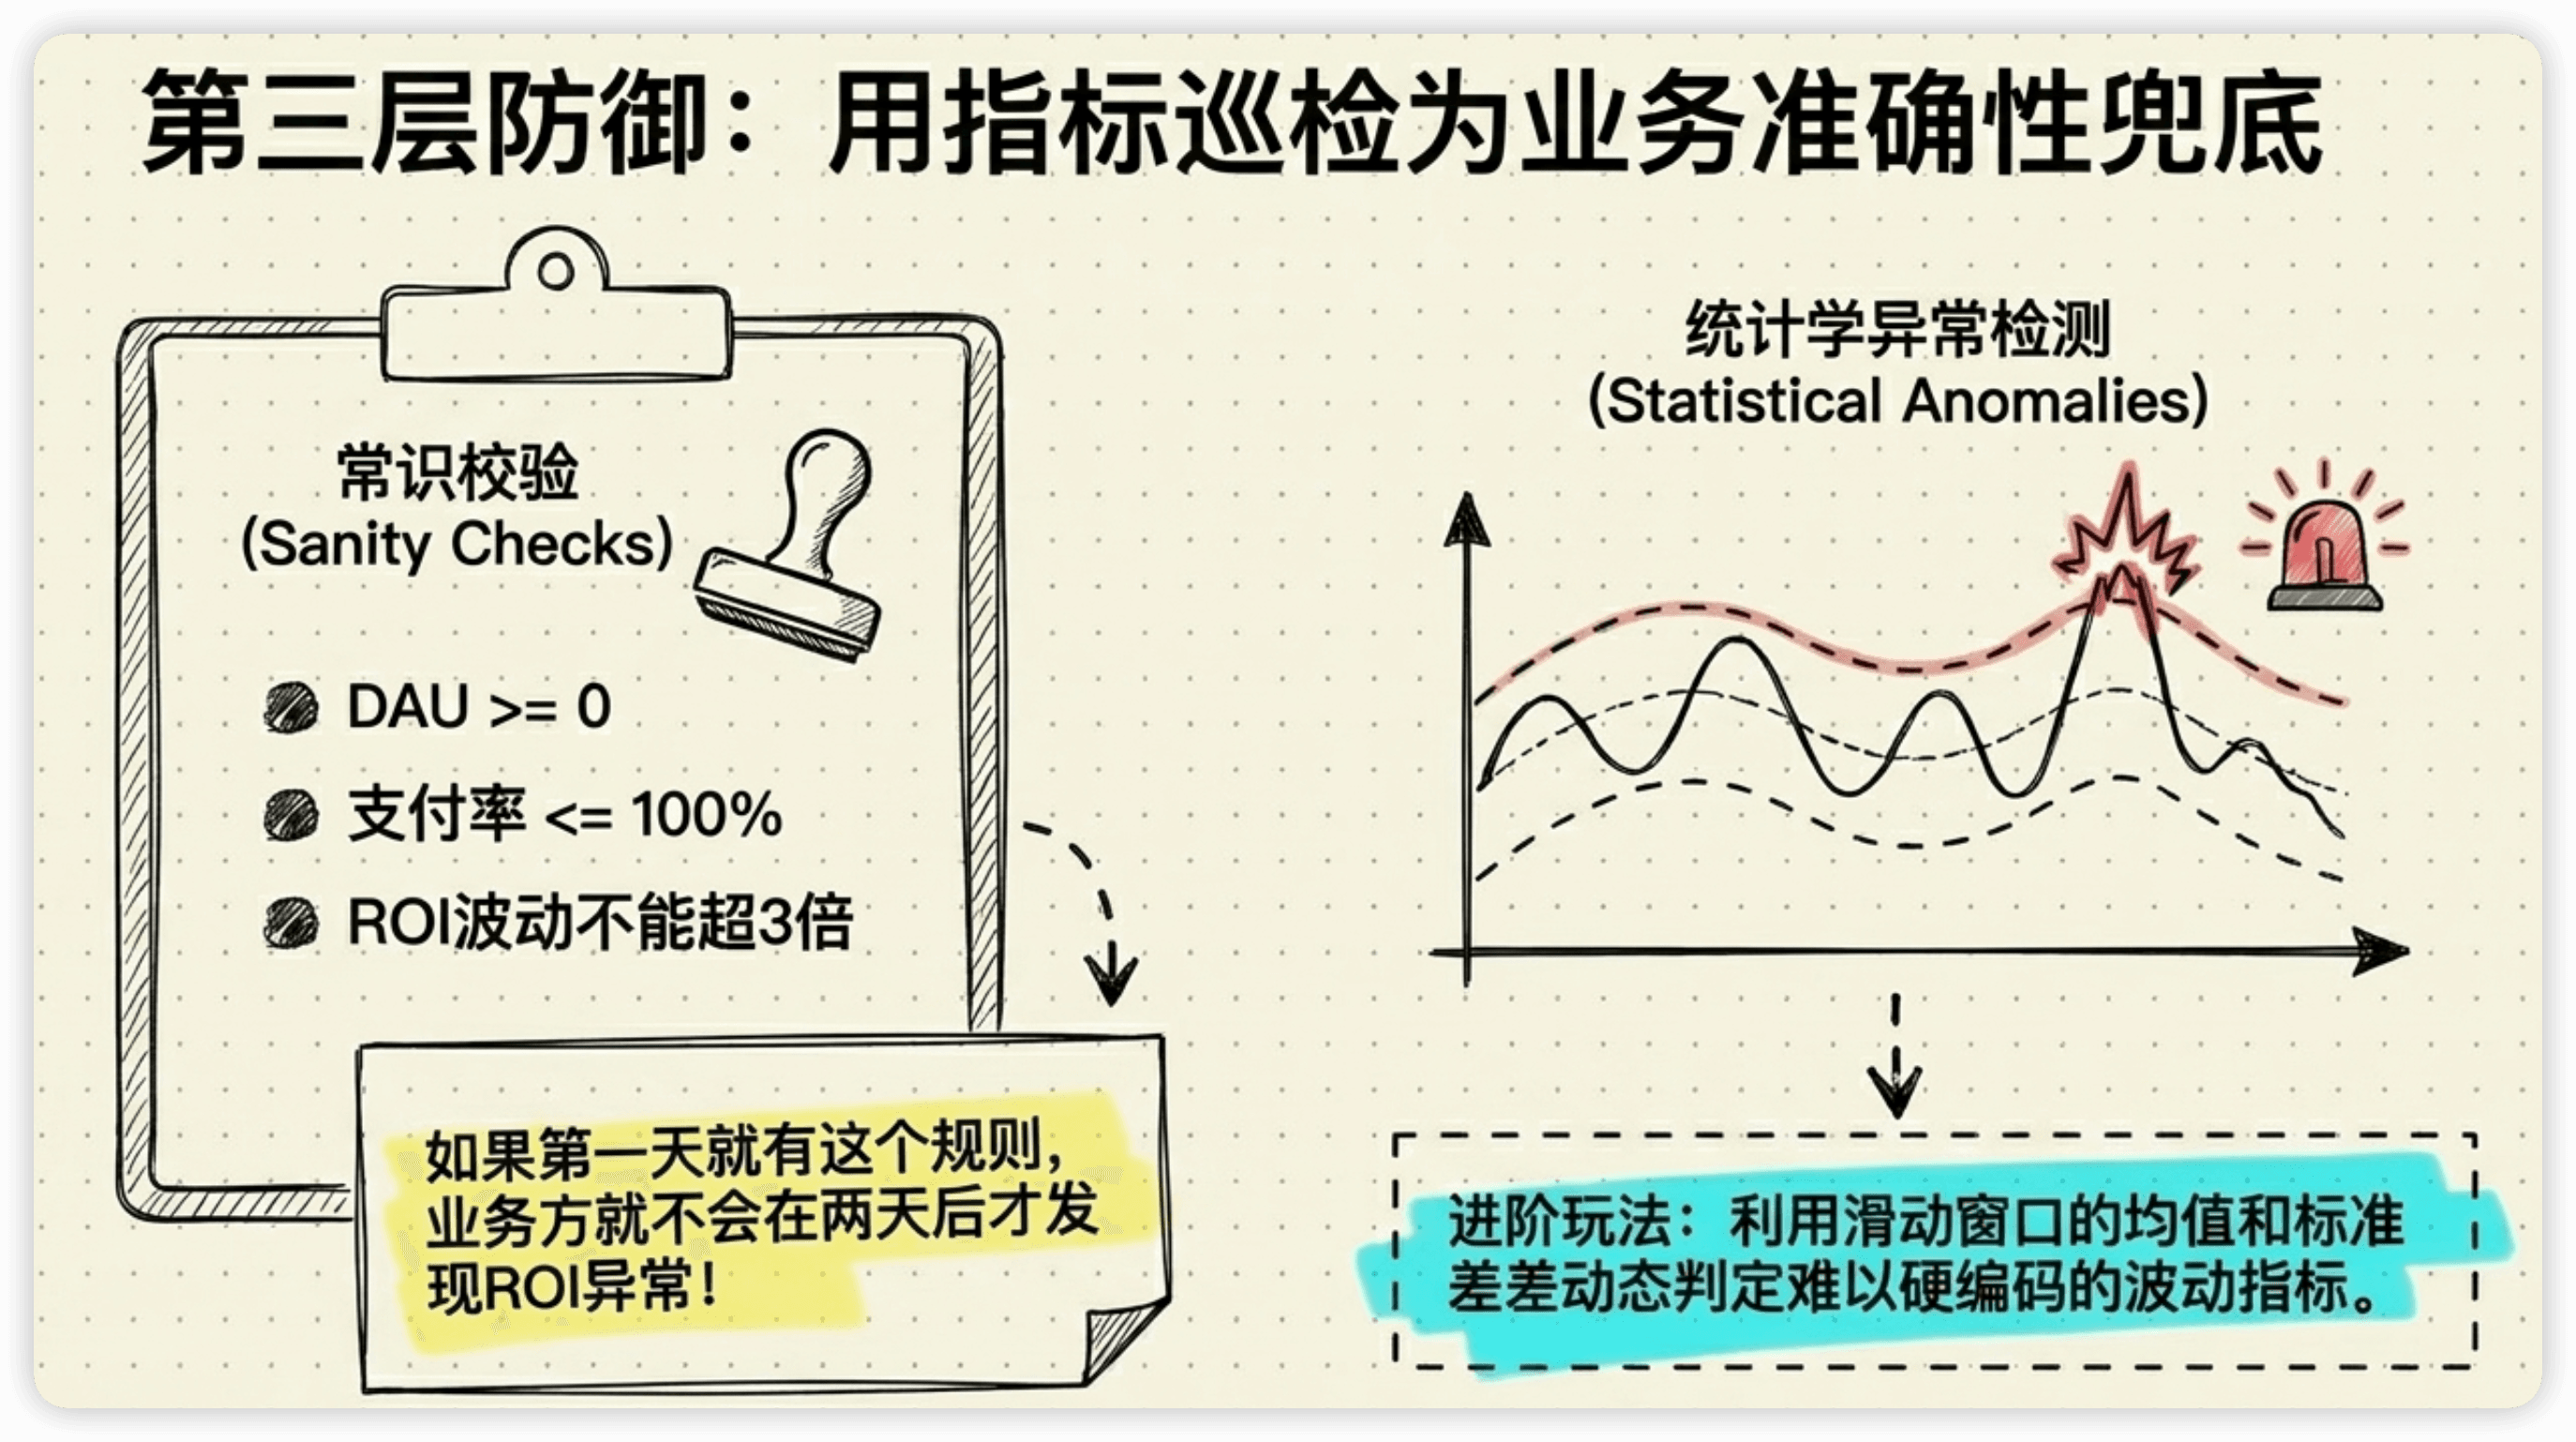
这些规则看起来很简单("DAU不能为负"),但正是这类"显而易见"的错误最容易在生产中发生——而且往往是上游某个环节出了问题后"级联传递"下来的。
我那次ROI翻3倍的事故,如果当时有一条规则"ROI不可能一天翻3倍",第一天就能发现,而不是两天后业务方来问才知道。
高级玩法:统计学异常检测
对于波动范围不好硬编码的指标(比如DAU正常波动就比较大),可以用滑动窗口的均值和标准差来动态判定:
-- 动态阈值:超过近30天均值±3倍标准差就告警
WITH stats AS (
    SELECT
        AVG(dau) AS avg_dau,
        STDDEV(dau) AS std_dau
    FROM ads_daily_summary
    WHERE dt BETWEEN DATE_SUB('${bizdate}', 30) AND DATE_SUB('${bizdate}', 1)
)
SELECT
    CASE
        WHEN t.dau > s.avg_dau + 3 * s.std_dau THEN 'WARN: DAU异常偏高'
        WHEN t.dau < s.avg_dau - 3 * s.std_dau THEN 'WARN: DAU异常偏低'
        ELSE 'PASS'
    END AS check_result
FROM ads_daily_summary t, stats s
WHERE t.dt = '${bizdate}';
问题出了怎么快速定位?四步溯源法
告警响了,怎么快速找到根因?
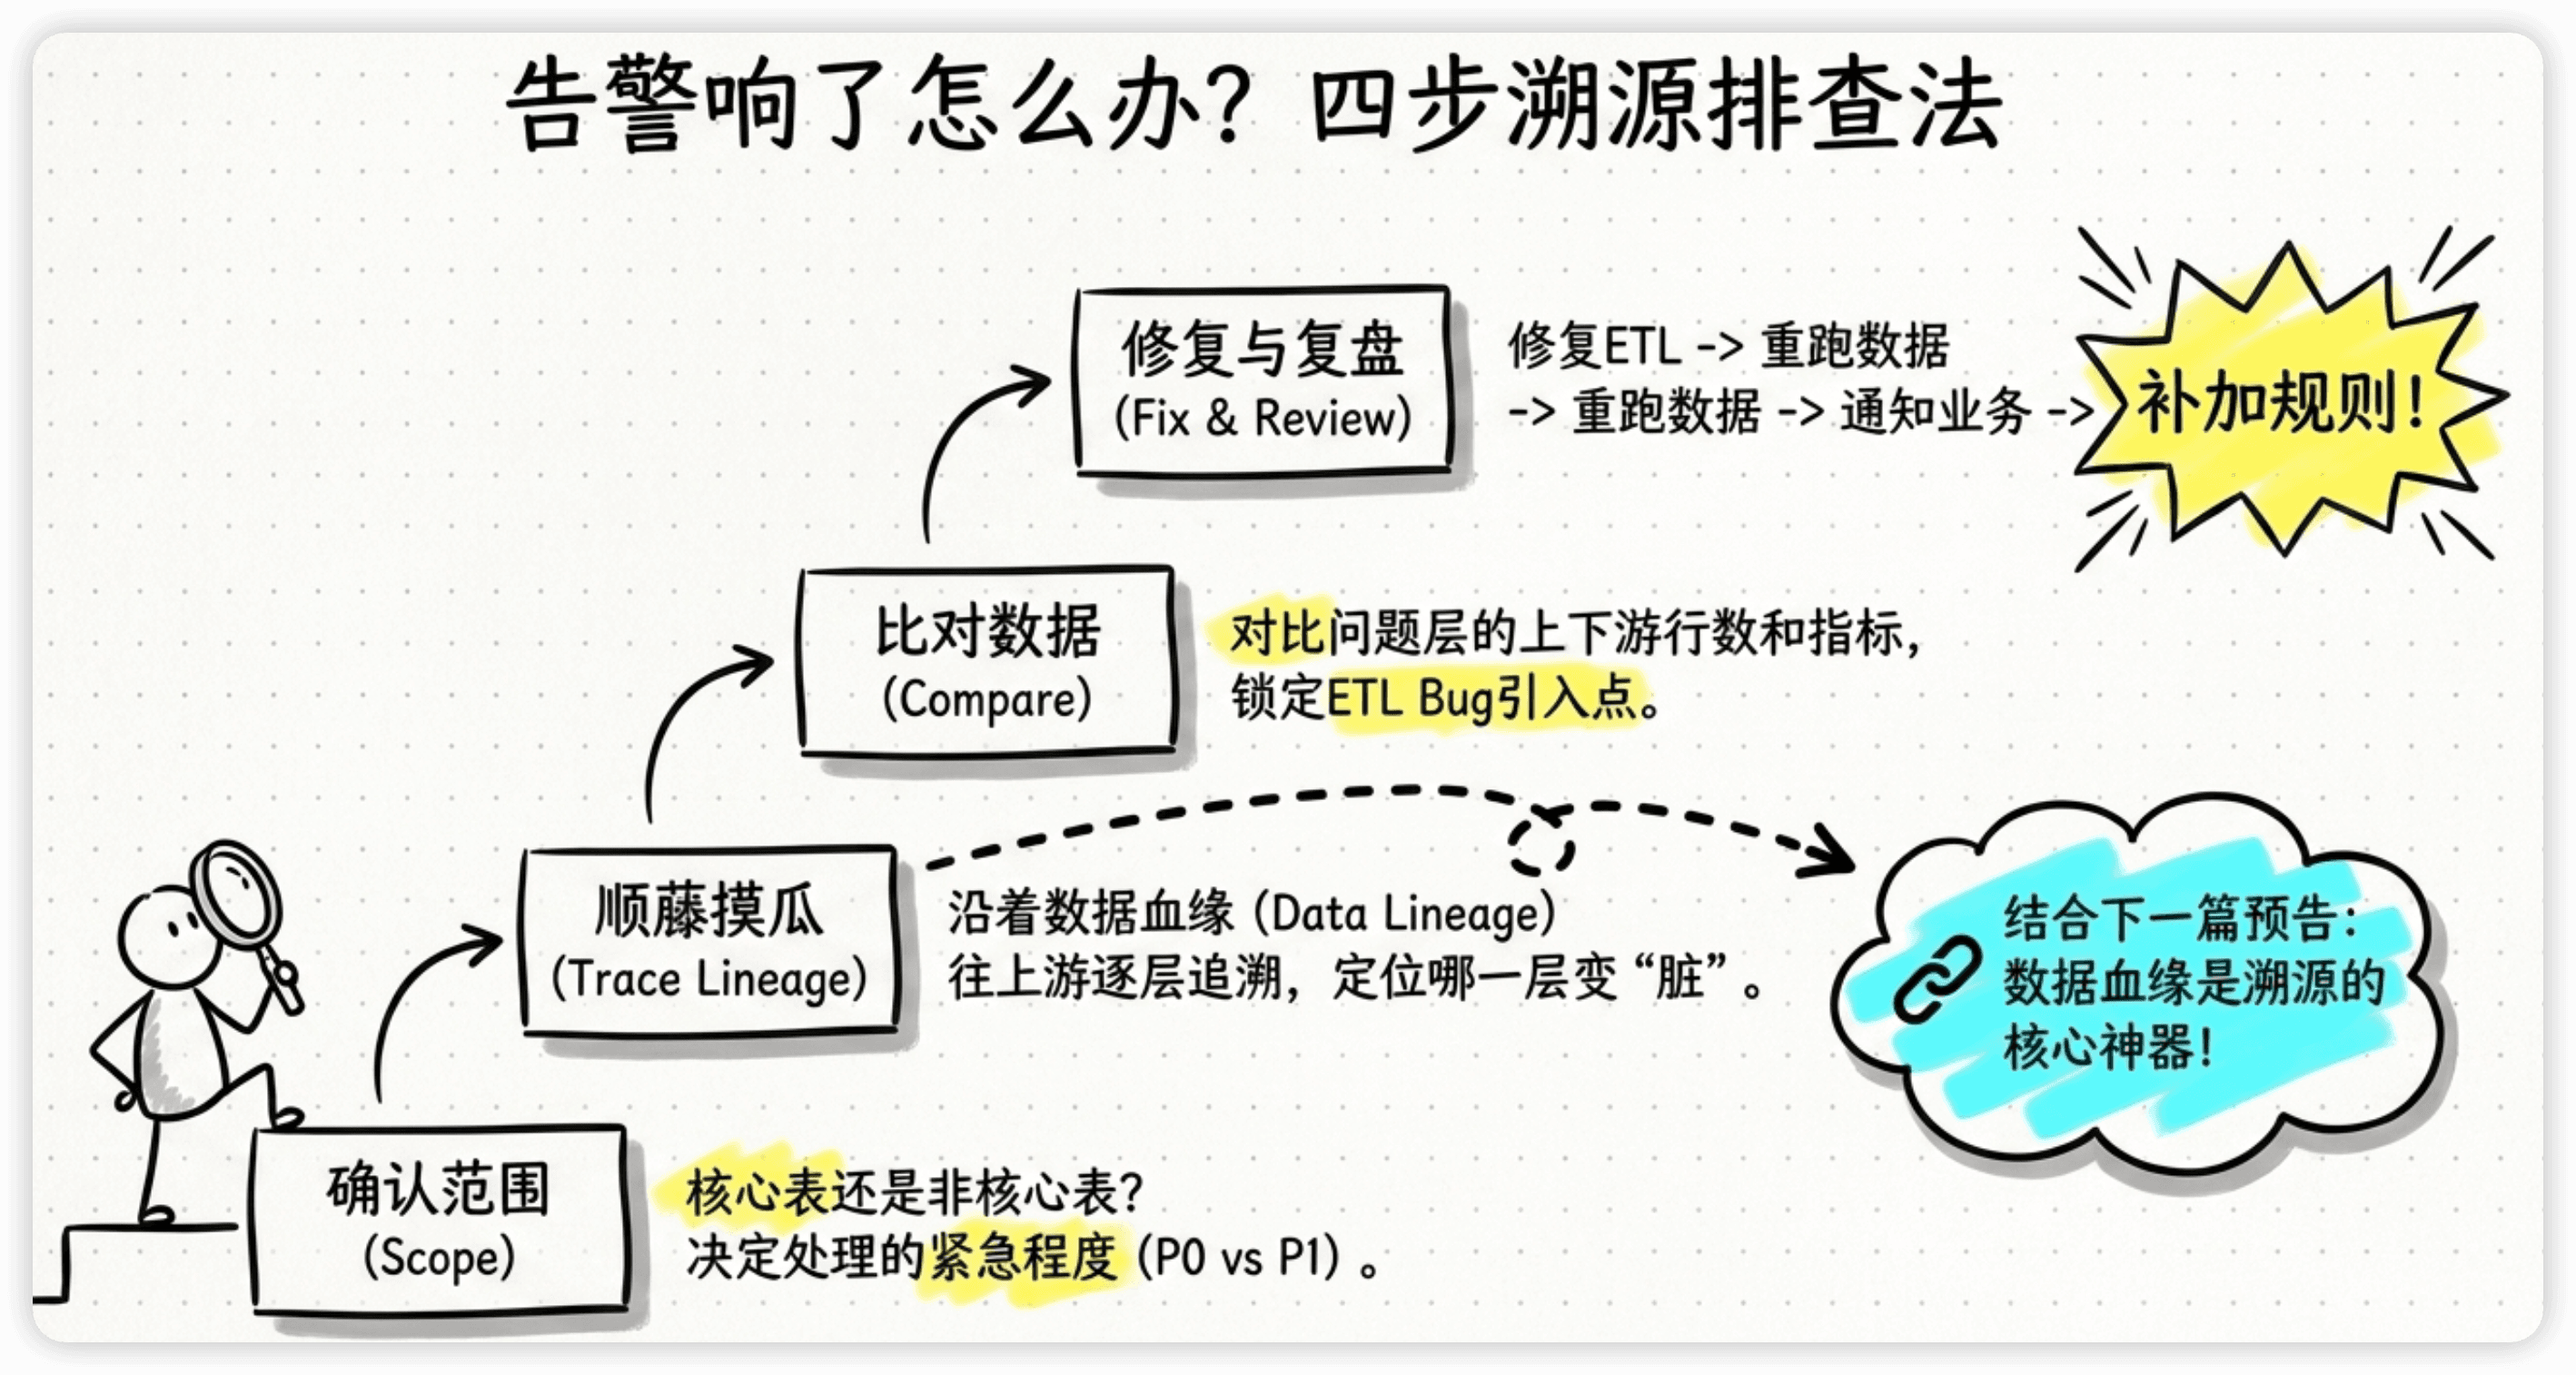
第一步:确认影响范围。 哪些表/报表受影响?是核心报表还是非核心?这决定了你的紧急程度。
第二步:沿血缘往上追。 从告警的表开始,沿着DAY 19的数据血缘一层一层往上游查。哪层的数据是对的,哪层开始不对。
ads_daily_report   ← 数据异常 ❌
dws_trade_summary  ← 数据异常 ❌
dwd_order_detail   ← 行数翻倍 ❌ ← 问题在这里!
ods_order          ← 正常 ✅
找到第一个出问题的层,基本就定位到根因了。
第三步:比对上下游数据。 对问题层的上游和下游做行数和关键指标对比,确认问题是在当前层的ETL逻辑中引入的。
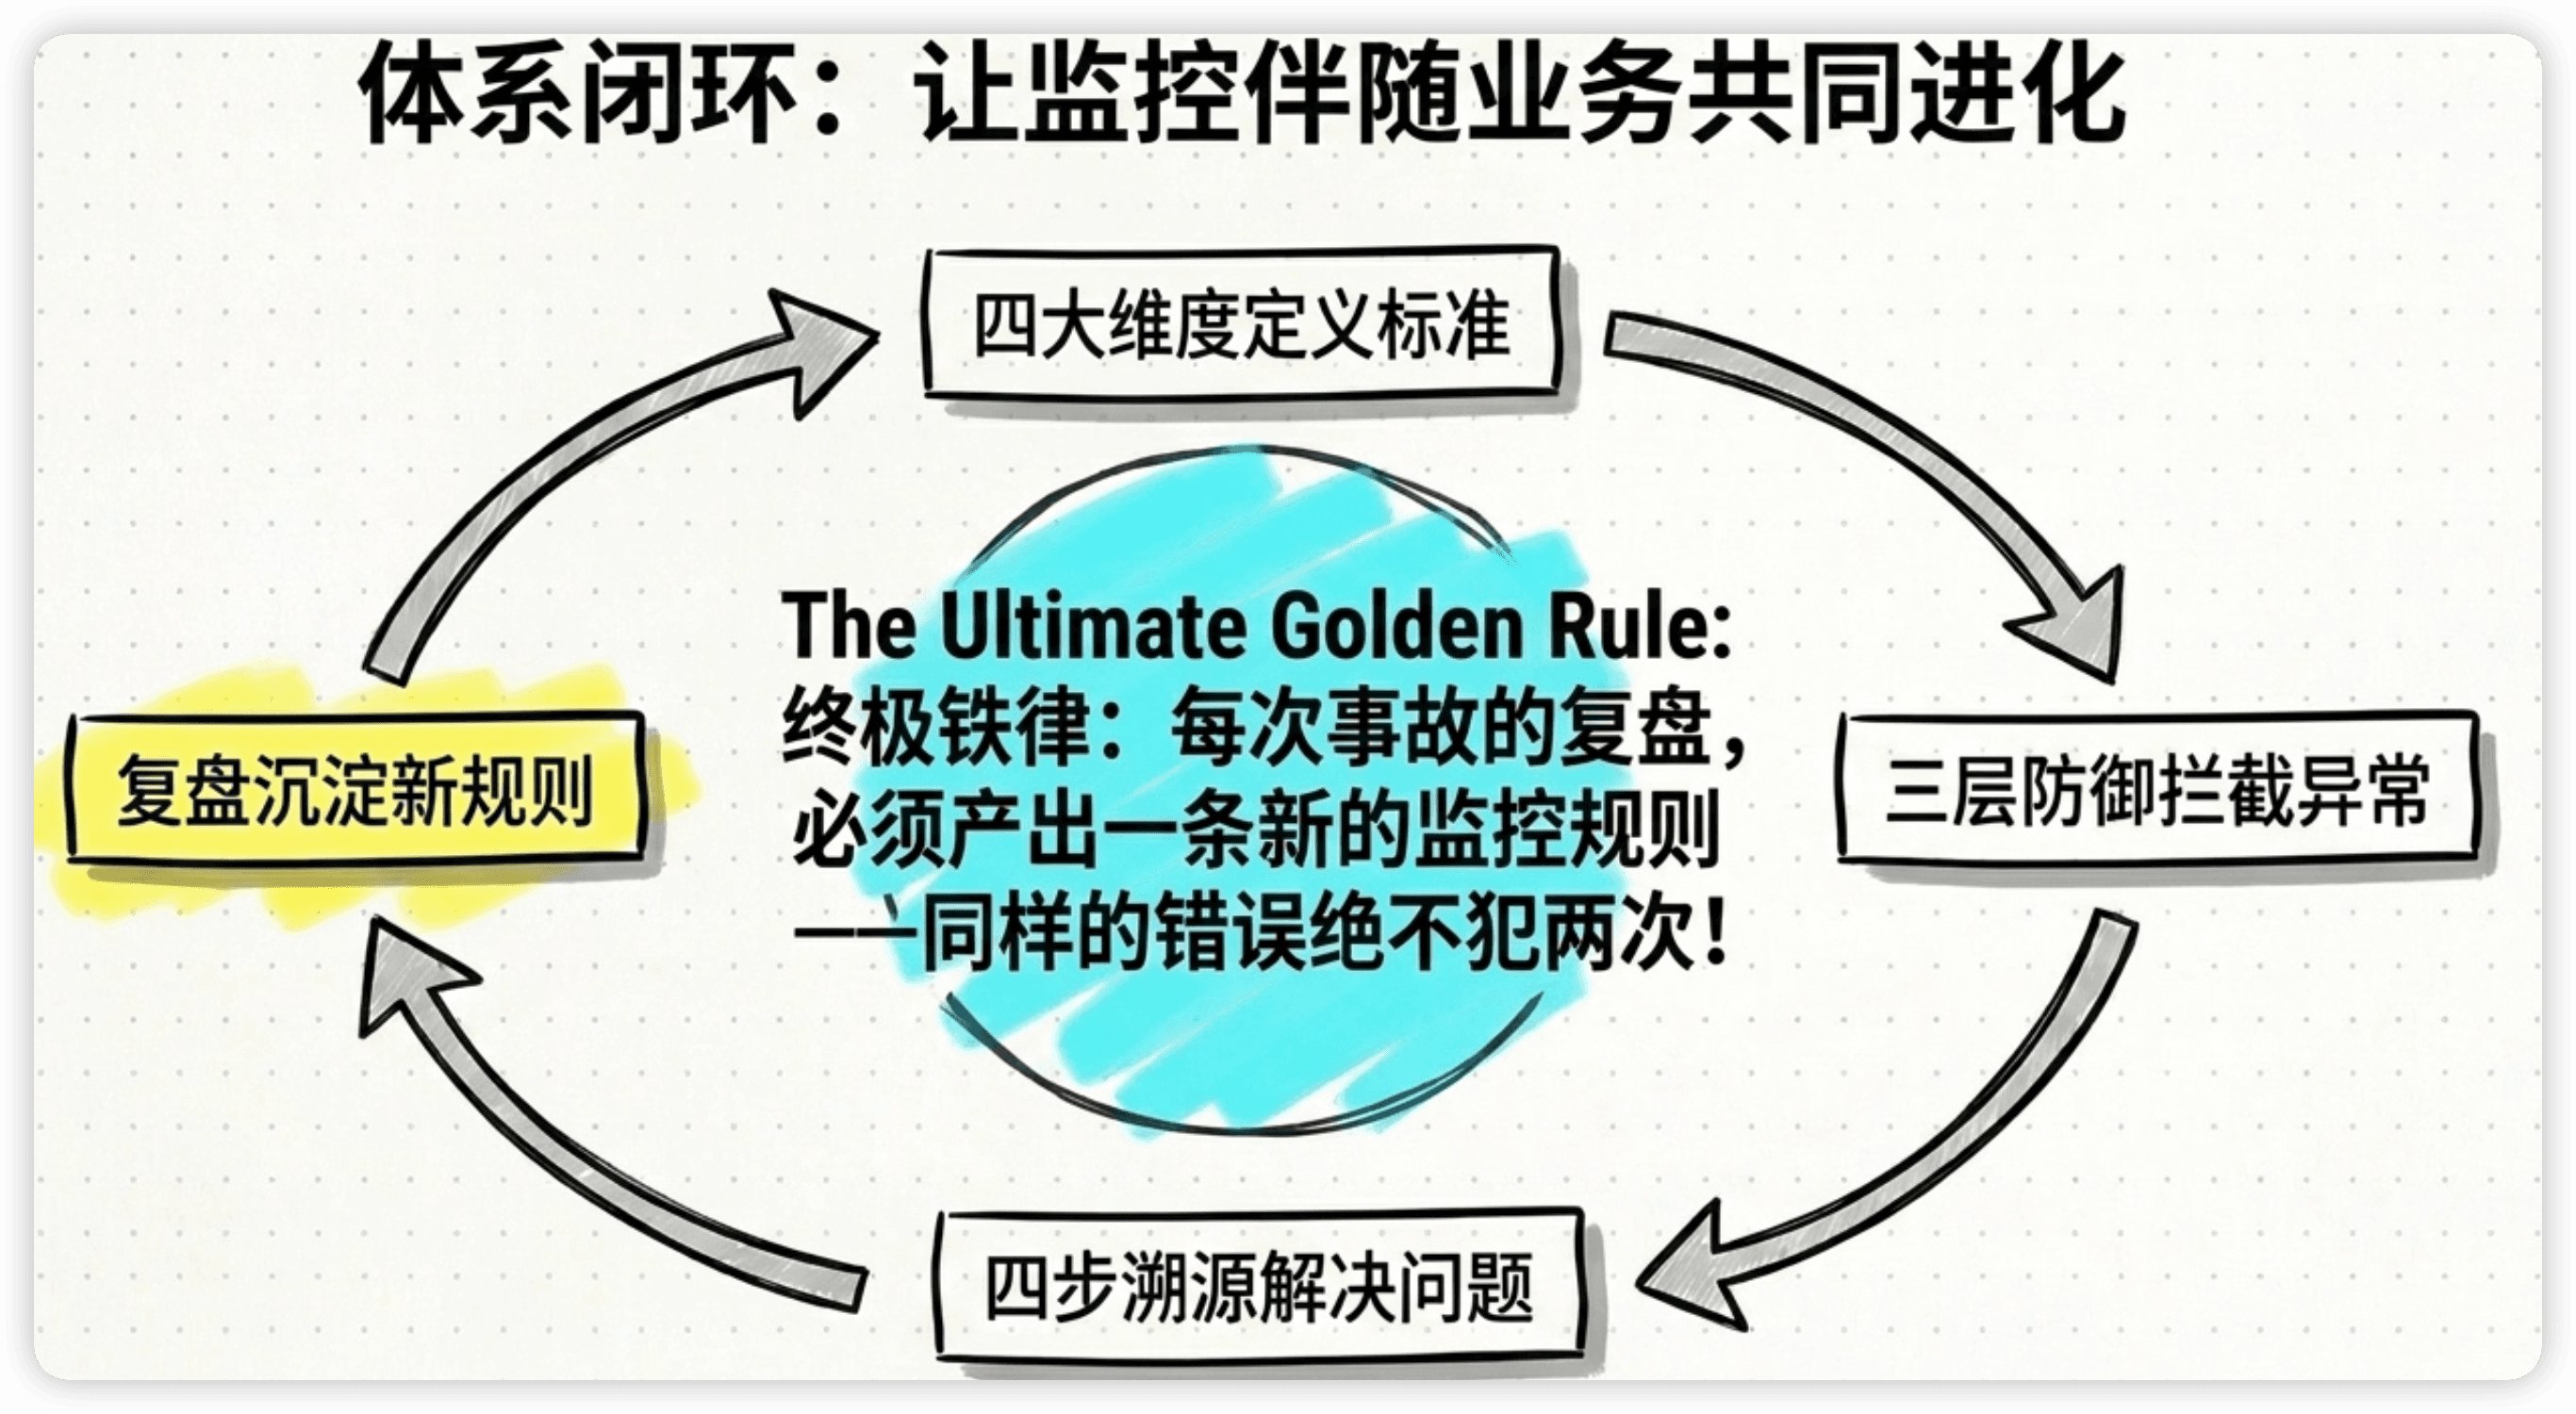
第四步:修复 + 复盘。 修复ETL逻辑 → 重跑受影响的数据 → 通知业务方数据已修正 → 写复盘文档 → 补上缺失的监控规则(确保同样的问题不会再次漏过去)。
我那次ROI事故的复盘行动:在ODS层加了字段Schema校验——每次API返回的数据先验证字段名和数据类型是否符合预期,不符合就阻断并告警。从那以后再没出过类似问题。
面试怎么答?
高分回答
「我们建了三层数据质量监控体系。第一层是ETL卡点——每个任务写入前校验主键唯一性、行数波动和NULL率,不通过不写入下游,从源头拦截脏数据。第二层是SLA监控——核心报表必须在7:30前产出,逐级告警机制保障及时性。第三层是指标巡检——每天自动校验核心指标的合理性,比如DAU不能为负、GMV不能一天翻10倍、支付率不能超过100%。」
「我之前经历过一次事故:广告平台API改了字段名,ROI翻了3倍,跑了两天才被业务方发现。复盘后在ODS层加了Schema校验,同时在指标巡检里加了'ROI波动不超过3倍'的规则。从那以后类似问题都能在第一天发现。」
追问防线
追问1:告警太多怎么办?告警疲劳了大家都不看了。
告警分级很重要。P0告警(核心指标异常/数据阻断)必须立即处理,通过电话/短信通知;P1告警(波动超阈值但不阻断)发飞书群消息,当天处理;P2告警(小问题/建议优化)汇总成日报,集中处理。
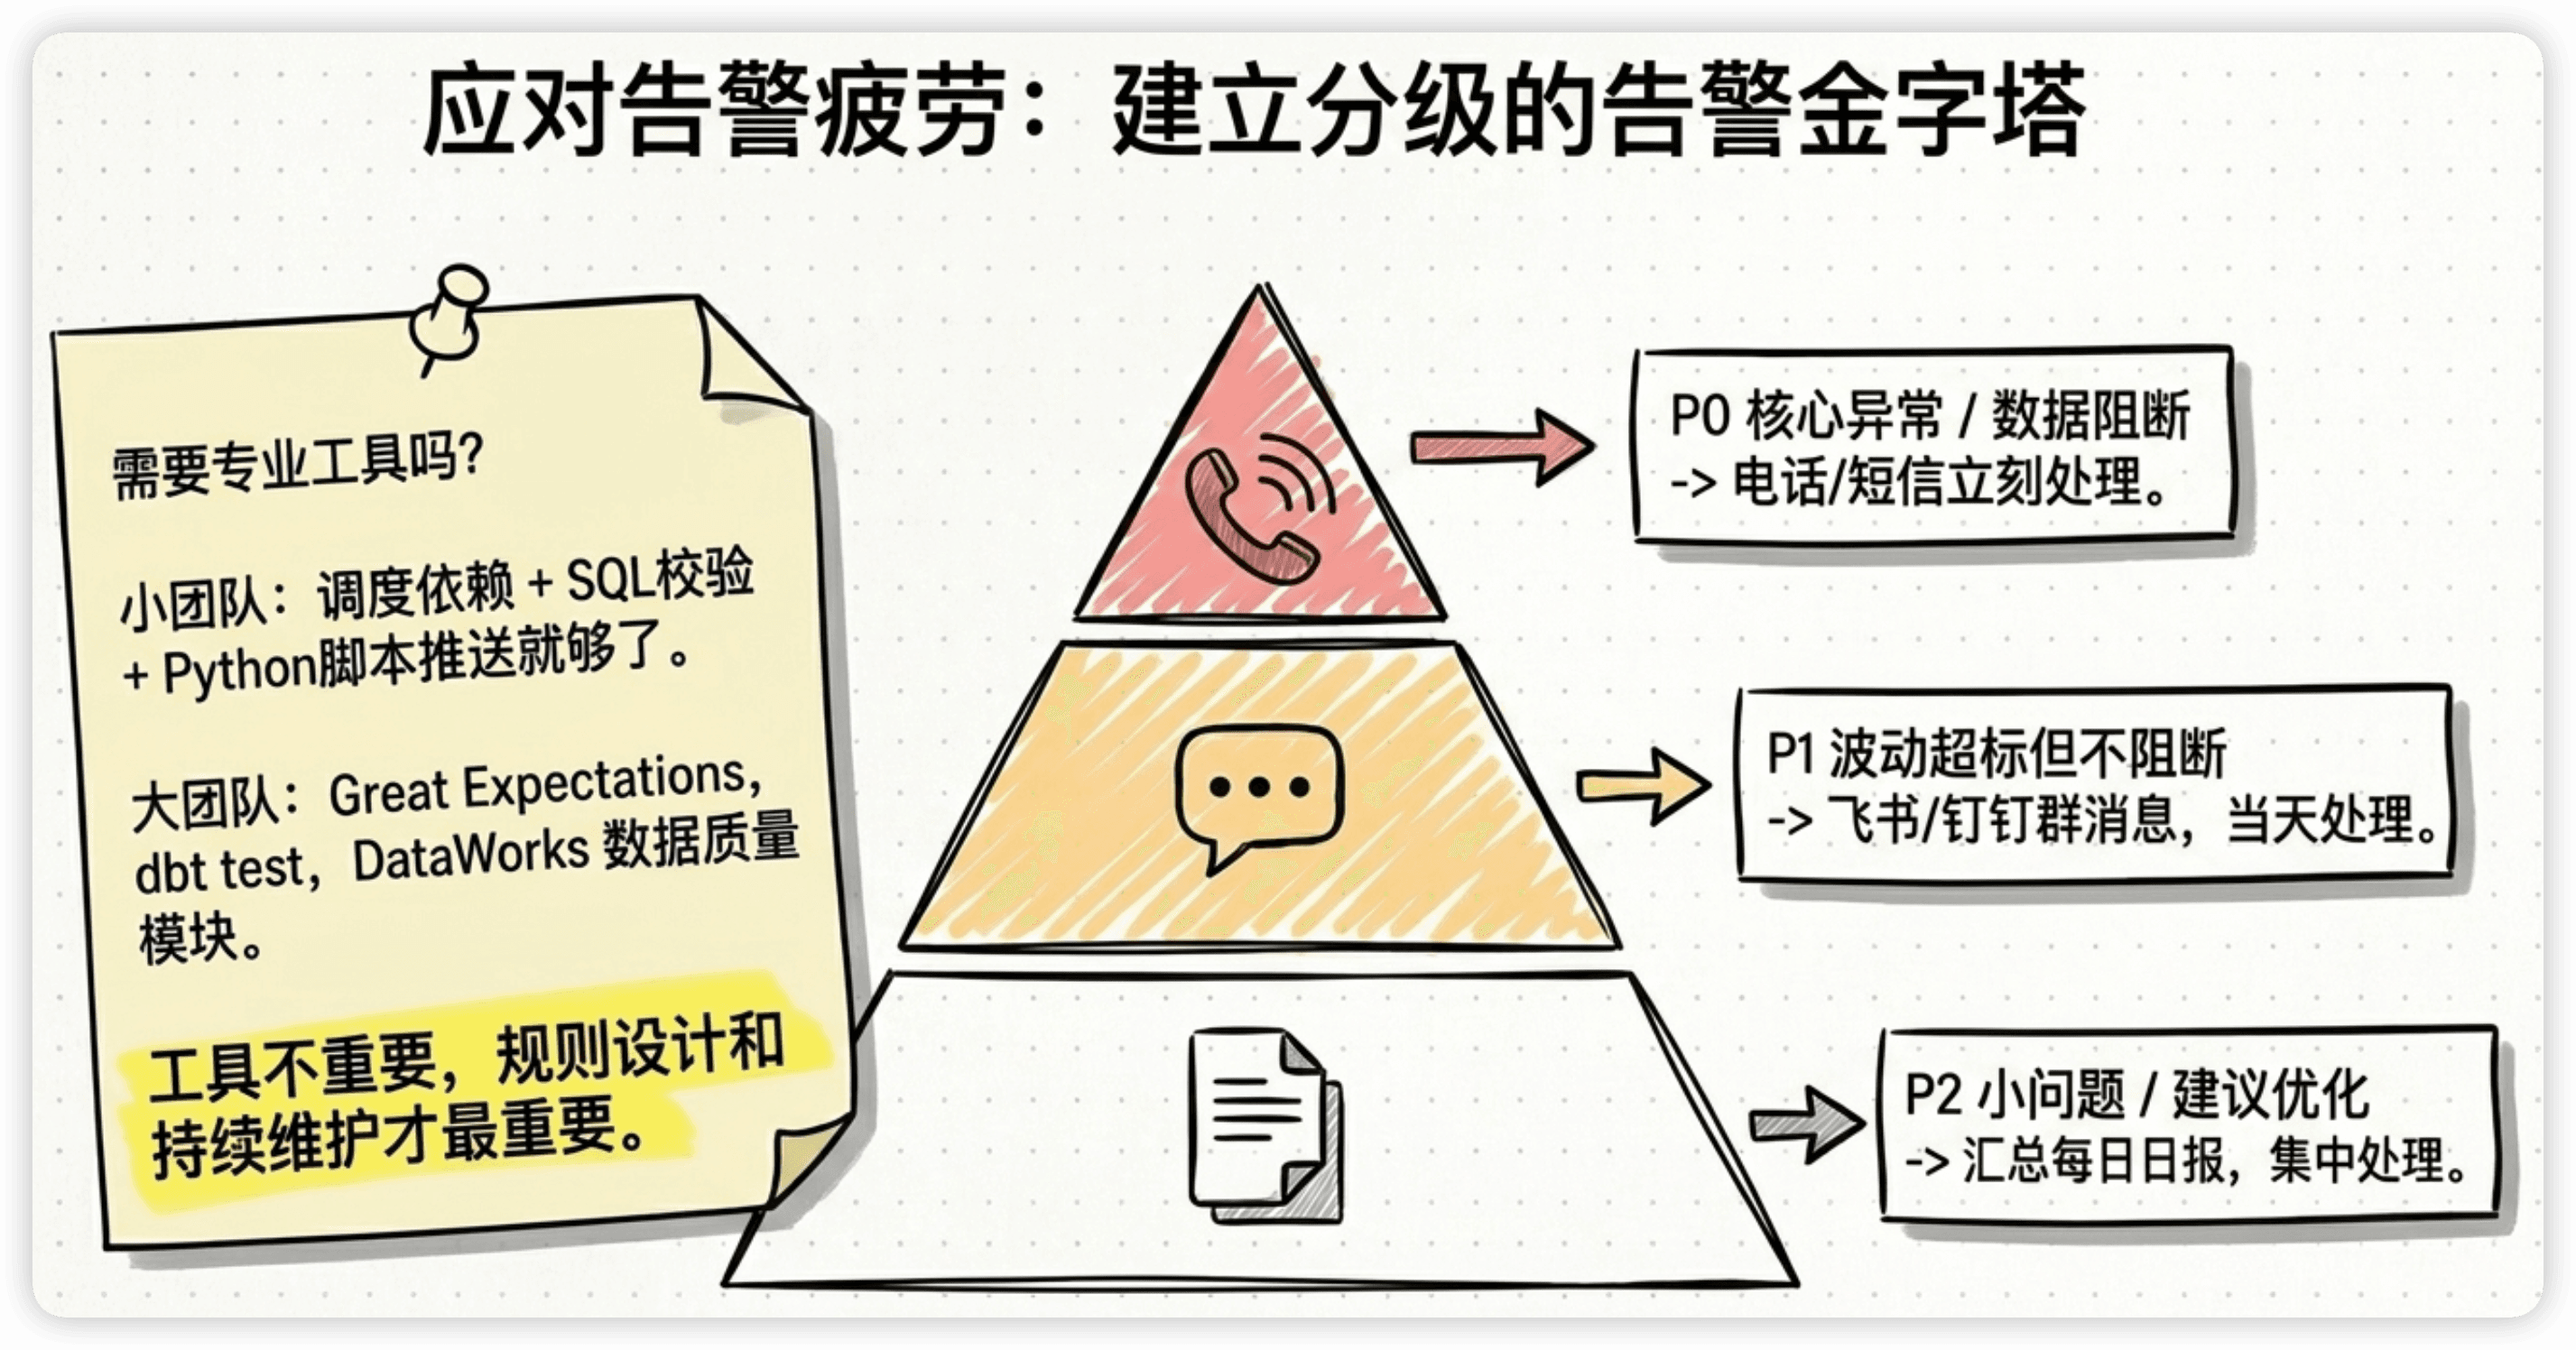
另外,阈值要调到合理水平——太敏感会频繁误报。可以先设宽一点,观察一个月后根据实际波动收紧。
追问2:质量监控需要专门的工具吗?
小团队不需要。用调度平台的任务依赖 + 几段校验SQL + 飞书/钉钉告警接口就够了。我们3人团队用的就是这个方案,核心是几十条SQL校验规则 + 一个Python脚本推送告警。
大团队可以考虑专业工具:Great Expectations(Python生态)、dbt test(dbt生态)、阿里云DataWorks的数据质量模块。但工具不重要,规则设计和持续维护才重要。
总结
- 数据质量四维度:完整性、准确性、一致性、及时性
- 三层监控体系:ETL卡点(写入前拦截)→ SLA监控(产出保障)→ 指标巡检(准确性兜底)
- ETL卡点三件套:主键唯一 + 行数波动 + NULL率,不通过不写入
- 问题溯源四步法:确认范围 → 追血缘 → 比对上下游 → 修复+复盘+补规则
- 每次事故的复盘必须产出一条新的监控规则——同样的错误不能犯两次