命名规范
我接手短剧出海公司的数据组时,做的第一件事不是写SQL,不是搭数仓,而是整理表名。
200多张表,命名风格五花八门:有user_data_new、有tmp_order_20240301、有dws_user_pay_final_v2、还有一张叫bak_xxx_copy_1的表至今不知道是谁建的。一半以上的表没有注释,想找一张"用户每日活跃汇总表"得翻半天。
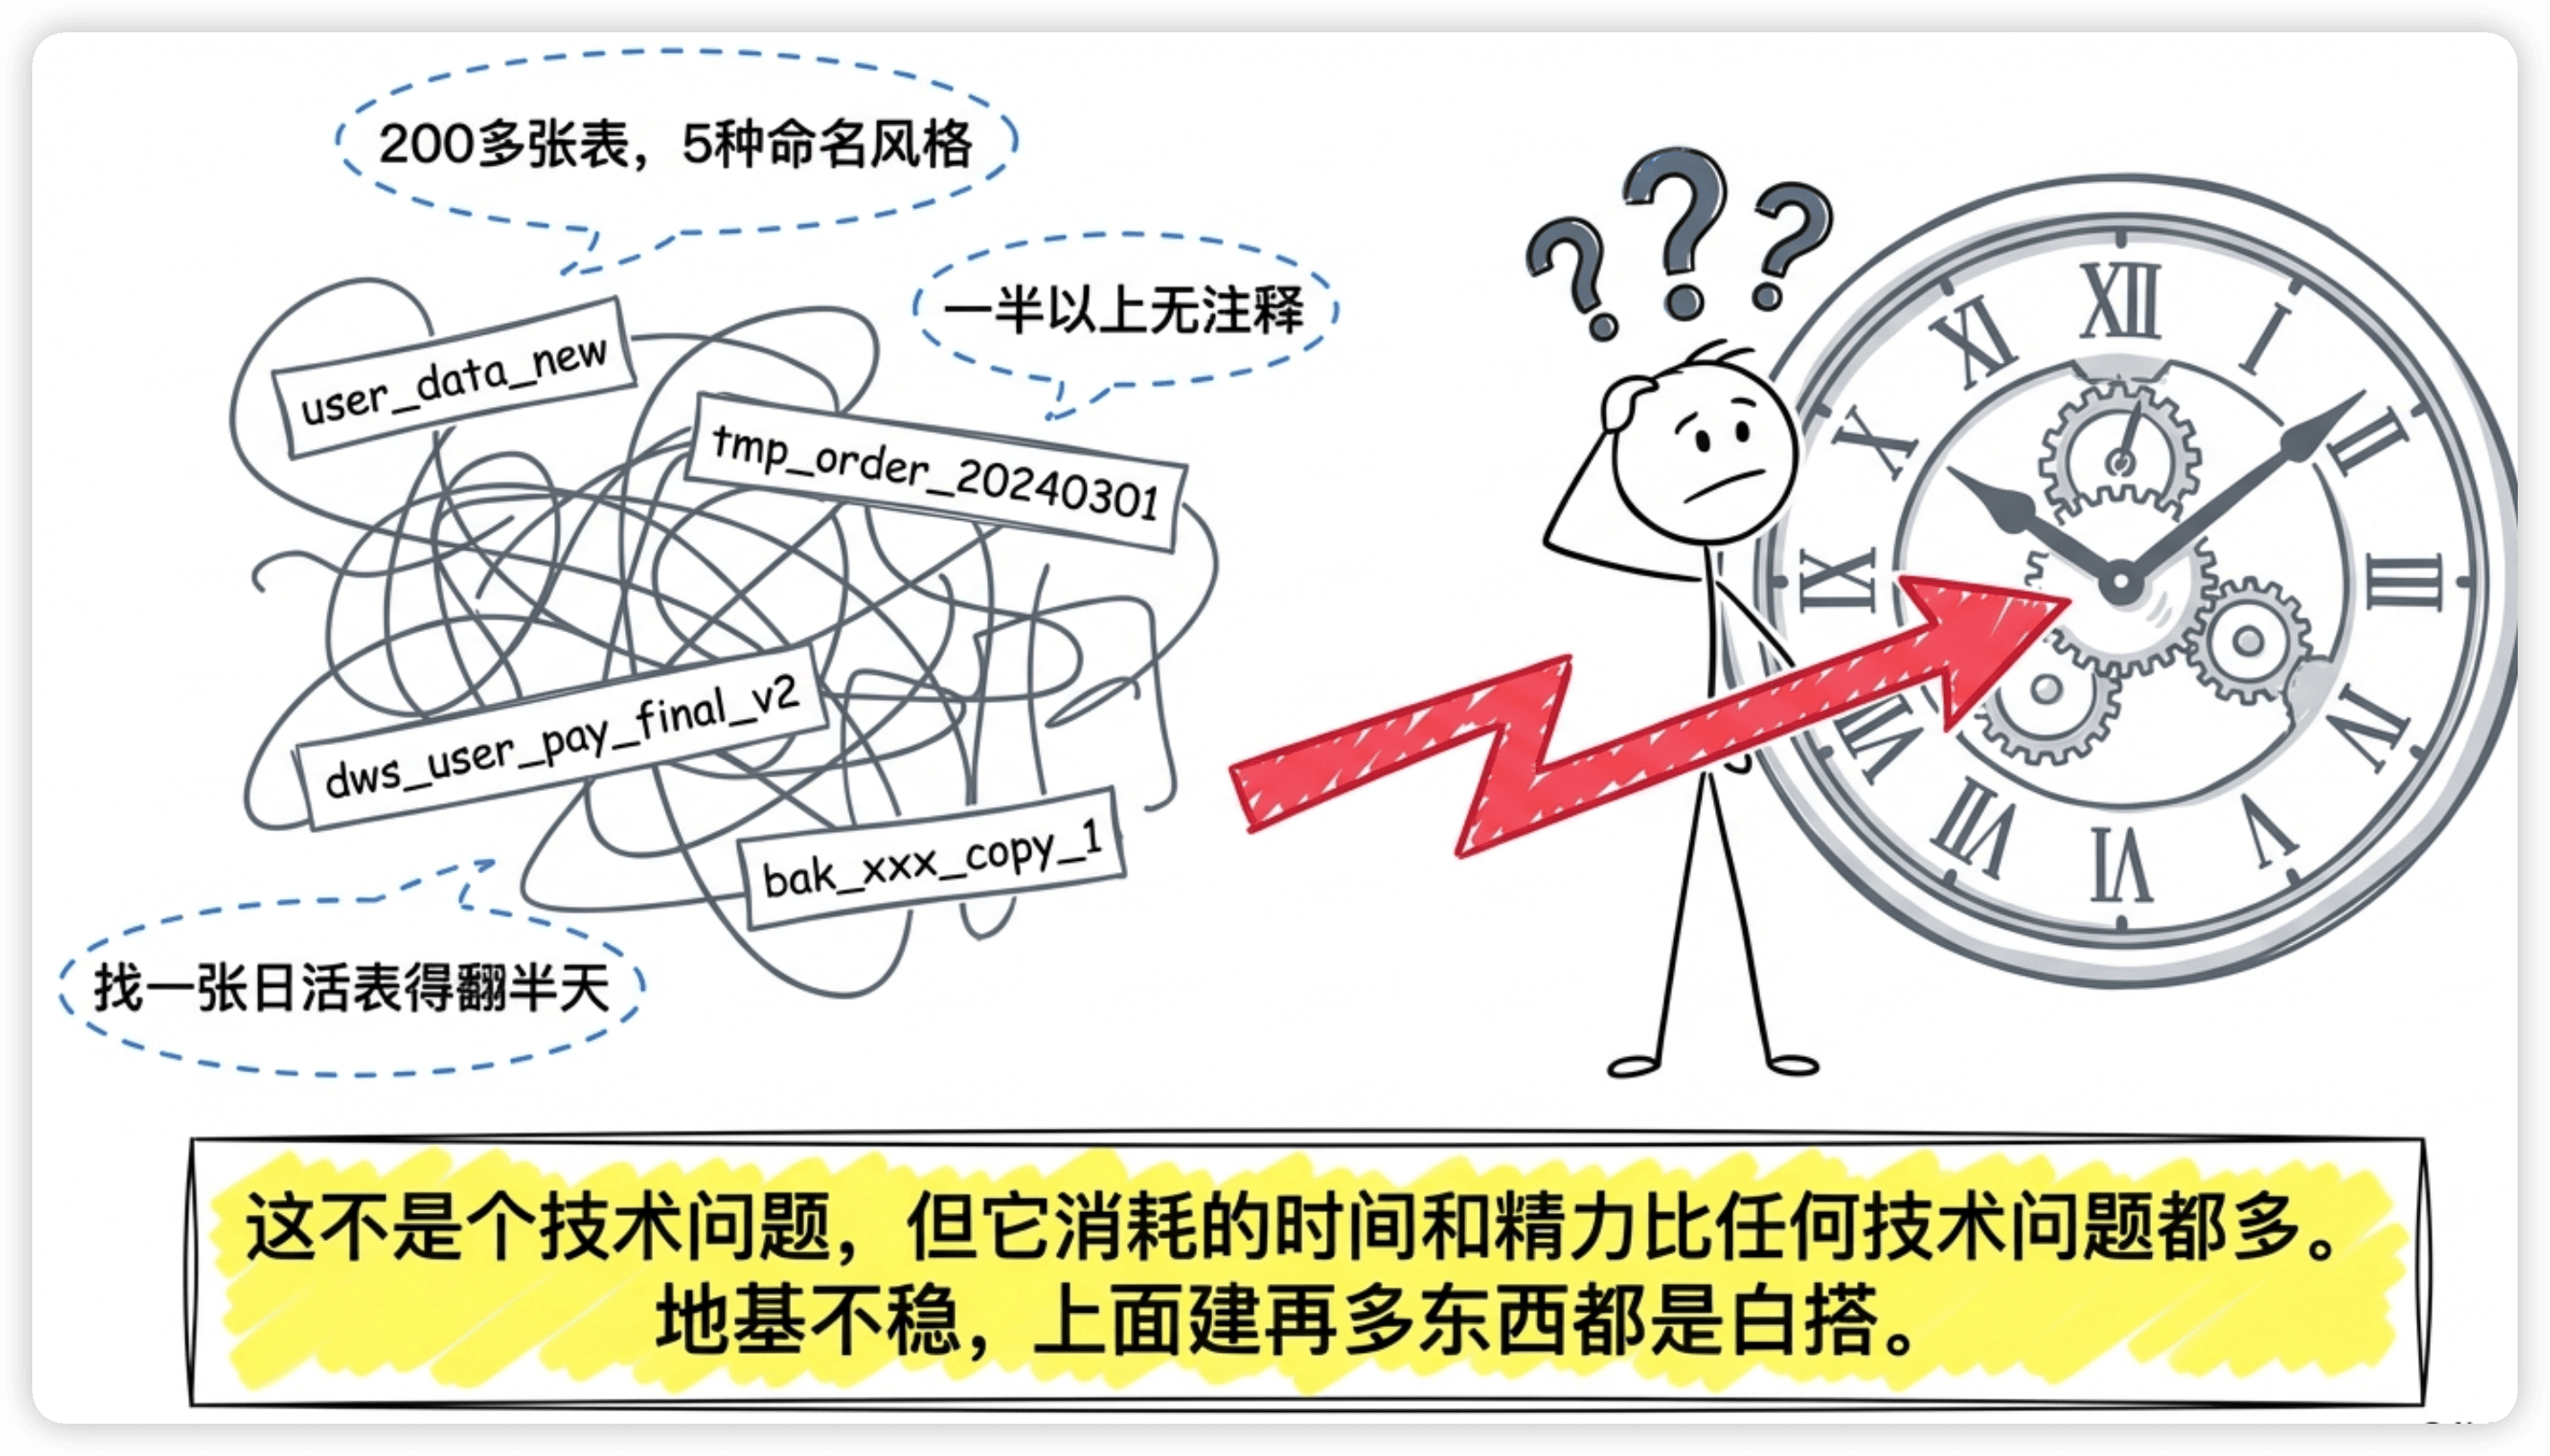
这不是个技术问题,但它消耗的时间和精力比任何技术问题都多。新人入职看不懂表名,每次开发都要问"这张表是干嘛的";线上出了问题排查依赖关系,连上下游都理不清。
命名规范看起来是最"简单"的事情,但它是数仓可维护性的地基。地基不稳,上面建再多东西都是白搭。
为什么好的命名这么重要?
因为好的命名 = 自文档化。
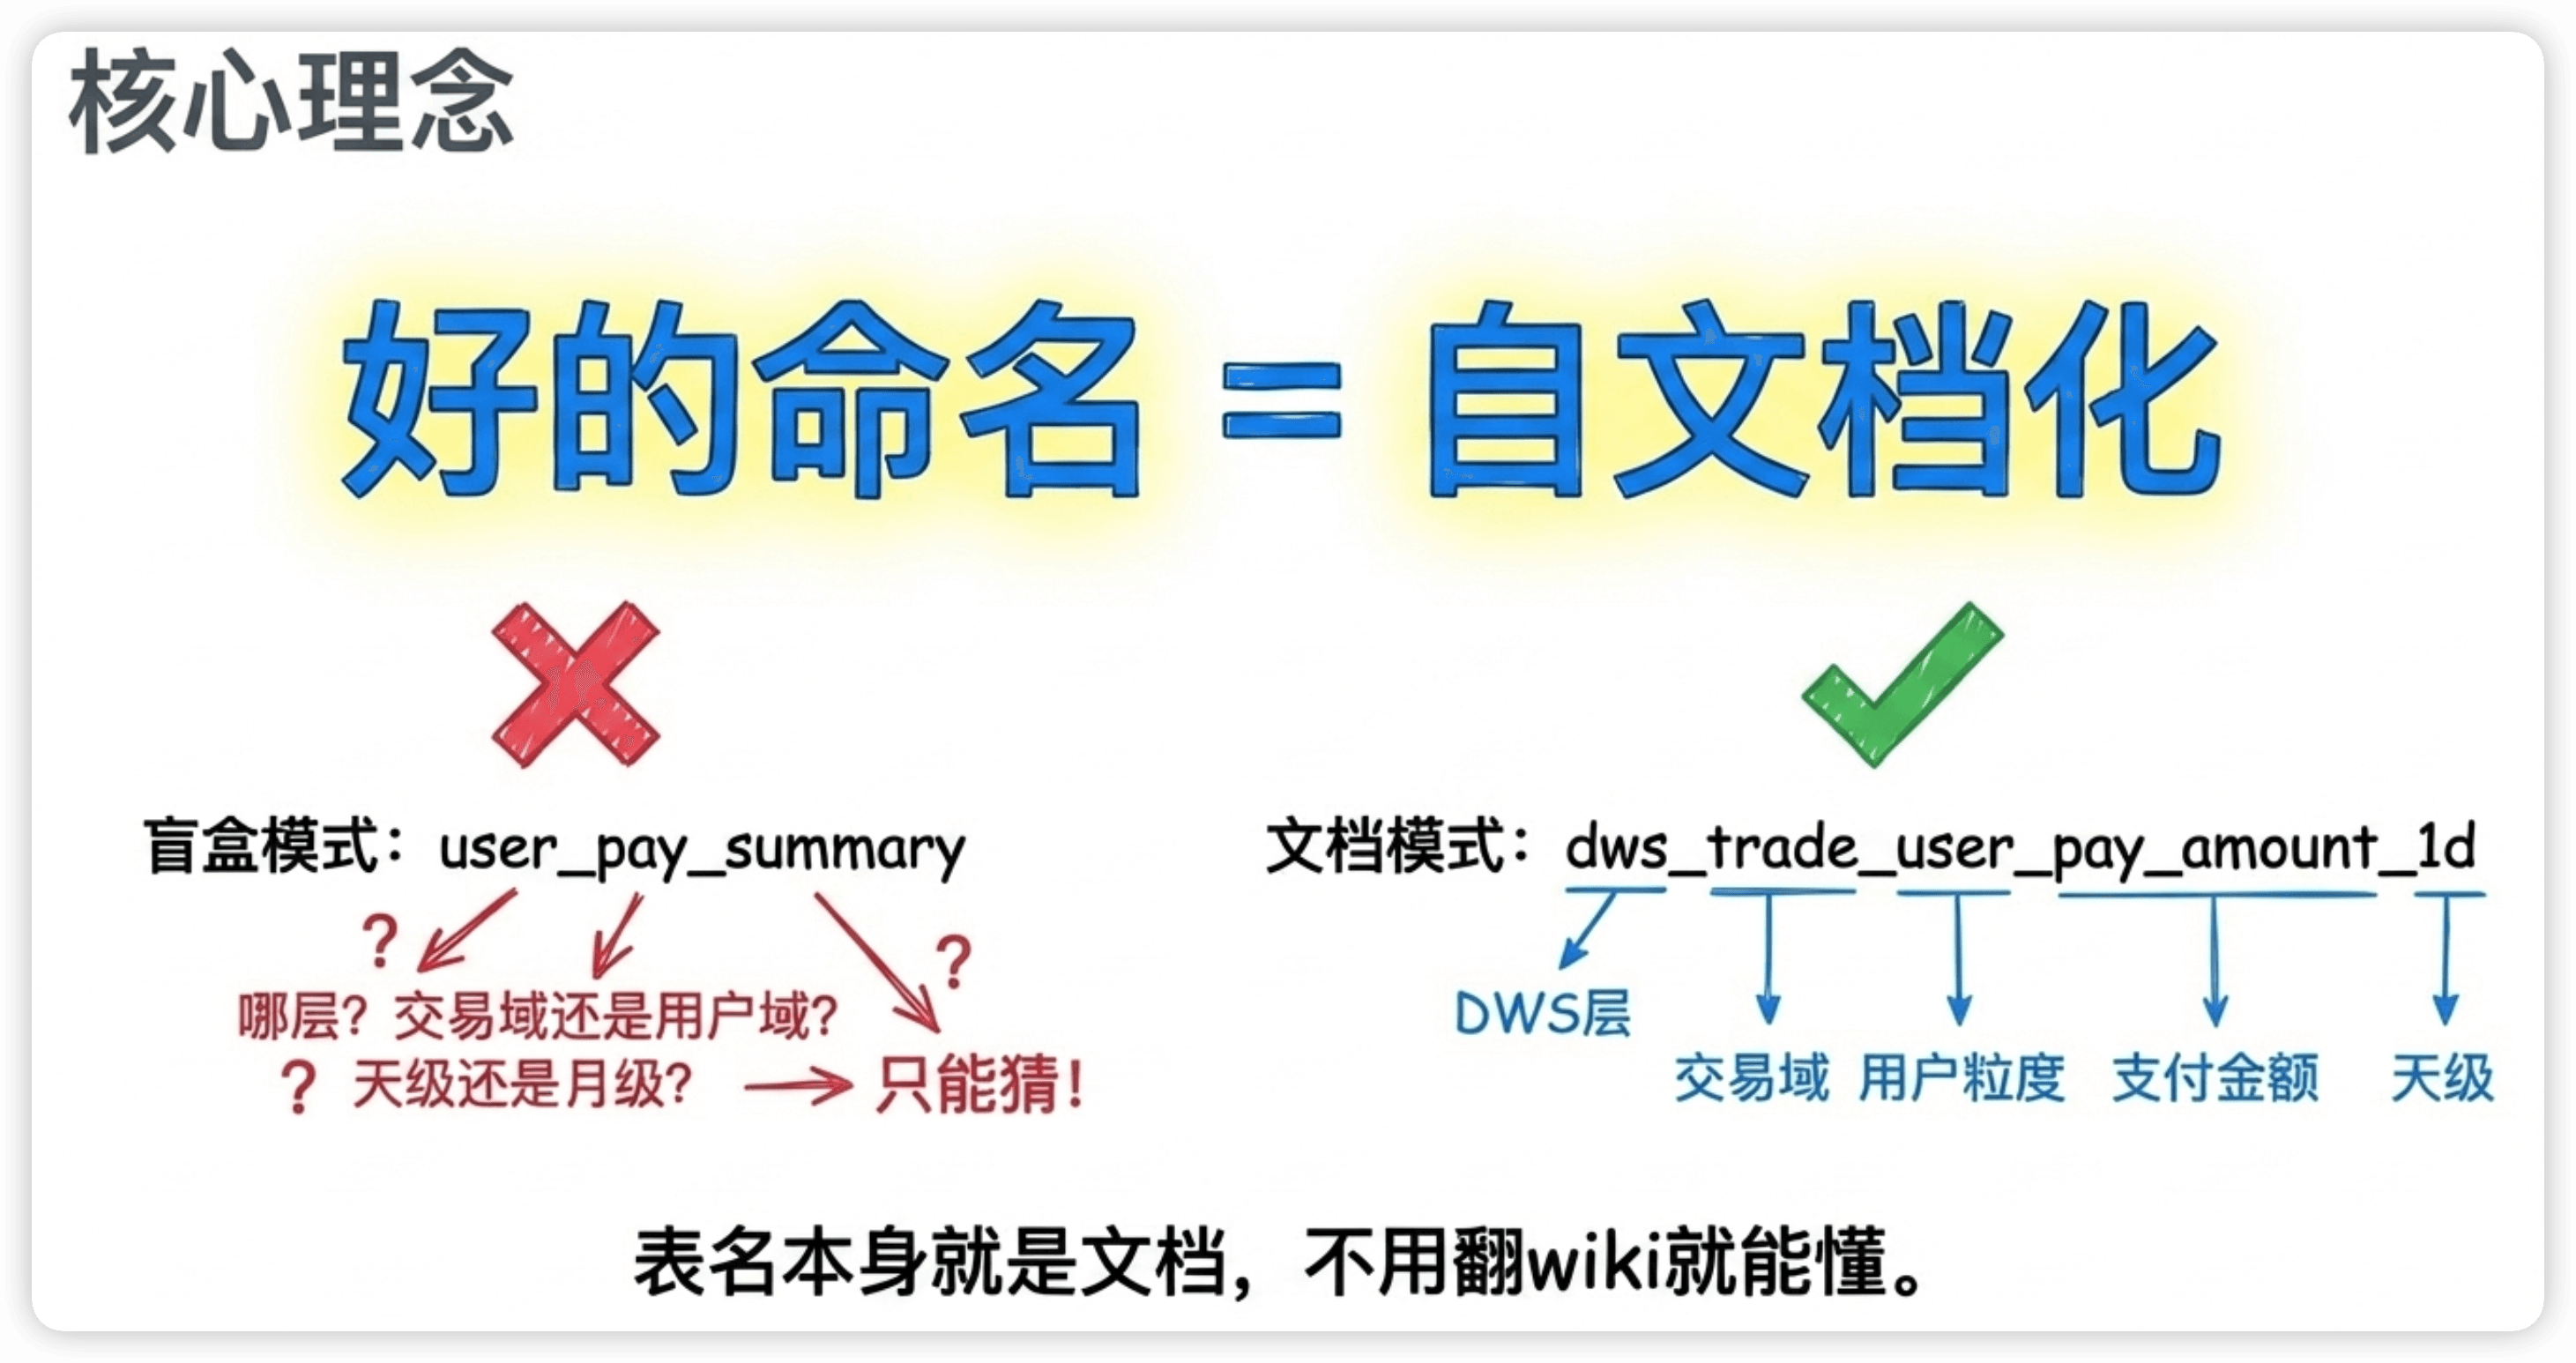
看到dws_trade_user_pay_amount_1d,不用翻文档就知道:DWS层,交易域,用户粒度,支付金额,天级汇总。表名本身就是文档。
看到user_pay_summary呢?它是哪一层的?交易域还是用户域?粒度是什么?是天级还是月级?全部不知道,要么翻文档,要么问人,要么打开表看数据猜。
一个团队3个人的时候,命名不规范勉强能扛——大家互相问一嘴就行。但团队到了5个人、10个人,表到了500张、1000张,没有规范就是灾难。
表命名:一个公式搞定
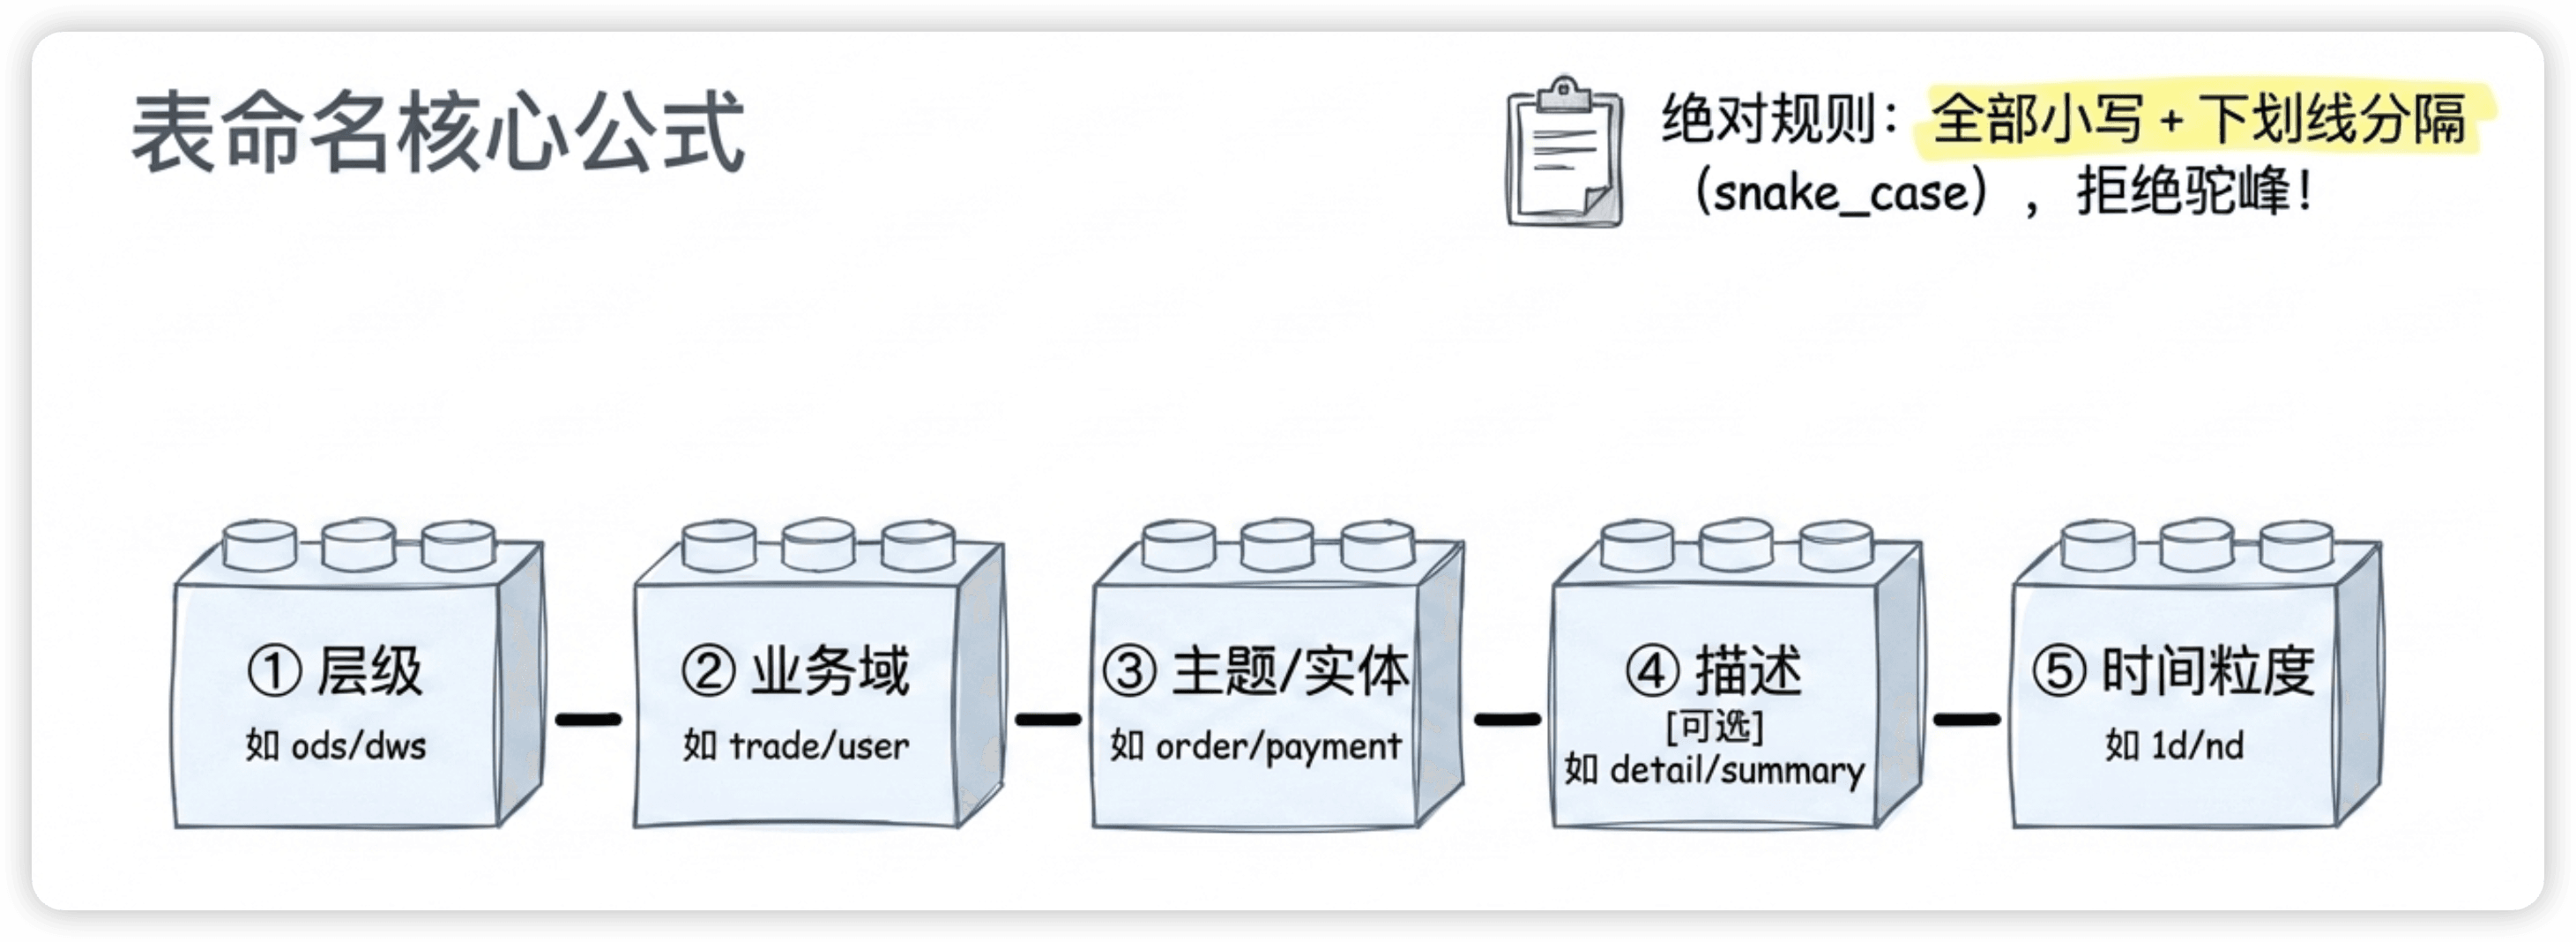
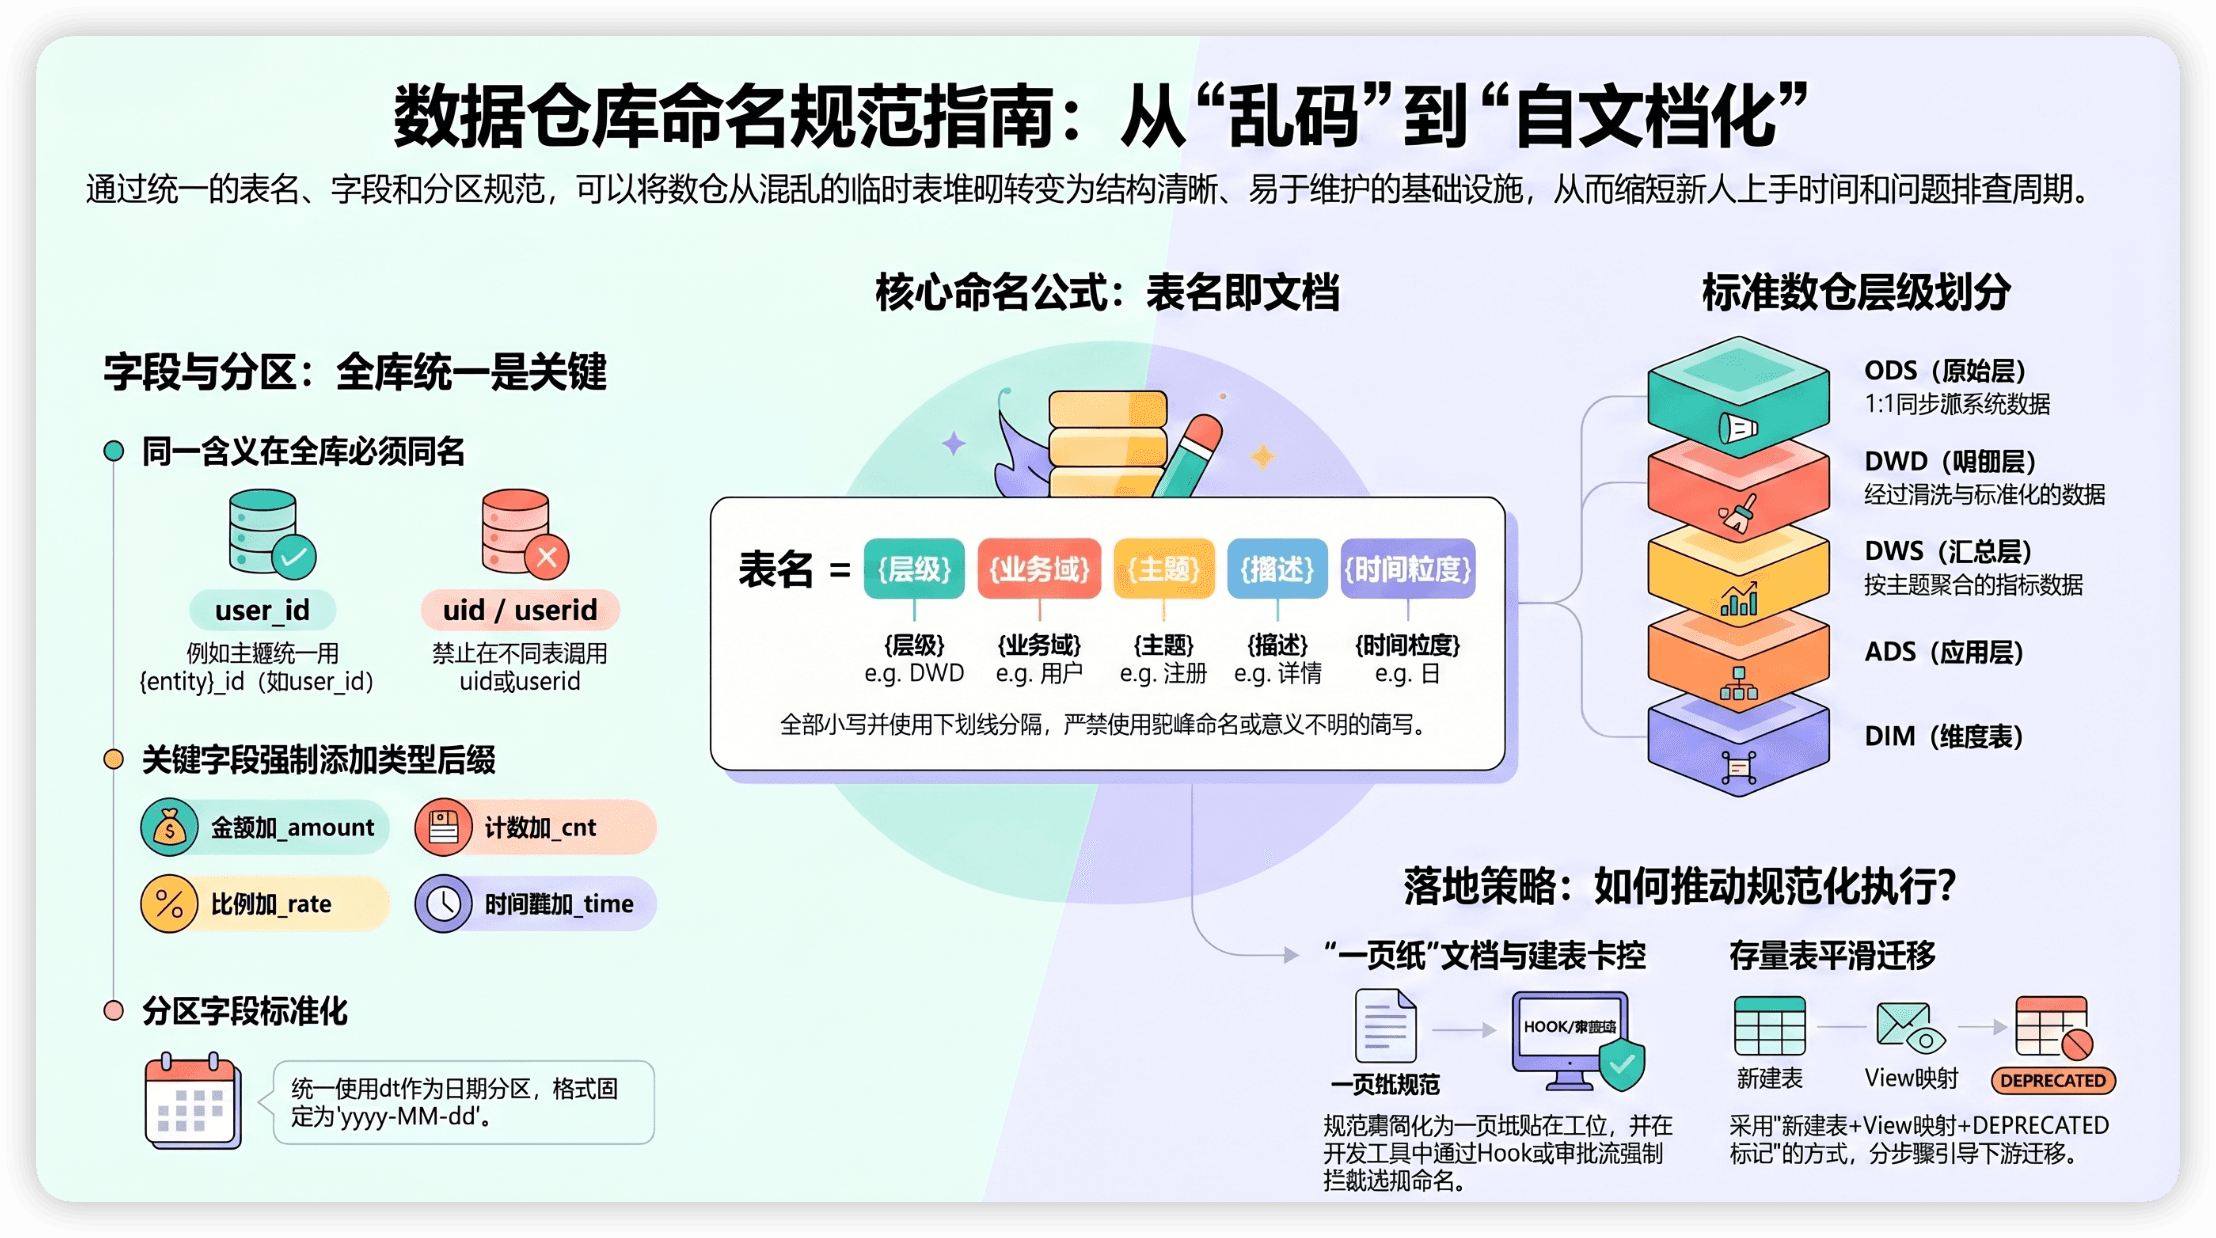
核心命名公式
{层级}_{业务域}_{主题/实体}_{描述}_{时间粒度}每个部分用下划线分隔,全部小写,不用驼峰。
逐个拆解
① 层级(第一个词)
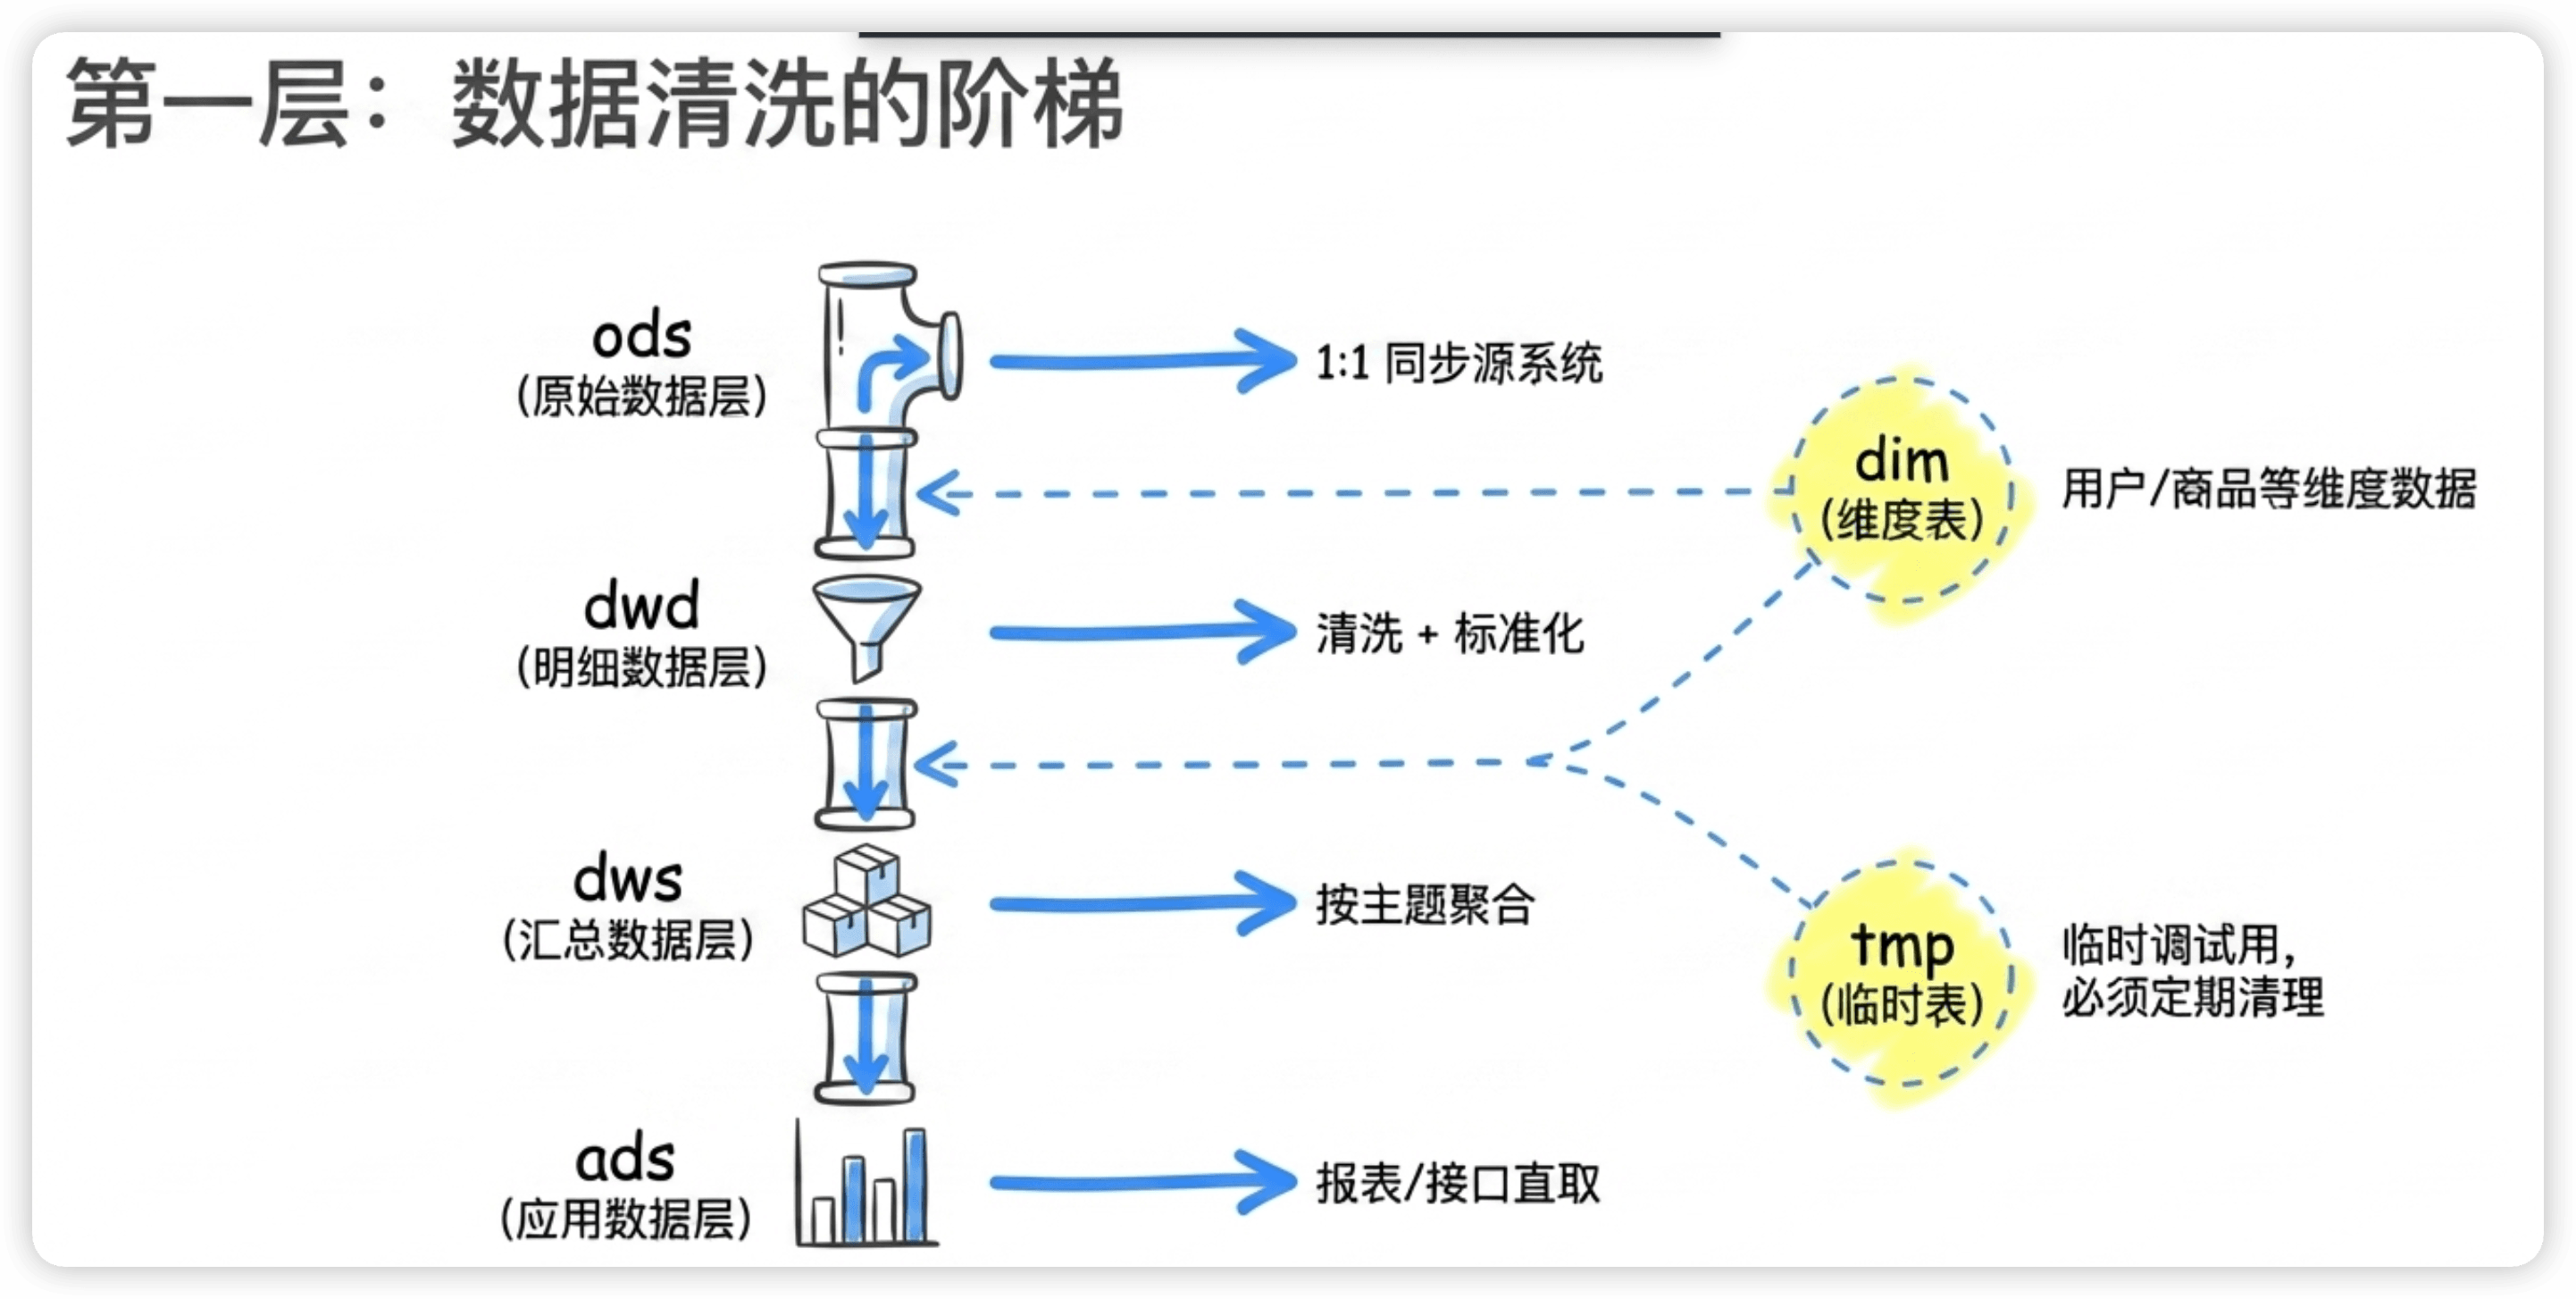
层级是最重要的前缀,一眼就能看出这张表属于数仓哪一层。
| 前缀 | 含义 | 说明 |
|---|---|---|
| ods | 原始数据层 | 1:1同步源系统 |
| dwd | 明细数据层 | 清洗+标准化 |
| dws | 汇总数据层 | 按主题聚合 |
| ads | 应用数据层 | 直接给报表/接口用 |
| dim | 维度表 | 用户、商品、渠道等维度 |
| tmp | 临时表 | 临时调试用,定期清理 |
 |
② 业务域(第二个词)
按公司业务划分的领域,常见的有:
trade    -- 交易/订单
user     -- 用户
ad       -- 广告/投放
content  -- 内容/视频
finance  -- 财务
log -- 日志/埋点业务域的划分要和团队统一,不能A叫orderB叫trade。我们团队统一用的是上面这套,新人入职第一天就对齐。
③ 主题/实体(第三个词)
核心实体名称:order(订单)、payment(支付)、click(点击)、user(用户)、product(商品)。
④ 描述(第四个词,可选)
补充说明:detail(明细)、summary(汇总)、wide(宽表)、snapshot(快照)。
⑤ 时间粒度(最后一个词)
di  -- daily increment,日增量
df  -- daily full,日全量
1d  -- 天级汇总
1h  -- 小时级汇总
7d  -- 7天汇总
rt  -- 实时
完整命名示例
-- ODS层
ods_mysql_order_di              -- ODS,MySQL源,订单表,日增量
ods_log_click_di                -- ODS,埋点日志,点击,日增量
ods_api_facebook_ads_di         -- ODS,API源,Facebook广告,日增量

-- DWD层
dwd_trade_order_detail_di       -- DWD,交易域,订单明细,日增量
dwd_user_login_detail_di        -- DWD,用户域,登录明细,日增量
dwd_ad_click_detail_di          -- DWD,广告域,点击明细,日增量

-- DWS层
dws_trade_user_pay_1d           -- DWS,交易域,用户支付汇总,天级
dws_user_behavior_1d            -- DWS,用户域,行为汇总,天级
dws_ad_campaign_roi_1d          -- DWS,广告域,投放ROI,天级

-- ADS层
ads_trade_daily_report          -- ADS,交易域,每日报表
ads_user_retention_report       -- ADS,用户域,留存报表

-- 维度表
dim_user_df                     -- 维度表,用户,日全量
dim_product_df                  -- 维度表,商品,日全量
dim_channel_df                  -- 维度表,渠道,日全量
看到这些表名,不用翻文档就能知道它是哪一层、什么业务域、什么粒度。这就是自文档化的力量。
字段命名:全库统一是关键
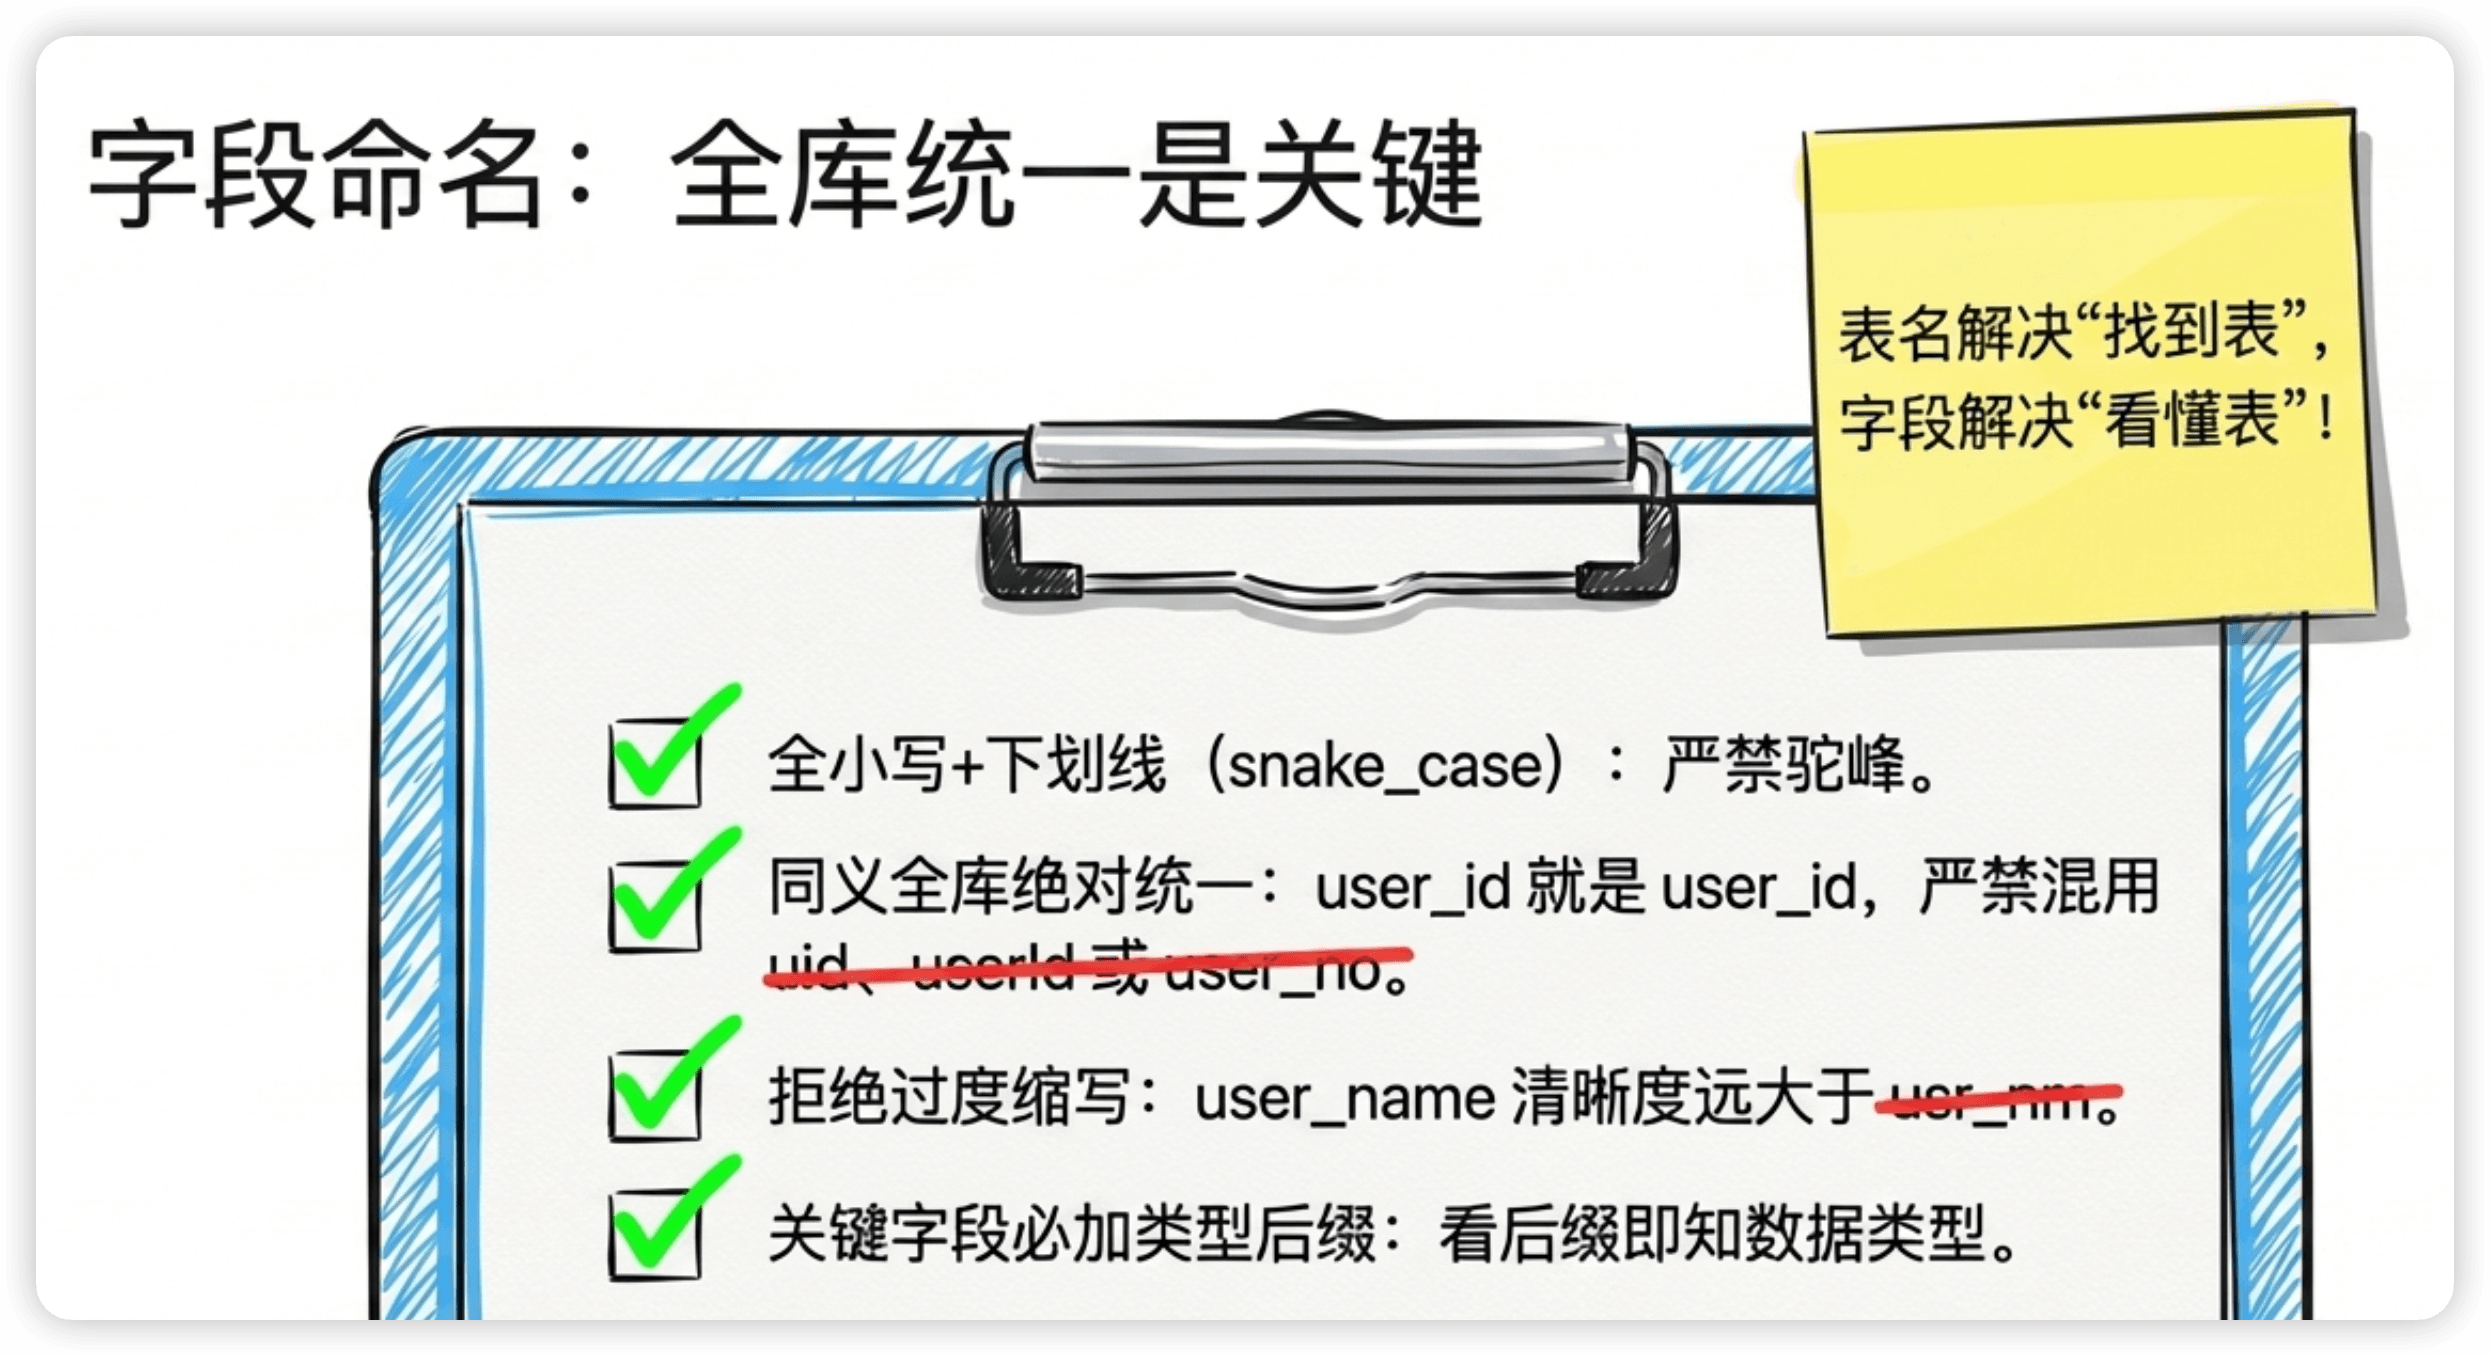
表名规范只解决了"找到表"的问题,字段命名规范解决的是"看懂表"的问题。
基本规则
- 全部小写 + 下划线分隔(snake_case),不用驼峰
- 同一含义在全库范围内用同一名称——
user_id就是user_id,不要有的表叫uid,有的叫userId,有的叫user_no - 不要过度缩写——
usr_nm不如user_name清晰 - 关键字段加类型后缀,让人一看就知道数据类型和含义
字段命名约定表
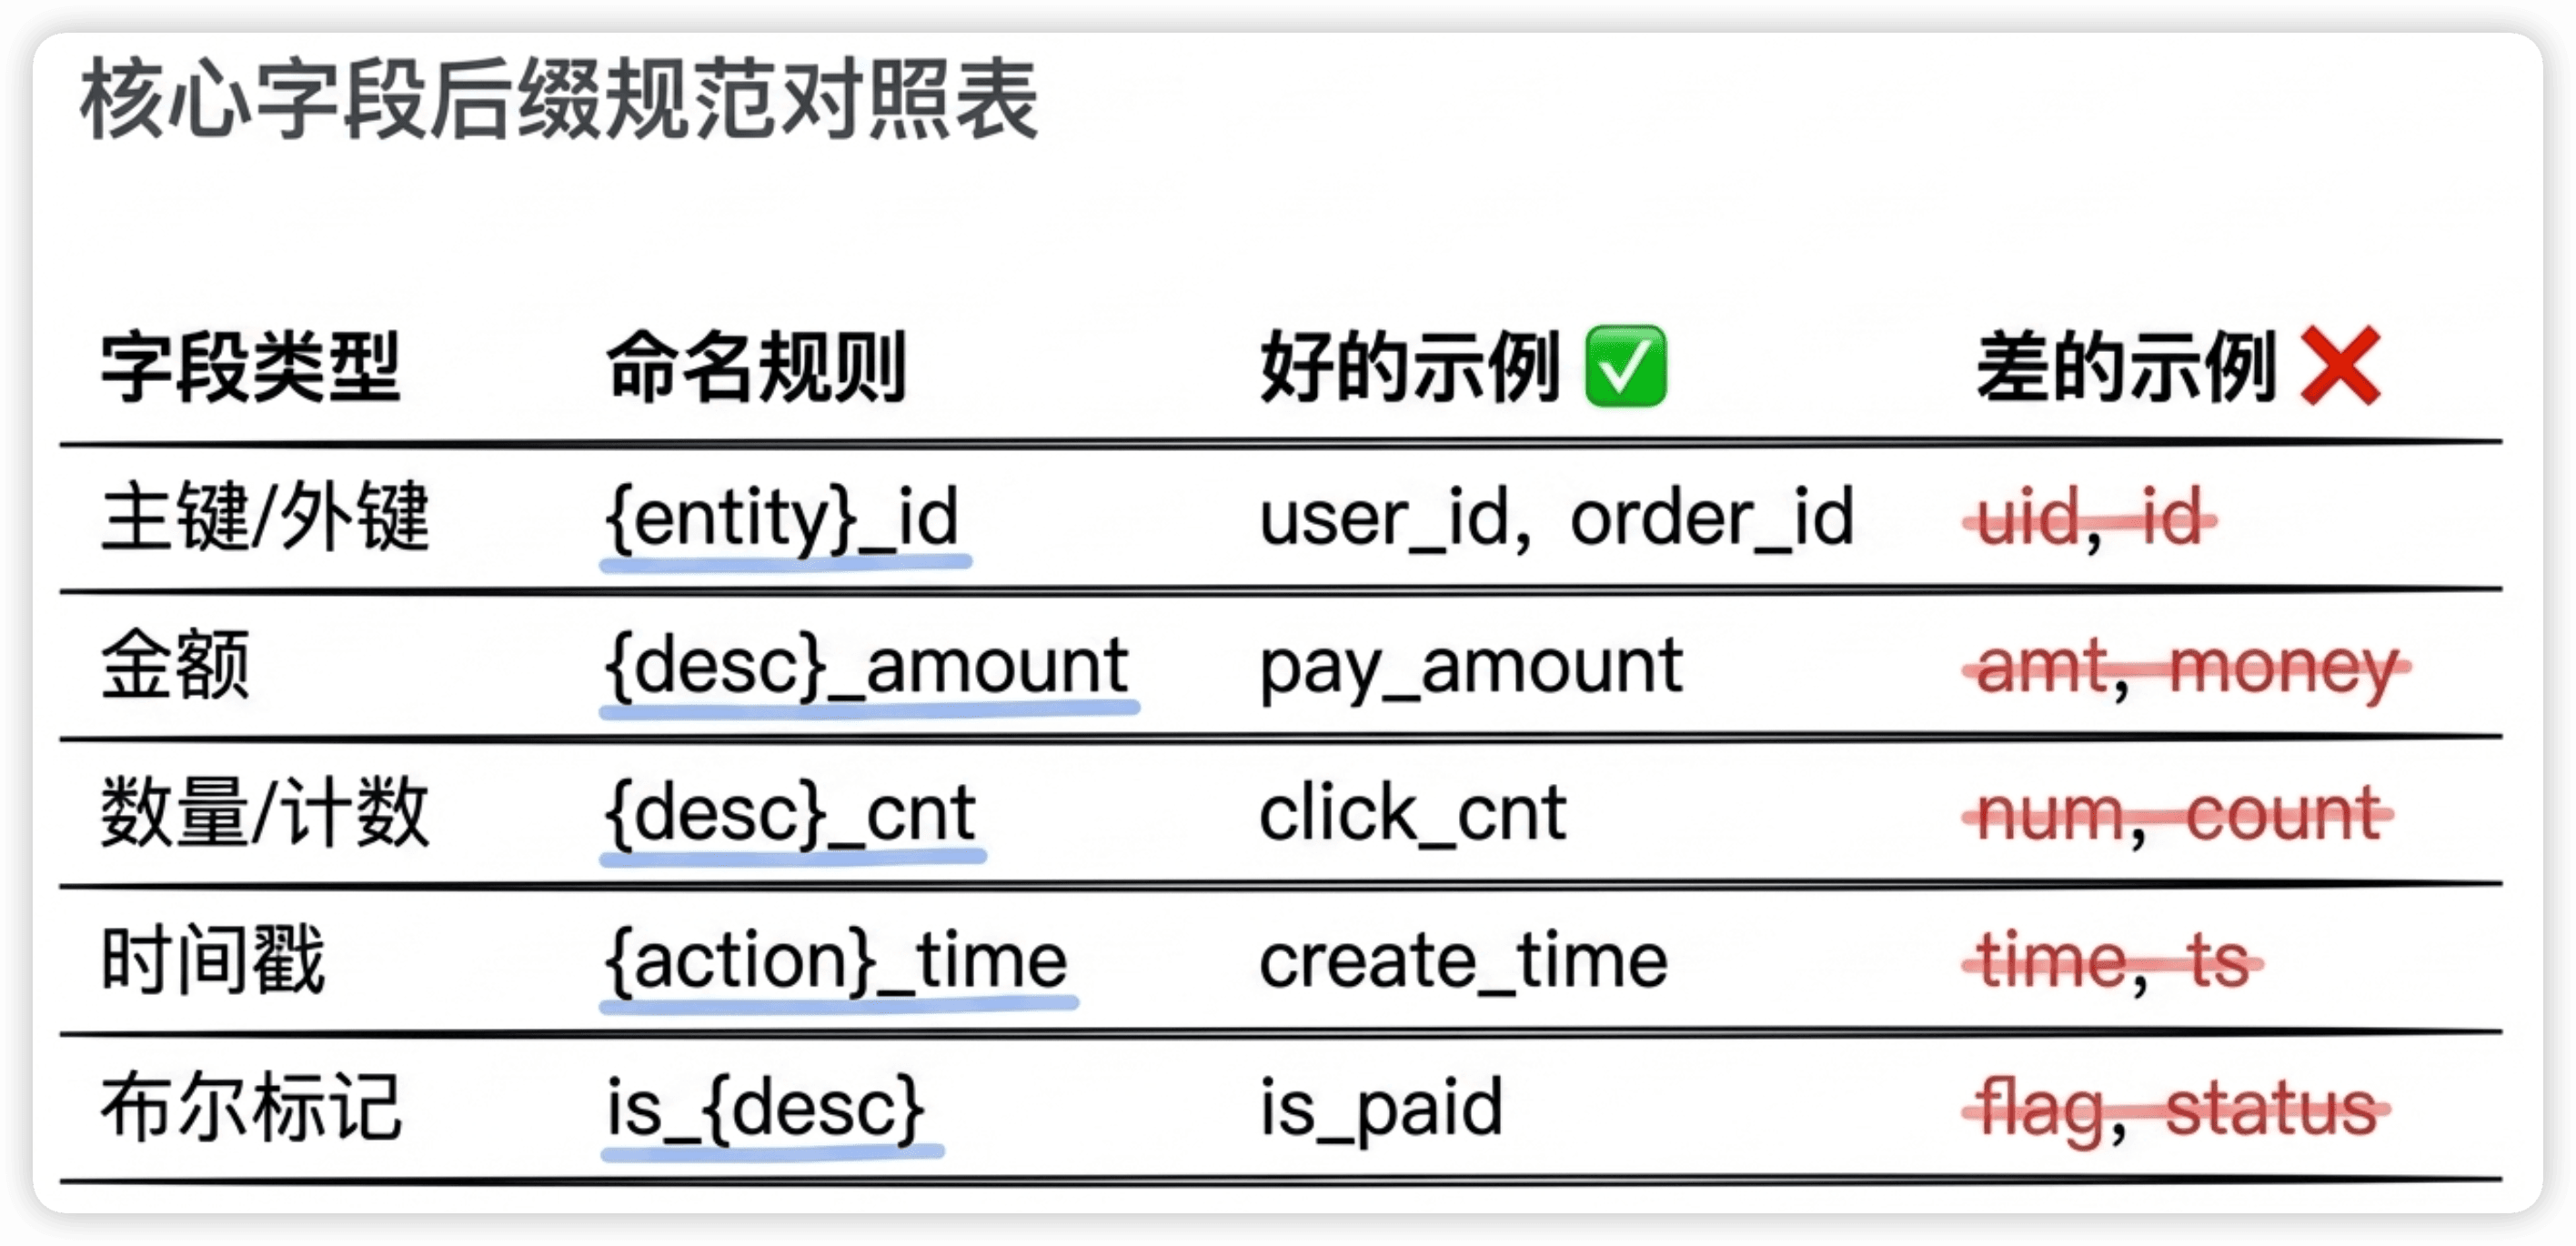
| 字段类型 | 命名规则 | 好的示例 | 差的示例 |
|---|---|---|---|
| 主键/外键 | {entity}_id |
user_id, order_id | uid, oid, id |
| 名称 | {entity}_name |
user_name, product_name | name, usr_nm |
| 金额 | {desc}_amount |
order_amount, pay_amount | amt, money, amount |
| 数量/计数 | {desc}_cnt |
order_cnt, click_cnt | num, count, number |
| 比率/比例 | {desc}_rate |
pay_rate, retention_rate | rate, ratio |
| 时间戳 | {action}_time |
create_time, pay_time | time, ts, datetime |
| 日期 | {desc}_date |
order_date, birth_date | date, dt (dt只用于分区) |
| 布尔标记 | is_{desc} |
is_paid, is_new_user | flag, status, paid |
| 时长 | {desc}_duration |
play_duration, session_duration | dur, len |
| 分区字段 | dt / hour | dt='2025-01-15' | p_date, partition_date |
容易踩坑的反面教材
-- ❌ 看不懂的命名
CREATE TABLE some_table (
    id       BIGINT,          -- 什么ID?用户?订单?
    amt      DECIMAL,         -- 什么金额?下单?支付?退款?
    flag     INT,             -- 什么标记?已支付?已删除?
    type     STRING,          -- 什么类型?
    status   INT,             -- 什么状态?用0/1/2代替含义?
    dt1      STRING,          -- 哪个日期?开始?结束?
    dt2      STRING           -- 和dt1什么关系?
);

-- ✅ 清晰的命名
CREATE TABLE dws_trade_order_summary_1d (
    order_id        BIGINT  COMMENT '订单ID',
    pay_amount      DECIMAL COMMENT '实付金额,单位:元',
    is_paid         INT     COMMENT '是否已支付:1=是,0=否',
    order_type      STRING  COMMENT '订单类型:normal/group/flash_sale',
    order_status    INT     COMMENT '订单状态:0=待支付,1=已支付,2=已取消,3=已退款',
    start_date      STRING  COMMENT '统计开始日期',
    end_date        STRING  COMMENT '统计结束日期'
) COMMENT 'DWS层-交易域-订单汇总-天级';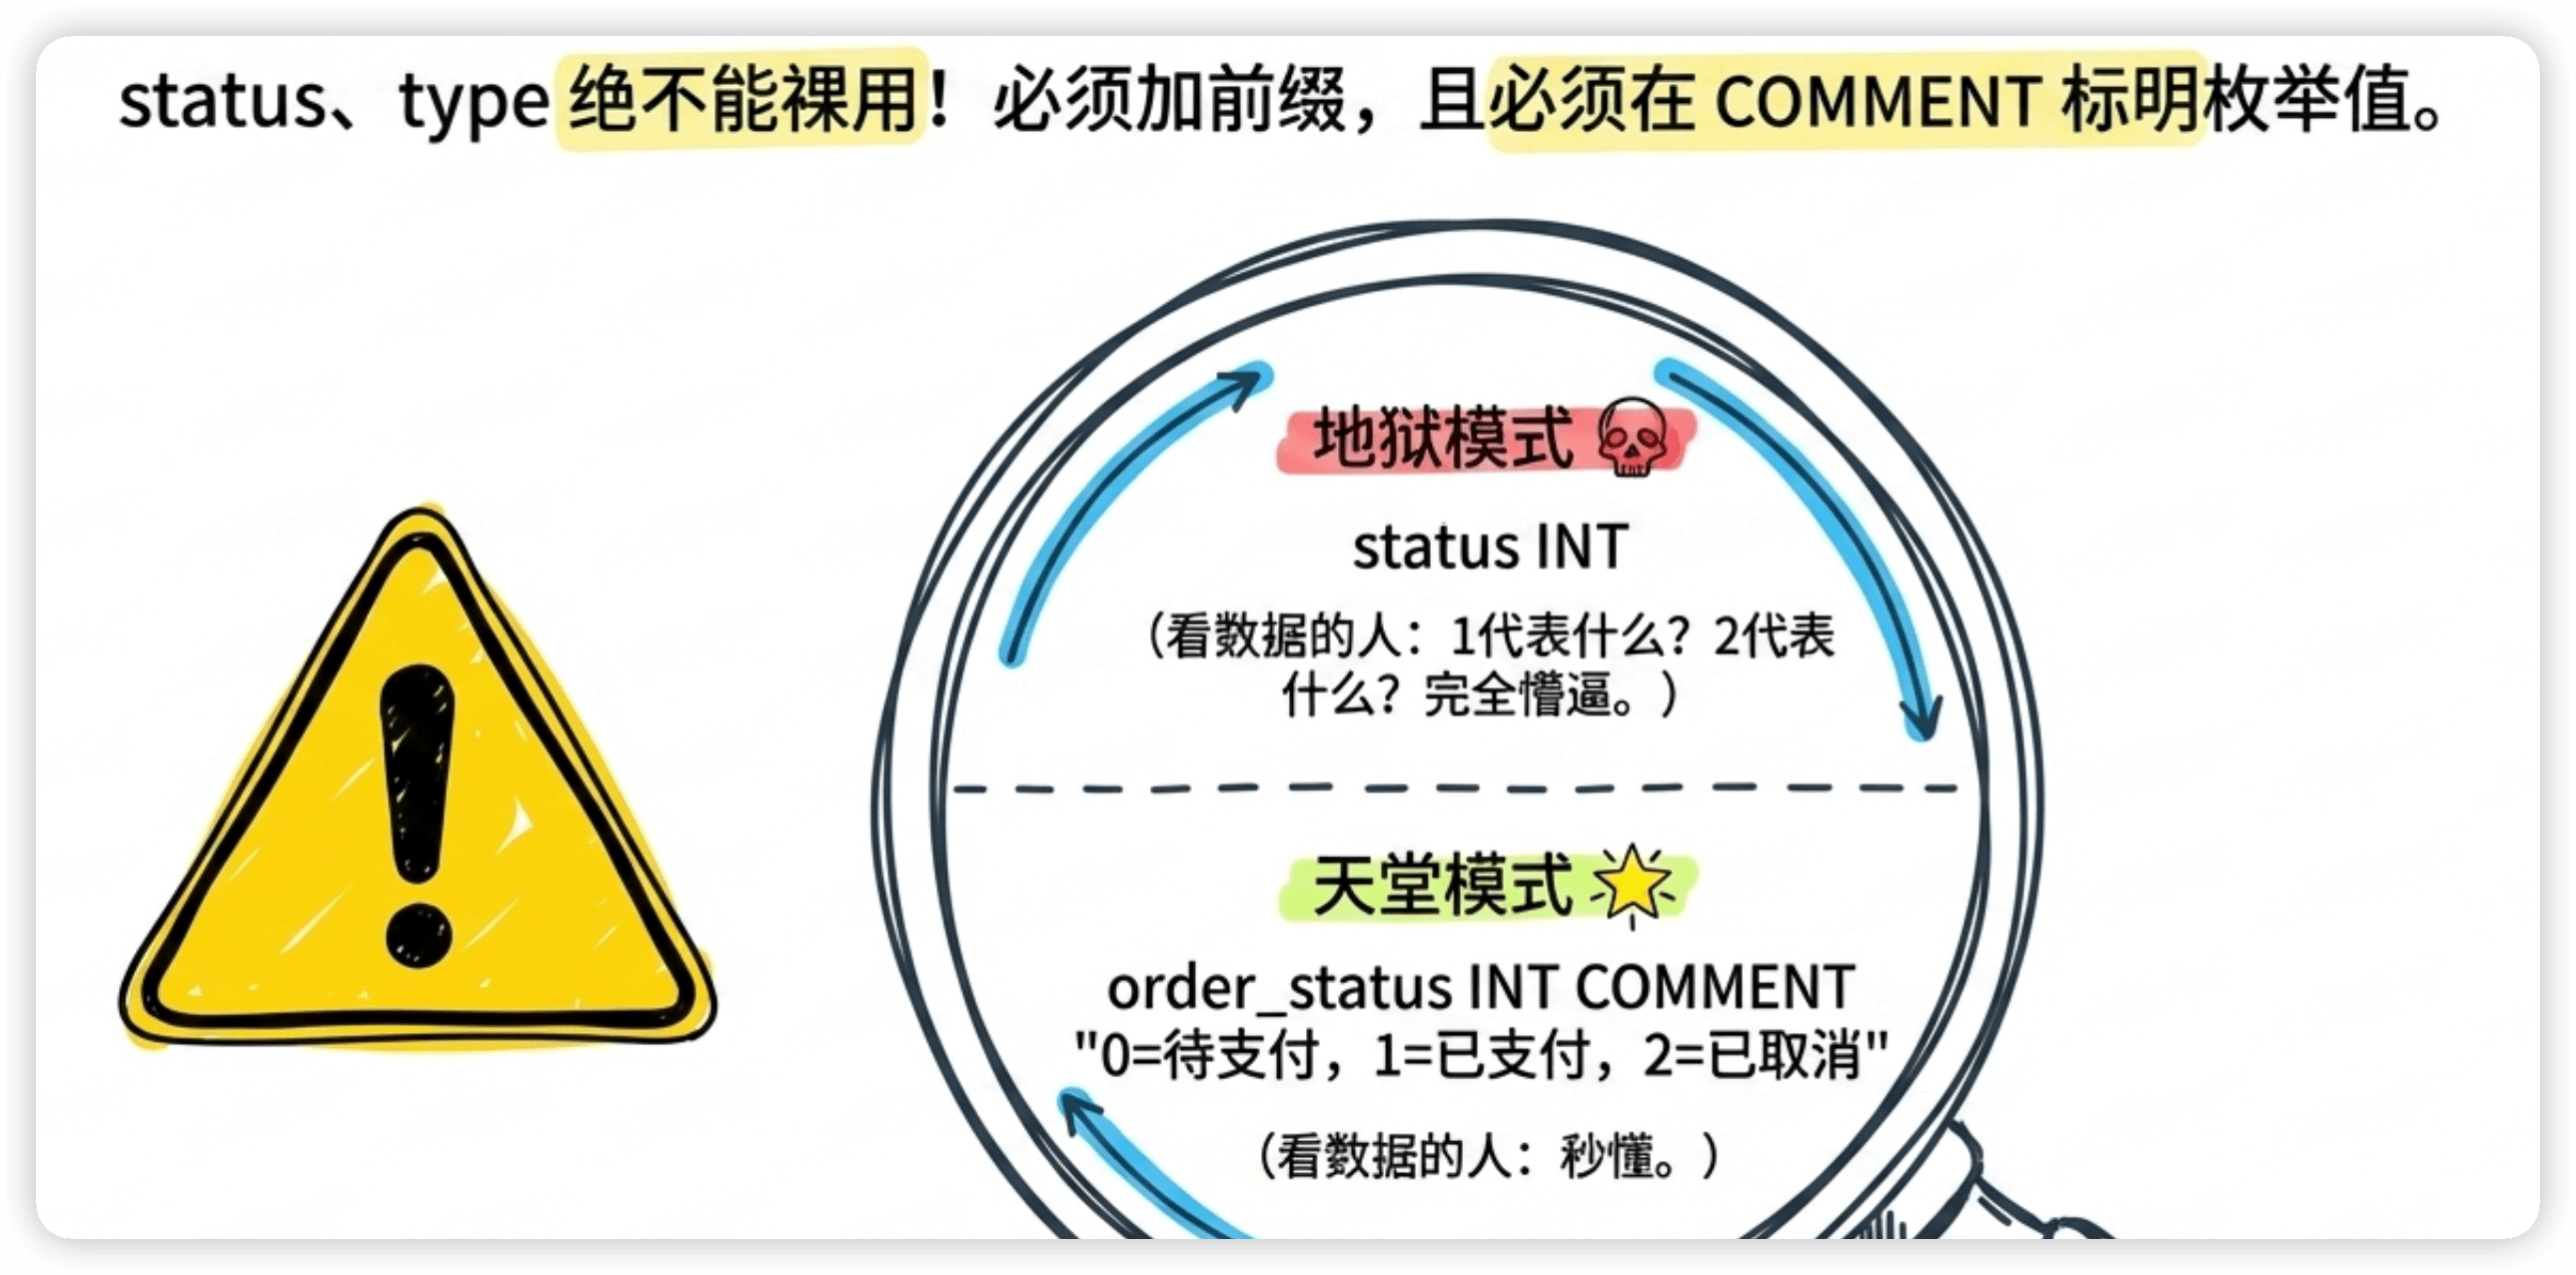 特别强调一点:status、type这类字段不能裸用,必须加前缀说明是什么的status/type,而且COMMENT里要写清楚每个枚举值的含义。
status INT和order_status INT COMMENT '0=待支付,1=已支付,2=已取消'的可读性天差地别。
分区命名规范
大数据表几乎都需要分区,分区字段也要统一:
-- 一级分区:日期(最常见,几乎所有表都有)
dt STRING COMMENT '数据日期,格式yyyy-MM-dd'

-- 二级分区:小时(实时/近实时场景)
hour STRING COMMENT '小时,格式HH,如08、14、23'

-- 二级分区:业务线(多业务场景)
biz_type STRING COMMENT '业务线:drama(短剧)/novel(小说)/game(游戏)'

-- 二级分区:地区(出海业务)
region STRING COMMENT '地区:us/jp/kr/tw/sea'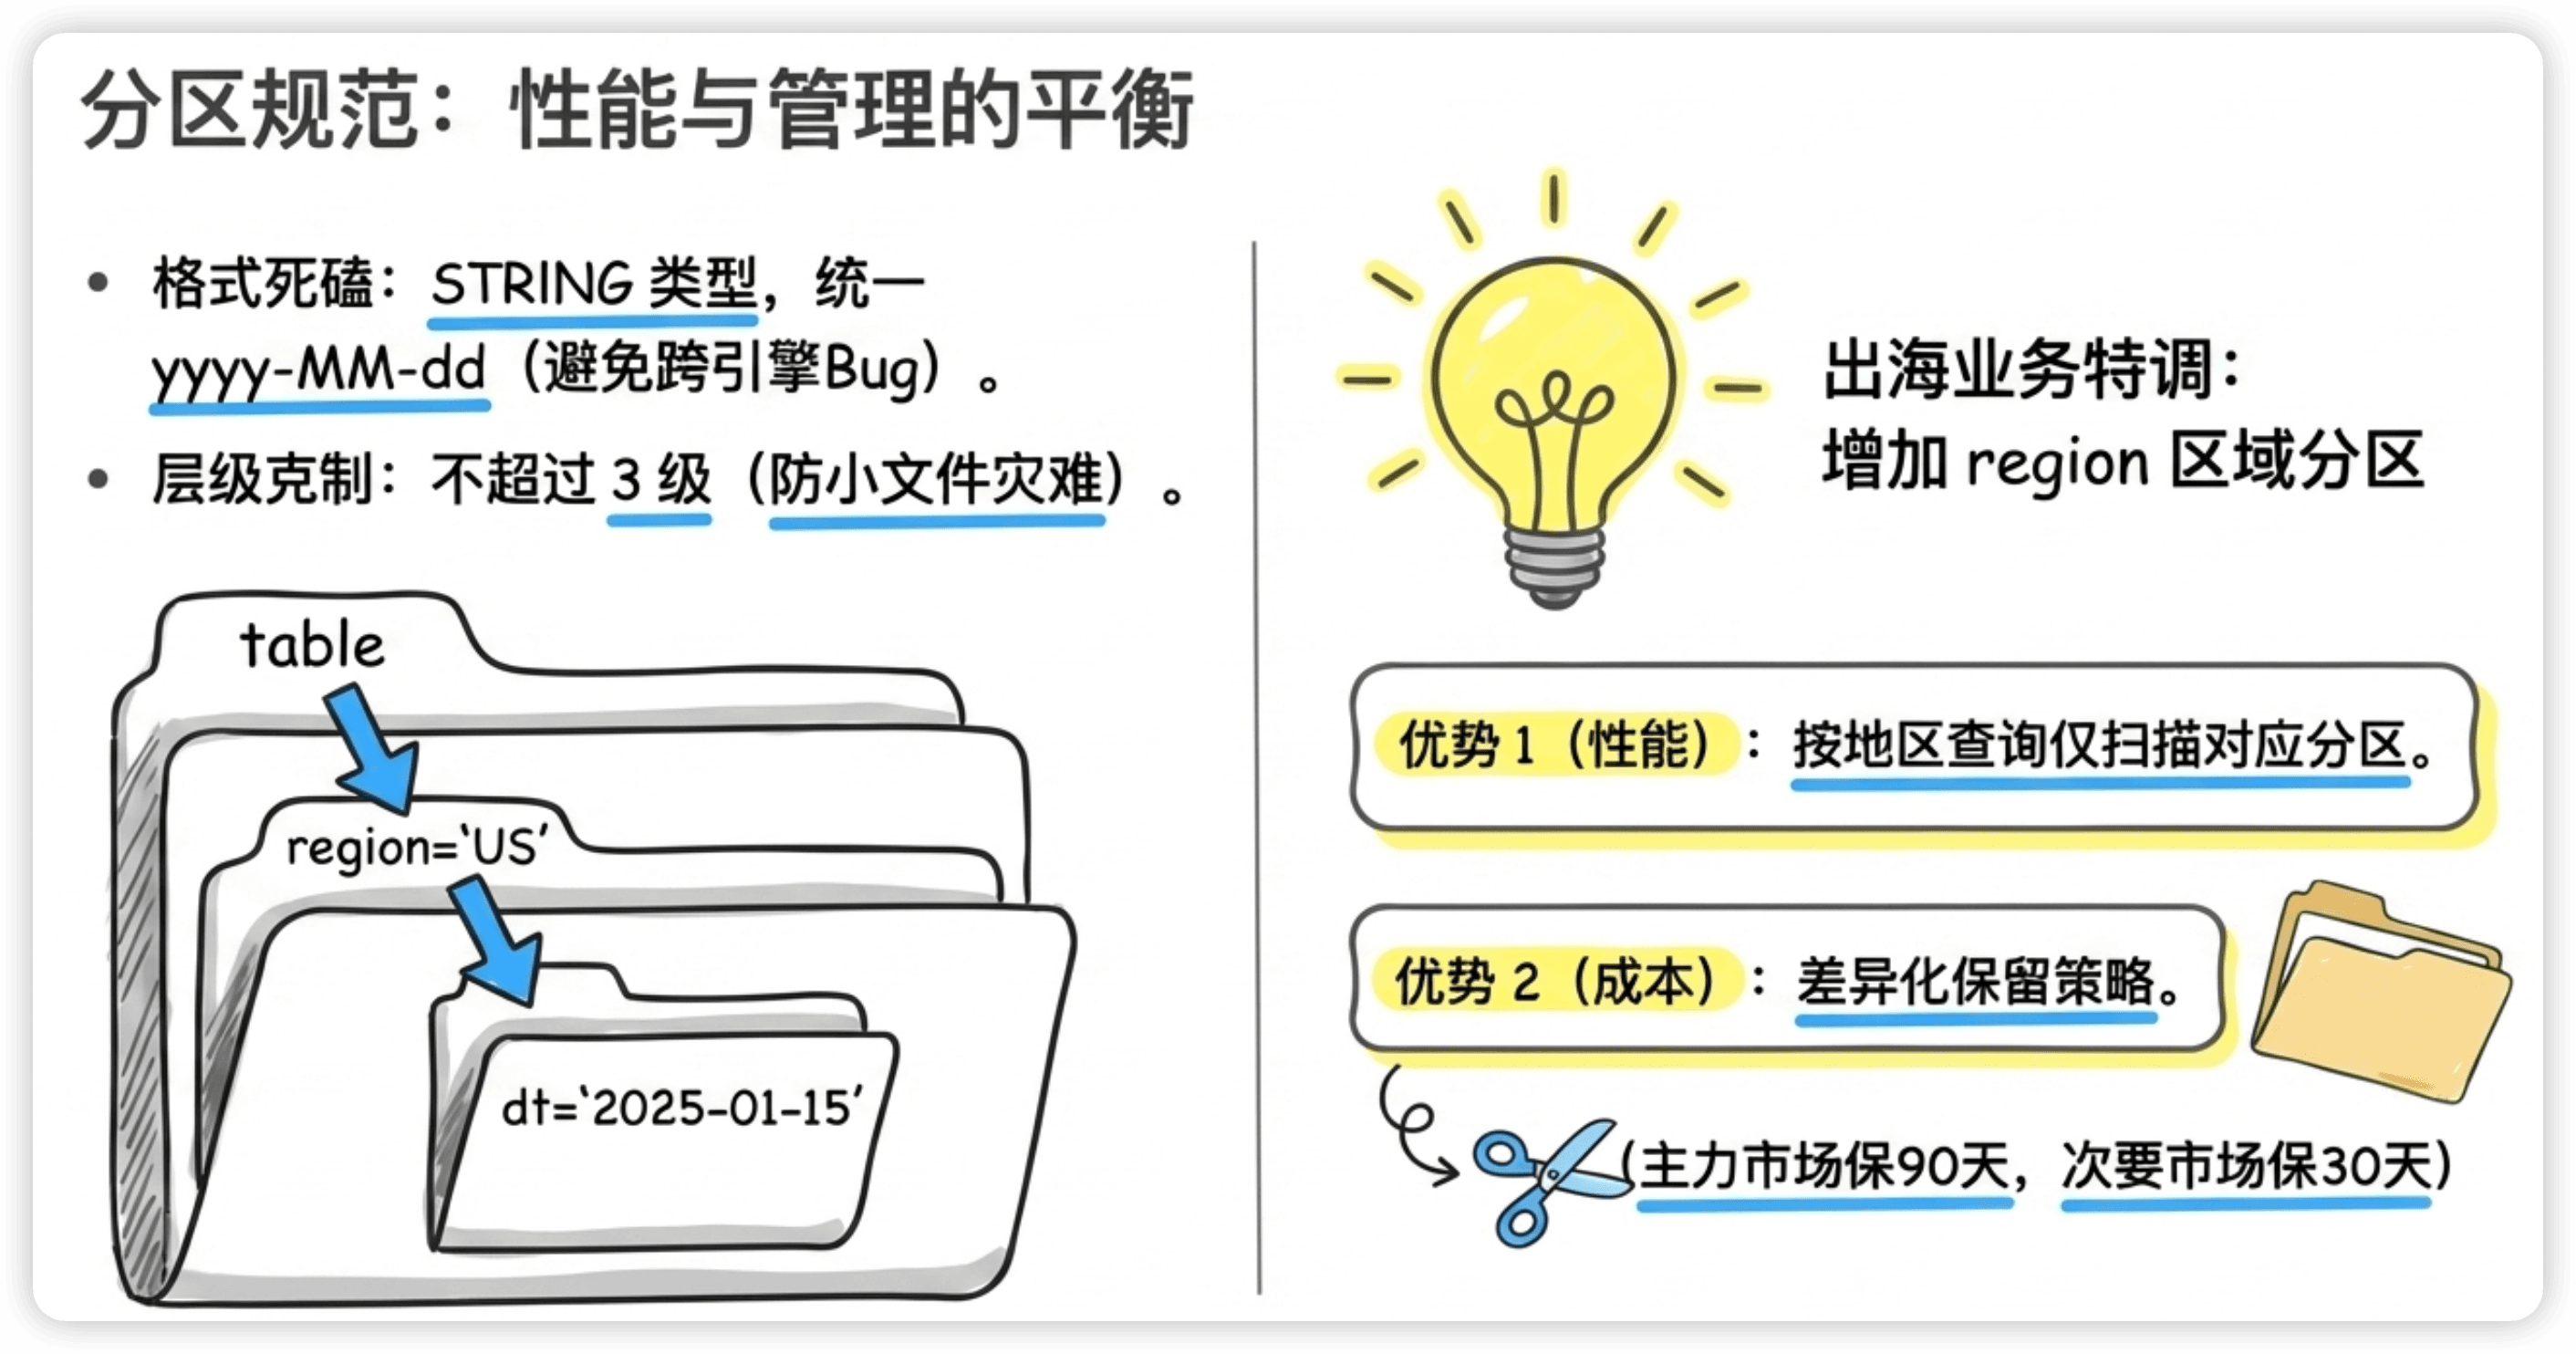
我们出海业务加了
region分区,好处很多:一是按地区查询时只扫描对应分区,性能好;二是不同地区的数据保留策略不一样(主要市场保留90天,次要市场保留30天),有分区就很好处理。
分区的注意事项:
- 分区字段统一用STRING类型,不要用DATE/INT,避免跨引擎兼容问题
- 日期格式统一用
yyyy-MM-dd,不要有的表用20250115有的用2025-01-15 - 分区层级不要超过3级,太深了管理成本高、小文件问题也会加剧
怎么让规范落地?
定规范是最简单的部分。让200多张存量表和一个5人团队都遵守规范,才是真正的挑战。我的经验分三步:
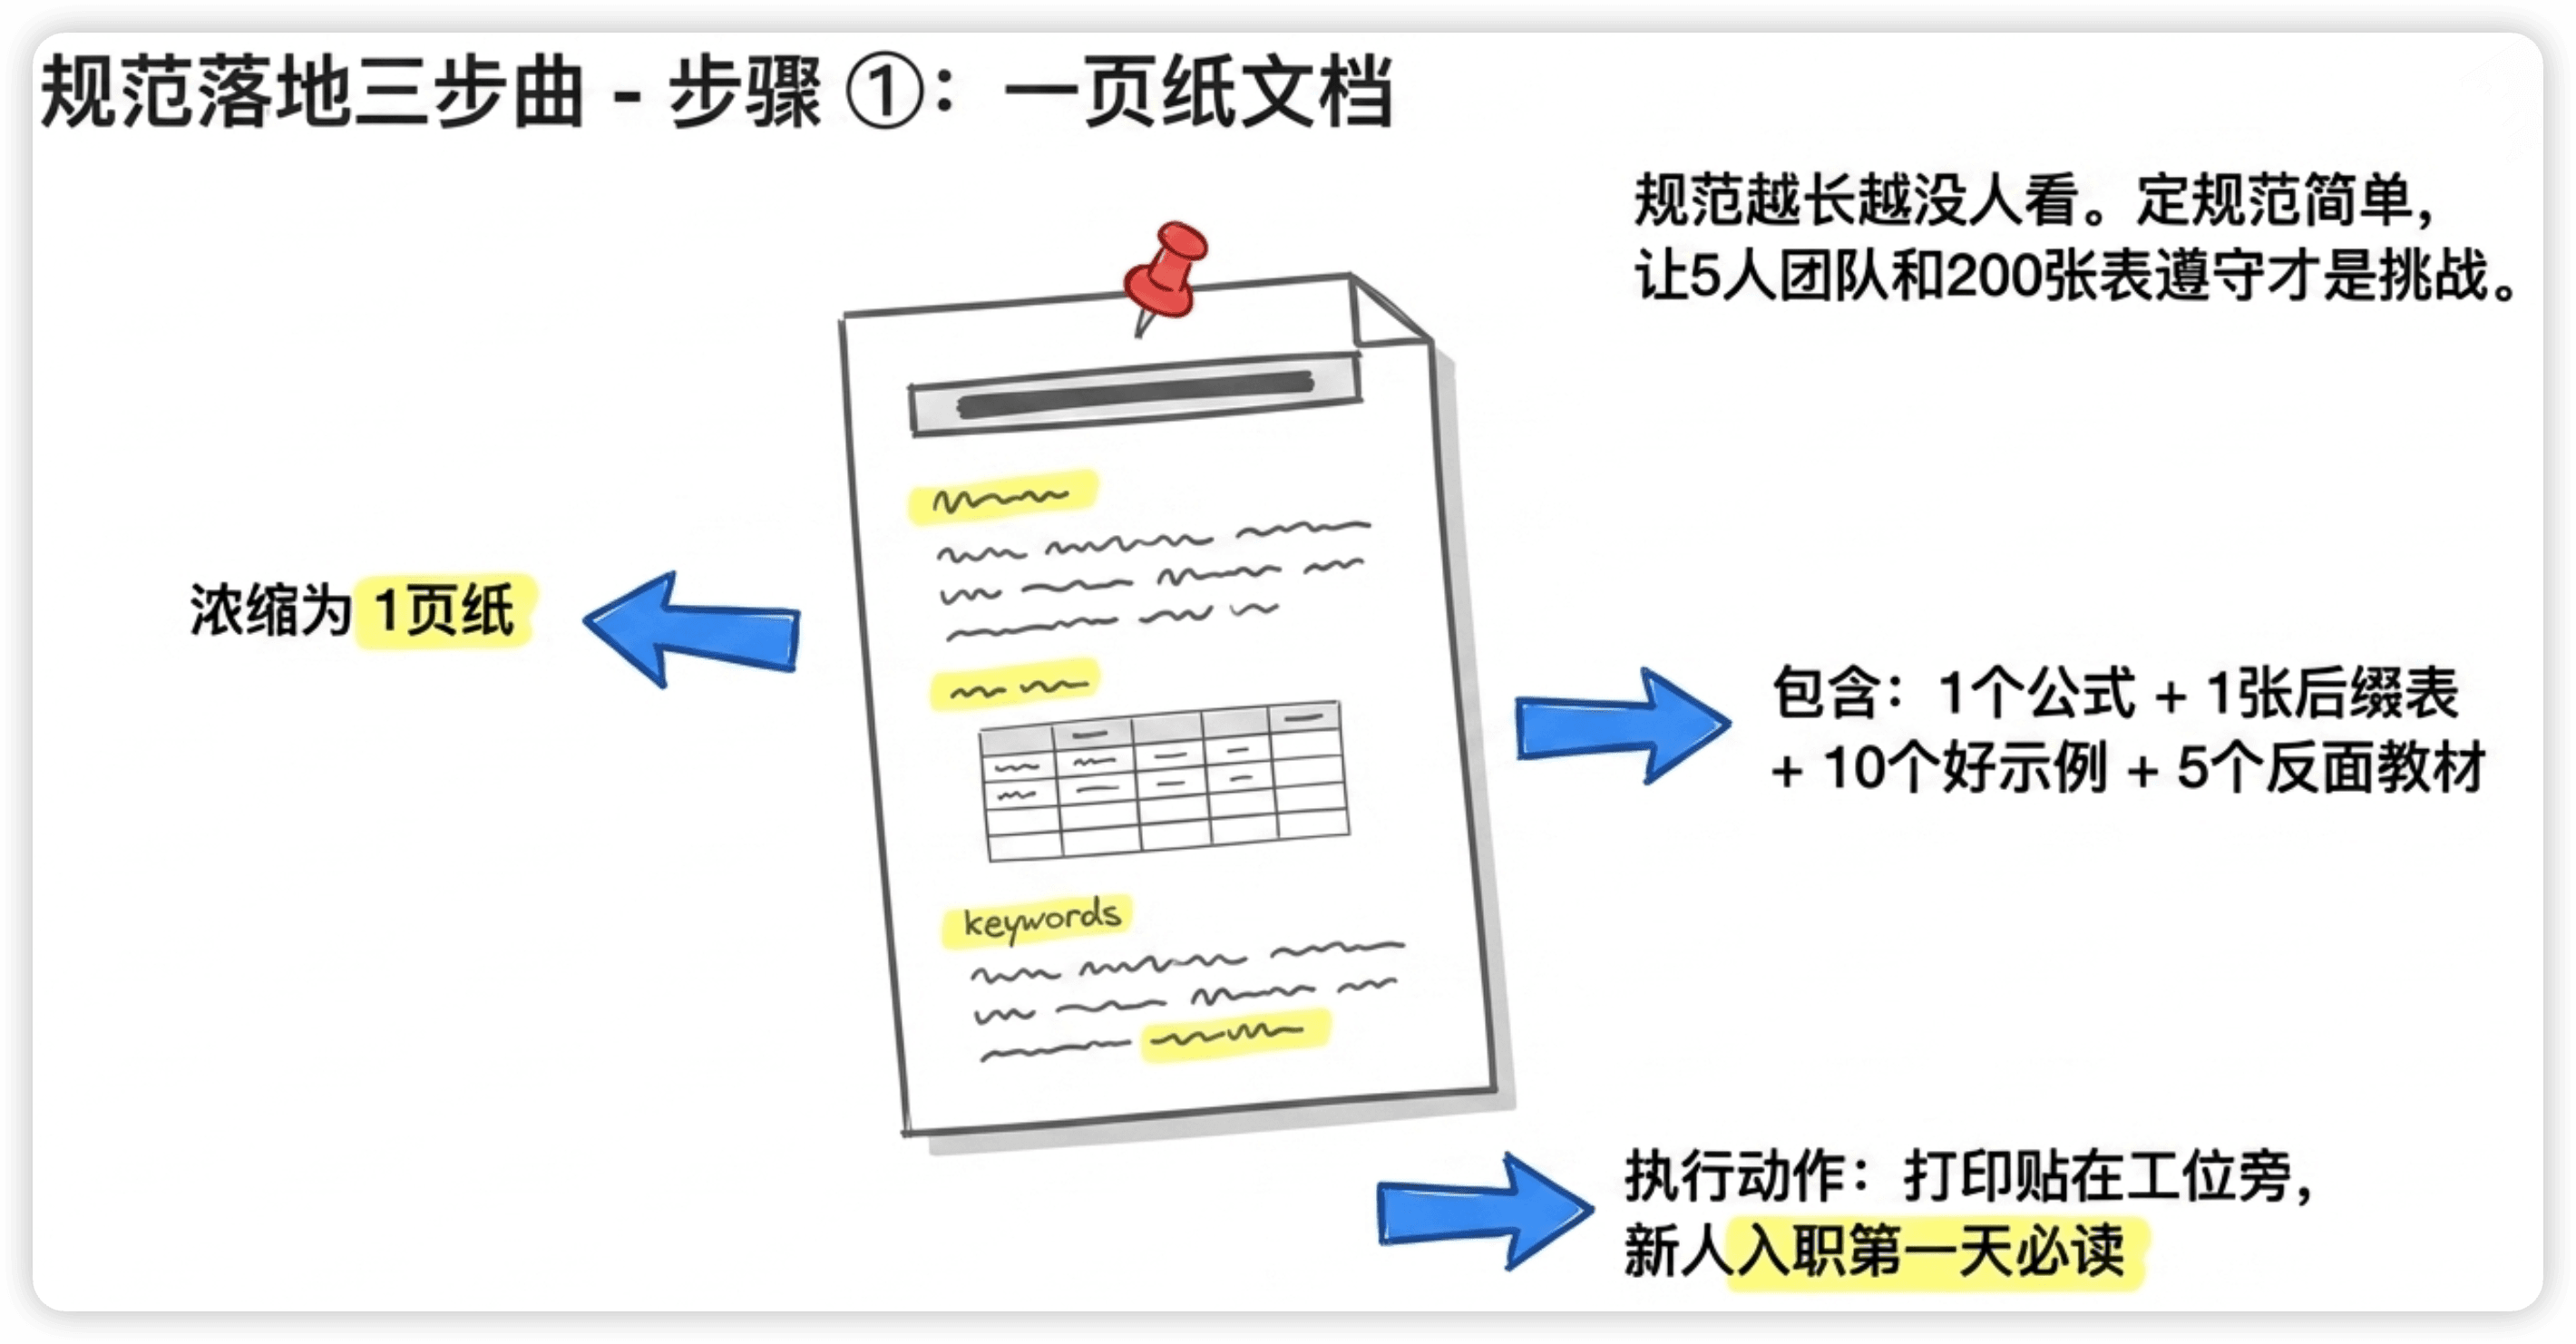
第一步:写成一页纸文档
规范文档不用写得很长——越长越没人看。一页纸的表格+10个命名示例就够了。打印出来贴在工位旁边,新人入职第一天读。
核心内容:表名公式 + 字段命名约定表 + 10个好示例 + 5个反面教材。
第二步:建表审批卡控
光靠文档和自觉是不够的,要用技术手段"卡住"。
# 建表时的命名校验(简化示例)
import re

VALID_LAYERS = ['ods', 'dwd', 'dws', 'ads', 'dim', 'tmp']
VALID_DOMAINS = ['trade', 'user', 'ad', 'content', 'finance', 'log']
VALID_GRANULARITY = ['di', 'df', '1d', '1h', '7d', '30d', 'rt']

def validate_table_name(table_name):
    parts = table_name.split('_')

    # 检查层级前缀
    if parts[0] not in VALID_LAYERS:
        return f"❌ 层级'{parts[0]}'不在允许列表中: {VALID_LAYERS}"

    # 检查业务域(dim和tmp可以跳过业务域)
    if parts[0] not in ['dim', 'tmp'] and parts[1] not in VALID_DOMAINS:
        return f"❌ 业务域'{parts[1]}'不在允许列表中: {VALID_DOMAINS}"

    # 检查时间粒度后缀
    if parts[-1] not in VALID_GRANULARITY:
        return f"⚠️ 时间粒度'{parts[-1]}'不在标准列表中,请确认是否有意为之"

    # 检查是否全小写
    if table_name != table_name.lower():
        return "❌ 表名必须全部小写"

    return "✅ 命名规范检查通过"

# 在DataWorks/Airflow的建表钩子里调用
print(validate_table_name("dws_trade_user_pay_1d"))    # ✅
print(validate_table_name("User_Pay_Summary"))          # ❌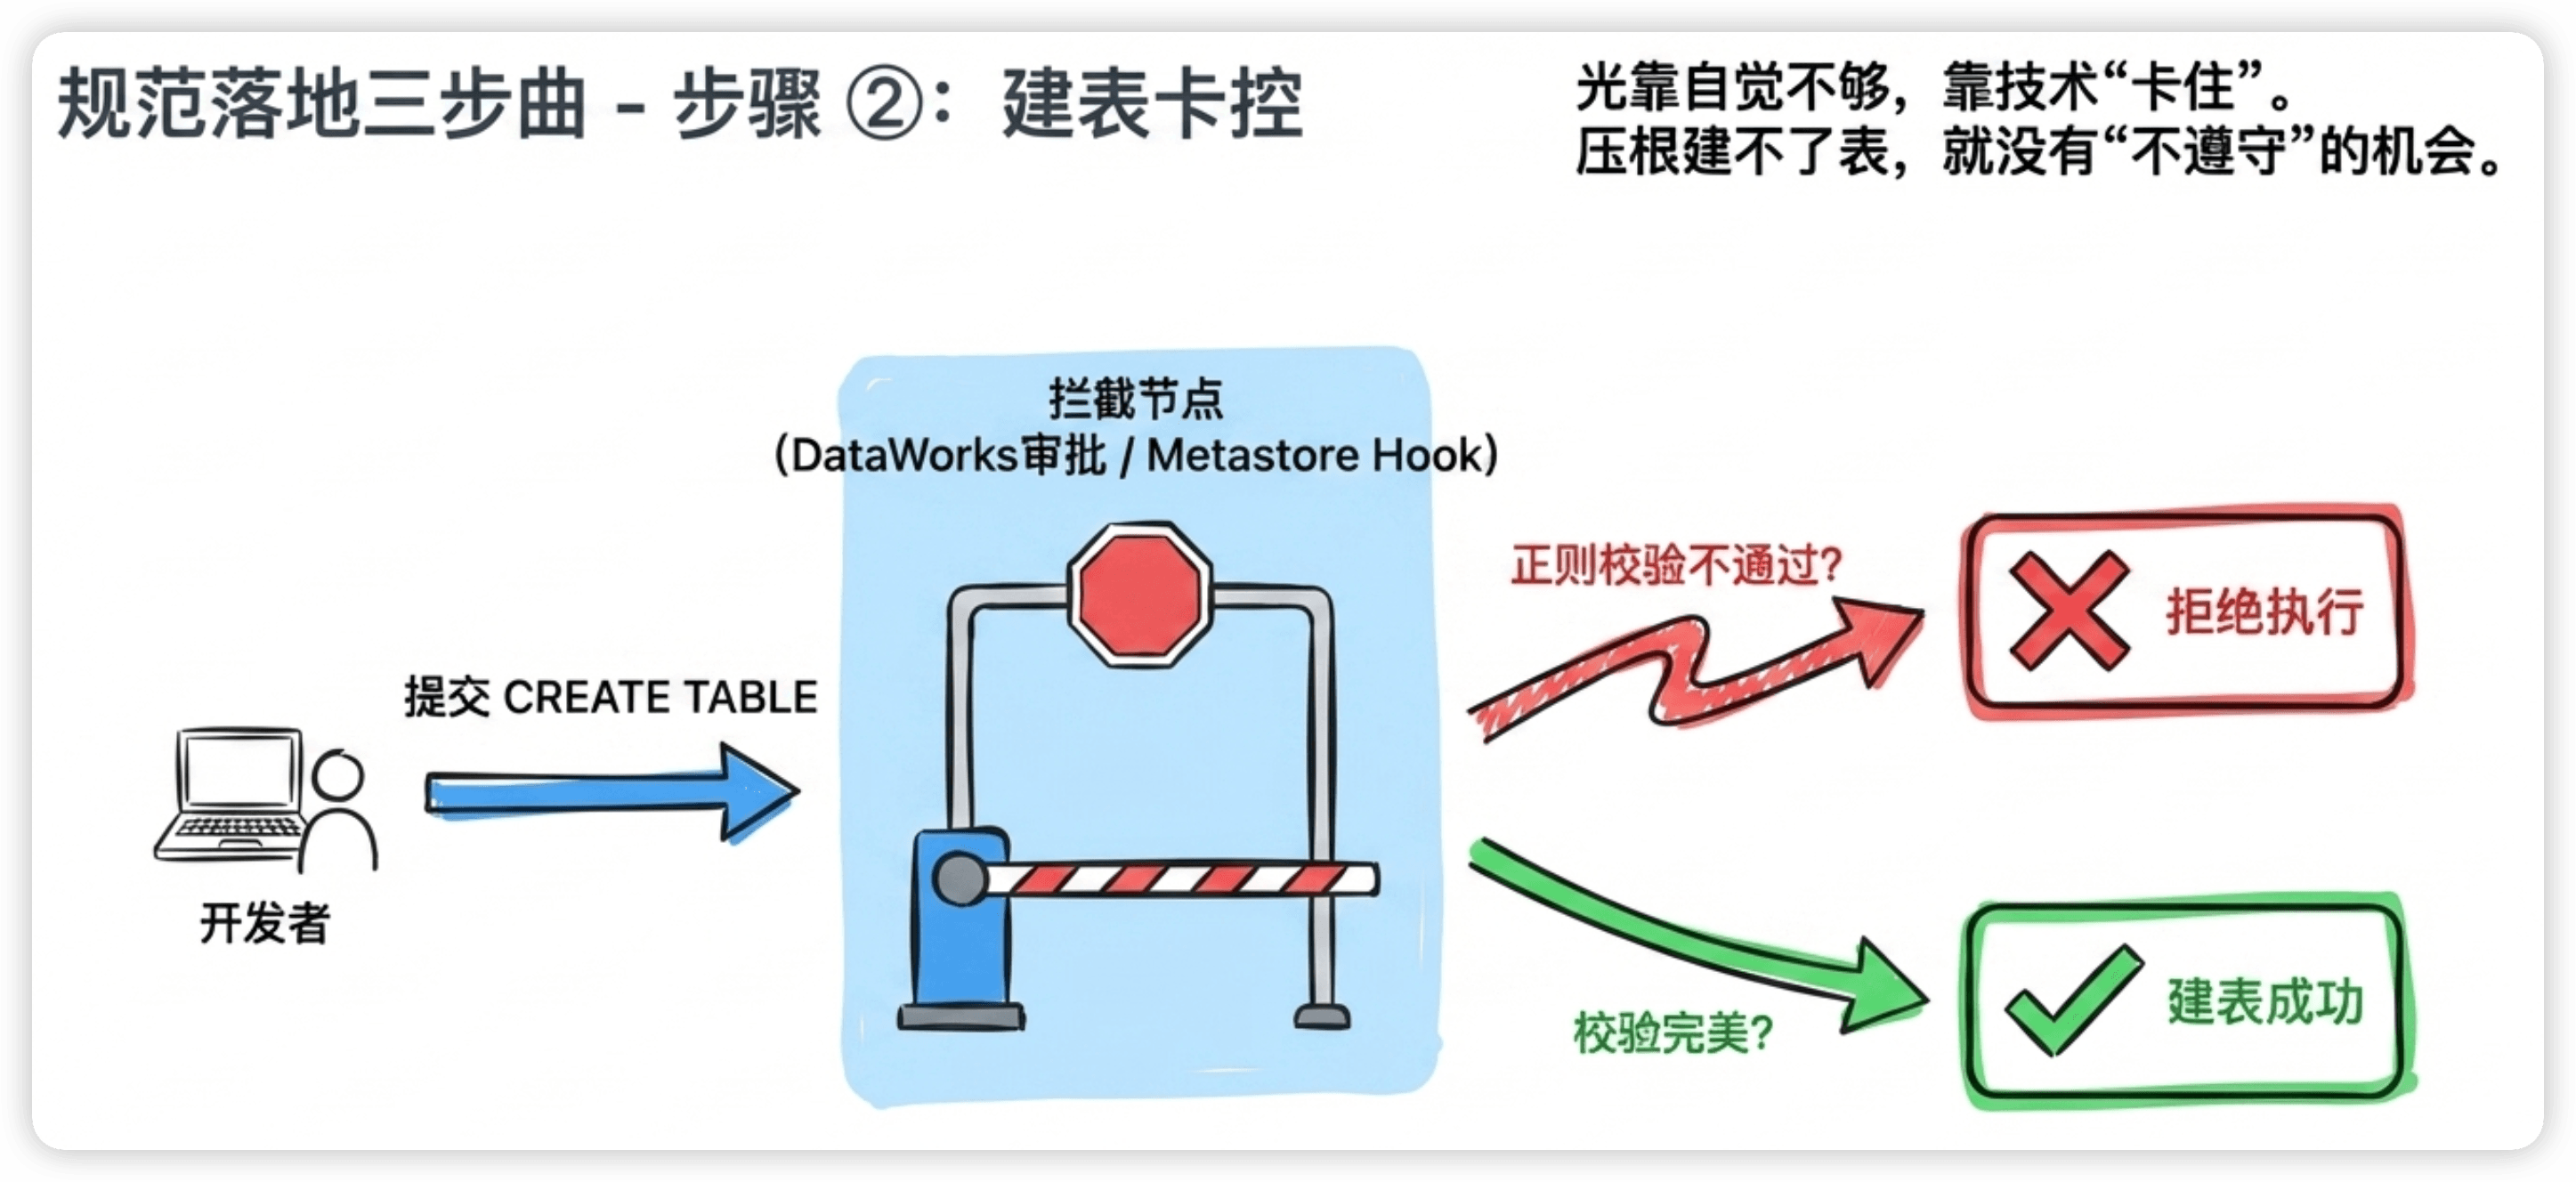
这个校验可以做成DataWorks的建表审批节点,也可以做成Hive Metastore的Hook。不符合规范的建表请求直接拒绝,从源头卡住。
第三步:存量表逐步迁移
200张存量表不能一刀切改名——下游报表、调度依赖都会断。正确的做法是渐进式迁移:
1. 新建规范命名的表(如 dws_trade_user_pay_1d)
2. 把数据从旧表迁移到新表
3. 旧表加 COMMENT '⚠️ DEPRECATED: 请改用 dws_trade_user_pay_1d'
4. 通知下游逐步切换到新表
5. 观察1-2周,确认旧表无人使用后下线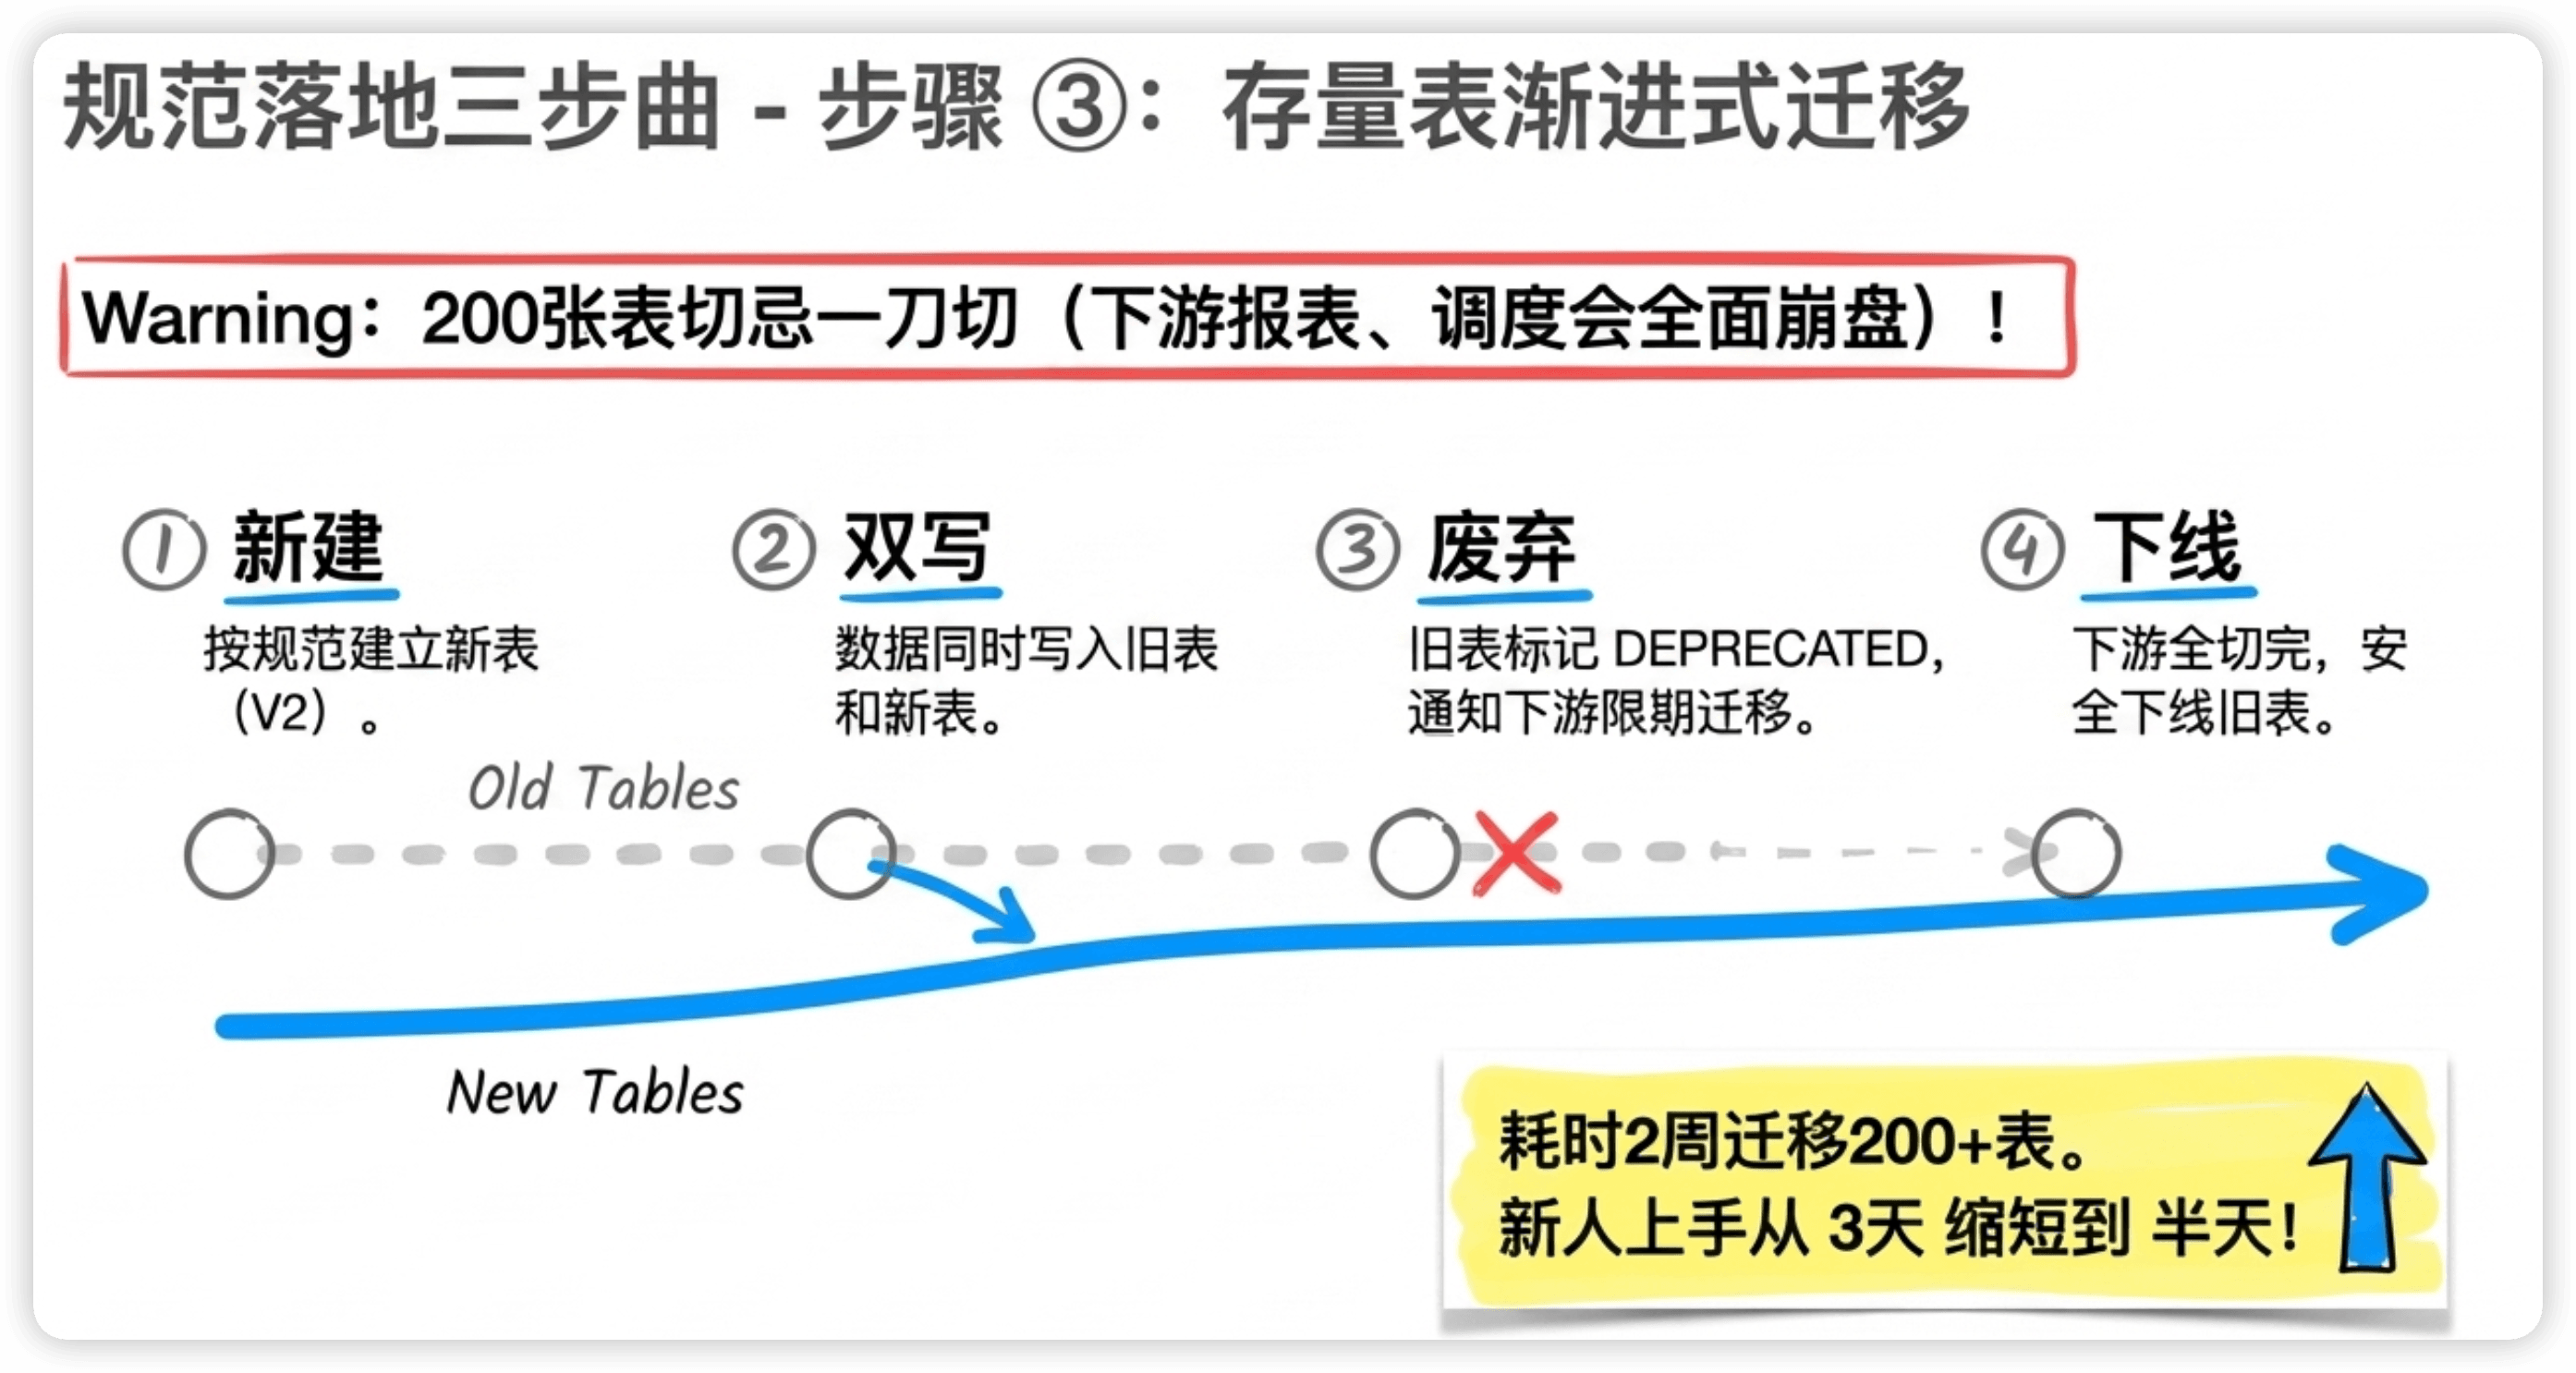
我花了两周时间完成了200多张表的迁移。过程确实痛苦,但之后的维护效率提升非常明显——新人上手时间从3天缩短到半天,排查问题时找表的时间从"翻半天"变成"看表名就知道"。
面试怎么答?
高分回答
「我接手数据组时,200多张表命名风格不统一,很多没注释。我做了三件事:第一,参考Kimball体系定了一套命名规范——层级_业务域_实体_描述_时间粒度,比如
dws_trade_user_pay_1d,一看就知道是什么;第二,在建表流程里加了命名校验,不符合正则的直接拒绝建表;第三,花了两周把存量表逐步迁移到新命名,用DEPRECATED标记过渡,等下游全切完再下线旧表。迁移后新人上手时间明显缩短,团队协作效率也提升了。」
追问防线
追问1:命名规范和元数据管理是什么关系?
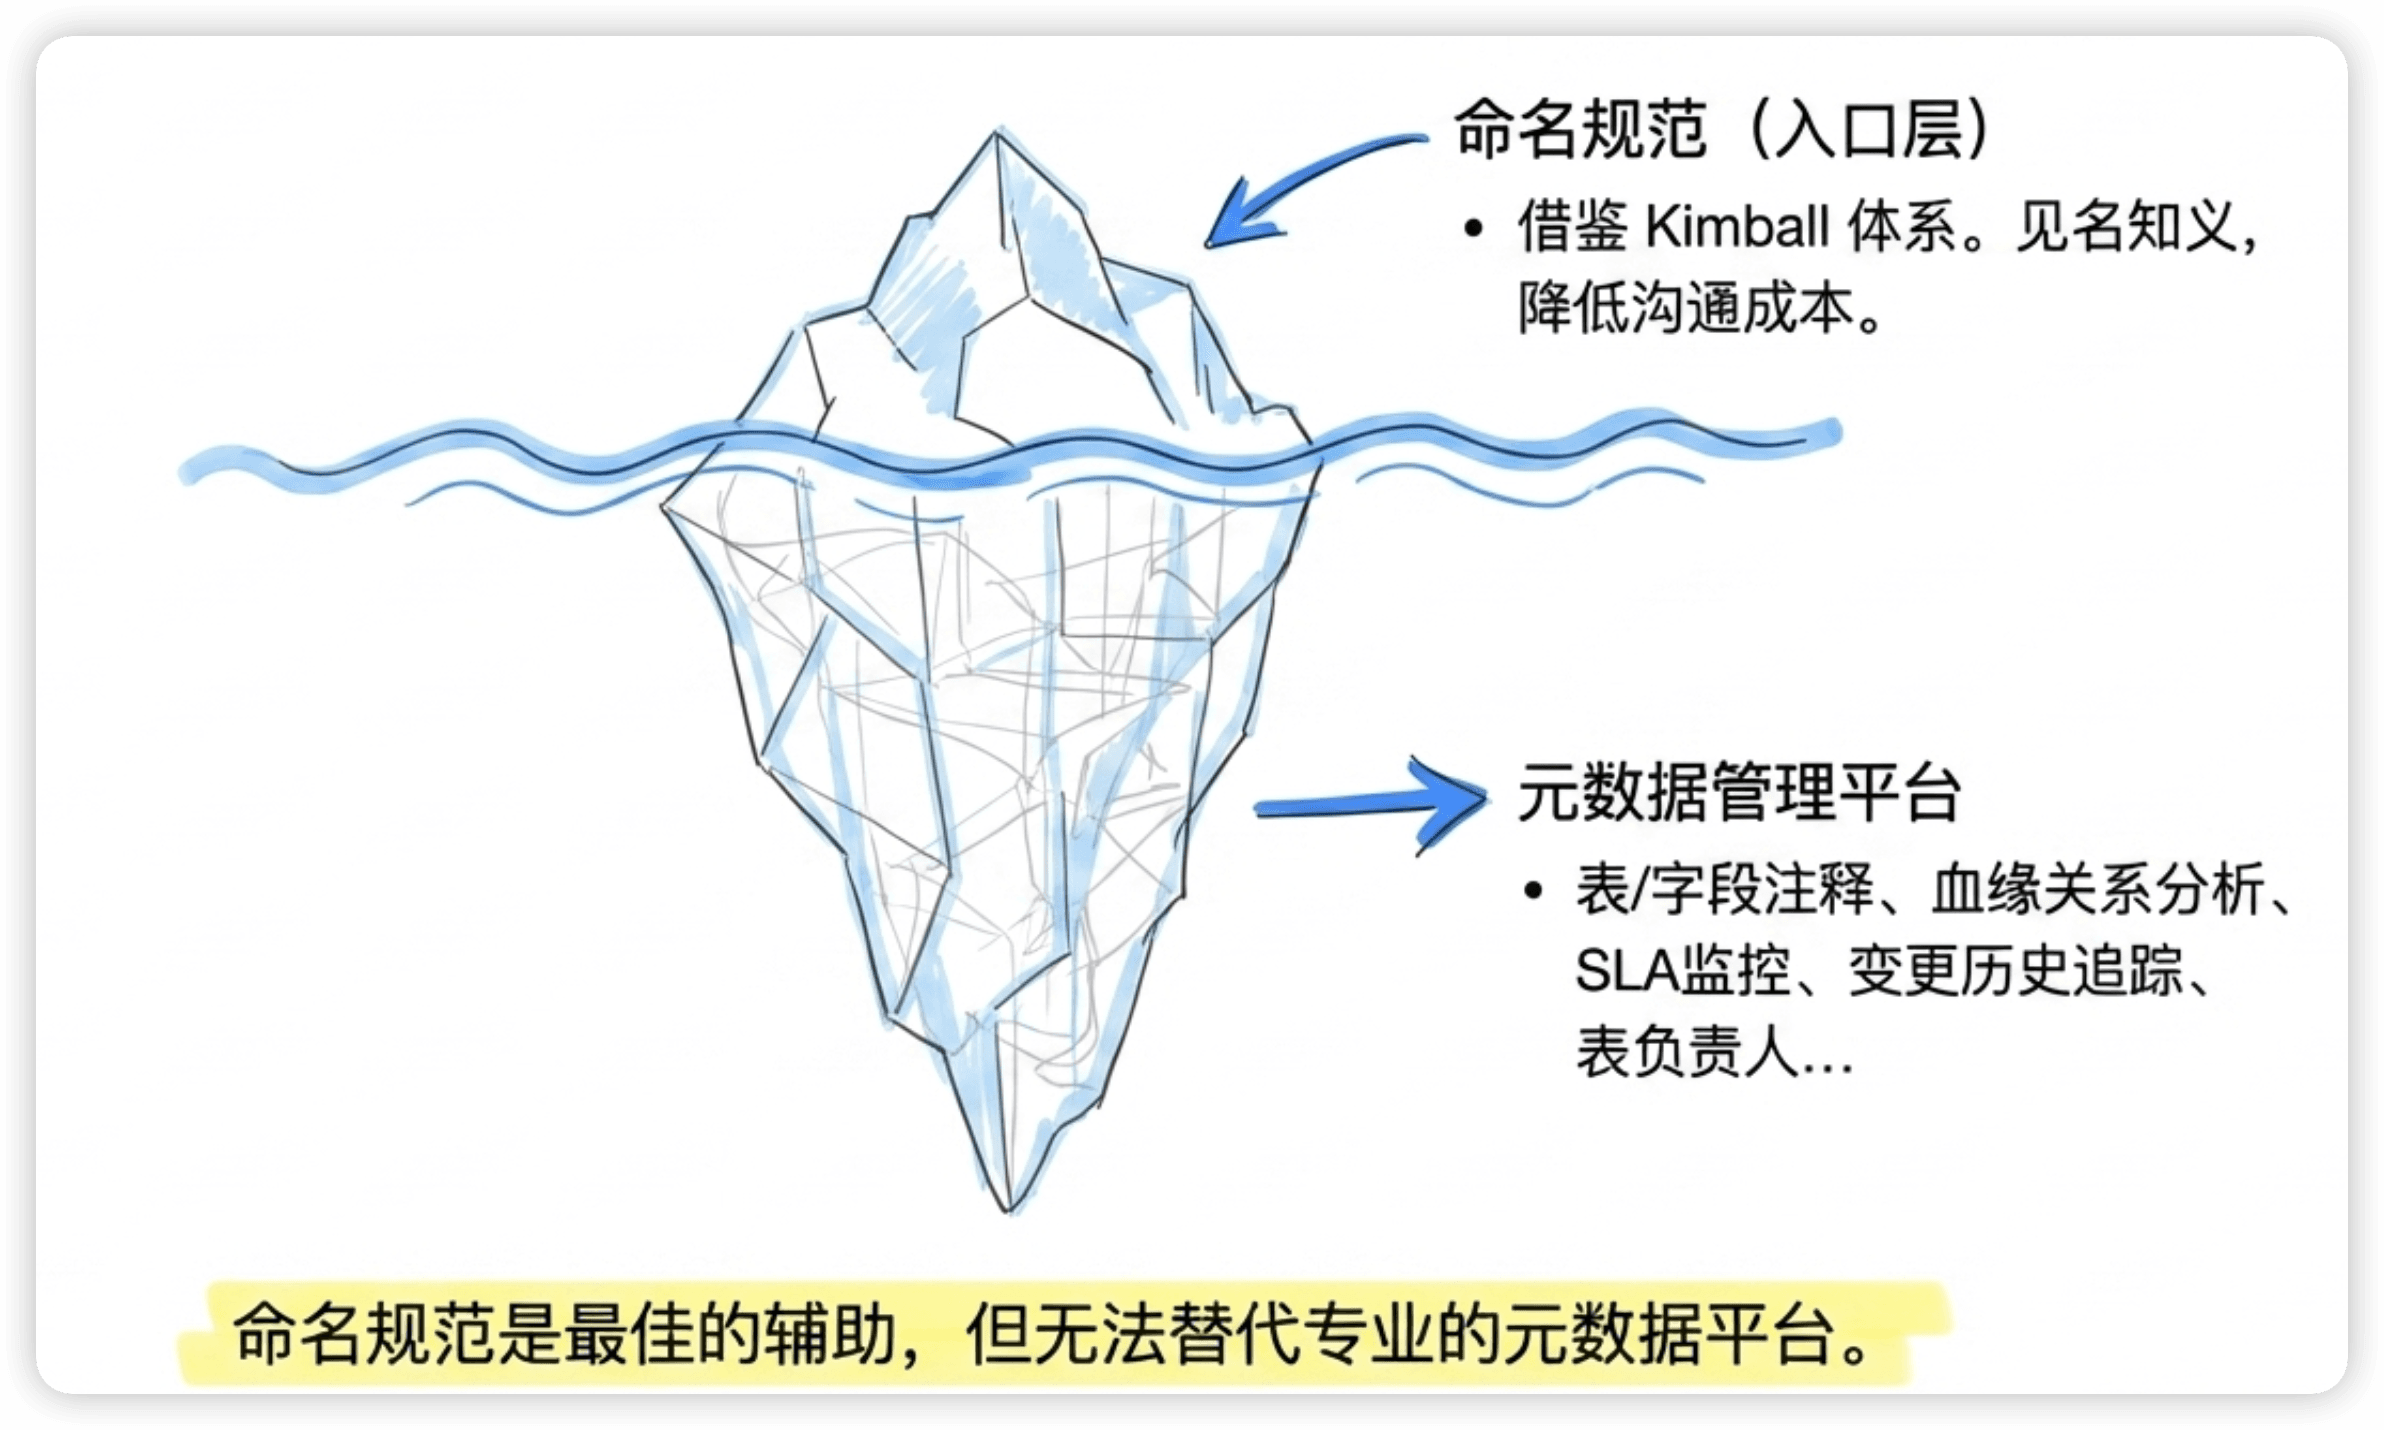
命名规范是元数据管理的一部分。完整的元数据管理还包括表注释、字段注释、数据血缘、表的负责人和SLA等。命名规范相当于元数据的"入口层"——名字起好了,很多信息不用查元数据系统就能获取。
但命名规范不能替代元数据管理。表的上下游关系、数据质量指标、变更历史这些信息不可能塞进表名里,还是需要专门的元数据平台来管理。
追问2:团队里有人不遵守规范怎么办?
两个层面。技术层面,用建表校验卡住——不符合规范的压根建不了表,没有"不遵守"的机会。管理层面,在Code Review环节检查SQL里引用的表名和字段名是否规范,这是一个很好的培养习惯的机会。
关键心态:规范不是给人添麻烦,而是减少沟通成本。一旦团队体会到了规范带来的效率提升,自觉遵守就不是问题了。
追问3:tmp临时表怎么管理?
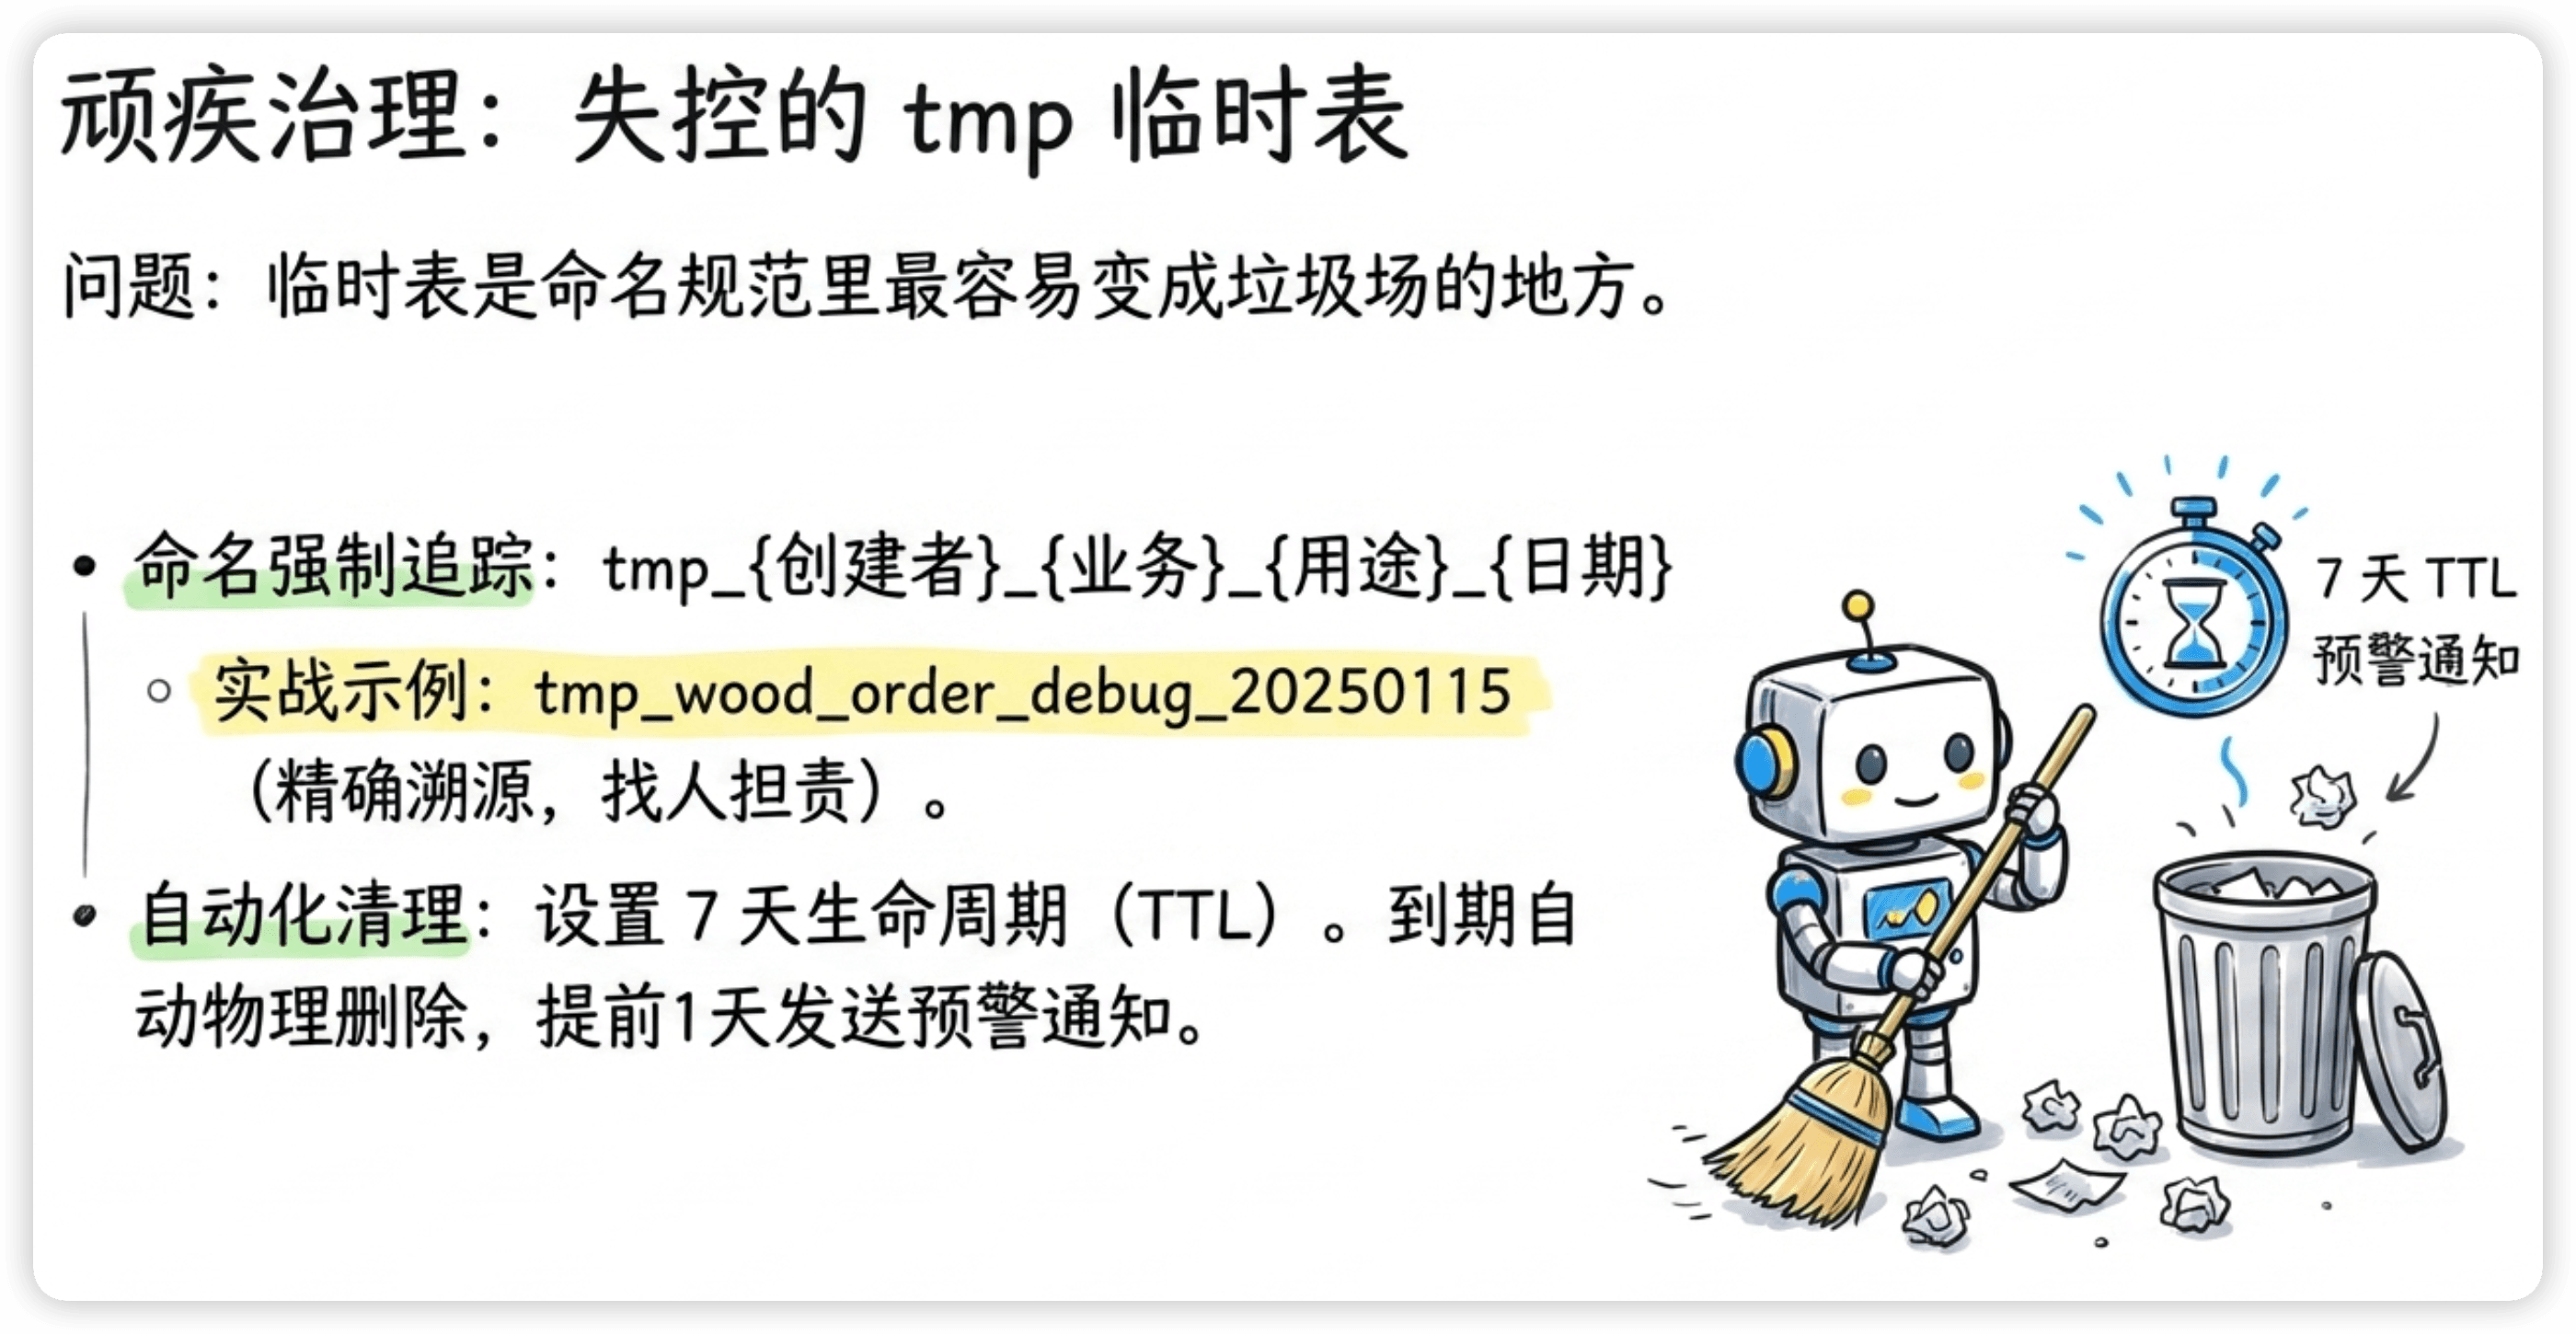
临时表是命名规范里最容易失控的部分。我们的做法是:tmp表必须在名字里加上创建者和日期——tmp_wood_order_debug_20250115,方便追溯。另外设置一个自动清理机制,超过7天的tmp表自动删除(会提前一天发通知)。
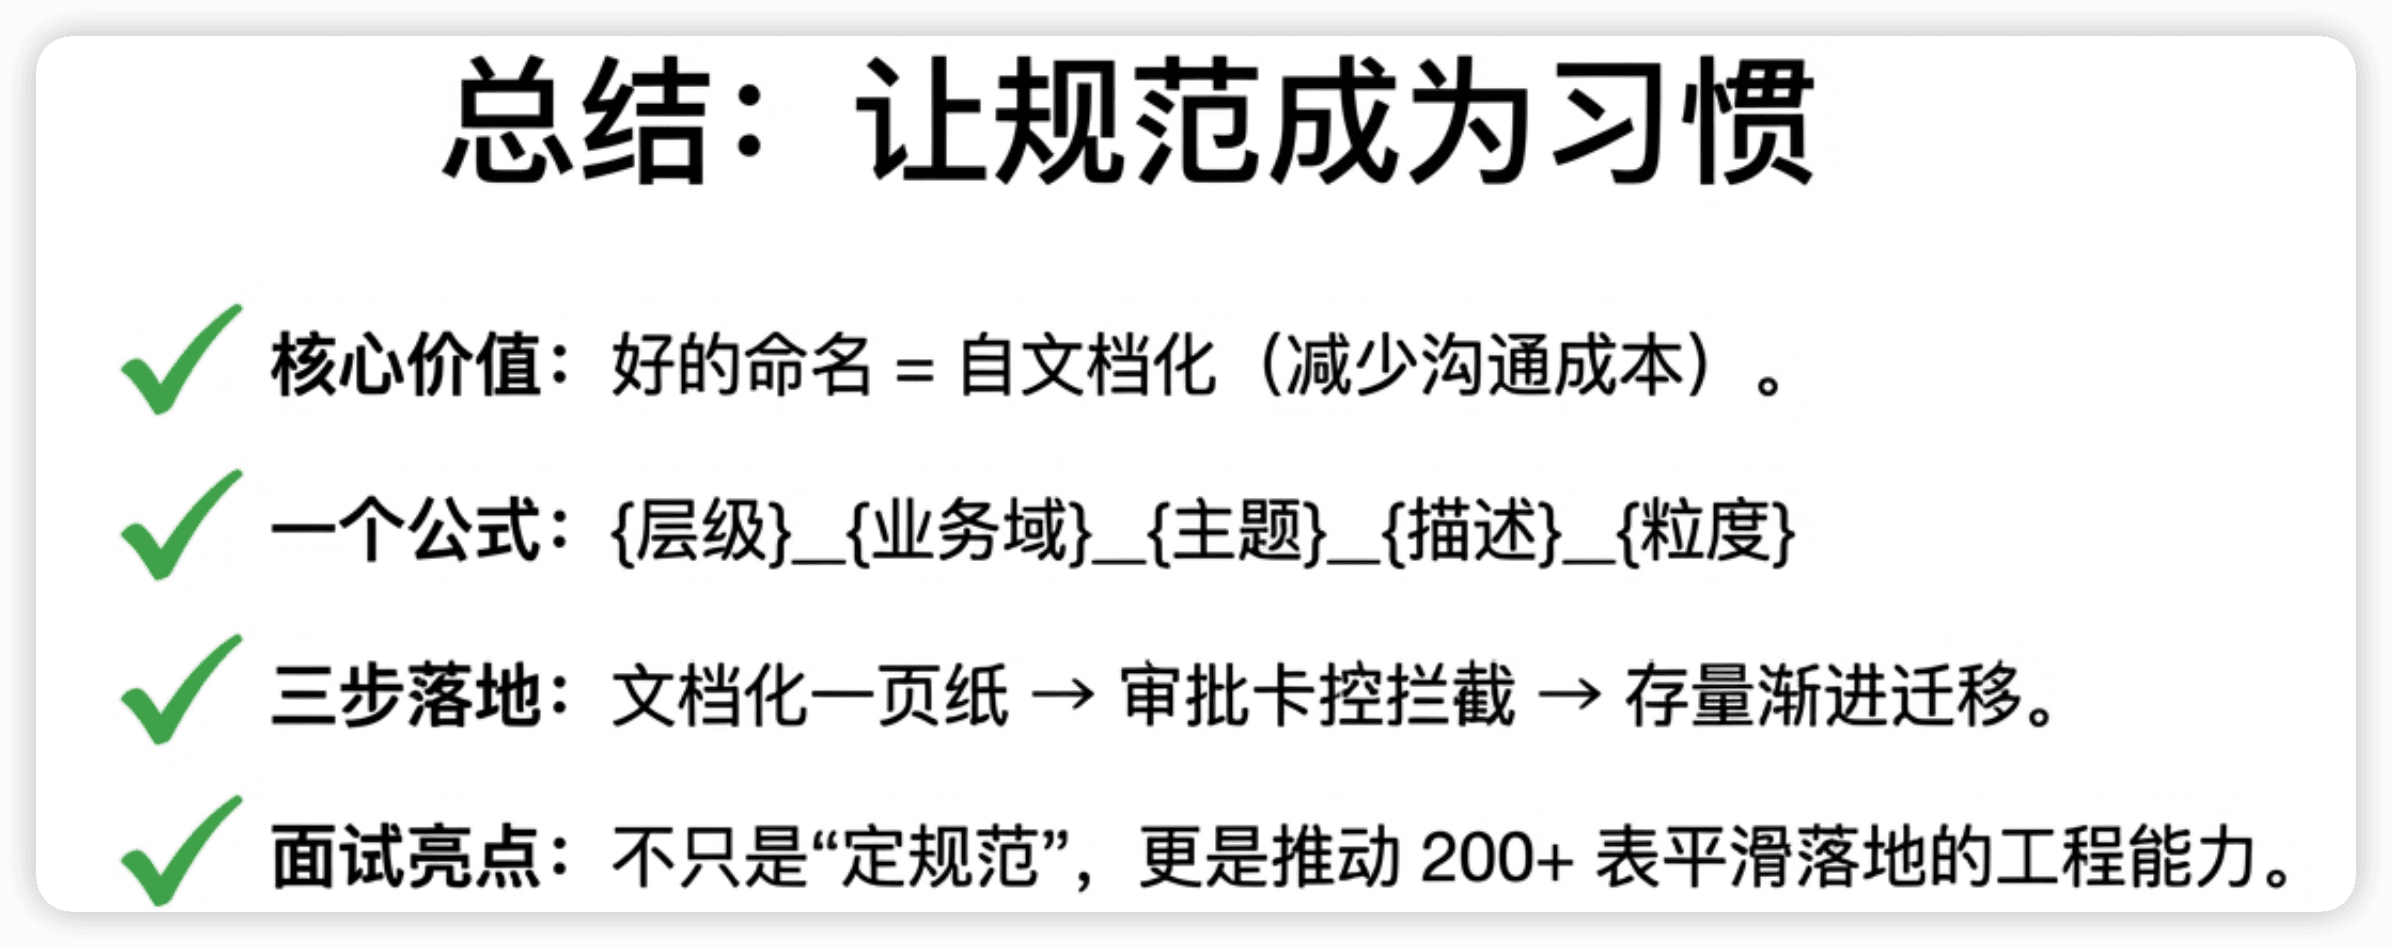
总结
- 好的命名 = 自文档化,表名本身就是文档
- 表名公式:{层级}_{业务域}_{主题}_{描述}_{时间粒度}
- 字段规则:全小写snake_case,同义全库统一,加类型后缀
- 分区规范:
dt为主分区,格式统一yyyy-MM-dd,按需加region/hour - 落地三步:文档化 → 建表卡控 → 存量迁移
- 面试加分点:不只是"定了规范",而是推动了200+表的迁移落地