数据生命周期管理
数据只增不删,存储账单只涨不降。
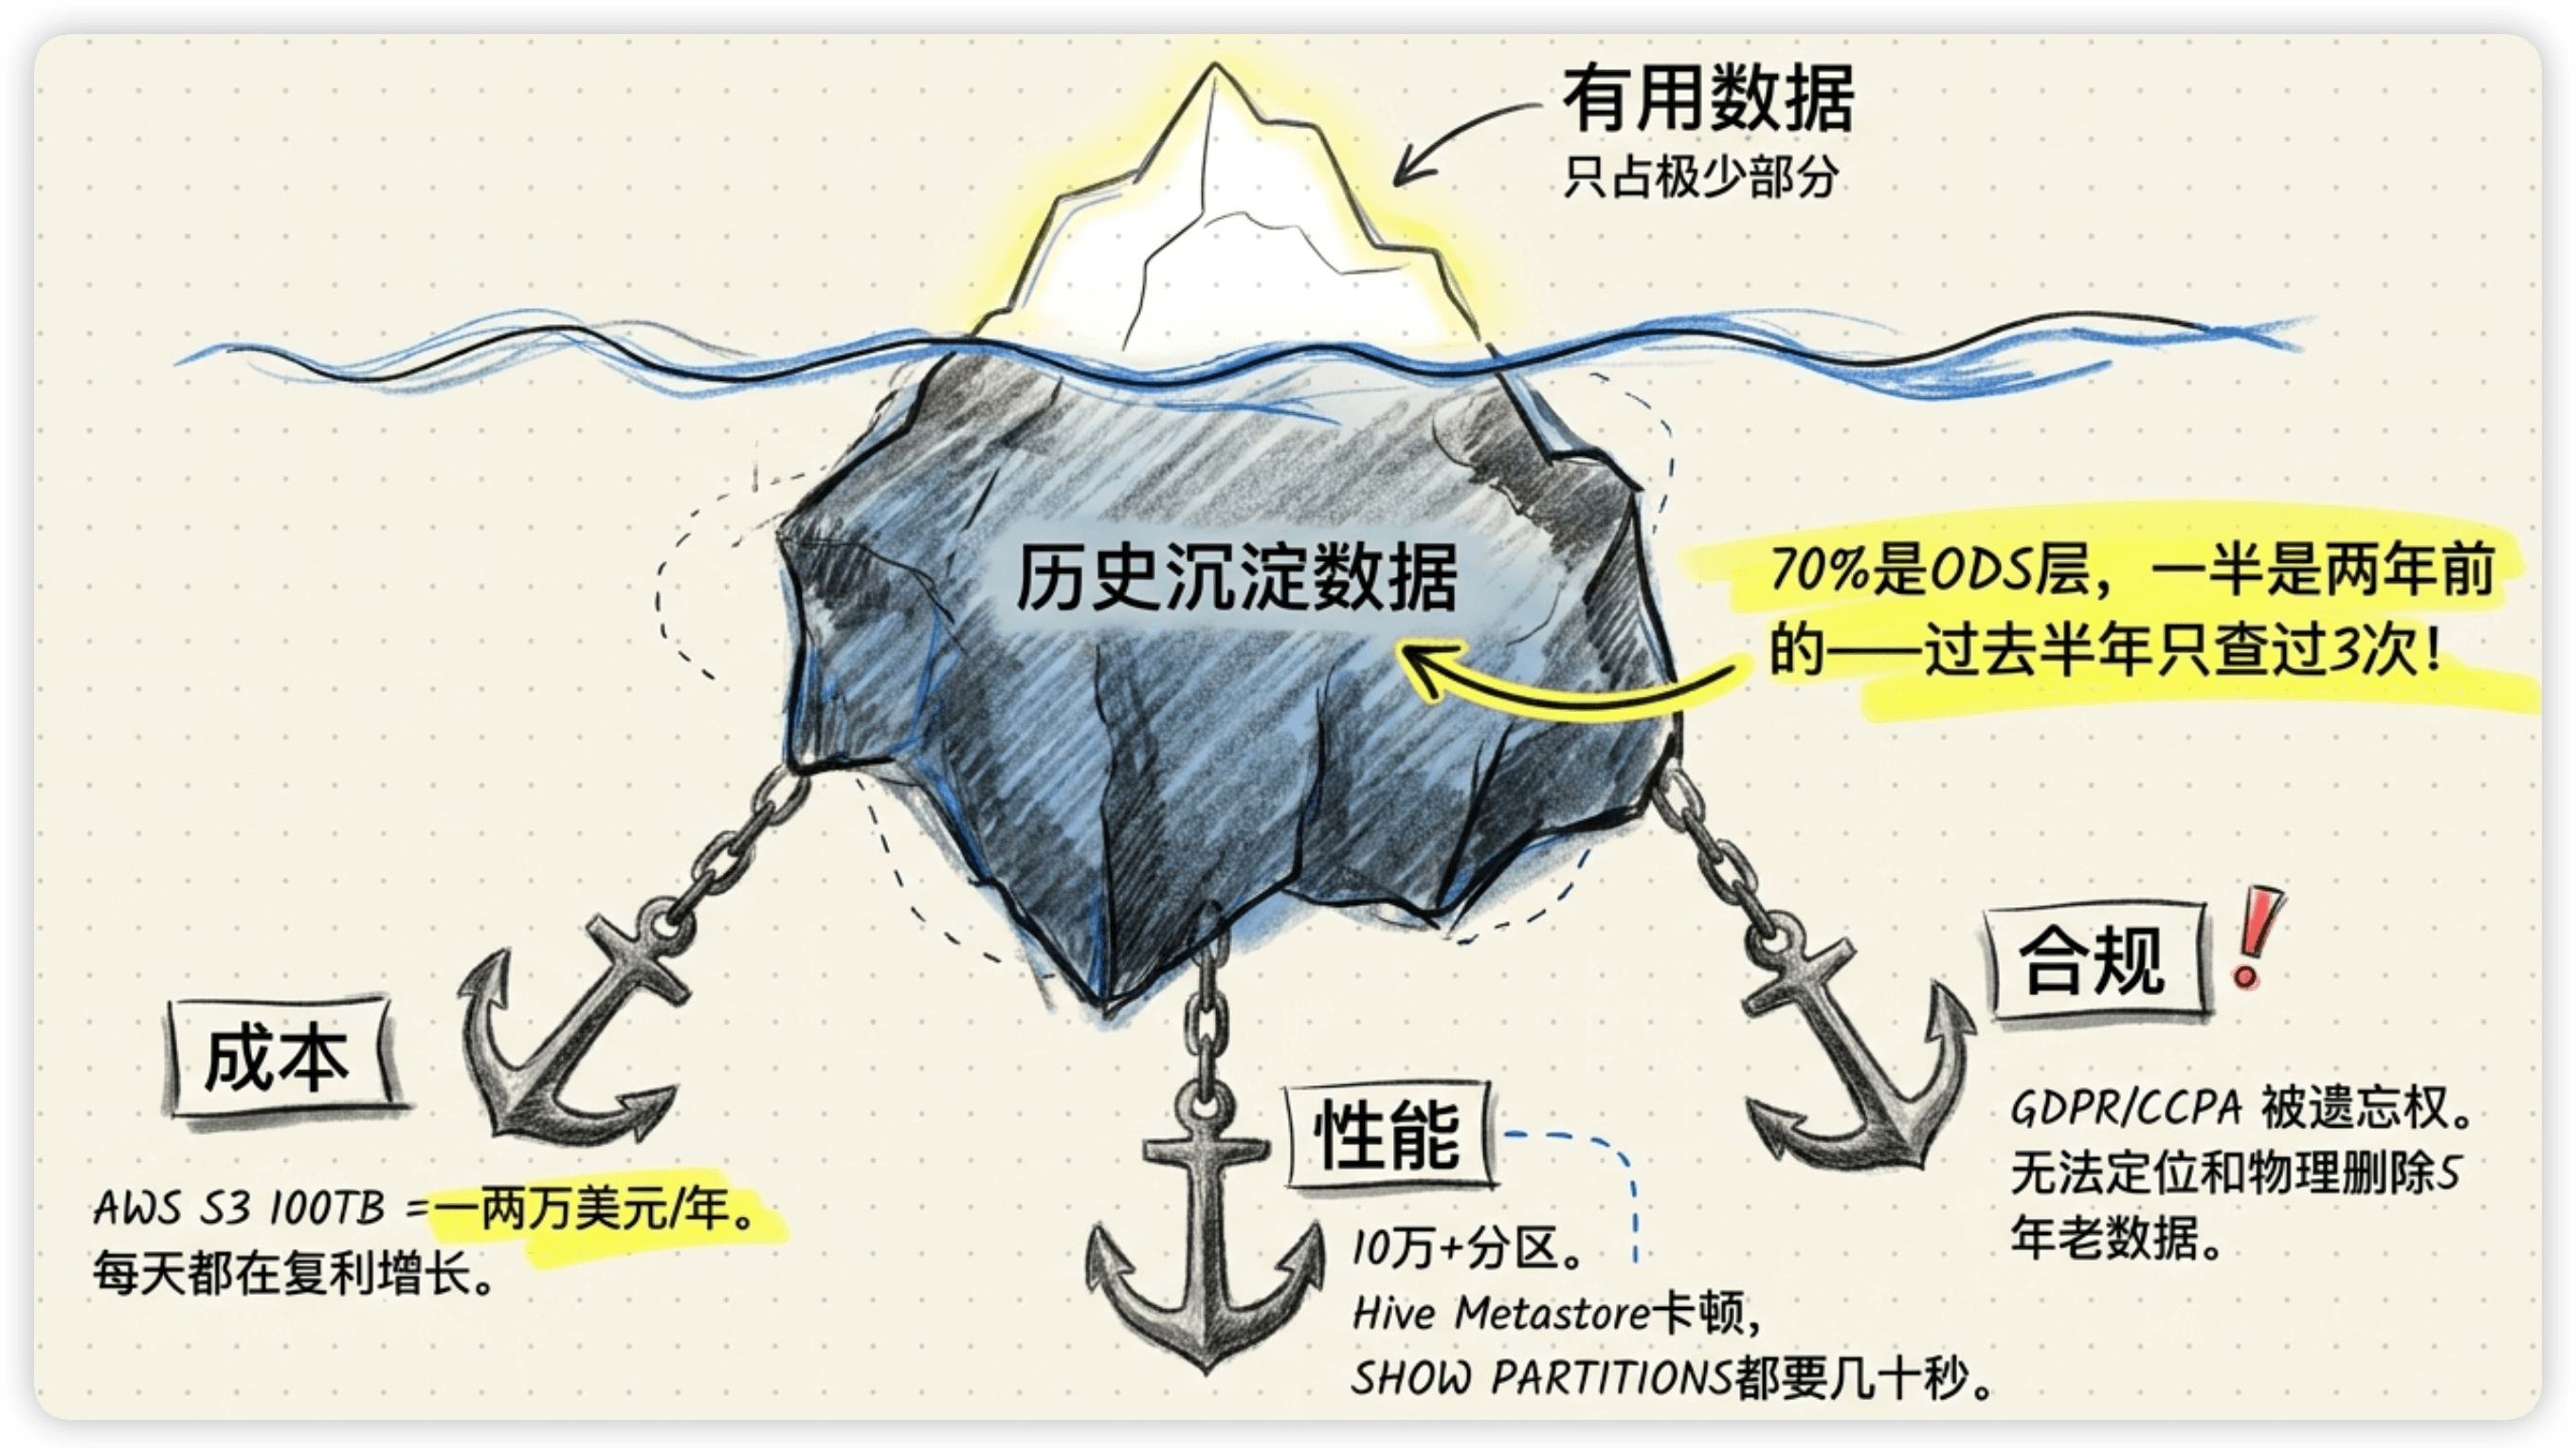
我在出海硬件品牌接手数据平台时,做的第一件事就是梳理存储占用。发现ODS层占了总存储的70%,其中两年前的数据占了一半——但过去半年这些数据只被查询过3次。每个月几万块的云存储费用,大部分花在了没人看的历史数据上。
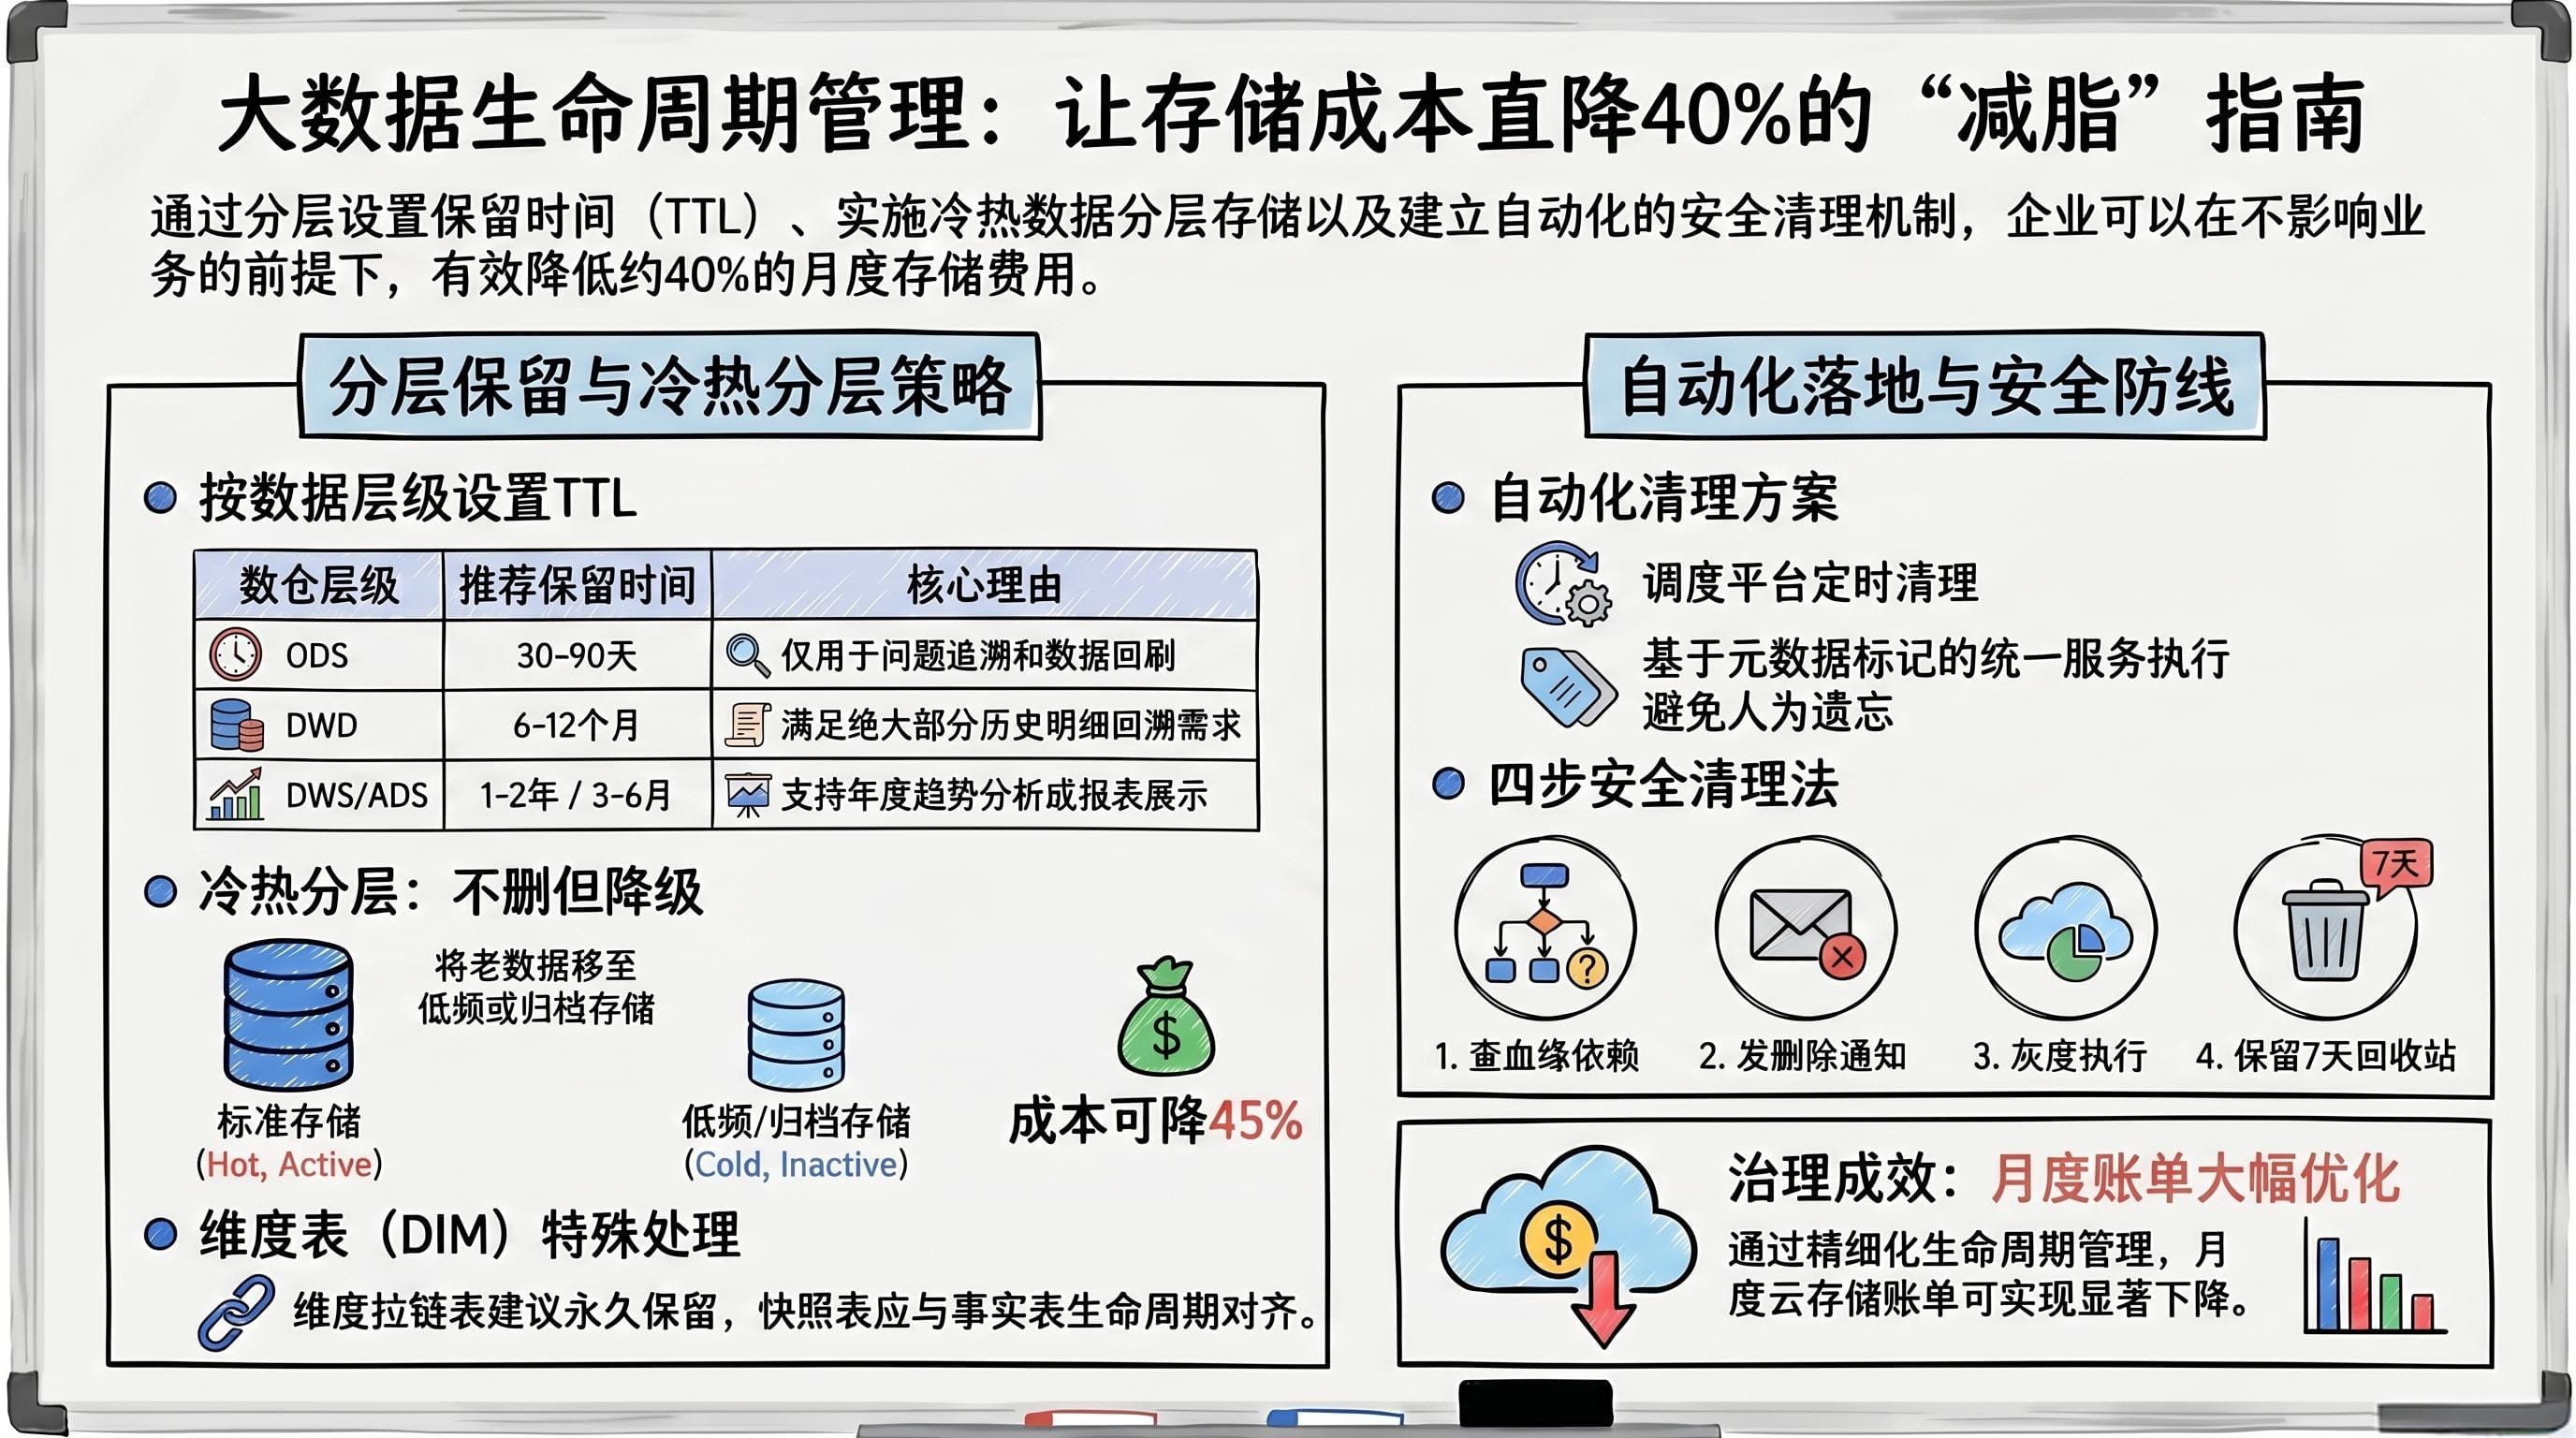
做了一轮生命周期治理之后,月度存储成本直接降了40%。
这件事让我意识到:存数据是有成本的,不是存越多越好。 数据的生命周期管理不是"高级话题",而是每个数据团队都应该做但大部分没做的基本功。
为什么要管生命周期?
成本
大数据的存储成本比很多人想象的高。以AWS S3标准存储为例,1TB/月大约23美元。听起来不多?但一个中等规模的数仓可能有50-100TB,一年就是一两万美元。如果是本地HDFS集群,硬件+运维成本更高。
而且数据是只增不减的——每天新增的数据都在累积,存储成本每天都在涨。如果不做生命周期管理,3年后存储成本可能是现在的5-10倍。
性能
数据越多,元数据越多,Hive Metastore查询分区列表越慢。表有10万个分区的时候,光是SHOW PARTITIONS就要几十秒。ETL任务启动的时候读取分区元数据也会变慢,影响整体调度效率。
合规
GDPR、CCPA等数据保护法规要求企业不能无限期保留用户个人数据。用户申请"被遗忘权"时,你需要能找到并删除相关数据。如果ODS层存了5年的明细数据,删除操作会非常复杂。
各层TTL策略
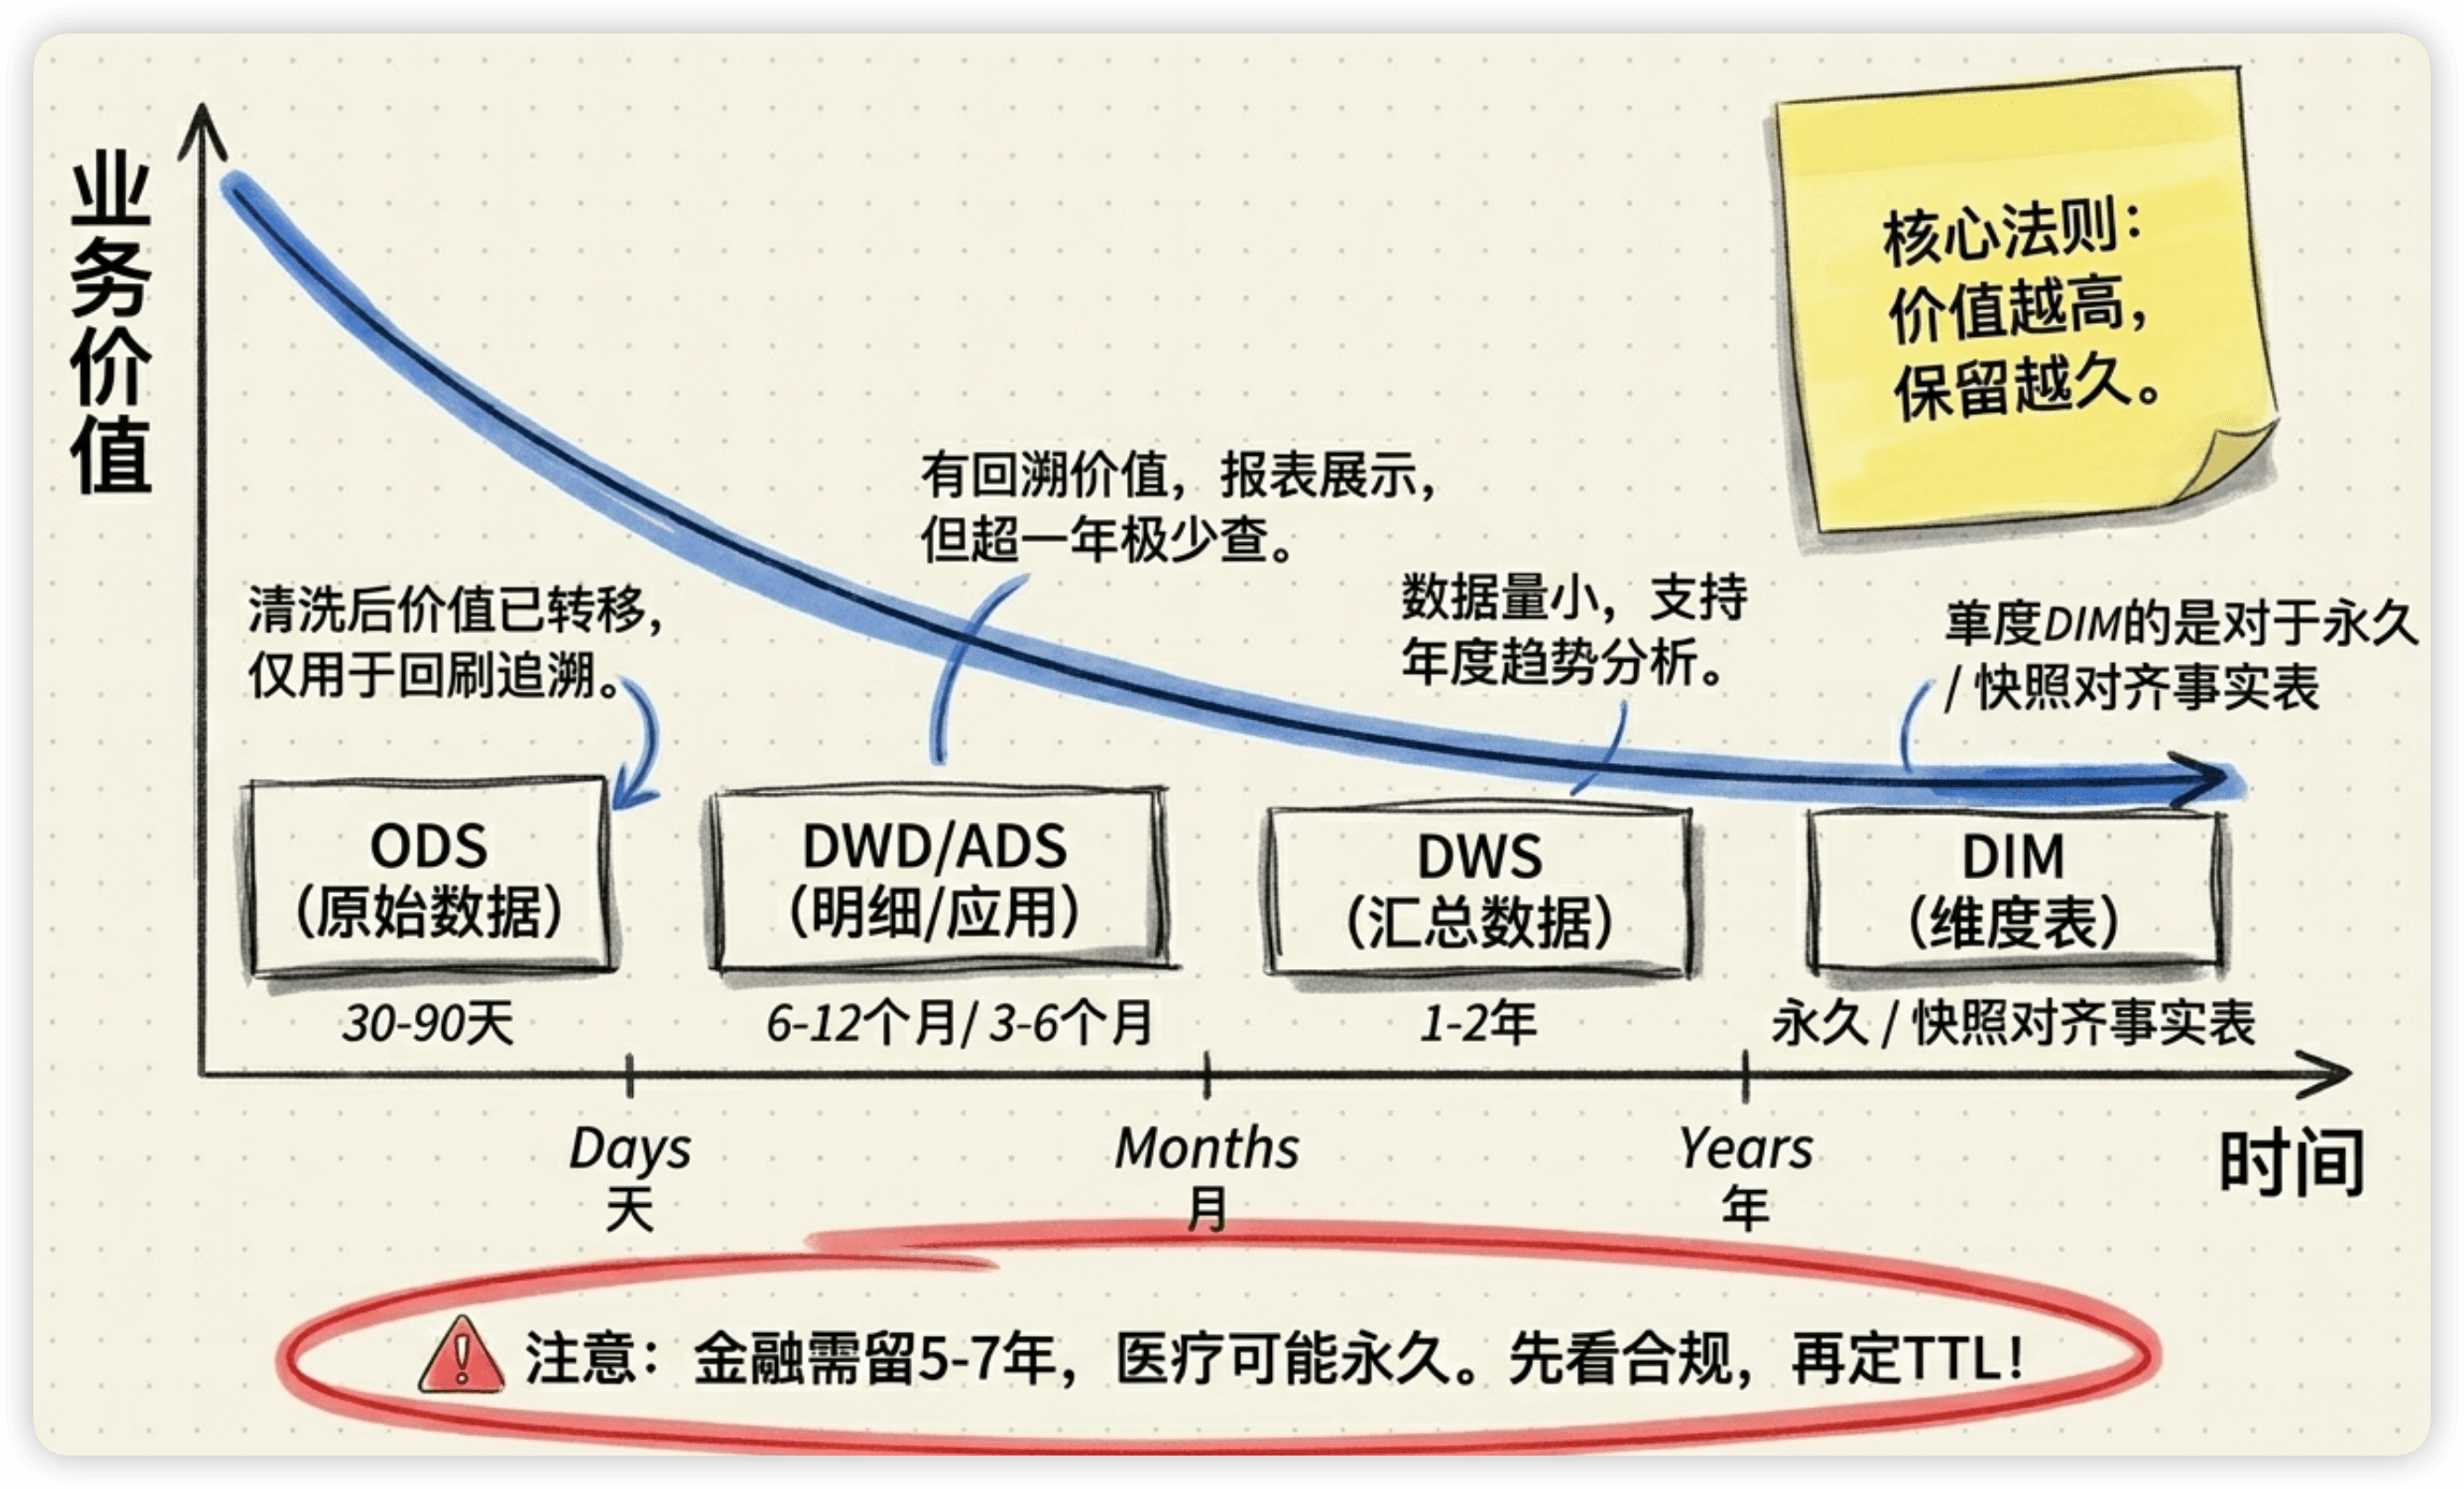
不同层级的数据价值不同,保留时间也应该不同:
| 层级 | 推荐保留时间 | 理由 |
|---|---|---|
| ODS | 30-90天 | 原始数据的价值在DWD层清洗后已经"转移"了,ODS只用于问题追溯和数据回刷 |
| DWD | 6-12个月 | 明细数据有回溯价值(比如排查某天的异常),但超过一年极少查 |
| DWS | 1-2年 | 汇总数据量不大(相比明细),保留长一些支持年度趋势分析 |
| ADS | 3-6个月 | 直接给报表用,报表通常只展示最近几个月的数据 |
| DIM(拉链表) | 永久 | 维度表数据量小,拉链表本身就是历史记录,不需要删 |
| DIM(快照) | 和事实表对齐 | 如果事实表保留1年,维度快照也保留1年 |
⚠️ 以上是互联网公司的常见策略。金融行业通常要求保留5-7年(监管合规),医疗行业可能要求永久保留。必须先确认行业法规要求,再定TTL策略。
怎么确定具体的TTL?
看数据。跑一个查询统计各分区的访问频率:
-- 统计ODS表各分区最近90天的查询次数(从审计日志中)
SELECT
    table_name,
    partition_value AS dt,
    COUNT(*) AS query_count,
    MAX(query_date) AS last_queried
FROM audit_query_log
WHERE table_name LIKE 'ods_%'
  AND query_date >= DATE_SUB(CURRENT_DATE, 90)
GROUP BY table_name, partition_value
ORDER BY query_count ASC;

-- 查询次数为0的分区就是"没人用"的历史数据
-- 这些就是可以清理的候选
冷热分层:不删但降级
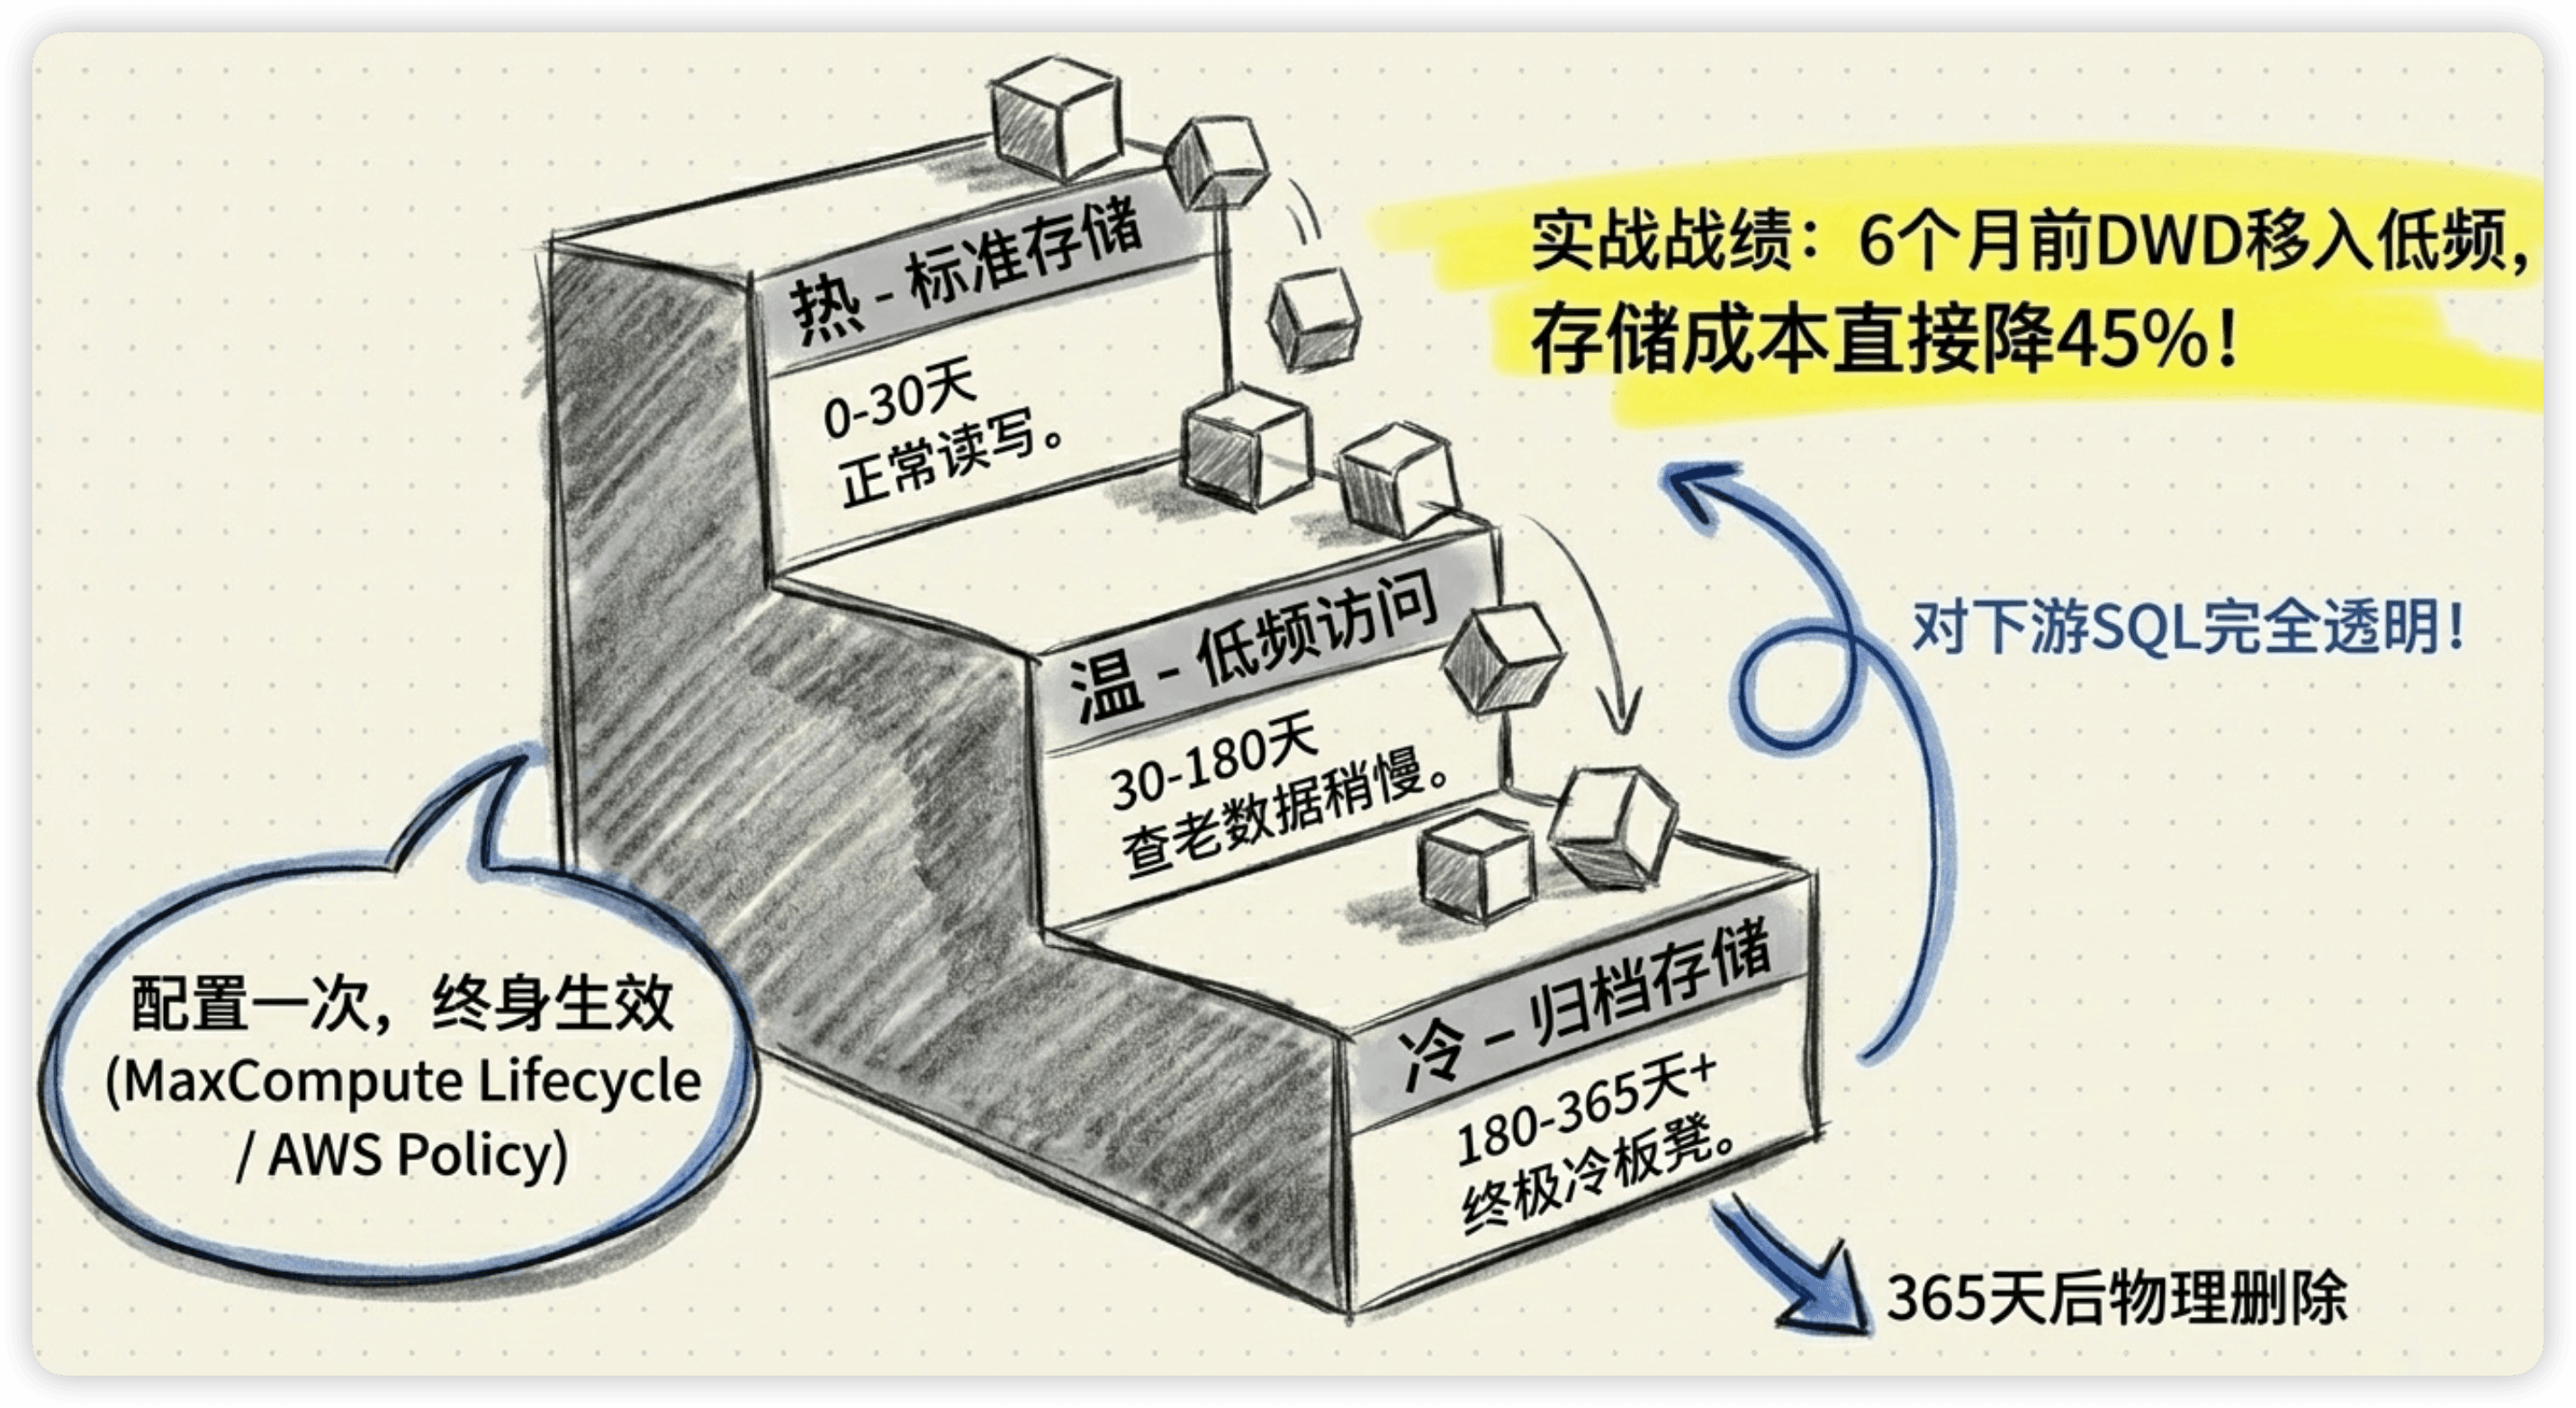
有些数据不能删(合规要求或"万一以后用到"),但也不需要高性能存储。这时候用冷热分层——把老数据移到便宜的存储上。
三级存储架构
热数据(最近30天)
├── 存储:SSD / 高性能HDFS / S3 Standard
├── 查询:秒级响应
├── 成本:最高
└── 场景:日常报表、实时分析、ad-hoc查询

温数据(30天-1年)
├── 存储:HDD / S3 Infrequent Access
├── 查询:分钟级
├── 成本:约为热存储的40-60%
└── 场景:历史趋势分析、问题排查

冷数据(1年以上)
├── 存储:S3 Glacier / OSS归档存储
├── 查询:需要提前解冻(小时级)
├── 成本:约为热存储的10-20%
└── 场景:合规存档、极少数回溯需求
实现方式
阿里云MaxCompute:
-- 设置表级生命周期,超期自动删除
ALTER TABLE ods_order SET LIFECYCLE 90;  -- 90天后自动清理
MaxCompute的LIFECYCLE是最省心的——配置一下就不用管了,平台自动执行。
Hive + HDFS:
#!/bin/bash
# 清理90天前的ODS分区
EXPIRE_DATE=$(date -d "90 days ago" +%Y-%m-%d)

hive -e "
    ALTER TABLE ods_trade_order_di
    DROP IF EXISTS PARTITION (dt < '${EXPIRE_DATE}');
"
echo "Cleaned partitions before ${EXPIRE_DATE}"
AWS S3 Lifecycle Policy:
{
    "Rules": [
        {
            "ID": "ODS冷热分层",
            "Filter": {"Prefix": "warehouse/ods/"},
            "Transitions": [
                {"Days": 30, "StorageClass": "STANDARD_IA"},
                {"Days": 180, "StorageClass": "GLACIER"}
            ],
            "Expiration": {"Days": 365}
        }
    ]
}
30天后自动从标准存储降到低频访问,180天后降到Glacier归档,365天后自动删除。配置一次,终身生效。
我在AWS环境做过一次冷热分层迁移:把6个月前的DWD明细数据从S3 Standard移到S3 Infrequent Access,存储成本直接降了45%。迁移过程用Spark跑了一个批处理任务,旧分区写到低频存储路径后更新Hive Metastore指向新路径。对下游查询完全透明——SQL还是一样写,只是查老数据的时候稍微慢一点。
自动化清理方案
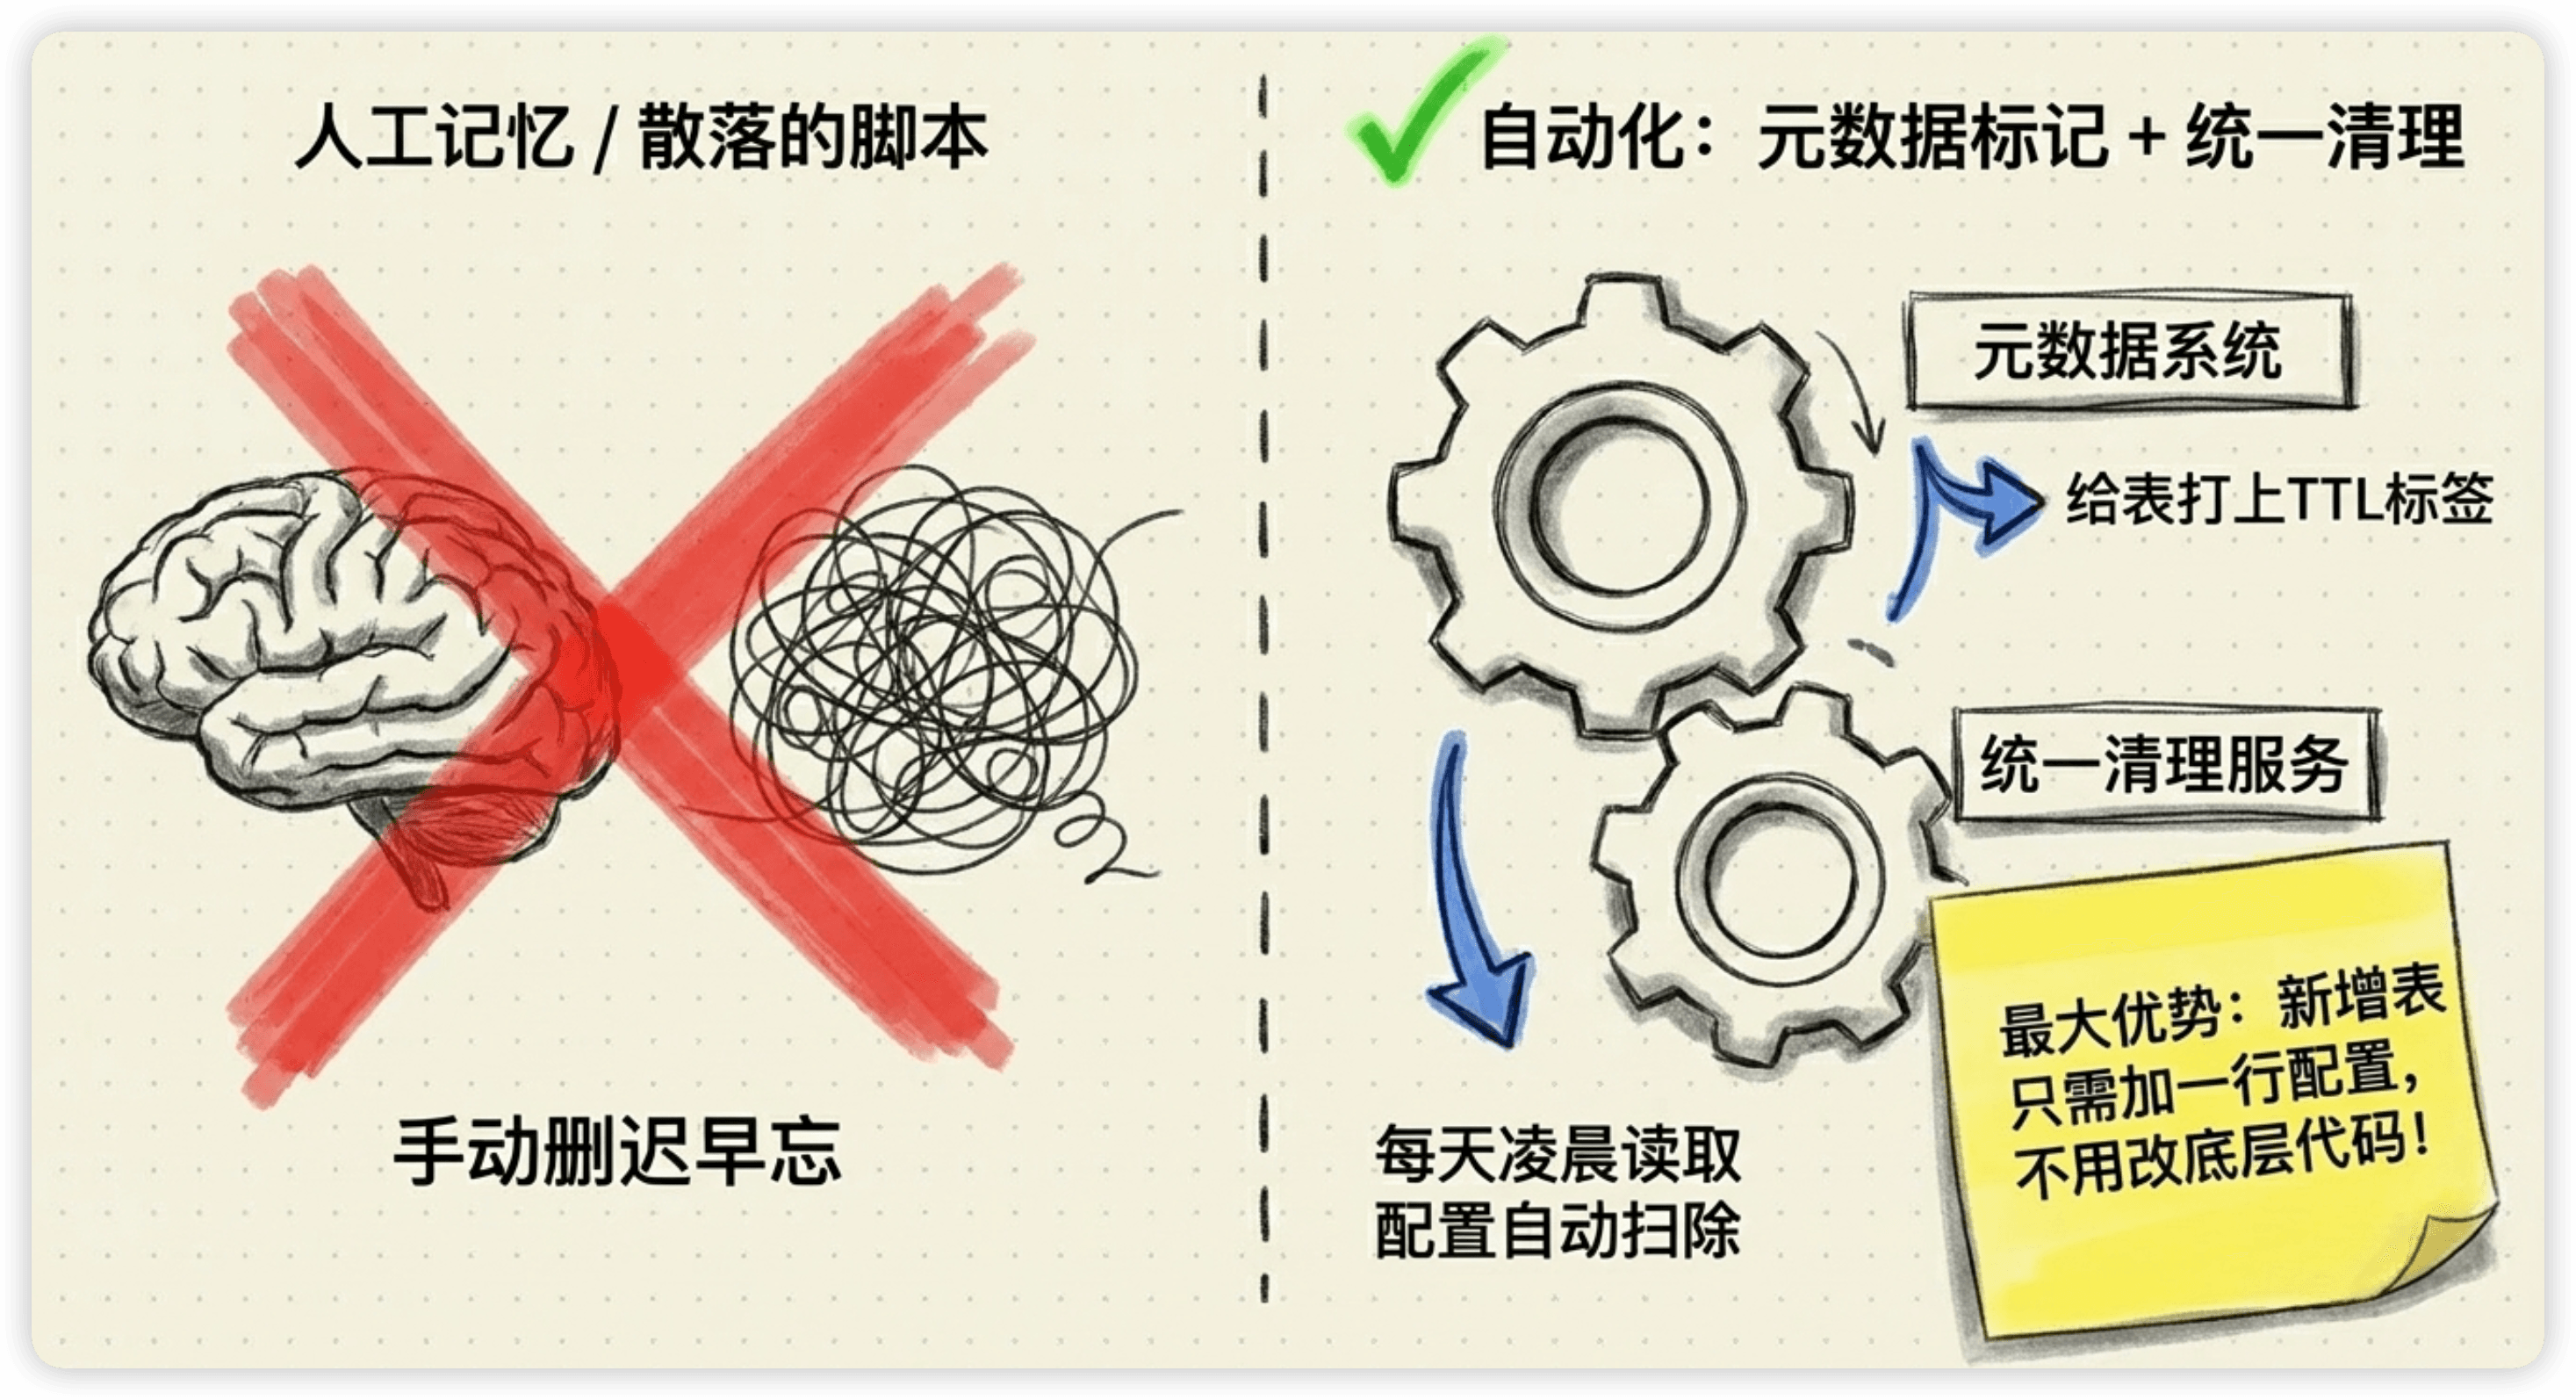
手动删数据迟早忘。必须自动化。
方案一:调度平台定时清理
# Airflow DAG:每天凌晨3点清理过期分区
from datetime import datetime, timedelta
from airflow import DAG
from airflow.operators.python import PythonOperator

# 各层TTL配置
TTL_CONFIG = {
    'ods': 90,     # ODS保留90天
    'dwd': 365,    # DWD保留1年
    'dws': 730,    # DWS保留2年
    'ads': 180,    # ADS保留6个月
}

def clean_expired_partitions():
    for layer, ttl_days in TTL_CONFIG.items():
        expire_date = (datetime.now() - timedelta(days=ttl_days)).strftime('%Y-%m-%d')
        tables = get_tables_by_prefix(layer)  # 获取该层所有表
        for table in tables:
            partitions = get_partitions_before(table, expire_date)
            if partitions:
                drop_partitions(table, partitions)
                log(f"Cleaned {len(partitions)} partitions from {table}")

# DAG定义
with DAG('data_lifecycle_cleanup', schedule_interval='0 3 * * *') as dag:
    cleanup = PythonOperator(
        task_id='clean_expired',
        python_callable=clean_expired_partitions
    )
方案二:元数据标记 + 统一清理
在元数据系统里给每张表标记TTL,统一的清理服务读取配置并执行:
表名: ods_trade_order_di       TTL: 90天     清理策略: 删除
表名: dwd_trade_order_di       TTL: 365天    清理策略: 归档到冷存储
表名: dws_user_active_1d       TTL: 730天    清理策略: 删除
表名: dim_user                 TTL: 永久     清理策略: 不清理
好处是配置集中管理,新增表时只需要在元数据里加一行配置,不用改清理脚本。
删之前的安全措施
数据删了就真没了。必须有安全机制:
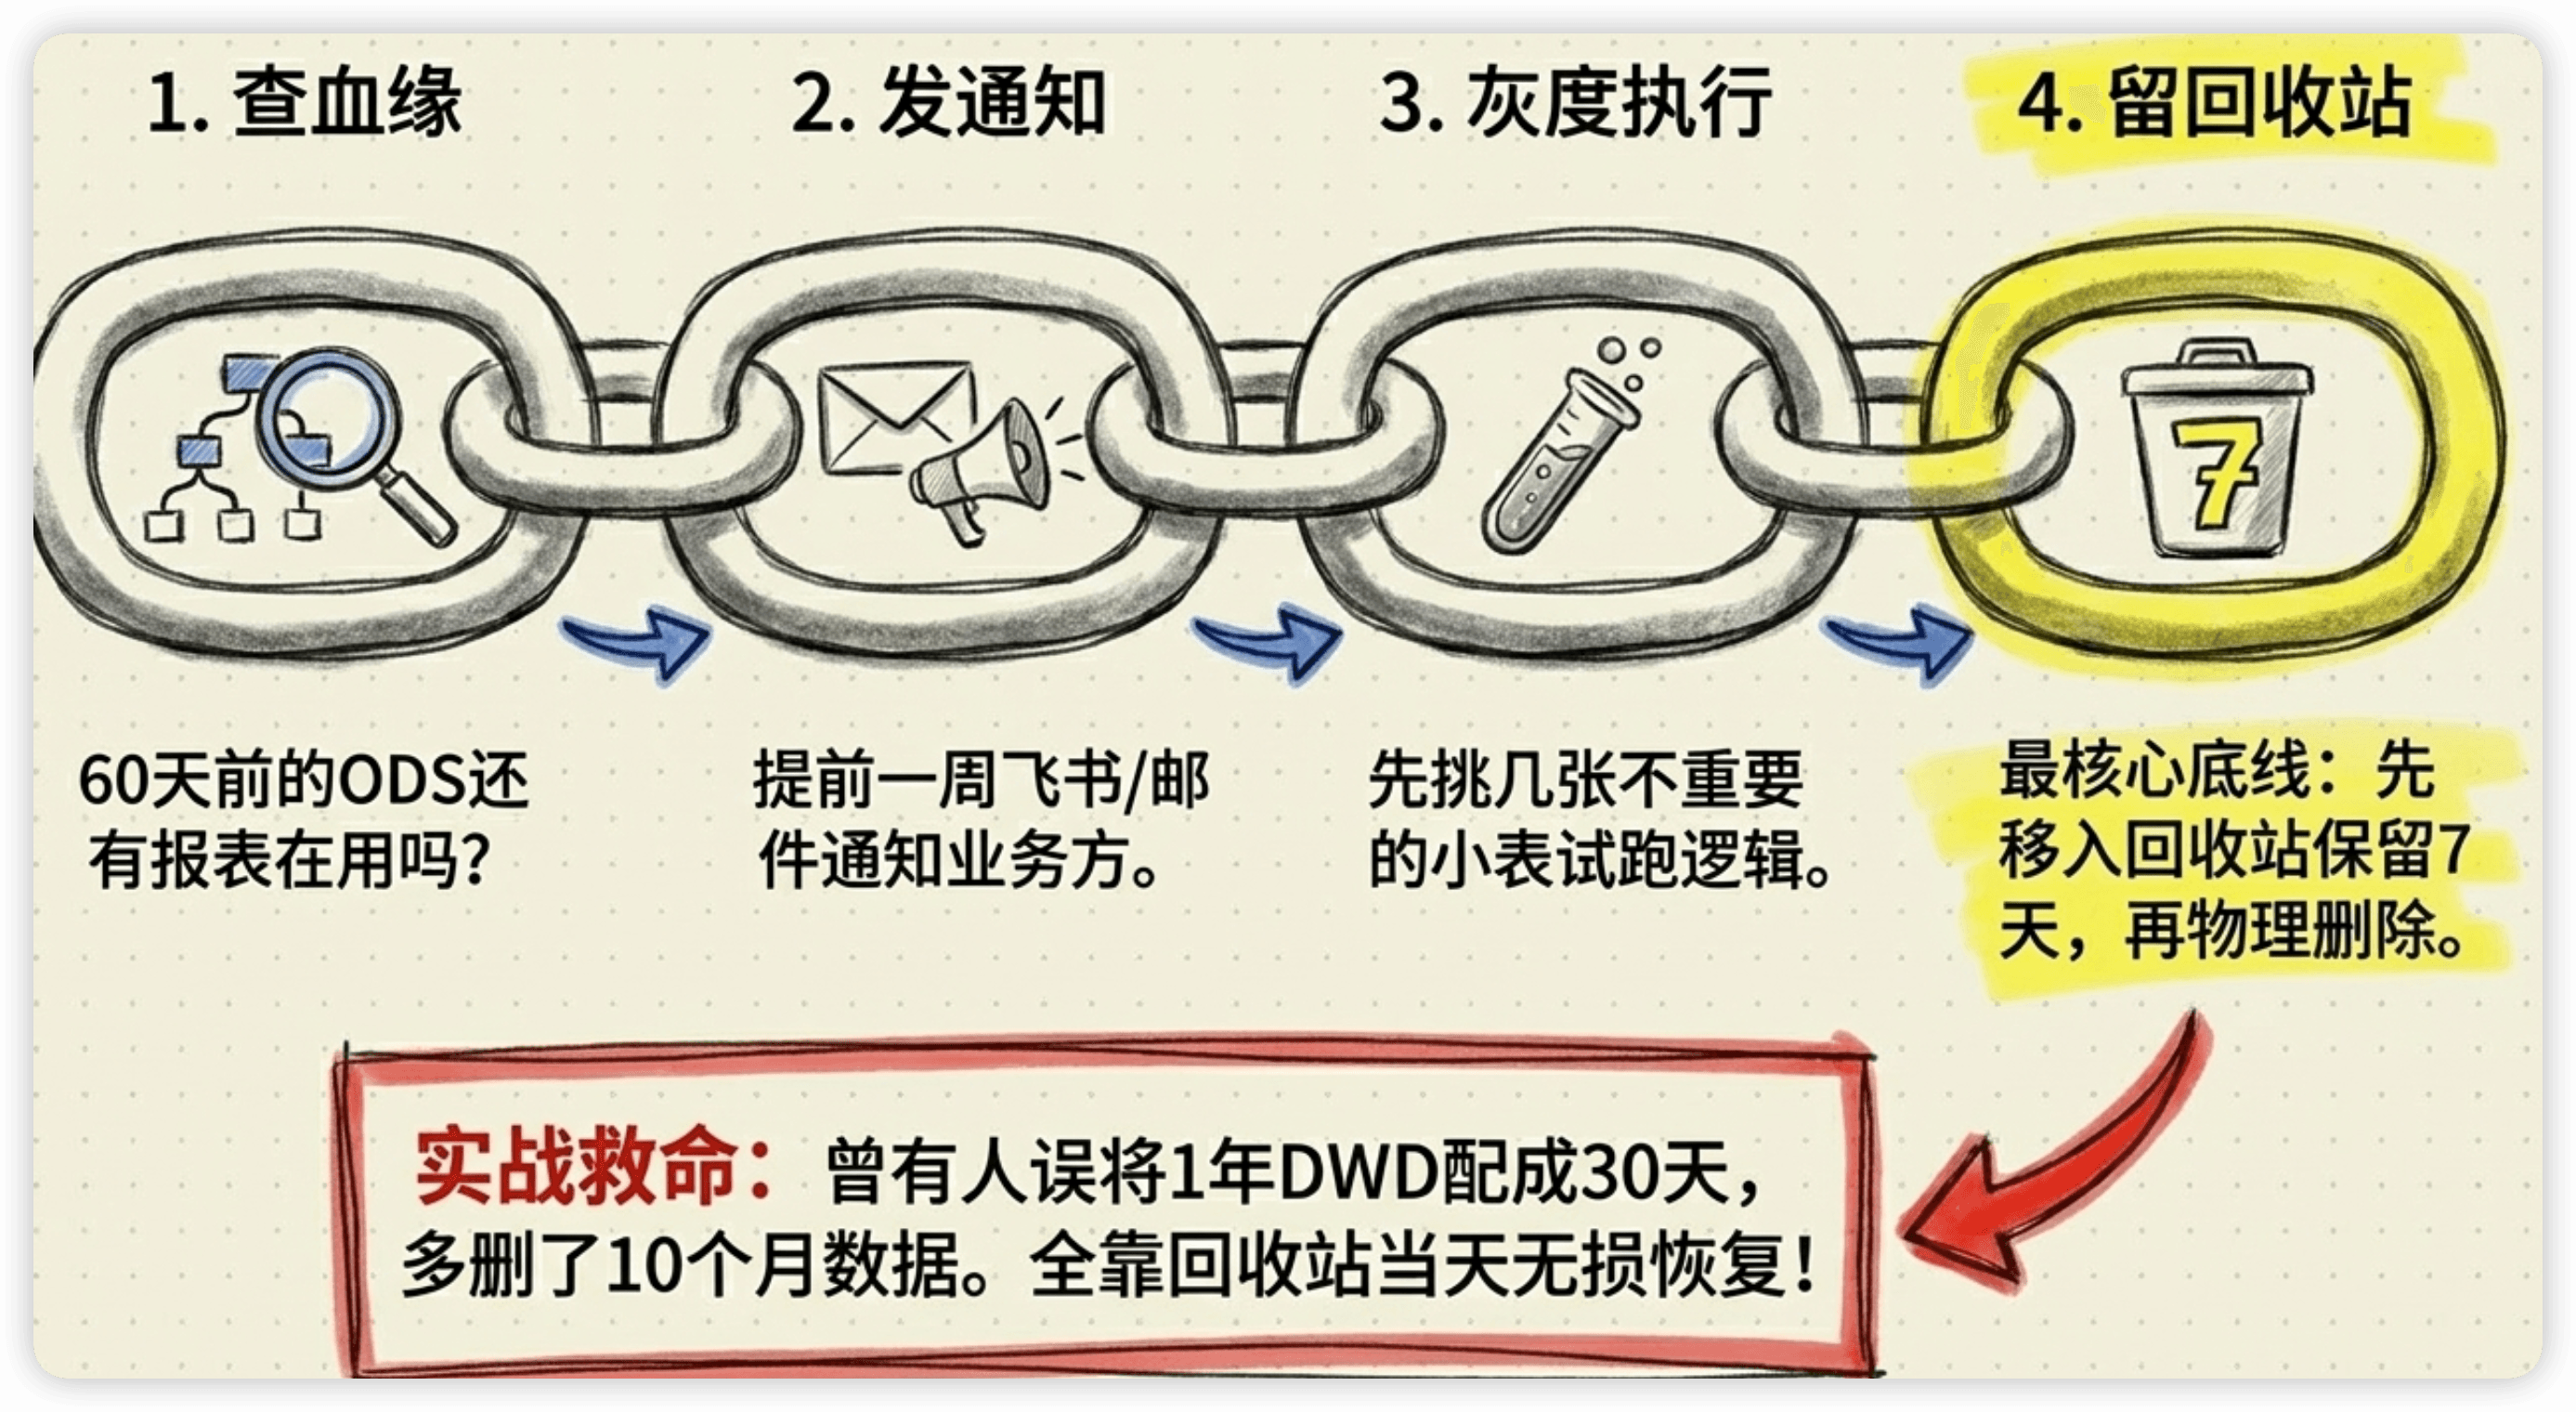
① 先查下游依赖。 要删的分区有没有下游表还在用?用数据血缘查一下。如果有报表在查60天前的ODS数据,那90天TTL可能不够。
② 删前通知。 给数据使用方发通知:"ODS层超过90天的数据将在X日清理,如有需要请提前备份。"第一次执行时建议提前一周通知。
③ 灰度执行。 先选几张不重要的小表试跑清理脚本,确认逻辑正确再全量执行。
④ 保留回收站。 如果存储允许,删除的数据先移到"回收站"目录保留7天,而不是直接物理删除:
# 不直接删除,先移到回收站
hdfs dfs -mv /warehouse/ods/order/dt=2024-10-01 /warehouse/_trash/ods/order/dt=2024-10-01

# 7天后再物理删除回收站
find /warehouse/_trash/ -mtime +7 -exec hdfs dfs -rm -r {} \;
万一误删了关键数据,7天内还能恢复。这个机制救过我们一次——有人误配了TTL参数,把应该保留1年的DWD表设成了30天,多删了10个月的数据。幸好有回收站,当天就恢复了。
面试怎么答?
高分回答
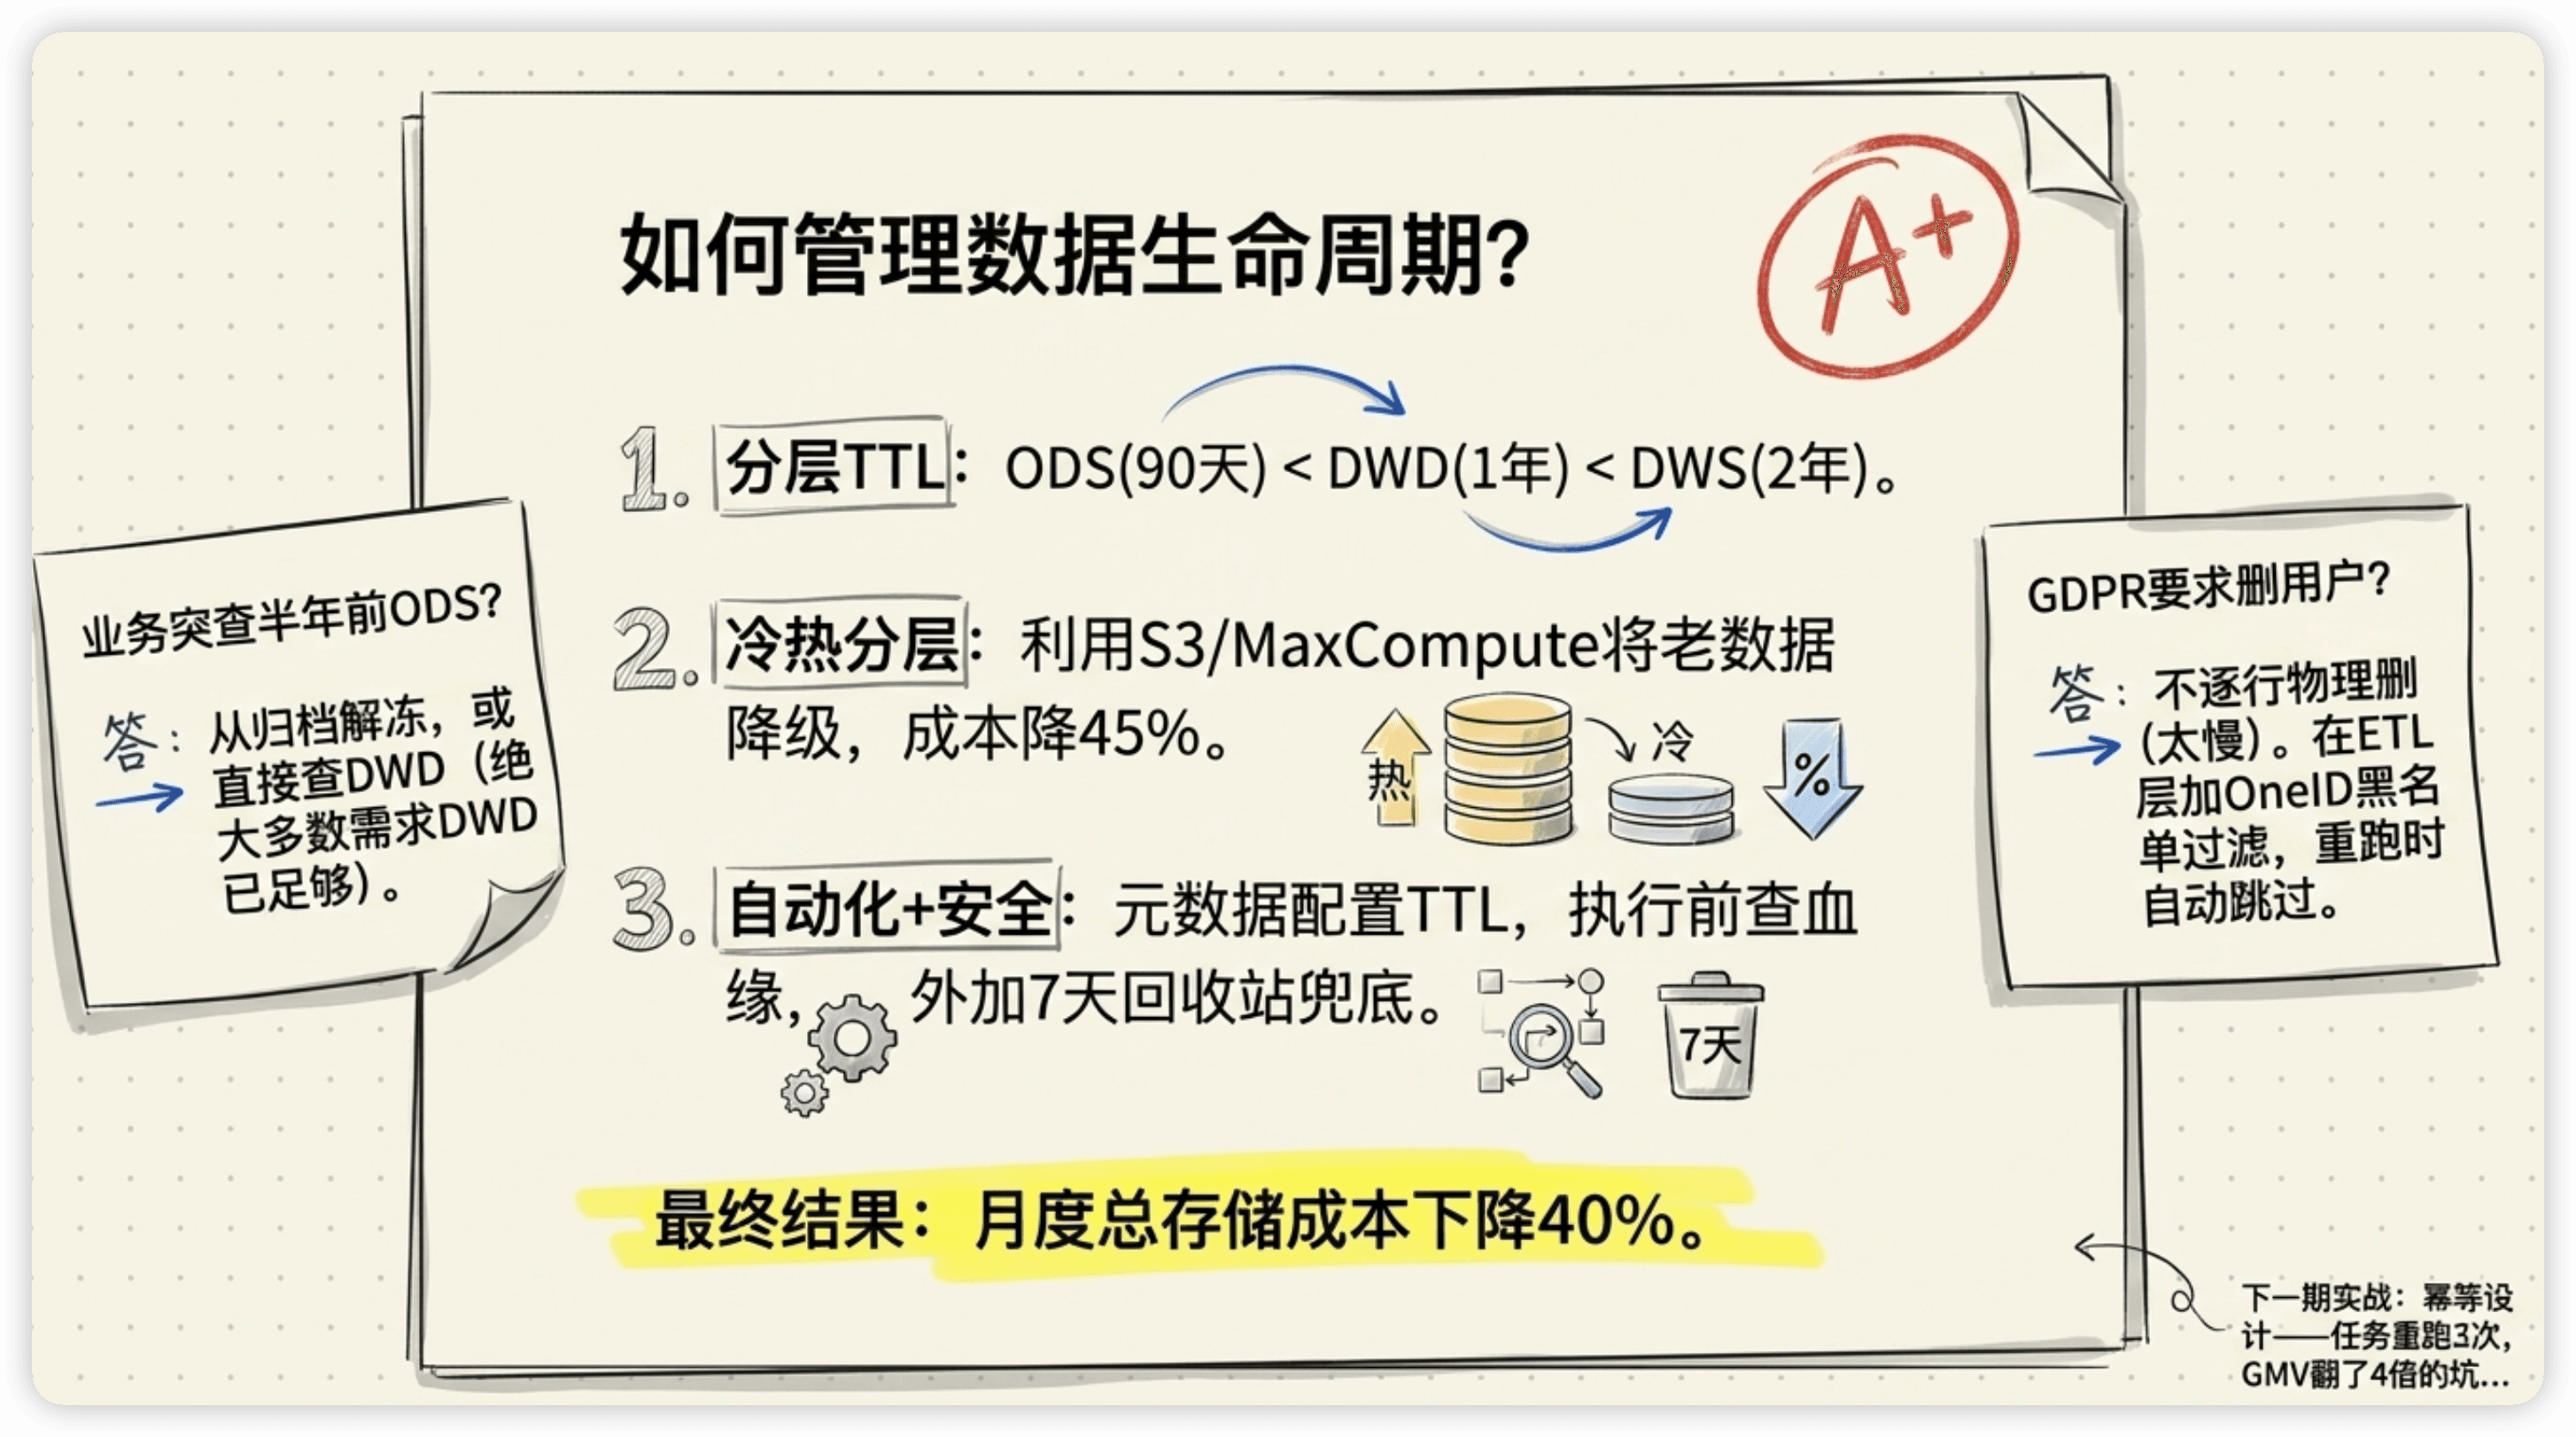
「我们按层级设置了不同的TTL策略:ODS保留90天,DWD保留1年,DWS保留2年,DIM永久保留。用Airflow定时清理过期分区,每天凌晨自动执行。另外做了冷热分层——6个月前的DWD明细数据从标准S3降到低频存储,存储成本降了45%。清理之前会先查数据血缘确认没有下游依赖,还有7天的回收站机制防误删。整体优化后月度存储成本降了约40%。」
追问防线
追问1:TTL设短了怎么办?业务方突然要查半年前的ODS数据。
这种情况偶尔会遇到。如果有冷存储归档,可以从归档中恢复(S3 Glacier解冻需要几小时)。如果已经物理删除了,就只能从DWD层往回推——DWD已经清洗过了,大部分分析需求其实不需要原始ODS。所以DWD的TTL通常设得比ODS长。
更好的做法是在设TTL之前和业务方对齐需求。实际上绝大部分业务方不需要半年前的ODS原始数据。
追问2:怎么处理GDPR的"被遗忘权"请求?
用户要求删除其个人数据时,需要在所有层级中定位并删除该用户的记录。如果有OneID映射表(DAY 9),可以通过one_id找到所有关联的数据行。具体实现上,对于分区表通常不会逐行删除(太慢),而是在DWD/DWS层的ETL中加过滤条件——维护一张"待删除用户名单",每次重跑时跳过这些用户。
总结
- 管理数据生命周期的核心原因:省钱,其次是性能和合规
- 各层TTL:ODS(90天) < DWD(1年) < DWS(2年),价值越高保留越久
- 冷热分层:热(30天) → 温(1年) → 冷(归档),不删但降级,成本降40-50%
- 自动化:调度平台定时清理 + 元数据配置TTL,不能靠人记忆
- 安全措施:查血缘 → 发通知 → 灰度执行 → 保留回收站