面试项目表达技巧
数仓建模系列写到第20篇,最后一篇不聊技术,聊一个比技术更重要的事情——怎么把你做过的项目讲出来。
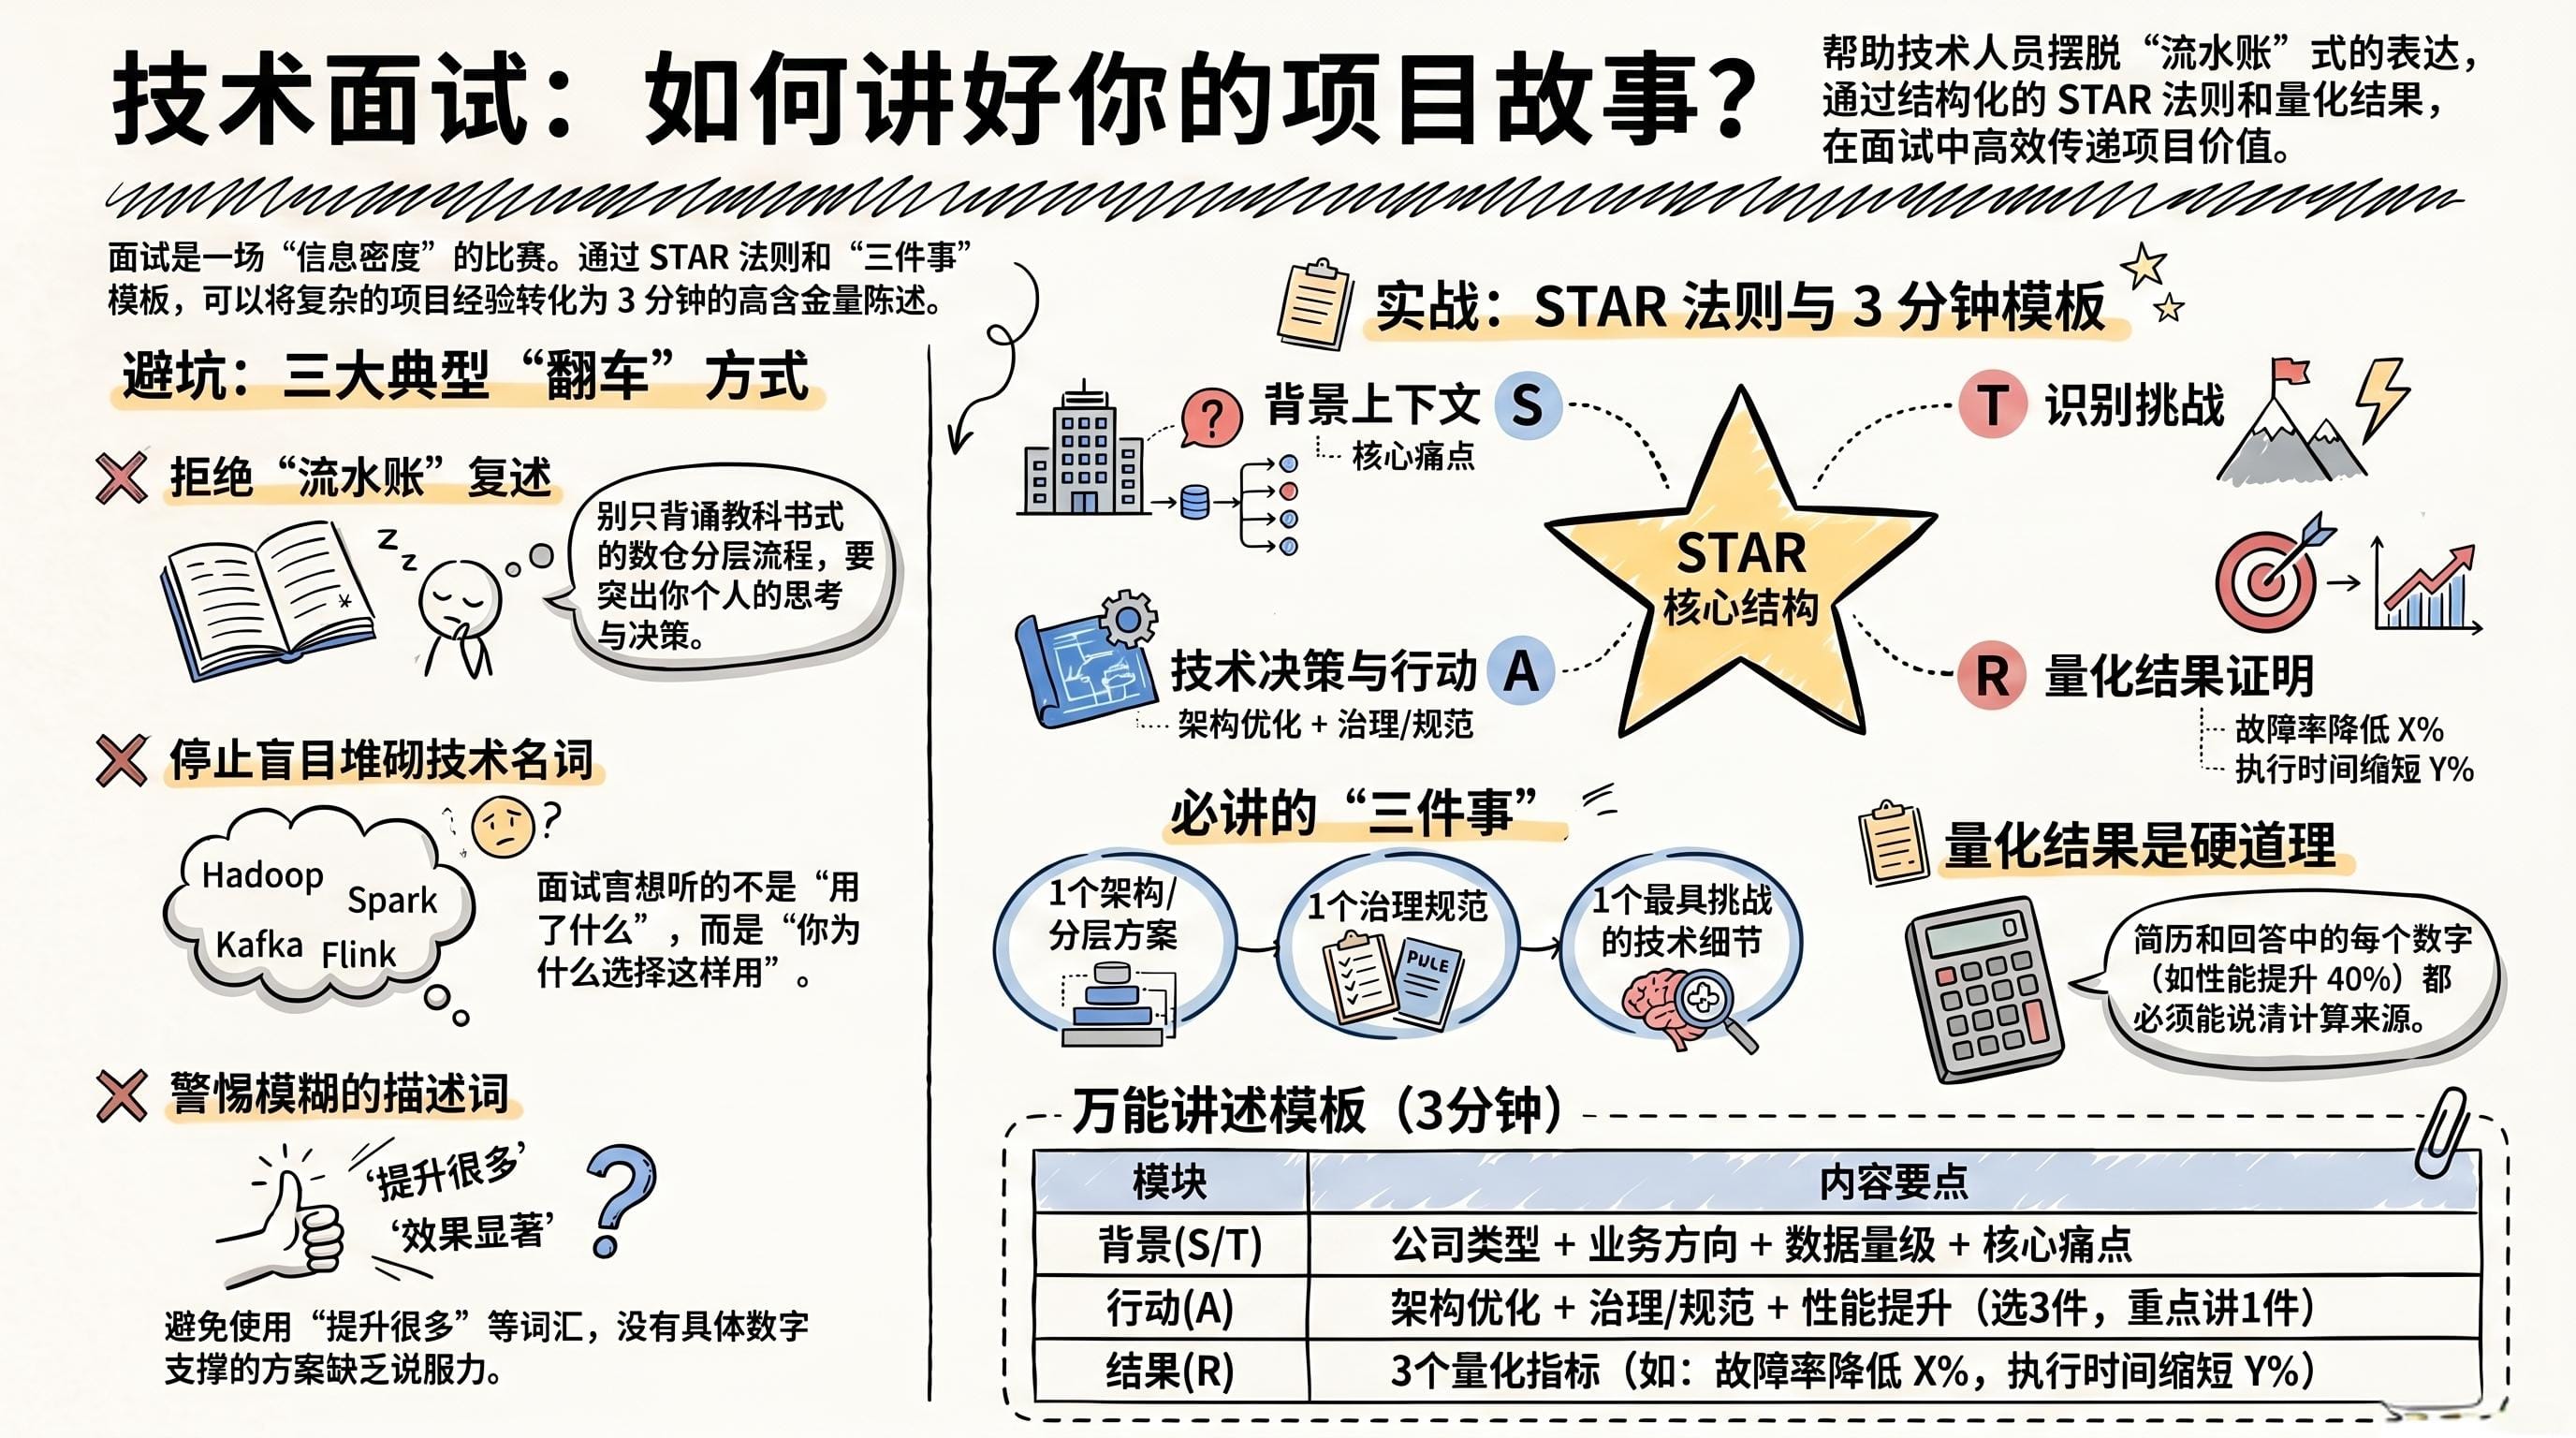
我见过太多技术很强但面试挂了的人。不是技术问题,是表达问题。有的人能把Flink的Checkpoint机制讲得头头是道,但一问"聊聊你做过的项目",就变成了流水账——"我先建了ODS,然后建了DWD,然后做了ETL……"面试官听了3分钟,依然不知道你解决了什么问题、为什么这样设计。
面试是一场信息密度的比赛。你只有3-5分钟让面试官觉得"这人做过真项目、有思考、能扛事"——怎么在这么短的时间里传递最多的有效信息,这是一种需要练习的能力。
最常见的三种翻车
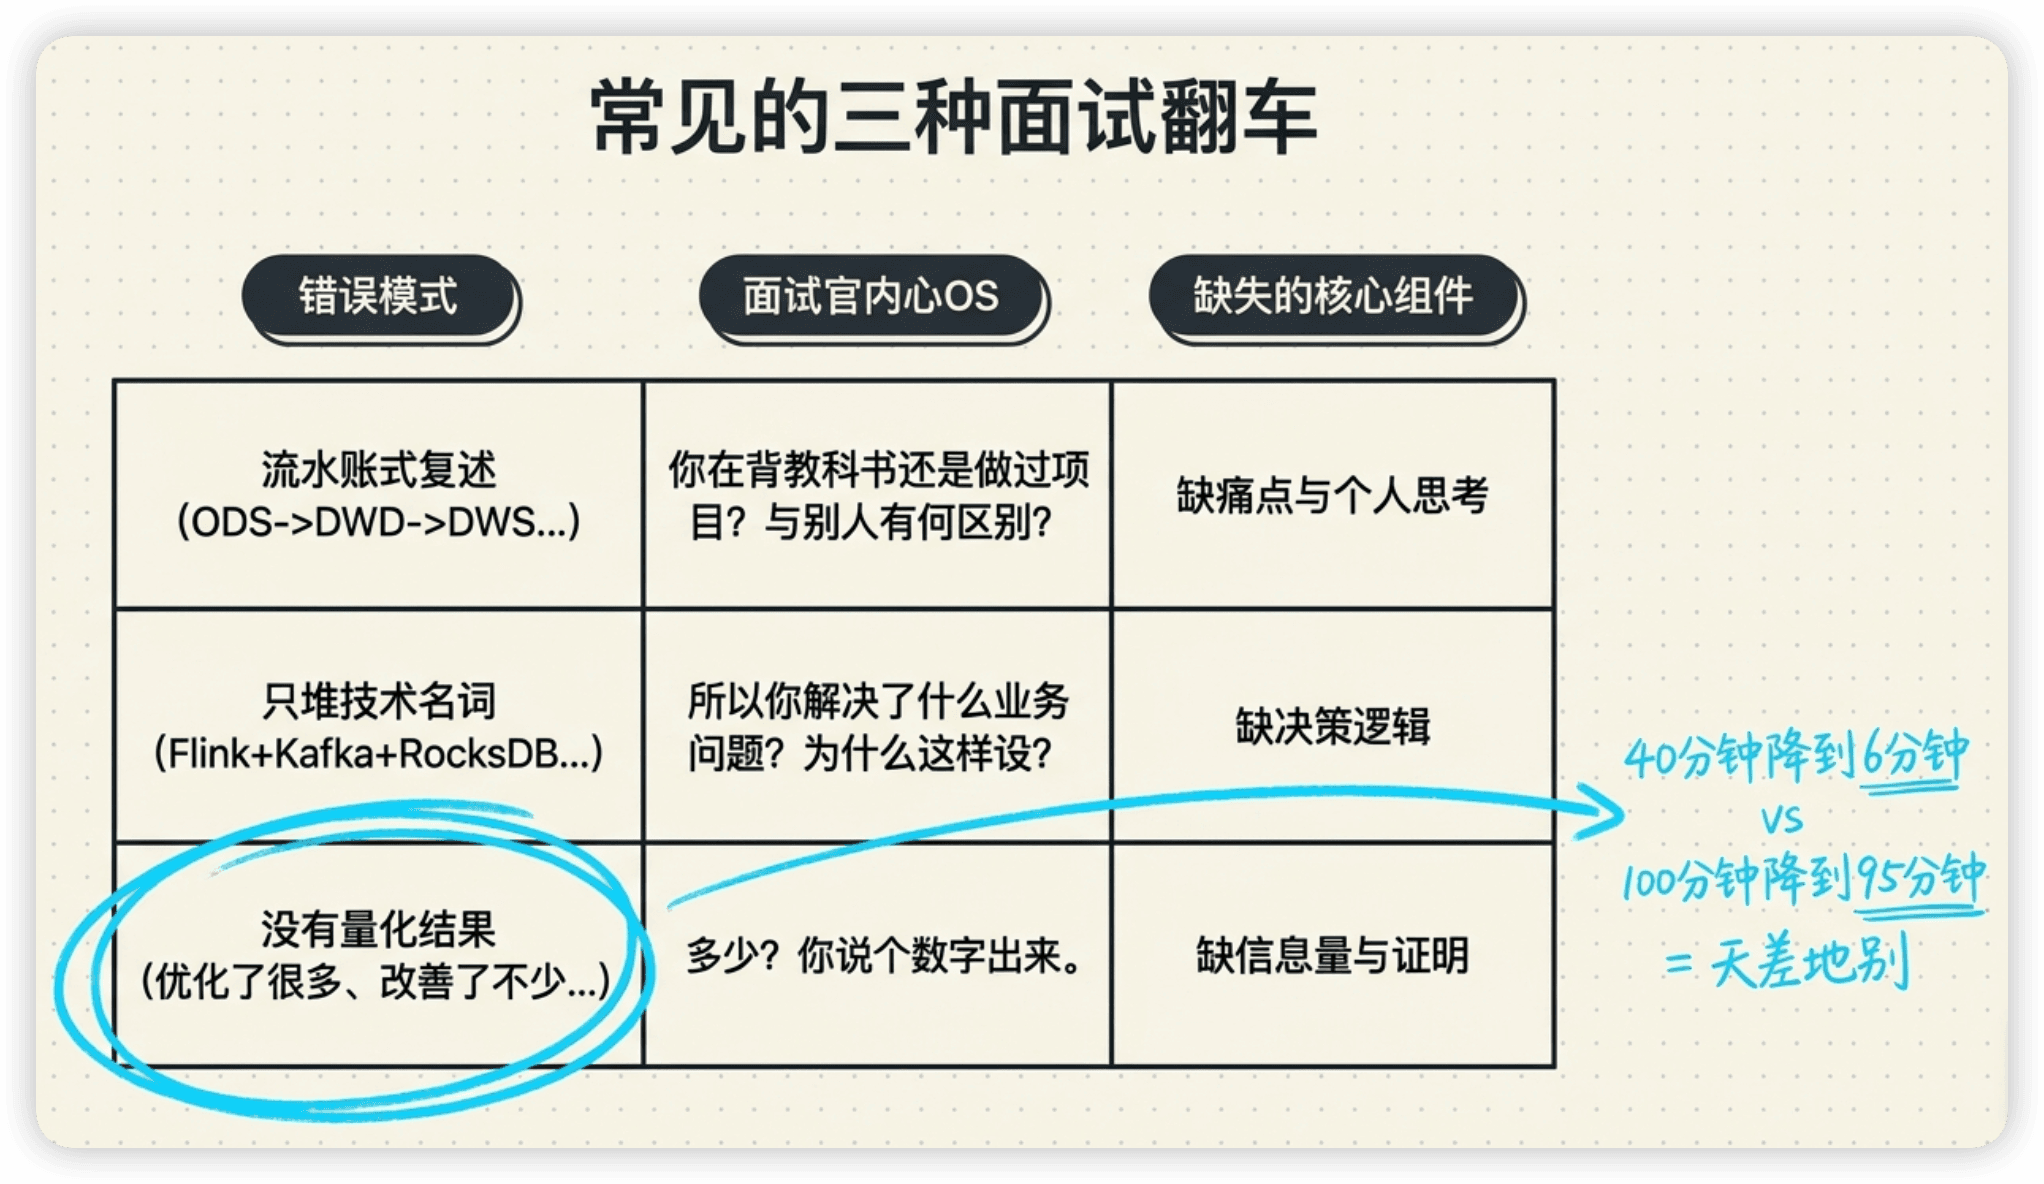
在分享正确方法之前,先看看三种典型的翻车方式。对号入座,避免踩坑。
翻车一:流水账式复述
「我先搭建了ODS层,然后清洗数据建了DWD层,然后按主题聚合建了DWS层,最后做了ADS层给报表用。用的是Kimball维度建模方法……」
面试官内心OS: "你在背教科书还是做过项目?每个做数仓的都是这个流程,你跟别人有什么区别?"
问题在哪: 没有痛点、没有挑战、没有你个人的决策和思考。换一个人来讲,内容完全一样。
翻车二:只堆技术名词
「我们用了Flink+Kafka+Doris做实时数仓,Checkpoint设的5分钟,Watermark设的30秒,状态后端用的RocksDB,Exactly-Once通过两阶段提交实现……」
面试官内心OS: "所以你解决了什么业务问题?这些配置为什么这样设?"
问题在哪: 堆技术名词而不解释背后的决策逻辑。面试官想听的不是"你用了什么",而是"你为什么这样用"。
翻车三:没有量化结果
「优化之后性能提升了很多」 「数据质量改善了不少」 「团队效率提高了」
面试官内心OS: "多少?你说个数字出来。"
问题在哪: "很多""不少""提高了"这种模糊描述没有信息量。40分钟降到6分钟是"很多",100分钟降到95分钟也是"很多"——含金量天差地别。
STAR法则:讲项目的万能结构
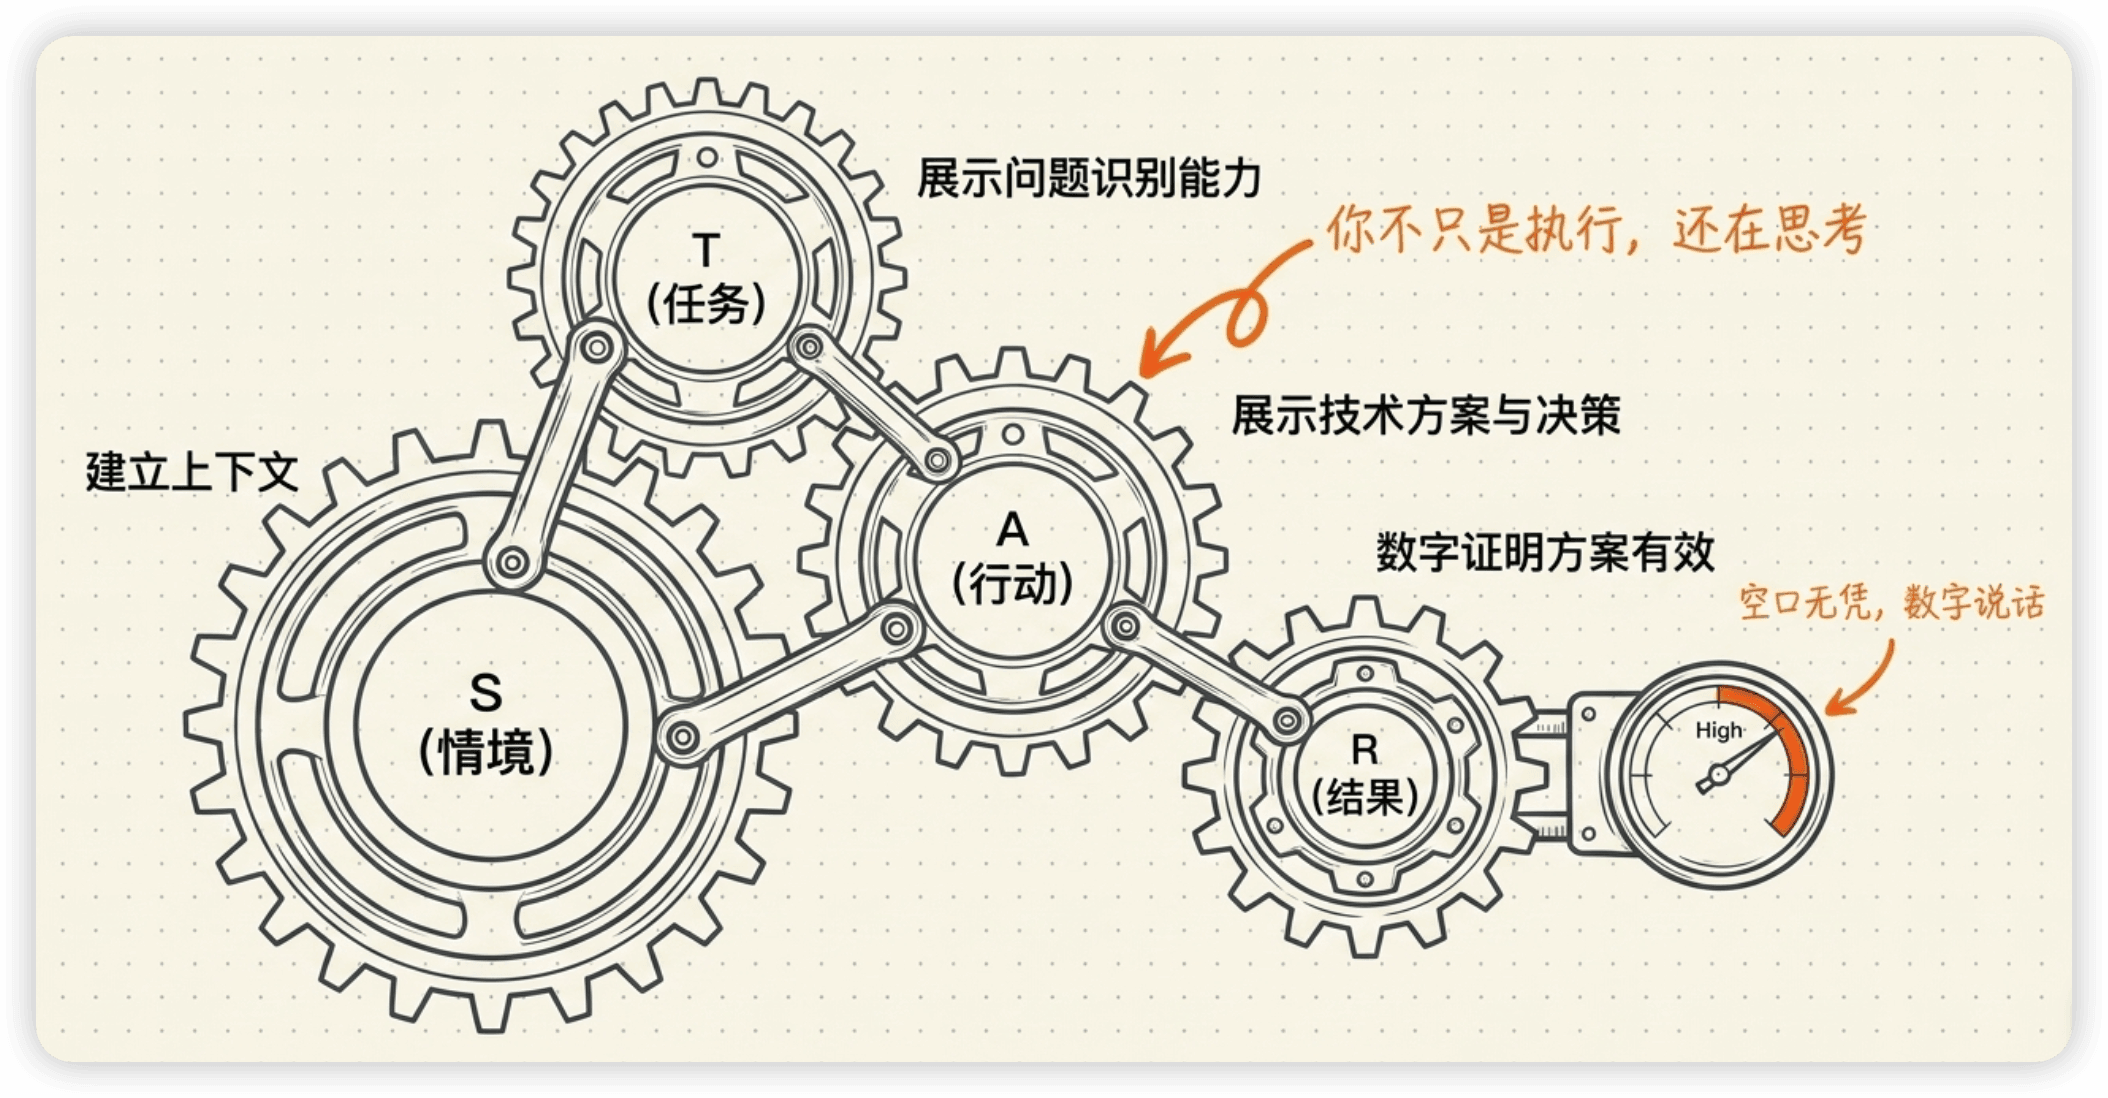
STAR法则是全世界通用的行为面试回答框架,用在数仓项目上也非常好用:
S — Situation(背景)
    什么公司?什么业务?团队多大?数据什么规模?

T — Task(挑战)
    接手时是什么状况?核心痛点是什么?

A — Action(方案)
    你做了什么?怎么设计的?为什么这样选?

R — Result(结果)
    量化成果。数字、数字、数字!
每个部分都有它的作用:
- S帮面试官建立上下文——他知道你面对的是什么级别的问题
- T展示你的问题识别能力——你能看到什么需要改进
- A展示你的技术方案和决策能力——你不只是执行,还在思考
- R证明你的方案有效——空口说方案好没有说服力,数字才有
3分钟项目讲述模板
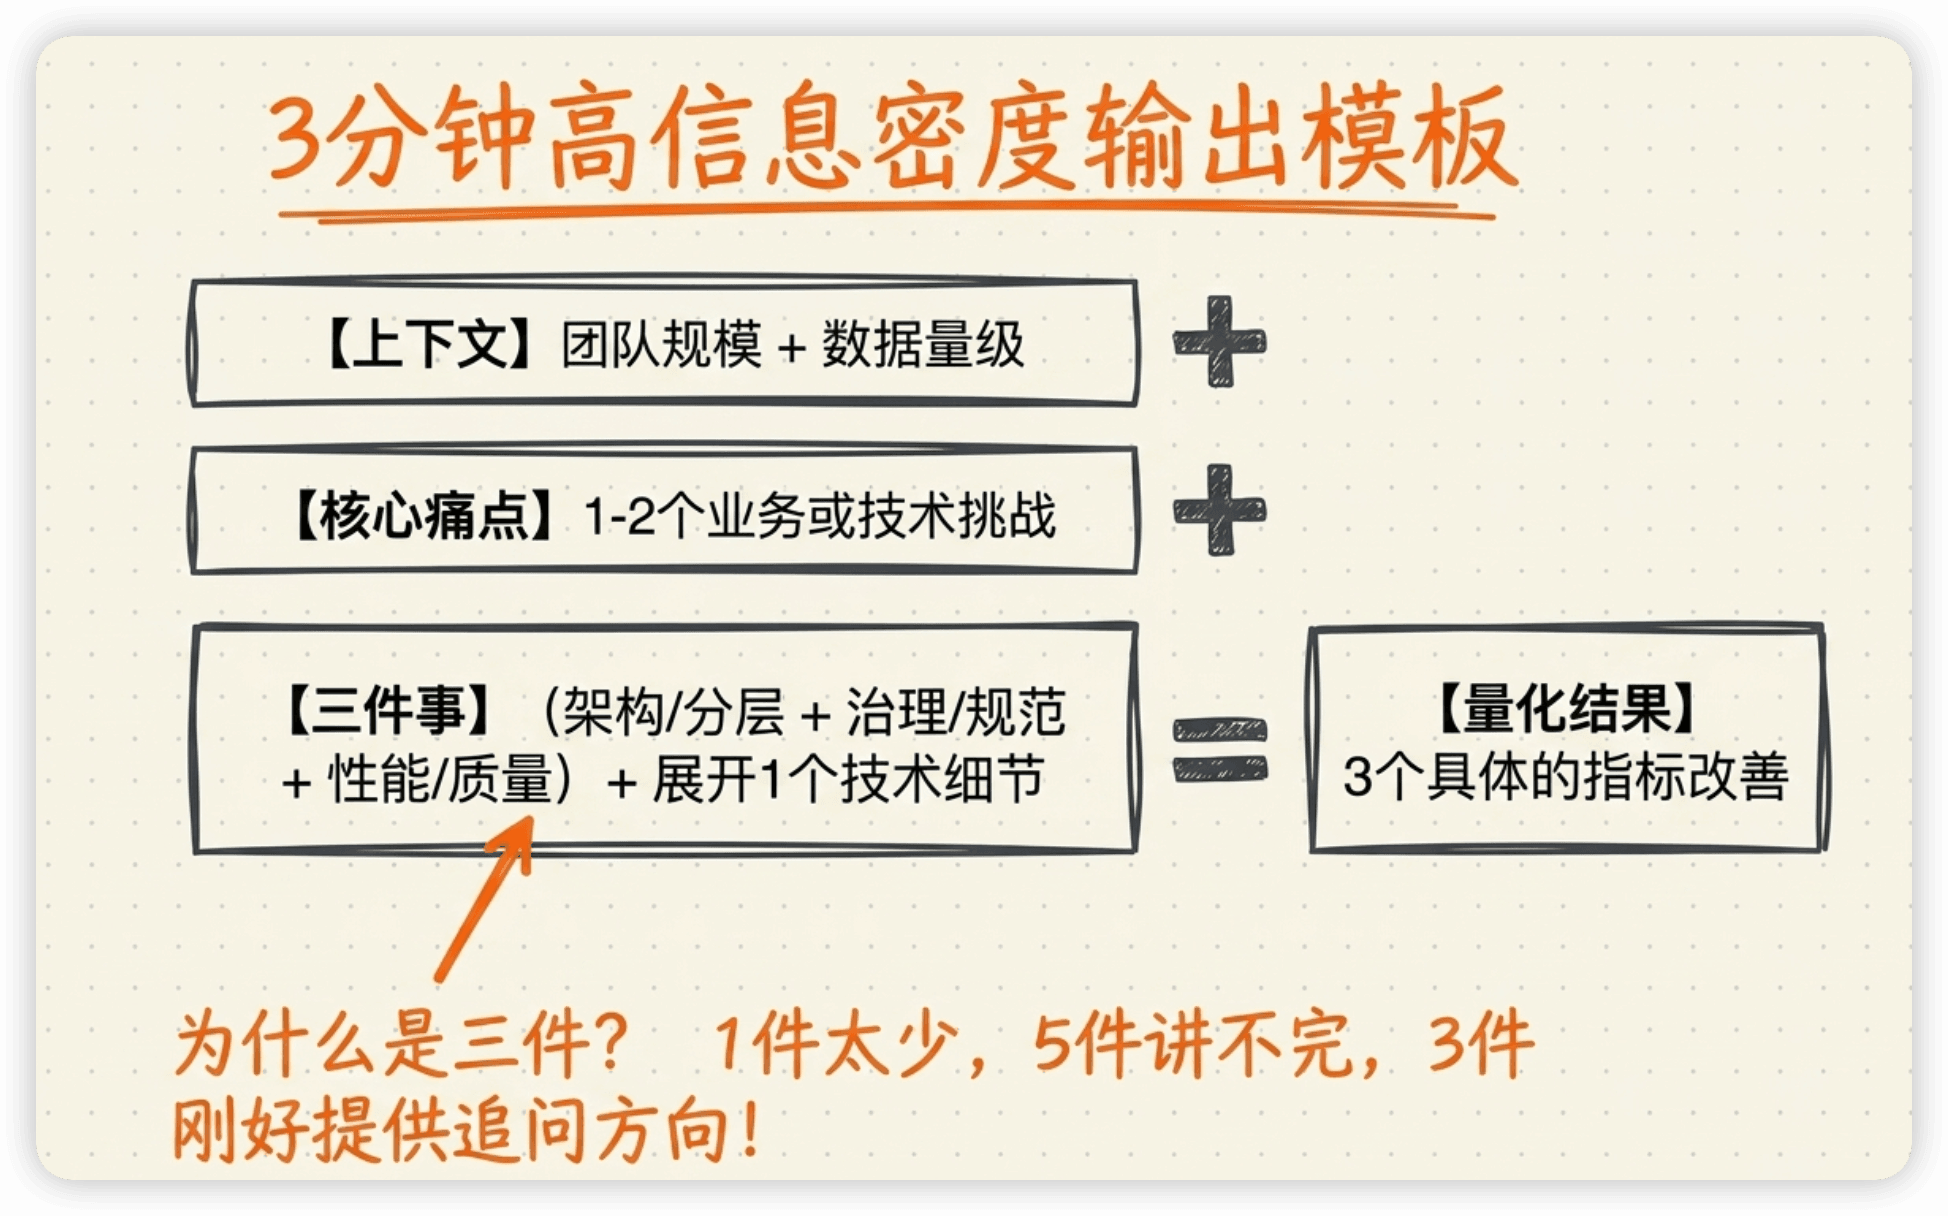
万能模板(填空即可)
「我在[公司类型]负责[业务方向]的数仓建设。团队[X]人,每天新增数据约[数量],总数据量[量级]。」
「接手时的核心问题是[1-2个痛点]。」
「我做了三件事:第一[架构/分层],第二[治理/规范],第三[性能/质量]。其中最有挑战的是[展开讲一个技术细节]。」
「结果:[3个量化指标]。」
为什么是"三件事"?
不是一件也不是五件,三件刚好:
- 一件太少,显得工作量不够
- 五件太多,3分钟讲不完,而且每件都只能蜻蜓点水
- 三件正好,整体框架讲清楚,其中一件展开讲技术细节
面试官听了三件事后,可以选择任何一件深挖——你主动给了他追问的方向,而不是等他随机提问。
实战示例
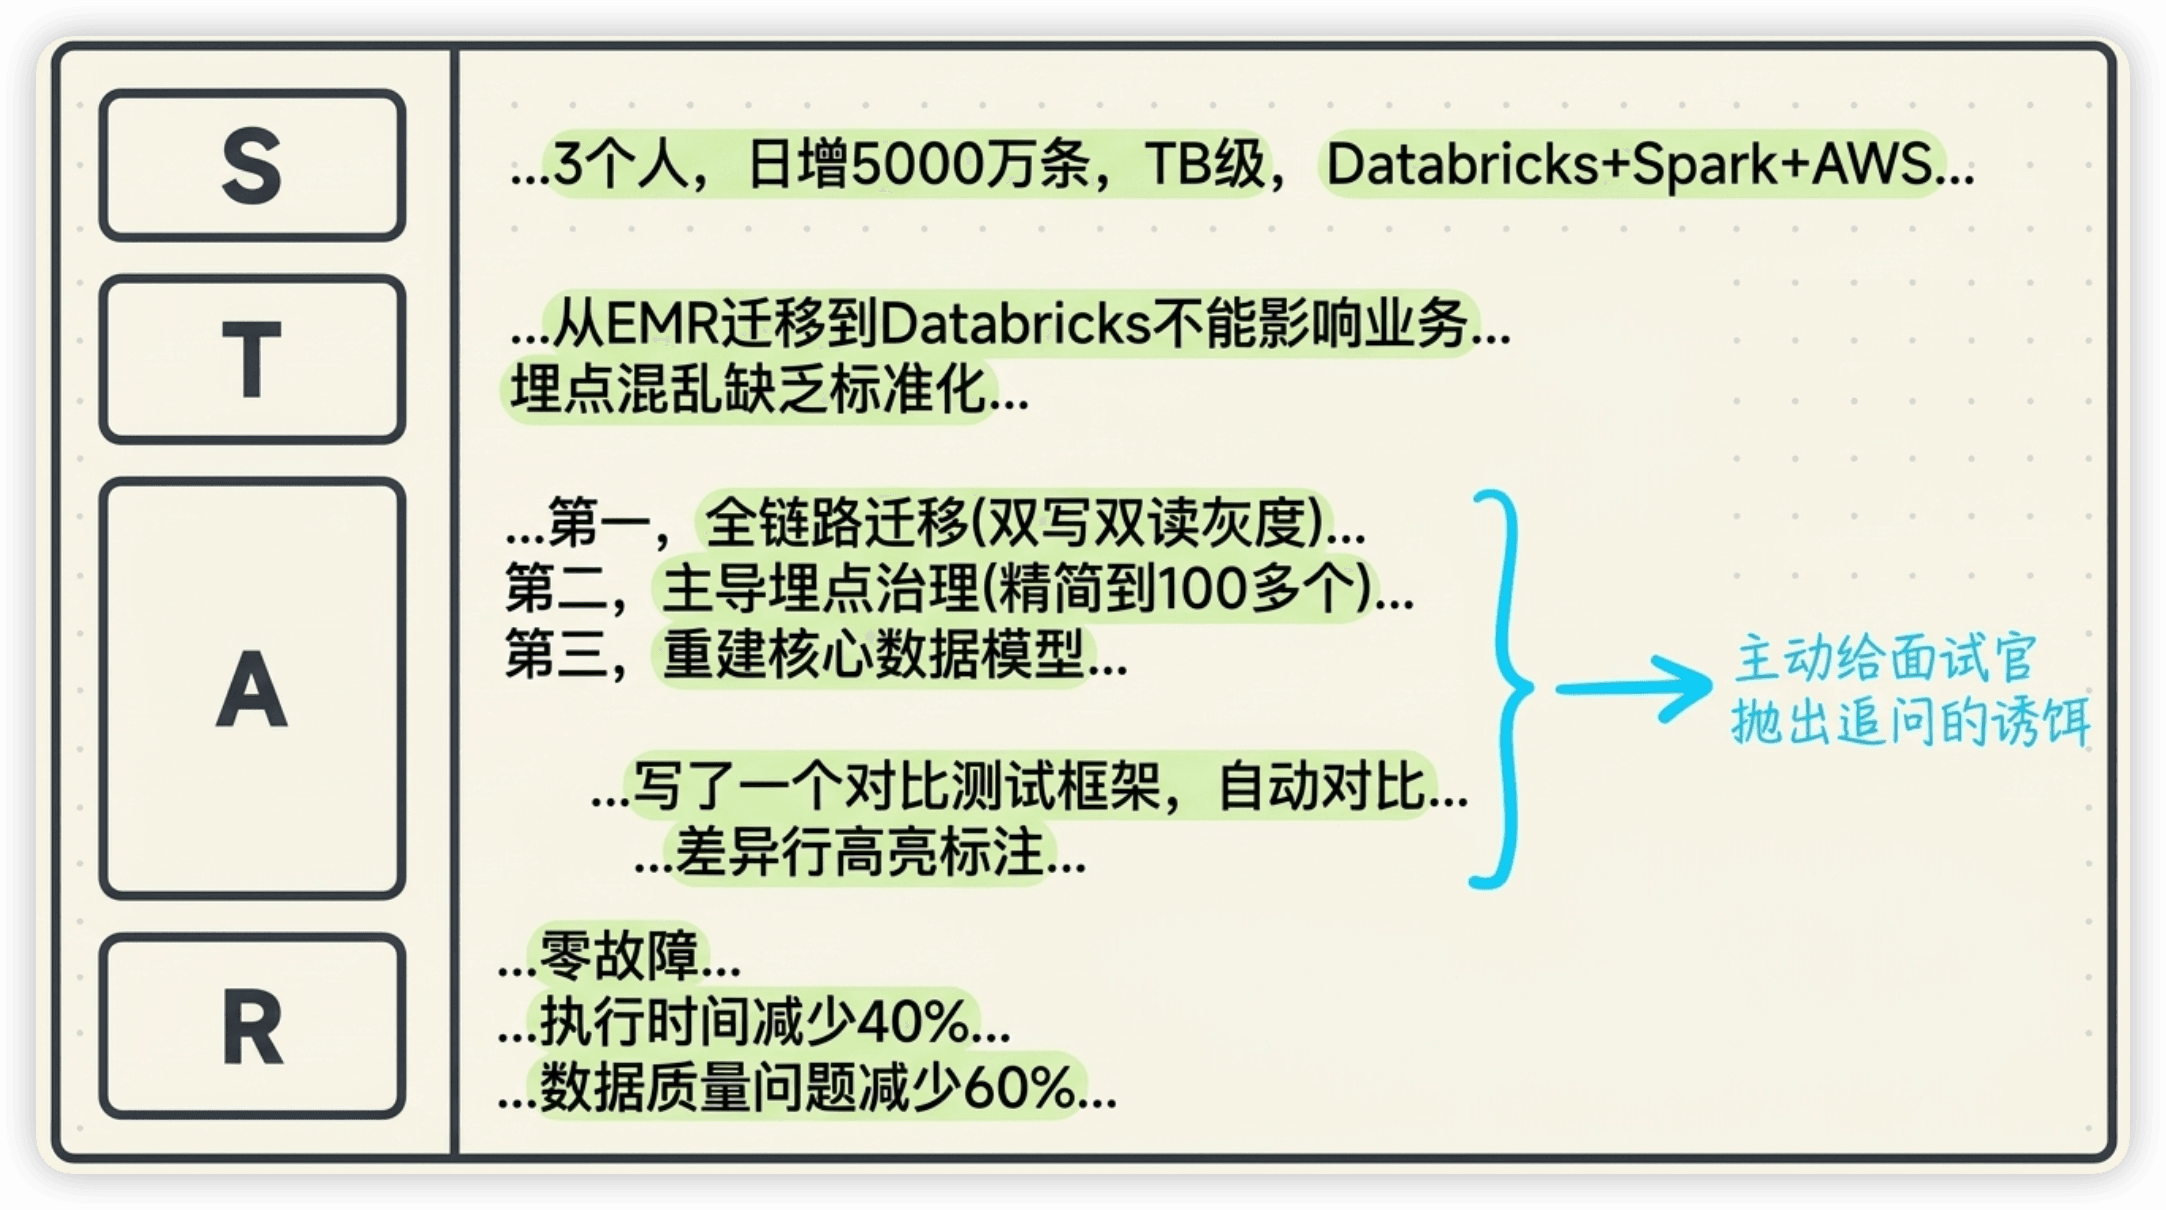
Situation:「我在某出海硬件品牌负责数据平台建设。团队3个人,日增数据约5000万条,总数据量TB级,技术栈是Databricks+Spark+AWS。」
Task:「接手时有两个核心挑战:一是公司决定从EMR迁移到Databricks,100多个Spark作业需要全部迁移且不能影响业务;二是埋点混乱,1000多个事件缺乏标准化,数据质量问题频发。」
Action:「我做了三件事。第一,独立完成了EMR到Databricks的全链路迁移——设计了双写双读灰度方案,两个平台并行运行两周,对比每个作业的输出一致性,确认无差异后才切换,实现了零故障切换。第二,主导了埋点治理——分析了所有1000多个事件的使用频率,把不再使用的清理掉,把功能重叠的合并,最终精简到100多个标准化事件。第三,重建了DWD和DWS层的核心数据模型,统一了指标口径,建立了指标字典和模型评审机制。」
「其中最有挑战的是迁移方案。两个平台的Spark版本不同,有20%的SQL因为方言差异需要微调,部分UDF的行为也不一致。我写了一个对比测试框架,自动对比每个作业在两个平台上的输出,差异行会高亮标注并人工Review。两周内逐批迁移完成100多个作业。」
Result:「迁移零故障,ETL执行时间整体减少40%。埋点治理后数据质量问题减少60%。指标口径统一后报表投诉从每周2-3次降到基本为零。」
这个回答控制在3分钟以内,但信息密度很高——面试官知道了你的团队规模、技术栈、面对的挑战、你的方案、技术细节、量化结果。
面试官追问的应对策略
3分钟概述之后,面试官一定会追问。追问不是刁难你,而是在验证——你说的是不是真做过的。
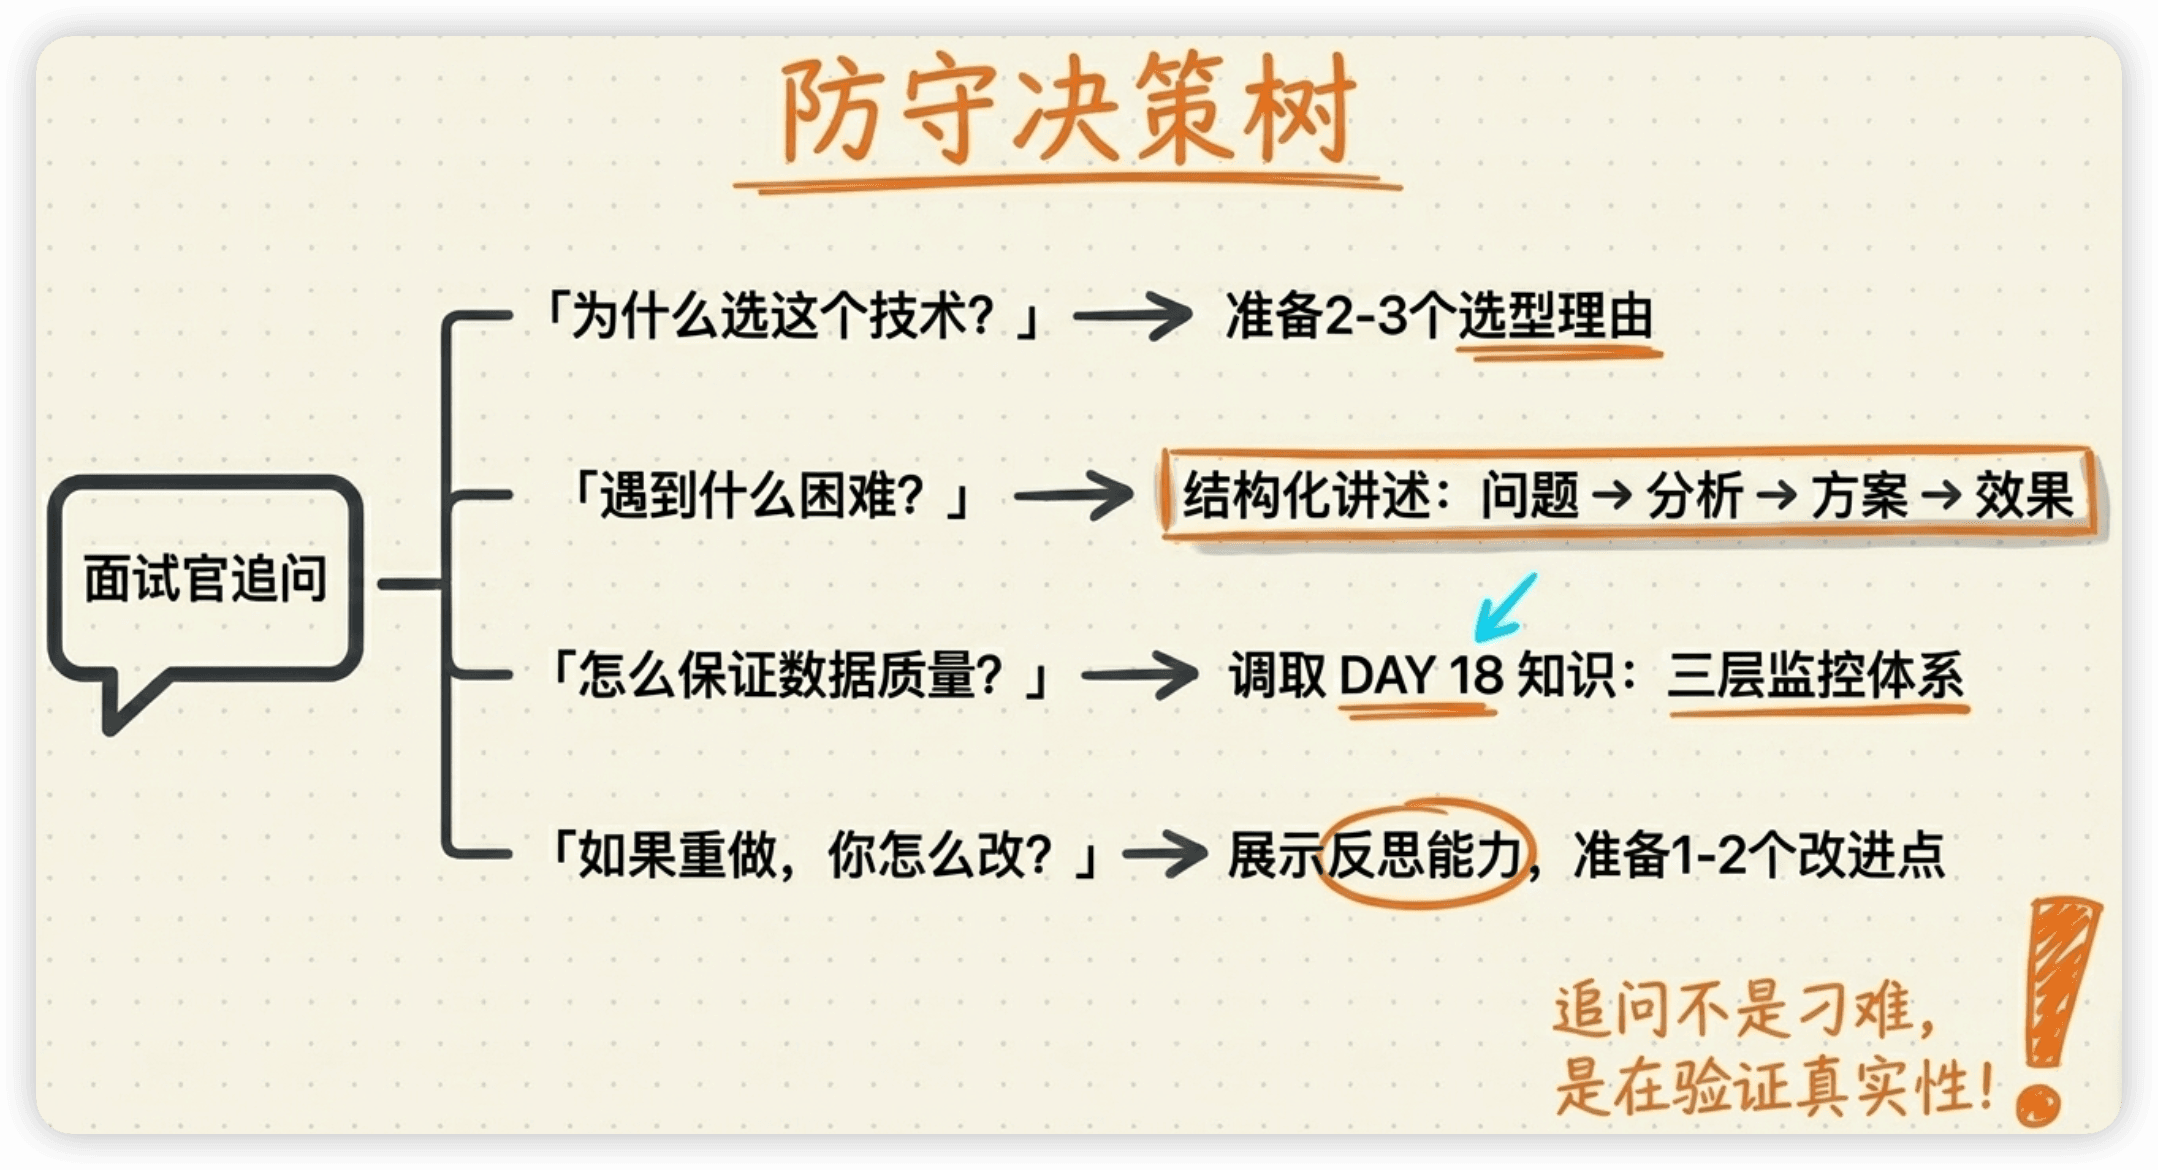
常见追问方向和准备策略
方向一:「为什么选这个技术?」
准备2-3个选型理由,每个理由从不同角度切入:
角度1:业务需求  → 「业务需要秒级查询响应,所以选了Doris而不是Hive」
角度2:团队能力  → 「团队之前用过Spark,迁移到Databricks学习成本最低」
角度3:生态兼容  → 「公司已经在用AWS,Databricks和AWS生态集成最好」
方向二:「遇到什么困难?怎么解决的?」
准备1-2个踩坑故事,用问题→分析→方案→效果的结构讲:
「迁移过程中遇到一个棘手的问题:Databricks的Spark版本和EMR的不一样,
有一个日期函数在两个平台上的行为不同,导致一批作业的日期分区偏移了一天。
排查了半天才发现是时区处理逻辑的差异。解决方案是在代码里统一用
UTC时间戳而不是DATE函数。修复后用对比框架验证了所有作业的输出一致。」
方向三:「怎么保证数据质量?」
直接用DAY 18的三层监控体系回答。
方向四:「这个数字怎么算的?」
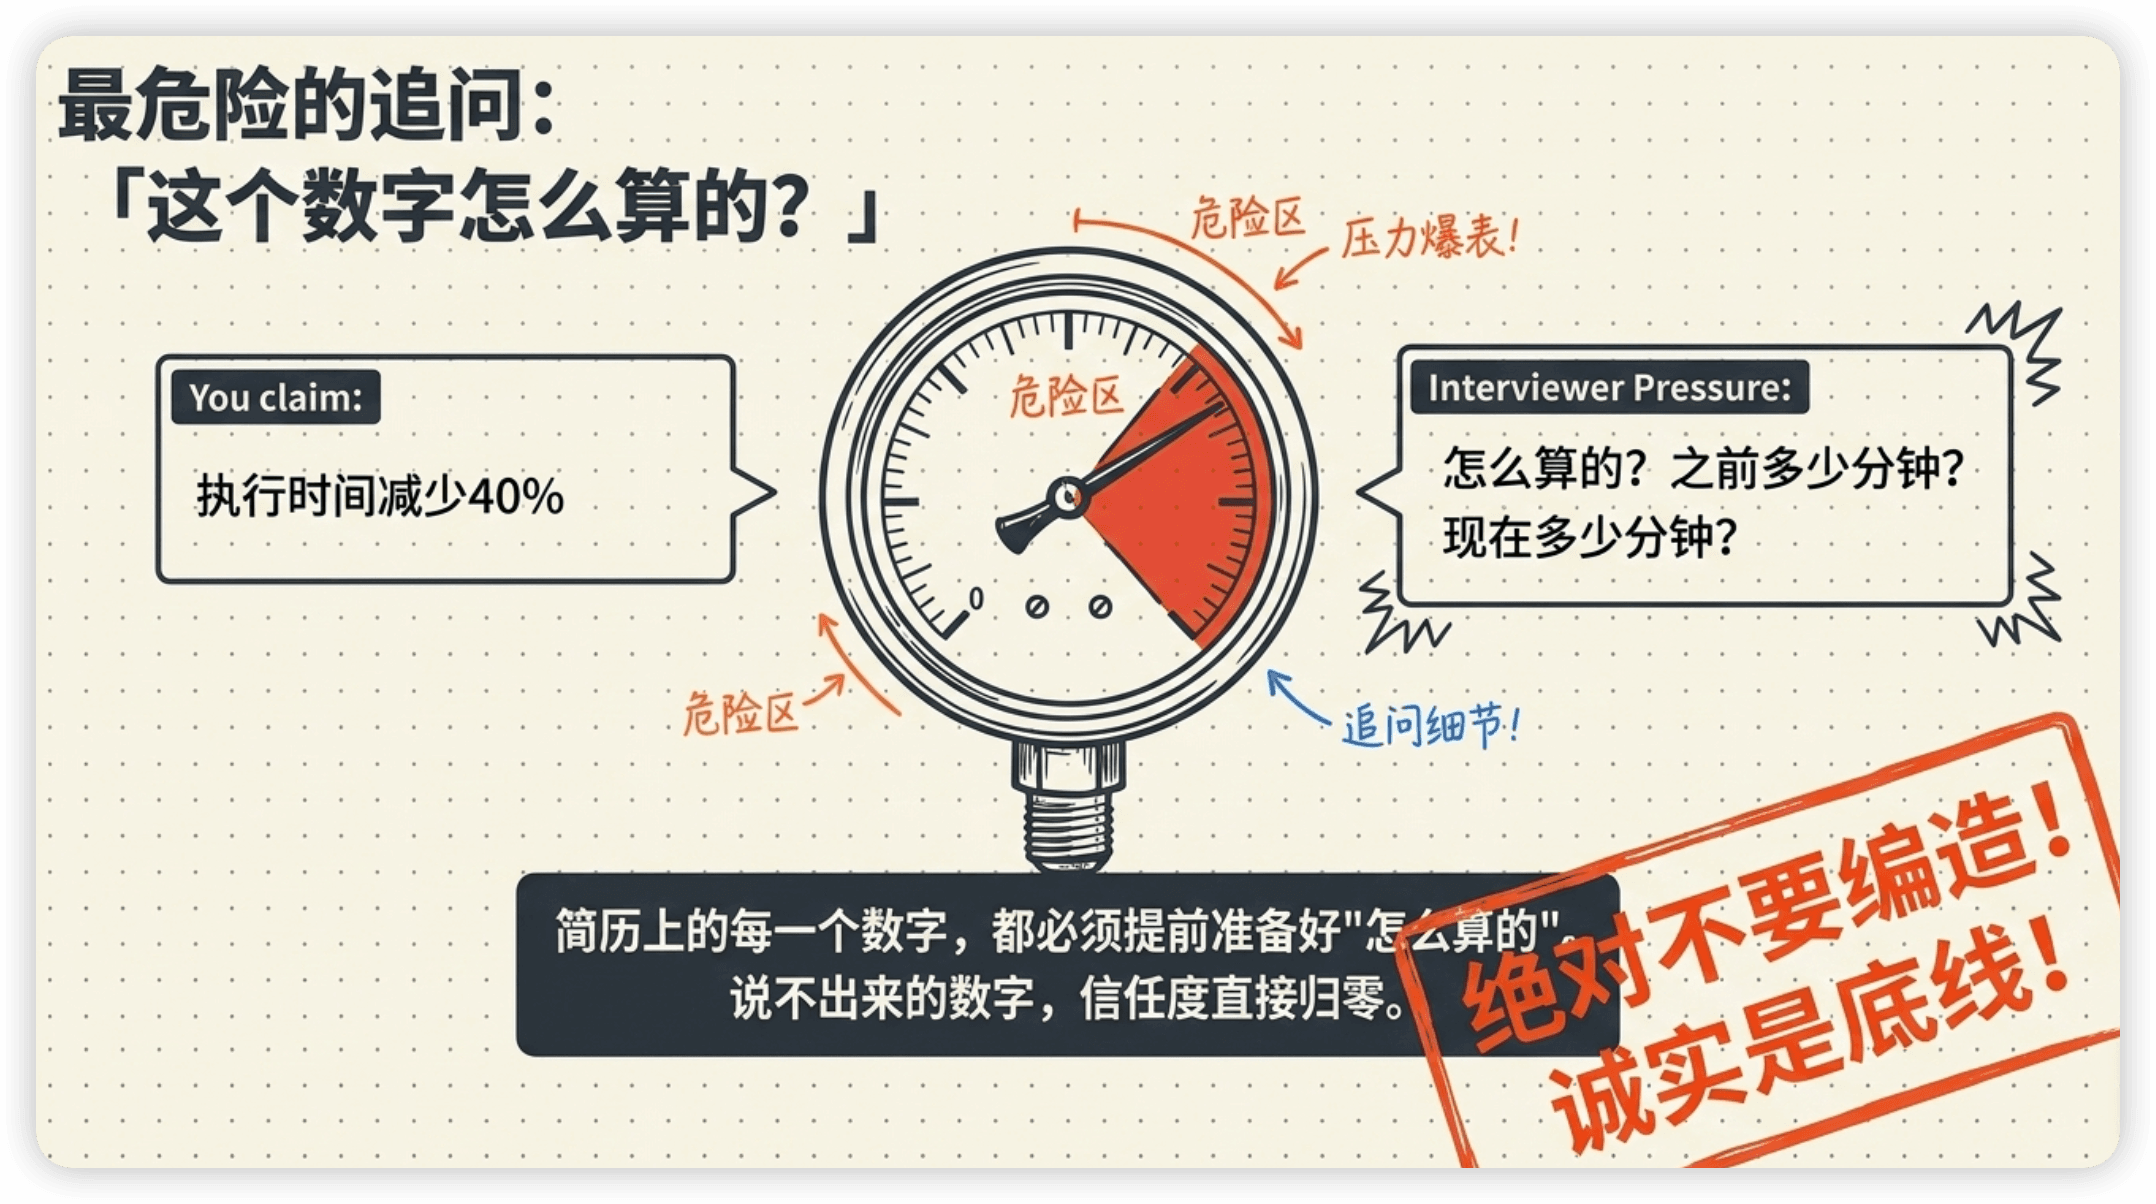
这是最危险的追问。如果你说"执行时间减少40%",面试官可能会问"40%是怎么算的?之前多少分钟?现在多少分钟?"
每个数字你都必须能说清楚来源。 说不出来的数字,信任度直接归零。
✅ "ETL执行时间从平均32分钟降到19分钟,减少了约40%"
✅ "数据质量告警从每周5-6次降到每月1-2次,减少了约80%"
❌ "性能提升了大概40%吧"(说不出具体数字)
我的做法是:简历上的每一个数字,都提前准备好"怎么算的"。面试前把所有数字过一遍,确保每个都能说出来源。
方向五:「如果重做,你会怎么改?」
这个问题考察你的反思能力。准备1-2个改进点:
「如果重做的话,我会更早建数据血缘。当时是先建了数仓再补的血缘,
中间有段时间做影响分析很痛苦——改一张表不知道下游有多少依赖。
如果一开始就在ETL脚本里自动采集血缘,就不会有这个问题了。」
简历上的项目描述怎么写?
简历是面试的"剧本"——面试官会按照简历上的项目来提问。简历写得好,面试时你就能引导话题走向你擅长的方向。
原则:每条经历 = 动作 + 量化结果
❌ 差的写法(空话):
  • 负责数仓开发和维护
  • 参与数据平台建设
  • 使用Spark/Hive进行数据处理

✅ 好的写法(具体+量化):
  • 独立完成EMR→Databricks全链路迁移(100+作业),
    设计双写双读灰度方案,实现零故障切换
  • 主导埋点治理,1000+事件精简为100+标准化事件,
    数据质量问题减少60%
  • 重建核心数仓模型(DWD/DWS),建立指标字典和模型评审机制,
    口径投诉降至零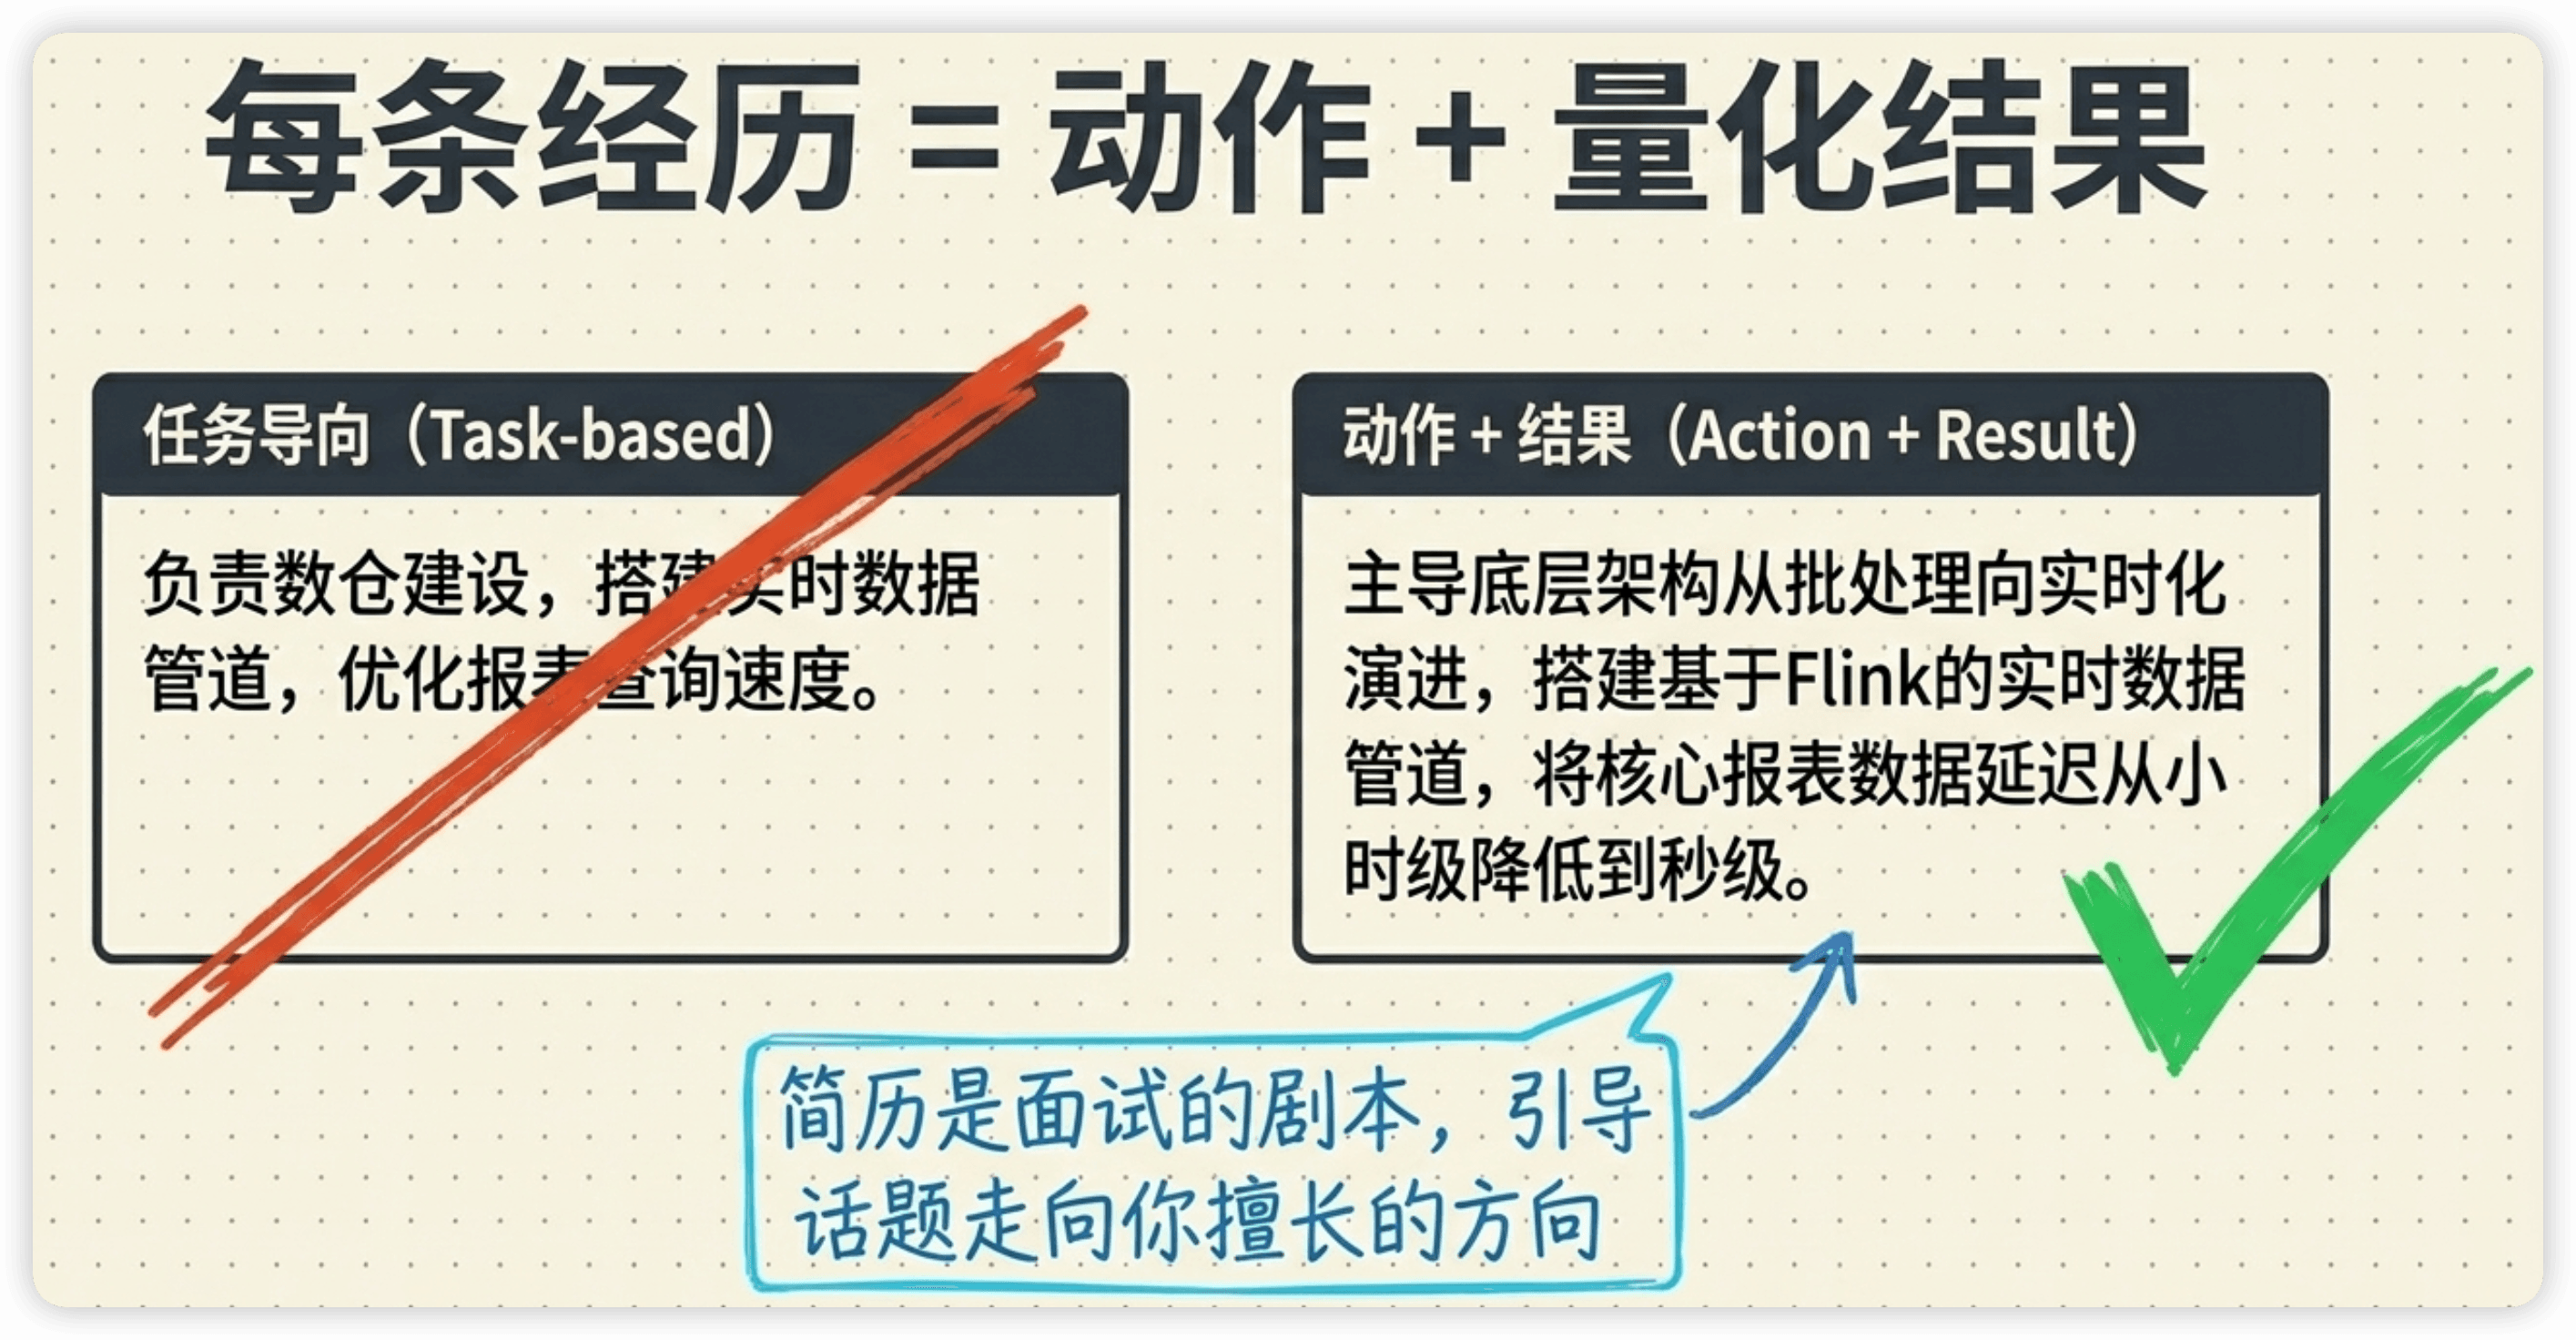
两种写法的区别一目了然。好的简历让面试官看完就知道你做过什么、做得怎么样,而不是看完只知道你"干过数仓"。
简历模板
项目名称:某出海硬件品牌数据平台建设
时间:2021.06 - 2023.12
角色:数据平台负责人(团队3人)

• 独立完成EMR→Databricks全链路迁移(100+Spark作业),
  设计双写双读灰度方案,零故障切换,ETL执行时间减少40%
• 主导埋点治理,1000+事件精简为100+标准化事件,
  数据质量问题减少60%
• 重建核心数仓模型,统一指标口径,推行模型评审Checklist,
  报表口径投诉从每周2-3次降至零

技术栈:Databricks / Spark / Delta Lake / AWS S3 / Airflow
给正在准备面试的你
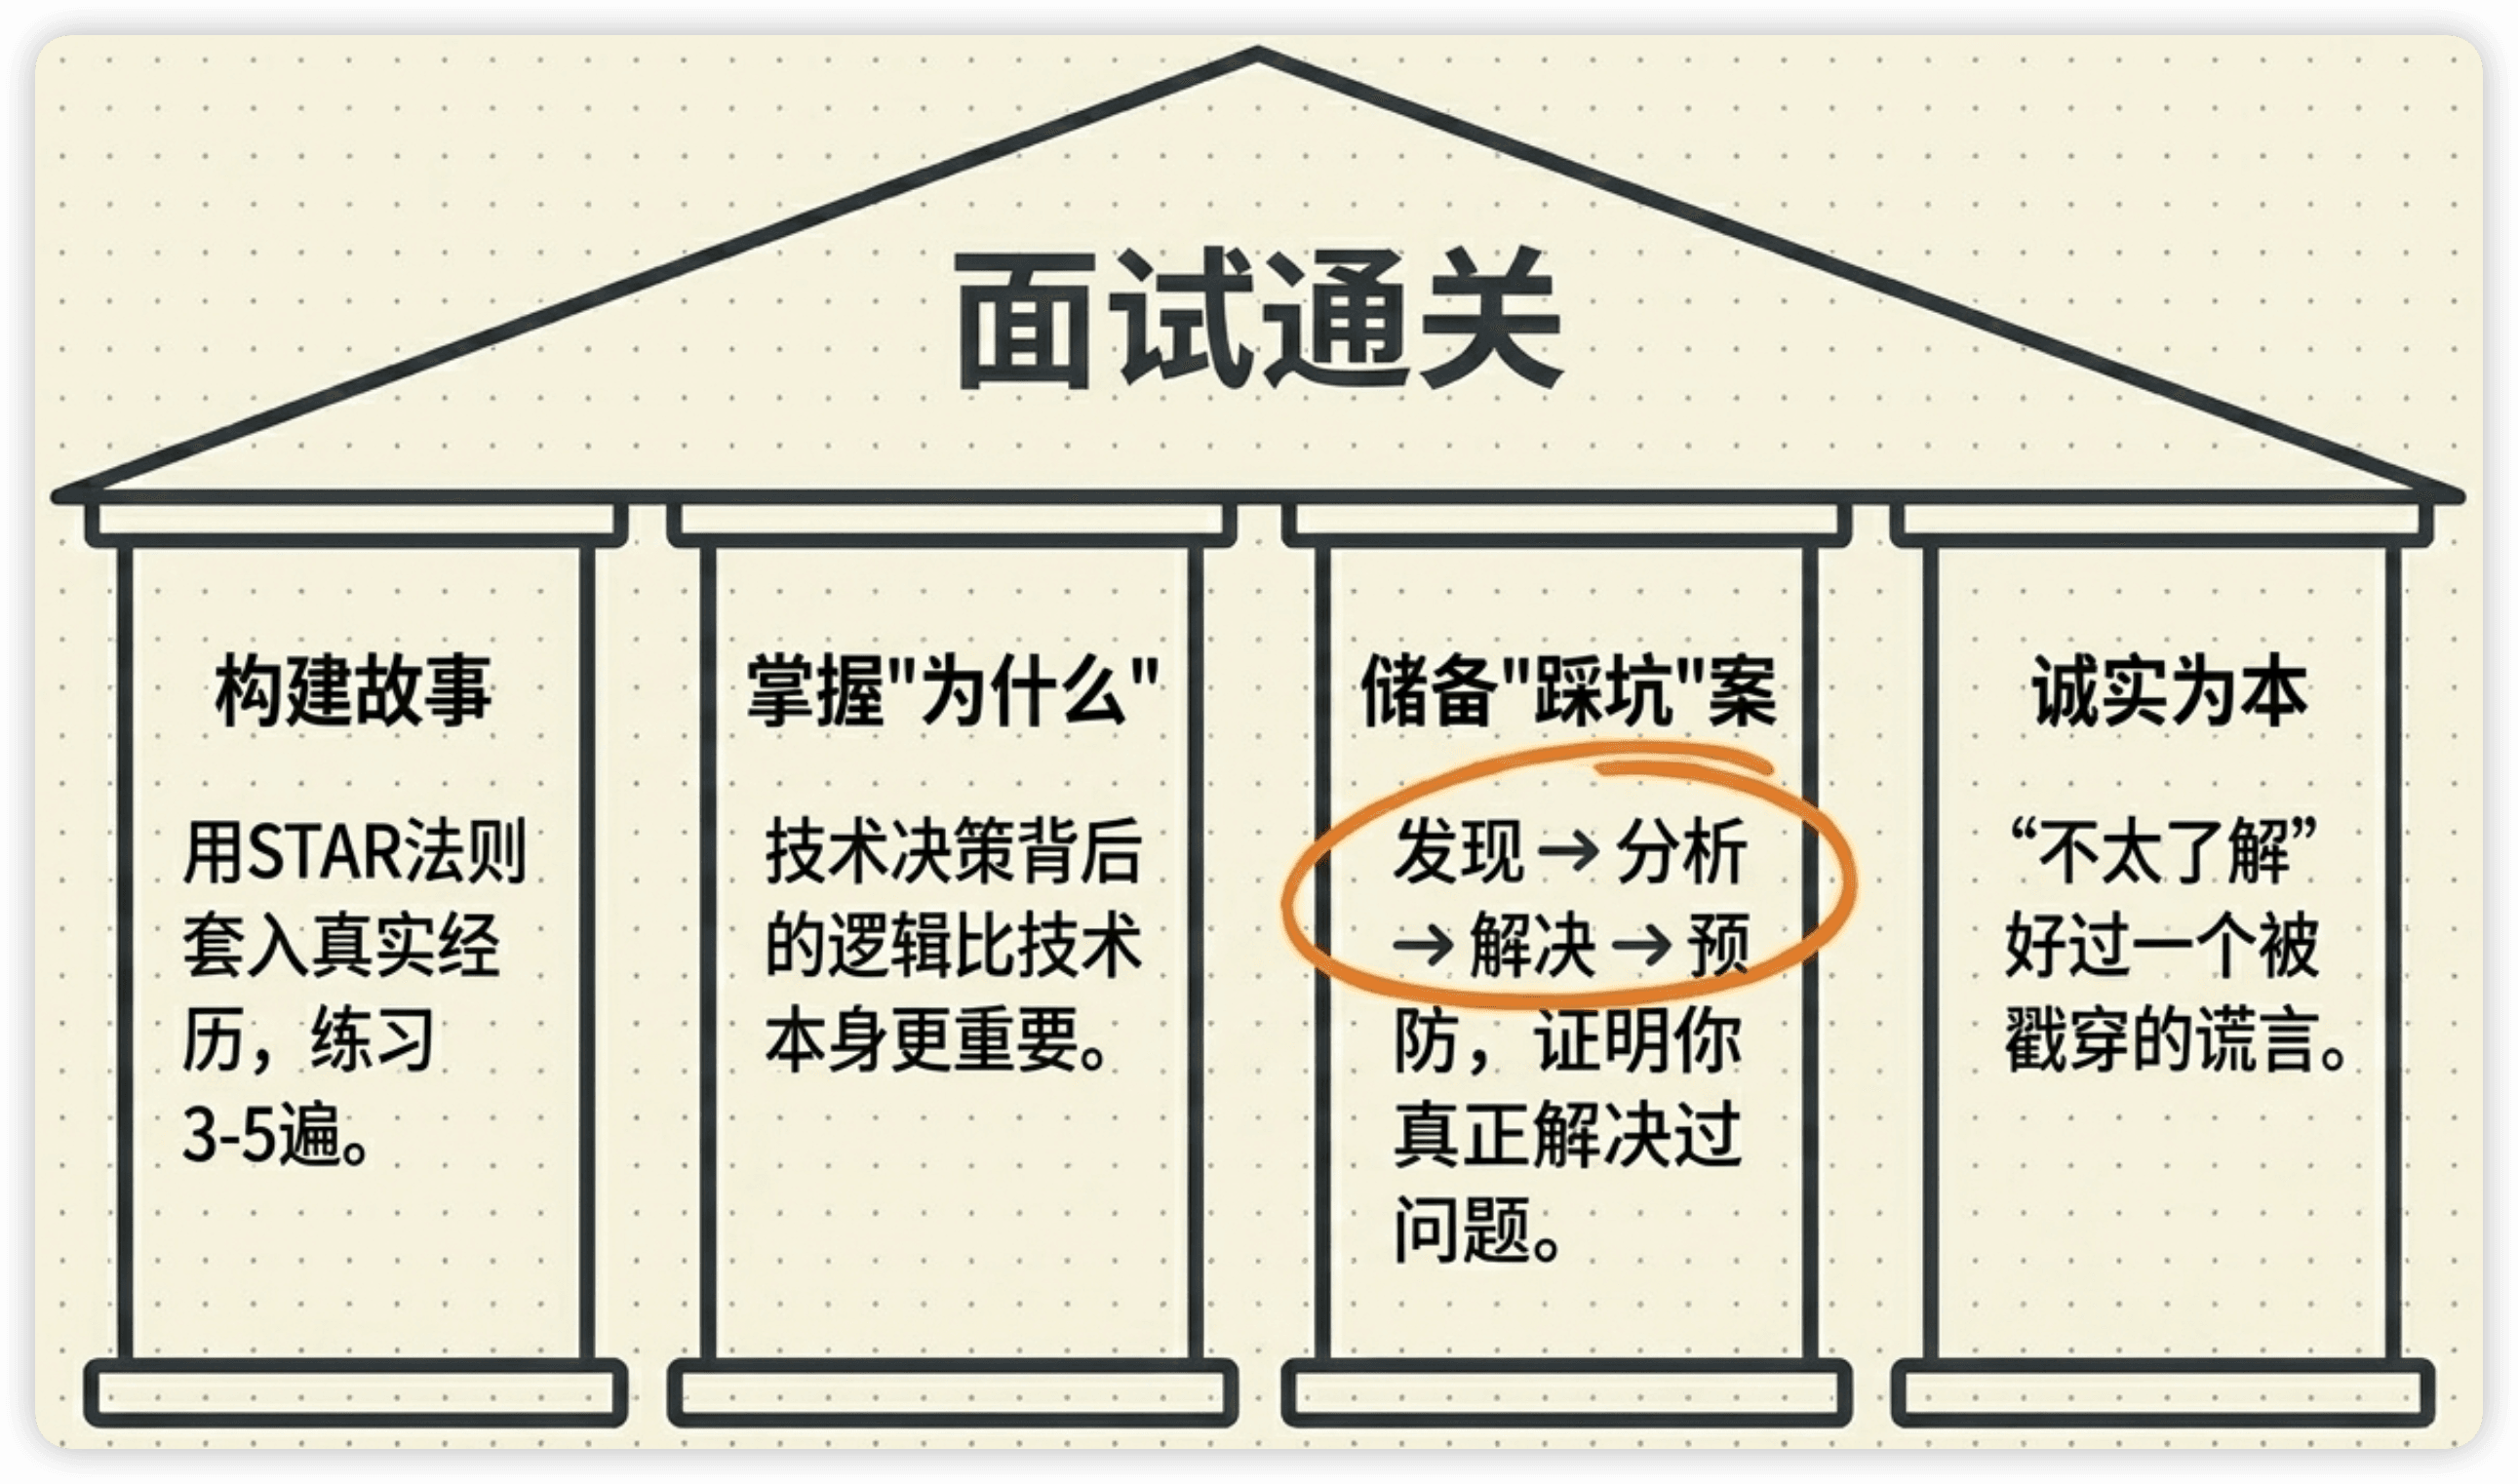
数仓建模系列20篇,从分层架构到面试表达,覆盖了数仓这个领域面试的完整链条。
最后给几个实用建议:
第一,用这20篇的知识构建你自己的项目故事。 你的经历和我的不一样,但框架是通用的。把你实际做过的事情,套进STAR法则,加上量化数字,练习讲3-5遍。
第二,每个技术决策都准备好"为什么"。 面试官不关心你用了什么技术,关心你为什么这样选。"我们用星型模型因为OLAP引擎擅长宽表+团队小维护简单"比"我们用星型模型"有信息量100倍。
第三,准备2-3个踩坑故事。 踩坑故事是面试中最有价值的素材——它证明你真做过、遇到过问题、能解决问题。把踩坑经历用"发现→分析→解决→预防"的结构准备好。
第四,诚实是底线。 数字不要夸大,没做过的不要编。面试官的经验通常比你想象的丰富,编的故事经不起追问。诚实地说"这个我不太了解"比编一个被戳穿的故事好一万倍。
数仓建模系列 · 全20篇知识地图
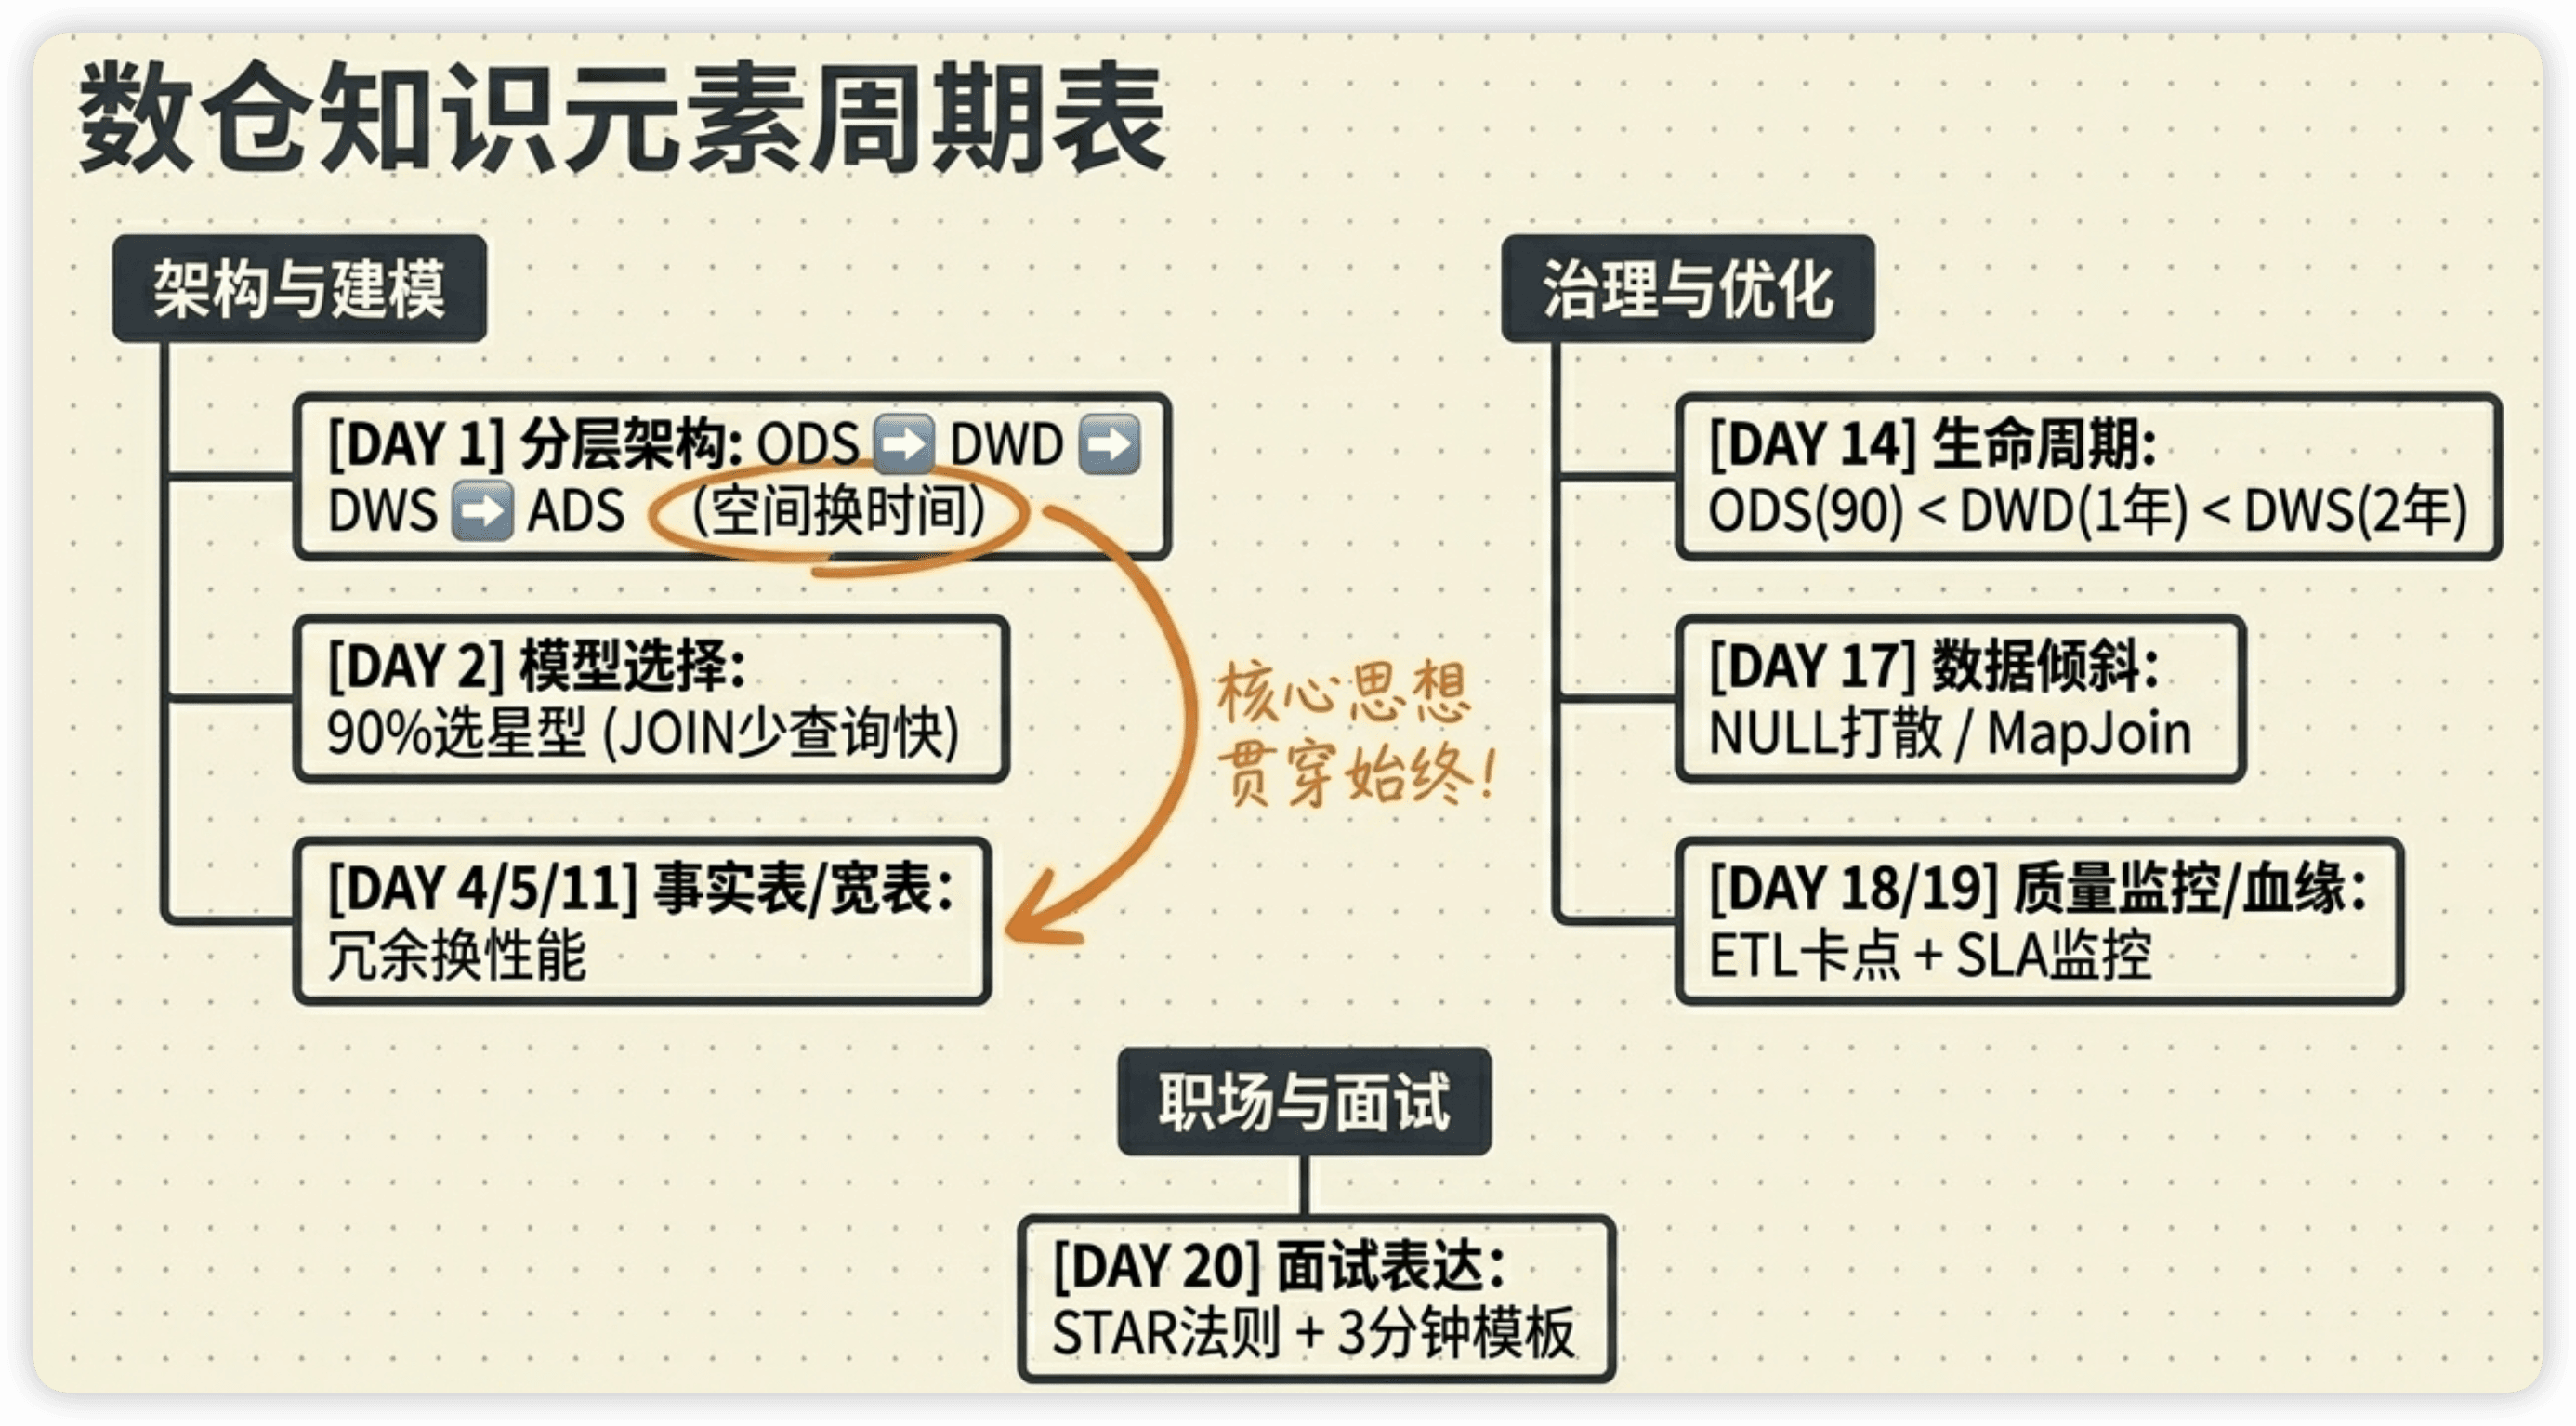
| DAY | 主题 | 核心一句话 |
|---|---|---|
| 1 | 分层架构 | ODS→DWD→DWS→ADS,以空间换时间 |
| 2 | 星型 vs 雪花 | 90%选星型,JOIN少查询快 |
| 3 | SCD拉链表 | Type 2最常用,三字段标记有效期 |
| 4 | 事实表三种类型 | 事务/快照/累积,先定粒度再设计 |
| 5 | 宽表设计 | 冗余换性能,粒度唯一,控制50-80字段 |
| 6 | 指标口径 | 一个指标一个SQL一个出口 |
| 7 | 数据膨胀 | JOIN键唯一性 + 粒度对齐 + 行数校验 |
| 8 | 命名规范 | 层级_业务域_主题_描述_粒度 |
| 9 | OneID | 确定性匹配为主,注意公共设备 |
| 10 | 模型评审 | 10项Checklist,2小时预防>1周补救 |
| 11 | Kimball vs Inmon | 互联网选Kimball,实际多混合方案 |
| 12 | 实战总结 | 5个坑 + 决策树 + 3分钟面试模板 |
| 13 | 分区策略 | 按查询模式选键,控制1万以内 |
| 14 | 生命周期管理 | ODS(90天) < DWD(1年) < DWS(2年) |
| 15 | 幂等设计 | INSERT OVERWRITE第一铁律 |
| 16 | 中间表治理 | 标记→通知→软删除→物理删除 |
| 17 | 数据倾斜 | NULL打散 / MapJoin / 加盐 / AQE |
| 18 | 质量监控 | ETL卡点 + SLA监控 + 指标巡检 |
| 19 | 数据血缘 | 从哪来、谁在用、改了影响谁 |
| 20 | 面试表达 | STAR法则 + 3分钟模板 + 量化数字 |
🎉 数仓建模系列20讲,全部完结!
 从DAY 1的分层架构到DAY 20的面试表达,这20篇覆盖了数仓建模面试的完整知识体系——不只是"怎么做",还有"怎么讲"。
祝每一个正在准备面试的你,都能拿到心仪的offer。技术是硬功夫,表达是软实力,两者缺一不可。