Kimball vs Inmon两大建模方法论,到底该选哪个
面试被问"Kimball和Inmon有什么区别",大多数人能答出"自下而上"和"自上而下"。但面试官紧接着追一句"你们公司用的是哪种?为什么?实际项目中是纯Kimball还是有变体?",就开始支支吾吾了。
这道题是高阶面试题,考的不是概念辨析,而是你的架构选型思维——你能不能结合团队规模、业务特点、技术栈做出合理的判断,并说清楚背后的取舍。
先说结论
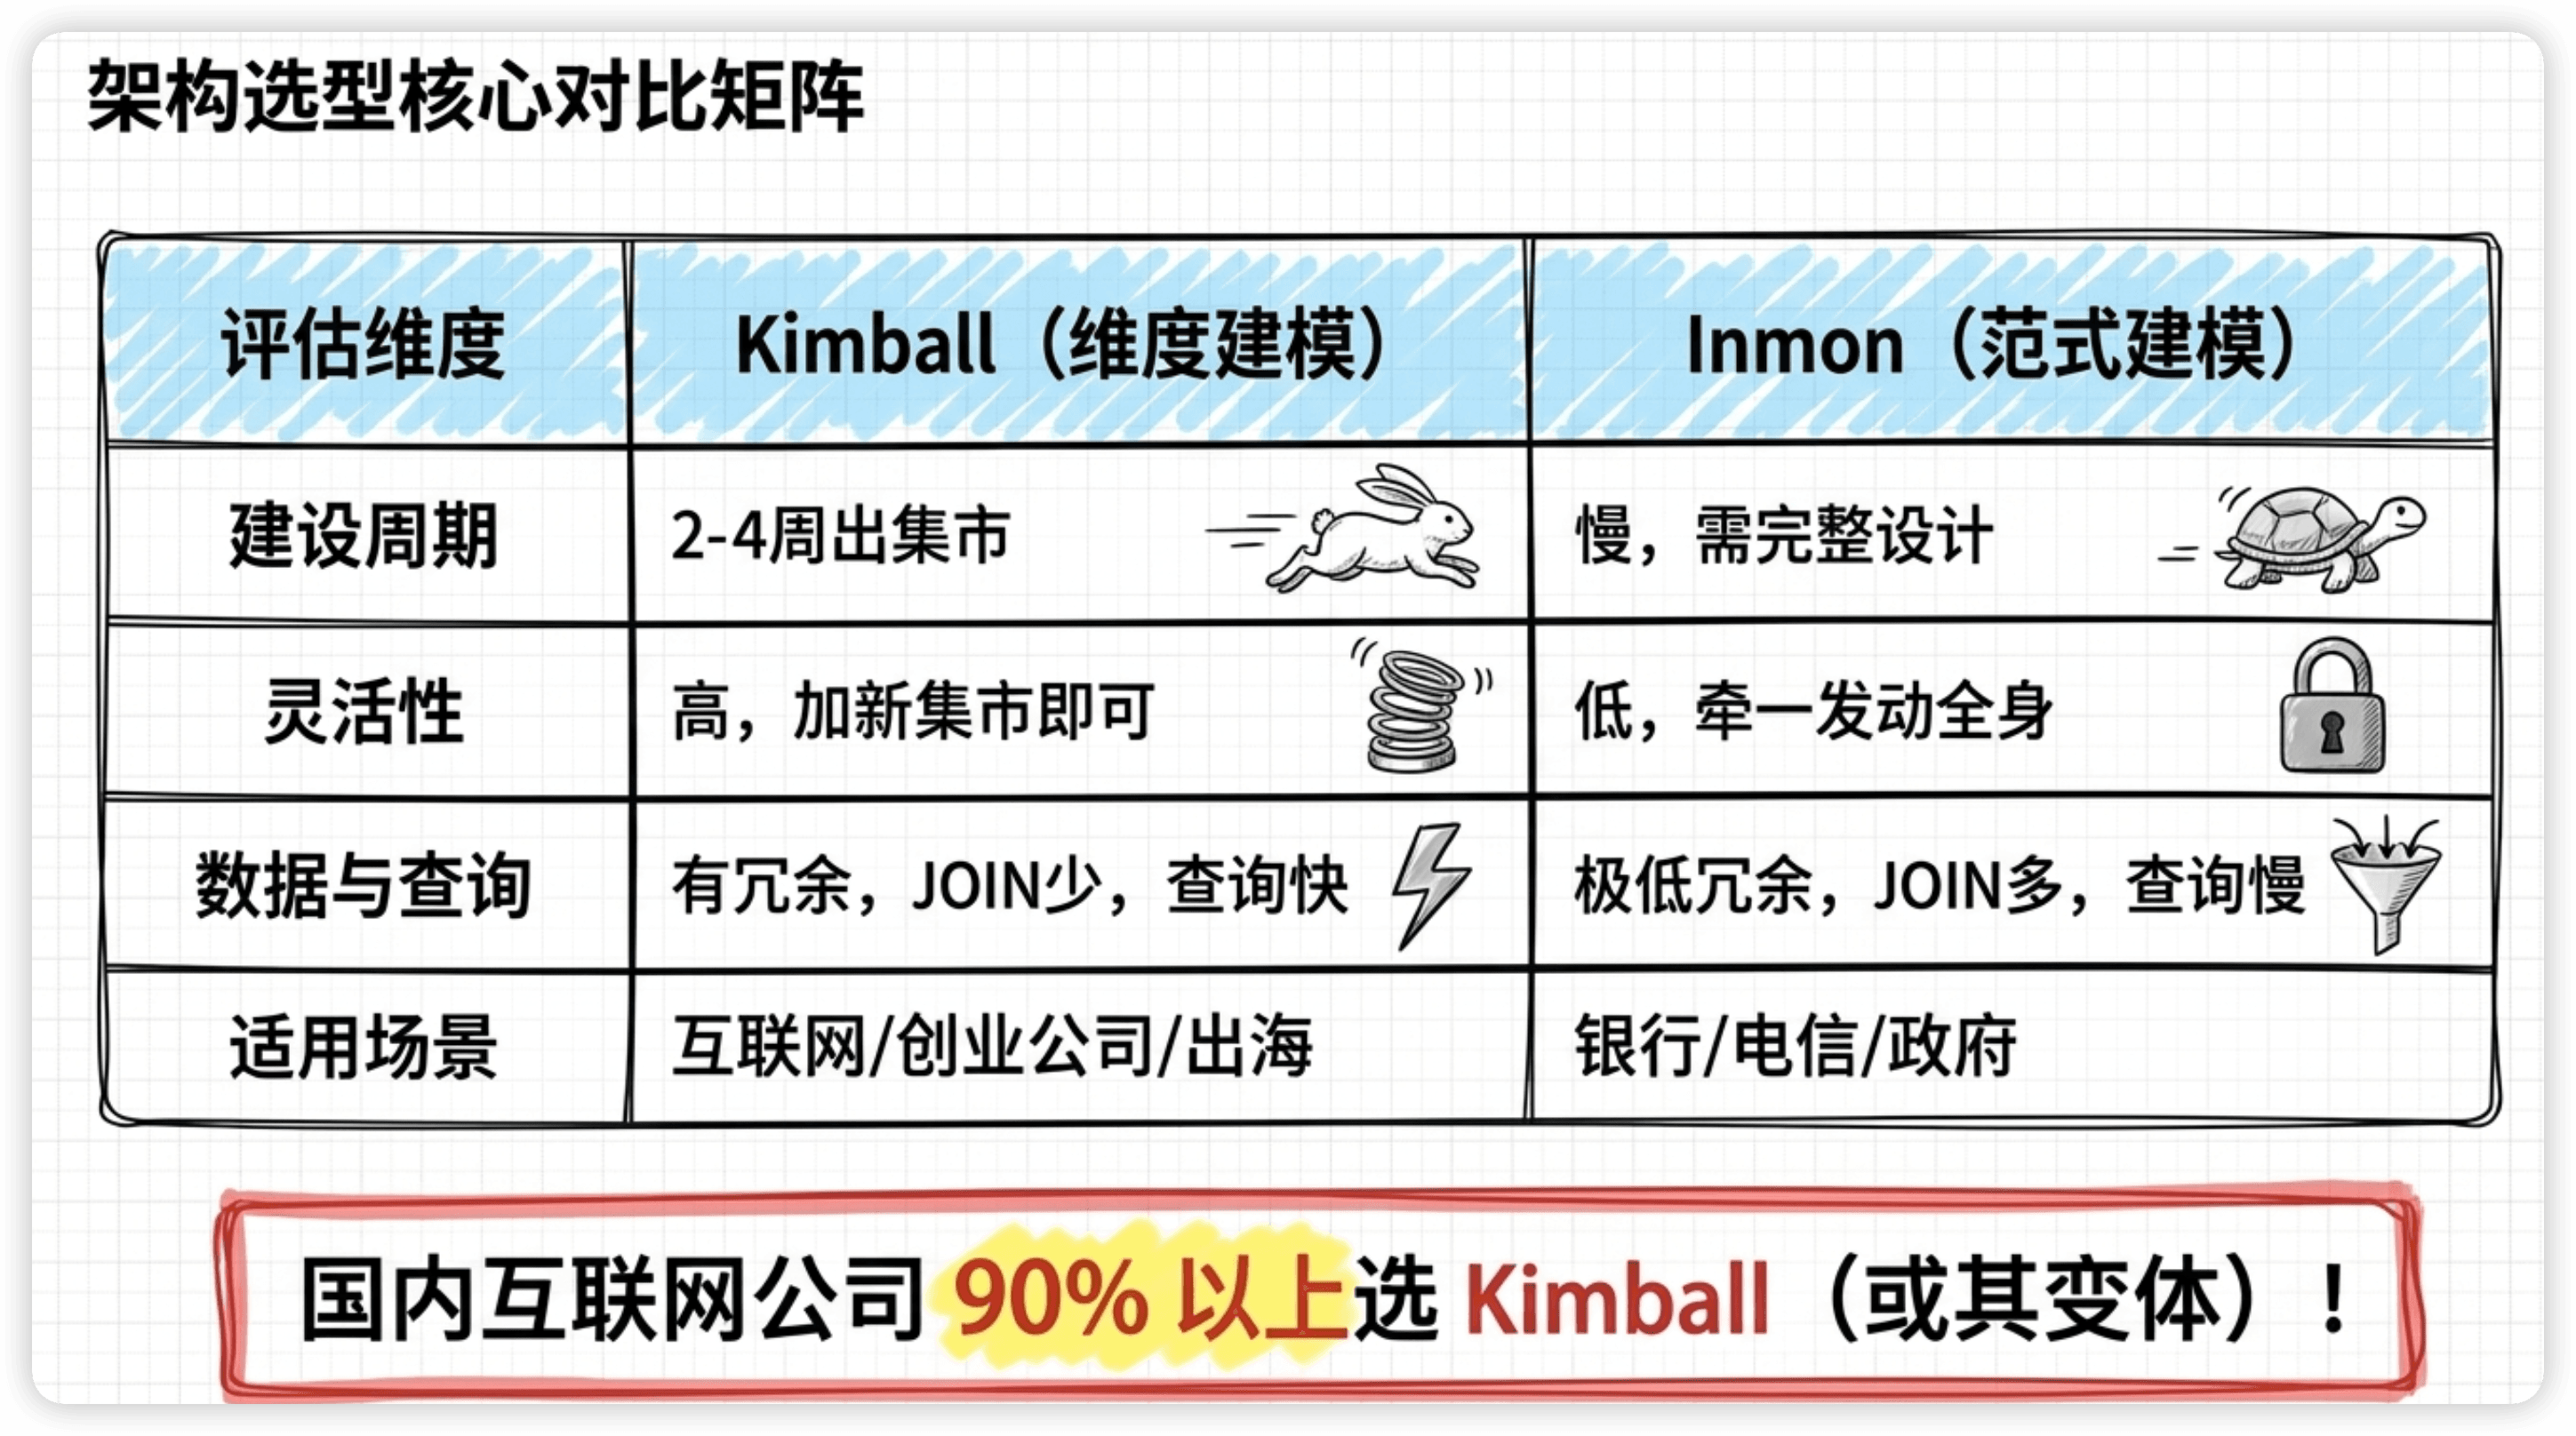
国内互联网公司90%以上用的是Kimball(维度建模),或者更准确地说,是Kimball的变体。
Inmon在传统企业(银行、电信、制造业)还有不少应用,但在互联网和大数据领域,Kimball是绝对主流。
但——纯粹的Kimball或纯粹的Inmon在实际项目中其实很少见。大部分公司用的是混合方案,只是比例偏向不同。
核心区别:两种完全不同的建设思路
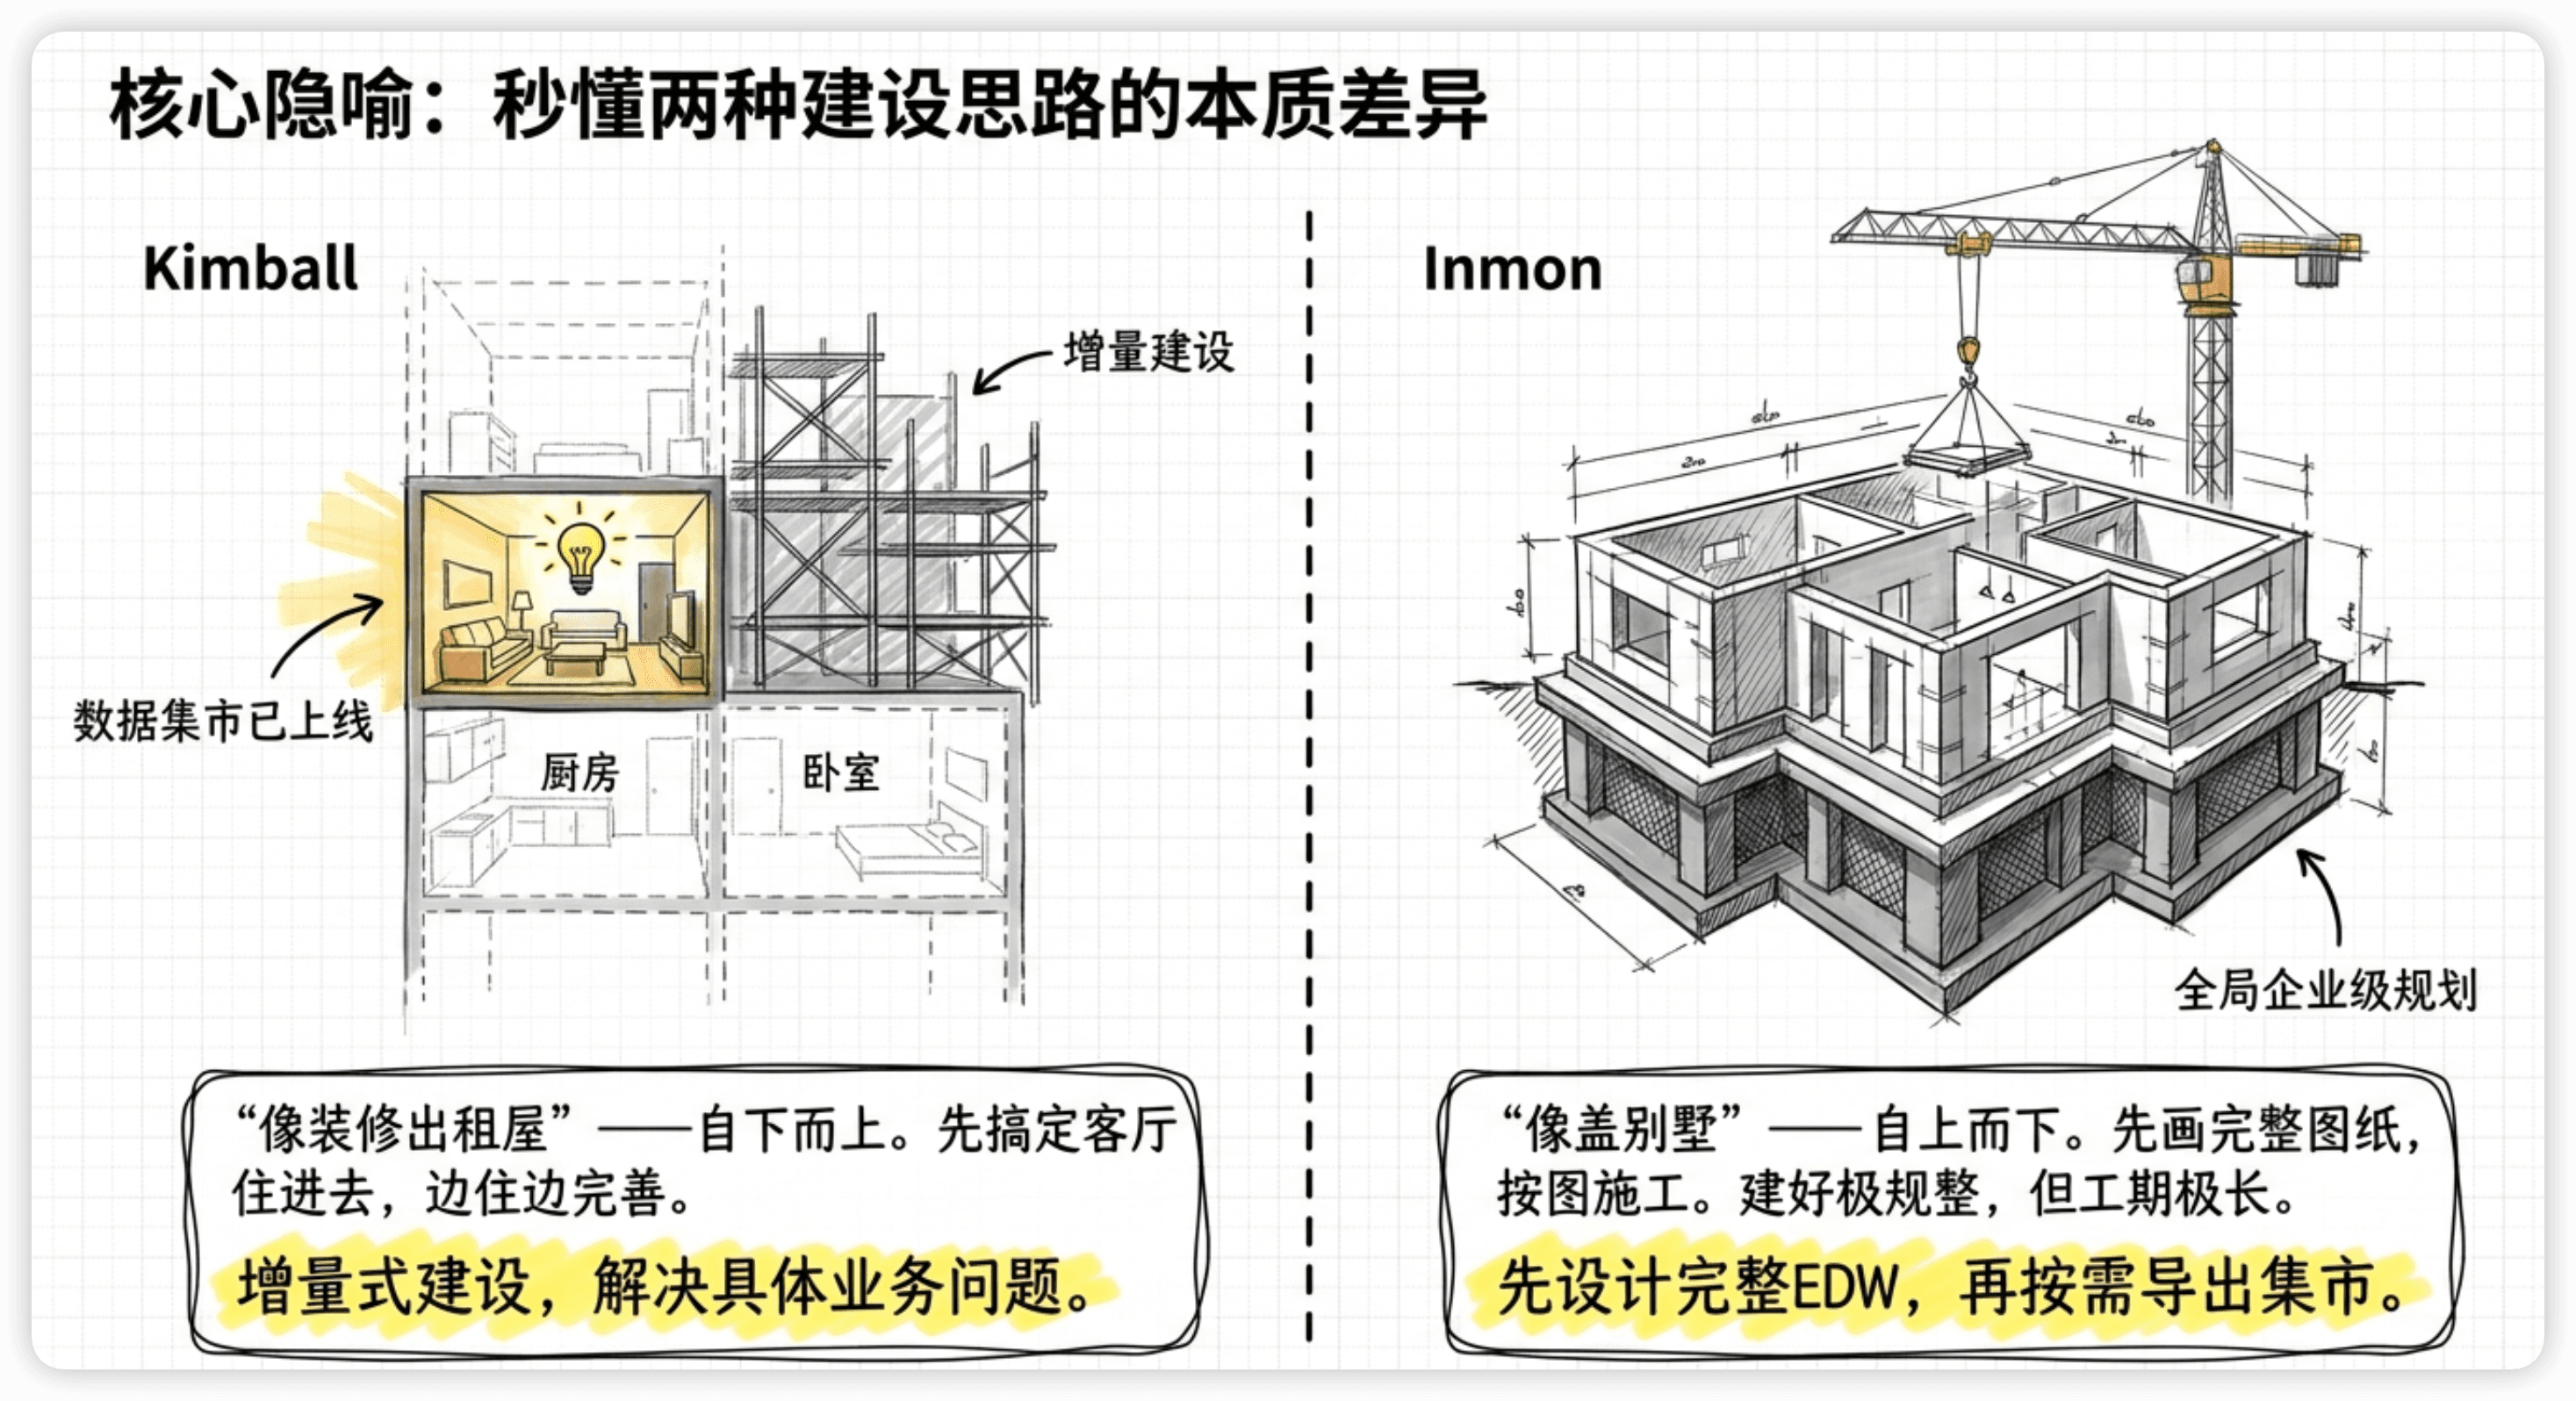
Kimball:自下而上,先解决具体问题
Kimball的核心思路是:从业务需求出发,先建一个个数据集市,解决具体的分析问题,再逐步整合。
业务方说"我要看交易数据"
→ 建交易域数据集市:fact_order + dim_user + dim_product(星型模型)
→ 2-4周搞定,业务能立刻用

业务方又说"我要看广告效果"
→ 建广告域数据集市:fact_ad_click + dim_channel + dim_campaign
→ 又2-4周搞定

两个集市要联合分析
→ 通过一致性维度(Conformed Dimensions)共用同一张dim_user
→ 就能做跨域分析整个过程是增量式的——先能用,再完善。不需要一开始就想清楚所有的数据关系。
Inmon:自上而下,先设计全局再拆分
Inmon的核心思路完全相反:先设计一个完整的、规范化的企业数据仓库(EDW),然后从EDW中按需导出数据集市。
数据架构师花3-6个月梳理全公司的数据关系
→ 设计企业级数据模型(第三范式/3NF)
→ 建设企业数据仓库(EDW)

业务方说"我要看交易数据"
→ 从EDW中导出交易域数据集市

业务方又说"我要看广告效果"
→ 同样从EDW导出,天然和交易域一致
→ 因为源头是同一个EDW
用一个类比记住
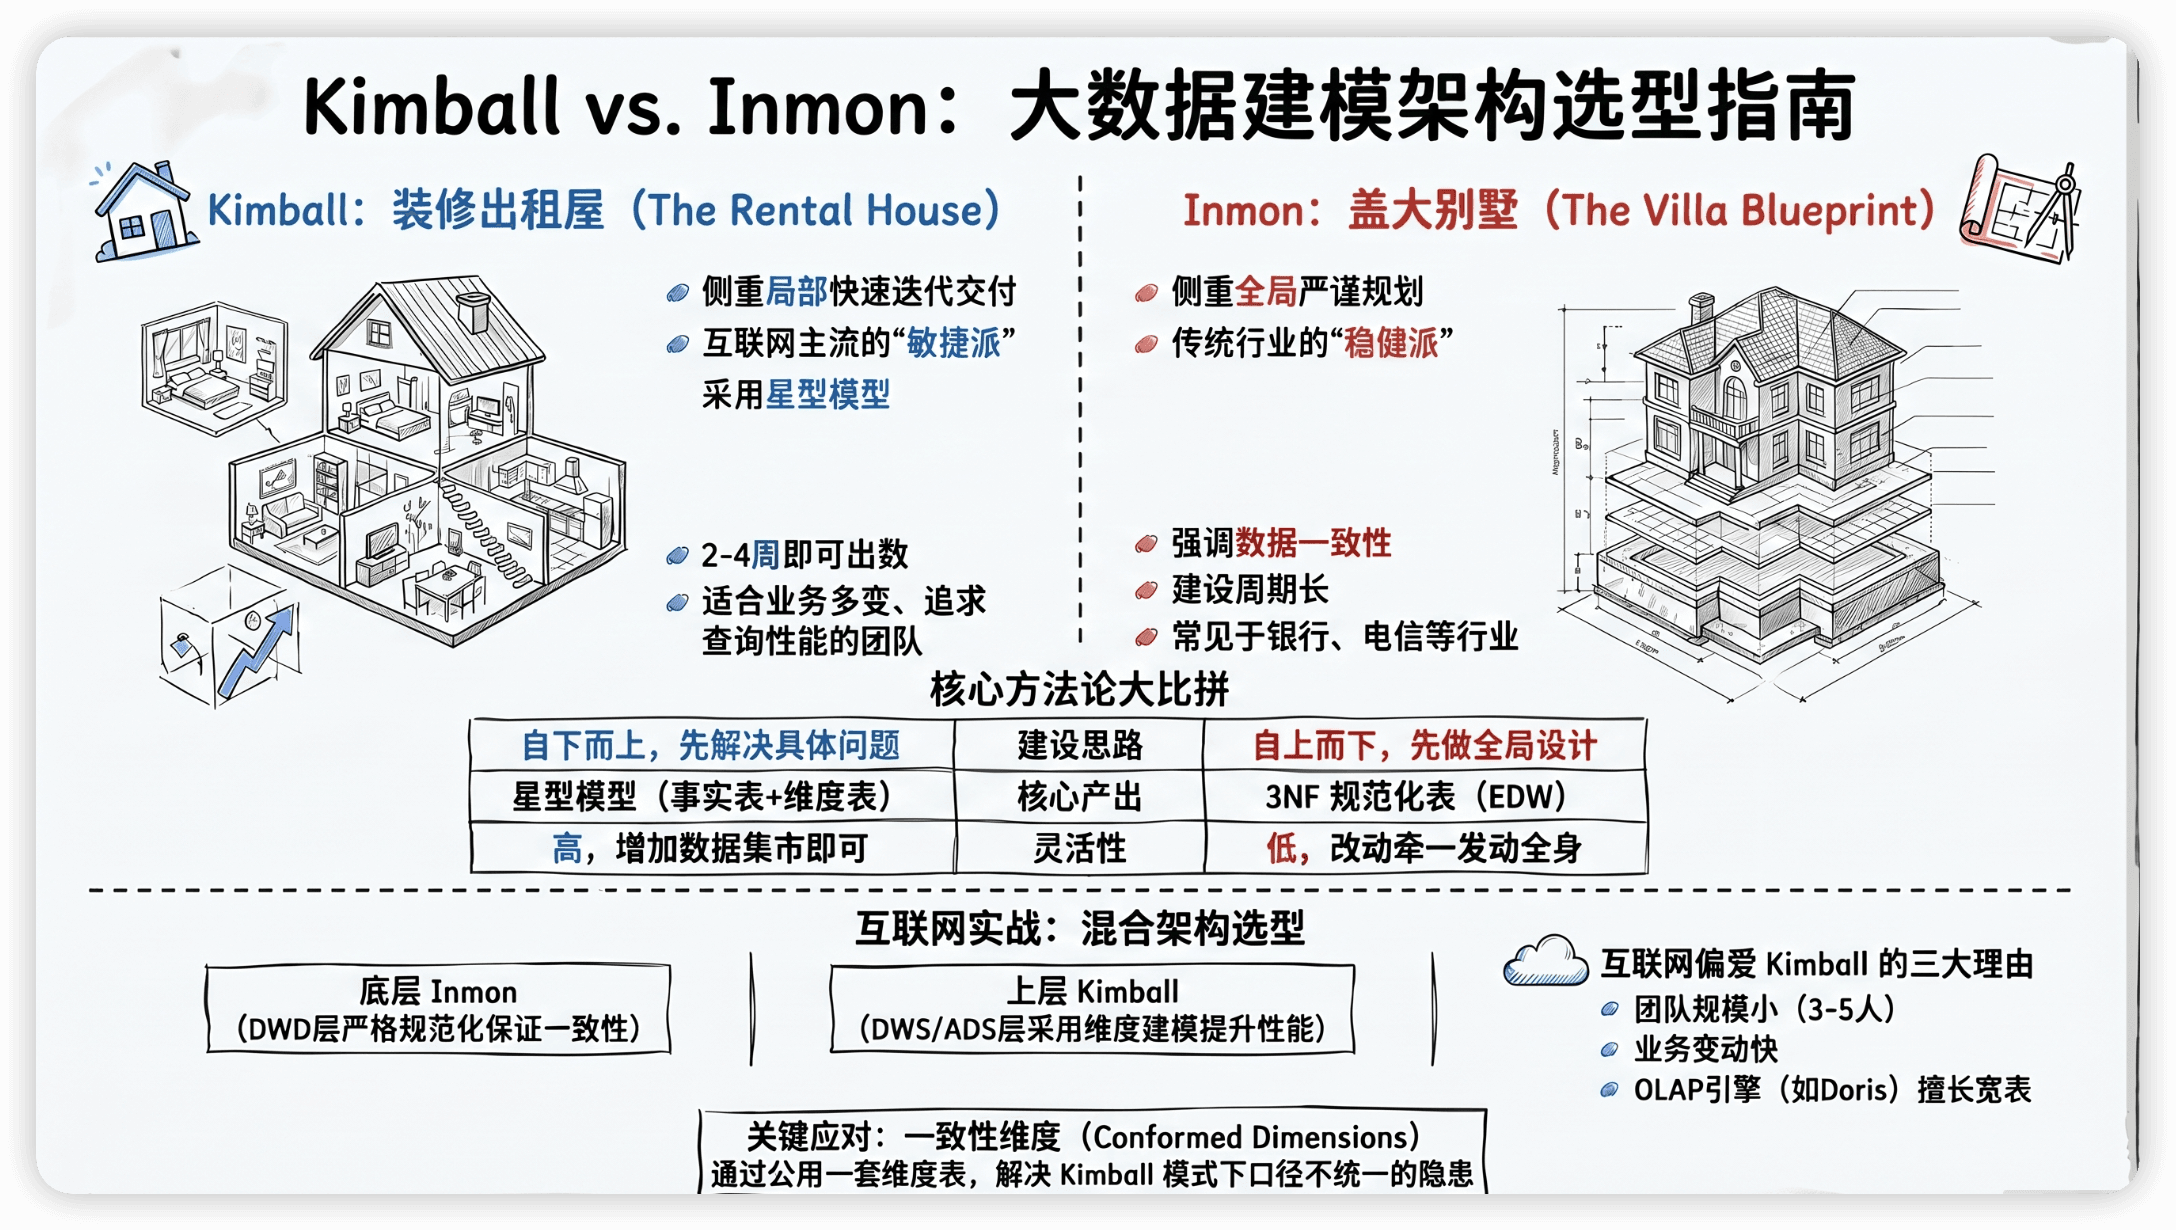
Kimball像装修出租屋——先把客厅搞好能住进去,卧室下周再弄,厨房下个月再说。边住边完善。
Inmon像盖别墅——先找建筑师画完整图纸,地基、水电、承重墙全部规划好,然后按图施工。建好之后很规整,但工期长、造价高。
互联网公司为什么选Kimball?因为业务变化太快——你花3个月画好图纸,可能业务方向已经变了。
完整对比
| 对比项 | Kimball(维度建模) | Inmon(范式建模) |
|---|---|---|
| 建设思路 | 自下而上,先解决具体问题 | 自上而下,先全局设计 |
| 核心产出 | 星型模型(事实表+维度表) | 3NF范式化表(EDW) |
| 建设周期 | 快,2-4周出第一个数据集市 | 慢,需要完整设计后才能用 |
| 灵活性 | 高,新需求加新集市就行 | 低,改动牵一发动全身 |
| 数据冗余 | 有冗余,存储换性能 | 低冗余,严格规范化 |
| 查询性能 | 好,JOIN少 | 差,JOIN多 |
| 数据一致性 | 需要额外保证(一致性维度) | 天然一致(单一EDW) |
| 适合的团队 | 小团队,快速迭代 | 大团队,长期规划 |
| 典型用户 | 互联网、创业公司、出海公司 | 银行、电信、政府 |
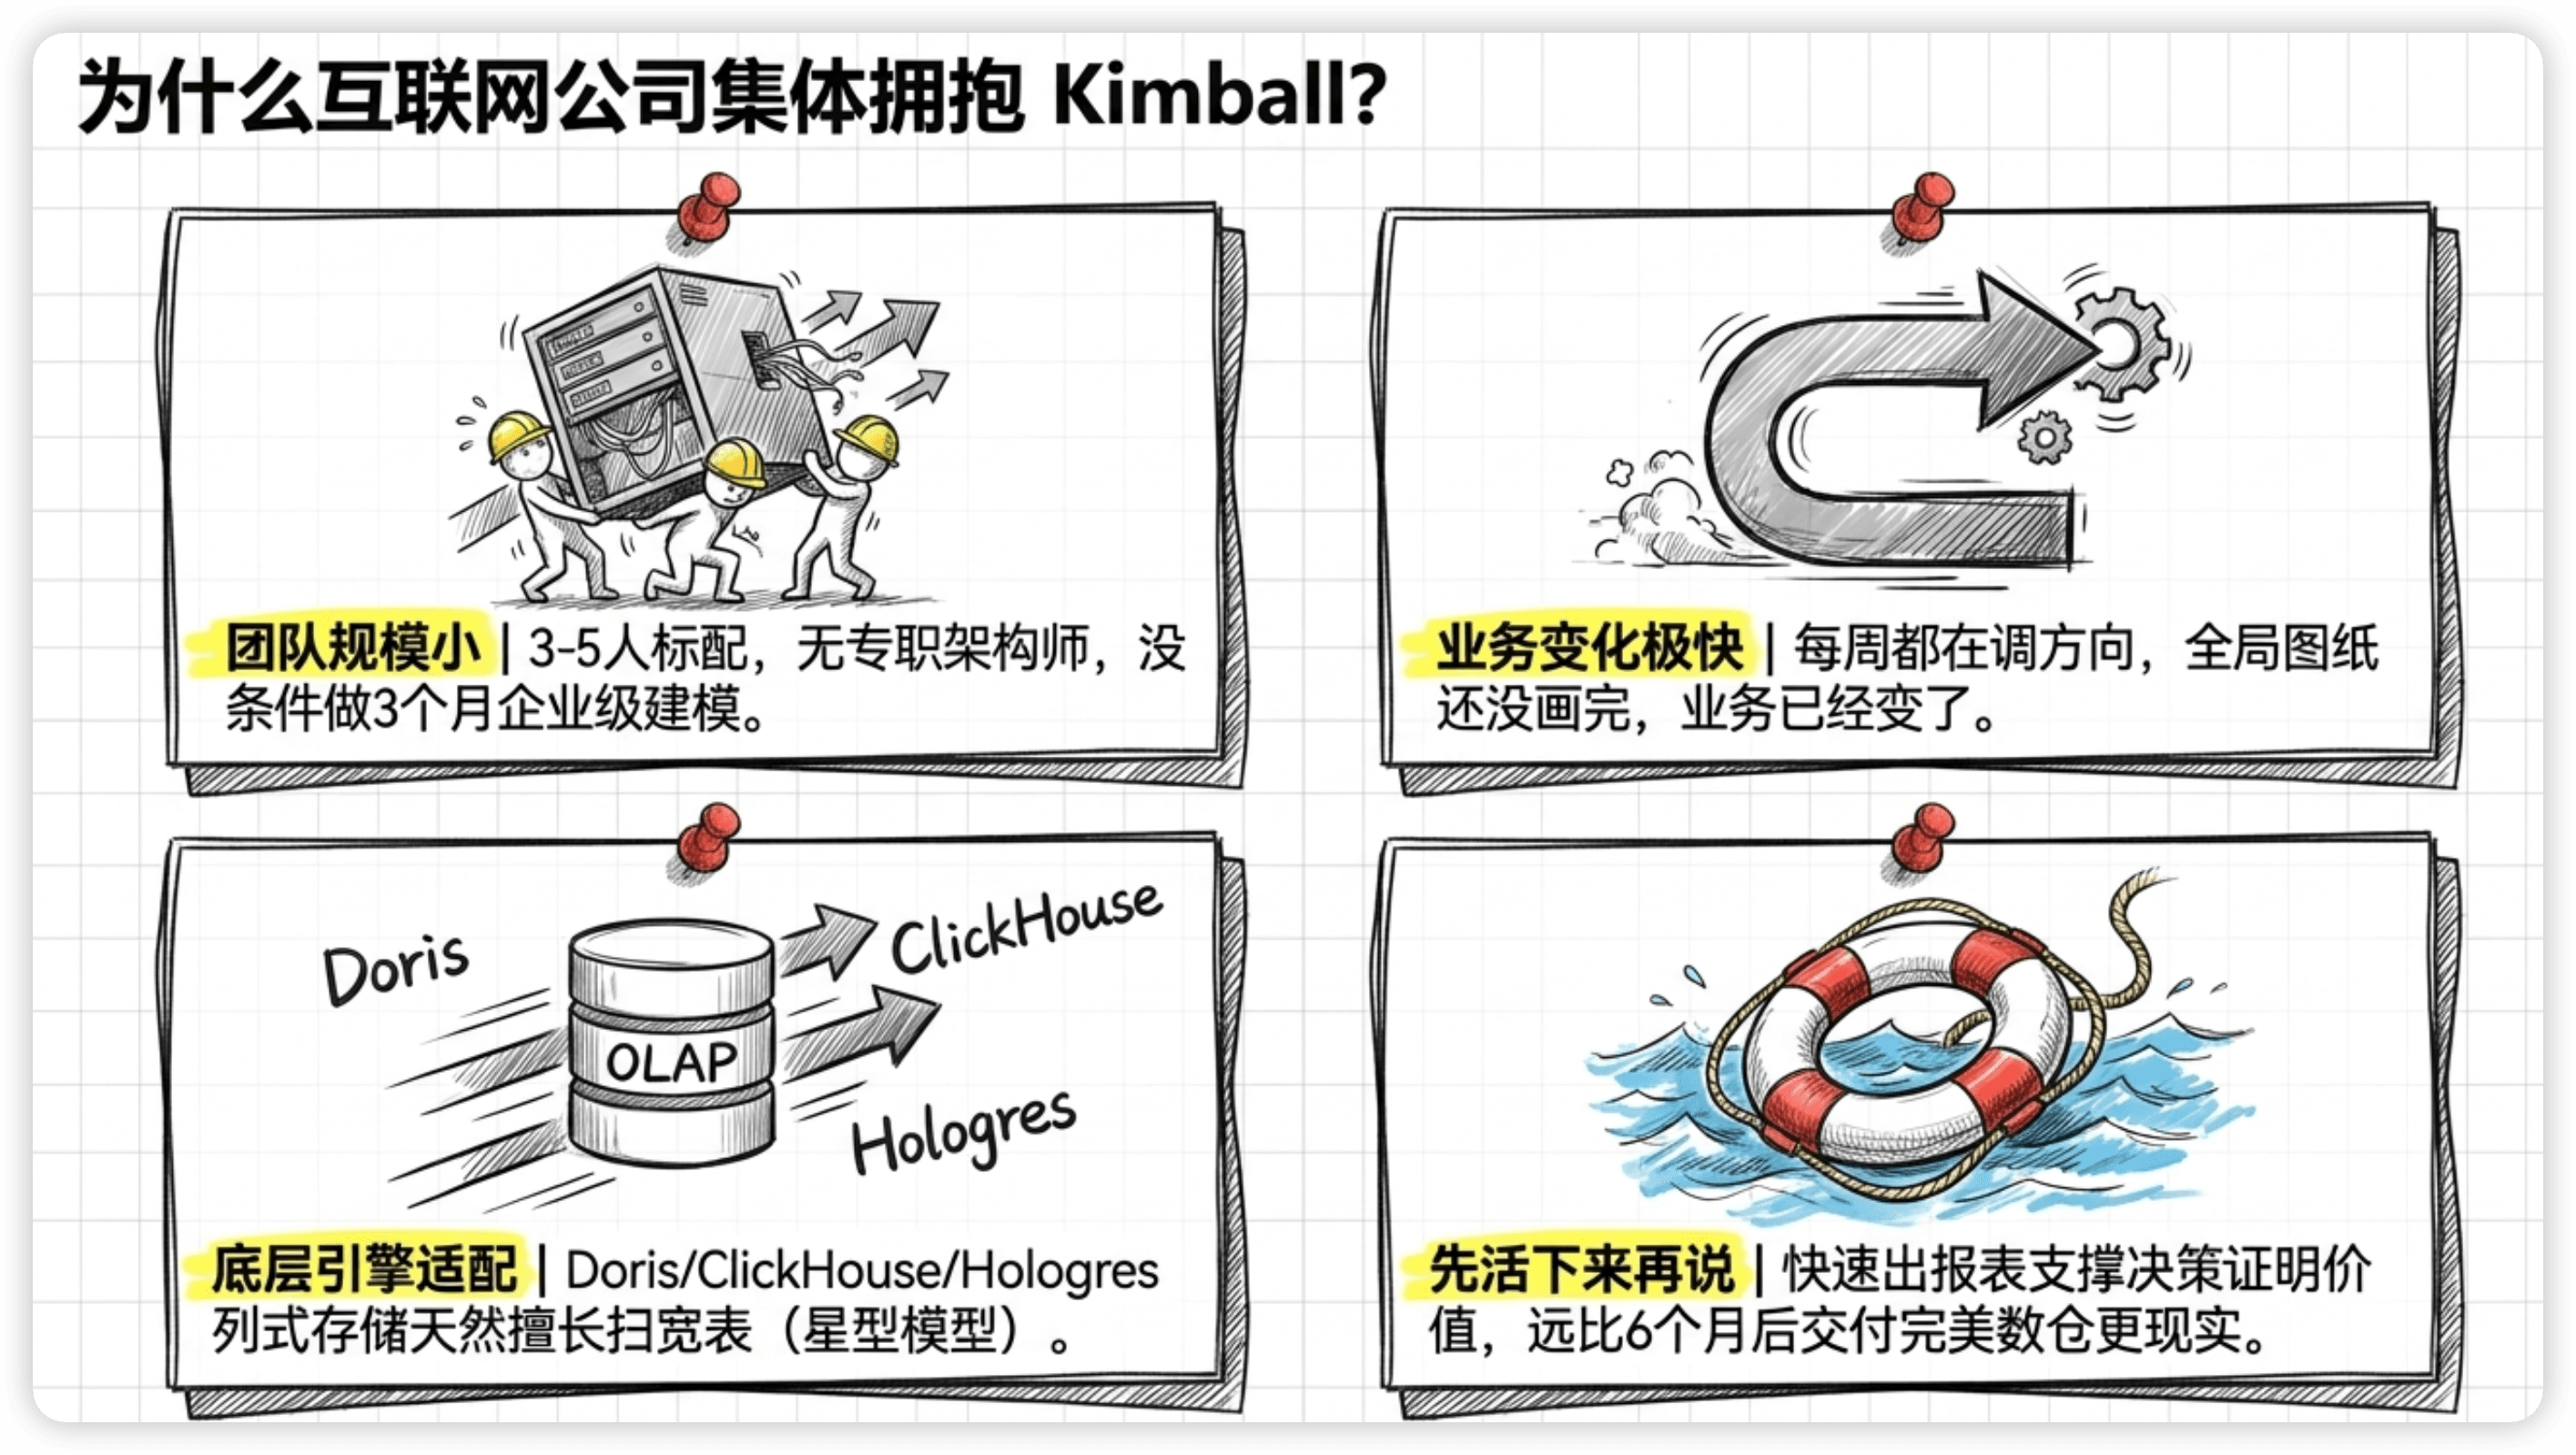
为什么互联网公司选Kimball?
不是因为Kimball"更先进",而是因为互联网公司的现实条件更适合它:
第一,团队小。 3-5个人的数据团队在互联网公司非常普遍。没有专职数据架构师,没有条件花3个月做企业级建模。Kimball的维度建模,高级数据开发就能把控质量。
第二,业务变化快。 互联网公司的业务可能每周都在调整——上周还在做直播,这周就要做短剧了。Inmon要求先想清楚全局再动手,但全局还没想清楚业务就变了。Kimball先解决眼前问题,更务实。
第三,OLAP引擎擅长宽表。 Doris、ClickHouse、StarRocks、Hologres底层都是列式存储,天然擅长扫描宽表。Kimball的星型模型JOIN少、维度表扁平,恰好符合这些引擎的设计哲学。
第四,先活下来再说。 创业公司或小公司的数据团队,首要任务是证明价值——快速出报表、快速支撑业务决策。2-4周交付一个数据集市远比6个月后交付一个完美数据仓库更现实。
我做了9年数据开发,4段工作经历,全部以Kimball为主。小公司没有条件花3个月做完整的企业数据模型设计,业务等不了那么久。先跑起来,边跑边优化,这就是Kimball的精髓。
Kimball的隐患和应对
Kimball不是没有问题。最大的隐患是一致性——各个数据集市独立建设,如果维度定义不统一,就会出现DAY 6讲的口径不一致问题。
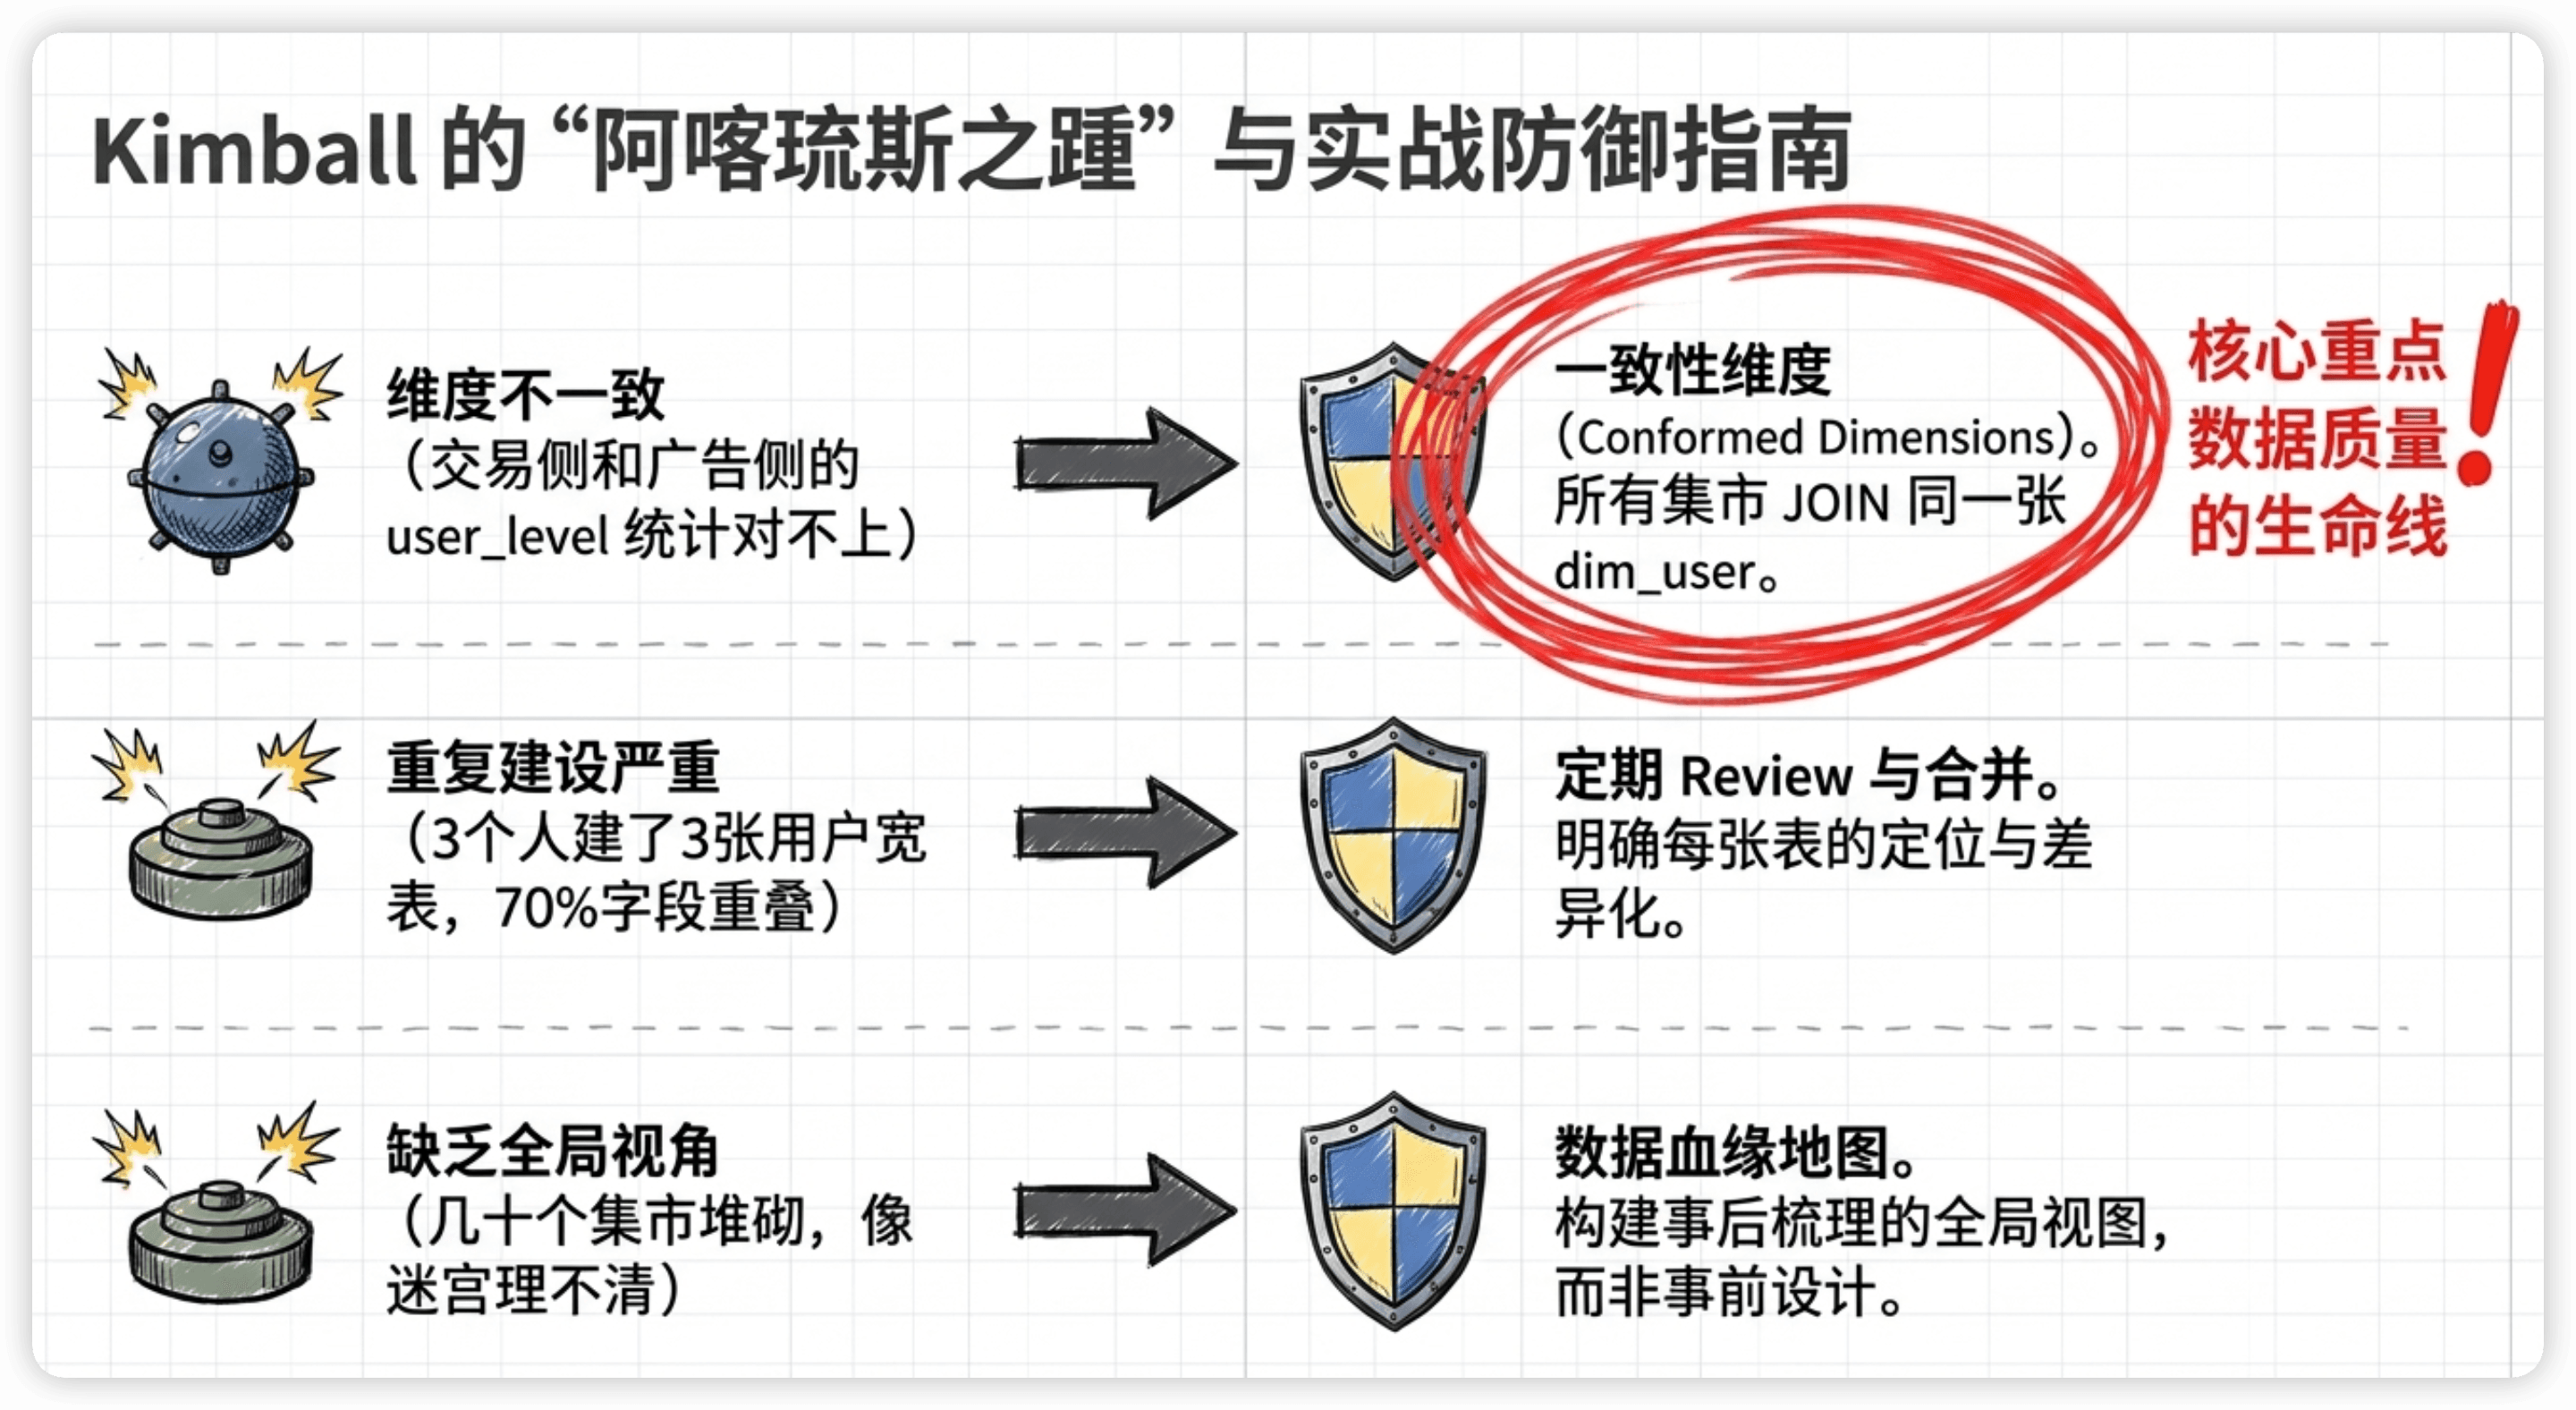
隐患一:维度不一致
交易域有一张dim_user,广告域也建了一张dim_user_ad,两张表的user_level定义不一样。跨域分析时发现数字对不上。
应对:一致性维度(Conformed Dimensions)。 所有数据集市共用同一套维度表。dim_user只有一张,所有集市JOIN同一张表。这需要DAY 10的模型评审机制来保障——新建维度表前先检查有没有已存在的。
隐患二:重复建设
3个人各自建了一张用户宽表,字段重叠70%。浪费计算资源,口径也不统一。
应对: 定期Review现有表,合并功能重叠的表,明确每张表的定位差异化。
隐患三:缺乏全局视角
建了20个数据集市之后,发现整体架构不够清晰,表之间的关系理不清。
应对: 做好数据血缘管理,即使用Kimball也要有"全局地图"——不是Inmon式的全局设计,而是事后梳理的全局视图。
实际项目中的混合方案
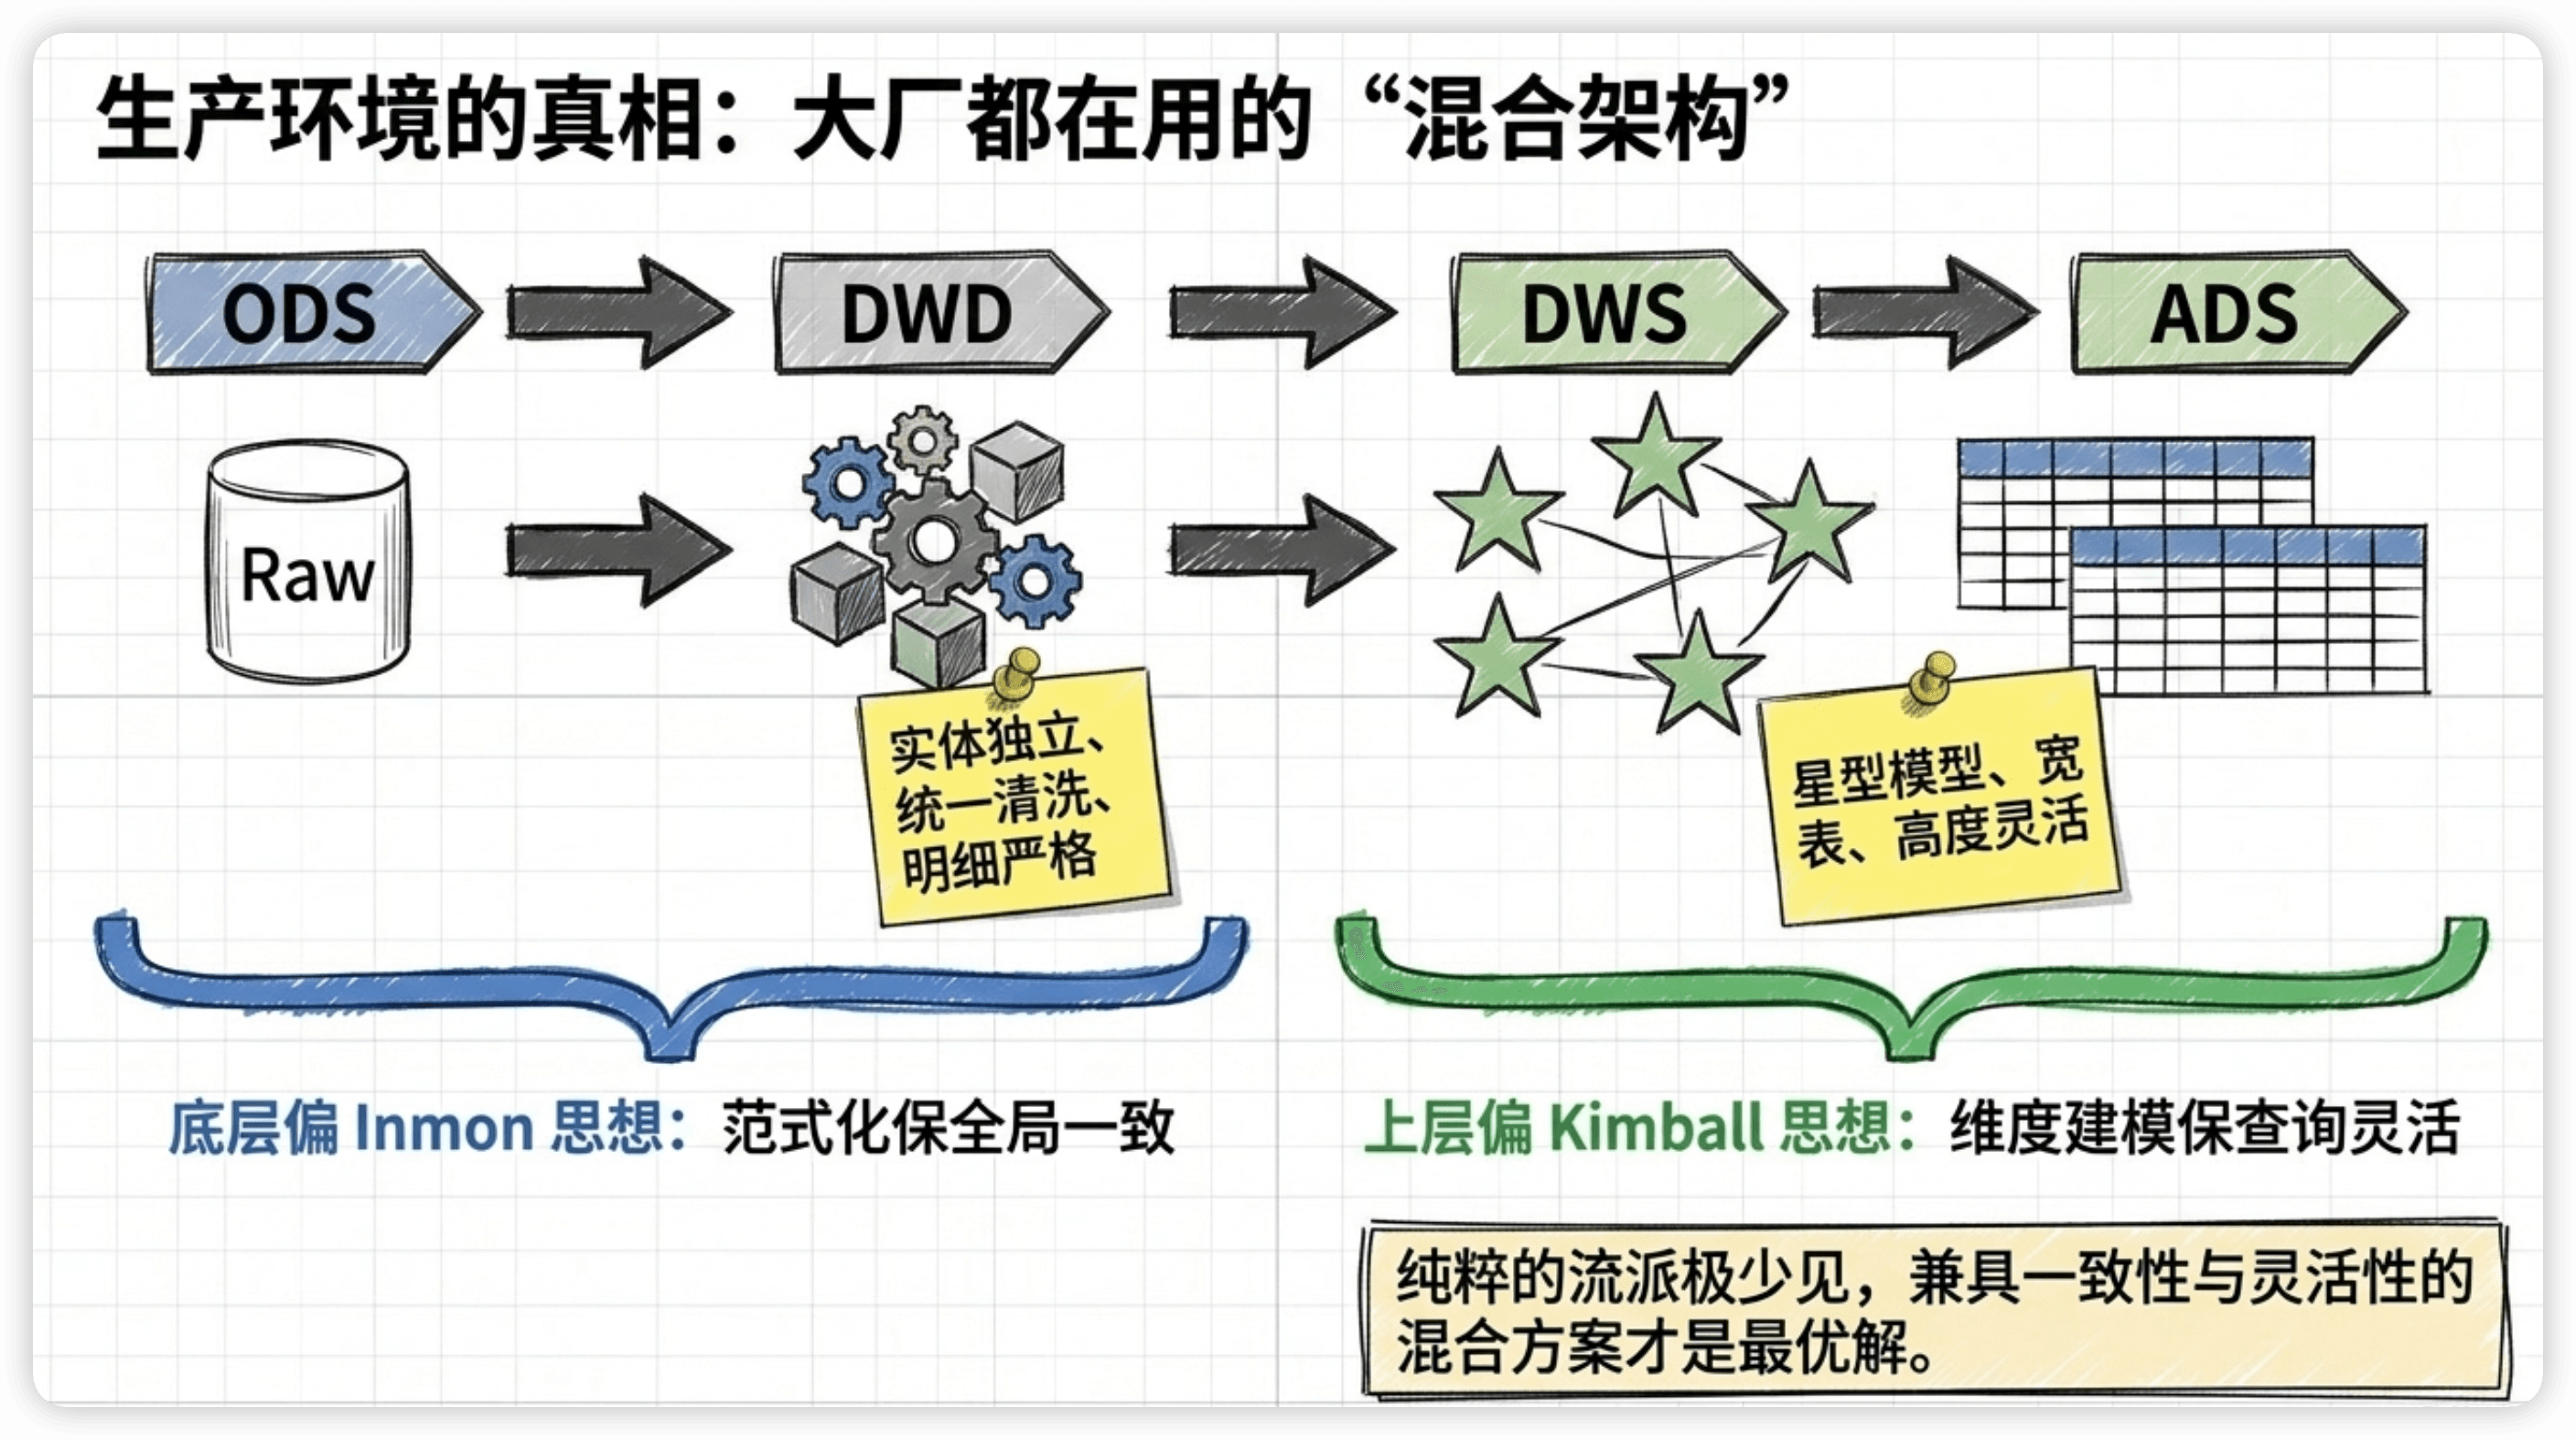
说实话,纯粹的Kimball或纯粹的Inmon我都没在生产环境中见过。大部分公司用的是这种混合方案:
ODS层 → 1:1同步源系统(和方法论无关)

DWD层 → 偏Inmon
         做一定程度的范式化清洗
         实体独立(用户表、订单表、商品表各自独立)
         字段定义全局统一
         保证底层数据的规范性

DWS层 → 偏Kimball
         按主题域建星型模型和宽表
         面向分析需求

ADS层 → 完全面向应用
         高度定制化的结果表
这种"底层规范化、上层维度化"的方案,兼具两者的优势:DWD层保证数据一致性(Inmon的长处),DWS/ADS层保证分析灵活性和性能(Kimball的长处)。
我在出海硬件品牌的时候就是这么做的。DWD层按照实体关系做了比较严格的建模——用户、设备、事件各自独立的明细表,字段定义全局统一。到了DWS层完全按Kimball的方式建星型模型和宽表。既保证了底层规范,又让上层分析足够灵活。
面试怎么答?
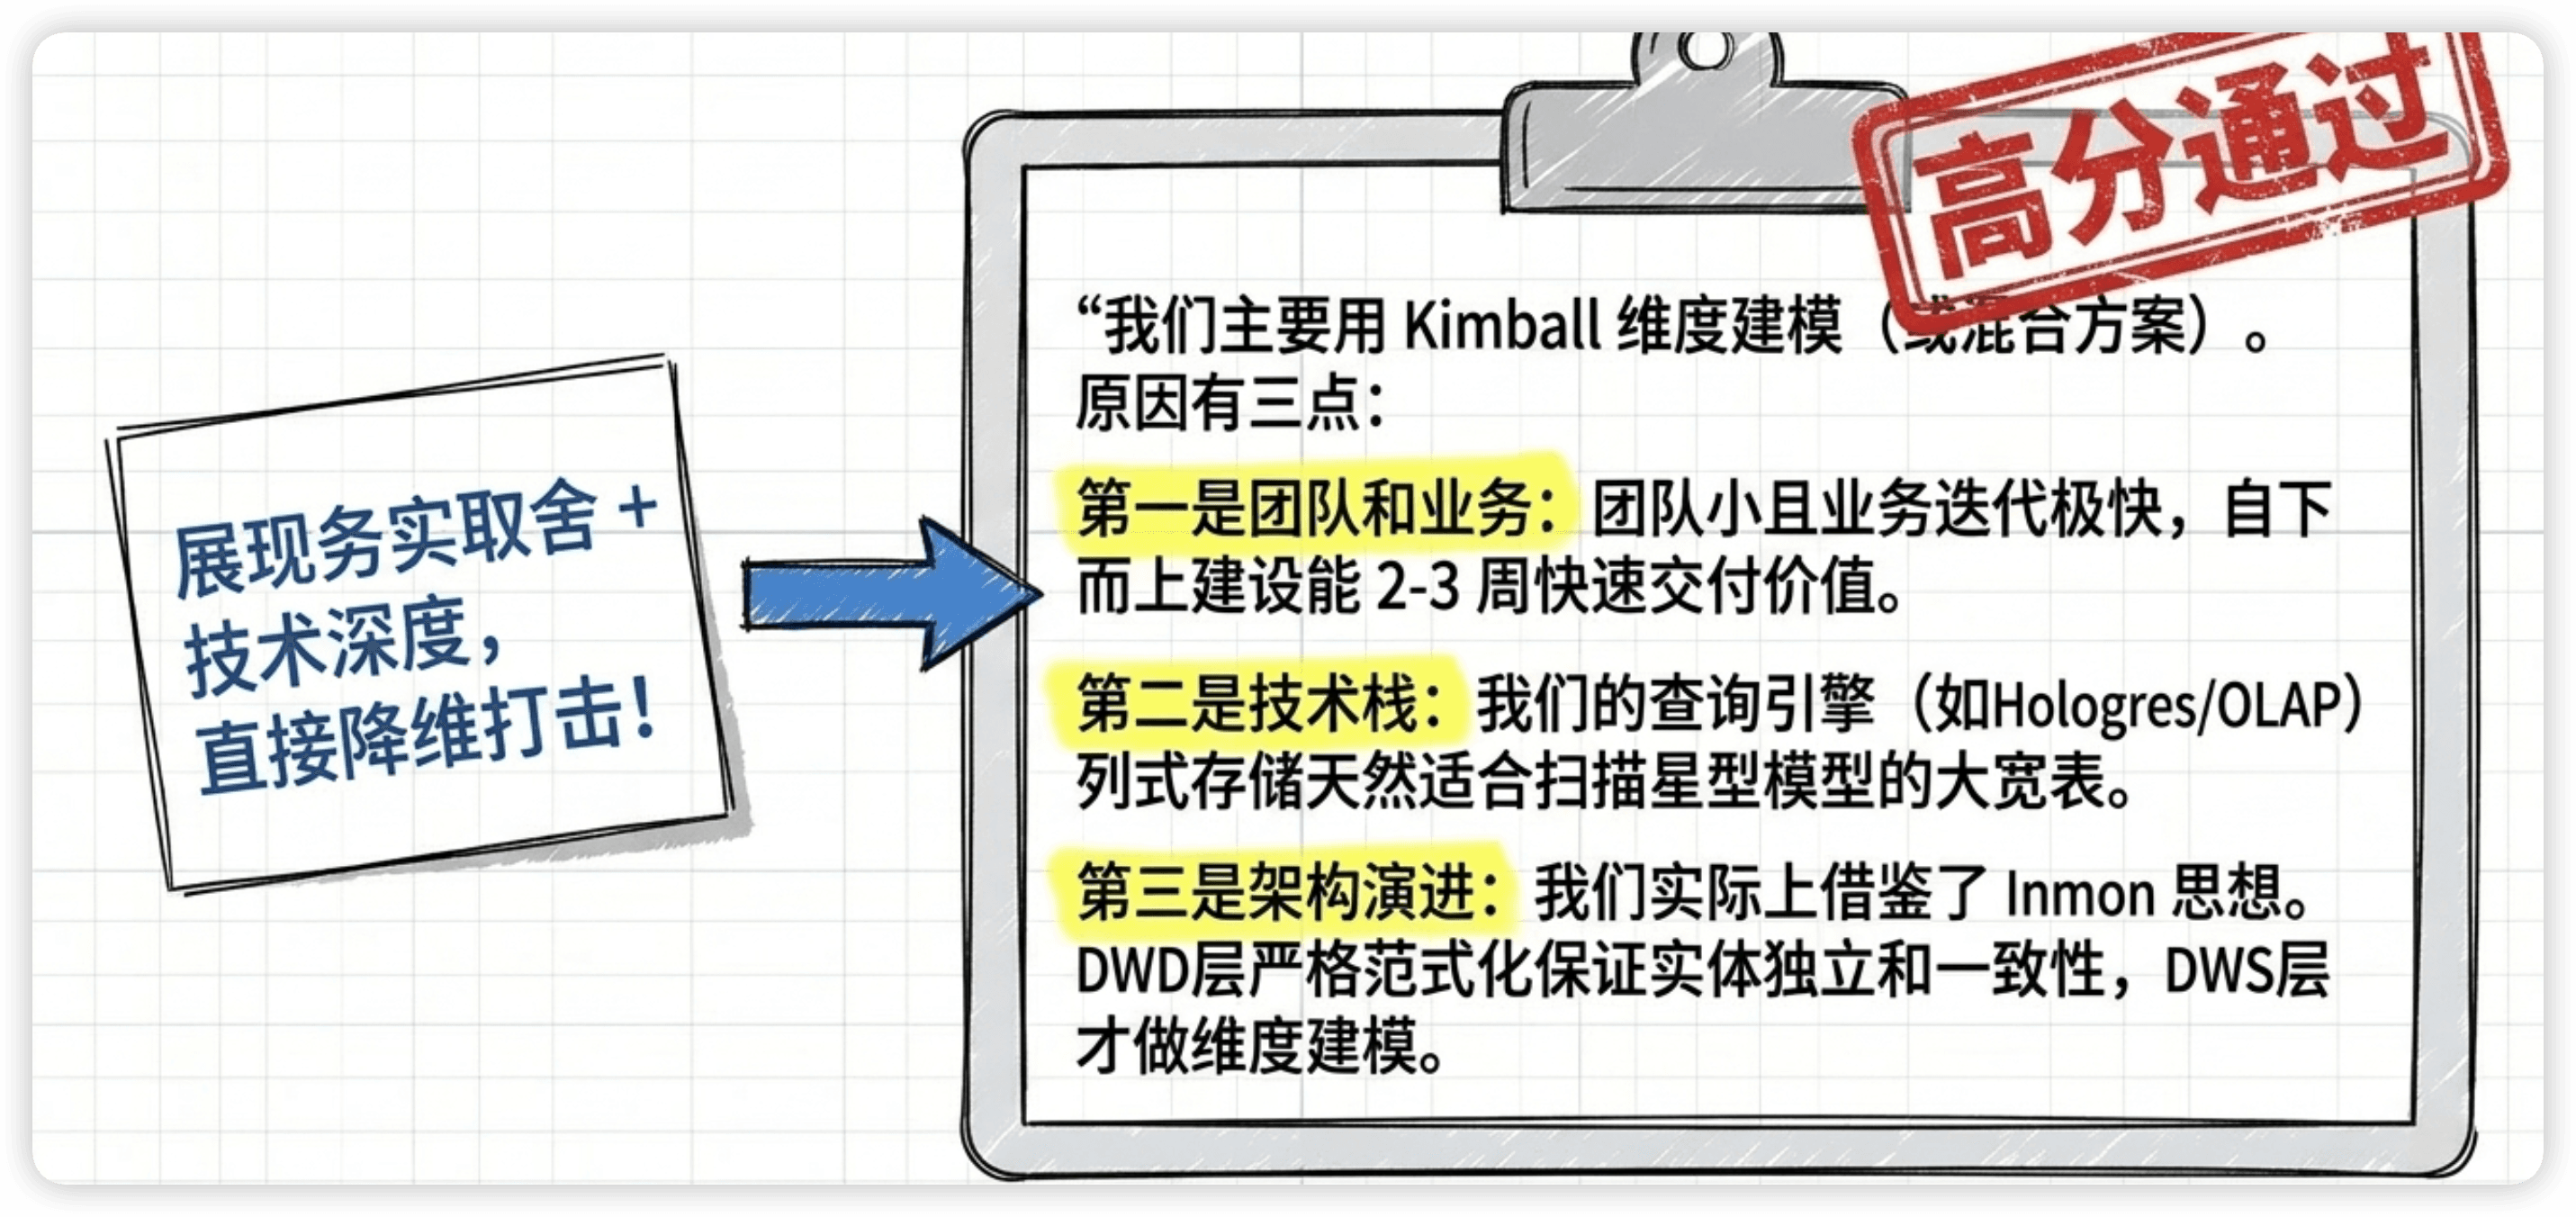
高分回答
「我们主要用Kimball的维度建模方法,原因有三:第一,团队只有3-5个人,没有条件做完整的企业级数据模型设计;第二,业务迭代快,每周都有新需求,Kimball自下而上的方式2-3周就能交付一个数据集市;第三,查询引擎是Hologres,列式存储天然适合星型模型。」
「不过我们也借鉴了Inmon的思想:DWD层做了比较严格的范式化清洗,保证实体独立、字段定义全局统一;DWS层才做维度建模。可以说是底层偏Inmon保证一致性,上层偏Kimball保证灵活性的混合方案。」
追问防线
追问1:一致性维度怎么实现?
核心是所有数据集市共用同一套维度表。比如交易域和广告域都需要用户维度,就只有一张dim_user,两个集市的事实表都JOIN这张表。实现上在DIM层统一维护维度表,所有DWS层从统一的DIM层JOIN。DAY 10的模型评审能保障这一点——新建维度表前先检查有没有已存在的。
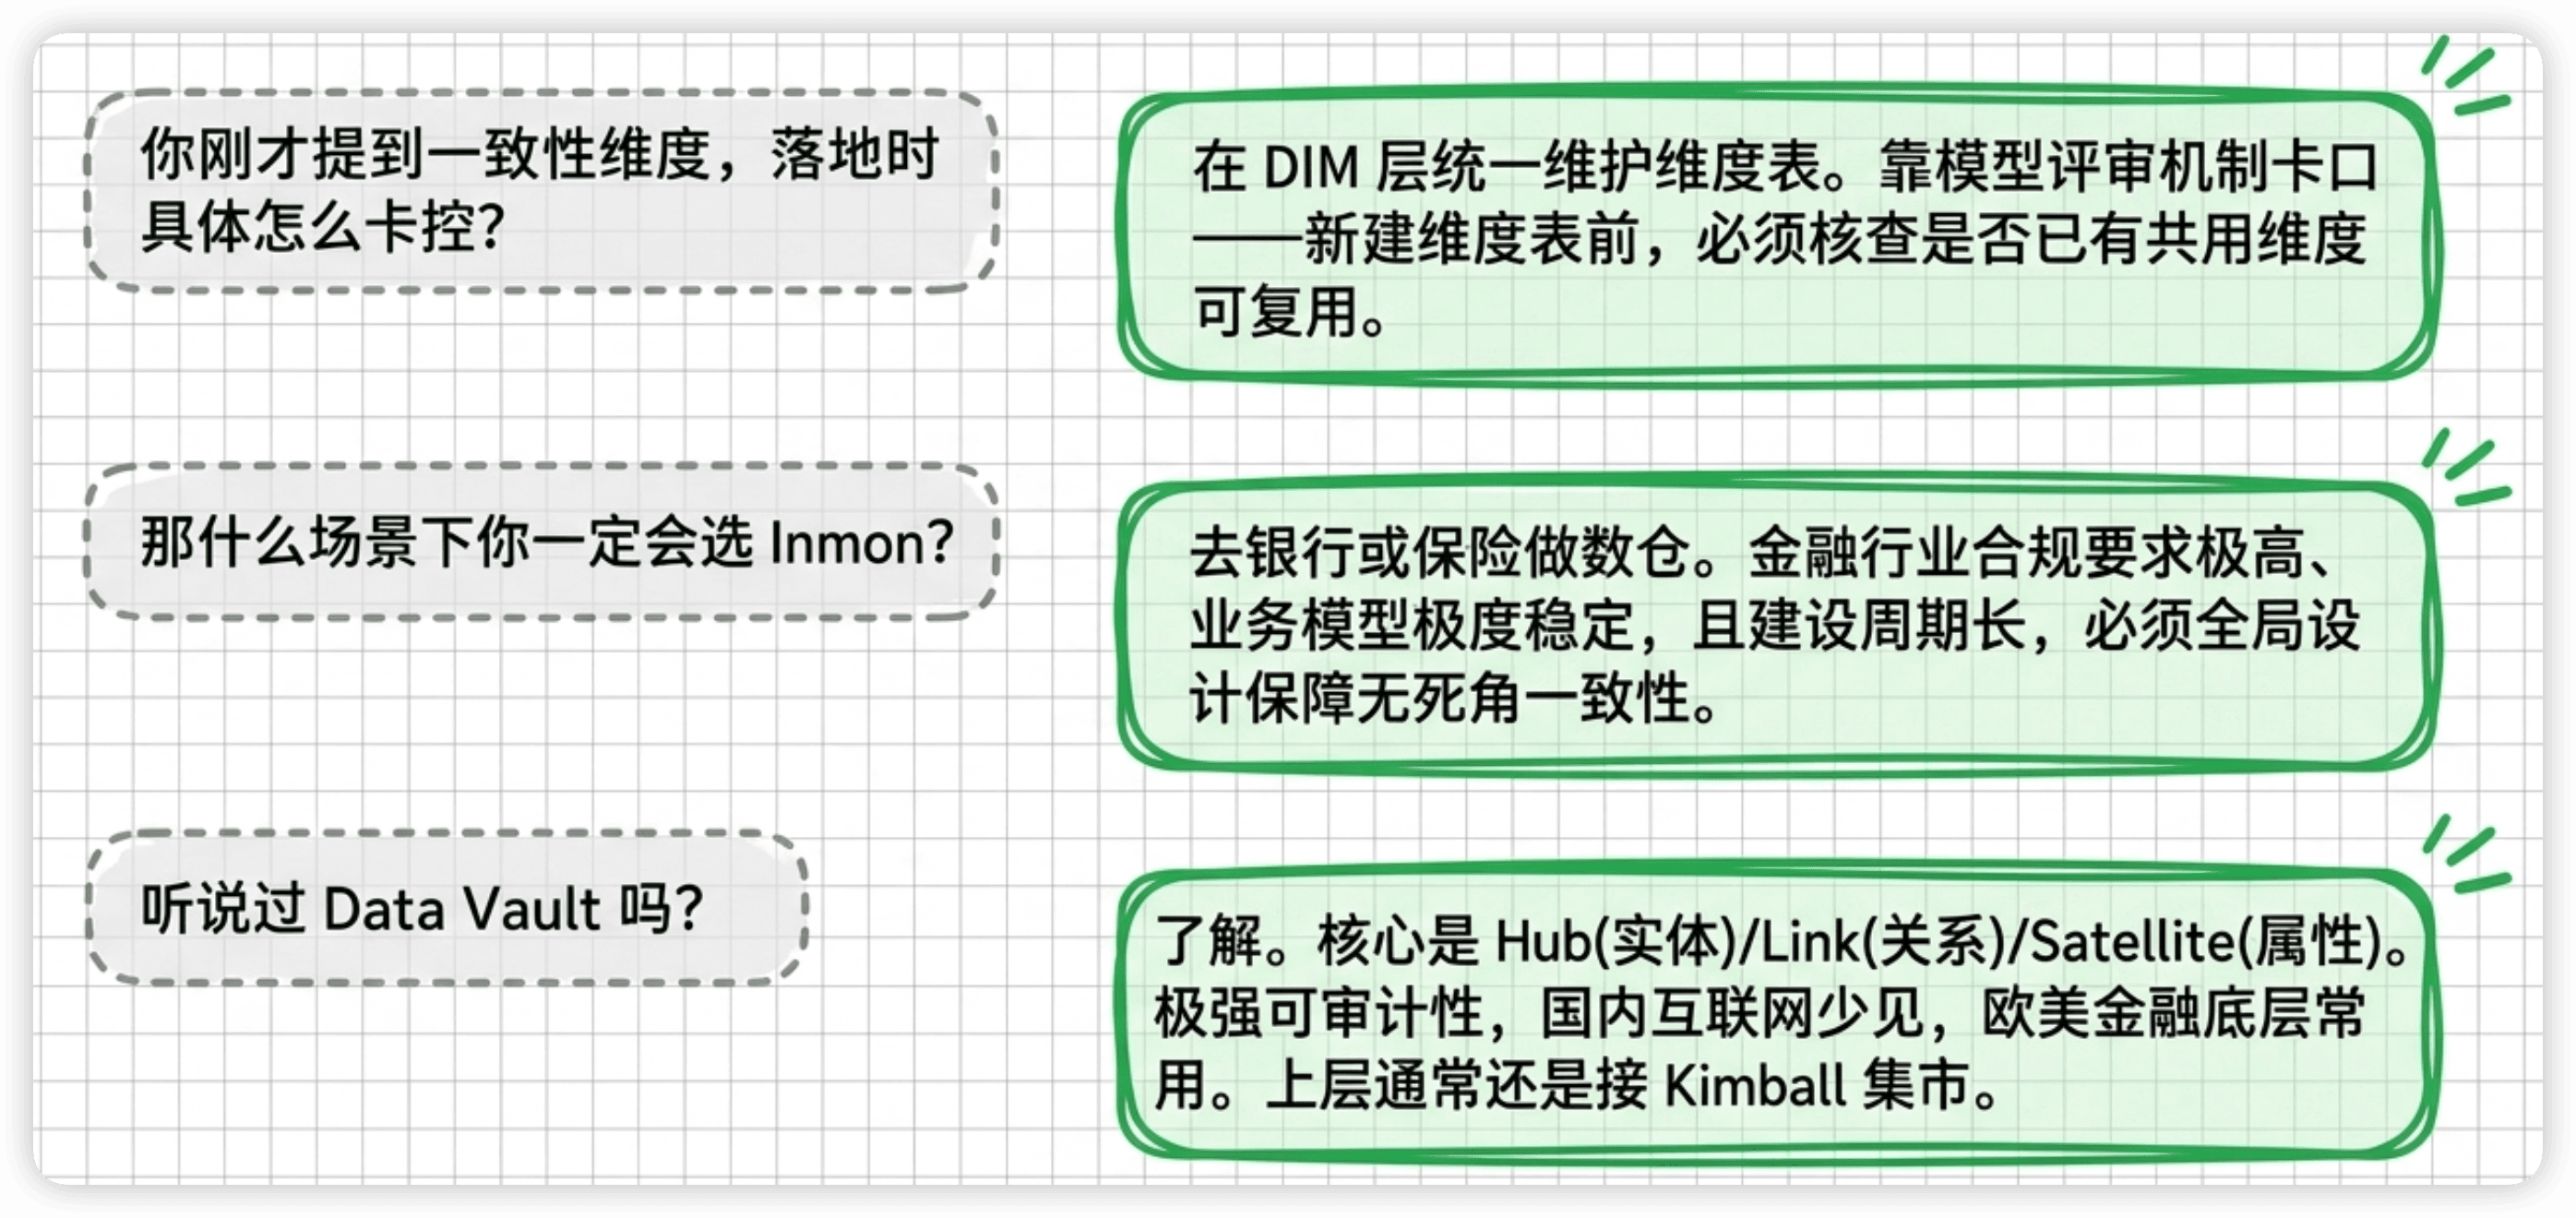
追问2:什么场景下你会选Inmon?
如果去银行或保险公司做数仓,我会更倾向Inmon。金融行业业务模型稳定、合规要求高、团队足够大、建设周期允许。但即使选Inmon,上层分析层我依然会用星型模型——因为分析师和BI工具需要这种结构。
追问3:Data Vault听说过吗?
Data Vault是第三种建模方法论,核心是Hub(实体)、Link(关系)、Satellite(属性),强调可审计性和灵活性。它主要用在底层的staging层,上层依然用Kimball做分析。在国内互联网公司很少见,但在欧美的金融、医疗行业有一些应用。
总结
- Kimball:自下而上,维度建模,快速交付,互联网绝对主流
- Inmon:自上而下,范式建模,全局一致,传统企业多
- 实际项目中大部分是混合方案:底层偏Inmon(DWD范式化),上层偏Kimball(DWS星型模型)
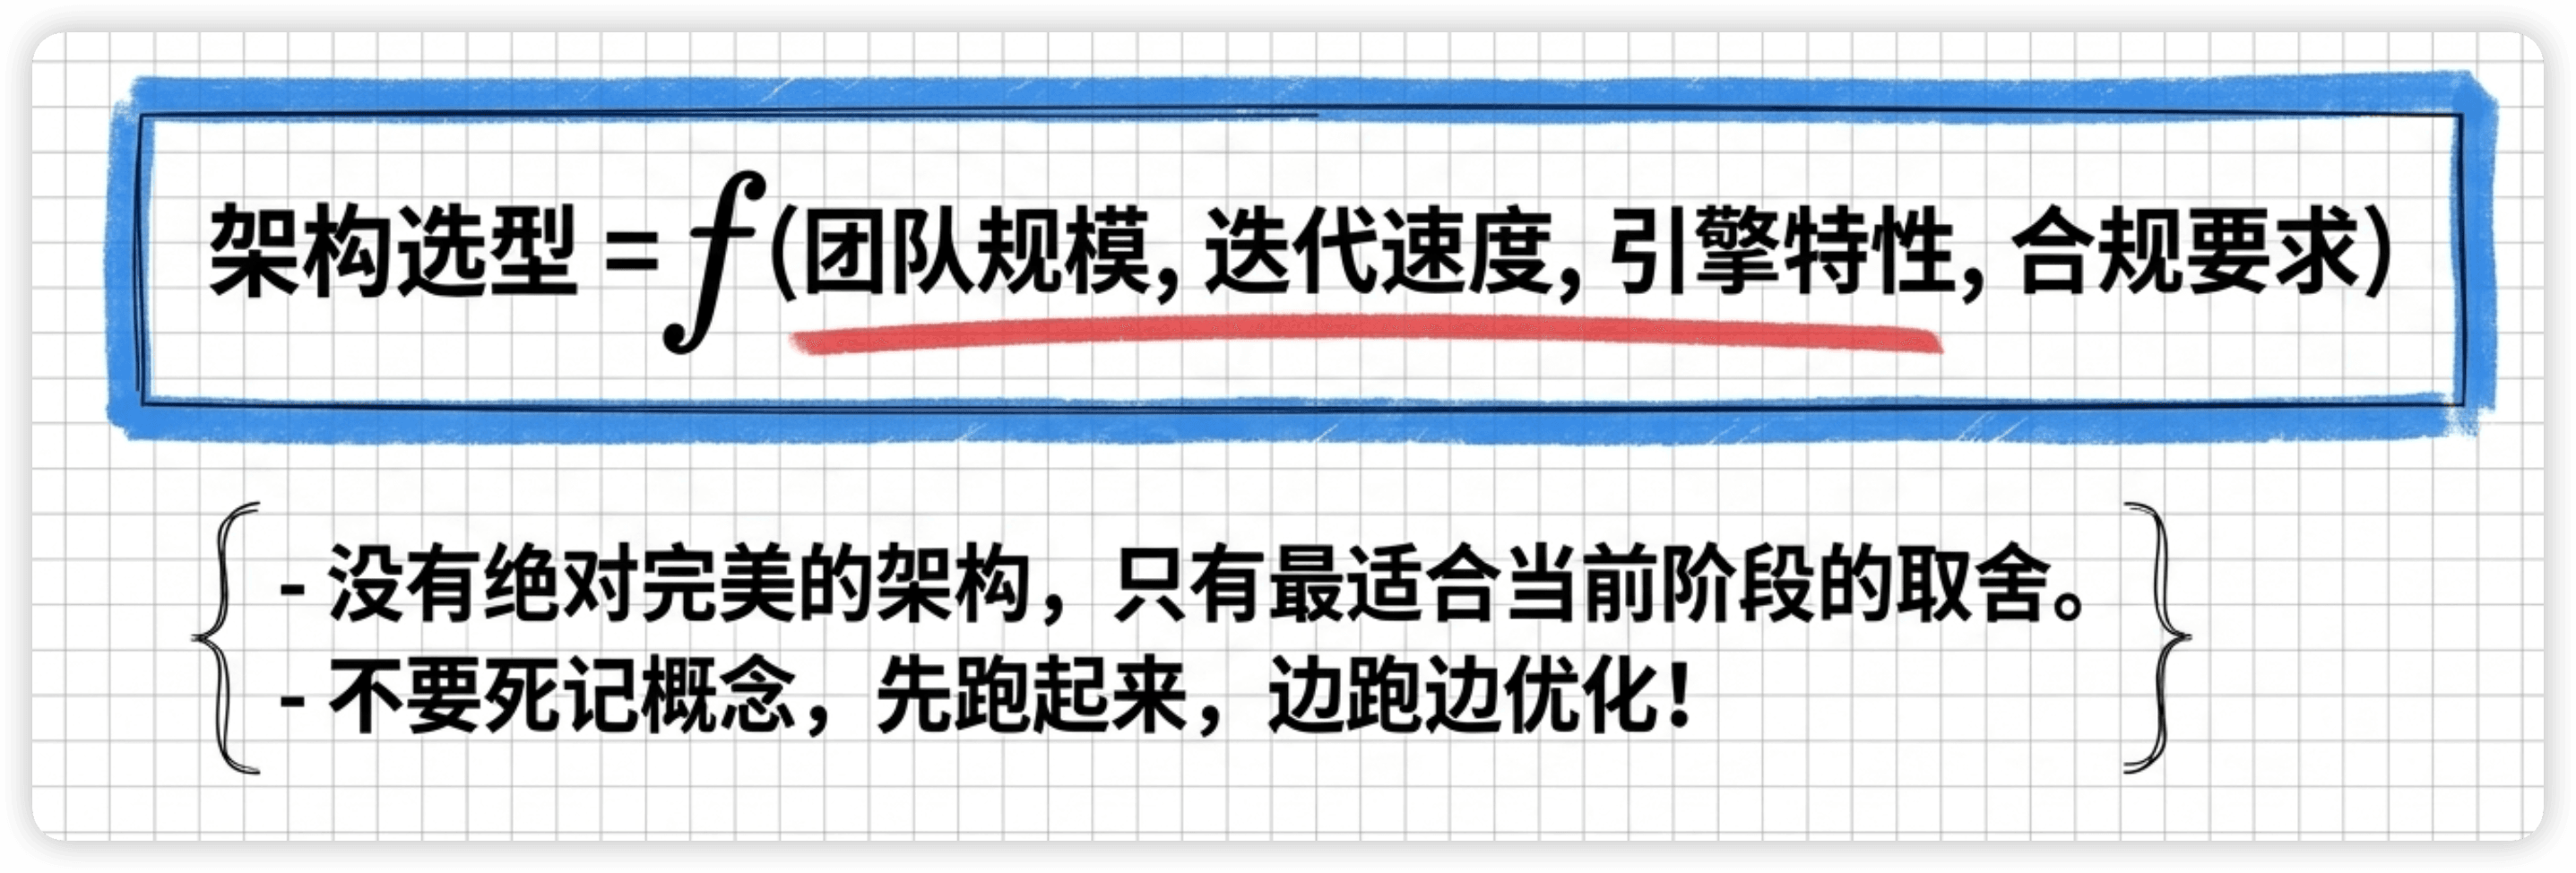
- 选型依据:团队规模 + 业务迭代速度 + 查询引擎特性 + 合规要求
- 面试回答:先说主方案+理由,再补充借鉴了什么,展示架构思维而非死记概念